
Last chance! 50% off DataCamp Premium
Sale ends in
इस ट्यूटोरियल का कोड ऑनलाइन चलाएं और संपादित करें
कोड चलाएंहम इन विधियों के गणितीय गुणों के साथ-साथ व्यावहारिक R उदाहरणों को भी कवर करेंगे, और कुछ अतिरिक्त तरकीबें भी देखेंगे। चलिए सीधे शुरू करते हैं!
आइए मूल बातें से शुरू करें: सरल लीनियर रिग्रेशन मॉडल, जिसमें आपका लक्ष्य है प्रतिक्रिया चर Y के n प्रेक्षणों की भविष्यवाणी करना, m प्रेडिक्टर चर X के एक रैखिक संयोजन और एक सामान्य-वितरित त्रुटि पद के साथ, जिसकी वैरिएंस σ2 है:
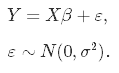
चूंकि हमें वास्तविक पैरामीटर, β, ज्ञात नहीं हैं, हमें इन्हें सैंपल से अनुमानित करना पड़ता है। Ordinary Least Squares (OLS) पद्धति में, हम इन्हें $\hat\beta$ के रूप में ऐसे अनुमानित करते हैं कि रेजिडुअल्स के स्क्वेयर का योग यथासंभव छोटा हो। दूसरे शब्दों में, हम निम्नलिखित लॉस फ़ंक्शन को न्यूनतम करते हैं:
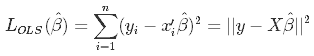
ताकि कुख्यात OLS पैरामीटर अनुमान प्राप्त हों, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$।
सांख्यिकी में, अनुमानकों की दो महत्वपूर्ण विशेषताएँ होती हैं: बायस और वैरिएंस। बायस वास्तविक आबादी के पैरामीटर और अपेक्षित अनुमानक के बीच का अंतर है:
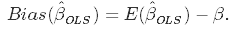
यह अनुमानों की सटीकता को मापता है। दूसरी ओर, वैरिएंस इन अनुमानों के फैलाव या अनिश्चितता को मापता है। यह निम्न प्रकार से दिया जाता है
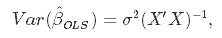
जहां अज्ञात त्रुटि वैरिएंस σ2 को रेजिडुअल्स से इस प्रकार अनुमानित किया जा सकता है
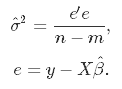
यह चित्रण बताता है कि बायस और वैरिएंस क्या हैं। कल्पना कीजिए, बुल्स-आई वह वास्तविक आबादी पैरामीटर है जिसका हम अनुमान लगा रहे हैं, β, और उस पर लगी गोलियां हमारे चार अलग-अलग अनुमानकों से प्राप्त अनुमानित मान हैं — कम बायस और कम वैरिएंस, अधिक बायस और अधिक वैरिएंस, और इनके संयोजन।
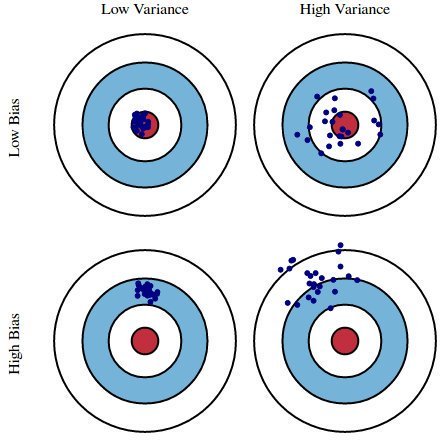
स्रोत: kdnuggets.com
हम चाहते हैं कि बायस और वैरिएंस दोनों ही कम हों, क्योंकि बड़े मान मॉडल से कमजोर भविष्यवाणी का कारण बनते हैं। वस्तुतः, मॉडल की त्रुटि को तीन भागों में विभाजित किया जा सकता है: बड़े वैरिएंस से उत्पन्न त्रुटि, महत्वपूर्ण बायस से उत्पन्न त्रुटि, और शेष — जो समझाई नहीं जा सकती।
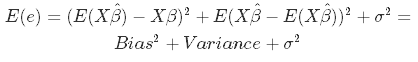
OLS अनुमानक में अनबायस्ड होने का वांछित गुण होता है। हालांकि, इसका वैरिएंस बहुत बड़ा हो सकता है। खासकर, ऐसा तब होता है जब:
इसका सामान्य समाधान है: कुछ बायस जोड़कर वैरिएंस को कम करना। इस पद्धति को रेग्युलराइज़ेशन कहते हैं और यह लगभग हमेशा मॉडल के प्रेडिक्टिव प्रदर्शन के लिए लाभकारी होती है। इसे और स्पष्ट करने के लिए, नीचे दिया गया प्लॉट देखें।
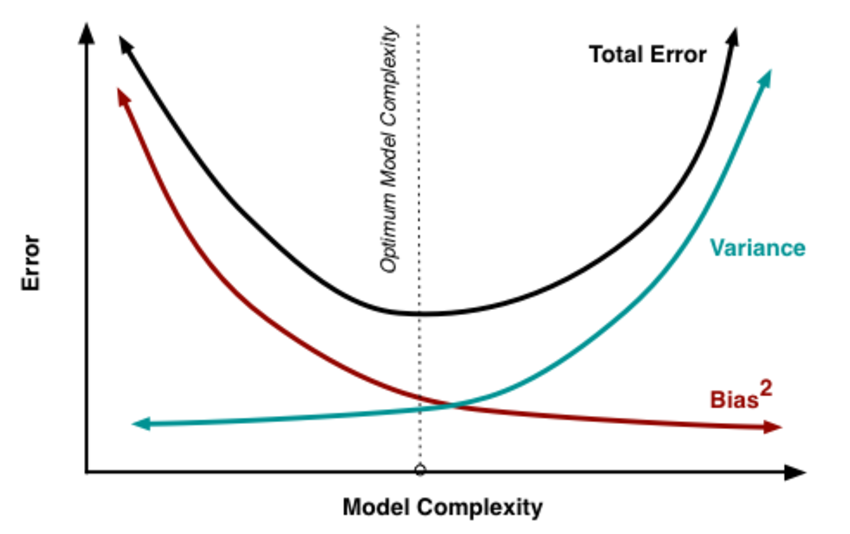
स्रोत: researchgate.net
जैसे-जैसे मॉडल की जटिलता बढ़ती है — जिसे लीनियर रिग्रेशन के संदर्भ में प्रेडिक्टर्स की संख्या समझा जा सकता है — अनुमानों का वैरिएंस भी बढ़ता है, पर बायस घटता है। अनबायस्ड OLS हमें चित्र के दाहिने हिस्से में ले जाएगा, जो इष्टतम से काफी दूर है। इसलिए हम रेग्युलराइज़ करते हैं: कुछ बायस की कीमत पर वैरिएंस घटाते हैं, यानी प्लॉट पर बाईं ओर इष्टतम की ओर बढ़ते हैं।
अब तक की चर्चा से निष्कर्ष निकलता है कि हम मॉडल की जटिलता, अर्थात प्रेडिक्टर्स की संख्या, घटाना चाहते हैं। इसके लिए हम फॉरवर्ड या बैकवर्ड सेलेक्शन का उपयोग कर सकते हैं, लेकिन उस स्थिति में हटाए गए वेरिएबल्स के प्रतिक्रिया पर प्रभाव के बारे में कुछ नहीं कह पाएंगे। मॉडल से प्रेडिक्टर्स हटाना, उनके गुणांकों को शून्य करने जैसा है। उन्हें ठीक-ठीक शून्य करने के बजाय, यदि वे शून्य से बहुत दूर हों तो उन्हें दंडित करें, यानी सतत तरीके से उन्हें छोटा करें। इस तरह, हम सभी वेरिएबल्स को मॉडल में रखते हुए जटिलता घटाते हैं। मूल रूप से, यही Ridge रिग्रेशन करता है।
Ridge रिग्रेशन में OLS लॉस फ़ंक्शन को इस प्रकार विस्तारित किया जाता है कि हम न केवल स्क्वेयर्ड रेजिडुअल्स के योग को न्यूनतम करते हैं, बल्कि पैरामीटर अनुमानों के आकार को भी दंडित करते हैं, ताकि उन्हें शून्य की ओर संकुचित किया जा सके:
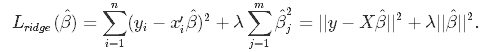
इसे $\hat\beta$ के लिए हल करने पर ridge रिग्रेशन के अनुमान मिलते हैं $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, जहां I आइडेंटिटी मैट्रिक्स है।
λ पैरामीटर रेग्युलराइज़ेशन पेनल्टी है। इसे कैसे चुनना है, इस पर हम आगे बात करेंगे, फिलहाल ध्यान दें कि:
तो λ को 0 रखने का अर्थ OLS का उपयोग करना है, जबकि इसका मान जितना बड़ा होगा, गुणांकों के आकार पर दंड उतना ही कड़ा होगा।
बायस और वैरिएंस के सूत्रों में रेग्युलराइज़ेशन गुणांक शामिल करने पर हमें मिलता है
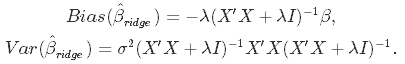
यहां से स्पष्ट है कि जैसे-जैसे λ बड़ा होता है, वैरिएंस घटता है और बायस बढ़ता है। सवाल है: वैरिएंस घटाने के लिए हम कितना बायस स्वीकार करने को तैयार हैं? या: λ का इष्टतम मान क्या है?
इसे निपटाने के दो तरीके हैं। एक पारंपरिक तरीका है λ ऐसा चुनना कि कोई सूचना मानदंड, जैसे AIC या BIC, न्यूनतम हो। एक अधिक मशीन लर्निंग-उन्मुख तरीका है क्रॉस-वैलिडेशन करना और वह λ चुनना जो क्रॉस-वैलिडेटेड स्क्वेयर्ड रेजिडुअल्स के योग (या कोई अन्य माप) को न्यूनतम करे। पहला तरीका डेटा पर मॉडल के अनुरूपता पर जोर देता है, जबकि दूसरा इसकी प्रेडिक्टिव परफॉर्मेंस पर केंद्रित है। दोनों पर चर्चा करें।
सूचना मानदंड को न्यूनतम करना
यह तरीका कई अलग-अलग λ मानों के साथ मॉडल का अनुमान लगाने और वह मान चुनने पर आधारित है जो Akaike या Bayesian सूचना मानदंड को न्यूनतम करता है:
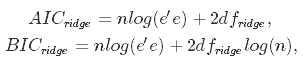
जहां dfridge डिग्रीज़ ऑफ फ्रीडम की संख्या है। यहां सावधान रहें! Ridge रिग्रेशन में डिग्रीज़ ऑफ फ्रीडम, सामान्य OLS से अलग होती है! इसे अक्सर नजरअंदाज किया जाता है, जिससे गलत निष्कर्ष निकलते हैं। OLS और ridge दोनों में, डिग्रीज़ ऑफ फ्रीडम तथाकथित हैट मैट्रिक्स के ट्रेस के बराबर होती है, जो प्रतिक्रिया मानों के वेक्टर को फिटेड मानों के वेक्टर पर ऐसे मैप करती है: $\hat y = H y$।
OLS में, हमें मिलता है HOLS = X(X′X)−1X, जिससे dfOLS = trHOLS = m मिलती है, जहां m प्रेडिक्टर्स की संख्या है। पर ridge रिग्रेशन में हैट मैट्रिक्स के सूत्र में रेग्युलराइज़ेशन पेनल्टी शामिल होनी चाहिए: Hridge = X(X′X + λI)−1X, जिससे dfridge = trHridge होती है, जो अब m के बराबर नहीं रहती। कुछ ridge सॉफ़्टवेयर OLS वाले सूत्र पर आधारित सूचना मानदंड दिखाते हैं। सुनिश्चित रहने के लिए इन्हें मैन्युअली निकालना बेहतर है — जैसा हम आगे इस ट्यूटोरियल में करेंगे।
क्रॉस-वैलिडेटेड रेजिडुअल्स को न्यूनतम करना
क्रॉस-वैलिडेशन से λ चुनने के लिए, आपको परीक्षण हेतु λ के P मानों का एक सेट चुनना है, डेटासेट को K फोल्ड्स में बांटना है, और यह एल्गोरिथ्म अपनाना है:
बेशक, आपको खुद से प्रोग्राम लिखने की जरूरत नहीं — R में समर्पित फ़ंक्शंस उपलब्ध हैं।
R में glmnet पैकेज ridge रिग्रेशन लागू करने के लिए पर्याप्त है। हम उदाहरण के लिए प्रसिद्ध mtcars डेटासेट का उपयोग करेंगे, जहां कार्य है कार की अन्य विशेषताओं के आधार पर माइल्स पर गैलन की भविष्यवाणी करना। एक और बात: ridge रिग्रेशन मानता है कि प्रेडिक्टर्स मानकीकृत (standardized) और प्रतिक्रिया केंद्रित (centered) है! आप जल्दी ही देखेंगे कि यह मान क्यों आवश्यक है। फिलहाल, हम मॉडलिंग से पहले मानकीकरण कर लेते हैं।
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)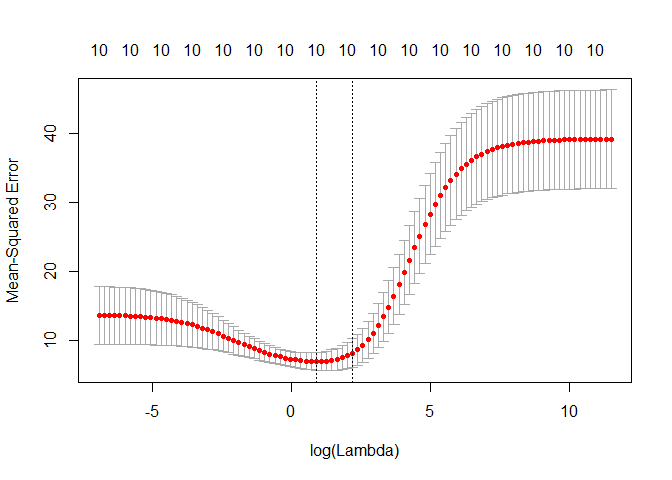
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))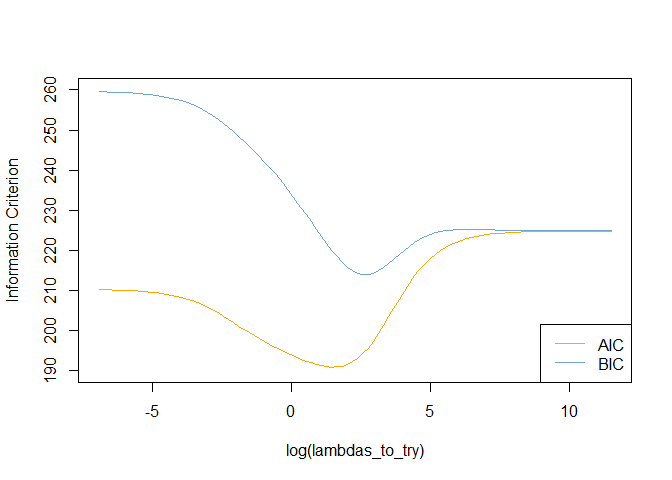
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)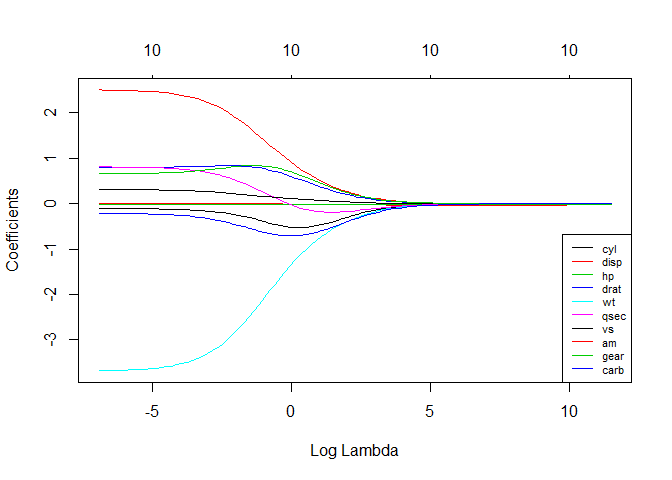
मैंने पहले बताया था कि ridge रिग्रेशन में प्रेडिक्टर्स का z-स्कोर के रूप में स्केल होना आवश्यक है। ऐसा क्यों? यह स्केलिंग सुनिश्चित करती है कि पेनल्टी टर्म प्रत्येक गुणांक को समान रूप से दंडित करे, ताकि उसका रूप $\lambda \sum_{j=1}^m\hat\beta_j^2$ हो। यदि प्रेडिक्टर्स मानकीकृत नहीं हैं, तो उनकी मानक विचलन एक के बराबर नहीं होंगे, और कुछ गणित से दिखाया जा सकता है कि तब पेनल्टी टर्म $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$ के रूप में होगा। यानी, गैर-मानकीकृत गुणांक अपने-अपने प्रेडिक्टर के मानक विचलन के व्युत्क्रम से वेट हो जाते हैं। हम इसे टालने के लिए X मैट्रिक्स को स्केल करते हैं, लेकिन... सभी प्रेडिक्टर्स की वैरिएंस बराबर करके इस हेटेरोस्केडास्टिसिटी समस्या को सुलझाने के बजाय, इन्हीं वैरिएंसेज़ को अनुमान प्रक्रिया में वेट के रूप में इस्तेमाल क्यों न करें! यही विचार है डिफरेंशियली-वेटेड या हेटेरोस्केडास्टिक Ridge रिग्रेशन के पीछे।
विचार है कि लॉस फ़ंक्शन में वेट्स जोड़कर अलग-अलग गुणांकों को अलग-अलग ताकत से दंडित किया जाए:
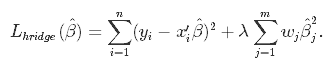
वेट्स wj कैसे चुनें? सभी प्रेडिक्टर्स के लिए एक-चर (univariate) रिग्रेशन चलाएं (प्रतिक्रिया बनाम एक प्रेडिक्टर), और गुणांक के वैरिएंस का अनुमान, $\hat\sigma_{j}$, निकालें, और उसे वेट के रूप में इस्तेमाल करें! इस तरह:
R में इसे ऐसे करें। चूंकि यह विधि glmnet में लागू नहीं है, यहां थोड़ा प्रोग्रामिंग करनी होगी।
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, या Least Absolute Shrinkage and Selection Operator, अवधारणात्मक रूप से ridge रिग्रेशन से काफी मिलता-जुलता है। यह भी गैर-शून्य गुणांकों पर पेनल्टी जोड़ता है, लेकिन जहां ridge रिग्रेशन गुणांकों के स्क्वेयर के योग (L2 पेनल्टी) को दंडित करता है, वहीं lasso उनके परिमाणों (absolute values) के योग (L1 पेनल्टी) को दंडित करता है। नतीजतन, λ के उच्च मानों पर, lasso में कई गुणांक ठीक-ठीक शून्य हो जाते हैं, जबकि ridge में ऐसा नहीं होता।
Ridge और lasso के लॉस फ़ंक्शंस में एकमात्र अंतर पेनल्टी टर्म में है। Lasso के तहत, लॉस इस प्रकार परिभाषित है:
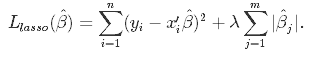
Lasso रिग्रेशन चलाने के लिए आप glmnet() फ़ंक्शन ही उपयोग कर सकते हैं, लेकिन alpha पैरामीटर 1 पर सेट करें।
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)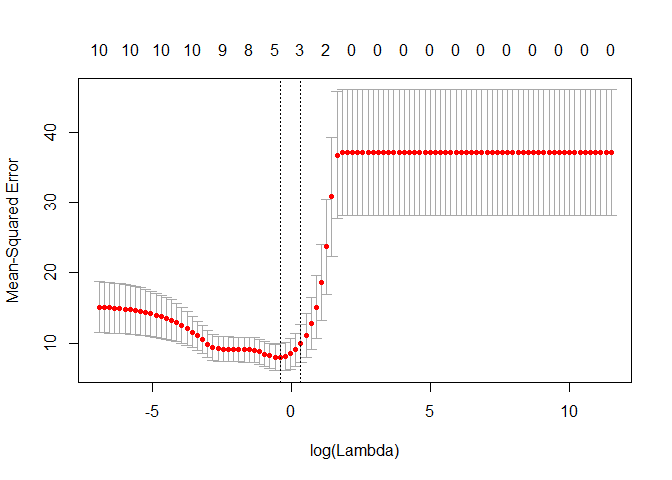
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)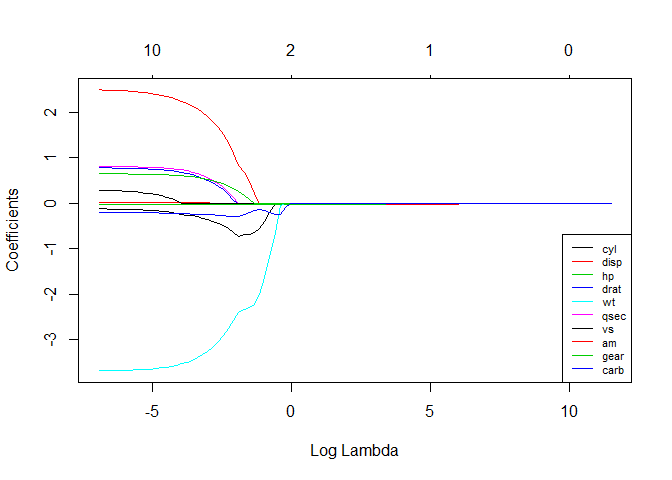
आइए उन विभिन्न मॉडलों के मल्टिपल R-squared की तुलना करें जो हमने अनुमानित किए हैं!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
इन डेटा पर इनका प्रदर्शन मिलता-जुलता है। याद रखें, हेटेरोस्केडास्टिक मॉडल ट्यून नहीं किया गया है, और lambda इष्टतम नहीं है! Ridge और lasso की तुलना पर कुछ और सामान्य विचार:
Elastic Net, lasso पर हुई आलोचना के परिणामस्वरूप सामने आया, जिसके अनुसार उसका वेरिएबल सेलेक्शन डेटा पर बहुत निर्भर और अस्थिर हो सकता है। समाधान है ridge और lasso दोनों की पेनल्टी को मिलाना, ताकि दोनों दुनियाओं के फायदे मिलें। Elastic Net निम्न लॉस फ़ंक्शन को न्यूनतम करने का लक्ष्य रखता है:
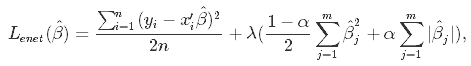
जहां α ridge (α = 0) और lasso (α = 1) के बीच मिक्सिंग पैरामीटर है।
अब, दो पैरामीटर ट्यून करने होते हैं: λ और α। glmnet पैकेज एक नियत α के लिए क्रॉस-वैलिडेशन द्वारा λ ट्यून करने देता है, लेकिन α ट्यूनिंग का समर्थन नहीं करता, इसलिए इसके लिए हम caret का सहारा लेंगे।
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2बधाई! यदि आप यहां तक पहुंच गए हैं, तो अब आप जानते हैं कि:
यदि आप R में रिग्रेशन के बारे में और सीखना चाहते हैं, तो DataCamp का Supervised Learning in R: Regression कोर्स करें। साथ ही हमारे Linear Regression in R और Logistic Regression in R ट्यूटोरियल भी देखें।
R कोर्स
कोर्स
कोर्स
कोर्स