Cursus
Introductie tot R
4 uur
3.1M
Voer de code van deze tutorial online uit en bewerk deze
Code uitvoerenWe behandelen zowel de wiskundige eigenschappen van de methoden als praktische R-voorbeelden, plus een paar extra tweaks en trucs. Zonder verder oponthoud: aan de slag!
We beginnen bij de basis: het eenvoudige lineaire regressiemodel, waarin je n waarnemingen van de responsvariabele, Y, wilt voorspellen met een lineaire combinatie van m voorspellers, X, en een normaal verdeelde foutterm met variantie σ2:
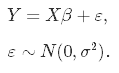
Omdat we de echte parameters, β, niet kennen, moeten we die schatten uit de steekproef. In de Ordinary Least Squares (OLS)-benadering schatten we ze als $\hat\beta$ zó dat de som van de kwadraten van de residuen zo klein mogelijk is. Met andere woorden, we minimaliseren de volgende verliesfunctie:
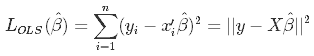
om zo de beruchte OLS-parameterschattingen te verkrijgen, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
In de statistiek zijn er twee cruciale eigenschappen van schatters om rekening mee te houden: de bias en de variantie. De bias is het verschil tussen de echte populatieparameter en de verwachtingswaarde van de schatter:
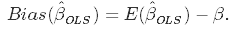
Dit meet de nauwkeurigheid van de schattingen. De variantie meet daarentegen de spreiding, of onzekerheid, in die schattingen. Die is gegeven door
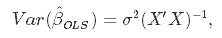
waarbij de onbekende foutvariantie σ2 uit de residuen kan worden geschat als
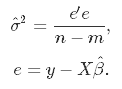
Deze afbeelding laat zien wat bias en variantie zijn. Stel je voor dat de roos de echte populatieparameter is die we schatten, β, en de schoten daarop de waarden van onze schattingen zijn die voortkomen uit vier verschillende schatters – lage bias en variantie, hoge bias en variantie, en de combinaties daarvan.
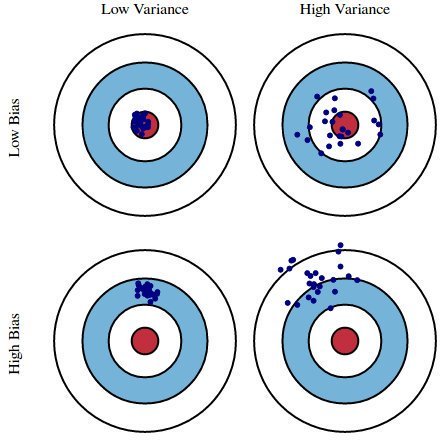
Bron: kdnuggets.com
Zowel de bias als de variantie wil je laag hebben, omdat grote waarden leiden tot slechte voorspellingen door het model. Het modellekfout kan namelijk worden opgesplitst in drie delen: fout door grote variantie, fout door aanzienlijke bias, en de rest – het onverklaarbare deel.
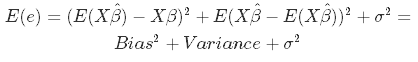
De OLS-schetter heeft de gewenste eigenschap ongewogen te zijn. Maar de variantie kan enorm zijn. Dit gebeurt met name wanneer:
De algemene oplossing is: verlaag de variantie ten koste van wat bias. Deze aanpak heet regularisatie en is bijna altijd gunstig voor de voorspellende prestaties van het model. Om dat te laten bezinken, kijken we naar de volgende grafiek.
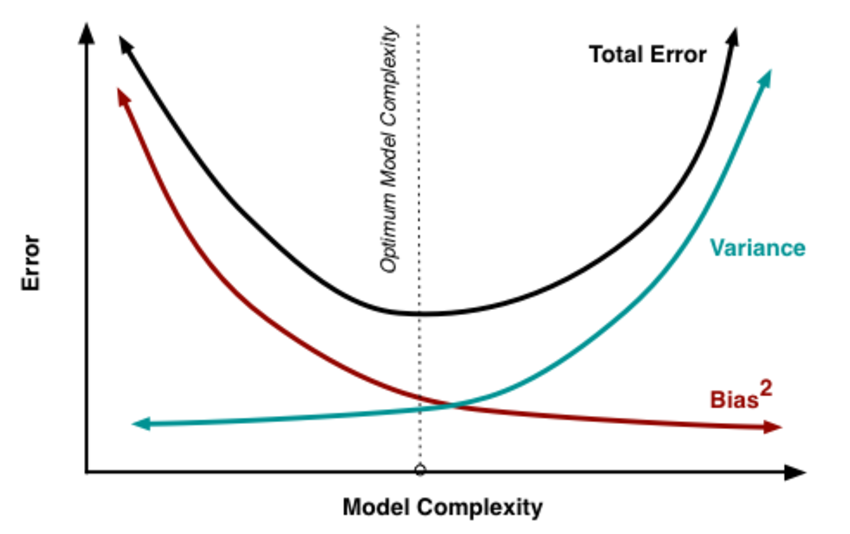
Bron: researchgate.net
Naarmate de modelcomplexiteit toeneemt – bij lineaire regressie kun je dat zien als het aantal voorspellers – neemt de variantie van de schattingen toe, maar de bias af. De ongewogen OLS plaatst ons aan de rechterkant van het plaatje, wat verre van optimaal is. Daarom regulariseren we: om de variantie te verlagen ten koste van wat bias, en zo naar links te bewegen richting het optimum.
Uit de bovenstaande bespreking concluderen we dat we de modelcomplexiteit willen verlagen, oftewel het aantal voorspellers. Je zou hiervoor forward of backward selectie kunnen gebruiken, maar dan kun je niets meer zeggen over het effect van de verwijderde variabelen op de respons. Voorspellers uit het model verwijderen kun je zien als hun coëfficiënten op nul zetten. In plaats van ze exact nul te forceren, gaan we ze bestraffen als ze te ver van nul afliggen, zodat we ze op een continue manier klein houden. Zo verlagen we de modelcomplexiteit, terwijl we alle variabelen in het model houden. Dit is in de kern wat Ridge-regressie doet.
Bij Ridge-regressie wordt de OLS-verliesfunctie uitgebreid zodat we niet alleen de som van gekwadrateerde residuen minimaliseren, maar ook de grootte van de parameterschattingen bestraffen, om ze naar nul toe te trekken:
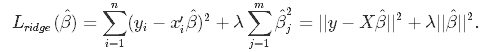
Dit oplossen voor $\hat\beta$ levert de ridge-regressieschattingen op: $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, waarbij I de identiteitsmatrix is.
De parameter λ is de regularisatiepenalty. Hoe je die kiest bespreken we in de volgende secties, maar let nu vast op dat:
Dus, λ op 0 zetten is hetzelfde als OLS gebruiken, terwijl een grotere waarde de coëfficiënten sterker bestraft op hun grootte.
Het opnemen van de regularisatiecoëfficiënt in de formules voor bias en variantie geeft ons
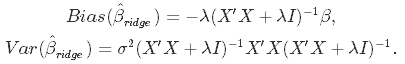
Daaruit zie je dat naarmate λ groter wordt, de variantie afneemt en de bias toeneemt. Dat roept de vraag op: hoeveel bias zijn we bereid te accepteren om de variantie te verlagen? Ofwel: wat is de optimale waarde voor λ?
Er zijn twee manieren om dit aan te pakken. Een meer traditionele benadering is λ zo te kiezen dat een informatiecriterium, bijvoorbeeld AIC of BIC, minimaal is. Een meer machine learning-achtige benadering is cross-validatie uit te voeren en de waarde van λ te kiezen die de cross-gevalideerde som van gekwadrateerde residuen (of een andere maat) minimaliseert. De eerste benadering legt de nadruk op de fit van het model op de data, terwijl de tweede meer gericht is op de voorspellende prestaties. We bespreken beide.
Informatiecriteria minimaliseren
Deze aanpak komt neer op het schatten van het model met veel verschillende waarden voor λ en het kiezen van de waarde die het Akaike- of Bayesiaanse Informatiecriterium minimaliseert:
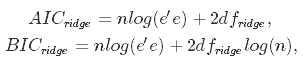
waarbij dfridge het aantal vrijheidsgraden is. Let op! Het aantal vrijheidsgraden bij ridge-regressie is anders dan bij gewone OLS! Dit wordt vaak over het hoofd gezien, wat leidt tot onjuiste inferentie. In zowel OLS als ridge-regressie is het aantal vrijheidsgraden gelijk aan de spoor (trace) van de zogeheten hat-matrix, een matrix die de vector met responswaarden afbeeldt op de vector met gefitte waarden: $\hat y = H y$.
Bij OLS vinden we HOLS = X(X′X)−1X, wat geeft dfOLS = trHOLS = m, waarbij m het aantal voorspellers is. Bij ridge-regressie hoort de regularisatiepenalty in de hat-matrixformule: Hridge = X(X′X + λI)−1X, wat geeft dfridge = trHridge, en dat is niet langer gelijk aan m. Sommige ridge-regressiesoftware geeft informatiecriteria op basis van de OLS-formule. Om zeker te zijn dat je het goed doet, is het veiliger om ze zelf te berekenen – wat we later in deze tutorial ook doen.
Cross-gevalideerde residuen minimaliseren
Om λ via cross-validatie te kiezen, neem je een set van P waarden van λ om te testen, splits je de dataset in K folds, en volg je dit algoritme:
Je hoeft dit natuurlijk niet zelf te programmeren – R heeft alle benodigde functies.
In R bevat het pakket glmnet alles wat je nodig hebt om ridge-regressie toe te passen. We gebruiken de beruchte mtcars-dataset als illustratie, waarbij de taak is om miles per gallon te voorspellen op basis van andere autokenmerken. Nog één ding: ridge-regressie gaat ervan uit dat de voorspellers gestandaardiseerd zijn en de respons is gecentreerd! Straks zie je waarom die aanname nodig is. Voor nu standaardiseren we vóór het modelleren.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)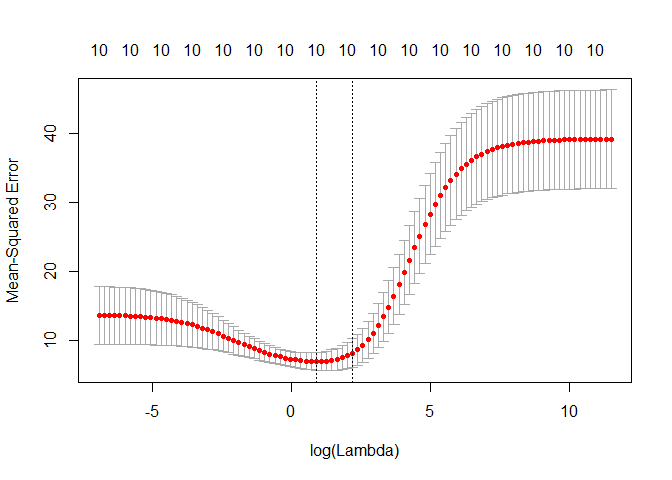
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))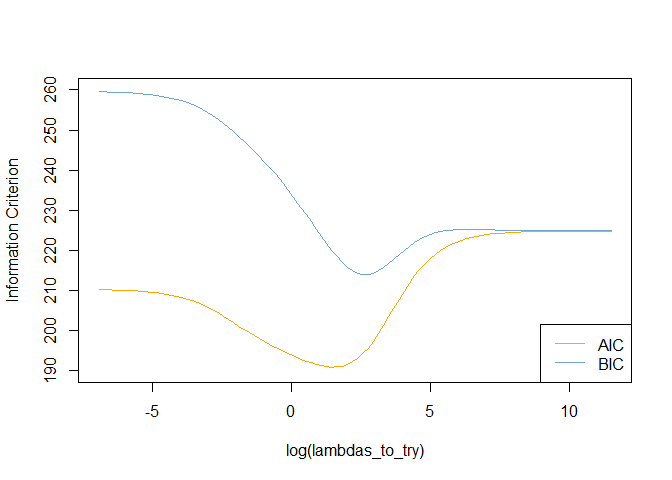
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)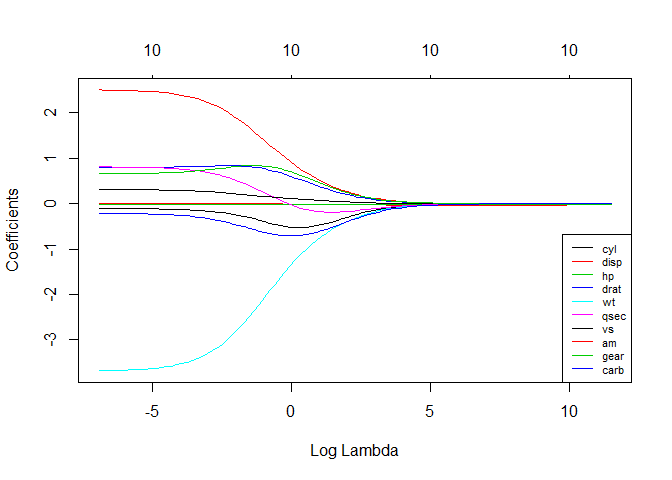
Ik noemde eerder dat ridge-regressie aanneemt dat de voorspellers zijn geschaald naar z-scores. Waarom is dit nodig? Deze schaling zorgt ervoor dat de penaltyterm elke coëfficiënt gelijk bestraft, zodat die de vorm aanneemt $\lambda \sum_{j=1}^m\hat\beta_j^2$. Als de voorspellers niet gestandaardiseerd zijn, zijn hun standaarddeviaties niet allemaal gelijk aan één, en met wat rekenwerk is te laten zien dat dit resulteert in een penaltyterm van de vorm $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. De ongestandaardiseerde coëfficiënten worden dan gewogen met het inverse van de standaarddeviatie van hun bijbehorende voorspeller. We schalen de X-matrix om dit te vermijden, maar... In plaats van dit heteroskedasticiteitsprobleem op te lossen door de varianties van alle voorspellers te gelijktrekken via schaling, zouden we ze net zo goed als gewichten in het schattingsproces kunnen gebruiken! Dit is het idee achter de Differentieel-gewogen of Heteroskedastische Ridge-regressie.
Het idee is om verschillende coëfficiënten met verschillende sterkte te bestraffen door gewichten in de verliesfunctie te introduceren:
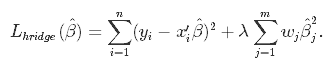
Hoe kies je de gewichten wj? Voer voor alle voorspellers een reeks univariate regressies uit (respons vs. één voorspeller), haal de schatting van de variantie van de coëfficiënt, $\hat\sigma_{j}$, op en gebruik die als gewicht! Zo geldt:
Zo doe je dit in R. Omdat deze methode niet in glmnet zit, is er wat programmeerwerk nodig.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, of Least Absolute Shrinkage and Selection Operator, lijkt conceptueel sterk op ridge-regressie. Het voegt ook een penalty toe voor niet-nulcoëfficiënten, maar in tegenstelling tot ridge – dat de som van gekwadrateerde coëfficiënten bestraft (de zogeheten L2-penalty) – bestraft lasso de som van de absolute waarden (L1-penalty). Het gevolg is dat bij hoge waarden van λ veel coëfficiënten onder lasso exact op nul uitkomen, wat bij ridge niet gebeurt.
Het enige verschil tussen de verliesfuncties van ridge en lasso zit in de penaltytermen. Onder lasso is het verlies gedefinieerd als:
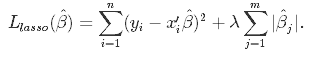
Voor Lasso-regressie kun je de functie glmnet() hergebruiken, maar dan met de parameter alpha op 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)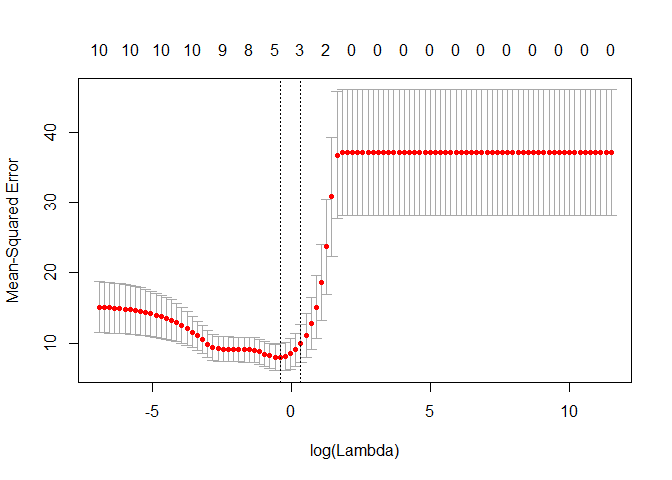
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)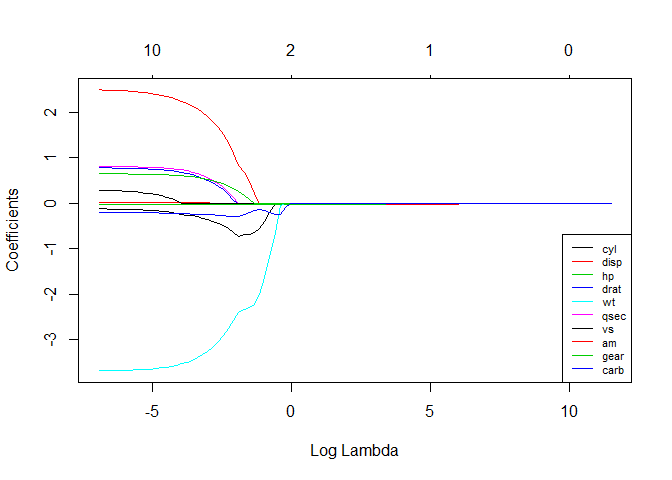
Laten we de multiple R-squared vergelijken van de verschillende modellen die we hebben geschat!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Ze lijken voor deze data vergelijkbaar te presteren. Denk eraan dat het heteroskedastische model niet getuned is, en de lambda dus niet optimaal! Enkele meer algemene overwegingen over hoe ridge en lasso zich verhouden:
Elastic Net ontstond als kritiek op lasso, waarvan de variabelenselectie te afhankelijk van de data en dus instabiel kan zijn. De oplossing is de penalties van ridge en lasso te combineren om het beste van beide werelden te krijgen. Elastic Net minimaliseert de volgende verliesfunctie:
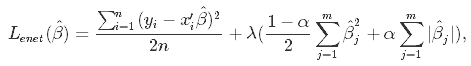
waarbij α de mengparameter is tussen ridge (α = 0) en lasso (α = 1).
Er zijn nu twee parameters om te tunen: λ en α. Het pakket glmnet kan λ via cross-validatie tunen voor een vaste α, maar ondersteunt geen α-tuning, dus schakelen we hiervoor over op caret.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Gefeliciteerd! Als je tot hier bent gekomen, weet je nu dat:
Wil je meer leren over regressie in R? Volg dan de DataCamp-cursus Supervised Learning in R: Regression. Bekijk ook onze tutorials Lineaire regressie in R en Logistische regressie in R.
R-cursussen
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

