
Last chance! 50% off DataCamp Premium
Sale ends in
Bu eğitimdeki kodu çevrimiçi olarak çalıştırın ve düzenleyin
Kodu çalıştırBu yazıda yöntemlerin matematiksel özelliklerinin yanı sıra pratik R örneklerini ve bazı ekstra püf noktalarını ele alacağız. Lafı uzatmadan başlayalım!
Temelden başlayalım: basit doğrusal regresyon modeli. Burada amaç, Y yanıt değişkeninin n gözlemini, m adet yordayıcı değişkenin, X, doğrusal bir kombinasyonu ve varyansı σ2 olan normal dağılmış bir hata terimi ile tahmin etmektir:
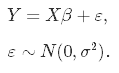
Gerçek parametreleri, β, bilmediğimiz için örneklemden tahmin etmek zorundayız. En Küçük Kareler (OLS) yaklaşımında, artıkların kareleri toplamı mümkün olduğunca küçük olacak şekilde $\hat\beta$ ile tahmin ederiz. Başka bir deyişle, aşağıdaki kayıp fonksiyonunu en aza indiririz:
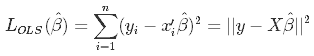
ve böylece meşhur OLS parametre tahminlerini elde ederiz: $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
İstatistikte tahmin edicilerin iki kritik özelliği vardır: önyargı (bias) ve varyans. Önyargı, gerçek anakütle parametresi ile beklenen tahmin edici arasındaki farktır:
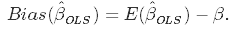
Bu, tahminlerin doğruluğunu ölçer. Varyans ise bu tahminlerdeki yayılımı veya belirsizliği ölçer. Şöyle verilir:
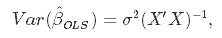
Burada bilinmeyen hata varyansı σ2, artıklar üzerinden aşağıdaki gibi tahmin edilebilir:
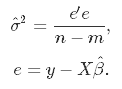
Bu görsel, önyargı ve varyansın ne olduğunu gösterir. Hedef tahtasının tam ortası, tahmin etmeye çalıştığımız gerçek anakütle parametresi β olsun; hedefe yapılan atışlar ise dört farklı tahmin ediciden gelen tahminlerimiz olsun — düşük önyargı ve varyans, yüksek önyargı ve varyans ve bunların kombinasyonları.
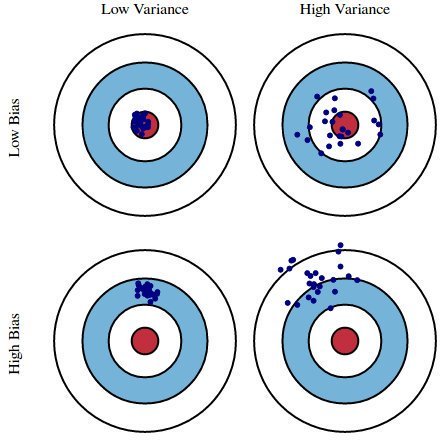
Kaynak: kdnuggets.com
Hem önyargının hem varyansın düşük olması istenir; büyük değerler modelden zayıf tahminlere yol açar. Aslında model hatası üç parçaya ayrılabilir: büyük varyanstan kaynaklanan hata, belirgin önyargıdan kaynaklanan hata ve geriye kalan — açıklanamaz kısım.
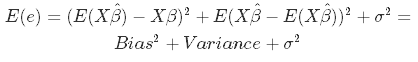
OLS tahmin edicisi önyargısız olma gibi arzu edilen bir özelliğe sahiptir. Ancak, varyansı çok büyük olabilir. Özellikle şu durumlarda:
Genel çözüm şudur: bir miktar önyargı ekleme pahasına varyansı azaltmak. Bu yaklaşım düzenlileştirme (regularization) olarak adlandırılır ve modelin öngörü performansı için neredeyse her zaman faydalıdır. Bunu pekiştirmek için aşağıdaki grafiğe bakalım.
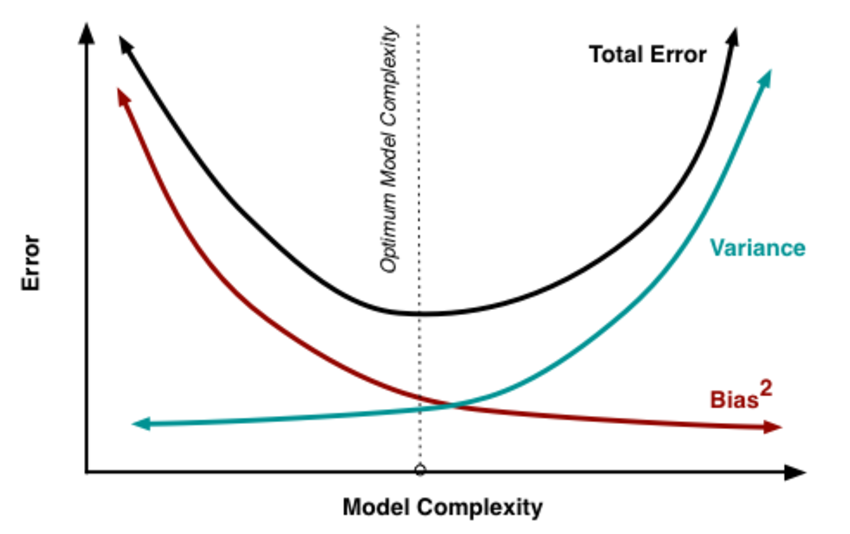
Kaynak: researchgate.net
Model karmaşıklığı —doğrusal regresyon özelinde yordayıcı sayısı olarak düşünebilirsiniz— arttıkça tahminlerin varyansı artar, ancak önyargı azalır. Önyargısız OLS bizi resmin sağ tarafına yerleştirir ki bu, optimumdan uzaktır. Bu yüzden düzenlileştiririz: biraz önyargı pahasına varyansı düşürmek ve grafikte sola, optimuma doğru ilerlemek için.
Buraya kadar olan tartışmadan, model karmaşıklığını, yani yordayıcı sayısını azaltmak istediğimiz sonucuna vardık. Bunu ileriye ya da geriye doğru değişken seçimiyle yapabiliriz, ancak o zaman modelden çıkarılan değişkenlerin yanıt üzerindeki etkileri hakkında bir şey söyleyemeyiz. Modelden yordayıcıları çıkarmak, katsayılarını sıfıra ayarlamak olarak görülebilir. Onları tam olarak sıfıra zorlamak yerine, sıfırdan çok uzaklarsa cezalandıralım; böylece katsayıları sürekli bir şekilde küçük tutalım. Bu yolla tüm değişkenleri modelde tutarken model karmaşıklığını azaltırız. Temelde Ridge Regresyonu bunu yapar.
Ridge Regresyonu'nda OLS kayıp fonksiyonu, artıkların kareleri toplamını en aza indirmenin yanı sıra parametre tahminlerinin büyüklüğünü de cezalandıracak şekilde genişletilir; böylece onları sıfıra doğru küçültürüz:
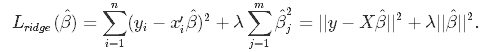
Bunu $\hat\beta$ için çözdüğümüzde ridge regresyonu tahminlerini elde ederiz: $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$; burada I birim (kimlik) matristir.
λ parametresi düzenlileştirme cezasıdır. Bunu nasıl seçeceğimizi bu eğitimin ilerleyen bölümlerinde konuşacağız; şimdilik şunu not edin:
Dolayısıyla λ'yı 0 yapmak OLS kullanmakla aynıdır; değeri büyüdükçe katsayıların büyüklüğüne uygulanan ceza da güçlenir.
Düzenlileştirme katsayısını önyargı ve varyans formüllerine dahil ettiğimizde şunu elde ederiz:
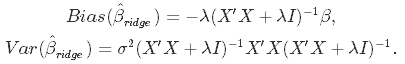
Buradan görebilirsiniz ki λ büyüdükçe varyans azalır, önyargı artar. Şu soruyu gündeme getirir: Varyansı azaltmak için ne kadar önyargıyı kabul etmeye razıyız? Ya da: λ için en uygun değer nedir?
Bu meseleyi iki şekilde ele alabiliriz. Daha geleneksel yaklaşım, AIC veya BIC gibi bir bilgi ölçütünü en küçük yapacak λ değerini seçmektir. Daha makine öğrenmesi odaklı yaklaşım ise çapraz doğrulama yapıp, çapraz doğrulamalı artık kareler toplamını (veya başka bir ölçütü) en aza indiren λ değerini seçmektir. İlki modelin veriye uyumunu vurgularken, ikincisi öngörü performansına odaklanır. İkisini de tartışalım.
Bilgi Ölçütlerini En Küçükleme
Bu yaklaşım, modeli birçok farklı λ değeriyle tahmin etmeye ve Akaike ya da Bayesyen Bilgi Ölçütünü en aza indireni seçmeye dayanır:
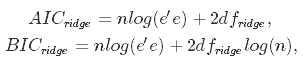
Burada dfridge, serbestlik derecesi sayısıdır. Dikkat! Ridge regresyonunda serbestlik dereceleri, sıradan OLS'dekinden farklıdır! Bu nokta sıkça gözden kaçar ve hatalı çıkarımlara yol açar. Hem OLS hem de ridge regresyonunda serbestlik dereceleri, yanıt vektörünü uyumlu değerler vektörüne eşleyen ve $\hat y = H y$ şeklinde yazılan sözde şapka matrisinin izine (trace) eşittir.
OLS'de HOLS = X(X′X)−1X olup dfOLS = trHOLS = m verir; burada m, yordayıcı sayısıdır. Oysa ridge regresyonunda şapka matrisi düzenlileştirme cezasını içermelidir: Hridge = X(X′X + λI)−1X ve bu da dfridge = trHridge sonucunu verir; artık m'e eşit değildir. Bazı ridge yazılımları bilgi ölçütlerini OLS formülüne göre üretir. Doğru yaptığınızdan emin olmak için bunları elle hesaplamak daha güvenlidir; bu eğitimin ilerleyen kısmında bunu yapacağız.
Çapraz Doğrulamalı Artıkları En Küçükleme
λ'yı çapraz doğrulama ile seçmek için, test edilecek P adet λ değeri belirleyin, veri kümesini K katmana bölün ve şu algoritmayı izleyin:
Elbette bunu kendiniz kodlamanıza gerek yok — R, bu iş için gerekli fonksiyonlara sahip.
R'de glmnet paketi, ridge regresyonunu uygulamak için gereken her şeyi içerir. Örnek olarak meşhur mtcars veri setini kullanacağız; görev, araçların diğer özelliklerine göre mil/galon değerini tahmin etmektir. Bir not daha: ridge regresyonu, yordayıcıların standardize edildiğini ve yanıtın merkezlendiğini varsayar! Bu varsayımın neden gerekli olduğunu birazdan göreceksiniz. Şimdilik modellemeden önce standardizasyon yapacağız.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)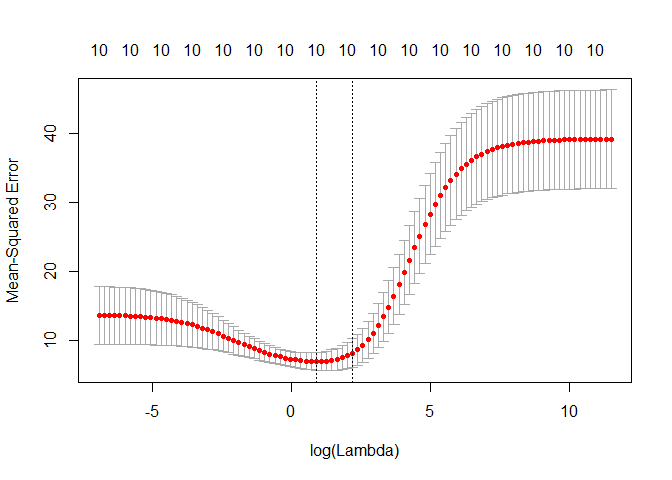
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))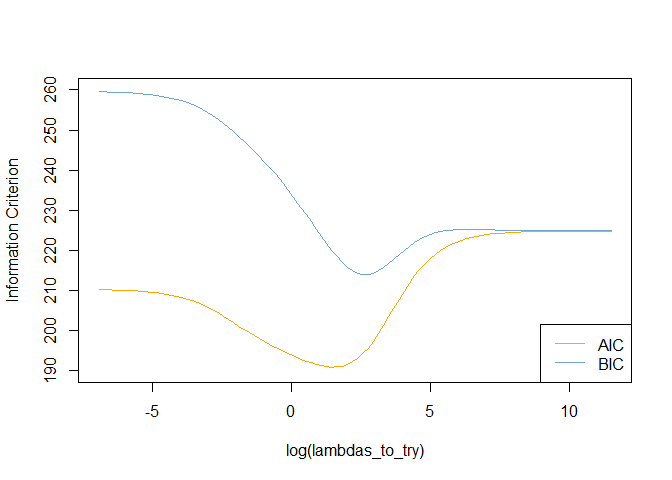
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)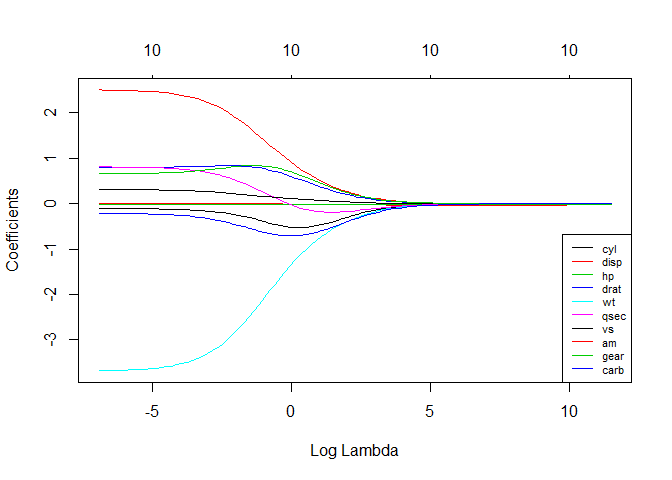
Ridge regresyonunun, yordayıcıların z-puanlarına ölçeklendirildiğini varsaydığını daha önce belirtmiştim. Neden gerekli? Bu ölçekleme, ceza teriminin her katsayıyı eşit şekilde cezalandırmasını sağlar; böylece biçimi $\lambda \sum_{j=1}^m\hat\beta_j^2$ olur. Yordayıcılar standardize edilmemişse, standart sapmaları bire eşit değildir ve biraz matematikle bunun $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$ biçiminde bir ceza terimiyle sonuçlandığı gösterilebilir. Yani standardize edilmemiş katsayılar, karşılık geldikleri yordayıcıların standart sapmalarının tersiyle ağırlıklandırılır. Bunu önlemek için X matrisini ölçeklendiririz ama… Tüm yordayıcıların varyanslarını ölçekleme ile eşitleyerek bu heteroskedastisite sorununu çözmek yerine, bunları doğrudan tahminde ağırlık olarak da kullanabiliriz! Farklı Ağırlıklandırılmış ya da Heteroskedastik Ridge Regresyonu fikri budur.
Fikir, kayıp fonksiyonuna ağırlıklar ekleyerek farklı katsayıları farklı şiddetlerde cezalandırmaktır:
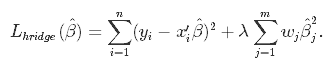
Ağırlıklar wj nasıl seçilir? Tüm yordayıcılar için bir dizi tek değişkenli regresyon (yanıt vs. tek bir yordayıcı) çalıştırın, katsayı varyansı tahminini, $\hat\sigma_{j}$, çıkarın ve bunu ağırlık olarak kullanın! Böylece:
Bunu R'de nasıl yapacağınız burada. Bu yöntem glmnet içinde uygulanmadığı için biraz programlama gerekecek.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.R
Lasso (Least Absolute Shrinkage and Selection Operator), kavramsal olarak ridge regresyona oldukça benzer. O da sıfır olmayan katsayılar için bir ceza ekler; ancak ridge, katsayıların kareleri toplamını (L2 cezası) cezalandırırken, lasso katsayıların mutlak değerleri toplamını (L1 cezası) cezalandırır. Sonuç olarak, λ yüksek olduğunda, lasso altında birçok katsayı tam olarak sıfırlanır; ridge regresyonda bu asla olmaz.
Ridge ve lasso kayıp fonksiyonları arasındaki tek fark ceza terimlerindedir. Lasso altında kayıp şöyle tanımlanır:
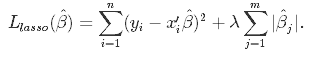
Lasso Regresyonu çalıştırmak için yine glmnet() fonksiyonunu kullanabilirsiniz, ancak alpha parametresini 1 olarak ayarlayın.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)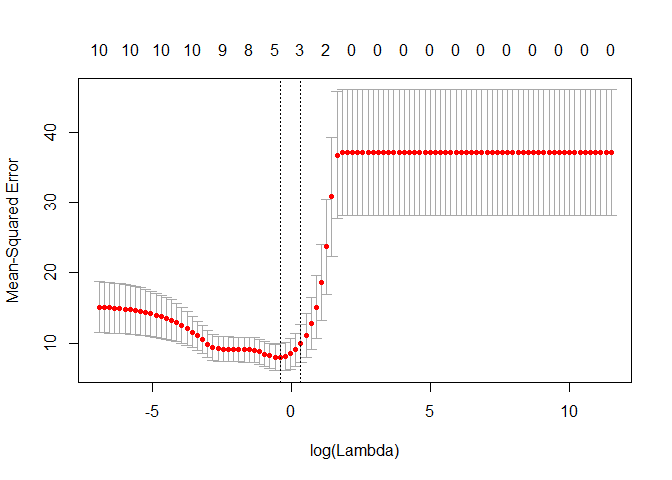
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)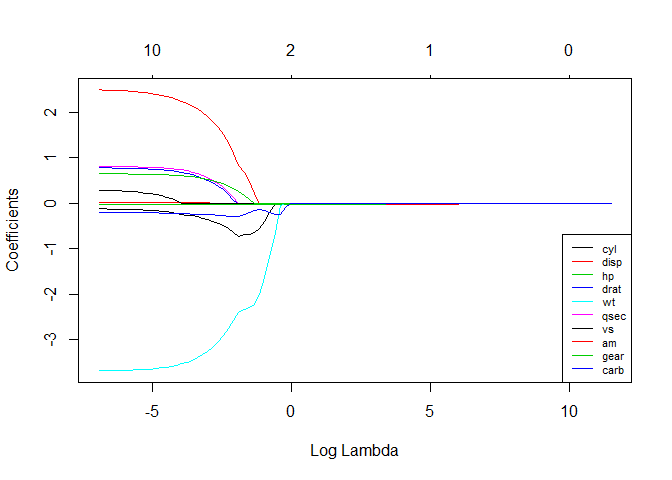
Tahmin ettiğimiz çeşitli modellerin çoklu R-kare değerlerini karşılaştıralım!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Bu veriler için benzer performans sergiliyorlar gibi görünüyor. Unutmayın, heteroskedastik model ayarlanmamıştır ve lambda optimal değildir! Ridge ve lasso karşılaştırmasına ilişkin bazı genel değerlendirmeler:
Elastic Net, lassoya yönelik, değişken seçiminin veriye aşırı bağımlı ve dolayısıyla istikrarsız olabileceği eleştirileri sonucunda ortaya çıkmıştır. Çözüm, ridge ve lasso cezalarını birleştirerek iki dünyanın en iyisini elde etmektir. Elastic Net, aşağıdaki kayıp fonksiyonunu en aza indirmeyi amaçlar:
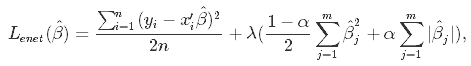
Burada α, ridge (α = 0) ile lasso (α = 1) arasındaki karışım parametresidir.
Artık ayarlanacak iki parametre var: λ ve α. glmnet paketi, sabit bir α için çapraz doğrulama ile λ'yı ayarlamaya izin verir; ancak α ayarlamasını desteklemez, bu yüzden bu iş için caret'e yöneleceğiz.
library(caret)

# Set training control
trainControl <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = trainControl)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Tebrikler! Buraya kadar geldiyseniz artık şunları biliyorsunuz:
R'de regresyon hakkında daha fazla bilgi edinmek isterseniz DataCamp'in Supervised Learning in R: Regression kursunu alın. Ayrıca R'de Doğrusal Regresyon ve R'de Lojistik Regresyon eğitimlerimize de göz atın.
R Kursları
Kurs
Kurs
Kurs
blog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Adel Nehme
Eğitim
Kurtis Pykes
8 dk.




