Corso
Introduzione a R
4 ore
3.1M
Esegui e modifica il codice da questo tutorial online
Esegui codiceCoprirermo sia le proprietà matematiche dei metodi sia esempi pratici in R, con qualche dritta extra. Bando alle ciance, iniziamo!
Partiamo dalle basi: il modello di regressione lineare semplice, in cui vuoi prevedere n osservazioni della variabile risposta, Y, con una combinazione lineare di m variabili predittive, X, e un termine d’errore normalmente distribuito con varianza σ2:
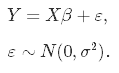
Poiché non conosciamo i veri parametri, β, dobbiamo stimarli dal campione. Nell’approccio dei minimi quadrati ordinari (OLS), li stimiamo come $\hat\beta$ in modo che la somma dei quadrati dei residui sia la più piccola possibile. In altre parole, minimizziamo la seguente funzione di perdita:
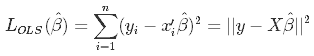
per ottenere le famigerate stime dei parametri OLS, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
In statistica, ci sono due caratteristiche cruciali degli stimatori da considerare: il bias e la varianza. Il bias è la differenza tra il vero parametro di popolazione e il valore atteso dello stimatore:
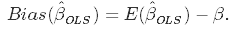
Misura l’accuratezza delle stime. La varianza, invece, misura la dispersione, o incertezza, di queste stime. È data da
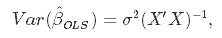
dove l’incognita varianza dell’errore σ2 può essere stimata dai residui come
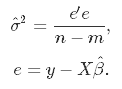
Questa grafica illustra cosa sono bias e varianza. Immagina che il bersaglio sia il vero parametro di popolazione che stiamo stimando, β, e i colpi i valori delle nostre stime risultanti da quattro stimatori diversi: bias e varianza bassi, bias e varianza alti, e le loro combinazioni.
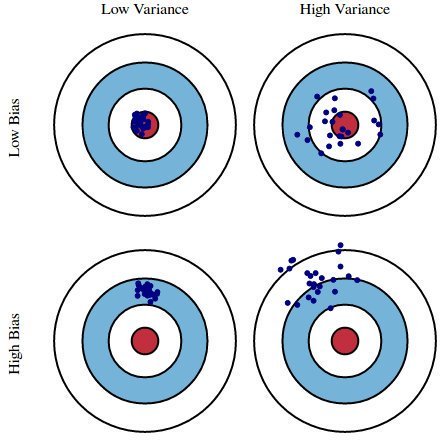
Fonte: kdnuggets.com
Sia il bias che la varianza devono essere bassi, perché valori elevati portano a previsioni scadenti del modello. Di fatto, l’errore del modello può essere scomposto in tre parti: errore dovuto a varianza elevata, errore dovuto a bias significativo e il resto, la parte non spiegabile.
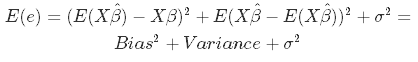
Lo stimatore OLS ha la proprietà desiderabile di essere non distorto (unbiased). Tuttavia, può avere una varianza enorme. In particolare, ciò accade quando:
La soluzione generale è: ridurre la varianza al costo di introdurre un po’ di bias. Questo approccio si chiama regolarizzazione ed è quasi sempre vantaggioso per le prestazioni predittive del modello. Per fissare l’idea, guarda il seguente grafico.
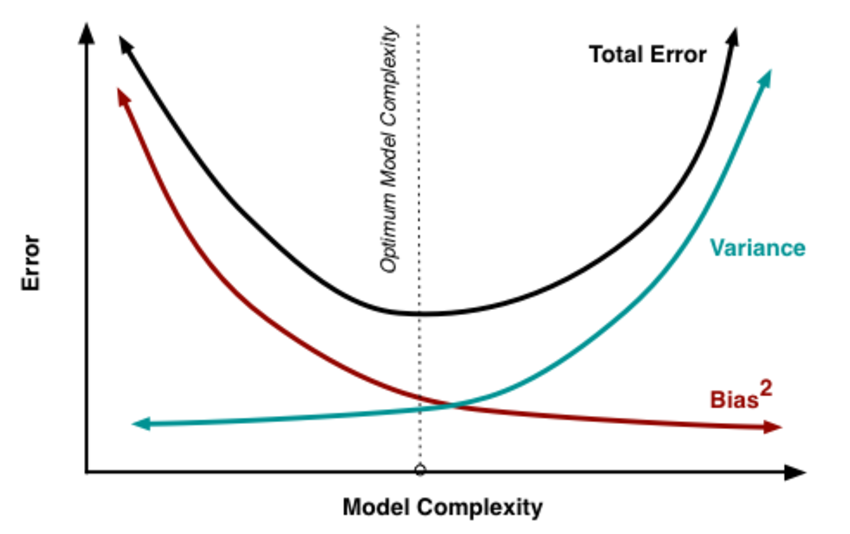
Fonte: researchgate.net
All’aumentare della complessità del modello, che nel caso della regressione lineare può essere vista come il numero di predittori, aumenta anche la varianza delle stime, mentre il bias diminuisce. L’OLS non distorto ci collocherebbe sul lato destro dell’immagine, lontano dall’ottimo. Ecco perché regolarizziamo: per abbassare la varianza al costo di un po’ di bias, spostandoci a sinistra nel grafico verso l’ottimo.
Da quanto discusso finora abbiamo concluso che vogliamo ridurre la complessità del modello, cioè il numero di predittori. Potremmo usare la selezione forward o backward, ma così non potremmo dire nulla sull’effetto sul response delle variabili rimosse. Rimuovere predittori dal modello può essere visto come impostare i loro coefficienti a zero. Invece di forzarli a essere esattamente zero, penalizziamoli se sono troppo lontani da zero, imponendoli a essere piccoli in modo continuo. In questo modo, riduciamo la complessità mantenendo tutte le variabili nel modello. Questo, in sostanza, è ciò che fa la Ridge Regression.
Nella Ridge Regression, la funzione di perdita OLS è ampliata in modo da minimizzare non solo la somma dei residui al quadrato ma anche penalizzare l’ampiezza delle stime dei parametri, per restringerle verso zero:
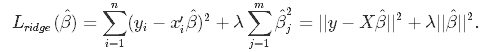
Risolvendo per $\hat\beta$ si ottengono le stime di ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, dove I denota la matrice identità.
Il parametro λ è la penalizzazione di regolarizzazione. Vedremo come sceglierlo nelle prossime sezioni del tutorial, ma per ora nota che:
Dunque, impostare λ a 0 equivale a usare OLS, mentre più è grande il suo valore, più è forte la penalizzazione sulla grandezza dei coefficienti.
Inserendo il coefficiente di regolarizzazione nelle formule per bias e varianza otteniamo
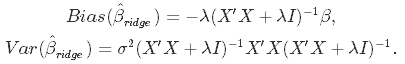
Da qui si vede che all’aumentare di λ, la varianza diminuisce e il bias aumenta. Questo pone la domanda: quanto bias siamo disposti ad accettare per ridurre la varianza? Ovvero: qual è il valore ottimale di λ?
Possiamo affrontare la questione in due modi. Un approccio più tradizionale è scegliere λ in modo che qualche criterio informativo, ad esempio AIC o BIC, sia il più piccolo. Un approccio più “da machine learning” è eseguire la cross-validation e selezionare il valore di λ che minimizza la somma dei residui al quadrato convalidata incrociata (o un’altra metrica). Il primo approccio enfatizza l’aderenza del modello ai dati, il secondo è più focalizzato sulle prestazioni predittive. Vediamoli entrambi.
Minimizzare i criteri informativi
Questo approccio si riduce a stimare il modello per molti diversi valori di λ e scegliere quello che minimizza l’Akaike o il Bayesian Information Criterion:
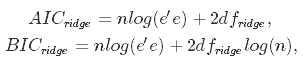
dove dfridge è il numero di gradi di libertà. Attenzione qui! Il numero di gradi di libertà nella ridge regression è diverso rispetto alla OLS classica! Questo è spesso trascurato e porta a inferenze scorrette. Sia in OLS che in ridge, i gradi di libertà sono pari alla traccia della cosiddetta hat matrix, che mappa il vettore dei valori di risposta al vettore dei valori stimati come segue: $\hat y = H y$.
In OLS, troviamo HOLS = X(X′X)−1X, che dà dfOLS = trHOLS = m, dove m è il numero di predittori. Nella ridge regression, però, la formula per la hat matrix include la penalizzazione: Hridge = X(X′X + λI)−1X, che dà dfridge = trHridge, non più uguale a m. Alcuni software per la ridge producono criteri informativi basati sulla formula OLS. Per essere sicuro di fare le cose correttamente, è più sicuro calcolarli manualmente, come faremo più avanti nel tutorial.
Minimizzare i residui in cross-validation
Per scegliere λ tramite cross-validation, dovresti selezionare un insieme di P valori di λ da testare, suddividere il dataset in K fold e seguire questo algoritmo:
Ovviamente, non c’è bisogno di programmarlo da zero: R ha tutte le funzioni dedicate.
In R, il pacchetto glmnet contiene tutto ciò che serve per implementare la ridge regression. Useremo il famigerato dataset mtcars come illustrazione, con l’obiettivo di prevedere i miles per gallon in base alle altre caratteristiche dell’auto. Un’ultima cosa: la ridge regression assume che i predittori siano standardizzati e la risposta centrata! Vedrai tra poco perché serve questa assunzione. Per ora, standardizziamo prima di modellare.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)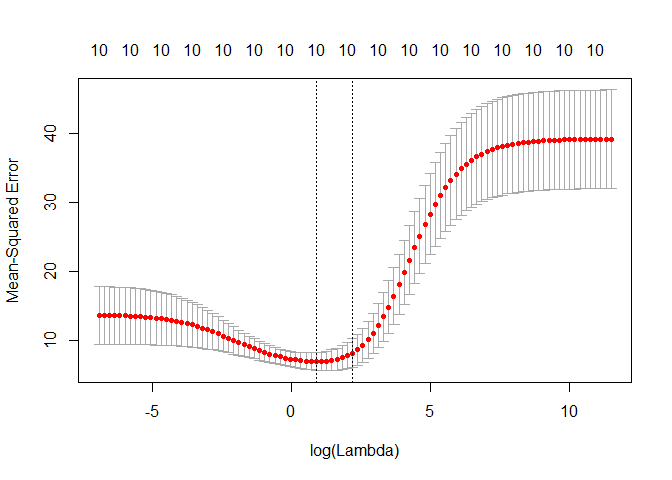
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))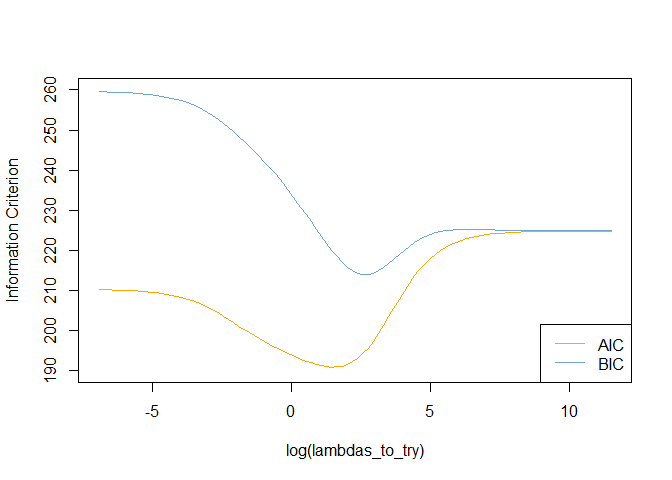
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)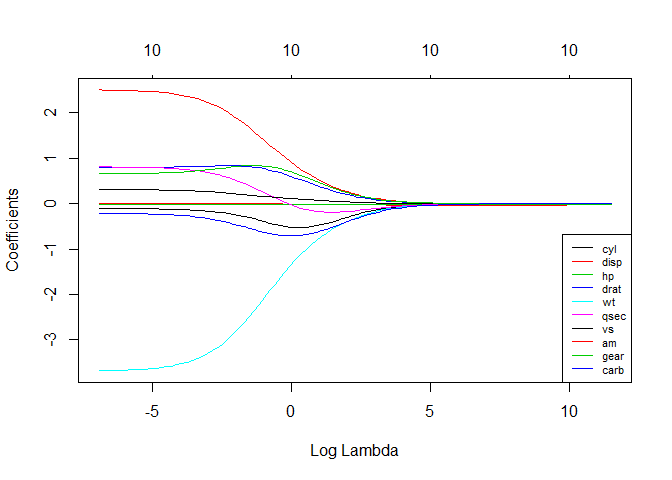
Ho accennato prima che la ridge regression assume i predittori scalati a z-score. Perché è necessario? Questo scaling garantisce che il termine di penalizzazione punisca ogni coefficiente in egual misura, così da avere la forma $\lambda \sum_{j=1}^m\hat\beta_j^2$. Se i predittori non sono standardizzati, le loro deviazioni standard non sono tutte uguali a uno, e si può mostrare con un po’ di matematica che ciò porta a un termine di penalizzazione della forma $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Quindi, i coefficienti non standardizzati sono pesati dall’inverso della deviazione standard dei rispettivi predittori. Scaliamo la matrice X per evitarlo, ma... Invece di risolvere questo problema di eteroschedasticità eguagliando le varianze di tutti i predittori tramite scaling, potremmo benissimo usarle come pesi nel processo di stima! Questa è l’idea alla base della Ridge Regression a pesi differenziali o eteroschedastica.
L’idea è penalizzare coefficienti diversi con intensità diversa introducendo pesi nella funzione di perdita:
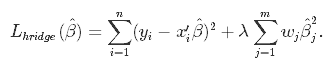
Come scegliere i pesi wj? Esegui un insieme di regressioni univariate (risposta vs. uno dei predittori) per tutti i predittori, estrai la stima della varianza del coefficiente, $\hat\sigma_{j}$, e usala come peso! In questo modo:
Ecco come farlo in R. Poiché questo metodo non è implementato in glmnet, servirà un po’ di programmazione.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RIl Lasso, o Least Absolute Shrinkage and Selection Operator, è concettualmente simile alla ridge. Aggiunge anch’esso una penalizzazione per i coefficienti non nulli, ma a differenza della ridge che penalizza la somma dei quadrati dei coefficienti (la cosiddetta penalizzazione L2), il lasso penalizza la somma dei loro valori assoluti (penalizzazione L1). Di conseguenza, per valori alti di λ, molti coefficienti vengono azzerati esattamente con il lasso, cosa che non avviene nella ridge.
L’unica differenza tra le funzioni di perdita di ridge e lasso è nei termini di penalizzazione. Nel lasso, la perdita è definita come:
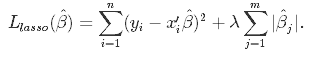
Per eseguire la Lasso Regression puoi riutilizzare la funzione glmnet(), ma con il parametro alpha impostato a 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)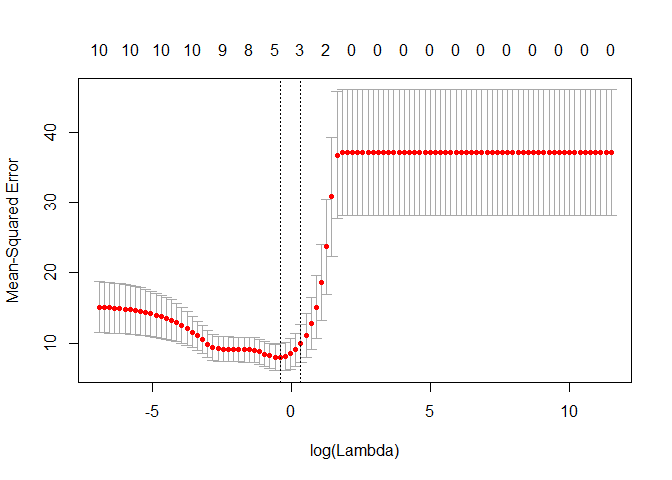
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)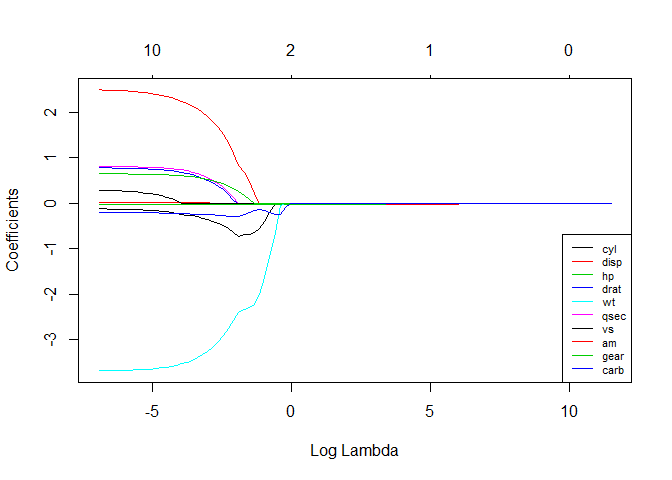
Confrontiamo il multiple R-squared dei vari modelli che abbiamo stimato!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Sembra che si comportino in modo simile su questi dati. Ricorda che il modello eteroschedastico non è ottimizzato e la lambda non è ottimale! Alcune considerazioni più generali sul confronto tra ridge e lasso:
L’Elastic Net è nato come critica al lasso, la cui selezione delle variabili può essere troppo dipendente dai dati e quindi instabile. La soluzione è combinare le penalizzazioni di ridge e lasso per ottenere il meglio di entrambi i mondi. Elastic Net mira a minimizzare la seguente funzione di perdita:
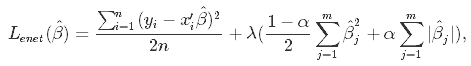
dove α è il parametro di mescolanza tra ridge (α = 0) e lasso (α = 1).
Ora ci sono due parametri da ottimizzare: λ e α. Il pacchetto glmnet permette di ottimizzare λ via cross-validation per un α fissato, ma non supporta l’ottimizzazione di α, quindi useremo caret per questo compito.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Complimenti! Se sei arrivato fin qui, sai già che:
Se vuoi approfondire la regressione in R, segui il corso di DataCamp Supervised Learning in R: Regression. Dai un’occhiata anche ai nostri tutorial su Linear Regression in R e Logistic Regression in R.
Corsi R
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min
blog
Abid Ali Awan
15 min



