
Last chance! 50% off DataCamp Premium
Sale ends in
Jalankan dan edit kode dari Tutorial ini secara online
Jalankan kodeKita akan membahas sifat matematis dari metode-metode ini sekaligus contoh praktis di R, ditambah beberapa penyesuaian dan trik. Tanpa berlama-lama, mari kita mulai!
Mari mulai dari dasar: model regresi linear sederhana, di mana Anda bertujuan memprediksi n observasi dari variabel respons, Y, dengan kombinasi linear dari m variabel prediktor, X, dan komponen galat yang berdistribusi normal dengan varians σ2:
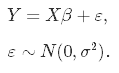
Karena kita tidak mengetahui parameter sebenarnya, β, kita harus mengestimasikannya dari sampel. Dalam pendekatan Ordinary Least Squares (OLS), kita mengestimasi sebagai $\hat\beta$ sedemikian rupa sehingga jumlah kuadrat residu sekecil mungkin. Dengan kata lain, kita meminimalkan fungsi loss berikut:
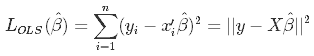
untuk memperoleh estimasi parameter OLS yang terkenal, $\hat\beta_{OLS} = (X'X)^{-1}(X'Y)$.
Dalam statistik, ada dua karakteristik penting dari penaksir yang perlu diperhatikan: bias dan varians. Bias adalah selisih antara parameter populasi sebenarnya dan nilai harapan dari penaksir:
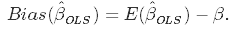
Bias mengukur ketepatan estimasi. Varians, di sisi lain, mengukur penyebaran atau ketidakpastian dalam estimasi tersebut. Dinyatakan sebagai
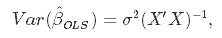
di mana varians galat yang tidak diketahui σ2 dapat diestimasi dari residu sebagai
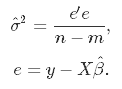
Grafik ini mengilustrasikan apa itu bias dan varians. Bayangkan titik pusat pada papan panah adalah parameter populasi sebenarnya yang kita estimasi, β, dan tembakan ke arahnya adalah nilai estimasi kita yang dihasilkan dari empat penaksir berbeda—bias dan varians rendah, bias dan varians tinggi, serta kombinasinya.
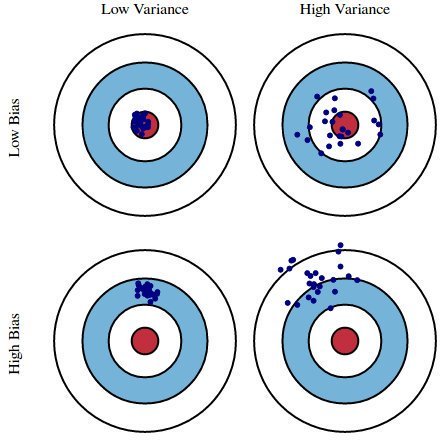
Sumber: kdnuggets.com
Baik bias maupun varians diharapkan rendah, karena nilai yang besar menghasilkan prediksi model yang buruk. Faktanya, galat model dapat diuraikan menjadi tiga bagian: galat akibat varians yang besar, galat akibat bias yang signifikan, dan sisanya—bagian yang tidak dapat dijelaskan.
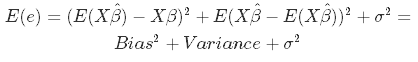
Penaksir OLS memiliki sifat yang diinginkan yaitu tidak bias. Namun, variansnya bisa sangat besar. Secara khusus, ini terjadi ketika:
Solusi umumnya adalah: mengurangi varians dengan mengorbankan memasukkan sedikit bias. Pendekatan ini disebut regularisasi dan hampir selalu bermanfaat bagi kinerja prediktif model. Agar lebih jelas, mari lihat plot berikut.
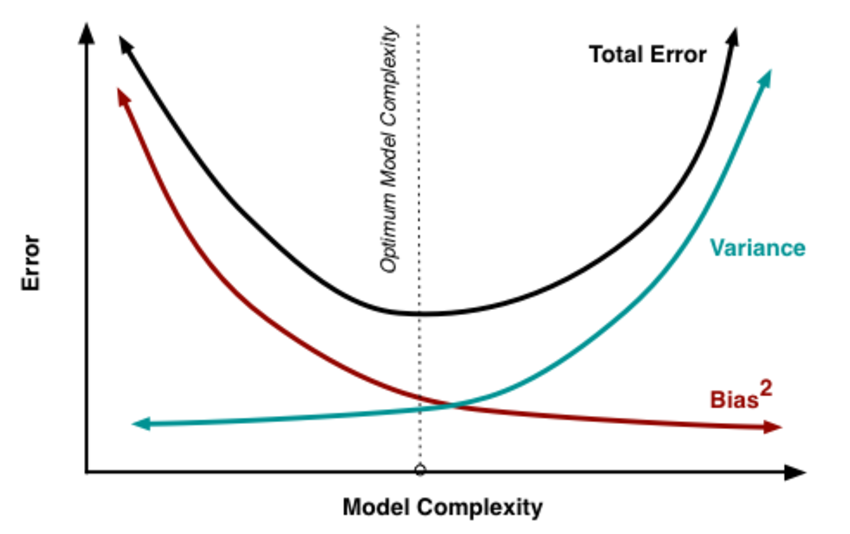
Sumber: researchgate.net
Seiring meningkatnya kompleksitas model—yang dalam kasus regresi linear dapat dipandang sebagai jumlah prediktor—varians estimasi juga meningkat, tetapi bias menurun. OLS yang tidak bias akan menempatkan kita di sisi kanan gambar, yang jauh dari optimal. Itulah mengapa kita melakukan regularisasi: untuk menurunkan varians dengan menambahkan sedikit bias, sehingga bergerak ke kiri pada plot, menuju titik optimum.
Dari pembahasan sejauh ini kita menyimpulkan bahwa kita ingin menurunkan kompleksitas model, yaitu jumlah prediktor. Kita bisa menggunakan pemilihan maju atau mundur untuk ini, tetapi dengan cara itu kita tidak dapat mengatakan apa pun tentang pengaruh variabel yang dihapus terhadap respons. Menghapus prediktor dari model dapat dipandang sebagai mengatur koefisiennya ke nol. Alih-alih memaksa tepat nol, mari beri penalti jika nilainya terlalu jauh dari nol, sehingga memaksanya menjadi kecil secara kontinu. Dengan cara ini, kita menurunkan kompleksitas model sambil tetap mempertahankan semua variabel dalam model. Inilah, secara garis besar, yang dilakukan oleh Regresi Ridge.
Pada Regresi Ridge, fungsi loss OLS ditambahkan sehingga kita tidak hanya meminimalkan jumlah kuadrat residu tetapi juga memberi penalti pada besaran estimasi parameter, untuk menyusutkannya menuju nol:
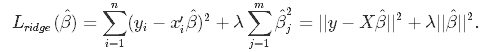
Menyelesaikannya untuk $\hat\beta$ memberikan estimasi regresi ridge $\hat\beta_{ridge} = (X'X+\lambda I)^{-1}(X'Y)$, di mana I menyatakan matriks identitas.
Parameter λ adalah penalti regularisasi. Kita akan membahas cara memilihnya di bagian berikut, tetapi untuk saat ini perhatikan bahwa:
Jadi, mengatur λ ke 0 sama dengan menggunakan OLS, sedangkan semakin besar nilainya, semakin kuat penalti terhadap besaran koefisien.
Mengikutsertakan koefisien regularisasi ke dalam rumus bias dan varians memberikan
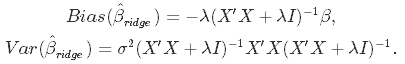
Dari sana terlihat bahwa ketika λ semakin besar, varians menurun dan bias meningkat. Ini memunculkan pertanyaan: seberapa besar bias yang bersedia kita terima untuk menurunkan varians? Atau: berapa nilai λ yang optimal?
Ada dua cara untuk menangani hal ini. Pendekatan yang lebih tradisional adalah memilih λ sedemikian rupa sehingga beberapa kriteria informasi, misalnya AIC atau BIC, menjadi yang terkecil. Pendekatan yang lebih ala machine learning adalah melakukan cross-validation dan memilih nilai λ yang meminimalkan jumlah kuadrat residu yang tervalidasi silang (atau ukuran lainnya). Pendekatan pertama menekankan kesesuaian model terhadap data, sedangkan yang kedua lebih berfokus pada kinerja prediktifnya. Mari bahas keduanya.
Meminimalkan Kriteria Informasi
Pendekatan ini bermuara pada mengestimasi model dengan banyak nilai λ yang berbeda dan memilih yang meminimalkan Akaike atau Bayesian Information Criterion:
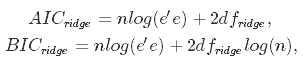
di mana dfridge adalah jumlah derajat kebebasan. Hati-hati di sini! Jumlah derajat kebebasan pada regresi ridge berbeda dengan pada OLS biasa! Ini sering terlewat sehingga menghasilkan inferensi yang keliru. Pada OLS maupun regresi ridge, derajat kebebasan sama dengan jejak (trace) dari yang disebut hat matrix, yaitu matriks yang memetakan vektor nilai respons ke vektor nilai terpasang sebagai berikut: $\hat y = H y$.
Pada OLS, kita peroleh HOLS = X(X′X)−1X, yang memberikan dfOLS = trHOLS = m, di mana m adalah jumlah variabel prediktor. Namun pada regresi ridge, rumus hat matrix harus memasukkan penalti regularisasi: Hridge = X(X′X + λI)−1X, yang memberikan dfridge = trHridge, yang tidak lagi sama dengan m. Beberapa perangkat lunak regresi ridge menghasilkan kriteria informasi berdasarkan rumus OLS. Untuk memastikan Anda melakukannya dengan benar, lebih aman menghitungnya secara manual, yang akan kita lakukan nanti di tutorial ini.
Meminimalkan residu tervalidasi silang
Untuk memilih λ melalui cross-validation, Anda perlu memilih sekumpulan P nilai λ untuk diuji, membagi dataset menjadi K lipatan (fold), dan mengikuti algoritme berikut:
Tentu saja, tidak perlu memprogramnya sendiri—R sudah menyediakan fungsi-fungsi khusus.
Di R, paket glmnet memiliki semua yang Anda butuhkan untuk menerapkan regresi ridge. Kita akan menggunakan dataset mtcars yang terkenal sebagai ilustrasi, dengan tugas memprediksi miles per gallon berdasarkan karakteristik mobil lainnya. Satu hal lagi: regresi ridge mengasumsikan prediktor distandardisasi dan respons di-center! Anda akan melihat mengapa asumsi ini diperlukan sebentar lagi. Untuk saat ini, kita akan melakukan standardisasi sebelum pemodelan.
# Load libraries, get data & set seed for reproducibility ---------------------
set.seed(123)    # seef for reproducibility
library(glmnet)  # for ridge regression
library(dplyr)   # for data cleaning
library(psych)   # for function tr() to compute trace of a matrix

data("mtcars")
# Center y, X will be standardized in the modelling function
y <- mtcars %>% select(mpg) %>% scale(center = TRUE, scale = FALSE) %>% as.matrix()
X <- mtcars %>% select(-mpg) %>% as.matrix()


# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 0 implements ridge regression
ridge_cv <- cv.glmnet(X, y, alpha = 0, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(ridge_cv)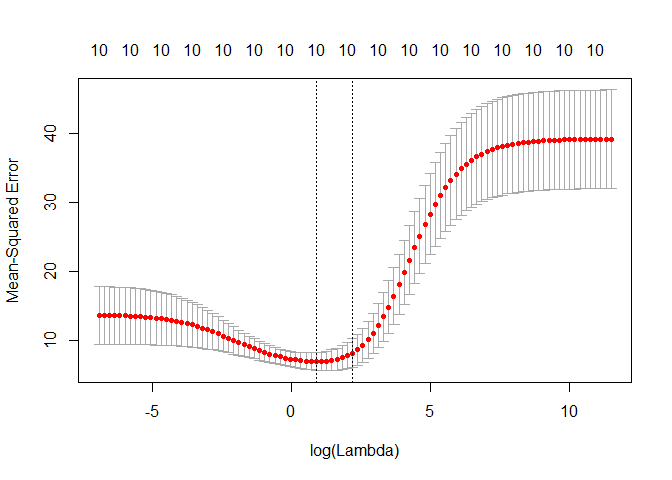
# Best cross-validated lambda
lambda_cv <- ridge_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 0, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_ridge_cv <- cor(y, y_hat_cv)^2


# Use information criteria to select lambda -----------------------------------
X_scaled <- scale(X)
aic <- c()
bic <- c()
for (lambda in seq(lambdas_to_try)) {
  # Run model
  model <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try[lambda], standardize = TRUE)
  # Extract coefficients and residuals (remove first row for the intercept)
  betas <- as.vector((as.matrix(coef(model))[-1, ]))
  resid <- y - (X_scaled %*% betas)
  # Compute hat-matrix and degrees of freedom
  ld <- lambdas_to_try[lambda] * diag(ncol(X_scaled))
  H <- X_scaled %*% solve(t(X_scaled) %*% X_scaled + ld) %*% t(X_scaled)
  df <- tr(H)
  # Compute information criteria
  aic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df
  bic[lambda] <- nrow(X_scaled) * log(t(resid) %*% resid) + 2 * df * log(nrow(X_scaled))
}

# Plot information criteria against tried values of lambdas
plot(log(lambdas_to_try), aic, col = "orange", type = "l",
     ylim = c(190, 260), ylab = "Information Criterion")
lines(log(lambdas_to_try), bic, col = "skyblue3")
legend("bottomright", lwd = 1, col = c("orange", "skyblue3"), legend = c("AIC", "BIC"))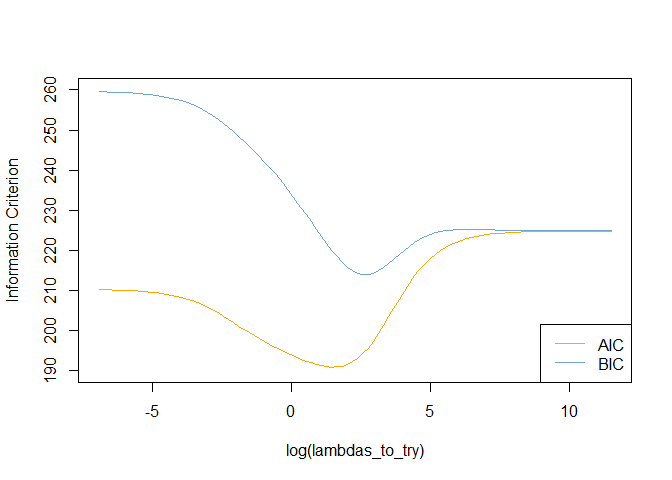
# Optimal lambdas according to both criteria
lambda_aic <- lambdas_to_try[which.min(aic)]
lambda_bic <- lambdas_to_try[which.min(bic)]

# Fit final models, get their sum of squared residuals and multiple R-squared
model_aic <- glmnet(X, y, alpha = 0, lambda = lambda_aic, standardize = TRUE)
y_hat_aic <- predict(model_aic, X)
ssr_aic <- t(y - y_hat_aic) %*% (y - y_hat_aic)
rsq_ridge_aic <- cor(y, y_hat_aic)^2

model_bic <- glmnet(X, y, alpha = 0, lambda = lambda_bic, standardize = TRUE)
y_hat_bic <- predict(model_bic, X)
ssr_bic <- t(y - y_hat_bic) %*% (y - y_hat_bic)
rsq_ridge_bic <- cor(y, y_hat_bic)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 0, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)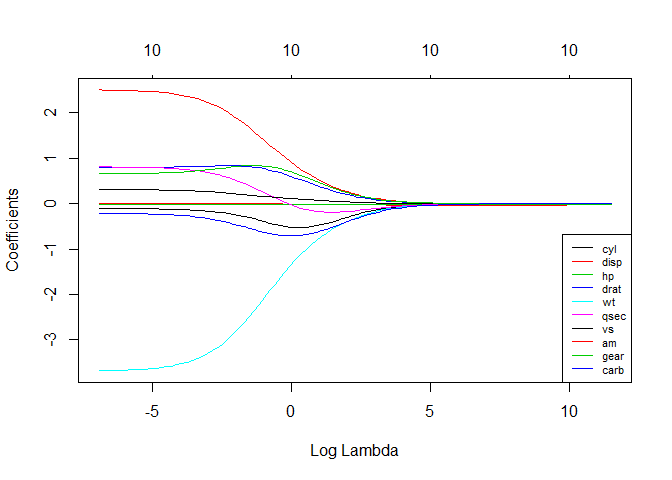
Sebelumnya saya menyebutkan bahwa regresi ridge mengasumsikan prediktor diskalakan ke skor-z. Mengapa ini diperlukan? Penskalaan ini memastikan bahwa suku penalti memberi penalti setiap koefisien secara setara sehingga berbentuk $\lambda \sum_{j=1}^m\hat\beta_j^2$. Jika prediktor tidak distandardisasi, simpangan bakunya tidak semuanya sama dengan satu, dan dapat ditunjukkan secara matematis bahwa ini menghasilkan suku penalti dengan bentuk $\lambda \sum_{j=1}^m\hat\beta_j^2/std(x_j)$. Jadi, koefisien yang tidak distandardisasi kemudian dibobot dengan kebalikan dari simpangan baku prediktor terkait. Kita menskalakan matriks X untuk menghindari ini, tetapi... Alih-alih menyelesaikan masalah heteroskedastisitas dengan menyamakan varians semua prediktor melalui penskalaan, kita juga bisa menggunakannya sebagai bobot dalam proses estimasi! Inilah gagasan di balik Differentially-weighted atau Heteroskedastic Ridge Regression.
Idenya adalah memberi penalti pada koefisien yang berbeda dengan kekuatan yang berbeda dengan memperkenalkan bobot ke fungsi loss:
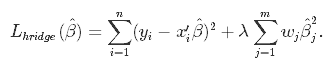
Bagaimana memilih bobot wj? Jalankan serangkaian regresi univariat (respons vs. salah satu prediktor) untuk semua prediktor, ekstrak estimasi varians koefisien, $\hat\sigma_{j}$, dan gunakan itu sebagai bobot! Dengan cara ini:
Berikut cara melakukannya di R. Karena metode ini tidak diimplementasikan di glmnet, kita perlu sedikit pemrograman di sini.
# Calculate the weights from univariate regressions
weights <- sapply(seq(ncol(X)), function(predictor) {
  uni_model <- lm(y ~ X[, predictor])
  coeff_variance <- summary(uni_model)$coefficients[2, 2]^2
})


# Heteroskedastic Ridge Regression loss function - to be minimized
hridge_loss <- function(betas) {
  sum((y - X %*% betas)^2) + lambda * sum(weights * betas^2)
}


# Heteroskedastic Ridge Regression function
hridge <- function(y, X, lambda, weights) {
  # Use regular ridge regression coefficient as initial values for optimization
  model_init <- glmnet(X, y, alpha = 0, lambda = lambda, standardize = FALSE)
  betas_init <- as.vector(model_init$beta)
  # Solve optimization problem to get coefficients
  coef <- optim(betas_init, hridge_loss)$par
  # Compute fitted values and multiple R-squared
  fitted <- X %*% coef
  rsq <- cor(y, fitted)^2
  names(coef) <- colnames(X)
  output <- list("coef" = coef,
                 "fitted" = fitted,
                 "rsq" = rsq)
  return(output)
}


# Fit model to the data for lambda = 0.001
hridge_model <- hridge(y, X, lambda = 0.001, weights = weights)
rsq_hridge_0001 <- hridge_model$rsq

# Cross-validation or AIC/BIC can be employed to select some better lambda!
# You can find some useful functions for this at https://github.com/MichalOleszak/momisc/blob/master/R/hridge.RLasso, atau Least Absolute Shrinkage and Selection Operator, secara konseptual mirip dengan regresi ridge. Lasso juga menambahkan penalti untuk koefisien yang tidak nol, tetapi berbeda dengan regresi ridge yang memberi penalti pada jumlah kuadrat koefisien (penalti L2), lasso memberi penalti pada jumlah nilai absolutnya (penalti L1). Akibatnya, untuk nilai λ yang tinggi, banyak koefisien menjadi tepat nol pada lasso, yang tidak pernah terjadi pada regresi ridge.
Satu-satunya perbedaan pada fungsi loss ridge dan lasso adalah pada suku penalti. Pada lasso, loss didefinisikan sebagai:
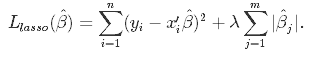
Untuk menjalankan Regresi Lasso Anda dapat menggunakan kembali fungsi glmnet(), tetapi dengan parameter alpha diatur ke 1.
# Perform 10-fold cross-validation to select lambda ---------------------------
lambdas_to_try <- 10^seq(-3, 5, length.out = 100)
# Setting alpha = 1 implements lasso regression
lasso_cv <- cv.glmnet(X, y, alpha = 1, lambda = lambdas_to_try,
                      standardize = TRUE, nfolds = 10)
# Plot cross-validation results
plot(lasso_cv)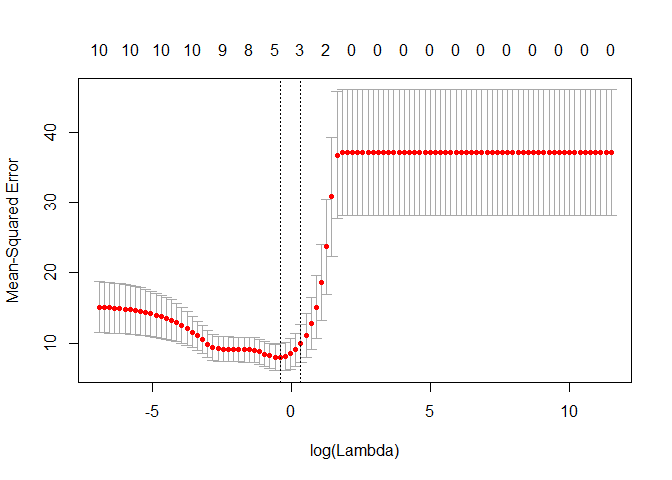
# Best cross-validated lambda
lambda_cv <- lasso_cv$lambda.min
# Fit final model, get its sum of squared residuals and multiple R-squared
model_cv <- glmnet(X, y, alpha = 1, lambda = lambda_cv, standardize = TRUE)
y_hat_cv <- predict(model_cv, X)
ssr_cv <- t(y - y_hat_cv) %*% (y - y_hat_cv)
rsq_lasso_cv <- cor(y, y_hat_cv)^2


# See how increasing lambda shrinks the coefficients --------------------------
# Each line shows coefficients for one variables, for different lambdas.
# The higher the lambda, the more the coefficients are shrinked towards zero.
res <- glmnet(X, y, alpha = 1, lambda = lambdas_to_try, standardize = FALSE)
plot(res, xvar = "lambda")
legend("bottomright", lwd = 1, col = 1:6, legend = colnames(X), cex = .7)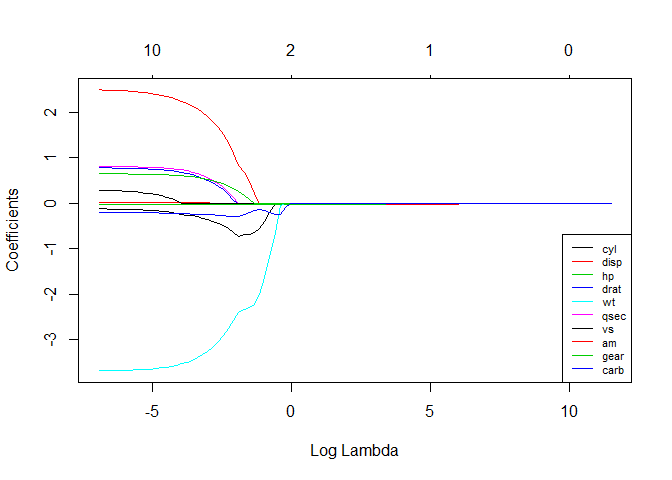
Mari bandingkan R-squared berganda dari berbagai model yang telah kita estimasi!
rsq <- cbind("R-squared" = c(rsq_ridge_cv, rsq_ridge_aic, rsq_ridge_bic, rsq_hridge_0001, rsq_lasso_cv))
rownames(rsq) <- c("ridge cross-validated", "ridge AIC", "ridge BIC", "hridge 0.001", "lasso cross_validated")
print(rsq)

##                       R-squared
## ridge cross-validated 0.8536968
## ridge AIC             0.8496310
## ridge BIC             0.8412011
## hridge 0.001          0.7278277
## lasso cross_validated 0.8426777
Kinerjanya tampak serupa untuk data ini. Ingat, model heteroskedastik belum di-tuning, dan nilai lambda belum optimal! Beberapa pertimbangan umum tentang bagaimana ridge dan lasso dibandingkan:
Elastic Net muncul sebagai hasil kritik terhadap lasso, yang seleksi variabelnya bisa terlalu bergantung pada data dan karenanya tidak stabil. Solusinya adalah menggabungkan penalti regresi ridge dan lasso untuk mendapatkan kelebihan keduanya. Elastic Net bertujuan meminimalkan fungsi loss berikut:
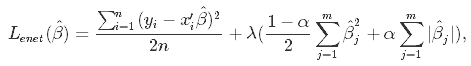
di mana α adalah parameter pencampur antara ridge (α = 0) dan lasso (α = 1).
Sekarang, ada dua parameter yang harus di-tuning: λ dan α. Paket glmnet memungkinkan tuning λ melalui cross-validation untuk α yang tetap, tetapi tidak mendukung tuning α, sehingga kita akan menggunakan caret untuk tugas ini.
library(caret)

# Set training control
train_control <- trainControl(method = "repeatedcv",
                              number = 5,
                              repeats = 5,
                              search = "random",
                              verboseIter = TRUE)

# Train the model
elastic_net_model <- train(mpg ~ .,
                           data = cbind(y, X),
                           method = "glmnet",
                           preProcess = c("center", "scale"),
                           tuneLength = 25,
                           trControl = train_control)

# Check multiple R-squared
y_hat_enet <- predict(elastic_net_model, X)
rsq_enet <- cor(y, y_hat_enet)^2Selamat! Jika Anda sampai pada titik ini, Anda sudah mengetahui bahwa:
Jika Anda ingin mempelajari lebih lanjut tentang regresi di R, ikuti kursus Supervised Learning in R: Regression dari DataCamp. Juga lihat tutorial kami tentang Regresi Linear di R dan Regresi Logistik di R.
Kursus R
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt



