

什么是峰度及其类型?
偏度关注的是正态分布的扩展(尾部),而峰度更关注高度。它告诉我们正态(或类正态)分布有多“尖”或多“平”。该术语源自希腊语,意为弯曲或拱形,最早由英国数学家卡尔·皮尔逊提出(不出所料,他一生致力于研究概率分布)。
高峰度表明:
- 分布中心的峰非常尖。
- 比正态分布有更多的数值集中在均值附近。
- 尾部更重,因为尾部聚集了更多极端值或异常值。
- 发生极端事件的可能性更大。
相反,低峰度表明:
- 峰较平。
- 在均值附近集中的数值更少,但仍多于正态分布。
- 尾部更轻。
- 发生极端事件的可能性更低。
按程度不同,分布的峰度有三种类型:
- 中峰(Mesokurtic)分布(峰度 = 3,超额峰度 = 0):完美正态分布或非常接近。
- 高峰(Leptokurtic)分布(峰度 > 3,超额峰度 > 0):尖峰、重尾
- 低峰(Platykurtic)分布(峰度 < 3,超额峰度 < 0):平峰、轻尾
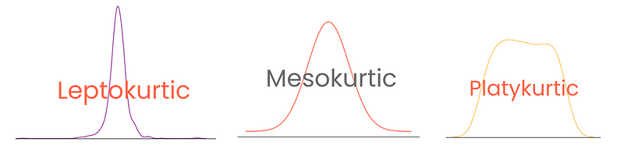
注意,这里超额峰度定义为 峰度 - 3,将正态分布的峰度视为 0。这样一来,峰度分数更易解释。
如何在 Python 中计算峰度
您可以像计算偏度一样,在 Python 中使用 pandas 或 SciPy 计算峰度:
from scipy.stats import kurtosis
kurtosis(diamond_prices)
2.177382669056634
Pandas 提供了两个函数来计算峰度:kurt 和 kurtosis。前者仅适用于 Pandas 的 Series,后者可用于 DataFrame。
diamond_prices.kurt()
2.17769575924869
# Select numeric features and calculate kurtosis
diamonds.select_dtypes(include="number").kurtosis()
carat 1.256635
depth 5.739415
table 2.801857
price 2.177696
x -0.618161
y 91.214557
z 47.086619
dtype: float64
同一分布的数值再次出现差异,是因为 pandas 与 SciPy 采用的公式不同。
如果您希望手动计算峰度,可以使用下面的公式:
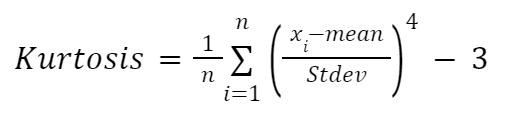
其中:
- n 表示数据集中的观测数量
- x_i 表示每个具体的数据点
我们再把公式封装进一个函数:
def moment_based_kurtosis(distribution):
n = len(distribution)
mean = np.mean(distribution)
std = np.std(distribution)
kurtosis = (1 / n) * sum(((distribution - mean) / std) ** 4) - 3
return kurtosis
>>> moment_based_kurtosis(diamond_prices)
2.1773826690576463
我们可以发现,钻石价格的超额峰度为 2.18,这意味着如果我们绘制其分布,峰会比正态分布更尖。
那就来画图吧!
在 Python 中可视化偏度与峰度
用于观察分布形状、从而查看偏度与峰度的最佳图形之一是核密度估计(KDE)图。它可以通过 Seaborn 直接绘制:
import matplotlib.pyplot as plt
sns.kdeplot(diamond_prices)
plt.title("KDE plot of diamond prices")
plt.xlabel("Price ($)")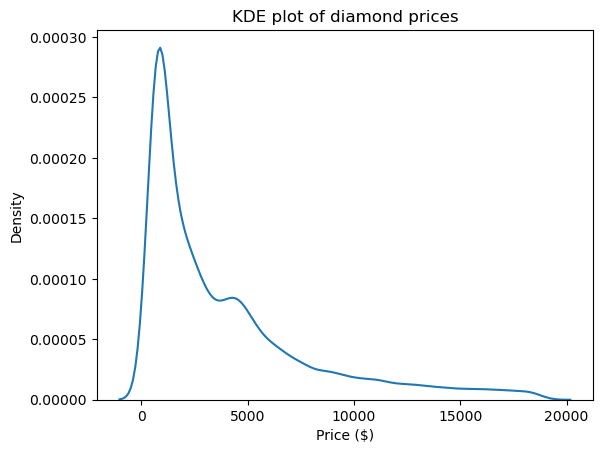
该图与我们目前看到的数据一致:分布有一条很长的右尾,表明正偏;同时峰非常尖,对应较高的峰度。
当然,KDE 并非唯一选择,我们也可以使用直方图:
sns.histplot(diamonds["carat"])
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")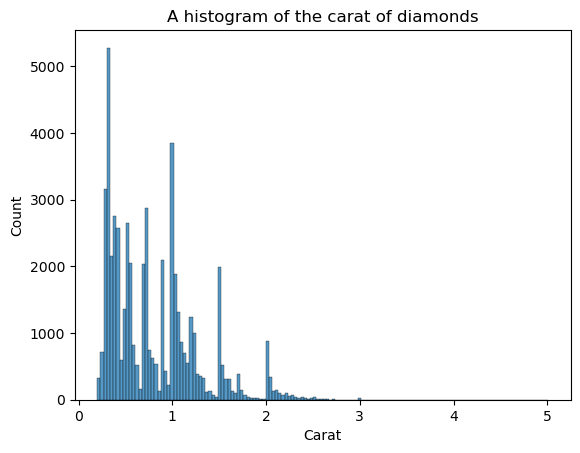
直方图的劣势在于需要您自行选择组距数量(柱状条数)。这里柱子太多,给可视化带来了噪声——我们无法清晰定义形状。因此,减少一下组距数量:
sns.histplot(diamonds["carat"], bins=25)
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")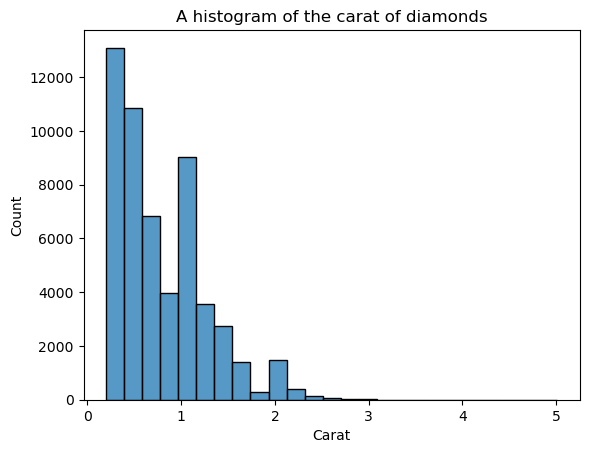
现在形状更清晰了,但我们还能继续改进。通过在 histplot 中设置 kde=True,我们可以在柱状图上叠加该分布的 KDE:
sns.histplot(diamonds["carat"], bins=25, kde=True)
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")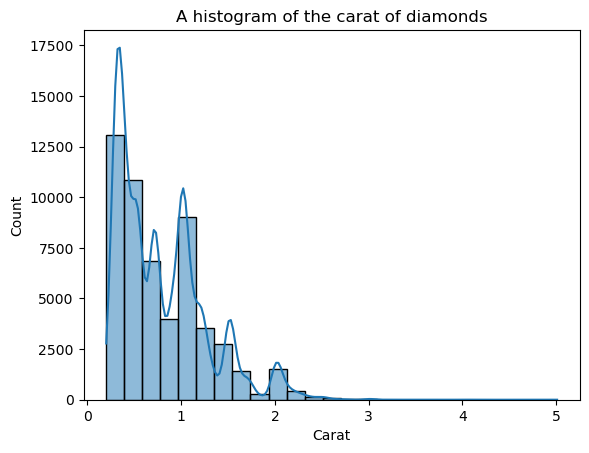
叠加的 KDE 线条看起来有些锯齿状,缺少那种能展示总体形状的平滑曲线。造成锯齿的原因是克拉数分布天然较为尖峰、多刺,离正态分布较远。
不过,我们可以通过调整带宽来降低 KDE 对这些波动的敏感度。可使用参数 bw_adjust 调整,默认值为 1:
# 将带宽从 1 改为 3
sns.kdeplot(diamonds["carat"], bw_adjust=3, color="red")
plt.title("KDE of diamond carats");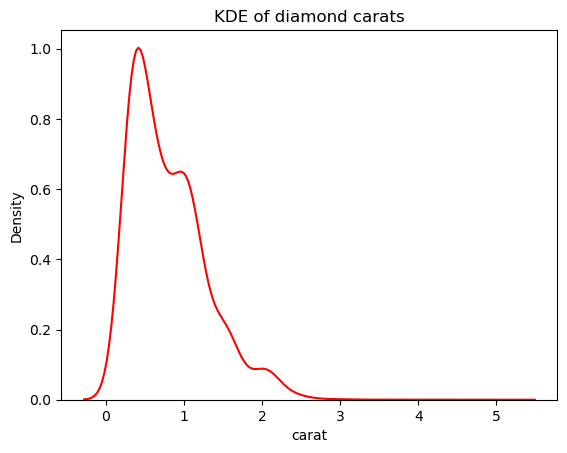
这个版本比之前叠加的 KDE 明显不那么“多刺”。在使用叠加 KDE 的直方图时,如果要调整 KDE 的带宽,可以使用 kde_kws 参数:
ax = sns.histplot(
diamonds["carat"],
kde=True,
kde_kws=dict(bw_adjust=3),
bins=25,
)
plt.title("An overlaid histogram of diamond carats");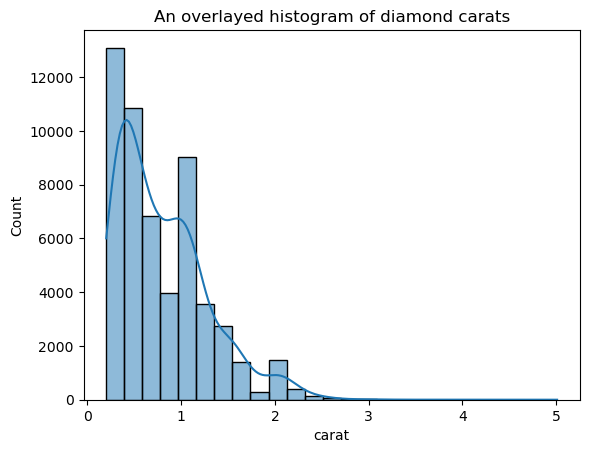
kde_kws 可接收所有 kdeplot 函数支持的、用于控制 KDE 计算的参数。
绘制 KDE 时,您可以使用一个小技巧:只保留 KDE 线条,移除其他元素。由于 KDE 的主要目的就是查看分布形状,坐标刻度、边框和标签等细节有时并非必要:
sns.kdeplot(diamond_prices, color="red")
# Remove the spine from three sides
sns.despine(top=True, right=True, left=True)
# Remove the ticks and ticklabels
plt.xticks([])
plt.yticks([])
plt.ylabel("")
plt.xlabel("")
# Set a title
plt.title("Diamond prices", fontdict=dict(fontsize=20));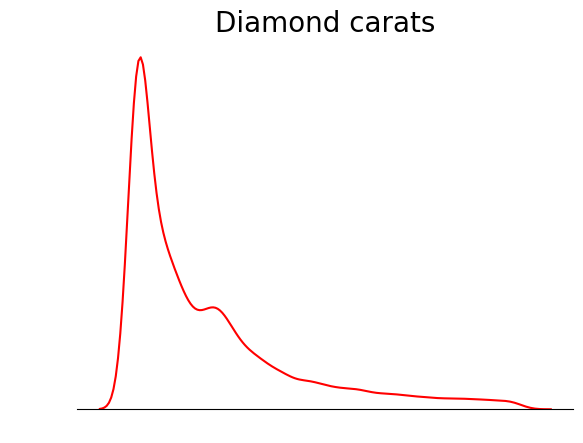
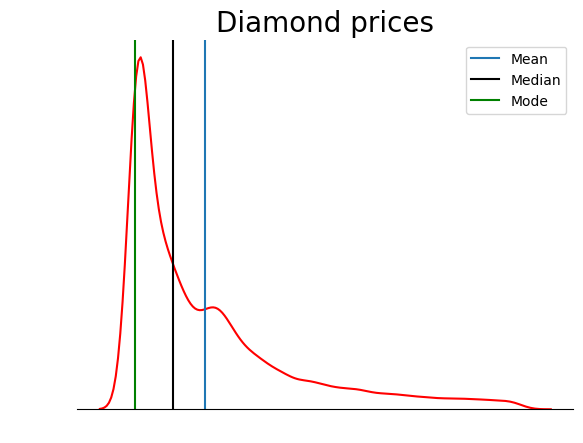
这个图干净利落。您还可以通过添加均值、中位数和众数位置的标线来进一步改进:
sns.kdeplot(diamond_prices, color="red")

sns.despine(top=True, right=True, left=True)
plt.xticks([])
plt.yticks([])
plt.ylabel("")
plt.xlabel("")
plt.title("Diamond prices", fontdict=dict(fontsize=20))

# Find the mean, median, mode
mean_price = diamonds["price"].mean()
median_price = diamonds["price"].median()
mode_price = diamonds["price"].mode().squeeze()

# Add vertical lines at the position of mean, median, mode
plt.axvline(mean_price, label="Mean")
plt.axvline(median_price, color="black", label="Median")
plt.axvline(mode_price, color="green", label="Mode")

plt.legend();


该图验证了我们在偏度类型部分的讨论:在正偏分布中,均值高于中位数,而众数低于均值和中位数。
结论
偏度与峰度在探索性数据分析中常被忽视,却能揭示分布本质的关键信息。
偏度提示数据的“倾斜”方向,揭示是否存在不对称。正偏意味着尾部向右延伸,负偏则相反。
峰度关注峰与尾。高峰度使峰更尖、尾更重,低峰度则使数据更分散、尾更轻。
如果您想进一步了解偏度与峰度,可以查看 DataCamp 上由行业专家授课的这些优秀量化分析课程:

我是一名数据科学内容创作者,拥有超过 2 年的经验,并在 Medium 上拥有较大的读者群。我喜欢用略带讽刺的笔调撰写有关 AI 和机器学习的深度文章——毕竟总得想点办法让这些内容不那么枯燥。我已发表 130 多篇文章,并制作了一门 DataCamp 课程,另有一门正在筹备中。我的内容已被超过 500 万人次阅读,其中有 2 万人在 Medium 和 LinkedIn 上成为关注者。
在收集数据并花费数小时清洗之后,您终于可以开始探索了!这一阶段通常称为探索性数据分析(EDA),也许是数据项目中最重要的一步。EDA 所获得的洞见会影响后续的方方面面。
例如,EDA 中必须执行的一步是检查分布的形状。正确识别形状会影响项目后续的诸多决策,例如:
等等。虽然我们可以用可视化来完成这项任务,但您还需要更可靠的度量来量化分布的各种特征。两个这样的度量就是偏度和峰度。您可以用它们来评估自己的分布与完美正态分布之间的相似程度。
读完本文,您将深入了解:
让我们开始吧!
什么是偏度?
我们到处都能看到正态分布:人体测量、物体重量、IQ 分数、测试成绩,甚至在健身房也能见到:
来源
除了是自然界的“宠儿”,几乎所有机器学习算法也都偏爱它。有些算法希望借此提升并稳定性能,有些则对非正态分布“水土不服”(没错,说的就是你们,线性模型)。
因此,为了满足算法对“正态性”的偏好,我们需要一种方法来衡量自己的分布与完美钟形曲线的相似(或不相似)程度。
先从尾部说起。在完美的正态分布中,左右两条尾巴长度相等。但当尾部存在不对称,使分布呈现向一侧倾斜、被“挤压”的样子时,我们称其为偏态。没错,我们用偏度来衡量这种不对称的程度。
正确归类并测量偏度可以帮助我们了解数值在均值周围的分布情况,并影响统计技术与数据变换的选择。比如,高度偏态的分布可能需要归一化或缩放,以让其更接近正态分布,从而有助于提升模型性能。
偏度的类型
偏度有三种类型:正偏、负偏和零偏。
先从最后一种说起。零偏的分布具有以下特征:
在实践中,均值、中位数和众数未必能完美重合成一直线。它们可能会略有偏离,但差异通常小到可以忽略不计。
在正偏(右偏)分布中:
在负偏(左偏)分布中:
记忆正偏与负偏差异的一个方法是这样想:如果您想提高分布的均值,就应往分布中加入远高于均值的数值;要降低均值,则反过来——加入远低于均值的数值。因此,如果大多数极端值高于均值,偏度将为正,因为它们会拉高均值;如果大多数极端值低于均值,偏度将为负,因为它们会拉低均值。
如何在 Python 中计算偏度
计算偏度的方法很多,但最简单的是皮尔逊第二偏度系数,也称为中位数偏度。
让我们在 Python 中手动实现这个公式:
另一种深受卡尔·皮尔逊研究影响的偏度近似公式是基于矩的公式。它更可靠,表达如下:
其中:
我们也在 Python 中实现一下:
如果您不想手动计算偏度(就像我一样),可以使用
pandas或scipy的内置方法:尽管不同的偏度近似公式会给出不同的分数,但差异通常微乎其微,不足以改变偏态的归类。例如,今天我们使用的各方法底层采用的公式不同,但结果非常接近。
计算出偏度后,您可以按以下标准对偏度程度进行归类: