

कर्टोसिस क्या है और इसके प्रकार?
जहाँ स्क्यूनेस नॉर्मल डिस्ट्रीब्यूशन के प्रसार (टेल्स) पर केंद्रित होती है, वहीं कर्टोसिस ऊँचाई पर अधिक ध्यान देती है। यह बताती है कि हमारी नॉर्मल (या नॉर्मल-जैसी) वितरण कितनी नुकीली या सपाट है। यह शब्द, जिसका यूनानी में अर्थ मुड़ा या मेहराबदार है, सबसे पहले, आश्चर्य नहीं, ब्रिटिश गणितज्ञ Karl Pearson ने गढ़ा था (उन्होंने अपना जीवन प्रॉबेबिलिटी डिस्ट्रीब्यूशन्स का अध्ययन करते हुए बिताया)।
उच्च कर्टोसिस इंगित करती है:
- वितरण के केंद्र में तीखी नुकीलापन।
- नॉर्मल डिस्ट्रीब्यूशन की तुलना में अधिक मान मीन के आसपास केंद्रित।
- टेल्स भारी होना, क्योंकि टेल्स में चरम मानों या आउटलायरों की अधिक सांद्रता होती है।
- चरम घटनाओं की अधिक संभावना।
दूसरी ओर, निम्न कर्टोसिस इंगित करती है:
- सपाट चोटी।
- मीन के आसपास कम मान केंद्रित, लेकिन फिर भी नॉर्मल डिस्ट्रीब्यूशन से अधिक।
- हल्की टेल्स।
- चरम घटनाओं की कम संभावना।
डिग्री के आधार पर, वितरणों में कर्टोसिस के तीन प्रकार होते हैं:
- मेसोकर्टिक वितरण (kurtosis = 3, excess kurtosis = 0): परिपूर्ण नॉर्मल डिस्ट्रीब्यूशन या उसके बहुत निकट।
- लेप्टोकर्टिक वितरण (kurtosis > 3, excess kurtosis > 0): नुकीली चोटी, भारी टेल्स
- प्लैटिकर्टिक वितरण (kurtosis < 3, excess kurtosis < 0): सपाट चोटी, हल्की टेल्स
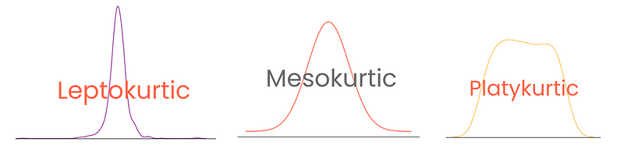
ध्यान दें कि यहाँ एक्सेस कर्टोसिस को kurtosis - 3 के रूप में परिभाषित किया गया है, जिसमें नॉर्मल डिस्ट्रीब्यूशन की कर्टोसिस को 0 माना जाता है। इस तरह कर्टोसिस स्कोर अधिक व्याख्यायोग्य हो जाते हैं।
Python में कर्टोसिस कैसे निकालें
आप pandas या SciPy का उपयोग करके, स्क्यूनेस की तरह ही Python में कर्टोसिस निकाल सकते हैं:
from scipy.stats import kurtosis
kurtosis(diamond_prices)
2.177382669056634
Pandas कर्टोसिस के लिए दो फ़ंक्शंस देता है: kurt और kurtosis। पहला केवल Pandas Series के लिए है, जबकि दूसरा DataFrames पर भी इस्तेमाल किया जा सकता है।
diamond_prices.kurt()
2.17769575924869
# Select numeric features and calculate kurtosis
diamonds.select_dtypes(include="number").kurtosis()
carat 1.256635
depth 5.739415
table 2.801857
price 2.177696
x -0.618161
y 91.214557
z 47.086619
dtype: float64
दोनों में संख्याएँ भिन्न हैं क्योंकि pandas और SciPy अलग-अलग सूत्र उपयोग करते हैं।
यदि आप कर्टोसिस की मैन्युअल गणना चाहते हैं, तो आप निम्न सूत्र का उपयोग कर सकते हैं:
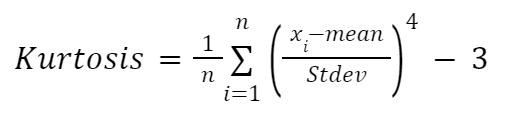
यहाँ:
- n डेटासेट में प्रेक्षणों की संख्या दर्शाता है
- x_i प्रत्येक व्यक्तिगत डेटा प्वाइंट को निरूपित करता है
हम फिर से इस सूत्र को एक फ़ंक्शन के अंदर लागू करेंगे:
def moment_based_kurtosis(distribution):
n = len(distribution)
mean = np.mean(distribution)
std = np.std(distribution)
kurtosis = (1 / n) * sum(((distribution - mean) / std) ** 4) - 3
return kurtosis
>>> moment_based_kurtosis(diamond_prices)
2.1773826690576463
और हमें पता चलता है कि डायमंड प्राइसेज़ की एक्सेस कर्टोसिस 2.18 है, जिसका अर्थ है कि यदि हम वितरण को प्लॉट करें, तो उसमें नॉर्मल डिस्ट्रीब्यूशन की तुलना में अधिक नुकीली चोटी होगी।
तो, आइए यह करें!
Python में स्क्यूनेस और कर्टोसिस का विज़ुअलीकरण
वितरणों के आकार और इस प्रकार उनकी स्क्यूनेस और कर्टोसिस देखने के लिए सबसे अच्छे विज़ुअल्स में से एक है कर्नेल डेंसिटी एस्टीमेट (KDE) प्लॉट। यह Seaborn के ज़रिये उपलब्ध है:
import matplotlib.pyplot as plt
sns.kdeplot(diamond_prices)
plt.title("KDE plot of diamond prices")
plt.xlabel("Price ($)")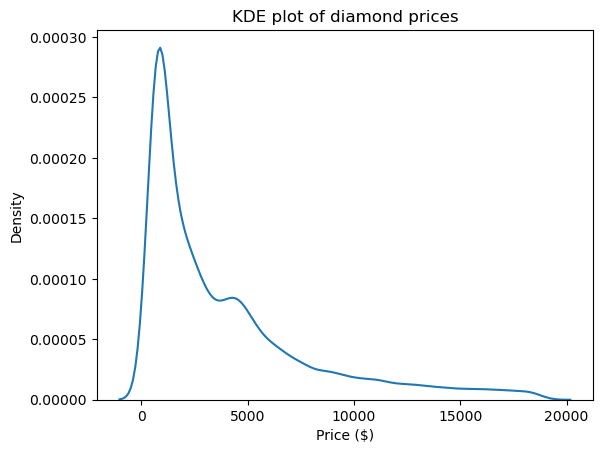
यह प्लॉट अब तक देखे गए अंकों के अनुरूप है: वितरण की दाहिनी लंबी टेल है, जो पॉज़िटिव स्क्यूनेस दर्शाती है, और इसकी चोटी बहुत नुकीली है, जो उच्च कर्टोसिस से मेल खाती है।
आकार देखने के लिए केवल KDE ही नहीं है। हम हिस्टोग्राम भी उपयोग कर सकते हैं:
sns.histplot(diamonds["carat"])
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")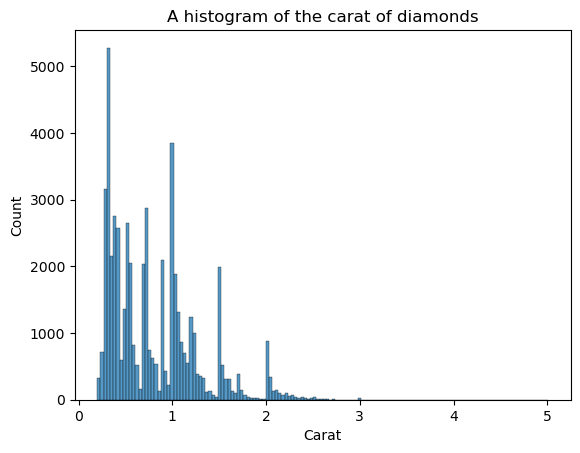
हिस्टोग्राम की कमी यह है कि आपको बिन्स (बारों की संख्या) स्वयं चुननी पड़ती है। यहाँ, बारों की संख्या बहुत अधिक है, जिससे विज़ुअल में शोर बन रहा है—हम आकार को स्पष्ट रूप से परिभाषित नहीं कर पा रहे। तो, आइए बिन्स की संख्या घटाएँ:
sns.histplot(diamonds["carat"], bins=25)
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")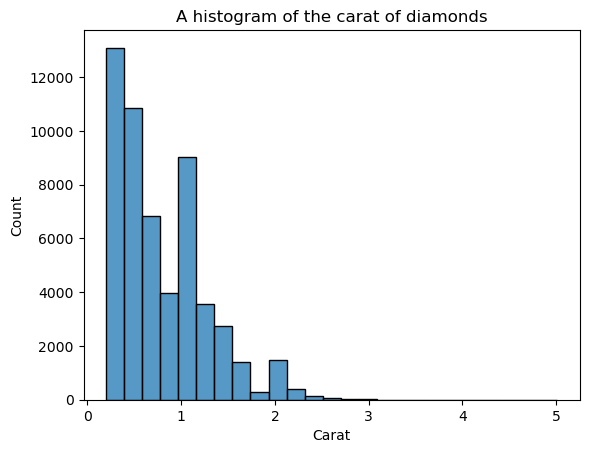
अब, आकार बेहतर परिभाषित है, लेकिन हम इसे और सुधार सकते हैं। histplot में kde=True सेट करके, हम बार्स के ऊपर वितरण का KDE प्लॉट कर सकते हैं:
sns.histplot(diamonds["carat"], bins=25, kde=True)
plt.xlabel("Carat")
plt.title("A histogram of the carat of diamonds")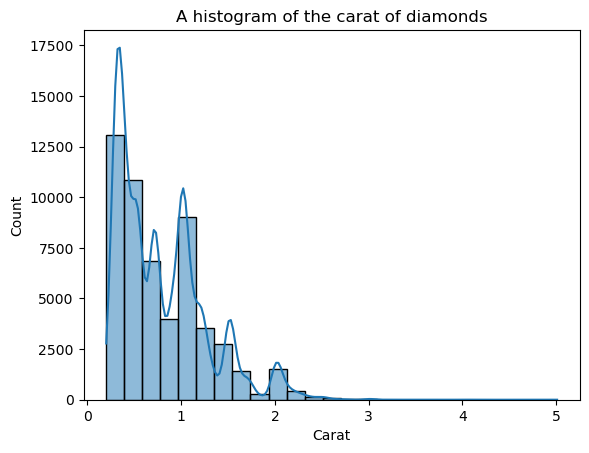
ओवरले की गई KDE रेखा दंतीली लग रही है, वैसी स्मूद कर्व नहीं जो हमें सामान्य आकार दिखाने में मदद करे। दंतीलेपन का कारण यह है कि कैरेट वितरण स्वाभाविक रूप से स्पाइकी है और नॉर्मल डिस्ट्रीब्यूशन से काफी दूर है।
लेकिन, हम बैंडविड्थ समायोजित करके इन उतार-चढ़ावों के प्रति KDE की संवेदनशीलता कम कर सकते हैं। यह bw_adjust पैरामीटर से होता है, जिसकी डिफ़ॉल्ट वैल्यू 1 है:
# Change the bandwidth from 1 to 3
sns.kdeplot(diamonds["carat"], bw_adjust=3, color="red")
plt.title("KDE of diamond carats");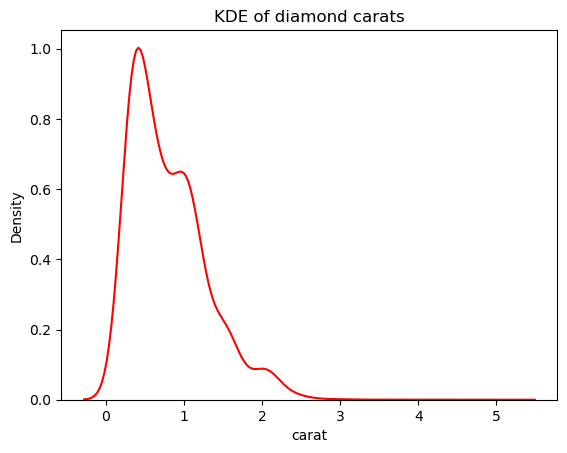
यह संस्करण ओवरले किए गए KDE प्लॉट की तुलना में काफ़ी कम स्पाइकी दिख रहा है। जब आप हिस्टोग्राम के साथ ओवरले KDE का बैंडविड्थ समायोजित करना चाहें, तो kde_kws पैरामीटर का उपयोग करें:
ax = sns.histplot(
diamonds["carat"],
kde=True,
kde_kws=dict(bw_adjust=3),
bins=25,
)
plt.title("An overlaid histogram of diamond carats");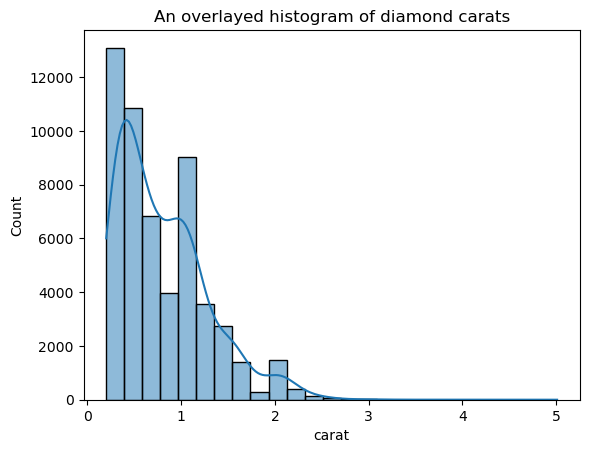
kde_kws वह सभी पैरामीटर स्वीकार करता है जो kdeplot फ़ंक्शन द्वारा स्वीकार्य हैं और KDE गणना को नियंत्रित करते हैं।
KDE प्लॉट करते समय आप एक तरकीब अपना सकते हैं: KDE रेखा के अलावा बाकी सब हटा दें। चूँकि KDE का मुख्य उद्देश्य वितरण का आकार देखना है, इसलिए प्लॉट के अन्य विवरण जैसे एक्सिस टिक, स्पाइन्स और लेबल कभी-कभी अनावश्यक होते हैं:
sns.kdeplot(diamond_prices, color="red")
# Remove the spine from three sides
sns.despine(top=True, right=True, left=True)
# Remove the ticks and ticklabels
plt.xticks([])
plt.yticks([])
plt.ylabel("")
plt.xlabel("")
# Set a title
plt.title("Diamond prices", fontdict=dict(fontsize=20));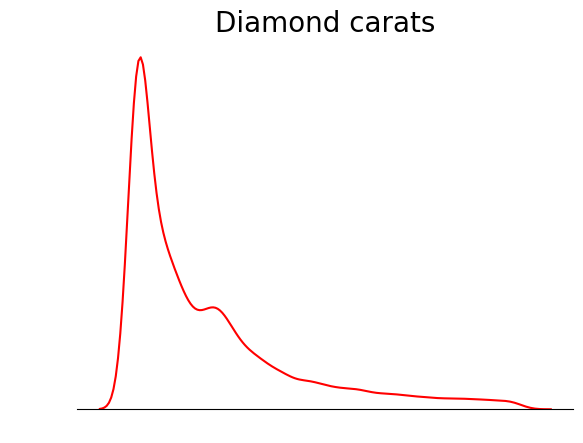
यह प्लॉट कहीं अधिक सुथरा है। आप मीन, मीडियन और मोड की स्थिति दर्शाने के लिए रेखाएँ जोड़कर प्लॉट को और बेहतर बना सकते हैं:
sns.kdeplot(diamond_prices, color="red")
sns.despine(top=True, right=True, left=True)
plt.xticks([])
plt.yticks([])
plt.ylabel("")
plt.xlabel("")
plt.title("Diamond prices", fontdict=dict(fontsize=20))
# Find the mean, median, mode
mean_price = diamonds["price"].mean()
median_price = diamonds["price"].median()
mode_price = diamonds["price"].mode().squeeze()
# Add vertical lines at the position of mean, median, mode
plt.axvline(mean_price, label="Mean")
plt.axvline(median_price, color="black", label="Median")
plt.axvline(mode_price, color="green", label="Mode")
plt.legend();
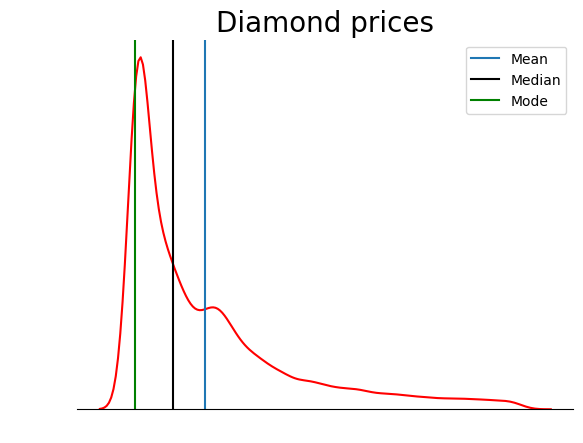
यह प्लॉट उस बात की पुष्टि करता है जो हमने स्क्यूनेस के प्रकारों वाले खंड में चर्चा की: पॉज़िटिवली स्क्यूड वितरण में, मीन मीडियन से अधिक होता है, और मोड मीन व मीडियन दोनों से कम होता है।
निष्कर्ष
Exploratory Data Analysis में अक्सर अनदेखी की जाने वाली स्क्यूनेस और कर्टोसिस वितरणों की प्रकृति के बारे में महत्वपूर्ण अंतर्दृष्टि उजागर करती हैं।
स्क्यूनेस डेटा के झुकाव की ओर इशारा करती है—बाएँ या दाएँ—और उसकी असममिति (यदि हो) को उजागर करती है। पॉज़िटिव स्क्यू का अर्थ है दाहिनी ओर फैली हुई टेल, जबकि नेगेटिव स्क्यू विपरीत दिशा में झुकाव दिखाती है।
कर्टोसिस चोटी और टेल्स के बारे में है। उच्च कर्टोसिस चोटियों को और नुकीला बनाती है और टेल्स को भारी, जबकि निम्न कर्टोसिस डेटा को फैला देती है और टेल्स को हल्का करती है।
यदि आप स्क्यूनेस और कर्टोसिस के बारे में अधिक सीखना चाहते हैं, तो आप DataCamp पर उद्योग विशेषज्ञों द्वारा पढ़ाए गए ये उत्कृष्ट क्वांटिटेटिव एनालिसिस कोर्स देख सकते हैं:

मैं 2 से अधिक वर्षों के अनुभव वाला डेटा साइंस कंटेंट क्रिएटर हूँ और Medium पर सबसे बड़े फॉलोइंग्स में से एक रखता हूँ। मुझे एआई और एमएल पर विस्तार से लेख लिखना पसंद है, जिसमें हल्का-सा व्यंग्यात्मक अंदाज रहता है—क्योंकि कुछ तो करना पड़ता है ताकि वे कम उबाऊ लगें। मैंने 130 से अधिक लेख और एक DataCamp कोर्स तैयार किया है, और एक और बन रहा है। मेरा कंटेंट 50 लाख से अधिक लोगों ने देखा है, जिनमें से 20 हज़ार लोग Medium और LinkedIn पर फॉलोअर्स बन गए।
डेटा इकट्ठा करने और उसे घंटों तक साफ करने के बाद, अब आप अंततः उसे एक्सप्लोर करना शुरू कर सकते हैं! इस चरण को अक्सर Exploratory Data Analysis (EDA) कहा जाता है, और यह किसी भी डेटा प्रोजेक्ट का शायद सबसे महत्वपूर्ण कदम है। EDA से मिलने वाली अंतर्दृष्टियाँ आगे की हर चीज़ को प्रभावित करती हैं।
उदाहरण के लिए, EDA में एक अनिवार्य कदम है वितरणों के आकार की जाँच करना। आकार की सही पहचान आगे चलकर कई फैसलों को प्रभावित करती है, जैसे:
आदि। जबकि इस कार्य के लिए विजुअल्स मौजूद हैं, वितरणों की विभिन्न विशेषताओं को परिमाणित करने के लिए आपको अधिक भरोसेमंद मीट्रिक्स चाहिए। ऐसे दो मीट्रिक्स हैं स्क्यूनेस और कर्टोसिस। आप इन्हें अपनी वितरणों की तुलना आदर्श, नॉर्मल डिस्ट्रीब्यूशन से करने के लिए उपयोग कर सकते हैं।
इस लेख को समाप्त करने तक, आप विस्तार से सीखेंगे:
चलिए शुरू करते हैं!
स्क्यूनेस क्या है?
हम हर जगह नॉर्मल डिस्ट्रीब्यूशन देखते हैं: मानव शरीर के माप, वस्तुओं का वज़न, IQ स्कोर, टेस्ट परिणाम, या यहाँ तक कि जिम में भी:
स्रोत
प्रकृति का पसंदीदा वितरण होने के अलावा, इसे लगभग सभी मशीन लर्निंग एल्गोरिद्म सार्वभौमिक रूप से पसंद करते हैं। कुछ इसका उपयोग अपने प्रदर्शन को सुधारने और स्थिर करने के लिए करते हैं, जबकि कुछ तो नॉर्मल डिस्ट्रीब्यूशन के अलावा किसी और चीज़ के साथ ठीक से काम करने से सीधे इनकार कर देते हैं (हाँ, मैं आपसे कह रहा हूँ, लीनियर मॉडल्स)।
तो, एल्गोरिद्म की सामान्यता की ज़रूरत को पूरा करने के लिए, हमें ऐसा तरीका चाहिए जिससे हम माप सकें कि हमारी अपनी वितरणें आदर्श घंटी-आकार वक्र के कितनी समान (या असमान) हैं।
आइए टेल्स से शुरू करें। एक परिपूर्ण नॉर्मल डिस्ट्रीब्यूशन में, टेल्स की लंबाई समान होती है। लेकिन जब टेल्स के बीच असमानता होती है, जिससे वितरण एक तरफ झुका या दबा हुआ लगता है, तो हम कहते हैं कि यह स्क्यूड है। और जैसा कि आपने सोचा, हम इस असमानता की सीमा को स्क्यूनेस से मापते हैं।
स्क्यूनेस की सही श्रेणीकरण और माप माध्य के आसपास मूल्यों के प्रसार की समझ देता है और सांख्यिकीय तकनीकों व डेटा ट्रांसफ़ॉर्मेशनों की पसंद को प्रभावित करता है। उदाहरण के लिए, अत्यधिक स्क्यूड वितरणों को नॉर्मलाइजेशन या स्केलिंग तकनीकों से लाभ मिल सकता है ताकि वे नॉर्मल डिस्ट्रीब्यूशन जैसी दिखें। इससे मॉडल प्रदर्शन में मदद मिलती है।
स्क्यूनेस के प्रकार
स्क्यूनेस के तीन प्रकार होते हैं: पॉज़िटिव, नेगेटिव, और ज़ीरो स्क्यूनेस।
आइए आखिरी वाले से शुरू करते हैं। ज़ीरो स्क्यूनेस वाली वितरण में निम्न विशेषताएँ होती हैं:
व्यवहार में, मीन, मीडियन और मोड एकदम ओवरलैपिंग सीधी रेखा नहीं बना सकते। वे एक-दूसरे से थोड़े दूर हो सकते हैं, लेकिन अंतर इतना छोटा होगा कि मायने नहीं रखेगा।
पॉज़िटिव स्क्यूनेस (राइट-स्क्यूड) वाली वितरण में:
नेगेटिव स्क्यूनेस (लेफ़्ट-स्क्यूड) वाली वितरण में:
पॉज़िटिव और नेगेटिव स्क्यूनेस के बीच अंतर याद रखने के लिए इसे यूँ समझें: यदि आप किसी वितरण का मीन बढ़ाना चाहते हैं, तो आपको मीन से बहुत बड़े मान जोड़ने चाहिए। मीन घटाने के लिए उल्टा करें—मीन से बहुत छोटे मान जोड़ें। इसलिए, यदि चरम मानों का अधिकांश भाग मीन से बड़ा है, तो स्क्यूनेस पॉज़िटिव होगी क्योंकि वे मीन बढ़ाते हैं। यदि चरम मानों का अधिकांश भाग मीन से छोटा है, तो स्क्यूनेस नेगेटिव होगी क्योंकि वे मीन घटाते हैं।
Python में स्क्यूनेस कैसे निकालें
स्क्यूनेस निकालने के कई तरीके हैं, लेकिन सबसे सरल है पियरसन का दूसरा स्क्यूनेस गुणांक, जिसे मीडियन स्क्यूनेस भी कहते हैं।
आइए इस सूत्र को Python में मैन्युअली लागू करें:
Karl Pearson के कार्यों से प्रभावित एक और सूत्र मोमेंट-आधारित स्क्यूनेस का है। यह अधिक भरोसेमंद है और इस प्रकार दिया जाता है:
यहाँ:
आइए इसे भी Python में लागू करें:
यदि आप स्क्यूनेस को मैन्युअली नहीं निकालना चाहते (मेरी तरह), तो आप
pandasयाscipyके बिल्ट-इन मेथड्स का उपयोग कर सकते हैं:हालाँकि स्क्यूनेस के निकटानुमान के सभी सूत्र अलग-अलग स्कोर देते हैं, पर उनका अंतर इतना कम होता है कि वह महत्वपूर्ण नहीं होता या स्क्यू की श्रेणी नहीं बदलता। उदाहरण के लिए, आज हमने जिन सभी तरीकों का उपयोग किया, वे अंदरूनी तौर पर अलग-अलग सूत्रों का सहारा लेते हैं, लेकिन नतीजे बहुत करीब हैं।
स्क्यूनेस की गणना करने के बाद, आप स्क्यू की तीव्रता को इस प्रकार श्रेणीबद्ध कर सकते हैं: