जैसे-जैसे मशीन लर्निंग तकनीक अभूतपूर्व गति से आगे बढ़ रही है, वैरिएशनल ऑटोएन्कोडर्स (VAEs) डेटा को प्रोसेस और जनरेट करने के तरीके में क्रांतिकारी बदलाव ला रहे हैं। शक्तिशाली डेटा एन्कोडिंग को अभिनव जनरेटिव क्षमताओं के साथ जोड़कर, VAEs इस क्षेत्र की जटिल चुनौतियों के लिए रूपांतरकारी समाधान प्रस्तुत करते हैं।
इस लेख में, हम VAEs के मूल सिद्धांतों, उनके अनुप्रयोगों, और उन्हें PyTorch के उपयोग से चरण-दर-चरण प्रभावी ढंग से कैसे लागू किया जा सकता है, इसकी पड़ताल करेंगे।
वैरिएशनल ऑटोएन्कोडर क्या है?
ऑटोएन्कोडर एक प्रकार का न्यूरल नेटवर्क है जिसे कुशल डेटा प्रतिनियोजन (representations) सीखने के लिए डिज़ाइन किया गया है, मुख्यतः आयामीयता में कमी या फीचर लर्निंग के उद्देश्य से।
ऑटोएन्कोडर दो मुख्य भागों से मिलकर बनते हैं:
एन्कोडर: इनपुट डेटा को कम-आयामी लेटेंट स्पेस में संकुचित करता है।
डीकोडर: इस संकुचित प्रतिनियोजन से मूल डेटा का पुनर्निर्माण करता है।
ऑटोएन्कोडर्स का मुख्य उद्देश्य इनपुट और पुनर्निर्मित आउटपुट के बीच के अंतर को न्यूनतम करना है, ताकि डेटा का एक कॉम्पैक्ट प्रतिनियोजन सीखा जा सके।
यहीं आते हैं वैरिएशनल ऑटोएन्कोडर्स (VAEs), जो एन्कोडिंग प्रक्रिया में प्रायिकतामूलक (probabilistic) तत्वों को शामिल करके पारंपरिक ऑटोएन्कोडर ढांचे की क्षमताओं का विस्तार करते हैं।
जहाँ मानक ऑटोएन्कोडर्स इनपुट्स को स्थिर लेटेंट प्रतिनियोजनों पर मैप करते हैं, वहीं VAEs एक प्रायिकतामूलक दृष्टिकोण लाते हैं जिसमें एन्कोडर लेटेंट स्पेस पर एक वितरण आउटपुट करता है, जिसे आमतौर पर मल्टिवेरिएट गॉसियन के रूप में मॉडल किया जाता है। इससे डीकोडिंग के दौरान इस वितरण से सैंपल लेना संभव होता है, जिसके परिणामस्वरूप नए डेटा इंस्टेंस उत्पन्न होते हैं।
VAEs का प्रमुख नवाचार उनके एक संरचित, सतत लेटेंट स्पेस को सीखकर नया, उच्च-गुणवत्ता वाला डेटा जनरेट करने की क्षमता में निहित है। यह जनरेटिव मॉडलिंग के लिए विशेष रूप से महत्वपूर्ण है, जहाँ लक्ष्य केवल डेटा को संकुचित करना नहीं, बल्कि मूल डेटासेट से मिलते-जुलते नए सैंपल बनाना होता है।
VAEs ने छवि संश्लेषण, डेटा डीनॉयजिंग, और एनॉमली डिटेक्शन जैसे कार्यों में उल्लेखनीय प्रभावशीलता दिखाई है, जिससे वे मशीन लर्निंग मॉडल और अनुप्रयोगों की क्षमताओं को आगे बढ़ाने के लिए प्रासंगिक उपकरण बन जाते हैं।
वैरिएशनल ऑटोएन्कोडर्स का सैद्धांतिक पृष्ठभूमि
इस खंड में, हम VAEs की सैद्धांतिक पृष्ठभूमि और उनके संचालन तंत्र का परिचय देंगे, ताकि आगे के खंडों में उनके अनुप्रयोगों का अन्वेषण करने के लिए आपकी मजबूत बुनियाद बने।
एन्कोडर्स से शुरू करते हैं। एन्कोडर एक न्यूरल नेटवर्क है जो इनपुट डेटा को लेटेंट स्पेस में मैप करने के लिए जिम्मेदार है। पारंपरिक ऑटोएन्कोडर्स के विपरीत जो लेटेंट स्पेस में एक स्थिर बिंदु देते हैं, VAE में एन्कोडर एक प्रायिकता वितरण के पैरामीटर—आमतौर पर गॉसियन वितरण का माध्य (mean) और विचलन (variance)—आउटपुट करता है। इससे VAE डेटा की अनिश्चितता और विविधता को प्रभावी ढंग से मॉडल कर पाता है।
डीकोडर नामक एक अन्य न्यूरल नेटवर्क का उपयोग लेटेंट स्पेस प्रतिनियोजन से मूल डेटा को पुनर्निर्मित करने के लिए किया जाता है। लेटेंट स्पेस वितरण से लिए गए सैंपल के आधार पर, डीकोडर ऐसा आउटपुट जनरेट करने का प्रयास करता है जो मूल इनपुट डेटा से काफ़ी मेल खाता हो। यह प्रक्रिया VAE को सीखे गए वितरण से सैंपल लेकर नए डेटा इंस्टेंस बनाने देती है।
लेटेंट स्पेस एक कम-आयामी, सतत स्पेस है जिसमें इनपुट डेटा को एन्कोड किया जाता है।
एन्कोडर, डीकोडर, और लेटेंट स्पेस की भूमिका का दृश्यांकन। छवि का स्रोत।
वैरिएशनल एप्रोच एक तकनीक है जिसका उपयोग जटिल प्रायिकता वितरणों का सन्निकटन (approximation) करने के लिए किया जाता है। VAEs के संदर्भ में, यह दिए गए डेटा पर लेटेंट वेरिएबल्स के ट्रू पोस्टेरियर वितरण का सन्निकटन करने से जुड़ा है, जो अक्सर असंभव (intractable) होता है।
VAE एक अनुमानित पोस्टेरियर वितरण सीखता है। लक्ष्य यह है कि यह सन्निकटन ट्रू पोस्टेरियर के जितना संभव हो उतना निकट हो।
बायेज़ियन इन्फरेंस किसी परिकल्पना की संभावना के आकलन को नई साक्ष्य या सूचना उपलब्ध होने पर अपडेट करने की विधि है। VAEs में, बायेज़ियन इन्फरेंस का उपयोग लेटेंट वेरिएबल्स के वितरण का आकलन करने के लिए किया जाता है।
पूर्व ज्ञान (prior distribution) को अवलोकित डेटा (likelihood) के साथ एकीकृत करके, VAEs सीखे गए पोस्टेरियर वितरण के माध्यम से लेटेंट स्पेस प्रतिनियोजन को समायोजित करते हैं।
प्रायर वितरण, पोस्टेरियर वितरण, और लाइकलीहुड फंक्शन के साथ बायेज़ियन इन्फरेंस। छवि का स्रोत।
प्रक्रिया प्रवाह इस प्रकार दिखता है:
इनपुट डेटा x एन्कोडर में दिया जाता है, जो लेटेंट स्पेस वितरण q(z∣x) के पैरामीटर (माध्य μऔर विचलन σ2) आउटपुट करता है।
लेटेंट वेरिएबल्स z को वितरण q(z∣x) से रीपैरामीटराइजेशन ट्रिक जैसी तकनीकों का उपयोग करके सैंपल किया जाता है।
सैंपल किया गया z डीकोडर से होकर गुज़रता है ताकि पुनर्निर्मित डेटा x̂ उत्पन्न हो, जो मूल इनपुट x के समान होना चाहिए।
वैरिएशनल ऑटोएन्कोडर बनाम पारंपरिक ऑटोएन्कोडर
आइए पारंपरिक ऑटोएन्कोडर्स पर VAEs के अंतरों और फ़ायदों की जाँच करें।
आर्किटेक्चर की तुलना
जैसा कि पहले देखा गया, पारंपरिक ऑटोएन्कोडर्स में एक एन्कोडर नेटवर्क होता है जो इनपुट डेटा x को एक स्थिर, कम-आयामी लेटेंट स्पेस प्रतिनियोजन z में मैप करता है। यह प्रक्रिया डेटerministic होती है, यानी हर इनपुट लेटेंट स्पेस में एक विशिष्ट बिंदु पर एन्कोड होता है।
इसके बाद डीकोडर नेटवर्क इस स्थिर लेटेंट प्रतिनियोजन से मूल डेटा का पुनर्निर्माण करता है, उद्देश्य इनपुट और उसके पुनर्निर्माण के बीच अंतर को न्यूनतम करना होता है।
पारंपरिक ऑटोएन्कोडर्स का लेटेंट स्पेस इनपुट डेटा का एक संकुचित प्रतिनियोजन होता है जिसमें कोई प्रायिकतामूलक मॉडलिंग नहीं होती, जिससे नई, विविध डेटा जनरेशन की क्षमता सीमित हो जाती है क्योंकि अनिश्चितता संभालने का तंत्र मौजूद नहीं होता।
ऑटोएन्कोडर आर्किटेक्चर। लेखक द्वारा छवि
VAEs एन्कोडिंग प्रक्रिया में प्रायिकतामूलक तत्व जोड़ते हैं। यानी, VAE का एन्कोडर इनपुट डेटा को लेटेंट वेरिएबल्स पर एक प्रायिकता वितरण में मैप करता है, जिसे प्रायः माध्य mean μऔर विचलन σ2. वाली गॉसियन के रूप में मॉडल किया जाता है।
यह दृष्टिकोण हर इनपुट को एकल बिंदु की बजाय एक वितरण में एन्कोड करता है, जिससे विभिन्नता और अनिश्चितता की एक परत जुड़ती है।
आर्किटेक्चरल अंतर पारंपरिक ऑटोएन्कोडर्स में डिटerministic मैपिंग के बनाम VAEs में प्रायिकतामूलक एन्कोडिंग और सैंपलिंग द्वारा दृश्यात्मक रूप से प्रदर्शित होते हैं।
यह संरचनात्मक अंतर KL डाइवर्जेंस नामक टर्म के माध्यम से रेग्युलराइज़ेशन को शामिल करने के तरीके को उजागर करता है, जो लेटेंट स्पेस को सतत और सुव्यवस्थित बनाता है।
यह रेग्युलराइज़ेशन जनरेट किए गए सैंपल्स की गुणवत्ता और सामंजस्य को उल्लेखनीय रूप से बढ़ाता है, जो पारंपरिक ऑटोएन्कोडर्स की क्षमताओं से बेहतर है।
वैरिएशनल ऑटोएन्कोडर आर्किटेक्चर। लेखक द्वारा छवि
अनुप्रयोगों की तुलना
VAEs की प्रायिकतामूलक प्रकृति, पारंपरिक ऑटोएन्कोडर्स की तुलना में उनके अनुप्रयोगों की सीमा को काफ़ी बढ़ा देती है। इसके विपरीत, पारंपरिक ऑटोएन्कोडर्स उन अनुप्रयोगों में अत्यंत प्रभावी हैं जहाँ डेटerministic डेटा प्रतिनियोजन पर्याप्त है।
इसे बेहतर समझने के लिए, प्रत्येक के कुछ अनुप्रयोग देखते हैं।
VAEs के अनुप्रयोग
जनरेटिव मॉडलिंग. VAEs का मूल लाभ यह है कि वे प्रशिक्षण डेटा से मिलते-जुलते, पर किसी विशिष्ट इंस्टेंस के समान नहीं, नए डेटा सैंपल जनरेट कर सकते हैं। उदाहरण के लिए, इमेज सिंथेसिस में, VAEs प्रशिक्षण सेट जैसी लेकिन विविधताओं के साथ नई छवियाँ बना सकते हैं, जो नई कलाकृतियाँ बनाने, यथार्थपरक चेहरे जनरेट करने, या फ़ैशन और आर्किटेक्चर में नए डिज़ाइनों के लिए उपयोगी है।
एनॉमली डिटेक्शन. सामान्य डेटा के वितरण को सीखकर, VAEs इस वितरण से विचलनों को एनॉमली के रूप में पहचान सकते हैं। यह धोखाधड़ी का पता लगाने, नेटवर्क सुरक्षा, और प्रिडिक्टिव मेंटेनेंस जैसे अनुप्रयोगों में विशेष रूप से उपयोगी है।
डेटा इंप्यूटेशन और डीनॉयजिंग. VAEs की एक ताकत गायब या शोरयुक्त हिस्सों वाले डेटा का पुनर्निर्माण करना है। सीखे गए लेटेंट वितरण से सैंपल लेकर, वे गायब मानों का अनुमान लगा कर भर सकते हैं या भ्रष्ट डेटा से शोर हटाते हैं। यह मेडिकल इमेजिंग जैसे अनुप्रयोगों में मूल्यवान है, जहाँ सटीक पुनर्निर्माण आवश्यक होता है, या खराब हुई ऑडियो/वीडियो बहाली में।
सेमी-सुपरवाइज़्ड लर्निंग. सेमी-सुपरवाइज़्ड परिदृश्यों में, VAEs लेटेंट स्पेस का उपयोग अंतर्निहित डेटा संरचनाओं को कैप्चर करने के लिए करते हैं, जिससे सीमित लेबल वाले डेटा के साथ भी क्लासिफ़ायर के प्रदर्शन में सुधार होता है।
लेटेंट स्पेस मैनिपुलेशन. VAEs एक संरचित और सतत लेटेंट स्पेस प्रदान करते हैं जिसे विभिन्न अनुप्रयोगों के लिए बदला जा सकता है। उदाहरण के लिए, इमेज एडिटिंग में, विशिष्ट फीचर्स (जैसे प्रकाश या चेहरे के भाव) लेटेंट स्पेस में नेविगेट करके समायोजित किए जा सकते हैं। यह रचनात्मक उद्योगों में छवियों और वीडियोज़ को मॉडिफ़ाई और एन्हांस करने में विशेष रूप से उपयोगी है।
पारंपरिक ऑटोएन्कोडर्स के अनुप्रयोग
आयामीयता में कमी. पारंपरिक ऑटोएन्कोडर्स का उपयोग डेटा की आयामीयता कम करने के लिए व्यापक रूप से किया जाता है। डेटा को कम-आयामी लेटेंट स्पेस में एन्कोड कर और फिर पुनर्निर्मित करके, वे डेटा की सबसे महत्वपूर्ण विशेषताओं को कैप्चर कर सकते हैं। यह डेटा विज़ुअलाइज़ेशन जैसे परिदृश्यों में उपयोगी है, जहाँ उच्च-आयामी डेटा को दो या तीन आयामों में प्रक्षेपित करना होता है, और अन्य मशीन लर्निंग मॉडलों के प्रीप्रोसेसिंग चरण में प्रदर्शन सुधारने और संगणनात्मक लागत घटाने के लिए।
फ़ीचर निष्कर्षण. एन्कोडर को इनपुट डेटा के आवश्यक पहलुओं को कैप्चर करना सिखाकर, लेटेंट प्रतिनियोजन को डाउनस्ट्रीम कार्यों जैसे क्लासिफिकेशन, क्लस्टरिंग, और रिग्रेशन के लिए कॉम्पैक्ट फीचर वेक्टर के रूप में उपयोग किया जा सकता है। यह इमेज रिकग्निशन जैसे अनुप्रयोगों में विशेष रूप से लाभकारी है, जहाँ लेटेंट स्पेस महत्वपूर्ण दृश्य पैटर्न उजागर कर सकता है।
डीनॉयजिंग. पारंपरिक ऑटोएन्कोडर्स शोरयुक्त संस्करणों से स्वच्छ इनपुट्स का पुनर्निर्माण सीखकर डेटा का डीनॉयजिंग करने में प्रभावी हैं। यह इमेज प्रोसेसिंग जैसी स्थितियों में मूल्यवान है, जहाँ छवियों से शोर हटाने से दृश्य गुणवत्ता बढ़ती है, और सिग्नल प्रोसेसिंग में, जहाँ यह ऑडियो सिग्नल की स्पष्टता सुधार सकता है।
डेटा संपीड़न. कॉम्पैक्ट लेटेंट वेक्टर मूल उच्च-आयामी डेटा की तुलना में अधिक कुशलता से संग्रहीत या प्रेषित किए जा सकते हैं, और आवश्यकता पड़ने पर डीकोडर डेटा का पुनर्निर्माण कर सकता है। यह छवि और वीडियो कम्प्रेशन जैसे अनुप्रयोगों में विशेष रूप से उपयोगी है।
इमेज पुनर्निर्माण और इनपेंटिंग. पारंपरिक ऑटोएन्कोडर्स का उपयोग छवियों के गायब हिस्सों के पुनर्निर्माण में किया जा सकता है। इमेज इनपेंटिंग में, ऑटोएन्कोडर को एक छवि के गायब या भ्रष्ट क्षेत्रों को आस-पास के पिक्सेल्स द्वारा प्रदान किए गए संदर्भ के आधार पर भरने के लिए प्रशिक्षित किया जाता है। यह कंप्यूटर विज़न और डिजिटल रिस्टोरेशन जैसे क्षेत्रों में उपयोगी है।
सीक्वेंस लर्निंग. ऑटोएन्कोडर्स को आवर्ती या कॉन्वोल्यूशनल लेयर्स का उपयोग करके अनुक्रमिक डेटा के साथ काम करने के लिए अनुकूलित किया जा सकता है। वे समय-आधारित निर्भरताओं और पैटर्न्स को कैप्चर कर सकते हैं, जिससे वे टेक्स्ट जनरेशन, स्पीच सिंथेसिस, और वित्तीय पूर्वानुमान जैसे अनुप्रयोगों में उपयोगी बनते हैं।
वैरिएशनल ऑटोएन्कोडर्स के प्रकार
VAEs मशीन लर्निंग में विभिन्न चुनौतियों और अनुप्रयोगों को संबोधित करने के लिए कई विशेष रूपों में विकसित हुए हैं। इस खंड में, हम सबसे प्रमुख प्रकारों की समीक्षा करेंगे, उनके उपयोग-केस, फायदे, और सीमाएँ उजागर करते हुए।
कंडीशनल वैरिएशनल ऑटोएन्कोडर
कंडीशनल वैरिएशनल ऑटोएन्कोडर्स (CVAEs) VAEs का एक विशेष रूप हैं जो अतिरिक्त जानकारी पर कंडीशन करके जनरेटिव प्रक्रिया को बेहतर बनाते हैं।
एक VAE कंडीशनल तब बनता है जब अतिरिक्त जानकारी, जिसे c द्वारा दर्शाया जाता है, एन्कोडर और डीकोडर दोनों नेटवर्क्स में शामिल की जाती है। यह कंडीशनिंग जानकारी कोई भी प्रासंगिक डेटा हो सकता है, जैसे क्लास लेबल्स, एट्रिब्यूट्स, या अन्य सन्दर्भीय डेटा।
नियंत्रित डेटा जनरेशन. उदाहरण के लिए, इमेज जनरेशन में, CVAE दिए गए लेबल्स या विवरणों के आधार पर विशिष्ट ऑब्जेक्ट्स या दृश्य की छवियाँ बना सकता है।
इमेज-टू-इमेज ट्रांसलेशन. CVAEs विशिष्ट एट्रिब्यूट्स को बनाए रखते हुए एक डोमेन से दूसरे में छवियों को ट्रांसफ़ॉर्म कर सकते हैं। उदाहरण के लिए, वे ब्लैक-एंड-व्हाइट छवियों को रंगीन में बदल सकते हैं या स्केच को यथार्थपरक फ़ोटो में परिवर्तित कर सकते हैं।
टेक्स्ट जनरेशन. CVAEs विशिष्ट प्रॉम्प्ट्स या विषयों पर कंडीशन करके टेक्स्ट जनरेट कर सकते हैं, जो कहानी निर्माण, चैटबॉट प्रतिक्रियाएँ, और वैयक्तिक सामग्री निर्माण जैसे कार्यों में उपयोगी है।
फायदे और सीमाएँ:
जनरेट किए गए डेटा पर अधिक सूक्ष्म नियंत्रण
प्रतिनियोजन लर्निंग में सुधार
ओवरफ़िटिंग का बढ़ा जोखिम
अन्य वैरिएंट्स
डिज़एन्टैंगल्ड वैरिएशनल ऑटोएन्कोडर्स, जिन्हें अक्सर बीटा-VAEs कहा जाता है, VAEs का एक और विशेष प्रकार हैं। इनका उद्देश्य ऐसे लेटेंट प्रतिनियोजन सीखना है जहाँ हर आयाम डेटा में भिन्नता के एक अलग और व्याख्यायोग्य कारक को कैप्चर करे। यह मूल VAE उद्देश्य को एक हाइपरपैरामीटर β से संशोधित करके प्राप्त होता है, जो रिकंस्ट्रक्शन लॉस और KL डाइवर्जेंस टर्म के बीच संतुलन बनाता है।
बीटा-VAEs के फायदे और सीमाएँ:
लेटेंट कारकों की व्याख्यात्मकता में सुधार।
जनरेट किए गए डेटा की व्यक्तिगत विशेषताओं में बदलाव की बेहतर क्षमता।
β पैरामीटर की सावधानी से ट्यूनिंग की आवश्यकता।
यदि टर्म्स के बीच संतुलन इष्टतम न हो तो पुनर्निर्माण गुणवत्ता घट सकती है।
VAEs का एक और वैरिएंट है एडवर्सेरियल ऑटोएन्कोडर्स(AAEs)। AAEs VAE ढांचे को जनरेटिव एडवर्सेरियल नेटवर्क्स (GANs) से आने वाले एडवर्सेरियल प्रशिक्षण सिद्धांतों के साथ जोड़ते हैं। एक अतिरिक्त डिस्क्रिमिनेटर नेटवर्क सुनिश्चित करता है कि लेटेंट प्रतिनियोजन एक प्रायर वितरण से मेल खाते हों, जिससे मॉडल की जनरेटिव क्षमताएँ बढ़ती हैं।
AAEs के फायदे और सीमाएँ:
उच्च-गुणवत्ता और यथार्थपरक डेटा सैंपल उत्पन्न करता है।
लेटेंट स्पेस को रेग्युलराइज़ करने में प्रभावी।
एडवर्सेरियल घटक के कारण प्रशिक्षण जटिलता बढ़ती है।
GANs जैसी प्रशिक्षण स्थिरता से संबंधित संभावित समस्याएँ।
अब, हम वैरिएशनल ऑटोएन्कोडर्स के दो और एक्सटेंशनों को देखेंगे।
पहला है वैरिएशनल रिकरेंट ऑटोएन्कोडर्स (VRAEs)। VRAEs एन्कोडर और डीकोडर नेटवर्क्स में रिकरेंट न्यूरल नेटवर्क्स (RNNs) को शामिल करके VAE ढांचे को अनुक्रमिक डेटा तक विस्तारित करते हैं। इससे VRAEs समय-आधारित निर्भरताओं और अनुक्रमिक पैटर्न्स को कैप्चर कर पाते हैं।
VRAEs के फायदे और सीमाएँ:
टाइम-सीरीज़ डेटा और अनुक्रमिक पैटर्न्स को संभालने में प्रभावी।
स्पीच सिंथेसिस, म्यूज़िक जनरेशन, और टाइम-सीरीज़ फ़ोरकास्टिंग जैसे अनुप्रयोगों में उपयोगी।
मॉडल की रिकरेंट प्रकृति के कारण उच्च संगणनात्मक आवश्यकताएँ।
अंतिम वैरिएंट जिसे हम देखेंगे वह है हाइरार्किकल वैरिएशनलऑटोएन्कोडर्स (HVAEs). HVAEs एक पदानुक्रमित संरचना में व्यवस्थित कई लेटेंट वेरिएबल लेयर्स पेश करते हैं, जो मॉडल को डेटा में अधिक जटिल निर्भरताओं और अमूर्तताओं (abstractions) को कैप्चर करने में सक्षम बनाता है।
HVAEs के फायदे और सीमाएँ:
पदानुक्रमित संरचनाओं वाले जटिल डेटा वितरणों का मॉडलिंग करने में सक्षम।
अधिक अभिव्यंजक लेटेंट प्रतिनियोजन प्रदान करता है।
मॉडल जटिलता और संगणनात्मक लागत में वृद्धि।
PyTorch के साथ वैरिएशनल ऑटोएन्कोडर लागू करना
इस खंड में, हम PyTorch का उपयोग करके एक सरल वैरिएशनल ऑटोएन्कोडर (VAE) लागू करेंगे।
1. वातावरण तैयार करना
VAE को लागू करने के लिए, हमें आवश्यक लाइब्रेरी और टूल्स के साथ अपना Python वातावरण सेटअप करना होगा। जिन लाइब्रेरीज़ का उपयोग किया जाएगा, वे हैं:
PyTorch
torchvision
matplotlib
numpy
इन लाइब्रेरीज़ को इंस्टॉल करने के लिए कोड इस प्रकार है:
pip install torch torchvision matplotlib numpyसंचालित द्वारा
2. इम्प्लीमेंटेशन
आइए VAE के इम्प्लीमेंटेशन को चरण-दर-चरण समझें। पहले, हमें लाइब्रेरीज़ इम्पोर्ट करनी होंगी:
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
import matplotlib.pyplot as plt
import numpy as npसंचालित द्वारा
अगला, हमें एन्कोडर, डीकोडर, और VAE परिभाषित करने होंगे। कोड इस प्रकार है:
हमें लॉस फ़ंक्शन भी परिभाषित करना होगा। VAE का लॉस फ़ंक्शन रिकंस्ट्रक्शन लॉस और KL डाइवर्जेंस लॉस से मिलकर बना होता है। PyTorch में यह इस तरह दिखता है:
आउटपुट्स का दृश्यांकन। सबसे ऊपर की पंक्ति मूल MNIST डेटा है, बीच की पंक्ति पुनर्निर्मित आउटपुट्स है, और अंतिम पंक्ति जनरेट किए गए सैंपल्स—लेखक द्वारा छवि।
वैरिएशनल ऑटोएन्कोडर्स: चुनौतियाँ और समाधान
हालाँकि वैरिएशनल ऑटोएन्कोडर्स (VAEs) जनरेटिव मॉडलिंग के लिए शक्तिशाली उपकरण हैं, वे कई चुनौतियों और सीमाओं के साथ आते हैं जो उनके प्रदर्शन को प्रभावित कर सकते हैं। आइए उनमें से कुछ पर चर्चा करें, और निवारण रणनीतियाँ प्रदान करें।
मोड कोलैप्स
यह एक ऐसी घटना है जहाँ VAE डेटा वितरण की पूरी विविधता को कैप्चर करने में विफल रहता है। परिणामस्वरूप जनरेट किए गए सैंपल्स डेटा वितरण के केवल कुछ ही मोड्स (अलग-अलग क्षेत्रों) का प्रतिनिधित्व करते हैं और दूसरों को नज़रअंदाज़ कर देते हैं। इससे आउटपुट्स में विविधता की कमी आती है।
मोड कोलैप्स के कारण:
लेटेंट स्पेस का खराब अन्वेषण: यदि ट्रेनिंग के दौरान लेटेंट स्पेस का पर्याप्त रूप से अन्वेषण नहीं होता, तो मॉडल केवल कुछ क्षेत्रों से सैंपल जनरेट करना ही सीख सकता है।
अपर्याप्त प्रशिक्षण डेटा: सीमित या अप्रतिनिधिक ट्रेनिंग डेटा मॉडल को विशिष्ट मोड्स पर ओवरफ़िट करा सकता है।
मोड कोलैप्स को निम्न तरीकों से कम किया जा सकता है:
रेग्युलराइज़ेशन तकनीकें: ड्रॉपआउट और बैच नॉर्मलाइज़ेशन जैसी तकनीकें सामान्यीकरण (generalization) में सुधार कर सकती हैं और मोड कोलैप्स को घटा सकती हैं।
सुधारित प्रशिक्षण एल्गोरिदम: इम्पॉर्टेंस-वेटेड ऑटोएन्कोडर्स (IWAE) बेहतर ग्रेडिएंट अनुमानों के माध्यम से लेटेंट स्पेस अन्वेषण में सुधार कर सकते हैं।
अनसूचनात्मक लेटेंट स्पेस
कुछ मामलों में, VAE द्वारा सीखा गया लेटेंट स्पेस अनसूचनात्मक हो सकता है, जहाँ मॉडल इनपुट डेटा की सार्थक विशेषताओं को कैप्चर करने के लिए लेटेंट वेरिएबल्स का प्रभावी ढंग से उपयोग नहीं करता। इससे जनरेट किए गए सैंपल्स और पुनर्निर्माण की गुणवत्ता घट सकती है।
यह आमतौर पर निम्न कारणों से होता है:
लॉस घटकों में असंतुलन: रिकंस्ट्रक्शन लॉस और KL डाइवर्जेंस के बीच ट्रेड-ऑफ़ का सही संतुलन न होने पर लेटेंट वेरिएबल्स नज़रअंदाज़ हो सकते हैं।
पोस्टेरियर कोलैप्स: एन्कोडर ऐसा पोस्टेरियर वितरण आउटपुट करना सीख लेता है जो प्रायर के बहुत करीब होता है, जिसके कारण लेटेंट स्पेस में सूचना का नुकसान होता है।
अनसूचनात्मक लेटेंट स्पेस को वॉर्म-अप रणनीति का उपयोग करके सुधारा जा सकता है, जिसमें ट्रेनिंग के दौरान KL डाइवर्जेंस के वज़न को धीरे-धीरे बढ़ाना शामिल है, या लॉस फ़ंक्शन में KL डाइवर्जेंस टर्म के वज़न को सीधे संशोधित करके।
प्रशिक्षण अस्थिरता
कभी-कभी VAEs का प्रशिक्षण अस्थिर हो सकता है, जिसमें लॉस फ़ंक्शन दोलन करता है या विचलित हो जाता है। इससे अभिसरण (convergence) हासिल करना और अच्छी तरह प्रशिक्षित मॉडल प्राप्त करना कठिन हो सकता है।
यह निम्न कारणों से होता है:
जटिल लॉस परिदृश्य: VAE का लॉस फ़ंक्शन रिकंस्ट्रक्शन और रेग्युलराइज़ेशन टर्म्स को मिलाता है, जिससे अनुकूलन परिदृश्य जटिल हो जाता है।
हाइपरपैरामीटर संवेदनशीलता: VAEs, लर्निंग रेट, KL डाइवर्जेंस के वज़न, और न्यूरल नेटवर्क की आर्किटेक्चर जैसे हाइपरपैरामीटर्स की पसंद के प्रति संवेदनशील होते हैं।
प्रशिक्षण अस्थिरता को कम करने के चरणों में शामिल हैं:
हाइपरपैरामीटर्स का सावधानीपूर्वक ट्यूनिंग: हाइपरपैरामीटर्स का व्यवस्थित अन्वेषण प्रशिक्षण के लिए स्थिर कॉन्फ़िगरेशन खोजने में मदद कर सकता है।
उन्नत ऑप्टिमाइज़र्स: Adam जैसे अनुकूली लर्निंग रेट ऑप्टिमाइज़र जटिल लॉस परिदृश्य को अधिक प्रभावी ढंग से नेविगेट करने में मदद कर सकते हैं।
संगणनात्मक लागत
विशेष रूप से बड़े और जटिल डेटासेट्स के साथ VAEs को प्रशिक्षित करना संगणनात्मक रूप से महंगा हो सकता है। इसका कारण सैंपलिंग और स्टोकेस्टिक लेयर्स के माध्यम से बैकप्रोपेगेशन की आवश्यकता है।
उच्च संगणनात्मक लागत के कारणों में शामिल हैं:
बड़े नेटवर्क्स: एन्कोडर और डीकोडर नेटवर्क बड़े और गहरे हो सकते हैं, जिससे संगणनात्मक भार बढ़ता है।
लेटेंट स्पेस सैंपलिंग: लेटेंट स्पेस से सैंपल लेना और इन सैंपल्स के माध्यम से ग्रेडिएंट्स की गणना करना संगणनात्मक लागत बढ़ा सकता है।
इनके निवारण के उपाय:
मॉडल सरलीकरण: एन्कोडर और डीकोडर नेटवर्क्स की जटिलता कम करना संगणनात्मक लागत घटाने में मदद कर सकता है।
कुशल सैंपलिंग तकनीकें: अधिक कुशल सैंपलिंग विधियाँ या अनुमानों का उपयोग संगणनात्मक लोड कम कर सकता है।
निष्कर्ष
वैरिएशनल ऑटोएन्कोडर्स (VAEs) मशीन लर्निंग और डेटा जनरेशन के क्षेत्र में एक क्रांतिकारी प्रगति साबित हुए हैं।
पारंपरिक ऑटोएन्कोडर ढांचे में प्रायिकतामूलक तत्व जोड़कर, VAEs नया, उच्च-गुणवत्ता वाला डेटा जनरेट करने में सक्षम बनाते हैं और एक अधिक संरचित और सतत लेटेंट स्पेस प्रदान करते हैं। इस अनूठी क्षमता ने जनरेटिव मॉडलिंग और एनॉमली डिटेक्शन से लेकर डेटा इंप्यूटेशन और सेमी-सुपरवाइज़्ड लर्निंग तक, अनुप्रयोगों की एक विस्तृत श्रृंखला का द्वार खोला है।
इस लेख में, हमने वैरिएशनल ऑटोएन्कोडर्स की बुनियादी बातें, विभिन्न प्रकार, PyTorch में VAEs को कैसे लागू करें, साथ ही VAEs के साथ काम करते समय आने वाली चुनौतियाँ और उनके समाधान कवर किए हैं।
एक ऑटोएन्कोडर और वैरिएशनल ऑटोएन्कोडर में क्या अंतर है? ⌄
एक ऑटोएन्कोडर वह न्यूरल नेटवर्क है जो इनपुट डेटा को कम-आयामी लेटेंट स्पेस में कंप्रेस करता है और फिर उसका पुनर्निर्माण करता है, प्रत्येक इनपुट को इस स्पेस में एक स्थिर बिंदु पर डेटerministically मैप करता है। वैरिएशनल ऑटोएन्कोडर (VAE) इसे आगे बढ़ाते हुए इनपुट्स को लेटेंट स्पेस पर एक प्रायिकता वितरण—आमतौर पर गॉसियन—में एन्कोड करता है। यह प्रायिकतामूलक दृष्टिकोण VAEs को लेटेंट वितरण से सैंपल लेने देता है, जिससे नए, विविध डेटा इंस्टेंस जनरेट करना और डेटा की विविधता का बेहतर मॉडलिंग संभव होता है।
VAEs का उपयोग किस लिए किया जाता है? ⌄
वैरिएशनल ऑटोएन्कोडर्स (VAEs) नए, उच्च-गुणवत्ता वाले डेटा सैंपल्स जनरेट करने के लिए उपयोग किए जाते हैं, जो इमेज सिंथेसिस और डेटा ऑगमेंटेशन जैसे अनुप्रयोगों में मूल्यवान हैं। वे एनॉमली डिटेक्शन में भी उपयोग होते हैं, जहाँ वे सीखे गए डेटा वितरणों से विचलनों की पहचान करते हैं, और डेटा डीनॉयजिंग व इंप्यूटेशन में, जहाँ वे गायब या भ्रष्ट डेटा का पुनर्निर्माण करते हैं।
वैरिएशनल ऑटोएन्कोडर्स के फ़ायदे क्या हैं? ⌄
VAEs एक सतत और संरचित लेटेंट स्पेस सीखकर विविध और उच्च-गुणवत्ता वाले डेटा सैंपल जनरेट करते हैं। वे डेटा प्रतिनियोजन में मजबूती भी बढ़ाते हैं और अनिश्चितता को प्रभावी ढंग से संभालने में सक्षम बनाते हैं, जो एनॉमली डिटेक्शन, डेटा डीनॉयजिंग, और सेमी-सुपरवाइज़्ड लर्निंग जैसे कार्यों में विशेष रूप से उपयोगी है।
ऑटोएन्कोडर की बजाय VAE का उपयोग क्यों करें? ⌄
वैरिएशनल ऑटोएन्कोडर्स (VAEs) एन्कोडिंग के लिए प्रायिकतामूलक दृष्टिकोण प्रदान करते हैं, जिससे वे एक सतत लेटेंट स्पेस वितरण का मॉडलिंग करके विविध और नवीन डेटा सैंपल जनरेट कर पाते हैं। पारंपरिक ऑटोएन्कोडर्स, जो स्थिर लेटेंट प्रतिनियोजन देते हैं, के विपरीत, VAEs डेटा जनरेशन क्षमताओं को बढ़ाते हैं और डेटा में अनिश्चितता और विविधता को बेहतर ढंग से संभालते हैं।
वैरिएशनल ऑटोएन्कोडर्स की कमियाँ क्या हैं? ⌄
वैरिएशनल ऑटोएन्कोडर्स (VAEs) मोड कोलैप्स जैसी समस्याओं से ग्रस्त हो सकते हैं, जहाँ वे डेटा वितरण की पूरी विविधता को कैप्चर करने में विफल रहते हैं, जिससे कम विविध जनरेट किए गए सैंपल्स मिलते हैं। अतिरिक्त रूप से, वे अन्य जनरेटिव मॉडलों जैसे GANs की तुलना में धुंधले या कम विस्तृत आउटपुट दे सकते हैं, और इनका प्रशिक्षण संगणनात्मक रूप से भारी और अस्थिर हो सकता है।
जानें कि जनरेटिव AI का जिम्मेदारी से उपयोग कैसे शुरू करें। जानें कि जनरेटिव AI मॉडल कैसे विकसित किए जाते हैं और आगे चलकर वे समाज को कैसे प्रभावित करेंगे।


जैसे-जैसे मशीन लर्निंग तकनीक अभूतपूर्व गति से आगे बढ़ रही है, वैरिएशनल ऑटोएन्कोडर्स (VAEs) डेटा को प्रोसेस और जनरेट करने के तरीके में क्रांतिकारी बदलाव ला रहे हैं। शक्तिशाली डेटा एन्कोडिंग को अभिनव जनरेटिव क्षमताओं के साथ जोड़कर, VAEs इस क्षेत्र की जटिल चुनौतियों के लिए रूपांतरकारी समाधान प्रस्तुत करते हैं।
इस लेख में, हम VAEs के मूल सिद्धांतों, उनके अनुप्रयोगों, और उन्हें PyTorch के उपयोग से चरण-दर-चरण प्रभावी ढंग से कैसे लागू किया जा सकता है, इसकी पड़ताल करेंगे।
वैरिएशनल ऑटोएन्कोडर क्या है?
ऑटोएन्कोडर एक प्रकार का न्यूरल नेटवर्क है जिसे कुशल डेटा प्रतिनियोजन (representations) सीखने के लिए डिज़ाइन किया गया है, मुख्यतः आयामीयता में कमी या फीचर लर्निंग के उद्देश्य से।
ऑटोएन्कोडर दो मुख्य भागों से मिलकर बनते हैं:
ऑटोएन्कोडर्स का मुख्य उद्देश्य इनपुट और पुनर्निर्मित आउटपुट के बीच के अंतर को न्यूनतम करना है, ताकि डेटा का एक कॉम्पैक्ट प्रतिनियोजन सीखा जा सके।
यहीं आते हैं वैरिएशनल ऑटोएन्कोडर्स (VAEs), जो एन्कोडिंग प्रक्रिया में प्रायिकतामूलक (probabilistic) तत्वों को शामिल करके पारंपरिक ऑटोएन्कोडर ढांचे की क्षमताओं का विस्तार करते हैं।
जहाँ मानक ऑटोएन्कोडर्स इनपुट्स को स्थिर लेटेंट प्रतिनियोजनों पर मैप करते हैं, वहीं VAEs एक प्रायिकतामूलक दृष्टिकोण लाते हैं जिसमें एन्कोडर लेटेंट स्पेस पर एक वितरण आउटपुट करता है, जिसे आमतौर पर मल्टिवेरिएट गॉसियन के रूप में मॉडल किया जाता है। इससे डीकोडिंग के दौरान इस वितरण से सैंपल लेना संभव होता है, जिसके परिणामस्वरूप नए डेटा इंस्टेंस उत्पन्न होते हैं।
VAEs का प्रमुख नवाचार उनके एक संरचित, सतत लेटेंट स्पेस को सीखकर नया, उच्च-गुणवत्ता वाला डेटा जनरेट करने की क्षमता में निहित है। यह जनरेटिव मॉडलिंग के लिए विशेष रूप से महत्वपूर्ण है, जहाँ लक्ष्य केवल डेटा को संकुचित करना नहीं, बल्कि मूल डेटासेट से मिलते-जुलते नए सैंपल बनाना होता है।
VAEs ने छवि संश्लेषण, डेटा डीनॉयजिंग, और एनॉमली डिटेक्शन जैसे कार्यों में उल्लेखनीय प्रभावशीलता दिखाई है, जिससे वे मशीन लर्निंग मॉडल और अनुप्रयोगों की क्षमताओं को आगे बढ़ाने के लिए प्रासंगिक उपकरण बन जाते हैं।
वैरिएशनल ऑटोएन्कोडर्स का सैद्धांतिक पृष्ठभूमि
इस खंड में, हम VAEs की सैद्धांतिक पृष्ठभूमि और उनके संचालन तंत्र का परिचय देंगे, ताकि आगे के खंडों में उनके अनुप्रयोगों का अन्वेषण करने के लिए आपकी मजबूत बुनियाद बने।
एन्कोडर्स से शुरू करते हैं। एन्कोडर एक न्यूरल नेटवर्क है जो इनपुट डेटा को लेटेंट स्पेस में मैप करने के लिए जिम्मेदार है। पारंपरिक ऑटोएन्कोडर्स के विपरीत जो लेटेंट स्पेस में एक स्थिर बिंदु देते हैं, VAE में एन्कोडर एक प्रायिकता वितरण के पैरामीटर—आमतौर पर गॉसियन वितरण का माध्य (mean) और विचलन (variance)—आउटपुट करता है। इससे VAE डेटा की अनिश्चितता और विविधता को प्रभावी ढंग से मॉडल कर पाता है।
डीकोडर नामक एक अन्य न्यूरल नेटवर्क का उपयोग लेटेंट स्पेस प्रतिनियोजन से मूल डेटा को पुनर्निर्मित करने के लिए किया जाता है। लेटेंट स्पेस वितरण से लिए गए सैंपल के आधार पर, डीकोडर ऐसा आउटपुट जनरेट करने का प्रयास करता है जो मूल इनपुट डेटा से काफ़ी मेल खाता हो। यह प्रक्रिया VAE को सीखे गए वितरण से सैंपल लेकर नए डेटा इंस्टेंस बनाने देती है।
लेटेंट स्पेस एक कम-आयामी, सतत स्पेस है जिसमें इनपुट डेटा को एन्कोड किया जाता है।
एन्कोडर, डीकोडर, और लेटेंट स्पेस की भूमिका का दृश्यांकन। छवि का स्रोत।
वैरिएशनल एप्रोच एक तकनीक है जिसका उपयोग जटिल प्रायिकता वितरणों का सन्निकटन (approximation) करने के लिए किया जाता है। VAEs के संदर्भ में, यह दिए गए डेटा पर लेटेंट वेरिएबल्स के ट्रू पोस्टेरियर वितरण का सन्निकटन करने से जुड़ा है, जो अक्सर असंभव (intractable) होता है।
VAE एक अनुमानित पोस्टेरियर वितरण सीखता है। लक्ष्य यह है कि यह सन्निकटन ट्रू पोस्टेरियर के जितना संभव हो उतना निकट हो।
बायेज़ियन इन्फरेंस किसी परिकल्पना की संभावना के आकलन को नई साक्ष्य या सूचना उपलब्ध होने पर अपडेट करने की विधि है। VAEs में, बायेज़ियन इन्फरेंस का उपयोग लेटेंट वेरिएबल्स के वितरण का आकलन करने के लिए किया जाता है।
पूर्व ज्ञान (prior distribution) को अवलोकित डेटा (likelihood) के साथ एकीकृत करके, VAEs सीखे गए पोस्टेरियर वितरण के माध्यम से लेटेंट स्पेस प्रतिनियोजन को समायोजित करते हैं।
प्रायर वितरण, पोस्टेरियर वितरण, और लाइकलीहुड फंक्शन के साथ बायेज़ियन इन्फरेंस। छवि का स्रोत।
प्रक्रिया प्रवाह इस प्रकार दिखता है:
वैरिएशनल ऑटोएन्कोडर बनाम पारंपरिक ऑटोएन्कोडर
आइए पारंपरिक ऑटोएन्कोडर्स पर VAEs के अंतरों और फ़ायदों की जाँच करें।
आर्किटेक्चर की तुलना
जैसा कि पहले देखा गया, पारंपरिक ऑटोएन्कोडर्स में एक एन्कोडर नेटवर्क होता है जो इनपुट डेटा x को एक स्थिर, कम-आयामी लेटेंट स्पेस प्रतिनियोजन z में मैप करता है। यह प्रक्रिया डेटerministic होती है, यानी हर इनपुट लेटेंट स्पेस में एक विशिष्ट बिंदु पर एन्कोड होता है।
इसके बाद डीकोडर नेटवर्क इस स्थिर लेटेंट प्रतिनियोजन से मूल डेटा का पुनर्निर्माण करता है, उद्देश्य इनपुट और उसके पुनर्निर्माण के बीच अंतर को न्यूनतम करना होता है।
पारंपरिक ऑटोएन्कोडर्स का लेटेंट स्पेस इनपुट डेटा का एक संकुचित प्रतिनियोजन होता है जिसमें कोई प्रायिकतामूलक मॉडलिंग नहीं होती, जिससे नई, विविध डेटा जनरेशन की क्षमता सीमित हो जाती है क्योंकि अनिश्चितता संभालने का तंत्र मौजूद नहीं होता।
ऑटोएन्कोडर आर्किटेक्चर। लेखक द्वारा छवि
VAEs एन्कोडिंग प्रक्रिया में प्रायिकतामूलक तत्व जोड़ते हैं। यानी, VAE का एन्कोडर इनपुट डेटा को लेटेंट वेरिएबल्स पर एक प्रायिकता वितरण में मैप करता है, जिसे प्रायः माध्य mean μ और विचलन σ2. वाली गॉसियन के रूप में मॉडल किया जाता है।
यह दृष्टिकोण हर इनपुट को एकल बिंदु की बजाय एक वितरण में एन्कोड करता है, जिससे विभिन्नता और अनिश्चितता की एक परत जुड़ती है।
आर्किटेक्चरल अंतर पारंपरिक ऑटोएन्कोडर्स में डिटerministic मैपिंग के बनाम VAEs में प्रायिकतामूलक एन्कोडिंग और सैंपलिंग द्वारा दृश्यात्मक रूप से प्रदर्शित होते हैं।
यह संरचनात्मक अंतर KL डाइवर्जेंस नामक टर्म के माध्यम से रेग्युलराइज़ेशन को शामिल करने के तरीके को उजागर करता है, जो लेटेंट स्पेस को सतत और सुव्यवस्थित बनाता है।
यह रेग्युलराइज़ेशन जनरेट किए गए सैंपल्स की गुणवत्ता और सामंजस्य को उल्लेखनीय रूप से बढ़ाता है, जो पारंपरिक ऑटोएन्कोडर्स की क्षमताओं से बेहतर है।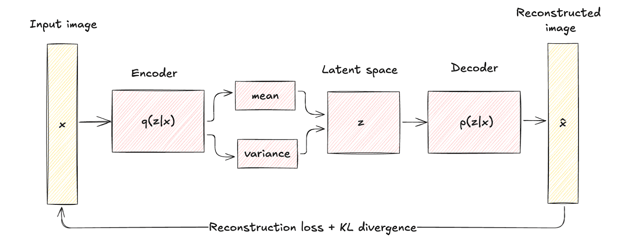
वैरिएशनल ऑटोएन्कोडर आर्किटेक्चर। लेखक द्वारा छवि
अनुप्रयोगों की तुलना
VAEs की प्रायिकतामूलक प्रकृति, पारंपरिक ऑटोएन्कोडर्स की तुलना में उनके अनुप्रयोगों की सीमा को काफ़ी बढ़ा देती है। इसके विपरीत, पारंपरिक ऑटोएन्कोडर्स उन अनुप्रयोगों में अत्यंत प्रभावी हैं जहाँ डेटerministic डेटा प्रतिनियोजन पर्याप्त है।
इसे बेहतर समझने के लिए, प्रत्येक के कुछ अनुप्रयोग देखते हैं।
VAEs के अनुप्रयोग
पारंपरिक ऑटोएन्कोडर्स के अनुप्रयोग
वैरिएशनल ऑटोएन्कोडर्स के प्रकार
VAEs मशीन लर्निंग में विभिन्न चुनौतियों और अनुप्रयोगों को संबोधित करने के लिए कई विशेष रूपों में विकसित हुए हैं। इस खंड में, हम सबसे प्रमुख प्रकारों की समीक्षा करेंगे, उनके उपयोग-केस, फायदे, और सीमाएँ उजागर करते हुए।
कंडीशनल वैरिएशनल ऑटोएन्कोडर
कंडीशनल वैरिएशनल ऑटोएन्कोडर्स (CVAEs) VAEs का एक विशेष रूप हैं जो अतिरिक्त जानकारी पर कंडीशन करके जनरेटिव प्रक्रिया को बेहतर बनाते हैं।
एक VAE कंडीशनल तब बनता है जब अतिरिक्त जानकारी, जिसे c द्वारा दर्शाया जाता है, एन्कोडर और डीकोडर दोनों नेटवर्क्स में शामिल की जाती है। यह कंडीशनिंग जानकारी कोई भी प्रासंगिक डेटा हो सकता है, जैसे क्लास लेबल्स, एट्रिब्यूट्स, या अन्य सन्दर्भीय डेटा।
CVAE मॉडल संरचना। छवि का स्रोत।
CVAEs के उपयोग-केस शामिल हैं:
फायदे और सीमाएँ:
अन्य वैरिएंट्स
डिज़एन्टैंगल्ड वैरिएशनल ऑटोएन्कोडर्स, जिन्हें अक्सर बीटा-VAEs कहा जाता है, VAEs का एक और विशेष प्रकार हैं। इनका उद्देश्य ऐसे लेटेंट प्रतिनियोजन सीखना है जहाँ हर आयाम डेटा में भिन्नता के एक अलग और व्याख्यायोग्य कारक को कैप्चर करे। यह मूल VAE उद्देश्य को एक हाइपरपैरामीटर β से संशोधित करके प्राप्त होता है, जो रिकंस्ट्रक्शन लॉस और KL डाइवर्जेंस टर्म के बीच संतुलन बनाता है।
बीटा-VAEs के फायदे और सीमाएँ:
VAEs का एक और वैरिएंट है एडवर्सेरियल ऑटोएन्कोडर्स (AAEs)। AAEs VAE ढांचे को जनरेटिव एडवर्सेरियल नेटवर्क्स (GANs) से आने वाले एडवर्सेरियल प्रशिक्षण सिद्धांतों के साथ जोड़ते हैं। एक अतिरिक्त डिस्क्रिमिनेटर नेटवर्क सुनिश्चित करता है कि लेटेंट प्रतिनियोजन एक प्रायर वितरण से मेल खाते हों, जिससे मॉडल की जनरेटिव क्षमताएँ बढ़ती हैं।
AAEs के फायदे और सीमाएँ:
अब, हम वैरिएशनल ऑटोएन्कोडर्स के दो और एक्सटेंशनों को देखेंगे।
पहला है वैरिएशनल रिकरेंट ऑटोएन्कोडर्स (VRAEs)। VRAEs एन्कोडर और डीकोडर नेटवर्क्स में रिकरेंट न्यूरल नेटवर्क्स (RNNs) को शामिल करके VAE ढांचे को अनुक्रमिक डेटा तक विस्तारित करते हैं। इससे VRAEs समय-आधारित निर्भरताओं और अनुक्रमिक पैटर्न्स को कैप्चर कर पाते हैं।
VRAEs के फायदे और सीमाएँ:
अंतिम वैरिएंट जिसे हम देखेंगे वह है हाइरार्किकल वैरिएशनल ऑटोएन्कोडर्स (HVAEs). HVAEs एक पदानुक्रमित संरचना में व्यवस्थित कई लेटेंट वेरिएबल लेयर्स पेश करते हैं, जो मॉडल को डेटा में अधिक जटिल निर्भरताओं और अमूर्तताओं (abstractions) को कैप्चर करने में सक्षम बनाता है।
HVAEs के फायदे और सीमाएँ:
PyTorch के साथ वैरिएशनल ऑटोएन्कोडर लागू करना
इस खंड में, हम PyTorch का उपयोग करके एक सरल वैरिएशनल ऑटोएन्कोडर (VAE) लागू करेंगे।
1. वातावरण तैयार करना
VAE को लागू करने के लिए, हमें आवश्यक लाइब्रेरी और टूल्स के साथ अपना Python वातावरण सेटअप करना होगा। जिन लाइब्रेरीज़ का उपयोग किया जाएगा, वे हैं:
इन लाइब्रेरीज़ को इंस्टॉल करने के लिए कोड इस प्रकार है:
2. इम्प्लीमेंटेशन
आइए VAE के इम्प्लीमेंटेशन को चरण-दर-चरण समझें। पहले, हमें लाइब्रेरीज़ इम्पोर्ट करनी होंगी:
अगला, हमें एन्कोडर, डीकोडर, और VAE परिभाषित करने होंगे। कोड इस प्रकार है:
हमें लॉस फ़ंक्शन भी परिभाषित करना होगा। VAE का लॉस फ़ंक्शन रिकंस्ट्रक्शन लॉस और KL डाइवर्जेंस लॉस से मिलकर बना होता है। PyTorch में यह इस तरह दिखता है:
VAE को प्रशिक्षित करने के लिए, हम MNIST डेटासेट लोड करेंगे, ऑप्टिमाइज़र परिभाषित करेंगे, और मॉडल को ट्रेन करेंगे।
3. मॉडल का परीक्षण और मूल्यांकन
ट्रेनिंग के बाद, हम पुनर्निर्मित आउटपुट्स और जनरेट किए गए सैंपल्स का दृश्यांकन करके VAE का मूल्यांकन कर सकते हैं।
कोड इस प्रकार है:
आउटपुट्स का दृश्यांकन। सबसे ऊपर की पंक्ति मूल MNIST डेटा है, बीच की पंक्ति पुनर्निर्मित आउटपुट्स है, और अंतिम पंक्ति जनरेट किए गए सैंपल्स—लेखक द्वारा छवि।
वैरिएशनल ऑटोएन्कोडर्स: चुनौतियाँ और समाधान
हालाँकि वैरिएशनल ऑटोएन्कोडर्स (VAEs) जनरेटिव मॉडलिंग के लिए शक्तिशाली उपकरण हैं, वे कई चुनौतियों और सीमाओं के साथ आते हैं जो उनके प्रदर्शन को प्रभावित कर सकते हैं। आइए उनमें से कुछ पर चर्चा करें, और निवारण रणनीतियाँ प्रदान करें।
मोड कोलैप्स
यह एक ऐसी घटना है जहाँ VAE डेटा वितरण की पूरी विविधता को कैप्चर करने में विफल रहता है। परिणामस्वरूप जनरेट किए गए सैंपल्स डेटा वितरण के केवल कुछ ही मोड्स (अलग-अलग क्षेत्रों) का प्रतिनिधित्व करते हैं और दूसरों को नज़रअंदाज़ कर देते हैं। इससे आउटपुट्स में विविधता की कमी आती है।
मोड कोलैप्स के कारण:
मोड कोलैप्स को निम्न तरीकों से कम किया जा सकता है:
अनसूचनात्मक लेटेंट स्पेस
कुछ मामलों में, VAE द्वारा सीखा गया लेटेंट स्पेस अनसूचनात्मक हो सकता है, जहाँ मॉडल इनपुट डेटा की सार्थक विशेषताओं को कैप्चर करने के लिए लेटेंट वेरिएबल्स का प्रभावी ढंग से उपयोग नहीं करता। इससे जनरेट किए गए सैंपल्स और पुनर्निर्माण की गुणवत्ता घट सकती है।
यह आमतौर पर निम्न कारणों से होता है:
अनसूचनात्मक लेटेंट स्पेस को वॉर्म-अप रणनीति का उपयोग करके सुधारा जा सकता है, जिसमें ट्रेनिंग के दौरान KL डाइवर्जेंस के वज़न को धीरे-धीरे बढ़ाना शामिल है, या लॉस फ़ंक्शन में KL डाइवर्जेंस टर्म के वज़न को सीधे संशोधित करके।
प्रशिक्षण अस्थिरता
कभी-कभी VAEs का प्रशिक्षण अस्थिर हो सकता है, जिसमें लॉस फ़ंक्शन दोलन करता है या विचलित हो जाता है। इससे अभिसरण (convergence) हासिल करना और अच्छी तरह प्रशिक्षित मॉडल प्राप्त करना कठिन हो सकता है।
यह निम्न कारणों से होता है:
प्रशिक्षण अस्थिरता को कम करने के चरणों में शामिल हैं:
संगणनात्मक लागत
विशेष रूप से बड़े और जटिल डेटासेट्स के साथ VAEs को प्रशिक्षित करना संगणनात्मक रूप से महंगा हो सकता है। इसका कारण सैंपलिंग और स्टोकेस्टिक लेयर्स के माध्यम से बैकप्रोपेगेशन की आवश्यकता है।
उच्च संगणनात्मक लागत के कारणों में शामिल हैं:
इनके निवारण के उपाय:
निष्कर्ष
वैरिएशनल ऑटोएन्कोडर्स (VAEs) मशीन लर्निंग और डेटा जनरेशन के क्षेत्र में एक क्रांतिकारी प्रगति साबित हुए हैं।
पारंपरिक ऑटोएन्कोडर ढांचे में प्रायिकतामूलक तत्व जोड़कर, VAEs नया, उच्च-गुणवत्ता वाला डेटा जनरेट करने में सक्षम बनाते हैं और एक अधिक संरचित और सतत लेटेंट स्पेस प्रदान करते हैं। इस अनूठी क्षमता ने जनरेटिव मॉडलिंग और एनॉमली डिटेक्शन से लेकर डेटा इंप्यूटेशन और सेमी-सुपरवाइज़्ड लर्निंग तक, अनुप्रयोगों की एक विस्तृत श्रृंखला का द्वार खोला है।
इस लेख में, हमने वैरिएशनल ऑटोएन्कोडर्स की बुनियादी बातें, विभिन्न प्रकार, PyTorch में VAEs को कैसे लागू करें, साथ ही VAEs के साथ काम करते समय आने वाली चुनौतियाँ और उनके समाधान कवर किए हैं।
अपनी सीख जारी रखने के लिए ये संसाधन देखें: