当一位医学研究者声称一款新药将平均血压降低了15点时,我们对这一结论应当有多大把握?答案往往在于理解标准误——一种统计度量,告诉我们样本估计究竟有多精确。
威廉·西利·戈塞特(William Sealy Gosset)以“Student”为笔名在健力士啤酒厂工作期间,基于真实的酿造难题发展了小样本理论。他的工作为在未知总体参数的情况下进行可靠推断奠定了数学基础。
本指南将介绍标准误在不同统计情境中的关键概念、数学公式与实践应用。我们的R 抽样课程更详细地讲解了这些计算背后的原理,而理解标准误与样本标准差之间的关系,将为您的统计推断打下坚实基础。
什么是标准误?
标准误为样本统计量周围的不确定性提供衡量,帮助我们理解:如果我们多次重复同样的研究,我们的估计可能会有多大变化。我们将剖析核心概念,并探讨标准误在各种统计分析中的不同形式。
核心概念与直觉
标准误衡量同一总体中重复抽样时某个样本统计量的变动性。您可以把它看作是在回答:“如果我收集100个相同大小的不同样本,我的样本均值会相差多少?”
这一概念直接来源于抽样分布理论。当我们计算一个样本均值时,该值只是众多可能样本结果中的一个。标准误量化任何一个样本统计量与我们试图估计的总体真实参数之间的典型距离。
标准误衡量样本统计量对总体参数的估计效果。较小的标准误意味着重复样本会产生相似的估计,表明我们当前样本提供了可靠的近似。较大的标准误则提示潜在样本之间存在显著变异,意味着我们对估计的信心较弱。
多种类型的标准误
标准误并非只有一种。不同的统计量根据所测量对象需要专门的公式。最常见的类型包括:
- 均值的标准误:用于估计总体平均数
- 比例的标准误:用于百分比或比率的估计
- 均值差的标准误:用于比较两个组
- 回归系数的标准误:用于线性模型中的斜率估计
每种类型都服务于特定的分析目的,并处理不同来源的变异。例如,比例的标准误考虑到是/否回应的二项特性,而回归斜率的标准误同时考虑残差变异和自变量取值的分散程度。
选用正确的类型至关重要。使用错误的公式可能导致过度自信的结论,或错过重要效应。
标准误的概念基础
本节将探讨标准误如何立足于抽样理论与统计推理,为标准误计算提供既有意义又可靠的理论基础。
抽样分布理论
抽样分布的概念为标准误提供理论依据。若我们能从一个总体中收集所有大小为 n 的可能样本,并对每个样本计算关注的统计量,我们就构建了一个抽样分布。标准误等于这一理论抽样分布的标准差,这也解释了它为何能量化各个样本统计量围绕总体真实参数的变动程度。
样本量与标准误呈反比关系。随着样本量增加,标准误按 n 的平方根成比例下降。中心极限定理进一步指出,随着样本量的增加,抽样分布会趋近正态,无论原始总体分布如何。这一正态性假设使我们即便在非正态数据下(样本量足够大时),也能利用标准误来构建置信区间与进行假设检验。
影响量级的因素
标准误的大小取决于三个因素:样本量、总体变异性与抽样设计。总体变异性会直接影响标准误。对于同样的样本量,变异性越大的总体产生的标准误越大。比如,在存在极端贫富差距的城市地区调查家庭收入,其标准误会比在收入较为同质的农村社区更大,即使样本量相同。
样本量通过平方根反比关系提供了最可控的影响。要将标准误减少一半,需要将样本量扩大四倍。抽样设计同样重要:整群抽样通常会增加标准误,因为群内观测往往相似;而分层抽样通过确保重要子群体的代表性,能够降低标准误。
标准误、样本量与大数定律
大数定律解释了为何样本越大,标准误越小。随着样本量增加,样本统计量会收敛于总体参数。标准误与 1/√n 成正比。这就是为什么要获得显著的精度提升需要极大的样本量:将样本量扩大四倍,标准误也只能减半。
但这里有个陷阱:更大的样本确实会降低标准误并提升精度,但极大的样本也可能让缺乏实际意义的微小差异达到统计显著。例如,对10万人的研究可能检测到在统计上显著、但在临床上无关紧要的0.1点血压差异。小样本则可能因标准误较大而错过重要效应。您需要在统计显著性与实际意义之间取得平衡。
数学表述与计算
从概念理解到计算流程,数学公式与逐步计算让标准误在数据分析中可操作。
不同情境下的基本公式
均值的标准误的基本公式取决于是否已知总体标准差。若已知,则直接使用总体参数:
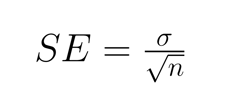
其中:
更常见的是未知总体标准差,此时以样本标准差替代,由此引入额外不确定性,需要参考 t 分布:
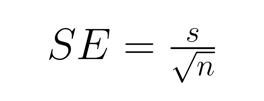
其中:
比例的标准误针对二元结果,使用二项分布公式:
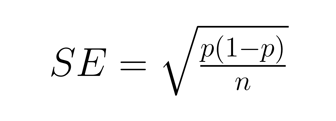
其中:
回归斜率的标准误同时涉及残差变异与自变量分散程度:
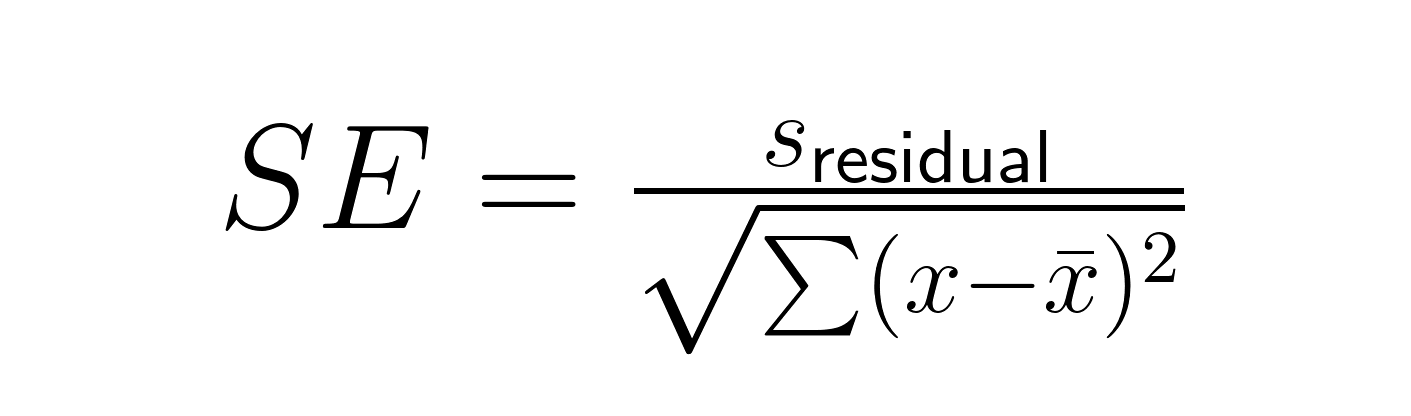
其中:
- sresidual = 回归的残差标准误
- x = 各个自变量取值
- x̄ = 自变量的均值
均值差的标准误会根据组间是否独立或配对而变化。对于独立组:
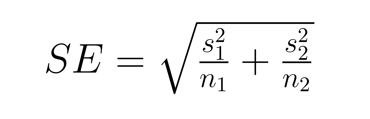
其中:
- s₁, s₂ = 第1组与第2组的标准差
- n₁, n₂ = 第1组与第2组的样本量
对于配对比较,公式将显著简化:
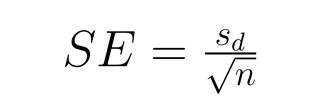
其中:
计算流程与场景
已知总体参数是理想情形,可使用正态分布进行推断。未知参数是更常见的研究情形,我们使用样本数据按三步法估计:
步骤 1:计算样本均值
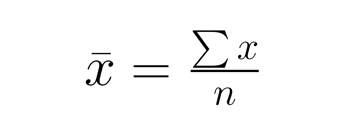
步骤 2:计算样本标准差
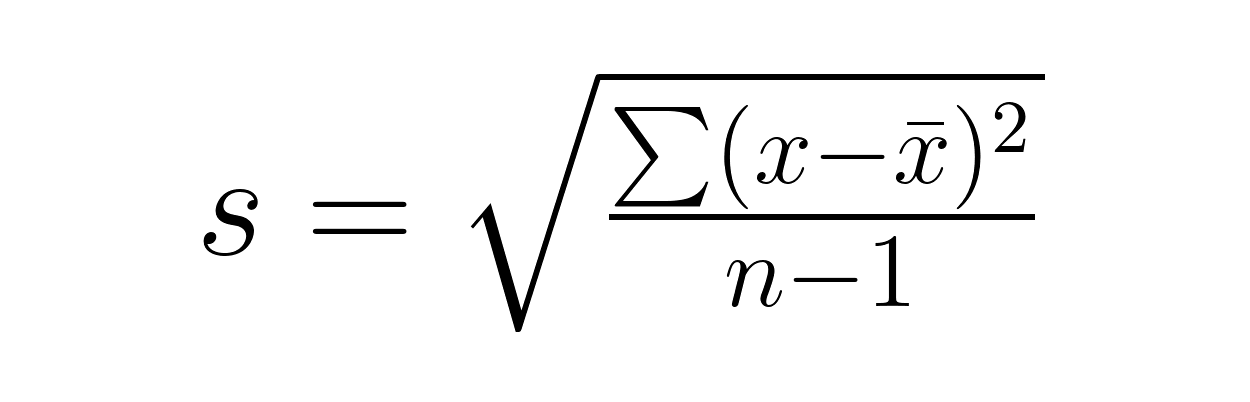
步骤 3:应用合适的标准误公式,使用样本标准差。
解读:标准误越小,估计越精确。对于样本均值为50、标准误为2.5的情况,意味着总体均值很可能大致落在45–55之间;而标准误为10则显示出不确定性大得多。在近似正态下,约68%落在1个标准误内,约95%落在1.96个标准误内。小样本且使用 s 时,请使用 t 临界值。
拓展与修正
有限总体修正(FPC)在抽样比例超过有限总体的5%时是必要的:
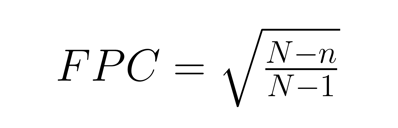
其中:
修正后的标准误为:
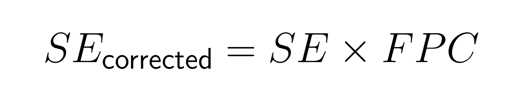
例如,从一个有2,000人的小镇抽样200人,修正因子约为0.95,使标准误降低约5%。
整群样本需要使用设计效应对有效样本量的减少进行调整:
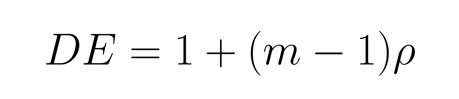
其中:
- m = 平均群大小
- ρ = 群内相关系数(群内观测相似程度)
调整后的标准误为:
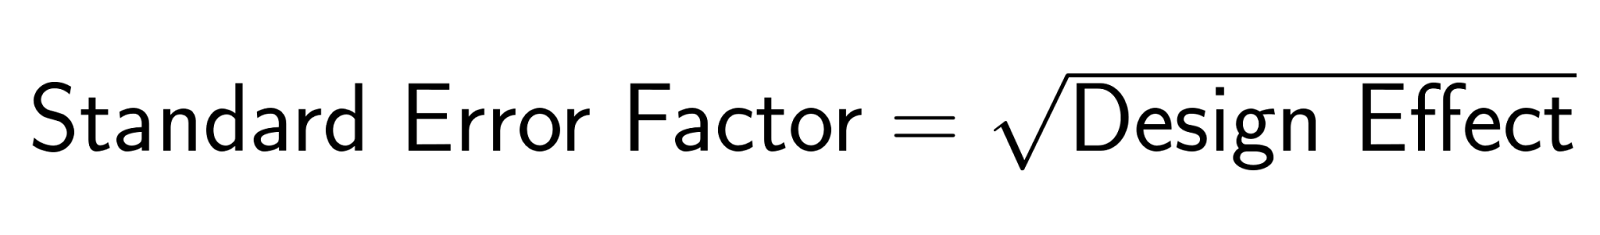
当家庭成员观点相似(ρ = 0.3),且平均家庭规模为3时,设计效应 DE = 1 + (3-1)(0.3) = 1.6。标准误放大因子为 √1.6 = 1.27,使标准误比简单随机抽样大27%。
在统计推断中的应用
标准误是统计推断中最重要技术的基石之一,从置信区间到假设检验。本节探讨标准误如何让这些基本过程成为可能并可靠。
构建置信区间
标准误直接决定置信区间的宽度:
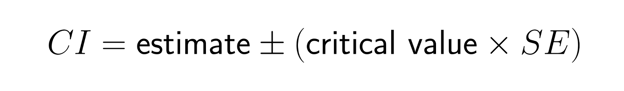
对于大样本,95%置信度的临界值约为1.96。小样本使用略大的 t 分布临界值。这种关系解释了为何研究者常在点估计旁报告标准误:它能立即传达结果的精度。
窄的区间表示标准误小、估计精确;宽的区间则表明不确定性较大。置信水平(95%、99%等)决定我们想要的把握度,但区间宽度关键取决于标准误。
假设检验框架
标准误通过将原始差异转化为抽样变异的单位来标准化检验统计量:
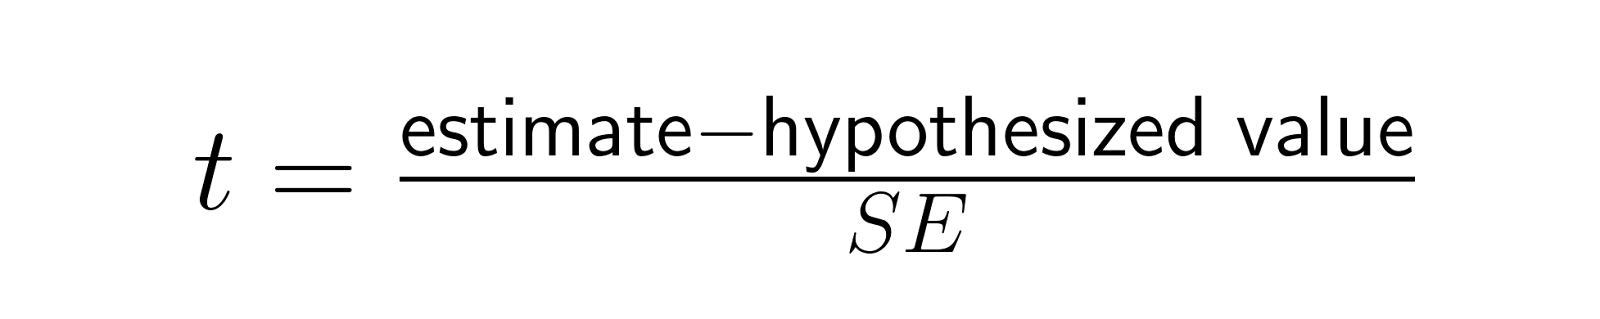
该 t 统计量通过将差异相对于原假设下的期望变异来表达,使跨研究与效应量的比较更有意义。差异为5点、标准误为1(t = 5)可能很重要;但标准误为10(t = 0.5)则可能微不足道,这显示了标准误为效应量解读提供的上下文。
由于统计检验将观测效应除以标准误,较小的标准误会让即便适度的真实效应也能达到统计显著;而较大的标准误则需要更大的效应才能显著。这也解释了为何大型研究能检测到小而真实的效应,而小型研究可能错过它们。
元分析中的应用
在元分析中,标准误通过逆方差加权决定每项研究的权重:
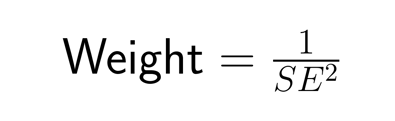
标准误较小(估计更精确)的研究会获得更高权重;标准误较大的研究权重更低。这反映了“更精确的估计应对整体认知贡献更多”的原则。标准误为0.5的研究会获得是标准误为1.0的研究四倍的权重,从而在跨研究的整合中最小化元分析估计的总体标准误。
标准误的报告与解读
清晰传达标准误需要关注呈现形式与解读语境。下面给出呈现标准误结果与避免常见解读错误的实用建议。
报告的最佳实践
务必说明您报告的是哪种标准误,并保持格式一致。可采用“均值(SE)”的格式,如表格中的“45.2 (2.8)”。在图表中,可用误差线表示点估计上下各一个标准误,但请明确误差线表示的是标准误、标准差还是置信区间。
在回归与模型中的解读
回归输出会在系数估计旁显示标准误。若某系数为0.75、SE = 0.25,则表明真实效应很可能大致在0.25到1.25之间;t 统计量为3.0则表明对原假设的不利证据很强。
非抽样误差的考量
标准误只量化抽样变异。它不包含测量误差、无应答偏差或其他不确定性来源。选择偏差或混杂等系统性偏差可能导致估计不准确,即使标准误很小也不例外。不要因为标准误小就对可能存在系统性偏差的结果过度自信。
常见误解与陷阱
要正确解读标准误,需要警惕那些常见且容易导致错误结论的误解。本节针对最常见的困惑来源,提供避免解读错误的指导。
标准误 vs. 标准差
标准误与标准差衡量的是不同层面的变异,二者不应混淆,尽管这种混淆在研究报告与大众媒体中屡见不鲜。标准差描述个体观测值围绕样本均值的分散程度,回答“个体数据点相对平均值有多分散?”;标准误描述样本均值作为总体均值估计的精度,回答“如果我们重复这项研究,样本均值会有多大变动?”
数学关系有助于澄清这种区别:
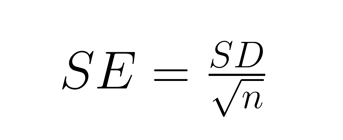
标准误等于标准差除以样本量的平方根,因此除非 n = 1,标准误总是小于标准差。比如,成年身高的数据集的标准差可能为4英寸(表明个体身高差异较大),而样本均值的标准误可能仅为0.1英寸(表明对平均身高的估计非常精确)。
精度与准确性的误区
标准误衡量的是精度,而非准确性。标准误小意味着高精度,因为重复样本会产生相似的估计,但系统性偏差可能破坏准确性。
想象一个浴室秤总是比真实体重高5磅:称量100次会得到高度一致的数值(标准误很小),但结果始终不准确。低标准误并不保证结果正确。
缺点与局限
标准误计算假定随机抽样、观测独立,且往往假定正态性。非随机抽样会使标准误不适用;相关观测(如同一所学校内的学生)需要更大的标准误。
不要把低标准误当作“证据确凿”。与同样低标准误的观察性研究相比,标准误小的随机对照试验能提供更强的证据,因为无论统计精度如何,研究设计都会影响有效性。我们的R 中的实验设计课程涵盖了恰当的随机化、区组与实验控制原则,保证您的标准误计算能够得出有效结论。
方法学的高级扩展
现代统计实践发展出了经典标准误方法的替代与扩展,当传统方法不足或需要更复杂的不确定性量化时,可提供解决方案。
自助法(Bootstrapping)提供一种不依赖分布假设的非参数方法。通过对原始数据反复重抽样,自助法可以为缺乏解析公式的复杂统计量估计标准误。我们的Python 抽样课程涵盖了自助法技术。
稳健标准误用于调整假设违背的情况。异方差一致的标准误在残差方差不恒定时仍然有效,而聚类标准误能处理组内相关。这些方法通常会给出更大的标准误,从而使推断更为保守。
贝叶斯方法通过后验分布而非标准误来量化不确定性。贝叶斯置信区间(可信区间)可给出直接的概率陈述:“参数落在2.1与4.7之间的概率为95%。”欢迎学习我们的使用 rstanarm 进行贝叶斯回归建模课程,了解贝叶斯方法如何以不同方式处理不确定性。
结论
标准误架起了样本数据与总体推断之间的桥梁,量化估计的精度,使有意义的统计结论成为可能。关键洞见:标准误衡量的是精度,而非准确性。它告诉我们在重复抽样中估计值的一致性,而不是这些估计是否正确。
要恰当使用标准误,请核查假设、选择正确类型,并在更广泛的研究设计语境下解读结果。始终在点估计旁报告标准误,明确您使用的类型,并承认其局限。若想更深入理解,可通过我们的R 统计推断学习路径进行探索。
无论您是在设计实验、分析调查数据,还是解读研究结果,标准误都为诚实的不确定性量化奠定基础,帮助建立对统计发现的信任。


当一位医学研究者声称一款新药将平均血压降低了15点时,我们对这一结论应当有多大把握?答案往往在于理解标准误——一种统计度量,告诉我们样本估计究竟有多精确。
威廉·西利·戈塞特(William Sealy Gosset)以“Student”为笔名在健力士啤酒厂工作期间,基于真实的酿造难题发展了小样本理论。他的工作为在未知总体参数的情况下进行可靠推断奠定了数学基础。
本指南将介绍标准误在不同统计情境中的关键概念、数学公式与实践应用。我们的R 抽样课程更详细地讲解了这些计算背后的原理,而理解标准误与样本标准差之间的关系,将为您的统计推断打下坚实基础。
什么是标准误?
标准误为样本统计量周围的不确定性提供衡量,帮助我们理解:如果我们多次重复同样的研究,我们的估计可能会有多大变化。我们将剖析核心概念,并探讨标准误在各种统计分析中的不同形式。
核心概念与直觉
标准误衡量同一总体中重复抽样时某个样本统计量的变动性。您可以把它看作是在回答:“如果我收集100个相同大小的不同样本,我的样本均值会相差多少?”
这一概念直接来源于抽样分布理论。当我们计算一个样本均值时,该值只是众多可能样本结果中的一个。标准误量化任何一个样本统计量与我们试图估计的总体真实参数之间的典型距离。
标准误衡量样本统计量对总体参数的估计效果。较小的标准误意味着重复样本会产生相似的估计,表明我们当前样本提供了可靠的近似。较大的标准误则提示潜在样本之间存在显著变异,意味着我们对估计的信心较弱。
多种类型的标准误
标准误并非只有一种。不同的统计量根据所测量对象需要专门的公式。最常见的类型包括:
每种类型都服务于特定的分析目的,并处理不同来源的变异。例如,比例的标准误考虑到是/否回应的二项特性,而回归斜率的标准误同时考虑残差变异和自变量取值的分散程度。
选用正确的类型至关重要。使用错误的公式可能导致过度自信的结论,或错过重要效应。
标准误的概念基础
本节将探讨标准误如何立足于抽样理论与统计推理,为标准误计算提供既有意义又可靠的理论基础。
抽样分布理论
抽样分布的概念为标准误提供理论依据。若我们能从一个总体中收集所有大小为 n 的可能样本,并对每个样本计算关注的统计量,我们就构建了一个抽样分布。标准误等于这一理论抽样分布的标准差,这也解释了它为何能量化各个样本统计量围绕总体真实参数的变动程度。
样本量与标准误呈反比关系。随着样本量增加,标准误按 n 的平方根成比例下降。中心极限定理进一步指出,随着样本量的增加,抽样分布会趋近正态,无论原始总体分布如何。这一正态性假设使我们即便在非正态数据下(样本量足够大时),也能利用标准误来构建置信区间与进行假设检验。
影响量级的因素
标准误的大小取决于三个因素:样本量、总体变异性与抽样设计。总体变异性会直接影响标准误。对于同样的样本量,变异性越大的总体产生的标准误越大。比如,在存在极端贫富差距的城市地区调查家庭收入,其标准误会比在收入较为同质的农村社区更大,即使样本量相同。
样本量通过平方根反比关系提供了最可控的影响。要将标准误减少一半,需要将样本量扩大四倍。抽样设计同样重要:整群抽样通常会增加标准误,因为群内观测往往相似;而分层抽样通过确保重要子群体的代表性,能够降低标准误。
标准误、样本量与大数定律
大数定律解释了为何样本越大,标准误越小。随着样本量增加,样本统计量会收敛于总体参数。标准误与 1/√n 成正比。这就是为什么要获得显著的精度提升需要极大的样本量:将样本量扩大四倍,标准误也只能减半。
但这里有个陷阱:更大的样本确实会降低标准误并提升精度,但极大的样本也可能让缺乏实际意义的微小差异达到统计显著。例如,对10万人的研究可能检测到在统计上显著、但在临床上无关紧要的0.1点血压差异。小样本则可能因标准误较大而错过重要效应。您需要在统计显著性与实际意义之间取得平衡。
数学表述与计算
从概念理解到计算流程,数学公式与逐步计算让标准误在数据分析中可操作。
不同情境下的基本公式
均值的标准误的基本公式取决于是否已知总体标准差。若已知,则直接使用总体参数:
其中:
更常见的是未知总体标准差,此时以样本标准差替代,由此引入额外不确定性,需要参考 t 分布:
其中:
比例的标准误针对二元结果,使用二项分布公式:
其中:
回归斜率的标准误同时涉及残差变异与自变量分散程度:
其中:
均值差的标准误会根据组间是否独立或配对而变化。对于独立组:
其中:
对于配对比较,公式将显著简化:
其中:
计算流程与场景
已知总体参数是理想情形,可使用正态分布进行推断。未知参数是更常见的研究情形,我们使用样本数据按三步法估计:
步骤 1:计算样本均值
步骤 2:计算样本标准差
步骤 3:应用合适的标准误公式,使用样本标准差。
解读:标准误越小,估计越精确。对于样本均值为50、标准误为2.5的情况,意味着总体均值很可能大致落在45–55之间;而标准误为10则显示出不确定性大得多。在近似正态下,约68%落在1个标准误内,约95%落在1.96个标准误内。小样本且使用 s 时,请使用 t 临界值。
拓展与修正
有限总体修正(FPC)在抽样比例超过有限总体的5%时是必要的:
其中:
修正后的标准误为:
例如,从一个有2,000人的小镇抽样200人,修正因子约为0.95,使标准误降低约5%。
整群样本需要使用设计效应对有效样本量的减少进行调整:
其中:
调整后的标准误为:
当家庭成员观点相似(ρ = 0.3),且平均家庭规模为3时,设计效应 DE = 1 + (3-1)(0.3) = 1.6。标准误放大因子为 √1.6 = 1.27,使标准误比简单随机抽样大27%。
在统计推断中的应用
标准误是统计推断中最重要技术的基石之一,从置信区间到假设检验。本节探讨标准误如何让这些基本过程成为可能并可靠。
构建置信区间
标准误直接决定置信区间的宽度:
对于大样本,95%置信度的临界值约为1.96。小样本使用略大的 t 分布临界值。这种关系解释了为何研究者常在点估计旁报告标准误:它能立即传达结果的精度。
窄的区间表示标准误小、估计精确;宽的区间则表明不确定性较大。置信水平(95%、99%等)决定我们想要的把握度,但区间宽度关键取决于标准误。
假设检验框架
标准误通过将原始差异转化为抽样变异的单位来标准化检验统计量:
该 t 统计量通过将差异相对于原假设下的期望变异来表达,使跨研究与效应量的比较更有意义。差异为5点、标准误为1(t = 5)可能很重要;但标准误为10(t = 0.5)则可能微不足道,这显示了标准误为效应量解读提供的上下文。
由于统计检验将观测效应除以标准误,较小的标准误会让即便适度的真实效应也能达到统计显著;而较大的标准误则需要更大的效应才能显著。这也解释了为何大型研究能检测到小而真实的效应,而小型研究可能错过它们。
元分析中的应用
在元分析中,标准误通过逆方差加权决定每项研究的权重:
标准误较小(估计更精确)的研究会获得更高权重;标准误较大的研究权重更低。这反映了“更精确的估计应对整体认知贡献更多”的原则。标准误为0.5的研究会获得是标准误为1.0的研究四倍的权重,从而在跨研究的整合中最小化元分析估计的总体标准误。
标准误的报告与解读
清晰传达标准误需要关注呈现形式与解读语境。下面给出呈现标准误结果与避免常见解读错误的实用建议。
报告的最佳实践
务必说明您报告的是哪种标准误,并保持格式一致。可采用“均值(SE)”的格式,如表格中的“45.2 (2.8)”。在图表中,可用误差线表示点估计上下各一个标准误,但请明确误差线表示的是标准误、标准差还是置信区间。
在回归与模型中的解读
回归输出会在系数估计旁显示标准误。若某系数为0.75、SE = 0.25,则表明真实效应很可能大致在0.25到1.25之间;t 统计量为3.0则表明对原假设的不利证据很强。
非抽样误差的考量
标准误只量化抽样变异。它不包含测量误差、无应答偏差或其他不确定性来源。选择偏差或混杂等系统性偏差可能导致估计不准确,即使标准误很小也不例外。不要因为标准误小就对可能存在系统性偏差的结果过度自信。
常见误解与陷阱
要正确解读标准误,需要警惕那些常见且容易导致错误结论的误解。本节针对最常见的困惑来源,提供避免解读错误的指导。
标准误 vs. 标准差
标准误与标准差衡量的是不同层面的变异,二者不应混淆,尽管这种混淆在研究报告与大众媒体中屡见不鲜。标准差描述个体观测值围绕样本均值的分散程度,回答“个体数据点相对平均值有多分散?”;标准误描述样本均值作为总体均值估计的精度,回答“如果我们重复这项研究,样本均值会有多大变动?”
数学关系有助于澄清这种区别:
标准误等于标准差除以样本量的平方根,因此除非 n = 1,标准误总是小于标准差。比如,成年身高的数据集的标准差可能为4英寸(表明个体身高差异较大),而样本均值的标准误可能仅为0.1英寸(表明对平均身高的估计非常精确)。
精度与准确性的误区
标准误衡量的是精度,而非准确性。标准误小意味着高精度,因为重复样本会产生相似的估计,但系统性偏差可能破坏准确性。
想象一个浴室秤总是比真实体重高5磅:称量100次会得到高度一致的数值(标准误很小),但结果始终不准确。低标准误并不保证结果正确。
缺点与局限
标准误计算假定随机抽样、观测独立,且往往假定正态性。非随机抽样会使标准误不适用;相关观测(如同一所学校内的学生)需要更大的标准误。
不要把低标准误当作“证据确凿”。与同样低标准误的观察性研究相比,标准误小的随机对照试验能提供更强的证据,因为无论统计精度如何,研究设计都会影响有效性。我们的R 中的实验设计课程涵盖了恰当的随机化、区组与实验控制原则,保证您的标准误计算能够得出有效结论。
方法学的高级扩展
现代统计实践发展出了经典标准误方法的替代与扩展,当传统方法不足或需要更复杂的不确定性量化时,可提供解决方案。
自助法(Bootstrapping)提供一种不依赖分布假设的非参数方法。通过对原始数据反复重抽样,自助法可以为缺乏解析公式的复杂统计量估计标准误。我们的Python 抽样课程涵盖了自助法技术。
稳健标准误用于调整假设违背的情况。异方差一致的标准误在残差方差不恒定时仍然有效,而聚类标准误能处理组内相关。这些方法通常会给出更大的标准误,从而使推断更为保守。
贝叶斯方法通过后验分布而非标准误来量化不确定性。贝叶斯置信区间(可信区间)可给出直接的概率陈述:“参数落在2.1与4.7之间的概率为95%。”欢迎学习我们的使用 rstanarm 进行贝叶斯回归建模课程,了解贝叶斯方法如何以不同方式处理不确定性。
结论
标准误架起了样本数据与总体推断之间的桥梁,量化估计的精度,使有意义的统计结论成为可能。关键洞见:标准误衡量的是精度,而非准确性。它告诉我们在重复抽样中估计值的一致性,而不是这些估计是否正确。
要恰当使用标准误,请核查假设、选择正确类型,并在更广泛的研究设计语境下解读结果。始终在点估计旁报告标准误,明确您使用的类型,并承认其局限。若想更深入理解,可通过我们的R 统计推断学习路径进行探索。
无论您是在设计实验、分析调查数据,还是解读研究结果,标准误都为诚实的不确定性量化奠定基础,帮助建立对统计发现的信任。