Quando un ricercatore medico afferma che un nuovo farmaco riduce la pressione sanguigna di una media di 15 punti, quanto dovremmo essere sicuri di questa affermazione? La risposta spesso sta nel capire l’errore standard, una misura statistica che ci dice quanto sono davvero precise le nostre stime campionarie.
William Sealy Gosset, che scriveva con lo pseudonimo "Student" mentre lavorava al birrificio Guinness, sviluppò la teoria dei piccoli campioni a partire da sfide reali della produzione. Il suo lavoro ci ha fornito le basi matematiche per trarre inferenze solide quando non conosciamo i parametri veri della popolazione.
Questa guida introduce i concetti chiave, le formule matematiche e le applicazioni pratiche dell’errore standard in diversi contesti statistici. Il nostro corso Sampling in R copre in maggior dettaglio i principi alla base di questi calcoli e capire come l’errore standard si collega alla deviazione standard del campione ti dà una base solida per l’inferenza statistica.
Cos’è l’errore standard?
L’errore standard fornisce una misura dell’incertezza attorno alle statistiche campionarie, aiutandoci a capire quanto potrebbero variare le nostre stime se ripetessimo lo stesso studio più volte. Esaminiamo il concetto di base ed esploriamo le diverse forme che l’errore standard assume nelle varie analisi statistiche.
Concetto di base e intuizione
L’errore standard misura la variabilità di una statistica campionaria attraverso campioni ripetuti dalla stessa popolazione. Pensalo come una risposta a: "Se raccogliessi 100 campioni diversi della stessa dimensione, quanto varierebbero le mie medie campionarie?"
Questo concetto deriva direttamente dalla teoria della distribuzione campionaria. Quando calcoliamo una media campionaria, quel valore rappresenta solo uno dei possibili esiti da molti potenziali campioni. L’errore standard quantifica la distanza tipica tra una statistica campionaria qualsiasi e il vero parametro di popolazione che stiamo cercando di stimare.
L’errore standard valuta quanto bene una statistica campionaria stima un parametro di popolazione. Un errore standard più piccolo significa che campioni ripetuti produrrebbero stime simili, suggerendo che il nostro campione attuale fornisce un’approssimazione affidabile. Un errore standard più grande suggerisce una variabilità sostanziale tra i potenziali campioni, indicando minore fiducia nella nostra stima.
Più tipi di errore standard
Non esiste un unico errore standard. Statistiche diverse richiedono formule specifiche a seconda di cosa stiamo misurando. I tipi più comuni includono:
- Errore standard della media: usato quando si stimano medie di popolazione
- Errore standard di una proporzione: applicato a stime di percentuali o tassi
- Errore standard della differenza tra medie: usato quando si confrontano due gruppi
- Errore standard dei coefficienti di regressione: applicato alle stime delle pendenze nei modelli lineari
Ogni tipo serve a scopi analitici specifici e affronta diverse fonti di variabilità. Per esempio, l’errore standard di una proporzione tiene conto della natura binomiale delle risposte sì/no, mentre l’errore standard di una pendenza di regressione considera sia la variazione dei residui sia la dispersione dei valori del predittore.
Scegliere il tipo giusto è importante. Usare la formula sbagliata può portare a conclusioni troppo fiduciose o a perdere effetti importanti.
Fondamenti concettuali dell’errore standard
Questa sezione esplora come l’errore standard si fonda sulla teoria del campionamento e sul ragionamento statistico, fornendo la base teorica che rende significativi e affidabili i calcoli dell’errore standard.
Teoria della distribuzione campionaria
Il concetto di distribuzione campionaria fornisce la base teorica per l’errore standard. Se potessimo raccogliere tutti i possibili campioni di dimensione n da una popolazione e calcolare la statistica di interesse per ciascun campione, creeremmo una distribuzione campionaria. L’errore standard equivale alla deviazione standard di questa distribuzione campionaria teorica, il che spiega perché quantifica quanto le singole statistiche campionarie variano attorno al vero parametro di popolazione.
La dimensione del campione ha una relazione inversa con l’errore standard. All’aumentare della dimensione del campione, l’errore standard diminuisce in proporzione alla radice quadrata di n. Il Teorema del Limite Centrale aggiunge che le distribuzioni campionarie si avvicinano alla normalità con l’aumentare della dimensione del campione, indipendentemente dalla distribuzione della popolazione sottostante. Questa assunzione di normalità ci consente di costruire intervalli di confidenza e test d’ipotesi usando l’errore standard, anche con dati non normali, purché il campione sia abbastanza grande.
Fattori che influenzano l’ampiezza
Tre fattori determinano l’ampiezza dell’errore standard: dimensione del campione, variabilità della popolazione e disegno di campionamento. La variabilità della popolazione influisce direttamente sull’errore standard. Popolazioni più variabili producono errori standard maggiori per una data dimensione campionaria. Un’indagine sul reddito familiare in aree urbane con forti disparità di ricchezza produrrà errori standard più grandi rispetto a comunità rurali con redditi omogenei, anche a parità di dimensione del campione.
La dimensione del campione è l’influenza più controllabile grazie alla relazione inversa con la radice quadrata. Dimezzare l’errore standard richiede di quadruplicare la dimensione del campione. Anche il disegno di campionamento conta: il campionamento a grappoli in genere aumenta l’errore standard perché le osservazioni all’interno dei grappoli tendono a essere simili, mentre il campionamento stratificato può ridurre l’errore standard garantendo la rappresentanza dei sottogruppi importanti.
Errore standard, dimensione del campione e Legge dei Grandi Numeri
La Legge dei Grandi Numeri spiega perché l’errore standard diminuisce con campioni più grandi. Le statistiche campionarie convergono verso i parametri di popolazione all’aumentare della dimensione del campione. L’errore standard è proporzionale a 1/√n. Ecco perché servono campioni enormi per miglioramenti sostanziali della precisione. Quadruplicare la dimensione del campione dimezza soltanto l’errore standard.
Ma c’è un rovescio della medaglia: sebbene campioni più grandi riducano l’errore standard e aumentino la precisione, campioni estremamente grandi possono produrre risultati statisticamente significativi per differenze banali prive di rilevanza pratica. Uno studio su 100.000 persone potrebbe rilevare una differenza statisticamente significativa ma clinicamente irrilevante di 0,1 punti nella pressione. Campioni piccoli possono perdere effetti importanti a causa di errori standard elevati. Devi bilanciare significatività statistica e rilevanza pratica.
Passando dalla comprensione concettuale alle procedure computazionali, le formule matematiche e i calcoli passo-passo rendono l’errore standard operativo per l’analisi dei dati.
Equazioni fondamentali per scenari diversi
La formula di base per l’errore standard della media dipende dal fatto che la deviazione standard della popolazione sia nota. Quando lo è, usiamo direttamente il parametro di popolazione:
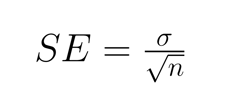
Dove:
- σ = deviazione standard della popolazione
- n = dimensione del campione
Più spesso, la deviazione standard della popolazione è sconosciuta, quindi si sostituisce con la deviazione standard del campione, introducendo un’ulteriore incertezza che richiede di fare riferimento alla distribuzione t:
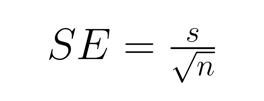
Dove:
- s = deviazione standard del campione
- n = dimensione del campione
Errore standard di una proporzione per esiti binari usando la formula della distribuzione binomiale:
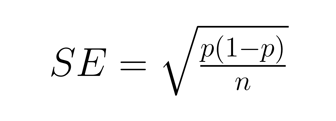
Dove:
- p = proporzione campionaria
- n = dimensione del campione
Errore standard della pendenza di regressione coinvolge sia la variazione residua sia la dispersione della variabile predittore:
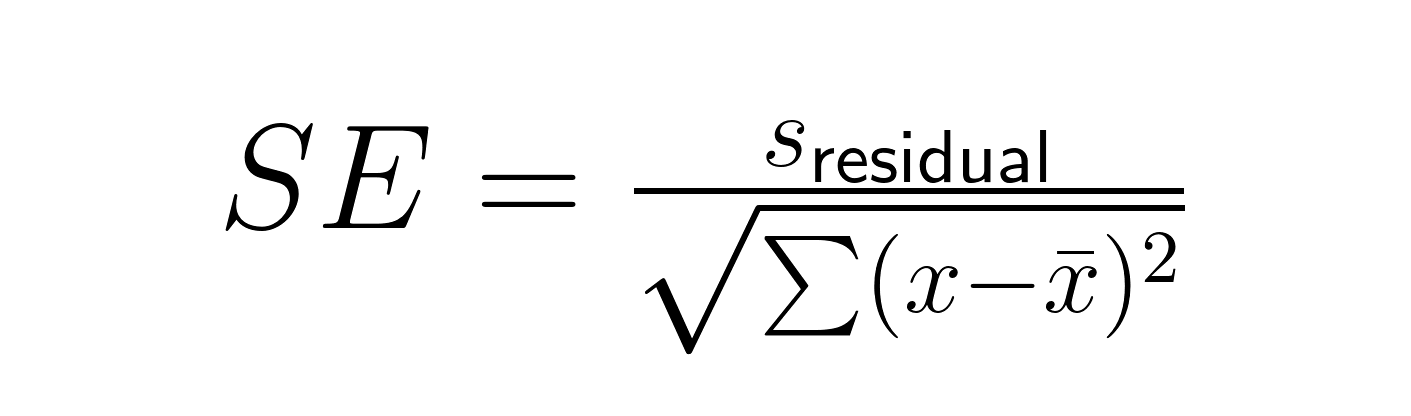
Dove:
- sresidual = errore standard residuo dalla regressione
- x = valori individuali del predittore
- x̄ = media dei valori del predittore
Errore standard della differenza tra medie varia a seconda che i gruppi siano indipendenti o appaiati. Per gruppi indipendenti:
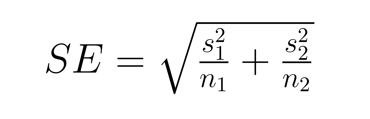
Dove:
- s₁, s₂ = deviazioni standard dei gruppi 1 e 2
- n₁, n₂ = dimensioni campionarie dei gruppi 1 e 2
Per confronti appaiati, la formula si semplifica notevolmente:
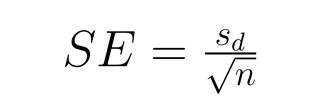
Dove:
- sd = deviazione standard delle differenze appaiate
- n = numero di coppie
Procedure di calcolo e scenari
Parametri di popolazione noti rappresentano lo scenario ideale che consente l’uso della distribuzione normale per l’inferenza. I parametri sconosciuti riflettono le situazioni tipiche di ricerca in cui stimiamo dai dati campionari seguendo un processo in tre passaggi:
Passo 1: Calcola la media campionaria
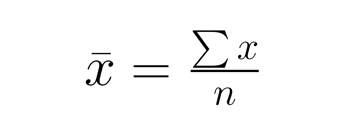
Passo 2: Calcola la deviazione standard campionaria
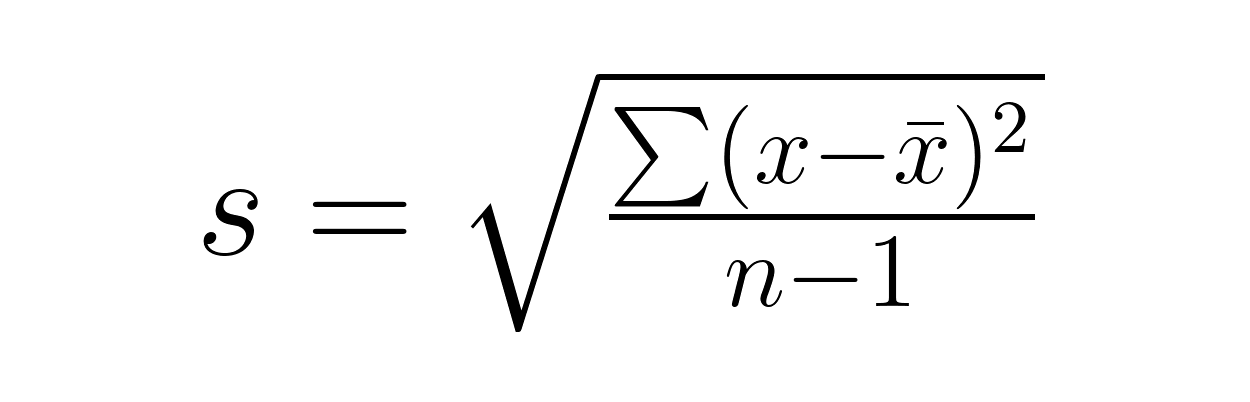
Passo 3: Applica la formula di errore standard appropriata usando la deviazione standard campionaria.
Interpretazione: errori standard più piccoli indicano stime più precise. Un errore standard di 2,5 per una media campionaria di 50 suggerisce che la vera media di popolazione probabilmente ricade approssimativamente tra 45 e 55, mentre un errore standard di 10 indica molta più incertezza. In approssimazione alla normalità, circa il 68% ricade entro 1 ES e circa il 95% entro 1,96 ES dalla vera media. Per campioni piccoli usando s, utilizza i valori critici t.
Estensioni e correzioni
La correzione per popolazione finita (FPC) diventa necessaria quando si campiona più del 5% di una popolazione finita:
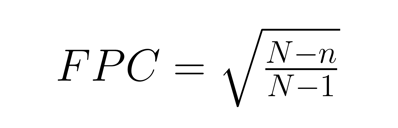
Dove:
- N = dimensione totale della popolazione
- n = dimensione del campione
L’errore standard corretto diventa:
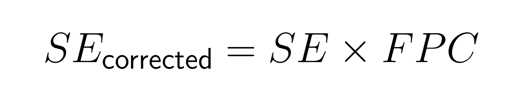
Per esempio, intervistare 200 persone in una città di 2.000 porta a un fattore di correzione di circa 0,95, riducendo l’errore standard del 5%.
Campioni clusterizzati richiedono aggiustamenti per la ridotta dimensione campionaria effettiva usando l’effetto di disegno (design effect):
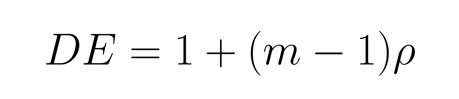
Dove:
- m = dimensione media del cluster
- ρ = coefficiente di correlazione intracluster (quanto sono simili le osservazioni all’interno dei cluster)
L’errore standard aggiustato diventa:
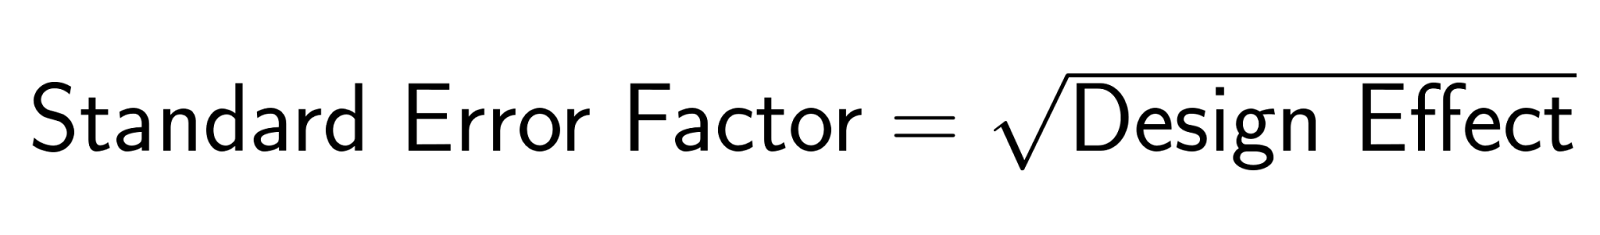
Quando i membri della famiglia hanno opinioni simili (ρ = 0,3) e la dimensione media del nucleo è 3, l’effetto di disegno è DE = 1 + (3-1)(0,3) = 1,6. Il fattore dell’errore standard è √1,6 = 1,27, rendendo gli errori standard più grandi del 27% rispetto a quanto produrrebbe un campionamento casuale semplice.
Applicazioni nell’inferenza statistica
L’errore standard è alla base di alcune delle tecniche più importanti dell’inferenza statistica, dagli intervalli di confidenza ai test d’ipotesi. Questa sezione esplora come l’errore standard renda possibili e affidabili queste procedure fondamentali.
Costruzione di intervalli di confidenza
L’errore standard determina direttamente l’ampiezza degli intervalli di confidenza:
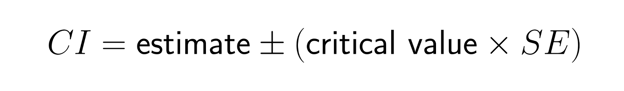
Per campioni grandi, il valore critico è circa 1,96 per una confidenza del 95%. Campioni più piccoli usano valori critici della distribuzione t leggermente maggiori. Questa relazione spiega perché i ricercatori spesso riportano gli errori standard insieme alle stime puntuali: forniscono un’idea immediata della precisione dei risultati.
Intervalli stretti indicano stime precise con errori standard piccoli, mentre intervalli ampi suggeriscono incertezza sostanziale. Il livello di confidenza (95%, 99%, ecc.) determina quanto vogliamo essere sicuri, ma l’ampiezza dell’intervallo dipende in modo critico dall’errore standard.
Quadro dei test d’ipotesi
L’errore standard standardizza le statistiche di test convertendo le differenze grezze in unità di variabilità campionaria:
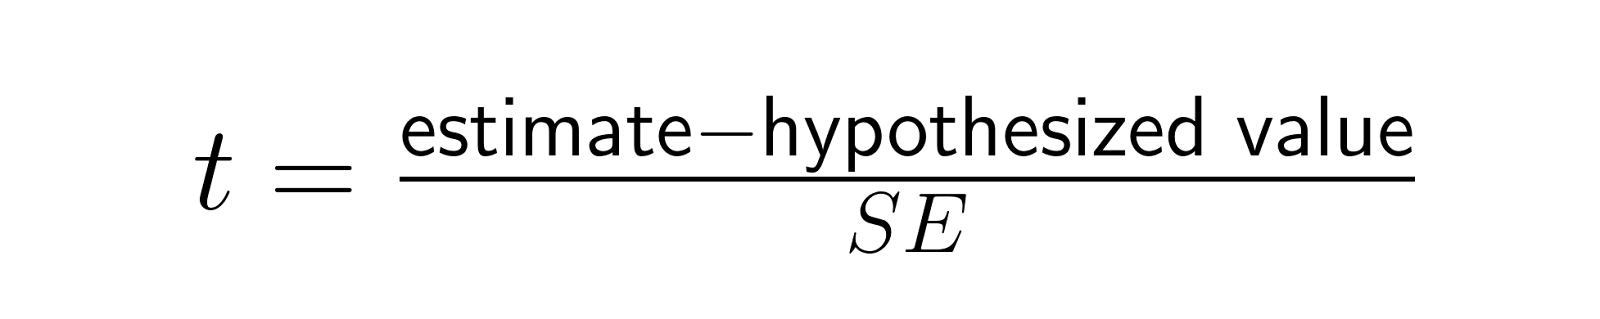
Questa statistica t consente confronti significativi tra studi diversi e dimensioni dell’effetto diverse, esprimendo le differenze rispetto alla loro variabilità attesa sotto l’ipotesi nulla. Una differenza di 5 punti può essere significativa con ES = 1 (dando t = 5) ma banale con ES = 10 (dando t = 0,5), illustrando come l’errore standard fornisca il contesto per interpretare le dimensioni dell’effetto.
Poiché i test statistici dividono l’effetto osservato per l’errore standard, errori standard più piccoli fanno sì che anche effetti reali modesti raggiungano la significatività statistica, mentre errori standard più grandi richiedono effetti maggiori per raggiungerla. Questo spiega perché studi grandi possono rilevare effetti piccoli ma reali che studi più piccoli perderebbero.
Nella meta-analisi, l’errore standard determina quanto peso riceve ciascuno studio tramite la ponderazione per varianza inversa:
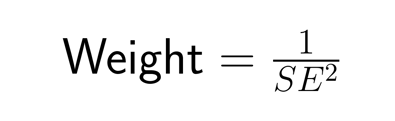
Gli studi con errori standard più piccoli (stime più precise) ricevono un peso maggiore rispetto a quelli con errori standard più grandi, riflettendo il principio per cui stime più precise dovrebbero contribuire di più alla nostra comprensione complessiva. Uno studio con errore standard pari a 0,5 riceve un peso quattro volte superiore rispetto a uno con errore standard pari a 1,0, combinando in modo ottimale le informazioni tra studi per minimizzare l’errore standard complessivo della stima meta-analitica.
Presentazione e interpretazione dell’errore standard
Comunicare chiaramente l’errore standard richiede attenzione sia al formato di presentazione sia al contesto interpretativo. Di seguito sono evidenziate indicazioni pratiche per presentare i risultati dell’errore standard ed evitare errori interpretativi comuni.
Buone pratiche di reporting
Specifica sempre quale tipo di errore standard stai riportando e mantieni un formato coerente. Usa formati come "Media (ES)", ad esempio "45,2 (2,8)" nelle tabelle. Per i grafici, usa barre di errore che si estendono di un errore standard sopra e sotto le stime puntuali, ma sii esplicito se le barre di errore rappresentano errore standard, deviazione standard o intervalli di confidenza.
Interpretazione in regressione e modelli
L’output di regressione mostra gli errori standard accanto alle stime dei coefficienti. Un coefficiente di 0,75 con ES = 0,25 suggerisce che il vero effetto probabilmente ricade tra circa 0,25 e 1,25, mentre una statistica t di 3,0 indica una forte evidenza contro l’ipotesi nulla.
Considerazioni sugli errori non campionari
L’errore standard quantifica solo la variabilità campionaria. Non include errori di misurazione, bias da non risposta o altre fonti di incertezza. Bias sistematici come bias di selezione o confondimento possono generare stime inaccurate indipendentemente da quanto sia piccolo l’errore standard. Non lasciare che errori standard piccoli alimentino un’eccessiva fiducia in risultati che potrebbero comunque essere sistematicamente distorti.
Interpretazioni errate e insidie comuni
Un’interpretazione attenta dell’errore standard richiede consapevolezza dei frequenti fraintendimenti che possono portare a conclusioni errate. Questa sezione affronta le fonti di confusione più comuni e fornisce indicazioni per evitare errori interpretativi.
Errore standard vs. deviazione standard
Errore standard e deviazione standard misurano aspetti diversi della variabilità e non dovrebbero essere confusi, sebbene questa confusione compaia spesso sia nei report di ricerca sia nei media. La deviazione standard descrive la dispersione delle osservazioni individuali attorno alla media del campione, rispondendo a "Quanto variano i singoli punti dati rispetto alla media?" L’errore standard descrive la precisione della media campionaria come stima della media di popolazione, rispondendo a "Quanto varierebbero le medie campionarie se ripetessimo lo studio?"
La relazione matematica aiuta a chiarire la distinzione:
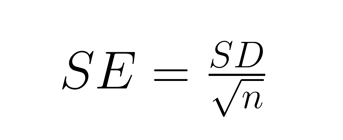
L’errore standard è uguale alla deviazione standard divisa per la radice quadrata della dimensione del campione, quindi è sempre più piccolo della deviazione standard (tranne quando n = 1). Un dataset di altezze adulte può avere una deviazione standard di 4 pollici (indicando che le altezze individuali variano considerevolmente) ma un errore standard di 0,1 pollici per la media campionaria (indicando una stima molto precisa dell’altezza media).
Fraintendimenti tra precisione e accuratezza
L’errore standard misura la precisione, non l’accuratezza. Un errore standard piccolo indica alta precisione perché campioni ripetuti produrrebbero stime simili, ma l’accuratezza può essere compromessa da bias sistematici.
Considera una bilancia da bagno che segna costantemente 5 libbre in più: pesarti 100 volte produrrebbe misurazioni altamente precise (errore standard piccolo) ma costantemente inaccurate. Un errore standard basso non garantisce risultati corretti.
Svantaggi e limitazioni
I calcoli dell’errore standard assumono campionamento casuale, osservazioni indipendenti e spesso normalità. Un campionamento non casuale rende inappropriato l’errore standard, mentre osservazioni correlate (come studenti all’interno di scuole) richiedono errori standard più grandi.
Non trattare un errore standard basso come "prova" di un risultato. Un trial randomizzato controllato con errore standard piccolo fornisce evidenze più forti di uno studio osservazionale con errore standard ugualmente piccolo, perché il disegno dello studio influisce sulla validità indipendentemente dalla precisione statistica. Il nostro corso Experimental Design in R copre i principi di corretta randomizzazione, blocking e controllo sperimentale che assicurano che i calcoli dell’errore standard conducano a conclusioni valide.
Estensioni metodologiche avanzate
La pratica statistica moderna ha sviluppato alternative ed estensioni agli approcci classici dell’errore standard, offrendo soluzioni quando i metodi tradizionali non bastano o quando serve una quantificazione dell’incertezza più sofisticata.
Tecniche di bootstrapping offrono un approccio non parametrico che non si basa su assunzioni distributive. Rieseguendo più volte il campionamento dei dati originali, i metodi bootstrap stimano gli errori standard per statistiche complesse dove non esistono formule analitiche. Il nostro corso Sampling in Python copre le tecniche bootstrap.
Errori standard robusti si adattano alle violazioni delle assunzioni. Gli errori standard consistenti all’eteroschedasticità restano validi quando la varianza dei residui non è costante, mentre gli errori standard clusterizzati tengono conto della correlazione all’interno dei gruppi. Questi metodi in genere producono errori standard più grandi, fornendo un’inferenza più conservativa.
Approcci bayesiani quantificano l’incertezza tramite distribuzioni posteriori anziché errori standard. Gli intervalli credibili bayesiani forniscono affermazioni di probabilità dirette: "C’è una probabilità del 95% che il parametro sia compreso tra 2,1 e 4,7." Esplora il nostro corso Bayesian Regression Modeling with rstanarm per imparare come i metodi bayesiani gestiscono l’incertezza in modo diverso.
Conclusione
L’errore standard fa da ponte tra dati campionari e inferenze sulla popolazione, quantificando la precisione delle nostre stime e consentendo conclusioni statistiche significative. L’idea chiave: l’errore standard misura la precisione, non l’accuratezza. Ci dice quanto sarebbero coerenti le nostre stime su campioni ripetuti, non se tali stime siano corrette.
Usa l’errore standard in modo appropriato verificando le assunzioni, scegliendo il tipo corretto e interpretando i risultati nel contesto più ampio del disegno di studio. Riporta sempre gli errori standard insieme alle stime puntuali, specifica quale tipo stai usando e riconosci le limitazioni. Considera di esplorare metodi avanzati con il nostro track Statistical Inference in R per una comprensione più profonda.
Che tu stia progettando esperimenti, analizzando dati di sondaggio o interpretando risultati di ricerca, l’errore standard fornisce le basi per una quantificazione onesta dell’incertezza che costruisce fiducia nei risultati statistici.





Quando un ricercatore medico afferma che un nuovo farmaco riduce la pressione sanguigna di una media di 15 punti, quanto dovremmo essere sicuri di questa affermazione? La risposta spesso sta nel capire l’errore standard, una misura statistica che ci dice quanto sono davvero precise le nostre stime campionarie.
William Sealy Gosset, che scriveva con lo pseudonimo "Student" mentre lavorava al birrificio Guinness, sviluppò la teoria dei piccoli campioni a partire da sfide reali della produzione. Il suo lavoro ci ha fornito le basi matematiche per trarre inferenze solide quando non conosciamo i parametri veri della popolazione.
Questa guida introduce i concetti chiave, le formule matematiche e le applicazioni pratiche dell’errore standard in diversi contesti statistici. Il nostro corso Sampling in R copre in maggior dettaglio i principi alla base di questi calcoli e capire come l’errore standard si collega alla deviazione standard del campione ti dà una base solida per l’inferenza statistica.
Cos’è l’errore standard?
L’errore standard fornisce una misura dell’incertezza attorno alle statistiche campionarie, aiutandoci a capire quanto potrebbero variare le nostre stime se ripetessimo lo stesso studio più volte. Esaminiamo il concetto di base ed esploriamo le diverse forme che l’errore standard assume nelle varie analisi statistiche.
Concetto di base e intuizione
L’errore standard misura la variabilità di una statistica campionaria attraverso campioni ripetuti dalla stessa popolazione. Pensalo come una risposta a: "Se raccogliessi 100 campioni diversi della stessa dimensione, quanto varierebbero le mie medie campionarie?"
Questo concetto deriva direttamente dalla teoria della distribuzione campionaria. Quando calcoliamo una media campionaria, quel valore rappresenta solo uno dei possibili esiti da molti potenziali campioni. L’errore standard quantifica la distanza tipica tra una statistica campionaria qualsiasi e il vero parametro di popolazione che stiamo cercando di stimare.
L’errore standard valuta quanto bene una statistica campionaria stima un parametro di popolazione. Un errore standard più piccolo significa che campioni ripetuti produrrebbero stime simili, suggerendo che il nostro campione attuale fornisce un’approssimazione affidabile. Un errore standard più grande suggerisce una variabilità sostanziale tra i potenziali campioni, indicando minore fiducia nella nostra stima.
Più tipi di errore standard
Non esiste un unico errore standard. Statistiche diverse richiedono formule specifiche a seconda di cosa stiamo misurando. I tipi più comuni includono:
Ogni tipo serve a scopi analitici specifici e affronta diverse fonti di variabilità. Per esempio, l’errore standard di una proporzione tiene conto della natura binomiale delle risposte sì/no, mentre l’errore standard di una pendenza di regressione considera sia la variazione dei residui sia la dispersione dei valori del predittore.
Scegliere il tipo giusto è importante. Usare la formula sbagliata può portare a conclusioni troppo fiduciose o a perdere effetti importanti.
Fondamenti concettuali dell’errore standard
Questa sezione esplora come l’errore standard si fonda sulla teoria del campionamento e sul ragionamento statistico, fornendo la base teorica che rende significativi e affidabili i calcoli dell’errore standard.
Teoria della distribuzione campionaria
Il concetto di distribuzione campionaria fornisce la base teorica per l’errore standard. Se potessimo raccogliere tutti i possibili campioni di dimensione n da una popolazione e calcolare la statistica di interesse per ciascun campione, creeremmo una distribuzione campionaria. L’errore standard equivale alla deviazione standard di questa distribuzione campionaria teorica, il che spiega perché quantifica quanto le singole statistiche campionarie variano attorno al vero parametro di popolazione.
La dimensione del campione ha una relazione inversa con l’errore standard. All’aumentare della dimensione del campione, l’errore standard diminuisce in proporzione alla radice quadrata di n. Il Teorema del Limite Centrale aggiunge che le distribuzioni campionarie si avvicinano alla normalità con l’aumentare della dimensione del campione, indipendentemente dalla distribuzione della popolazione sottostante. Questa assunzione di normalità ci consente di costruire intervalli di confidenza e test d’ipotesi usando l’errore standard, anche con dati non normali, purché il campione sia abbastanza grande.
Fattori che influenzano l’ampiezza
Tre fattori determinano l’ampiezza dell’errore standard: dimensione del campione, variabilità della popolazione e disegno di campionamento. La variabilità della popolazione influisce direttamente sull’errore standard. Popolazioni più variabili producono errori standard maggiori per una data dimensione campionaria. Un’indagine sul reddito familiare in aree urbane con forti disparità di ricchezza produrrà errori standard più grandi rispetto a comunità rurali con redditi omogenei, anche a parità di dimensione del campione.
La dimensione del campione è l’influenza più controllabile grazie alla relazione inversa con la radice quadrata. Dimezzare l’errore standard richiede di quadruplicare la dimensione del campione. Anche il disegno di campionamento conta: il campionamento a grappoli in genere aumenta l’errore standard perché le osservazioni all’interno dei grappoli tendono a essere simili, mentre il campionamento stratificato può ridurre l’errore standard garantendo la rappresentanza dei sottogruppi importanti.
Errore standard, dimensione del campione e Legge dei Grandi Numeri
La Legge dei Grandi Numeri spiega perché l’errore standard diminuisce con campioni più grandi. Le statistiche campionarie convergono verso i parametri di popolazione all’aumentare della dimensione del campione. L’errore standard è proporzionale a 1/√n. Ecco perché servono campioni enormi per miglioramenti sostanziali della precisione. Quadruplicare la dimensione del campione dimezza soltanto l’errore standard.
Ma c’è un rovescio della medaglia: sebbene campioni più grandi riducano l’errore standard e aumentino la precisione, campioni estremamente grandi possono produrre risultati statisticamente significativi per differenze banali prive di rilevanza pratica. Uno studio su 100.000 persone potrebbe rilevare una differenza statisticamente significativa ma clinicamente irrilevante di 0,1 punti nella pressione. Campioni piccoli possono perdere effetti importanti a causa di errori standard elevati. Devi bilanciare significatività statistica e rilevanza pratica.
Formulazione matematica e calcolo
Passando dalla comprensione concettuale alle procedure computazionali, le formule matematiche e i calcoli passo-passo rendono l’errore standard operativo per l’analisi dei dati.
Equazioni fondamentali per scenari diversi
La formula di base per l’errore standard della media dipende dal fatto che la deviazione standard della popolazione sia nota. Quando lo è, usiamo direttamente il parametro di popolazione:
Dove:
Più spesso, la deviazione standard della popolazione è sconosciuta, quindi si sostituisce con la deviazione standard del campione, introducendo un’ulteriore incertezza che richiede di fare riferimento alla distribuzione t:
Dove:
Errore standard di una proporzione per esiti binari usando la formula della distribuzione binomiale:
Dove:
Errore standard della pendenza di regressione coinvolge sia la variazione residua sia la dispersione della variabile predittore:
Dove:
Errore standard della differenza tra medie varia a seconda che i gruppi siano indipendenti o appaiati. Per gruppi indipendenti:
Dove:
Per confronti appaiati, la formula si semplifica notevolmente:
Dove:
Procedure di calcolo e scenari
Parametri di popolazione noti rappresentano lo scenario ideale che consente l’uso della distribuzione normale per l’inferenza. I parametri sconosciuti riflettono le situazioni tipiche di ricerca in cui stimiamo dai dati campionari seguendo un processo in tre passaggi:
Passo 1: Calcola la media campionaria
Passo 2: Calcola la deviazione standard campionaria
Passo 3: Applica la formula di errore standard appropriata usando la deviazione standard campionaria.
Interpretazione: errori standard più piccoli indicano stime più precise. Un errore standard di 2,5 per una media campionaria di 50 suggerisce che la vera media di popolazione probabilmente ricade approssimativamente tra 45 e 55, mentre un errore standard di 10 indica molta più incertezza. In approssimazione alla normalità, circa il 68% ricade entro 1 ES e circa il 95% entro 1,96 ES dalla vera media. Per campioni piccoli usando s, utilizza i valori critici t.
Estensioni e correzioni
La correzione per popolazione finita (FPC) diventa necessaria quando si campiona più del 5% di una popolazione finita:
Dove:
L’errore standard corretto diventa:
Per esempio, intervistare 200 persone in una città di 2.000 porta a un fattore di correzione di circa 0,95, riducendo l’errore standard del 5%.
Campioni clusterizzati richiedono aggiustamenti per la ridotta dimensione campionaria effettiva usando l’effetto di disegno (design effect):
Dove:
L’errore standard aggiustato diventa:
Quando i membri della famiglia hanno opinioni simili (ρ = 0,3) e la dimensione media del nucleo è 3, l’effetto di disegno è DE = 1 + (3-1)(0,3) = 1,6. Il fattore dell’errore standard è √1,6 = 1,27, rendendo gli errori standard più grandi del 27% rispetto a quanto produrrebbe un campionamento casuale semplice.
Applicazioni nell’inferenza statistica
L’errore standard è alla base di alcune delle tecniche più importanti dell’inferenza statistica, dagli intervalli di confidenza ai test d’ipotesi. Questa sezione esplora come l’errore standard renda possibili e affidabili queste procedure fondamentali.
Costruzione di intervalli di confidenza
L’errore standard determina direttamente l’ampiezza degli intervalli di confidenza:
Per campioni grandi, il valore critico è circa 1,96 per una confidenza del 95%. Campioni più piccoli usano valori critici della distribuzione t leggermente maggiori. Questa relazione spiega perché i ricercatori spesso riportano gli errori standard insieme alle stime puntuali: forniscono un’idea immediata della precisione dei risultati.
Intervalli stretti indicano stime precise con errori standard piccoli, mentre intervalli ampi suggeriscono incertezza sostanziale. Il livello di confidenza (95%, 99%, ecc.) determina quanto vogliamo essere sicuri, ma l’ampiezza dell’intervallo dipende in modo critico dall’errore standard.
Quadro dei test d’ipotesi
L’errore standard standardizza le statistiche di test convertendo le differenze grezze in unità di variabilità campionaria:
Questa statistica t consente confronti significativi tra studi diversi e dimensioni dell’effetto diverse, esprimendo le differenze rispetto alla loro variabilità attesa sotto l’ipotesi nulla. Una differenza di 5 punti può essere significativa con ES = 1 (dando t = 5) ma banale con ES = 10 (dando t = 0,5), illustrando come l’errore standard fornisca il contesto per interpretare le dimensioni dell’effetto.
Poiché i test statistici dividono l’effetto osservato per l’errore standard, errori standard più piccoli fanno sì che anche effetti reali modesti raggiungano la significatività statistica, mentre errori standard più grandi richiedono effetti maggiori per raggiungerla. Questo spiega perché studi grandi possono rilevare effetti piccoli ma reali che studi più piccoli perderebbero.
Applicazioni meta-analitiche
Nella meta-analisi, l’errore standard determina quanto peso riceve ciascuno studio tramite la ponderazione per varianza inversa:
Gli studi con errori standard più piccoli (stime più precise) ricevono un peso maggiore rispetto a quelli con errori standard più grandi, riflettendo il principio per cui stime più precise dovrebbero contribuire di più alla nostra comprensione complessiva. Uno studio con errore standard pari a 0,5 riceve un peso quattro volte superiore rispetto a uno con errore standard pari a 1,0, combinando in modo ottimale le informazioni tra studi per minimizzare l’errore standard complessivo della stima meta-analitica.
Presentazione e interpretazione dell’errore standard
Comunicare chiaramente l’errore standard richiede attenzione sia al formato di presentazione sia al contesto interpretativo. Di seguito sono evidenziate indicazioni pratiche per presentare i risultati dell’errore standard ed evitare errori interpretativi comuni.
Buone pratiche di reporting
Specifica sempre quale tipo di errore standard stai riportando e mantieni un formato coerente. Usa formati come "Media (ES)", ad esempio "45,2 (2,8)" nelle tabelle. Per i grafici, usa barre di errore che si estendono di un errore standard sopra e sotto le stime puntuali, ma sii esplicito se le barre di errore rappresentano errore standard, deviazione standard o intervalli di confidenza.
Interpretazione in regressione e modelli
L’output di regressione mostra gli errori standard accanto alle stime dei coefficienti. Un coefficiente di 0,75 con ES = 0,25 suggerisce che il vero effetto probabilmente ricade tra circa 0,25 e 1,25, mentre una statistica t di 3,0 indica una forte evidenza contro l’ipotesi nulla.
Considerazioni sugli errori non campionari
L’errore standard quantifica solo la variabilità campionaria. Non include errori di misurazione, bias da non risposta o altre fonti di incertezza. Bias sistematici come bias di selezione o confondimento possono generare stime inaccurate indipendentemente da quanto sia piccolo l’errore standard. Non lasciare che errori standard piccoli alimentino un’eccessiva fiducia in risultati che potrebbero comunque essere sistematicamente distorti.
Interpretazioni errate e insidie comuni
Un’interpretazione attenta dell’errore standard richiede consapevolezza dei frequenti fraintendimenti che possono portare a conclusioni errate. Questa sezione affronta le fonti di confusione più comuni e fornisce indicazioni per evitare errori interpretativi.
Errore standard vs. deviazione standard
Errore standard e deviazione standard misurano aspetti diversi della variabilità e non dovrebbero essere confusi, sebbene questa confusione compaia spesso sia nei report di ricerca sia nei media. La deviazione standard descrive la dispersione delle osservazioni individuali attorno alla media del campione, rispondendo a "Quanto variano i singoli punti dati rispetto alla media?" L’errore standard descrive la precisione della media campionaria come stima della media di popolazione, rispondendo a "Quanto varierebbero le medie campionarie se ripetessimo lo studio?"
La relazione matematica aiuta a chiarire la distinzione:
L’errore standard è uguale alla deviazione standard divisa per la radice quadrata della dimensione del campione, quindi è sempre più piccolo della deviazione standard (tranne quando n = 1). Un dataset di altezze adulte può avere una deviazione standard di 4 pollici (indicando che le altezze individuali variano considerevolmente) ma un errore standard di 0,1 pollici per la media campionaria (indicando una stima molto precisa dell’altezza media).
Fraintendimenti tra precisione e accuratezza
L’errore standard misura la precisione, non l’accuratezza. Un errore standard piccolo indica alta precisione perché campioni ripetuti produrrebbero stime simili, ma l’accuratezza può essere compromessa da bias sistematici.
Considera una bilancia da bagno che segna costantemente 5 libbre in più: pesarti 100 volte produrrebbe misurazioni altamente precise (errore standard piccolo) ma costantemente inaccurate. Un errore standard basso non garantisce risultati corretti.
Svantaggi e limitazioni
I calcoli dell’errore standard assumono campionamento casuale, osservazioni indipendenti e spesso normalità. Un campionamento non casuale rende inappropriato l’errore standard, mentre osservazioni correlate (come studenti all’interno di scuole) richiedono errori standard più grandi.
Non trattare un errore standard basso come "prova" di un risultato. Un trial randomizzato controllato con errore standard piccolo fornisce evidenze più forti di uno studio osservazionale con errore standard ugualmente piccolo, perché il disegno dello studio influisce sulla validità indipendentemente dalla precisione statistica. Il nostro corso Experimental Design in R copre i principi di corretta randomizzazione, blocking e controllo sperimentale che assicurano che i calcoli dell’errore standard conducano a conclusioni valide.
Estensioni metodologiche avanzate
La pratica statistica moderna ha sviluppato alternative ed estensioni agli approcci classici dell’errore standard, offrendo soluzioni quando i metodi tradizionali non bastano o quando serve una quantificazione dell’incertezza più sofisticata.
Tecniche di bootstrapping offrono un approccio non parametrico che non si basa su assunzioni distributive. Rieseguendo più volte il campionamento dei dati originali, i metodi bootstrap stimano gli errori standard per statistiche complesse dove non esistono formule analitiche. Il nostro corso Sampling in Python copre le tecniche bootstrap.
Errori standard robusti si adattano alle violazioni delle assunzioni. Gli errori standard consistenti all’eteroschedasticità restano validi quando la varianza dei residui non è costante, mentre gli errori standard clusterizzati tengono conto della correlazione all’interno dei gruppi. Questi metodi in genere producono errori standard più grandi, fornendo un’inferenza più conservativa.
Approcci bayesiani quantificano l’incertezza tramite distribuzioni posteriori anziché errori standard. Gli intervalli credibili bayesiani forniscono affermazioni di probabilità dirette: "C’è una probabilità del 95% che il parametro sia compreso tra 2,1 e 4,7." Esplora il nostro corso Bayesian Regression Modeling with rstanarm per imparare come i metodi bayesiani gestiscono l’incertezza in modo diverso.
Conclusione
L’errore standard fa da ponte tra dati campionari e inferenze sulla popolazione, quantificando la precisione delle nostre stime e consentendo conclusioni statistiche significative. L’idea chiave: l’errore standard misura la precisione, non l’accuratezza. Ci dice quanto sarebbero coerenti le nostre stime su campioni ripetuti, non se tali stime siano corrette.
Usa l’errore standard in modo appropriato verificando le assunzioni, scegliendo il tipo corretto e interpretando i risultati nel contesto più ampio del disegno di studio. Riporta sempre gli errori standard insieme alle stime puntuali, specifica quale tipo stai usando e riconosci le limitazioni. Considera di esplorare metodi avanzati con il nostro track Statistical Inference in R per una comprensione più profonda.
Che tu stia progettando esperimenti, analizzando dati di sondaggio o interpretando risultati di ricerca, l’errore standard fornisce le basi per una quantificazione onesta dell’incertezza che costruisce fiducia nei risultati statistici.