Bir tıp araştırmacısı yeni bir ilacın kan basıncını ortalama 15 puan düşürdüğünü iddia ettiğinde, bu iddiaya ne kadar güvenmeliyiz? Cevap çoğu zaman, örneklem tahminlerimizin gerçekte ne kadar hassas olduğunu söyleyen bir istatistiksel ölçü olan standart hatayı anlamakta yatar.
Guinness bira fabrikasında "Student" mahlasıyla yazan William Sealy Gosset, gerçek demleme zorluklarından hareketle küçük örneklem kuramını geliştirdi. Çalışmaları, gerçek anakütle parametrelerini bilmediğimizde sağlam çıkarımlar yapmamıza olanak tanıyan matematiksel temelleri sağladı.
Bu rehber, farklı istatistiksel bağlamlarda standart hatanın temel kavramlarını, matematiksel formüllerini ve pratik uygulamalarını tanıtır. R ile Örnekleme kursumuz bu hesaplamaların ardındaki ilkeleri daha ayrıntılı ele alır ve standart hatanın örneklem standart sapmasıyla ilişkisini anlamak istatistiksel çıkarım için sağlam bir temel sunar.
Standart Hata Nedir?
Standart hata, örneklem istatistiklerinin etrafındaki belirsizliği ölçerek aynı çalışmayı defalarca tekrarlasaydık tahminlerimizin ne kadar değişebileceğini anlamamıza yardımcı olur. Temel kavramı inceliyor ve çeşitli istatistiksel analizlerde standart hatanın aldığı farklı biçimleri keşfediyoruz.
Temel kavram ve sezgi
Standart hata, aynı anakütleden tekrarlanan örneklemler arasında bir örneklem istatistiğinin değişkenliğini ölçer. Bunu şu soruya verilen yanıt gibi düşünebilirsiniz: "Aynı büyüklükte 100 farklı örnek toplasam, örneklem ortalamalarım ne kadar değişirdi?"
Bu kavram doğrudan örnekleme dağılımı kuramından ortaya çıkar. Bir örneklem ortalaması hesapladığımızda, bu değer birçok olası örnekten yalnızca bir olası sonucu temsil eder. Standart hata, tahmin etmeye çalıştığımız gerçek anakütle parametresi ile herhangi bir bireysel örneklem istatistiği arasındaki tipik uzaklığı niceliksel olarak ifade eder.
Standart hata, bir örneklem istatistiğinin bir anakütle parametresini ne kadar iyi tahmin ettiğini ölçer. Daha küçük standart hata, tekrarlanan örneklemlerin benzer tahminler üreteceğini, dolayısıyla mevcut örneklemimizin güvenilir bir yaklaşıklık sunduğunu gösterir. Daha büyük standart hata ise olası örneklemler arasında önemli bir değişkenlik olduğunu ve tahminimize olan güvenin daha düşük olduğunu ima eder.
Birden çok standart hata türü
Tek bir standart hata yoktur. Ölçtüğümüz şeye bağlı olarak farklı istatistikler için özel formüller gerekir. En yaygın türler şunlardır:
- Ortalamanın standart hatası: Anakütle ortalamalarını tahmin ederken kullanılır
- Oranın standart hatası: Yüzde ya da oran tahminlerinde uygulanır
- Ortalama farkının standart hatası: İki grubu karşılaştırırken kullanılır
- Regresyon katsayılarının standart hatası: Doğrusal modellerde eğim tahminlerine uygulanır
Her tür, belirli analitik amaçlara hizmet eder ve farklı değişkenlik kaynaklarını ele alır. Örneğin, bir oranın standart hatası evet/hayır yanıtlarının binom yapısını hesaba katarken, bir regresyon eğiminin standart hatası hem artık (residual) varyasyonu hem de yordayıcı değerlerin yayılımını dikkate alır.
Doğru türü seçmek önemlidir. Yanlış formül kullanmak aşırı kendinden emin sonuçlara ya da önemli etkileri kaçırmaya yol açabilir.
Standart Hatanın Kavramsal Temelleri
Bu bölüm, standart hatanın örnekleme kuramına ve istatistiksel akıl yürütmeye nasıl dayandığını araştırır; bu da standart hata hesaplamalarını hem anlamlı hem de güvenilir kılan teorik temeli sağlar.
Örnekleme dağılımı kuramı
Örnekleme dağılımı kavramı, standart hata için teorik temeli sağlar. Bir anakütleden büyüklüğü n olan tüm olası örnekleri toplayabilsek ve her biri için ilgilendiğimiz istatistiği hesaplasak, bir örnekleme dağılımı oluştururduk. Standart hata, bu teorik örnekleme dağılımının standart sapmasına eşittir; bu da bireysel örneklem istatistiklerinin gerçek anakütle parametresi etrafında ne kadar değiştiğini neden niceliksel olarak ifade ettiğini açıklar.
Örneklem büyüklüğü, standart hatayla ters orantılıdır. Örneklem büyüklüğü arttıkça, standart hata n'in kareköküne orantılı olarak azalır. Merkezi Limit Teoremi, örneklem büyüklüğü arttıkça örnekleme dağılımlarının, altta yatan anakütle dağılımından bağımsız olarak normale yaklaştığını ekler. Bu normallik varsayımı, örneklem büyüklüğü yeterince büyük olduğu sürece, normal olmayan verilerle bile standart hatayı kullanarak güven aralıkları ve hipotez testleri oluşturmamıza olanak tanır.
Büyüklüğü etkileyen faktörler
Standart hatanın büyüklüğünü üç faktör belirler: örneklem büyüklüğü, anakütle değişkenliği ve örnekleme tasarımı. Anakütle değişkenliği doğrudan standart hatayı etkiler. Daha değişken anakütleler, herhangi bir örneklem büyüklüğü için daha büyük standart hatalar üretir. Aşırı servet eşitsizliklerinin bulunduğu kentsel bölgelerde hane geliri hakkında yapılan bir anket, örneklem büyüklükleri aynı olsa bile, gelirlerin homojen olduğu kırsal topluluklara kıyasla daha büyük standart hatalar üretecektir.
Örneklem büyüklüğü, ters karekök ilişkisi sayesinde en kontrol edilebilir etkiyi sağlar. Standart hatayı yarıya indirmek, örneklem büyüklüğünü dörde katlamayı gerektirir. Örnekleme tasarımı da önemlidir: Küme örneklemesi, kümeler içindeki gözlemler benzer olma eğiliminde olduğundan genellikle standart hatayı artırır; tabakalı örnekleme ise önemli alt grupların temsili sağlanarak standart hatayı azaltabilir.
Standart hata, örneklem büyüklüğü ve Büyük Sayılar Yasası
Büyük Sayılar Yasası, standart hatanın daha büyük örneklemlerle neden azaldığını açıklar. Örneklem istatistikleri, örneklem büyüklüğü arttıkça anakütle parametrelerine yakınsar. Standart hata 1/√n ile orantılıdır. Bu nedenle, önemli hassasiyet artışları için devasa örneklem büyüklükleri gerekir. Örneklem büyüklüğünü dört katına çıkarmak yalnızca standart hatayı yarıya indirir.
Ancak bir püf noktası var: Daha büyük örneklemler standart hatayı azaltır ve hassasiyeti artırır; fakat aşırı büyük örneklemler, pratik önemi olmayan önemsiz farklar için istatistiksel olarak anlamlı sonuçlar üretebilir. 100.000 kişilik bir çalışma, klinik olarak ilgisiz 0,1 puanlık kan basıncı farkını istatistiksel olarak anlamlı bulabilir. Küçük örneklemler ise büyük standart hatalar nedeniyle önemli etkileri kaçırabilir. İstatistiksel anlamlılık ile pratik anlamlılık arasında denge kurmanız gerekir.
Kavramsal anlayıştan hesaplama prosedürlerine geçerken, matematiksel formüller ve adım adım hesaplamalar standart hatayı veri analizi için pratik hale getirir.
Farklı senaryolar için temel denklemler
Ortalamanın standart hatası için temel formül, anakütle standart sapmasının bilinip bilinmediğine bağlıdır. Biliniyorsa, anakütle parametresini doğrudan kullanırız:
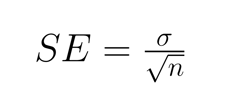
Burada:
- σ = anakütle standart sapması
- n = örneklem büyüklüğü
Daha yaygın olarak, anakütle standart sapması bilinmez; bu nedenle örneklem standart sapmasını ikame ederiz ve bu da t-dağılımına başvurmayı gerektiren ek bir belirsizlik getirir:
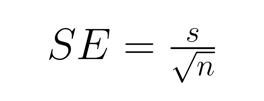
Burada:
- s = örneklem standart sapması
- n = örneklem büyüklüğü
Oranın standart hatası, ikili sonuçları binom dağılımı formülüyle ele alır:
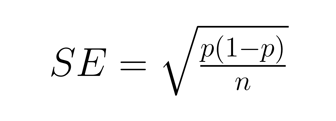
Burada:
- p = örneklem oranı
- n = örneklem büyüklüğü
Bir regresyon eğiminin standart hatası hem artık varyasyonu hem de yordayıcı değişkenin yayılımını içerir:
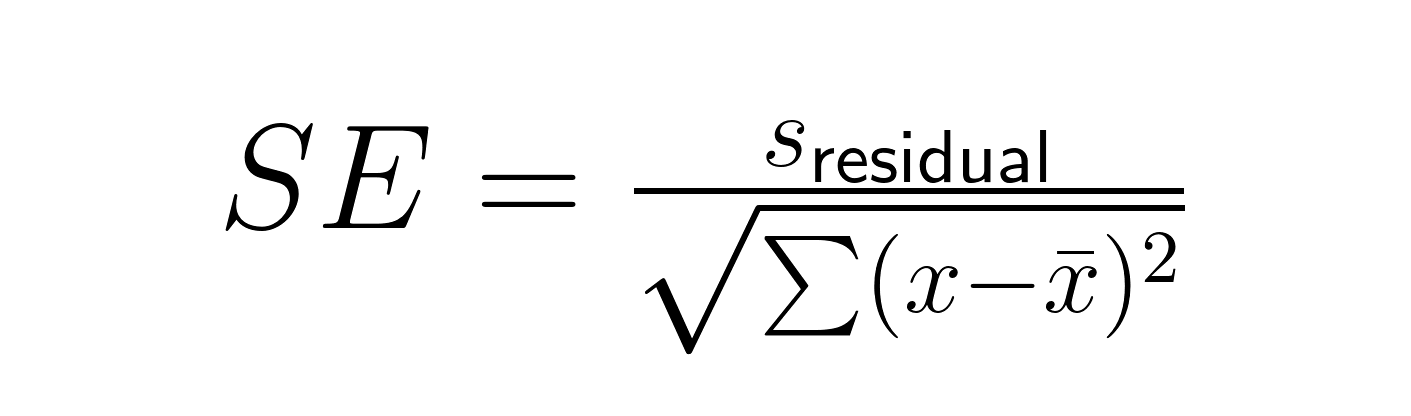
Burada:
- sresidual = regresyondan elde edilen artık standart hata
- x = bireysel yordayıcı değerleri
- x̄ = yordayıcı değerlerin ortalaması
Ortalama farkının standart hatası, grupların bağımsız ya da eşleştirilmiş olmasına göre değişir. Bağımsız gruplar için:
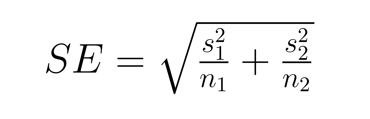
Burada:
- s₁, s₂ = 1. ve 2. grupların standart sapmaları
- n₁, n₂ = 1. ve 2. grupların örneklem büyüklükleri
Eşleştirilmiş karşılaştırmalar için formül önemli ölçüde sadeleşir:
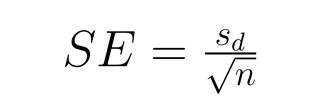
Burada:
- sd = eşleştirilmiş farkların standart sapması
- n = çift sayısı
Hesaplama prosedürleri ve senaryolar
Bilinen anakütle parametreleri, çıkarım için normal dağılımın kullanımını sağlayan ideal senaryoyu temsil eder. Bilinmeyen parametreler ise tipik araştırma durumlarını yansıtır; burada örneklem verilerinden üç adımlı bir süreçle tahmin yaparız:
Adım 1: Örneklem ortalamasını hesaplayın
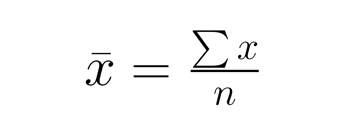
Adım 2: Örneklem standart sapmasını hesaplayın
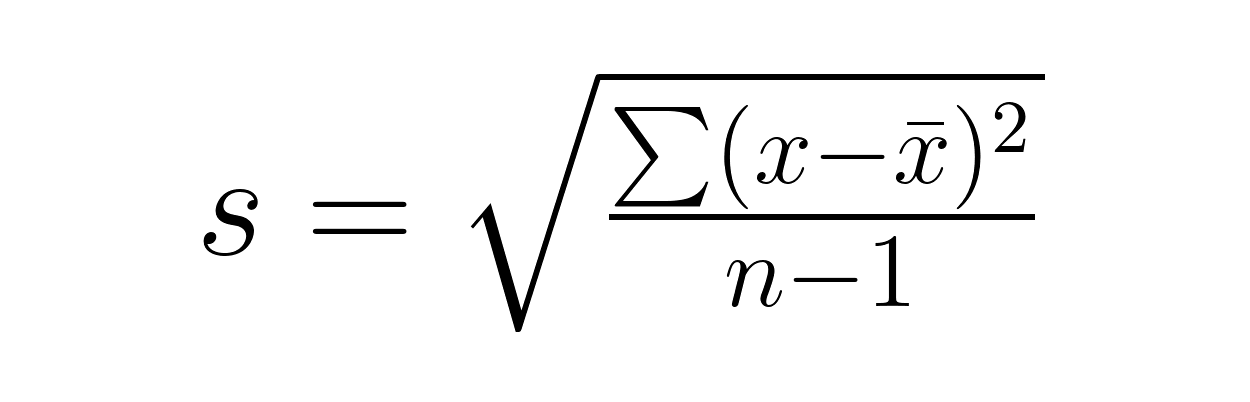
Adım 3: Uygun standart hata formülünü uygulayın ve örneklem standart sapmasını kullanın.
Yorumlama: Daha küçük standart hatalar, daha hassas tahminleri gösterir. 50'lik bir örneklem ortalaması için 2,5'lik bir standart hata, gerçek anakütle ortalamasının kabaca 45-55 aralığında olabileceğini ima ederken, 10'luk standart hata çok daha büyük bir belirsizliğe işaret eder. Yaklaşık normallik altında, değerin yaklaşık %68'i gerçek ortalamanın 1 SH ve yaklaşık %95'i 1,96 SH içinde yer alır. Küçük örneklemlerde s kullanılıyorsa, t kritik değerlerini kullanın.
Genişletmeler ve düzeltmeler
Sonlu anakütle düzeltmesi (FPC), sonlu bir anakütlenin %5'inden fazlası örneklendiğinde gerekli hale gelir:
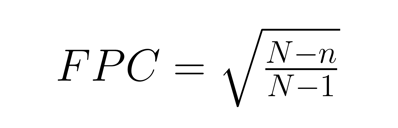
Burada:
- N = toplam anakütle büyüklüğü
- n = örneklem büyüklüğü
Düzeltilmiş standart hata şu hale gelir:
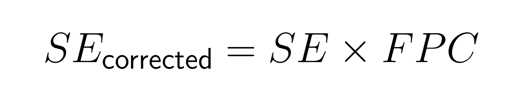
Örneğin, 2.000 kişilik bir kasabadan 200 kişiyle yapılan bir anket yaklaşık 0,95'lik bir düzeltme faktörü verir ve standart hatayı %5 azaltır.
Kümelenmiş örneklemler, tasarım etkisi kullanılarak azalan etkin örneklem büyüklüğü için ayarlamalar gerektirir:
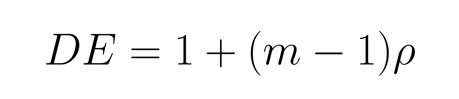
Burada:
- m = ortalama küme büyüklüğü
- ρ = küme içi korelasyon katsayısı (kümeler içindeki gözlemler ne kadar benzer)
Ayarlanmış standart hata şu hale gelir:
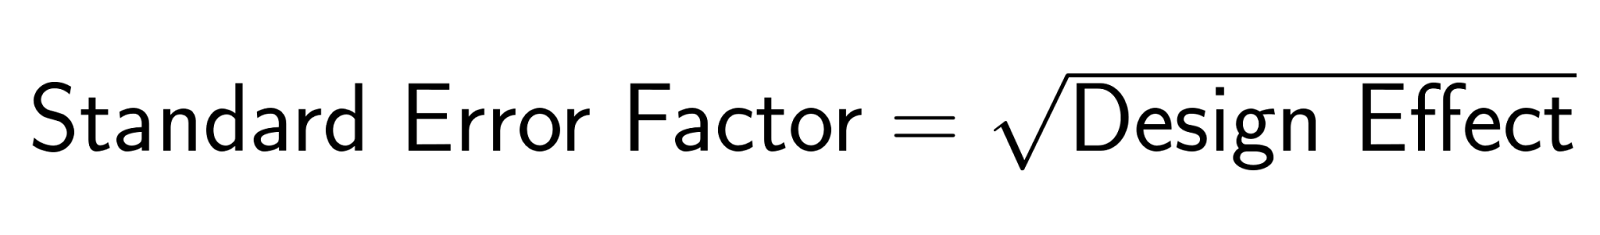
Aile üyelerinin benzer görüşlere sahip olduğu (ρ = 0,3) ve ortalama hane halkı büyüklüğünün 3 olduğu durumda, tasarım etkisi TE = 1 + (3-1)(0,3) = 1,6 olur. Standart hata faktörü √1,6 = 1,27'dir; bu da standart hataların basit rastgele örneklemeye kıyasla %27 daha büyük olacağı anlamına gelir.
İstatistiksel Çıkarımda Uygulamalar
Standart hata, güven aralıklarından hipotez testlerine kadar istatistiksel çıkarımın en önemli tekniklerinin temelini oluşturur. Bu bölüm, standart hatanın bu temel prosedürleri nasıl mümkün ve güvenilir kıldığını inceler.
Güven aralığı oluşturma
Standart hata, güven aralığı genişliğini doğrudan belirler:
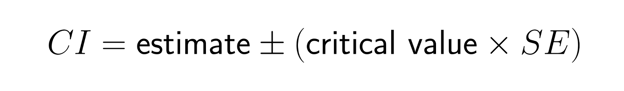
Büyük örneklemler için kritik değer %95 güven düzeyinde yaklaşık 1,96'dır. Daha küçük örneklemler biraz daha büyük olan t-dağılımı kritik değerlerini kullanır. Bu ilişki, araştırmacıların nokta tahminlerinin yanında standart hataları sıklıkla rapor etmelerinin nedenini açıklar. Standart hatalar, bulguların hassasiyeti hakkında anında içgörü sağlar.
Dar aralıklar, küçük standart hatalarla birlikte hassas tahminleri; geniş aralıklar ise önemli belirsizliği gösterir. Güven düzeyi (%95, %99, vb.) ne kadar emin olmak istediğimizi belirler; ancak aralık genişliği kritik olarak standart hataya bağlıdır.
Hipotez testi çerçevesi
Standart hata, ham farkları örnekleme değişkenliği birimlerine dönüştürerek test istatistiklerini standardize eder:
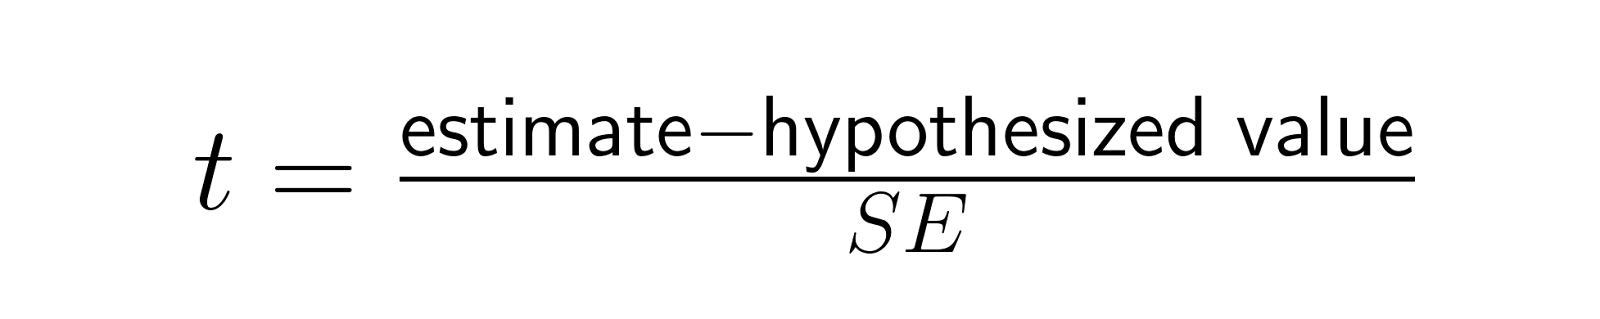
Bu t-istatistiği, farkları sıfır hipotezi altında beklenen değişkenliğe göre ifade ederek farklı çalışmalar ve etki büyüklükleri arasında anlamlı karşılaştırma yapılmasını sağlar. 5 puanlık bir fark, SH = 1 ise (t = 5 vererek) anlamlı olabilirken, SH = 10 ise (t = 0,5 vererek) önemsiz kalabilir; bu da standart hatanın etki büyüklüklerini yorumlamak için bağlam sunduğunu gösterir.
İstatistiksel testler gözlenen etkiyi standart hataya böldüğünden, daha küçük standart hatalar mütevazı gerçek etkilerin bile istatistiksel olarak anlamlı olmasını sağlarken, daha büyük standart hatalar anlamlılığa ulaşmak için daha büyük etkiler gerektirir. Bu durum, büyük çalışmaların küçük ama gerçek etkileri, küçük çalışmaların ise kaçırabileceğini açıklar.
Meta-analizde, standart hata, ters varyans ağırlıklandırması yoluyla her çalışmanın ne kadar ağırlık alacağını belirler:
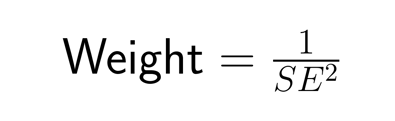
Daha küçük standart hatalara (daha hassas tahminlere) sahip çalışmalar, daha büyük standart hatalara sahip çalışmalara göre daha fazla ağırlık alır; bu da daha hassas tahminlerin genel anlayışımıza daha fazla katkıda bulunması gerektiği ilkesini yansıtır. Standart hatası 0,5 olan bir çalışma, standart hatası 1,0 olan bir çalışmadan dört kat daha fazla ağırlık alır; böylece çalışmalar arasında bilgiyi optimal biçimde birleştirerek meta-analitik tahminin genel standart hatasını en aza indirir.
Standart Hatanın Raporlanması ve Yorumlanması
Standart hata hakkında net iletişim, hem sunum formatına hem de yorumlayıcı bağlama dikkat gerektirir. Aşağıda, standart hata sonuçlarını sunmaya yönelik pratik rehberlik ve yaygın yorum hatalarından kaçınma yolları vurgulanmıştır.
Raporlama için en iyi uygulamalar
Hangi tür standart hatayı rapor ettiğinizi daima belirtin ve tutarlı biçimlendirme kullanın. Tablolarda "Ortalama (SH)" biçimini, örneğin "45,2 (2,8)" şeklinde kullanın. Grafiklerde, hata çubuklarını nokta tahminlerinin bir standart hata üstüne ve altına uzatın; ancak hata çubuklarının standart hatayı mı, standart sapmayı mı, yoksa güven aralıklarını mı temsil ettiğini açıkça belirtin.
Regresyon ve modellerde yorumlama
Regresyon çıktıları, katsayı tahminlerinin yanında standart hataları gösterir. SH = 0,25 olan 0,75'lik bir katsayı, gerçek etkinin kabaca 0,25 ile 1,25 arasında olabileceğini ima ederken, 3,0'lık t-istatistiği sıfır hipotezine karşı güçlü kanıt sunar.
Örnekleme dışı hata hususları
Standart hata yalnızca örnekleme değişkenliğini niceliksel olarak ifade eder. Ölçüm hataları, yanıtsızlık yanlılığı veya diğer belirsizlik kaynaklarını içermez. Seçim yanlılığı veya karıştırıcı değişkenler gibi sistematik yanlılıklar, standart hata ne kadar küçük olursa olsun hatalı tahminlere yol açabilir. Küçük standart hataların, yine de sistematik olarak yanlı olabilecek sonuçlarda aşırı güven oluşturmasına izin vermeyin.
Yaygın Yanlış Yorumlar ve Tuzaklar
Standart hatanın dikkatli yorumlanması, yanlış sonuçlara yol açabilecek sık görülen yanlış anlamaların farkında olmayı gerektirir. Bu bölüm, en yaygın karmaşa kaynaklarını ele alır ve yorum hatalarından kaçınmaya yönelik rehberlik sunar.
Standart hata vs. standart sapma
Standart hata ve standart sapma farklı değişkenlik boyutlarını ölçer ve karıştırılmamalıdır; ancak bu karışıklık hem araştırma raporlarında hem de popüler medya haberlerinde sıklıkla görülür. Standart sapma, bireysel gözlemlerin örneklem ortalaması etrafındaki yayılımını tanımlar ve "Bireysel veri noktaları ortalamadan ne kadar sapar?" sorusunu yanıtlar. Standart hata ise örneklem ortalamasının anakütle ortalamasının bir tahmini olarak hassasiyetini tanımlar ve "Çalışmayı tekrarlasaydık örneklem ortalamaları ne kadar değişirdi?" sorusunu yanıtlar.
Matematiksel ilişki bu ayrımı netleştirmeye yardımcı olur:
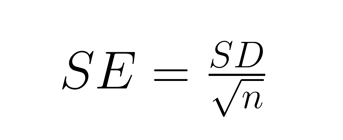
Standart hata, standart sapmanın örneklem büyüklüğünün kareköküne bölünmesine eşittir; bu nedenle, n = 1 dışında standart hata her zaman standart sapmadan küçüktür. Yetişkin boylarına ait bir veri kümesi 4 inçlik bir standart sapmaya sahip olabilir (bireysel boyların önemli ölçüde değiştiğini gösterir), ancak örneklem ortalaması için 0,1 inçlik bir standart hataya sahip olabilir (ortalama boyun çok hassas bir şekilde tahmin edildiğini gösterir).
Hassasiyet ve doğrulukla ilgili yanlış kanılar
Standart hata hassasiyeti ölçer, doğruluğu değil. Küçük standart hata, tekrarlanan örneklemlerin benzer tahminler üreteceği için yüksek hassasiyete işaret eder; ancak doğruluk, sistematik yanlılıklar tarafından zedelenebilir.
Banyodaki bir baskülün sürekli olarak 5 pound fazla gösterdiğini düşünün: Kendinizi 100 kez tartmanız çok hassas ölçümler (küçük standart hata) üretir, ancak sonuçlar tutarlı şekilde yanlış olur. Düşük standart hata, doğru sonuçları garanti etmez.
Dezavantajlar ve sınırlamalar
Standart hata hesaplamaları, rastgele örnekleme, bağımsız gözlemler ve çoğu zaman normallik varsayımına dayanır. Rastgele olmayan örnekleme, standart hatayı uygunsuz kılar; okullar içindeki öğrenciler gibi ilişkili gözlemler ise daha büyük standart hatalar gerektirir.
Düşük standart hatayı bir sonucun "kanıtı" olarak görmeyin. Küçük standart hataya sahip bir randomize kontrollü çalışma, aynı derecede küçük standart hataya sahip bir gözlemsel çalışmadan daha güçlü kanıt sağlar; çünkü çalışma tasarımı, istatistiksel hassasiyetten bağımsız olarak geçerliliği etkiler. R ile Deneysel Tasarım kursumuz, standart hata hesaplamalarınızın geçerli sonuçlara yol açmasını sağlayan uygun rastgeleleştirme, bloklama ve deneysel kontrol ilkelerini kapsar.
İleri Yöntemsel Genişletmeler
Modern istatistiksel uygulama, klasik standart hata yaklaşımlarına alternatifler ve genişletmeler geliştirmiştir; bunlar, geleneksel yöntemlerin yetersiz kaldığı durumlarda ya da daha sofistike belirsizlik nicemlemesi gerektiğinde çözümler sunar.
Bootstrap teknikleri, dağılım varsayımlarına dayanmayan parametrik olmayan bir yaklaşım sunar. Orijinal veriyi tekrar tekrar yeniden örnekleyerek, analitik formüllerin bulunmadığı karmaşık istatistikler için standart hataları tahmin eder. Python ile Örnekleme kursumuz bootstrap tekniklerini kapsar.
Sağlam (robust) standart hatalar, varsayım ihlallerine göre ayarlama yapar. Değişen varyans tutarlılığına (heteroskedastisite) duyarlı sağlam standart hatalar, artık varyans sabit olmadığında da geçerliliğini korur; kümelenmiş standart hatalar ise gruplar içindeki korelasyonu hesaba katar. Bu yöntemler genellikle daha büyük standart hatalar üretir ve daha temkinli çıkarım sağlar.
Bayesçi yaklaşımlar, standart hatalar yerine artk (posterior) dağılımlar aracılığıyla belirsizliği nicemler. Bayesçi güvenilir aralıklar doğrudan olasılık ifadeleri sunar: "Parametrenin 2,1 ile 4,7 arasında olma olasılığı %95." rstanarm ile Bayesçi Regresyon Modellemesi kursumuzu inceleyerek Bayesçi yöntemlerin belirsizliği nasıl farklı ele aldığını öğrenin.
Sonuç
Standart hata, örneklem verileri ile anakütle çıkarımları arasında köprü kurarak tahminlerimizin hassasiyetini niceliksel olarak ifade eder ve anlamlı istatistiksel sonuçlara olanak tanır. Kilit içgörü: standart hata hassasiyeti ölçer, doğruluğu değil. Bize, tekrarlanan örneklemler arasında tahminlerimizin ne kadar tutarlı olacağını söyler; bu tahminlerin doğru olup olmadığını değil.
Varsayımları doğrulayarak, doğru türü seçerek ve sonuçları çalışma tasarımının daha geniş bağlamında yorumlayarak standart hatayı uygun şekilde kullanın. Nokta tahminlerinin yanında daima standart hataları rapor edin, hangi türü kullandığınızı belirtin ve sınırlamaları kabul edin. Daha derin bir anlayış için R ile İstatistiksel Çıkarım yolumuzu keşfetmeyi düşünün.
İster deney tasarlayın, ister anket verilerini analiz edin, ister araştırma sonuçlarını yorumlayın; standart hata, istatistiksel bulgulara güven oluşturan dürüst belirsizlik nicemlemesinin temelini sağlar.





Bir tıp araştırmacısı yeni bir ilacın kan basıncını ortalama 15 puan düşürdüğünü iddia ettiğinde, bu iddiaya ne kadar güvenmeliyiz? Cevap çoğu zaman, örneklem tahminlerimizin gerçekte ne kadar hassas olduğunu söyleyen bir istatistiksel ölçü olan standart hatayı anlamakta yatar.
Guinness bira fabrikasında "Student" mahlasıyla yazan William Sealy Gosset, gerçek demleme zorluklarından hareketle küçük örneklem kuramını geliştirdi. Çalışmaları, gerçek anakütle parametrelerini bilmediğimizde sağlam çıkarımlar yapmamıza olanak tanıyan matematiksel temelleri sağladı.
Bu rehber, farklı istatistiksel bağlamlarda standart hatanın temel kavramlarını, matematiksel formüllerini ve pratik uygulamalarını tanıtır. R ile Örnekleme kursumuz bu hesaplamaların ardındaki ilkeleri daha ayrıntılı ele alır ve standart hatanın örneklem standart sapmasıyla ilişkisini anlamak istatistiksel çıkarım için sağlam bir temel sunar.
Standart Hata Nedir?
Standart hata, örneklem istatistiklerinin etrafındaki belirsizliği ölçerek aynı çalışmayı defalarca tekrarlasaydık tahminlerimizin ne kadar değişebileceğini anlamamıza yardımcı olur. Temel kavramı inceliyor ve çeşitli istatistiksel analizlerde standart hatanın aldığı farklı biçimleri keşfediyoruz.
Temel kavram ve sezgi
Standart hata, aynı anakütleden tekrarlanan örneklemler arasında bir örneklem istatistiğinin değişkenliğini ölçer. Bunu şu soruya verilen yanıt gibi düşünebilirsiniz: "Aynı büyüklükte 100 farklı örnek toplasam, örneklem ortalamalarım ne kadar değişirdi?"
Bu kavram doğrudan örnekleme dağılımı kuramından ortaya çıkar. Bir örneklem ortalaması hesapladığımızda, bu değer birçok olası örnekten yalnızca bir olası sonucu temsil eder. Standart hata, tahmin etmeye çalıştığımız gerçek anakütle parametresi ile herhangi bir bireysel örneklem istatistiği arasındaki tipik uzaklığı niceliksel olarak ifade eder.
Standart hata, bir örneklem istatistiğinin bir anakütle parametresini ne kadar iyi tahmin ettiğini ölçer. Daha küçük standart hata, tekrarlanan örneklemlerin benzer tahminler üreteceğini, dolayısıyla mevcut örneklemimizin güvenilir bir yaklaşıklık sunduğunu gösterir. Daha büyük standart hata ise olası örneklemler arasında önemli bir değişkenlik olduğunu ve tahminimize olan güvenin daha düşük olduğunu ima eder.
Birden çok standart hata türü
Tek bir standart hata yoktur. Ölçtüğümüz şeye bağlı olarak farklı istatistikler için özel formüller gerekir. En yaygın türler şunlardır:
Her tür, belirli analitik amaçlara hizmet eder ve farklı değişkenlik kaynaklarını ele alır. Örneğin, bir oranın standart hatası evet/hayır yanıtlarının binom yapısını hesaba katarken, bir regresyon eğiminin standart hatası hem artık (residual) varyasyonu hem de yordayıcı değerlerin yayılımını dikkate alır.
Doğru türü seçmek önemlidir. Yanlış formül kullanmak aşırı kendinden emin sonuçlara ya da önemli etkileri kaçırmaya yol açabilir.
Standart Hatanın Kavramsal Temelleri
Bu bölüm, standart hatanın örnekleme kuramına ve istatistiksel akıl yürütmeye nasıl dayandığını araştırır; bu da standart hata hesaplamalarını hem anlamlı hem de güvenilir kılan teorik temeli sağlar.
Örnekleme dağılımı kuramı
Örnekleme dağılımı kavramı, standart hata için teorik temeli sağlar. Bir anakütleden büyüklüğü n olan tüm olası örnekleri toplayabilsek ve her biri için ilgilendiğimiz istatistiği hesaplasak, bir örnekleme dağılımı oluştururduk. Standart hata, bu teorik örnekleme dağılımının standart sapmasına eşittir; bu da bireysel örneklem istatistiklerinin gerçek anakütle parametresi etrafında ne kadar değiştiğini neden niceliksel olarak ifade ettiğini açıklar.
Örneklem büyüklüğü, standart hatayla ters orantılıdır. Örneklem büyüklüğü arttıkça, standart hata n'in kareköküne orantılı olarak azalır. Merkezi Limit Teoremi, örneklem büyüklüğü arttıkça örnekleme dağılımlarının, altta yatan anakütle dağılımından bağımsız olarak normale yaklaştığını ekler. Bu normallik varsayımı, örneklem büyüklüğü yeterince büyük olduğu sürece, normal olmayan verilerle bile standart hatayı kullanarak güven aralıkları ve hipotez testleri oluşturmamıza olanak tanır.
Büyüklüğü etkileyen faktörler
Standart hatanın büyüklüğünü üç faktör belirler: örneklem büyüklüğü, anakütle değişkenliği ve örnekleme tasarımı. Anakütle değişkenliği doğrudan standart hatayı etkiler. Daha değişken anakütleler, herhangi bir örneklem büyüklüğü için daha büyük standart hatalar üretir. Aşırı servet eşitsizliklerinin bulunduğu kentsel bölgelerde hane geliri hakkında yapılan bir anket, örneklem büyüklükleri aynı olsa bile, gelirlerin homojen olduğu kırsal topluluklara kıyasla daha büyük standart hatalar üretecektir.
Örneklem büyüklüğü, ters karekök ilişkisi sayesinde en kontrol edilebilir etkiyi sağlar. Standart hatayı yarıya indirmek, örneklem büyüklüğünü dörde katlamayı gerektirir. Örnekleme tasarımı da önemlidir: Küme örneklemesi, kümeler içindeki gözlemler benzer olma eğiliminde olduğundan genellikle standart hatayı artırır; tabakalı örnekleme ise önemli alt grupların temsili sağlanarak standart hatayı azaltabilir.
Standart hata, örneklem büyüklüğü ve Büyük Sayılar Yasası
Büyük Sayılar Yasası, standart hatanın daha büyük örneklemlerle neden azaldığını açıklar. Örneklem istatistikleri, örneklem büyüklüğü arttıkça anakütle parametrelerine yakınsar. Standart hata 1/√n ile orantılıdır. Bu nedenle, önemli hassasiyet artışları için devasa örneklem büyüklükleri gerekir. Örneklem büyüklüğünü dört katına çıkarmak yalnızca standart hatayı yarıya indirir.
Ancak bir püf noktası var: Daha büyük örneklemler standart hatayı azaltır ve hassasiyeti artırır; fakat aşırı büyük örneklemler, pratik önemi olmayan önemsiz farklar için istatistiksel olarak anlamlı sonuçlar üretebilir. 100.000 kişilik bir çalışma, klinik olarak ilgisiz 0,1 puanlık kan basıncı farkını istatistiksel olarak anlamlı bulabilir. Küçük örneklemler ise büyük standart hatalar nedeniyle önemli etkileri kaçırabilir. İstatistiksel anlamlılık ile pratik anlamlılık arasında denge kurmanız gerekir.
Matematiksel Formülasyon ve Hesaplama
Kavramsal anlayıştan hesaplama prosedürlerine geçerken, matematiksel formüller ve adım adım hesaplamalar standart hatayı veri analizi için pratik hale getirir.
Farklı senaryolar için temel denklemler
Ortalamanın standart hatası için temel formül, anakütle standart sapmasının bilinip bilinmediğine bağlıdır. Biliniyorsa, anakütle parametresini doğrudan kullanırız:
Burada:
Daha yaygın olarak, anakütle standart sapması bilinmez; bu nedenle örneklem standart sapmasını ikame ederiz ve bu da t-dağılımına başvurmayı gerektiren ek bir belirsizlik getirir:
Burada:
Oranın standart hatası, ikili sonuçları binom dağılımı formülüyle ele alır:
Burada:
Bir regresyon eğiminin standart hatası hem artık varyasyonu hem de yordayıcı değişkenin yayılımını içerir:
Burada:
Ortalama farkının standart hatası, grupların bağımsız ya da eşleştirilmiş olmasına göre değişir. Bağımsız gruplar için:
Burada:
Eşleştirilmiş karşılaştırmalar için formül önemli ölçüde sadeleşir:
Burada:
Hesaplama prosedürleri ve senaryolar
Bilinen anakütle parametreleri, çıkarım için normal dağılımın kullanımını sağlayan ideal senaryoyu temsil eder. Bilinmeyen parametreler ise tipik araştırma durumlarını yansıtır; burada örneklem verilerinden üç adımlı bir süreçle tahmin yaparız:
Adım 1: Örneklem ortalamasını hesaplayın
Adım 2: Örneklem standart sapmasını hesaplayın
Adım 3: Uygun standart hata formülünü uygulayın ve örneklem standart sapmasını kullanın.
Yorumlama: Daha küçük standart hatalar, daha hassas tahminleri gösterir. 50'lik bir örneklem ortalaması için 2,5'lik bir standart hata, gerçek anakütle ortalamasının kabaca 45-55 aralığında olabileceğini ima ederken, 10'luk standart hata çok daha büyük bir belirsizliğe işaret eder. Yaklaşık normallik altında, değerin yaklaşık %68'i gerçek ortalamanın 1 SH ve yaklaşık %95'i 1,96 SH içinde yer alır. Küçük örneklemlerde s kullanılıyorsa, t kritik değerlerini kullanın.
Genişletmeler ve düzeltmeler
Sonlu anakütle düzeltmesi (FPC), sonlu bir anakütlenin %5'inden fazlası örneklendiğinde gerekli hale gelir:
Burada:
Düzeltilmiş standart hata şu hale gelir:
Örneğin, 2.000 kişilik bir kasabadan 200 kişiyle yapılan bir anket yaklaşık 0,95'lik bir düzeltme faktörü verir ve standart hatayı %5 azaltır.
Kümelenmiş örneklemler, tasarım etkisi kullanılarak azalan etkin örneklem büyüklüğü için ayarlamalar gerektirir:
Burada:
Ayarlanmış standart hata şu hale gelir:
Aile üyelerinin benzer görüşlere sahip olduğu (ρ = 0,3) ve ortalama hane halkı büyüklüğünün 3 olduğu durumda, tasarım etkisi TE = 1 + (3-1)(0,3) = 1,6 olur. Standart hata faktörü √1,6 = 1,27'dir; bu da standart hataların basit rastgele örneklemeye kıyasla %27 daha büyük olacağı anlamına gelir.
İstatistiksel Çıkarımda Uygulamalar
Standart hata, güven aralıklarından hipotez testlerine kadar istatistiksel çıkarımın en önemli tekniklerinin temelini oluşturur. Bu bölüm, standart hatanın bu temel prosedürleri nasıl mümkün ve güvenilir kıldığını inceler.
Güven aralığı oluşturma
Standart hata, güven aralığı genişliğini doğrudan belirler:
Büyük örneklemler için kritik değer %95 güven düzeyinde yaklaşık 1,96'dır. Daha küçük örneklemler biraz daha büyük olan t-dağılımı kritik değerlerini kullanır. Bu ilişki, araştırmacıların nokta tahminlerinin yanında standart hataları sıklıkla rapor etmelerinin nedenini açıklar. Standart hatalar, bulguların hassasiyeti hakkında anında içgörü sağlar.
Dar aralıklar, küçük standart hatalarla birlikte hassas tahminleri; geniş aralıklar ise önemli belirsizliği gösterir. Güven düzeyi (%95, %99, vb.) ne kadar emin olmak istediğimizi belirler; ancak aralık genişliği kritik olarak standart hataya bağlıdır.
Hipotez testi çerçevesi
Standart hata, ham farkları örnekleme değişkenliği birimlerine dönüştürerek test istatistiklerini standardize eder:
Bu t-istatistiği, farkları sıfır hipotezi altında beklenen değişkenliğe göre ifade ederek farklı çalışmalar ve etki büyüklükleri arasında anlamlı karşılaştırma yapılmasını sağlar. 5 puanlık bir fark, SH = 1 ise (t = 5 vererek) anlamlı olabilirken, SH = 10 ise (t = 0,5 vererek) önemsiz kalabilir; bu da standart hatanın etki büyüklüklerini yorumlamak için bağlam sunduğunu gösterir.
İstatistiksel testler gözlenen etkiyi standart hataya böldüğünden, daha küçük standart hatalar mütevazı gerçek etkilerin bile istatistiksel olarak anlamlı olmasını sağlarken, daha büyük standart hatalar anlamlılığa ulaşmak için daha büyük etkiler gerektirir. Bu durum, büyük çalışmaların küçük ama gerçek etkileri, küçük çalışmaların ise kaçırabileceğini açıklar.
Meta-analitik uygulamalar
Meta-analizde, standart hata, ters varyans ağırlıklandırması yoluyla her çalışmanın ne kadar ağırlık alacağını belirler:
Daha küçük standart hatalara (daha hassas tahminlere) sahip çalışmalar, daha büyük standart hatalara sahip çalışmalara göre daha fazla ağırlık alır; bu da daha hassas tahminlerin genel anlayışımıza daha fazla katkıda bulunması gerektiği ilkesini yansıtır. Standart hatası 0,5 olan bir çalışma, standart hatası 1,0 olan bir çalışmadan dört kat daha fazla ağırlık alır; böylece çalışmalar arasında bilgiyi optimal biçimde birleştirerek meta-analitik tahminin genel standart hatasını en aza indirir.
Standart Hatanın Raporlanması ve Yorumlanması
Standart hata hakkında net iletişim, hem sunum formatına hem de yorumlayıcı bağlama dikkat gerektirir. Aşağıda, standart hata sonuçlarını sunmaya yönelik pratik rehberlik ve yaygın yorum hatalarından kaçınma yolları vurgulanmıştır.
Raporlama için en iyi uygulamalar
Hangi tür standart hatayı rapor ettiğinizi daima belirtin ve tutarlı biçimlendirme kullanın. Tablolarda "Ortalama (SH)" biçimini, örneğin "45,2 (2,8)" şeklinde kullanın. Grafiklerde, hata çubuklarını nokta tahminlerinin bir standart hata üstüne ve altına uzatın; ancak hata çubuklarının standart hatayı mı, standart sapmayı mı, yoksa güven aralıklarını mı temsil ettiğini açıkça belirtin.
Regresyon ve modellerde yorumlama
Regresyon çıktıları, katsayı tahminlerinin yanında standart hataları gösterir. SH = 0,25 olan 0,75'lik bir katsayı, gerçek etkinin kabaca 0,25 ile 1,25 arasında olabileceğini ima ederken, 3,0'lık t-istatistiği sıfır hipotezine karşı güçlü kanıt sunar.
Örnekleme dışı hata hususları
Standart hata yalnızca örnekleme değişkenliğini niceliksel olarak ifade eder. Ölçüm hataları, yanıtsızlık yanlılığı veya diğer belirsizlik kaynaklarını içermez. Seçim yanlılığı veya karıştırıcı değişkenler gibi sistematik yanlılıklar, standart hata ne kadar küçük olursa olsun hatalı tahminlere yol açabilir. Küçük standart hataların, yine de sistematik olarak yanlı olabilecek sonuçlarda aşırı güven oluşturmasına izin vermeyin.
Yaygın Yanlış Yorumlar ve Tuzaklar
Standart hatanın dikkatli yorumlanması, yanlış sonuçlara yol açabilecek sık görülen yanlış anlamaların farkında olmayı gerektirir. Bu bölüm, en yaygın karmaşa kaynaklarını ele alır ve yorum hatalarından kaçınmaya yönelik rehberlik sunar.
Standart hata vs. standart sapma
Standart hata ve standart sapma farklı değişkenlik boyutlarını ölçer ve karıştırılmamalıdır; ancak bu karışıklık hem araştırma raporlarında hem de popüler medya haberlerinde sıklıkla görülür. Standart sapma, bireysel gözlemlerin örneklem ortalaması etrafındaki yayılımını tanımlar ve "Bireysel veri noktaları ortalamadan ne kadar sapar?" sorusunu yanıtlar. Standart hata ise örneklem ortalamasının anakütle ortalamasının bir tahmini olarak hassasiyetini tanımlar ve "Çalışmayı tekrarlasaydık örneklem ortalamaları ne kadar değişirdi?" sorusunu yanıtlar.
Matematiksel ilişki bu ayrımı netleştirmeye yardımcı olur:
Standart hata, standart sapmanın örneklem büyüklüğünün kareköküne bölünmesine eşittir; bu nedenle, n = 1 dışında standart hata her zaman standart sapmadan küçüktür. Yetişkin boylarına ait bir veri kümesi 4 inçlik bir standart sapmaya sahip olabilir (bireysel boyların önemli ölçüde değiştiğini gösterir), ancak örneklem ortalaması için 0,1 inçlik bir standart hataya sahip olabilir (ortalama boyun çok hassas bir şekilde tahmin edildiğini gösterir).
Hassasiyet ve doğrulukla ilgili yanlış kanılar
Standart hata hassasiyeti ölçer, doğruluğu değil. Küçük standart hata, tekrarlanan örneklemlerin benzer tahminler üreteceği için yüksek hassasiyete işaret eder; ancak doğruluk, sistematik yanlılıklar tarafından zedelenebilir.
Banyodaki bir baskülün sürekli olarak 5 pound fazla gösterdiğini düşünün: Kendinizi 100 kez tartmanız çok hassas ölçümler (küçük standart hata) üretir, ancak sonuçlar tutarlı şekilde yanlış olur. Düşük standart hata, doğru sonuçları garanti etmez.
Dezavantajlar ve sınırlamalar
Standart hata hesaplamaları, rastgele örnekleme, bağımsız gözlemler ve çoğu zaman normallik varsayımına dayanır. Rastgele olmayan örnekleme, standart hatayı uygunsuz kılar; okullar içindeki öğrenciler gibi ilişkili gözlemler ise daha büyük standart hatalar gerektirir.
Düşük standart hatayı bir sonucun "kanıtı" olarak görmeyin. Küçük standart hataya sahip bir randomize kontrollü çalışma, aynı derecede küçük standart hataya sahip bir gözlemsel çalışmadan daha güçlü kanıt sağlar; çünkü çalışma tasarımı, istatistiksel hassasiyetten bağımsız olarak geçerliliği etkiler. R ile Deneysel Tasarım kursumuz, standart hata hesaplamalarınızın geçerli sonuçlara yol açmasını sağlayan uygun rastgeleleştirme, bloklama ve deneysel kontrol ilkelerini kapsar.
İleri Yöntemsel Genişletmeler
Modern istatistiksel uygulama, klasik standart hata yaklaşımlarına alternatifler ve genişletmeler geliştirmiştir; bunlar, geleneksel yöntemlerin yetersiz kaldığı durumlarda ya da daha sofistike belirsizlik nicemlemesi gerektiğinde çözümler sunar.
Bootstrap teknikleri, dağılım varsayımlarına dayanmayan parametrik olmayan bir yaklaşım sunar. Orijinal veriyi tekrar tekrar yeniden örnekleyerek, analitik formüllerin bulunmadığı karmaşık istatistikler için standart hataları tahmin eder. Python ile Örnekleme kursumuz bootstrap tekniklerini kapsar.
Sağlam (robust) standart hatalar, varsayım ihlallerine göre ayarlama yapar. Değişen varyans tutarlılığına (heteroskedastisite) duyarlı sağlam standart hatalar, artık varyans sabit olmadığında da geçerliliğini korur; kümelenmiş standart hatalar ise gruplar içindeki korelasyonu hesaba katar. Bu yöntemler genellikle daha büyük standart hatalar üretir ve daha temkinli çıkarım sağlar.
Bayesçi yaklaşımlar, standart hatalar yerine artk (posterior) dağılımlar aracılığıyla belirsizliği nicemler. Bayesçi güvenilir aralıklar doğrudan olasılık ifadeleri sunar: "Parametrenin 2,1 ile 4,7 arasında olma olasılığı %95." rstanarm ile Bayesçi Regresyon Modellemesi kursumuzu inceleyerek Bayesçi yöntemlerin belirsizliği nasıl farklı ele aldığını öğrenin.
Sonuç
Standart hata, örneklem verileri ile anakütle çıkarımları arasında köprü kurarak tahminlerimizin hassasiyetini niceliksel olarak ifade eder ve anlamlı istatistiksel sonuçlara olanak tanır. Kilit içgörü: standart hata hassasiyeti ölçer, doğruluğu değil. Bize, tekrarlanan örneklemler arasında tahminlerimizin ne kadar tutarlı olacağını söyler; bu tahminlerin doğru olup olmadığını değil.
Varsayımları doğrulayarak, doğru türü seçerek ve sonuçları çalışma tasarımının daha geniş bağlamında yorumlayarak standart hatayı uygun şekilde kullanın. Nokta tahminlerinin yanında daima standart hataları rapor edin, hangi türü kullandığınızı belirtin ve sınırlamaları kabul edin. Daha derin bir anlayış için R ile İstatistiksel Çıkarım yolumuzu keşfetmeyi düşünün.
İster deney tasarlayın, ister anket verilerini analiz edin, ister araştırma sonuçlarını yorumlayın; standart hata, istatistiksel bulgulara güven oluşturan dürüst belirsizlik nicemlemesinin temelini sağlar.