Wanneer een medisch onderzoeker beweert dat een nieuw medicijn de bloeddruk gemiddeld met 15 punten verlaagt, hoe zeker kunnen we dan zijn van die claim? Het antwoord ligt vaak in het begrip standaardfout: een statistische maatstaf die aangeeft hoe precies onze schattingswaarden uit steekproeven werkelijk zijn.
William Sealy Gosset, die onder het pseudoniem "Student" schreef terwijl hij bij de Guinness-brouwerij werkte, ontwikkelde de kleinschalige steekproeftheorie aan de hand van echte brouwproblemen. Zijn werk gaf ons de wiskundige basis om stevige conclusies te trekken wanneer we de werkelijke populatieparameters niet kennen.
Deze gids introduceert de kernconcepten, wiskundige formules en praktische toepassingen van standaardfout in verschillende statistische contexten. Onze Sampling in R-cursus behandelt de principes achter deze berekeningen uitgebreider, en inzicht in hoe standaardfout zich verhoudt tot de steekproefstandaarddeviatie geeft je een solide basis voor statistische inferentie.
Wat is standaardfout?
Standaardfout geeft een maat voor de onzekerheid rond statistieken uit steekproeven en helpt ons te begrijpen hoeveel onze schattingen kunnen variëren als we dezelfde studie meerdere keren herhalen. We bekijken het kernconcept en verkennen de verschillende vormen die standaardfout aanneemt in uiteenlopende statistische analyses.
Kernconcept en intuïtie
Standaardfout meet de variabiliteit van een steekproefstatistiek over herhaalde steekproeven uit dezelfde populatie. Zie het als het antwoord op: "Als ik 100 verschillende steekproeven van dezelfde grootte neem, hoeveel zouden mijn steekproefgemiddelden dan variëren?"
Dit concept komt rechtstreeks voort uit de theorie van steekproevenverdelingen. Wanneer we een steekproefgemiddelde berekenen, is die waarde slechts één mogelijke uitkomst uit vele potentiële steekproeven. De standaardfout kwantificeert de typische afstand tussen een individuele steekproefstatistiek en de werkelijke populatieparameter die we proberen te schatten.
Standaardfout geeft aan hoe goed een steekproefstatistiek een populatieparameter benadert. Een kleinere standaardfout betekent dat herhaalde steekproeven vergelijkbare schattingen zouden opleveren, wat suggereert dat onze huidige steekproef een betrouwbare benadering biedt. Een grotere standaardfout wijst op aanzienlijke variabiliteit tussen potentiële steekproeven en dus op minder vertrouwen in onze schatting.
Meerdere typen standaardfout
Er bestaat niet slechts één soort standaardfout. Verschillende statistieken vereisen hun eigen gespecialiseerde formules, afhankelijk van wat we meten. De meest voorkomende typen zijn:
- Standaardfout van het gemiddelde: Gebruikt bij het schatten van populatiegemiddelden
- Standaardfout van een proportie: Toegepast op percentage- of tariefschattingen
- Standaardfout van het verschil tussen gemiddelden: Gebruikt bij het vergelijken van twee groepen
- Standaardfout van regressiecoëfficiënten: Toegepast op hellingsschattingen in lineaire modellen
Elk type dient specifieke analytische doelen en pakt verschillende bronnen van variabiliteit aan. Zo houdt de standaardfout van een proportie rekening met het binomiale karakter van ja/nee-antwoorden, terwijl de standaardfout van een regressiehelling zowel de residuvariatie als de spreiding van voorspellerwaarden meeneemt.
De juiste keuze is belangrijk. Het gebruik van de verkeerde formule kan leiden tot al te zelfverzekerde conclusies of tot het missen van belangrijke effecten.
Conceptuele basis van standaardfout
Dit onderdeel verkent hoe standaardfout verankerd is in steekproeftheorie en statistische redenering, en biedt de theoretische basis die standaardfoutberekeningen betekenisvol en betrouwbaar maakt.
Theorie van steekproevenverdelingen
Het concept van de steekproevenverdeling vormt de theoretische basis voor standaardfout. Als we alle mogelijke steekproeven van grootte n uit een populatie konden trekken en voor elke steekproef de statistiek van belang berekenden, zouden we een steekproevenverdeling creëren. De standaardfout is gelijk aan de standaarddeviatie van deze theoretische steekproevenverdeling, wat verklaart waarom ze kwantificeert hoeveel individuele steekproefstatistieken variëren rond de werkelijke populatieparameter.
Steekproefgrootte heeft een omgekeerde relatie met standaardfout. Naarmate de steekproefgrootte toeneemt, daalt de standaardfout evenredig met de wortel van n. De centrale limietstelling voegt toe dat steekproevenverdelingen normaliteit benaderen naarmate de steekproef groter wordt, ongeacht de onderliggende populatieverdeling. Deze normaliteitsaannames stellen ons in staat om betrouwbaarheidsintervallen en hypothesetoetsen op te stellen met standaardfout, zelfs bij niet-normale data, mits de steekproef groot genoeg is.
Factoren die de grootte beïnvloeden
Drie factoren bepalen de grootte van de standaardfout: steekproefgrootte, populatievariabiliteit en steekproefopzet. Populatievariabiliteit beïnvloedt de standaardfout direct. Variabelere populaties produceren grotere standaardfouten voor een gegeven steekproefgrootte. Een enquête naar huishoudinkomen in stedelijke gebieden met extreme vermogensverschillen zal grotere standaardfouten opleveren dan in landelijke gebieden met meer homogene inkomens, zelfs bij identieke steekproefgroottes.
Steekproefgrootte is de meest stuurbare factor via de omgekeerde wortelrelatie. Om de standaardfout te halveren, moet je de steekproefgrootte verviervoudigen. De steekproefopzet doet er ook toe: clustersteekproeven vergroten doorgaans de standaardfout omdat observaties binnen clusters vaak op elkaar lijken, terwijl gestratificeerde steekproeven de standaardfout kunnen verkleinen door representatie over belangrijke subgroepen te waarborgen.
Standaardfout, steekproefgrootte en de wet van de grote aantallen
De wet van de grote aantallen verklaart waarom standaardfout afneemt bij grotere steekproeven. Steekproefstatistieken convergeren naar populatieparameters naarmate de steekproefgrootte toeneemt. Standaardfout is evenredig met 1/√n. Daarom zijn enorme steekproeven nodig voor substantiële precisiewinst. Het verviervoudigen van de steekproefgrootte halveert slechts de standaardfout.
Maar er is een kanttekening: hoewel grotere steekproeven de standaardfout verkleinen en de precisie verhogen, kunnen extreem grote steekproeven statistisch significante resultaten opleveren voor triviale verschillen zonder praktische relevantie. Een studie met 100.000 mensen kan een statistisch significant maar klinisch irrelevant verschil van 0,1 punt in bloeddruk detecteren. Kleine steekproeven kunnen belangrijke effecten missen door grote standaardfouten. Je moet statistische significantie afwegen tegen praktische relevantie.
Van conceptueel begrip naar rekenprocedures: de wiskundige formules en stapsgewijze berekeningen maken standaardfout praktisch toepasbaar voor data-analyse.
Fundamentele vergelijkingen voor verschillende scenario's
De basisformule voor de standaardfout van het gemiddelde hangt af van de vraag of de populatiestandaarddeviatie bekend is. Als die bekend is, gebruiken we de populatieparameter direct:
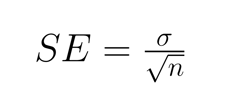
Waarbij:
- σ = populatiestandaarddeviatie
- n = steekproefgrootte
Vaker is de populatiestandaarddeviatie onbekend, dus substitueren we de steekproefstandaarddeviatie. Dat introduceert extra onzekerheid waarvoor we de t-verdeling moeten raadplegen:
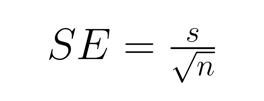
Waarbij:
- s = steekproefstandaarddeviatie
- n = steekproefgrootte
Standaardfout van een proportie behandelt binaire uitkomsten met de binomiale verdelingsformule:
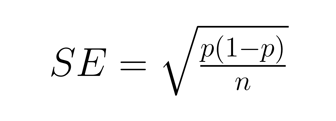
Waarbij:
- p = steekproefproportie
- n = steekproefgrootte
Standaardfout van een regressiehelling omvat zowel residuvariatie als de spreiding van de voorspeller:
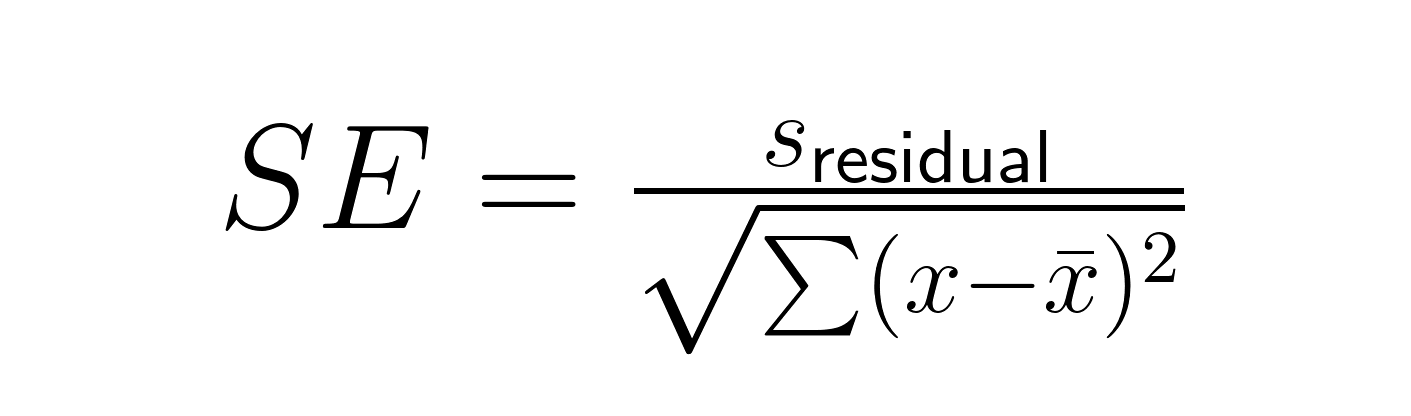
Waarbij:
- sresidual = residustandaardfout uit de regressie
- x = individuele voorspellerwaarden
- x̄ = gemiddelde van de voorspellerwaarden
Standaardfout van het verschil tussen gemiddelden varieert afhankelijk van of groepen onafhankelijk of gepaard zijn. Voor onafhankelijke groepen:
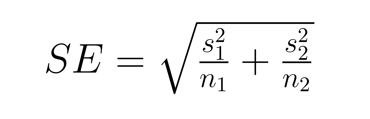
Waarbij:
- s₁, s₂ = standaarddeviaties van groepen 1 en 2
- n₁, n₂ = steekproefgroottes van groepen 1 en 2
Voor gepaarde vergelijkingen vereenvoudigt de formule aanzienlijk:
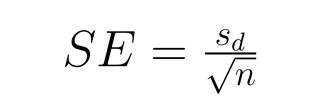
Waarbij:
- sd = standaarddeviatie van de gepaarde verschillen
- n = aantal paren
Rekenprocedures en scenario's
Bekende populatieparameters vormen het ideale scenario en maken gebruik van de normale verdeling voor inferentie mogelijk. Onbekende parameters weerspiegelen typische onderzoeksituaties waarin we schatten op basis van steekproefdata via een driestappenproces:
Stap 1: Bereken het steekproefgemiddelde
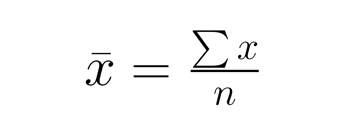
Stap 2: Bereken de steekproefstandaarddeviatie
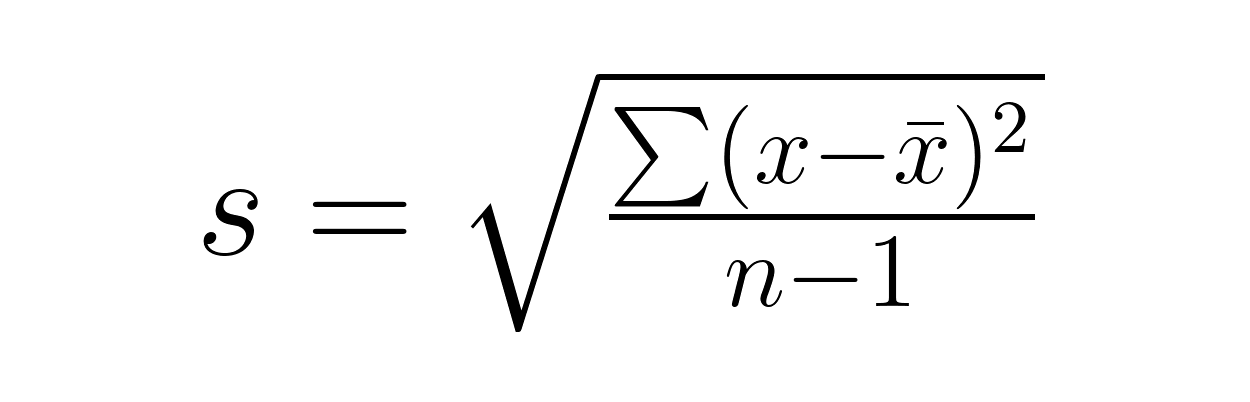
Stap 3: Pas de juiste standaardfoutformule toe met gebruik van de steekproefstandaarddeviatie.
Interpretatie: Kleinere standaardfouten duiden op preciesere schattingen. Een standaardfout van 2,5 bij een steekproefgemiddelde van 50 suggereert dat het werkelijke populatiegemiddelde waarschijnlijk ruwweg tussen 45 en 55 ligt, terwijl een standaardfout van 10 veel meer onzekerheid aangeeft. Onder benaderende normaliteit ligt ongeveer 68% binnen 1 SE en ongeveer 95% binnen 1,96 SE van het werkelijke gemiddelde. Gebruik bij kleine steekproeven met s de kritieke t-waarden.
Uitbreidingen en correcties
De eindige-populatiecorrectie (FPC) wordt nodig wanneer je meer dan 5% van een eindige populatie bemonstert:
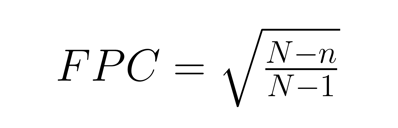
Waarbij:
- N = totale populatiegrootte
- n = steekproefgrootte
De gecorrigeerde standaardfout wordt dan:
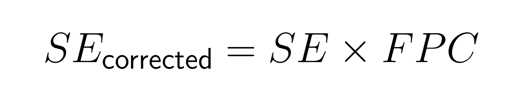
Bijvoorbeeld: een enquête onder 200 mensen in een stad met 2.000 inwoners levert een correctiefactor op van ongeveer 0,95, waardoor de standaardfout met 5% afneemt.
Clustersteekproeven vereisen aanpassingen voor een lagere effectieve steekproefgrootte met behulp van het design effect:
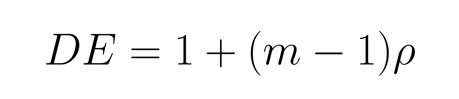
Waarbij:
- m = gemiddelde clustergrootte
- ρ = intraclustercorrelatiecoëfficiënt (hoe sterk observaties binnen clusters op elkaar lijken)
De aangepaste standaardfout wordt dan:
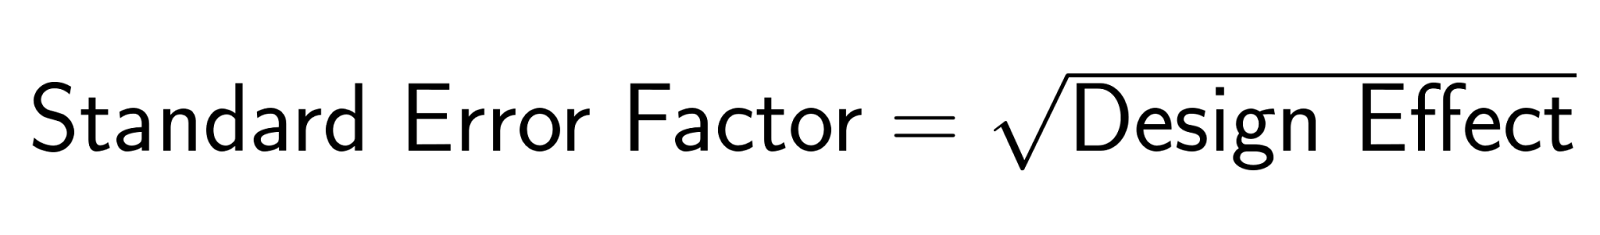
Wanneer gezinsleden vergelijkbare meningen hebben (ρ = 0,3) en de gemiddelde huishoudgrootte 3 is, is het design effect DE = 1 + (3-1)(0,3) = 1,6. De standaardfoutfactor is √1,6 = 1,27, waardoor standaardfouten 27% groter zijn dan bij een eenvoudige aselecte steekproef.
Toepassingen in statistische inferentie
Standaardfout is de hoeksteen van een aantal van de belangrijkste technieken in statistische inferentie, van betrouwbaarheidsintervallen tot hypothesetoetsing. In dit onderdeel verkennen we hoe standaardfout deze fundamentele procedures mogelijk en betrouwbaar maakt.
Constructie van betrouwbaarheidsintervallen
Standaardfout bepaalt rechtstreeks de breedte van betrouwbaarheidsintervallen:
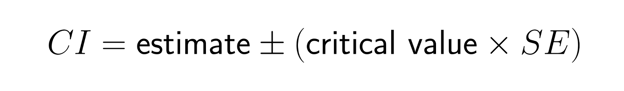
Bij grote steekproeven is de kritieke waarde ongeveer 1,96 voor 95% betrouwbaarheid. Kleinere steekproeven gebruiken kritieke waarden uit de t-verdeling die iets groter zijn. Deze relatie verklaart waarom onderzoekers vaak standaardfouten naast puntschattingen rapporteren: ze geven direct inzicht in de precisie van de bevindingen.
Smalle intervallen duiden op precieze schattingen met kleine standaardfouten, terwijl brede intervallen aanzienlijke onzekerheid suggereren. Het betrouwbaarheidsniveau (95%, 99%, etc.) bepaalt hoe zeker we willen zijn, maar de intervalbreedte hangt cruciaal af van de standaardfout.
Kader voor hypothesetoetsing
Standaardfout standaardiseert toetsingsstatistieken door ruwe verschillen om te zetten in eenheden van steekproefvariabiliteit:
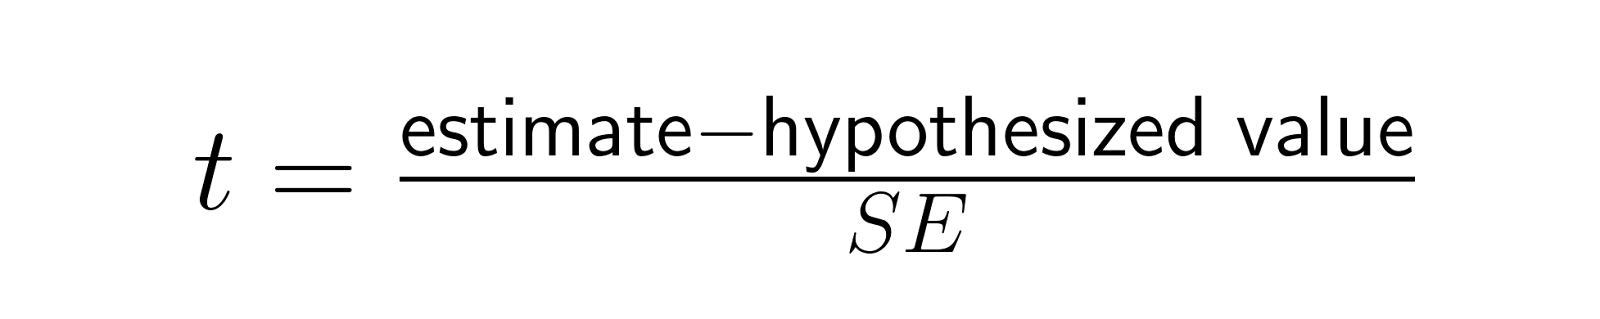
Deze t-statistiek maakt zinvolle vergelijking tussen verschillende studies en effectgroottes mogelijk door verschillen uit te drukken ten opzichte van hun verwachte variabiliteit onder de nulhypothese. Een verschil van 5 punten kan betekenisvol zijn bij SE = 1 (t = 5) maar triviaal bij SE = 10 (t = 0,5), wat illustreert hoe standaardfout de context biedt voor het interpreteren van effectgroottes.
Omdat statistische toetsen het geobserveerde effect delen door de standaardfout, zorgen kleinere standaardfouten ervoor dat zelfs bescheiden echte effecten statistische significantie bereiken, terwijl grotere standaardfouten grotere effecten vereisen om significant te worden. Dit verklaart waarom grote studies kleine maar echte effecten kunnen detecteren die kleinere studies zouden missen.
In meta-analyses bepaalt de standaardfout hoeveel gewicht elke studie krijgt via inverse variantieweging:
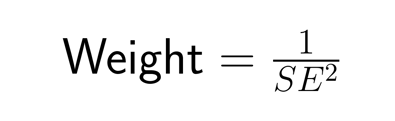
Studies met kleinere standaardfouten (preciezere schattingen) krijgen meer gewicht dan studies met grotere standaardfouten, in lijn met het principe dat preciezere schattingen meer moeten bijdragen aan ons totale begrip. Een studie met een standaardfout van 0,5 krijgt vier keer zoveel gewicht als een studie met een standaardfout van 1,0, waardoor informatie over studies heen optimaal wordt gecombineerd om de totale standaardfout van de meta-analytische schatting te minimaliseren.
Rapporteren en interpreteren van standaardfout
Heldere communicatie over standaardfout vraagt aandacht voor zowel presentatievorm als interpretatieve context. Hieronder vind je praktische richtlijnen voor het presenteren van standaardfoutresultaten en het vermijden van veelgemaakte interpretatiefouten.
Best practices voor rapportage
Specificeer altijd welk type standaardfout je rapporteert en hanteer een consistente opmaak. Gebruik formats als "Gemiddelde (SE)" zoals "45,2 (2,8)" in tabellen. Gebruik in grafieken foutbalken die één standaardfout boven en onder de puntschattingen uitsteken, maar wees expliciet of de foutbalken standaardfout, standaarddeviatie of betrouwbaarheidsintervallen weergeven.
Interpretatie in regressie en modellen
Regressie-uitvoer toont standaardfouten naast coëfficiëntschattingen. Een coëfficiënt van 0,75 met SE = 0,25 suggereert dat het werkelijke effect waarschijnlijk ruwweg tussen 0,25 en 1,25 ligt, terwijl de t-statistiek van 3,0 sterk bewijs tegen de nulhypothese aangeeft.
Overwegingen rond niet-steekproeffouten
Standaardfout kwantificeert alleen steekproefvariabiliteit. Ze omvat geen meetfouten, non-responsbias of andere bronnen van onzekerheid. Systematische vertekeningen zoals selectiebias of confounding kunnen onjuiste schattingen opleveren ongeacht hoe klein de standaardfout is. Laat kleine standaardfouten je geen overmoedig vertrouwen geven in resultaten die mogelijk toch systematisch vertekend zijn.
Veelvoorkomende misinterpretaties en valkuilen
Zorgvuldige interpretatie van standaardfout vereist bewustzijn van veelvoorkomende misvattingen die tot onjuiste conclusies kunnen leiden. Dit onderdeel behandelt de meest voorkomende bronnen van verwarring en biedt richtlijnen om interpretatiefouten te voorkomen.
Standaardfout vs. standaarddeviatie
Standaardfout en standaarddeviatie meten verschillende aspecten van variabiliteit en moeten niet worden verward, ook al gebeurt die verwarring vaak in zowel onderzoeksrapporten als populaire media. Standaarddeviatie beschrijft de spreiding van individuele observaties rond het steekproefgemiddelde en beantwoordt de vraag: "Hoeveel wijken individuele datapunten af van het gemiddelde?" Standaardfout beschrijft de precisie van het steekproefgemiddelde als schatting van het populatiegemiddelde en beantwoordt: "Hoeveel zouden steekproefgemiddelden variëren als we de studie herhalen?"
De wiskundige relatie helpt het onderscheid te verduidelijken:
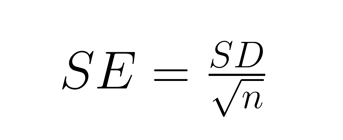
Standaardfout is gelijk aan de standaarddeviatie gedeeld door de wortel uit de steekproefgrootte, dus standaardfout is altijd kleiner dan standaarddeviatie (behalve wanneer n = 1). Een dataset met lengtes van volwassenen kan een standaarddeviatie van 4 inch hebben (wat aangeeft dat individuele lengtes aanzienlijk variëren), maar een standaardfout van 0,1 inch voor het steekproefgemiddelde (wat zeer precieze schatting van de gemiddelde lengte aangeeft).
Misvattingen over precisie vs. nauwkeurigheid
Standaardfout meet precisie, niet nauwkeurigheid. Een kleine standaardfout duidt op hoge precisie omdat herhaalde steekproeven vergelijkbare schattingen zouden opleveren, maar de nauwkeurigheid kan worden aangetast door systematische vertekeningen.
Denk aan een weegschaal die consequent 5 pond te veel aangeeft: jezelf 100 keer wegen levert zeer precieze metingen op (kleine standaardfout) maar steeds onnauwkeurige resultaten. Een lage standaardfout garandeert geen correcte resultaten.
Nadelen en beperkingen
Berekeningen van standaardfout gaan uit van aselecte steekproeven, onafhankelijke observaties en vaak normaliteit. Niet-aselecte steekproeven maken standaardfout ongeschikt, terwijl gecorreleerde observaties (zoals studenten binnen scholen) grotere standaardfouten vereisen.
Zie een lage standaardfout niet als "bewijs" van een resultaat. Een gerandomiseerde gecontroleerde trial met een kleine standaardfout levert sterker bewijs dan een observationele studie met even kleine standaardfout, omdat de onderzoeksopzet de geldigheid beïnvloedt ongeacht de statistische precisie. Onze Experimental Design in R-cursus behandelt de principes van juiste randomisatie, blokkering en experimentele controle die ervoor zorgen dat je standaardfoutberekeningen tot geldige conclusies leiden.
Geavanceerde methodologische uitbreidingen
In de moderne statistische praktijk zijn alternatieven en uitbreidingen op klassieke benaderingen van standaardfout ontwikkeld, die oplossingen bieden wanneer traditionele methoden tekortschieten of wanneer meer geavanceerde onzekerheidskwantificatie nodig is.
Bootstraptechnieken bieden een non-parametrische aanpak die niet op verdelingsaannames steunt. Door de oorspronkelijke data herhaaldelijk te hersampelen, schatten bootstrapmethoden standaardfouten voor complexe statistieken waarvoor geen analytische formules bestaan. Onze Sampling in Python-cursus behandelt bootstraptechnieken.
Robuuste standaardfouten corrigeren voor schendingen van aannames. Heteroscedasticity-consistente standaardfouten blijven geldig wanneer de residuvariantie niet constant is, terwijl geclusterde standaardfouten rekening houden met correlatie binnen groepen. Deze methoden produceren doorgaans grotere standaardfouten en leveren daardoor meer conservatieve inferenties op.
Bayesiaanse benaderingen kwantificeren onzekerheid via posterieure verdelingen in plaats van via standaardfouten. Bayesiaanse geloofwaardigheidsintervallen geven directe probabilistische uitspraken: "Er is 95% kans dat de parameter tussen 2,1 en 4,7 ligt." Bekijk onze Bayesian Regression Modeling with rstanarm-cursus om te leren hoe Bayesiaanse methoden anders met onzekerheid omgaan.
Conclusie
Standaardfout vormt de brug tussen steekproefdata en populatie-inferenties: ze kwantificeert de precisie van onze schattingen en maakt betekenisvolle statistische conclusies mogelijk. De kern: standaardfout meet precisie, niet nauwkeurigheid. Ze vertelt ons hoe consistent onze schattingen zouden zijn over herhaalde steekproeven, niet of die schattingen correct zijn.
Gebruik standaardfout op de juiste manier door aannames te verifiëren, het juiste type te kiezen en resultaten te interpreteren in de bredere context van het onderzoeksontwerp. Rapporteer altijd standaardfouten naast puntschattingen, specificeer welk type je gebruikt en erken beperkingen. Overweeg om geavanceerde methoden te verkennen via ons Statistical Inference in R-track voor een dieper begrip.
Of je nu experimenten ontwerpt, enquêtegegevens analyseert of onderzoeksresultaten interpreteert: standaardfout biedt de basis voor eerlijke onzekerheidskwantificatie die vertrouwen wekt in statistische bevindingen.




Wanneer een medisch onderzoeker beweert dat een nieuw medicijn de bloeddruk gemiddeld met 15 punten verlaagt, hoe zeker kunnen we dan zijn van die claim? Het antwoord ligt vaak in het begrip standaardfout: een statistische maatstaf die aangeeft hoe precies onze schattingswaarden uit steekproeven werkelijk zijn.
William Sealy Gosset, die onder het pseudoniem "Student" schreef terwijl hij bij de Guinness-brouwerij werkte, ontwikkelde de kleinschalige steekproeftheorie aan de hand van echte brouwproblemen. Zijn werk gaf ons de wiskundige basis om stevige conclusies te trekken wanneer we de werkelijke populatieparameters niet kennen.
Deze gids introduceert de kernconcepten, wiskundige formules en praktische toepassingen van standaardfout in verschillende statistische contexten. Onze Sampling in R-cursus behandelt de principes achter deze berekeningen uitgebreider, en inzicht in hoe standaardfout zich verhoudt tot de steekproefstandaarddeviatie geeft je een solide basis voor statistische inferentie.
Wat is standaardfout?
Standaardfout geeft een maat voor de onzekerheid rond statistieken uit steekproeven en helpt ons te begrijpen hoeveel onze schattingen kunnen variëren als we dezelfde studie meerdere keren herhalen. We bekijken het kernconcept en verkennen de verschillende vormen die standaardfout aanneemt in uiteenlopende statistische analyses.
Kernconcept en intuïtie
Standaardfout meet de variabiliteit van een steekproefstatistiek over herhaalde steekproeven uit dezelfde populatie. Zie het als het antwoord op: "Als ik 100 verschillende steekproeven van dezelfde grootte neem, hoeveel zouden mijn steekproefgemiddelden dan variëren?"
Dit concept komt rechtstreeks voort uit de theorie van steekproevenverdelingen. Wanneer we een steekproefgemiddelde berekenen, is die waarde slechts één mogelijke uitkomst uit vele potentiële steekproeven. De standaardfout kwantificeert de typische afstand tussen een individuele steekproefstatistiek en de werkelijke populatieparameter die we proberen te schatten.
Standaardfout geeft aan hoe goed een steekproefstatistiek een populatieparameter benadert. Een kleinere standaardfout betekent dat herhaalde steekproeven vergelijkbare schattingen zouden opleveren, wat suggereert dat onze huidige steekproef een betrouwbare benadering biedt. Een grotere standaardfout wijst op aanzienlijke variabiliteit tussen potentiële steekproeven en dus op minder vertrouwen in onze schatting.
Meerdere typen standaardfout
Er bestaat niet slechts één soort standaardfout. Verschillende statistieken vereisen hun eigen gespecialiseerde formules, afhankelijk van wat we meten. De meest voorkomende typen zijn:
Elk type dient specifieke analytische doelen en pakt verschillende bronnen van variabiliteit aan. Zo houdt de standaardfout van een proportie rekening met het binomiale karakter van ja/nee-antwoorden, terwijl de standaardfout van een regressiehelling zowel de residuvariatie als de spreiding van voorspellerwaarden meeneemt.
De juiste keuze is belangrijk. Het gebruik van de verkeerde formule kan leiden tot al te zelfverzekerde conclusies of tot het missen van belangrijke effecten.
Conceptuele basis van standaardfout
Dit onderdeel verkent hoe standaardfout verankerd is in steekproeftheorie en statistische redenering, en biedt de theoretische basis die standaardfoutberekeningen betekenisvol en betrouwbaar maakt.
Theorie van steekproevenverdelingen
Het concept van de steekproevenverdeling vormt de theoretische basis voor standaardfout. Als we alle mogelijke steekproeven van grootte n uit een populatie konden trekken en voor elke steekproef de statistiek van belang berekenden, zouden we een steekproevenverdeling creëren. De standaardfout is gelijk aan de standaarddeviatie van deze theoretische steekproevenverdeling, wat verklaart waarom ze kwantificeert hoeveel individuele steekproefstatistieken variëren rond de werkelijke populatieparameter.
Steekproefgrootte heeft een omgekeerde relatie met standaardfout. Naarmate de steekproefgrootte toeneemt, daalt de standaardfout evenredig met de wortel van n. De centrale limietstelling voegt toe dat steekproevenverdelingen normaliteit benaderen naarmate de steekproef groter wordt, ongeacht de onderliggende populatieverdeling. Deze normaliteitsaannames stellen ons in staat om betrouwbaarheidsintervallen en hypothesetoetsen op te stellen met standaardfout, zelfs bij niet-normale data, mits de steekproef groot genoeg is.
Factoren die de grootte beïnvloeden
Drie factoren bepalen de grootte van de standaardfout: steekproefgrootte, populatievariabiliteit en steekproefopzet. Populatievariabiliteit beïnvloedt de standaardfout direct. Variabelere populaties produceren grotere standaardfouten voor een gegeven steekproefgrootte. Een enquête naar huishoudinkomen in stedelijke gebieden met extreme vermogensverschillen zal grotere standaardfouten opleveren dan in landelijke gebieden met meer homogene inkomens, zelfs bij identieke steekproefgroottes.
Steekproefgrootte is de meest stuurbare factor via de omgekeerde wortelrelatie. Om de standaardfout te halveren, moet je de steekproefgrootte verviervoudigen. De steekproefopzet doet er ook toe: clustersteekproeven vergroten doorgaans de standaardfout omdat observaties binnen clusters vaak op elkaar lijken, terwijl gestratificeerde steekproeven de standaardfout kunnen verkleinen door representatie over belangrijke subgroepen te waarborgen.
Standaardfout, steekproefgrootte en de wet van de grote aantallen
De wet van de grote aantallen verklaart waarom standaardfout afneemt bij grotere steekproeven. Steekproefstatistieken convergeren naar populatieparameters naarmate de steekproefgrootte toeneemt. Standaardfout is evenredig met 1/√n. Daarom zijn enorme steekproeven nodig voor substantiële precisiewinst. Het verviervoudigen van de steekproefgrootte halveert slechts de standaardfout.
Maar er is een kanttekening: hoewel grotere steekproeven de standaardfout verkleinen en de precisie verhogen, kunnen extreem grote steekproeven statistisch significante resultaten opleveren voor triviale verschillen zonder praktische relevantie. Een studie met 100.000 mensen kan een statistisch significant maar klinisch irrelevant verschil van 0,1 punt in bloeddruk detecteren. Kleine steekproeven kunnen belangrijke effecten missen door grote standaardfouten. Je moet statistische significantie afwegen tegen praktische relevantie.
Wiskundige formulering en berekening
Van conceptueel begrip naar rekenprocedures: de wiskundige formules en stapsgewijze berekeningen maken standaardfout praktisch toepasbaar voor data-analyse.
Fundamentele vergelijkingen voor verschillende scenario's
De basisformule voor de standaardfout van het gemiddelde hangt af van de vraag of de populatiestandaarddeviatie bekend is. Als die bekend is, gebruiken we de populatieparameter direct:
Waarbij:
Vaker is de populatiestandaarddeviatie onbekend, dus substitueren we de steekproefstandaarddeviatie. Dat introduceert extra onzekerheid waarvoor we de t-verdeling moeten raadplegen:
Waarbij:
Standaardfout van een proportie behandelt binaire uitkomsten met de binomiale verdelingsformule:
Waarbij:
Standaardfout van een regressiehelling omvat zowel residuvariatie als de spreiding van de voorspeller:
Waarbij:
Standaardfout van het verschil tussen gemiddelden varieert afhankelijk van of groepen onafhankelijk of gepaard zijn. Voor onafhankelijke groepen:
Waarbij:
Voor gepaarde vergelijkingen vereenvoudigt de formule aanzienlijk:
Waarbij:
Rekenprocedures en scenario's
Bekende populatieparameters vormen het ideale scenario en maken gebruik van de normale verdeling voor inferentie mogelijk. Onbekende parameters weerspiegelen typische onderzoeksituaties waarin we schatten op basis van steekproefdata via een driestappenproces:
Stap 1: Bereken het steekproefgemiddelde
Stap 2: Bereken de steekproefstandaarddeviatie
Stap 3: Pas de juiste standaardfoutformule toe met gebruik van de steekproefstandaarddeviatie.
Interpretatie: Kleinere standaardfouten duiden op preciesere schattingen. Een standaardfout van 2,5 bij een steekproefgemiddelde van 50 suggereert dat het werkelijke populatiegemiddelde waarschijnlijk ruwweg tussen 45 en 55 ligt, terwijl een standaardfout van 10 veel meer onzekerheid aangeeft. Onder benaderende normaliteit ligt ongeveer 68% binnen 1 SE en ongeveer 95% binnen 1,96 SE van het werkelijke gemiddelde. Gebruik bij kleine steekproeven met s de kritieke t-waarden.
Uitbreidingen en correcties
De eindige-populatiecorrectie (FPC) wordt nodig wanneer je meer dan 5% van een eindige populatie bemonstert:
Waarbij:
De gecorrigeerde standaardfout wordt dan:
Bijvoorbeeld: een enquête onder 200 mensen in een stad met 2.000 inwoners levert een correctiefactor op van ongeveer 0,95, waardoor de standaardfout met 5% afneemt.
Clustersteekproeven vereisen aanpassingen voor een lagere effectieve steekproefgrootte met behulp van het design effect:
Waarbij:
De aangepaste standaardfout wordt dan:
Wanneer gezinsleden vergelijkbare meningen hebben (ρ = 0,3) en de gemiddelde huishoudgrootte 3 is, is het design effect DE = 1 + (3-1)(0,3) = 1,6. De standaardfoutfactor is √1,6 = 1,27, waardoor standaardfouten 27% groter zijn dan bij een eenvoudige aselecte steekproef.
Toepassingen in statistische inferentie
Standaardfout is de hoeksteen van een aantal van de belangrijkste technieken in statistische inferentie, van betrouwbaarheidsintervallen tot hypothesetoetsing. In dit onderdeel verkennen we hoe standaardfout deze fundamentele procedures mogelijk en betrouwbaar maakt.
Constructie van betrouwbaarheidsintervallen
Standaardfout bepaalt rechtstreeks de breedte van betrouwbaarheidsintervallen:
Bij grote steekproeven is de kritieke waarde ongeveer 1,96 voor 95% betrouwbaarheid. Kleinere steekproeven gebruiken kritieke waarden uit de t-verdeling die iets groter zijn. Deze relatie verklaart waarom onderzoekers vaak standaardfouten naast puntschattingen rapporteren: ze geven direct inzicht in de precisie van de bevindingen.
Smalle intervallen duiden op precieze schattingen met kleine standaardfouten, terwijl brede intervallen aanzienlijke onzekerheid suggereren. Het betrouwbaarheidsniveau (95%, 99%, etc.) bepaalt hoe zeker we willen zijn, maar de intervalbreedte hangt cruciaal af van de standaardfout.
Kader voor hypothesetoetsing
Standaardfout standaardiseert toetsingsstatistieken door ruwe verschillen om te zetten in eenheden van steekproefvariabiliteit:
Deze t-statistiek maakt zinvolle vergelijking tussen verschillende studies en effectgroottes mogelijk door verschillen uit te drukken ten opzichte van hun verwachte variabiliteit onder de nulhypothese. Een verschil van 5 punten kan betekenisvol zijn bij SE = 1 (t = 5) maar triviaal bij SE = 10 (t = 0,5), wat illustreert hoe standaardfout de context biedt voor het interpreteren van effectgroottes.
Omdat statistische toetsen het geobserveerde effect delen door de standaardfout, zorgen kleinere standaardfouten ervoor dat zelfs bescheiden echte effecten statistische significantie bereiken, terwijl grotere standaardfouten grotere effecten vereisen om significant te worden. Dit verklaart waarom grote studies kleine maar echte effecten kunnen detecteren die kleinere studies zouden missen.
Meta-analytische toepassingen
In meta-analyses bepaalt de standaardfout hoeveel gewicht elke studie krijgt via inverse variantieweging:
Studies met kleinere standaardfouten (preciezere schattingen) krijgen meer gewicht dan studies met grotere standaardfouten, in lijn met het principe dat preciezere schattingen meer moeten bijdragen aan ons totale begrip. Een studie met een standaardfout van 0,5 krijgt vier keer zoveel gewicht als een studie met een standaardfout van 1,0, waardoor informatie over studies heen optimaal wordt gecombineerd om de totale standaardfout van de meta-analytische schatting te minimaliseren.
Rapporteren en interpreteren van standaardfout
Heldere communicatie over standaardfout vraagt aandacht voor zowel presentatievorm als interpretatieve context. Hieronder vind je praktische richtlijnen voor het presenteren van standaardfoutresultaten en het vermijden van veelgemaakte interpretatiefouten.
Best practices voor rapportage
Specificeer altijd welk type standaardfout je rapporteert en hanteer een consistente opmaak. Gebruik formats als "Gemiddelde (SE)" zoals "45,2 (2,8)" in tabellen. Gebruik in grafieken foutbalken die één standaardfout boven en onder de puntschattingen uitsteken, maar wees expliciet of de foutbalken standaardfout, standaarddeviatie of betrouwbaarheidsintervallen weergeven.
Interpretatie in regressie en modellen
Regressie-uitvoer toont standaardfouten naast coëfficiëntschattingen. Een coëfficiënt van 0,75 met SE = 0,25 suggereert dat het werkelijke effect waarschijnlijk ruwweg tussen 0,25 en 1,25 ligt, terwijl de t-statistiek van 3,0 sterk bewijs tegen de nulhypothese aangeeft.
Overwegingen rond niet-steekproeffouten
Standaardfout kwantificeert alleen steekproefvariabiliteit. Ze omvat geen meetfouten, non-responsbias of andere bronnen van onzekerheid. Systematische vertekeningen zoals selectiebias of confounding kunnen onjuiste schattingen opleveren ongeacht hoe klein de standaardfout is. Laat kleine standaardfouten je geen overmoedig vertrouwen geven in resultaten die mogelijk toch systematisch vertekend zijn.
Veelvoorkomende misinterpretaties en valkuilen
Zorgvuldige interpretatie van standaardfout vereist bewustzijn van veelvoorkomende misvattingen die tot onjuiste conclusies kunnen leiden. Dit onderdeel behandelt de meest voorkomende bronnen van verwarring en biedt richtlijnen om interpretatiefouten te voorkomen.
Standaardfout vs. standaarddeviatie
Standaardfout en standaarddeviatie meten verschillende aspecten van variabiliteit en moeten niet worden verward, ook al gebeurt die verwarring vaak in zowel onderzoeksrapporten als populaire media. Standaarddeviatie beschrijft de spreiding van individuele observaties rond het steekproefgemiddelde en beantwoordt de vraag: "Hoeveel wijken individuele datapunten af van het gemiddelde?" Standaardfout beschrijft de precisie van het steekproefgemiddelde als schatting van het populatiegemiddelde en beantwoordt: "Hoeveel zouden steekproefgemiddelden variëren als we de studie herhalen?"
De wiskundige relatie helpt het onderscheid te verduidelijken:
Standaardfout is gelijk aan de standaarddeviatie gedeeld door de wortel uit de steekproefgrootte, dus standaardfout is altijd kleiner dan standaarddeviatie (behalve wanneer n = 1). Een dataset met lengtes van volwassenen kan een standaarddeviatie van 4 inch hebben (wat aangeeft dat individuele lengtes aanzienlijk variëren), maar een standaardfout van 0,1 inch voor het steekproefgemiddelde (wat zeer precieze schatting van de gemiddelde lengte aangeeft).
Misvattingen over precisie vs. nauwkeurigheid
Standaardfout meet precisie, niet nauwkeurigheid. Een kleine standaardfout duidt op hoge precisie omdat herhaalde steekproeven vergelijkbare schattingen zouden opleveren, maar de nauwkeurigheid kan worden aangetast door systematische vertekeningen.
Denk aan een weegschaal die consequent 5 pond te veel aangeeft: jezelf 100 keer wegen levert zeer precieze metingen op (kleine standaardfout) maar steeds onnauwkeurige resultaten. Een lage standaardfout garandeert geen correcte resultaten.
Nadelen en beperkingen
Berekeningen van standaardfout gaan uit van aselecte steekproeven, onafhankelijke observaties en vaak normaliteit. Niet-aselecte steekproeven maken standaardfout ongeschikt, terwijl gecorreleerde observaties (zoals studenten binnen scholen) grotere standaardfouten vereisen.
Zie een lage standaardfout niet als "bewijs" van een resultaat. Een gerandomiseerde gecontroleerde trial met een kleine standaardfout levert sterker bewijs dan een observationele studie met even kleine standaardfout, omdat de onderzoeksopzet de geldigheid beïnvloedt ongeacht de statistische precisie. Onze Experimental Design in R-cursus behandelt de principes van juiste randomisatie, blokkering en experimentele controle die ervoor zorgen dat je standaardfoutberekeningen tot geldige conclusies leiden.
Geavanceerde methodologische uitbreidingen
In de moderne statistische praktijk zijn alternatieven en uitbreidingen op klassieke benaderingen van standaardfout ontwikkeld, die oplossingen bieden wanneer traditionele methoden tekortschieten of wanneer meer geavanceerde onzekerheidskwantificatie nodig is.
Bootstraptechnieken bieden een non-parametrische aanpak die niet op verdelingsaannames steunt. Door de oorspronkelijke data herhaaldelijk te hersampelen, schatten bootstrapmethoden standaardfouten voor complexe statistieken waarvoor geen analytische formules bestaan. Onze Sampling in Python-cursus behandelt bootstraptechnieken.
Robuuste standaardfouten corrigeren voor schendingen van aannames. Heteroscedasticity-consistente standaardfouten blijven geldig wanneer de residuvariantie niet constant is, terwijl geclusterde standaardfouten rekening houden met correlatie binnen groepen. Deze methoden produceren doorgaans grotere standaardfouten en leveren daardoor meer conservatieve inferenties op.
Bayesiaanse benaderingen kwantificeren onzekerheid via posterieure verdelingen in plaats van via standaardfouten. Bayesiaanse geloofwaardigheidsintervallen geven directe probabilistische uitspraken: "Er is 95% kans dat de parameter tussen 2,1 en 4,7 ligt." Bekijk onze Bayesian Regression Modeling with rstanarm-cursus om te leren hoe Bayesiaanse methoden anders met onzekerheid omgaan.
Conclusie
Standaardfout vormt de brug tussen steekproefdata en populatie-inferenties: ze kwantificeert de precisie van onze schattingen en maakt betekenisvolle statistische conclusies mogelijk. De kern: standaardfout meet precisie, niet nauwkeurigheid. Ze vertelt ons hoe consistent onze schattingen zouden zijn over herhaalde steekproeven, niet of die schattingen correct zijn.
Gebruik standaardfout op de juiste manier door aannames te verifiëren, het juiste type te kiezen en resultaten te interpreteren in de bredere context van het onderzoeksontwerp. Rapporteer altijd standaardfouten naast puntschattingen, specificeer welk type je gebruikt en erken beperkingen. Overweeg om geavanceerde methoden te verkennen via ons Statistical Inference in R-track voor een dieper begrip.
Of je nu experimenten ontwerpt, enquêtegegevens analyseert of onderzoeksresultaten interpreteert: standaardfout biedt de basis voor eerlijke onzekerheidskwantificatie die vertrouwen wekt in statistische bevindingen.