
预测区间与置信区间的差异
预测区间与置信区间这两个概念密切相关。同一项分析往往会同时涉及两类区间。因此,将它们放在一起比较很有帮助。
目的与解读
当您需要了解某个总体参数(如均值)时,会用样本来估计该参数。由于样本量通常远小于总体,样本的参数估计并不完美。置信区间是基于样本估计,预期包含总体参数的范围。
回归系数也属于总体参数。由于它们是基于样本(而非总体)估计得到,因此自带误差,所以也可以用置信区间来表示。
此外,回归可用于预测以下两者之一:
- 因变量的平均值(如 2 岁犬只的平均体重),或
- 某个个体数据点的值(如一只特定 2 岁犬只的体重)。
前者使用置信区间,后者使用预测区间。 下一节将更详细地解释这一差异。
计算方法与区间宽度
推断统计中的置信区间计算
如前所述,置信区间与标准差成正比、与样本量成反比。总体均值 𝛍 的置信区间表示为:
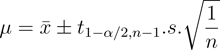
在上式中:
- x 是样本均值,即可测得的估计值
- 𝛍 是总体均值,即您要估计的总体参数。
- n 为样本量
- s 为样本标准差
- t 为在以下条件下的学生 t 分布临界值:
- 显著性水平为 1 - α
- n-1 个自由度
- 可从标准化表中查到 t 值——搜索 “Student’s T table” 即可。
因此,𝛍 的取值范围为:
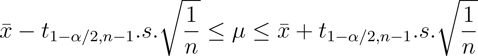
理解置信水平与显著性水平
还要注意,区间大小与 t 值成正比。若您希望对“真实值落在给定范围内”具有极高的把握(确定性),则该范围必须足够大。置信度越低,区间越窄。但置信度过低并无太大意义。因此,实践中常用的置信水平为 90%、95%、99% 等。
如果置信水平为 95%,则显著性水平为 5%。在双侧区间下,您需要查找 2.5%(0.025)处的 t 临界值。
从概念上讲,所有区间都可表示为:

可以看到,误差越大,区间越宽。误差的计算方式因场景而异:在推断问题中,误差为标准差;在回归中,误差见下节。
回归中的置信区间计算
当您要预测因变量的平均值时,会用置信区间来估计其范围。例如,您想根据年龄预测 2 岁犬只的平均体重。这称为均值响应的置信区间。它也被视为总体参数,因为它是整个总体的属性。该区间表示为:
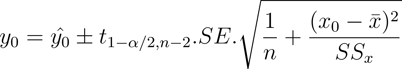
在上式中:
- y0 为被预测参数的真实值。
- y0 为根据回归关系得到的预测值。
- t 临界值的说明见前一节
- n 为样本量
- (x0 - x) 是 x 的均值与待预测 y0 所对应 x0 之间的差。注意这一区别越大,区间越宽。因此,当 x 取值更接近样本均值时,区间更窄(预测更准确)。
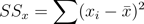
- SSx 为 x 样本值的平方离差,表示为:
- SE 为估计的标准误。它是均方误差(MSE)的平方根。MSE 是误差的方差,因此 SE 类似于误差的标准差。MSE 基于残差误差,表示为:
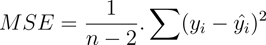
上式中的求和项也称为残差平方和。残差是 y 的真实值与预测值之差。
用 MSE 替代 SE,均值响应的置信区间也可写为:
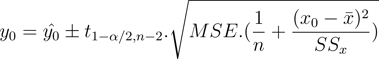
将上式与先前给出的概念性关系作比较。
可以看到,误差考虑了以下因素:
- y 的真实值与预测值之间的差异。
- x 的均值与用于生成预测的 xo 之间的差异
- x 值相对于其均值的总体离散程度
回归中的预测区间计算
当您要预测某个个体数据点(而非均值)的具体取值时,会用预测区间来估计其范围。例如,您想根据年龄预测某一只特定 2 岁犬只的真实体重范围。该区间称为预测区间,表示为:
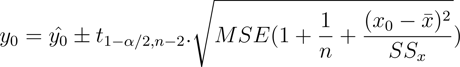
将其与前述置信区间作比较:
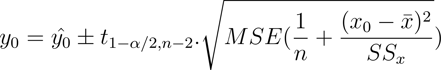
可以看到两式非常相似,唯一的差别是预测区间里多了一个误差项。与置信区间相比,预测区间在根号内多了一个 MSE 项,这是为了纳入您要预测的 y 值的变异性。因此,预测区间比置信区间更宽。
下图示意了点估计(预测值)与置信区间、预测区间之间的关系。
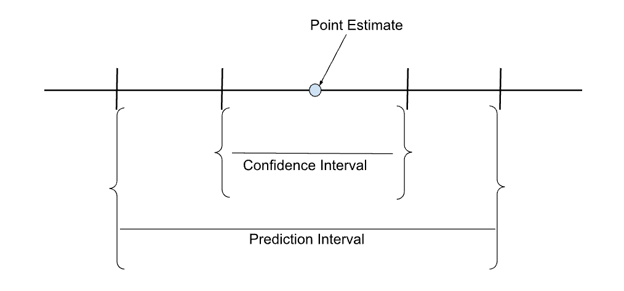
点估计的置信区间与预测区间比较。作者绘制。
下图示意了回归中的置信区间与预测区间——还可看到区间在均值附近最窄。
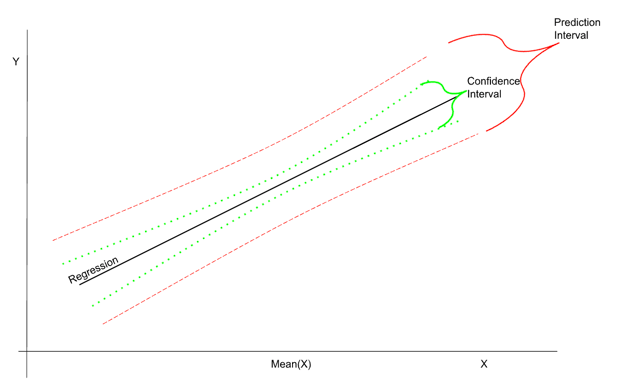
回归中的置信区间与预测区间示意。作者绘制。
何时使用置信区间
前文介绍了置信区间与预测区间的基础、用途及其计算公式。本节结合实例说明二者的适用场景。
在估计总体参数时使用置信区间。 为了估计总体参数,您可以:
- 基于随机样本进行直接测量
- 基于随机样本构建回归模型
置信区间的示例用例如下:
- 基于随机样本测量来估计总体参数。例如,为估计新生儿的平均身高与体重,测量一组随机抽取的新生儿。
- 通过研究随机样本来估计总体行为。这一用例在临床试验中很常见:通过研究药物对随机样本的影响来估计其对总体的影响。
- 基于随机样本进行回归分析,从而预测因变量的均值响应。例如,您想基于每 15 天测量一次的小狗体重样本,预测 55 天大小狗的平均体重。
- 制定制造过程中的公差限。例如,若机器生产规定重量的零件,单个零件的重量不会与规格完全一致,而是落在规格重量的置信区间内。该区间即公差限。超出公差限的零件将被判为不合格。机器应当生产出大部分在公差限内的零件。
- 质量控制。若您想确定机器生产的零件是否在公差限内,不可能逐一测量所有零件,只能依赖随机抽样、测量,并用样本估计去判断总体参数。
- 假设检验。置信水平与显著性水平是一体两面。显著性水平 = 1 - 置信水平。给定置信水平的置信区间,包含了在相应显著性水平(1 - 指定置信水平)下原假设为真的数据点。
何时使用预测区间
当您基于对随机样本的观察(并进行回归分析)来预测某个个体数据点的期望值时,应使用预测区间。
一些实际例子包括:
- 基于回归分析预测个体数据点的取值范围。由于个体数据点的变异性通常大于样本均值,预测区间需要更宽。例如,您想基于每 15 天测量一次的小狗体重样本,预测某只 55 天大小狗的体重。
- 使用蒙特卡罗模拟来预测未知变量的取值。由于蒙特卡罗方法是概率性的,每次运行模型都会得到略有不同的输出。不同输出之间的差异可用蒙特卡罗不确定性区间来表示,其概念上与预测区间相似。
- 在标准回归中,您建立关系来预测某一参数的均值。在分位数回归中,您为目标参数的各个分位数分别建立模型,这也使您能构建更细粒度的预测区间。
- 机器学习模型关注于预测未知参数的取值。这些模型通常基于统计方法,因此预测的是未知量的平均值。因此,模型输出通常同时包含期望(平均)值与预测区间。
- 深度学习模型通过一系列神经网络进行预测。为了评估输出的不确定性,常见做法是随机丢弃不同的神经元以研究输出的波动。预测的方差可用于构建预测区间。
- 在时间序列预测中,目标是在未来时刻预测某个可观测量的取值。预测基于 ARIMA 等统计模型,其对移动平均进行自回归,因此预测的是期望值。实际观测值落在期望值的预测区间内。该预测区间是标准差的函数。例如,在 95% 置信水平下,预测区间为期望值±1.96 个标准差。此外,多步预测(更长的预测视界)通常对应更宽的预测区间。想进一步了解时间序列,请参阅 DataCamp 的 时间序列分析课程。
置信区间 vs 预测区间:总结
置信区间与预测区间常在同一语境下使用,理解它们的差异十分重要。
下表基于前文讨论对差异做一总结:
|
置信区间 |
预测区间 |
|
用于基于样本统计量来确定总体参数 |
不用于基于样本来确定总体参数 |
|
用于基于回归预测均值响应(给定自变量时因变量的平均值)。 |
用于基于回归预测未来值(给定自变量时某个个体数据点的值)。 |
|
在同一分析下通常更窄 |
在同一分析下通常更宽 |
在 R 中实现置信区间与预测区间
本节通过 R 语言的实际示例来估计置信区间与预测区间。R 为统计应用而生,内置数据集与统计函数十分丰富。
要进一步学习如何用 R 做回归,请参阅 DataCamp 的R 线性回归教程。
下面的示例使用内置的 Orange 数据集。该数据集记录了橙树的树围(毫米)与年龄(天)。很自然,树龄越大,树围越大。
在 R 中实现置信区间
以下示例展示如何为汇总统计与回归分析估计置信区间。
汇总统计中的置信区间
要获得均值的置信区间,针对数据集运行标准 t 检验函数 t.test():
t.test(Orange$circumference)输出类似如下示例:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
96.10926 135.60502
sample estimates:
mean of x
115.8571 它给出了均值估计与 95% 置信区间。默认情况下,t 检验函数使用 95% 的置信水平。使用 conf.level 参数可指定不同的置信水平,如 99%。
> t.test(Orange$circumference, conf.level = 0.99)该命令得到如下输出:
t = 11.923, df = 34, p-value = 1.076e-13
alternative hypothesis: true mean is not equal to 0
99 percent confidence interval:
89.34458 142.36970
sample estimates:
mean of x
115.8571 可以看到,两次的均值估计相同。但若要更高的置信水平,区间就需要更宽。基于这些数据,我对“均值位于 89.3 到 142.4 之间”有 99% 的把握;而对“位于 96.1 到 135.6 之间”只有 95% 的把握。对同一样本估计的参数而言,置信区间越窄,置信水平越低。
回归中的置信区间
在回归分析中,您需要回归系数与预测值的置信区间。
如需深入了解如何在 R 中做回归,请参阅 DataCamp 的R 线性回归推断课程。
回归系数的置信区间
回归系数是通过分析随机样本估计得到的,因此并非总体的真实系数。回归参数的估计值伴随一定误差。除了给出估计值,为参数提供置信区间也很有帮助。
使用 lm() 函数基于 Orange 数据集建立线性模型,给定年龄(天)预测橙树的树围(毫米):
model_orange <- lm(circumference ~ age, data = Orange)查看该线性模型的系数:
model_orange该命令会显示模型参数(截距与斜率),如下:
Coefficients: (Intercept) age
17.3997 0.1068 使用 confint() 计算 95% 置信区间:
confint(model_orange, level = 0.95)现在可以看到模型估计的斜率与截距的 95% 置信区间:
2.5 % 97.5 %
(Intercept) -0.14328303 34.9425835
age 0.08993141 0.1236092均值响应预测的置信区间
使用上述回归模型预测 900 天大橙树的期望平均树围。通过 interval 参数指定置信区间。
predict(model_orange, data.frame(age = 900), interval = "confidence", level = 0.95) 输出包含预测值(fit)以及置信区间(下界 lwr 与上界 upr),如下所示:
fit lwr upr
1 113.4929 105.3211 121.6647在 R 中实现预测区间
沿用同一模型来预测某棵 900 天大橙树这一“个体”的具体树围。使用 interval 参数指定需要预测区间。
> predict(model, data.frame(age = 900), interval = "prediction", level = 0.95) 输出类似如下示例:
fit lwr upr
1 113.4929 64.5118 162.4741可以看到,两种情况下预测的树围均为 113.49。但预测区间远宽于置信区间。预测的置信区间给出的是 900 天大橙树“平均”树围的范围;预测区间给出的是单棵 900 天大橙树的树围范围。原因在于个体树之间的差异更大,而取平均时这种差异会被平滑掉。
常见误解与陷阱
统计区间在数据分析、医药统计、计量经济等应用领域十分常见。对缺乏统计学背景的人而言,很容易将置信区间与预测区间混淆。
常见误解包括:
- 只给出预测值而不考虑预测区间。
- 当您用回归模型在给定自变量的情况下预测因变量的取值时,回归方程给出的是因变量的期望值。实际值很少与期望值完全一致,而是落在预测区间所规定的范围内。
- 认为回归分析只涉及预测区间。
- 使用回归模型可以进行两类预测:1)预测未来值;2)预测均值响应。在橙树示例中,您可以预测 1)一棵 900 天大橙树的树围;或 2)所有 900 天大橙树的平均树围。两种情况下的“期望值”相同,但前者用预测区间,后者用置信区间。
- 认为区间越窄越好。
- 您可能会倾向于在使用回归结果时选用更窄的区间。但置信区间并非因“更好”而更窄,而是因为它描述的对象与预测区间不同。请先明确您是在预测因变量的平均值,还是在预测某个个体数据点。
- 将置信区间误认为预测区间。
- 如果您的预测涉及从样本确定总体参数,或基于回归预测均值响应(平均值),应使用置信区间;如果您试图基于回归预测某个个体数据点的属性,应使用预测区间。
结论
本文概述了置信区间与预测区间,解释了这两个名称相近的概念之间的差异,并给出了各自适用的实际示例。同时,本文还展示了如何使用 R 语言计算预测区间与置信区间。
若要学习如何用 Python 应用统计公式,请参阅DataCamp 的 Python 统计课程。最后,若您正在准备涉及统计的求职面试,请查看DataCamp 的 Python 统计面试题课程。
FAQs
我们为什么需要区间?为什么真实值不等于期望值?
之所以需要区间,是因为在统计分析中我们只能研究小样本而非整个总体。样本的性质(我们可以研究与预测)能够反映总体,但并不等同于我们想要了解的总体属性。然而,真实值会落在预测值周围的某个区间内。
置信区间与预测区间可以互换吗?
不,它们截然不同。置信区间用于表示总体参数(如均值)的范围。预测区间用于表示某个个体数据点真实值的范围。
置信区间与预测区间会在同一语境中使用吗?
可以,它们在回归研究中都会用到。您可能需要预测数据点的平均值(如 2 岁犬只的平均体重),也可能需要预测某一只 2 岁犬只的体重。前者使用置信区间,后者使用预测区间。
置信区间和预测区间是否依赖于样本量?
会。样本量越大,对总体参数的估计就越好。因此,基于更大样本的估计会有更窄的区间。
可以只用样本估计而不给区间吗?
原则上可以,但在实践中意义不大。样本估计是“期望”值,真实值很少与期望值完全相等,但很可能位于期望值周围的某个范围内。因此,通常会在给出估计值的同时提供区间。如果区间合适,甚至在没有期望值的情况下也可使用。
在给定 x 预测 y 时,预测区间对所有 x、y 都一样吗?置信区间呢?
这是个好问题。答案是否定的。x 的取值越偏离 x 的平均值,预测区间与置信区间就越宽。当 x 的取值接近其均值时,这些区间最窄。

无论是估计总体参数,还是预测因变量,统计研究总伴随着不确定性。这种不确定性的根源在于抽样过程。进行统计分析时,考察整个总体并不现实。因此,无论是为了估计总体参数(如均值),还是为了构建回归模型,都需要选择具有代表性的样本。
如需学习或温习这些基础知识,请参阅 DataCamp 的统计学入门课程。
总体参数的真实值通常不等于基于样本得到的估计值——两者之差称为标准误。为了考虑这种误差,通常的做法是先给出一个期望值,再给出一个预期包含真实值的区间范围。
同样,回归研究也基于随机样本而非整个总体。样本回归得到的自变量与因变量之间关系,并不完全等于总体中的真实关系。因此,单个数据点的预测值并不恰好等于其真实值;真实值预期落在预测值周围的某个区间内。
本文将解释这两类区间的含义,以及用来计算它们的数学方法;并讨论各自的典型应用场景。最后,我们将通过实际示例演示如何在 R 语言中计算置信区间与预测区间。
什么是置信区间?
置信区间是在给定置信水平下,预期包含某一总体参数(如总体均值)真实值的范围。
推断统计中的置信区间
总体参数是描述整个总体的数值属性。总体均值就是总体参数的一个例子。两个变量之间回归系数的真实值也是总体参数的一个例子。推断统计即通过研究随机样本中的数据点,来估计总体参数。
假设您是一位园艺学家或橙子种植者,想知道橙树在 100 天大时会长多粗。不可能把所有 100 天大的橙树都测一遍,于是您随机选取一些 100 天大的橙树,测量它们的树围(粗细)。这些测量的平均值就是样本均值。您希望用这个样本均值去估计总体均值。
橙树林总体。使用 DALL-E 生成。
样本均值是总体参数的点估计(此处感兴趣的参数是均值)。DataCamp 的推断统计课程对这些概念有更详细的讨论。
样本均值具有代表性,但并不完全等于总体均值。总体均值预期落在样本均值附近的某个区间内,这个区间称为置信区间。
回归中的置信区间
上一节解释了推断统计中的置信区间。回归分析同样会用到置信区间。
以橙树示例的一个变体为例:
您可以通过回归分析来实现。用于回归的数据集基于橙树样本,因此估计得到的样本均值(100 天大橙树的平均树围)不会精确等于总体均值。总体均值的真实值落在该样本均值的置信区间内。
后续章节将给出并解释置信区间的数学表达式。
什么是预测区间?
预测区间是在给定置信水平下,基于回归分析的预测,预期包含某个个体数据点真实值的范围。
再看前述回归示例的另一个变体:
您沿用相同的回归公式。该个体树围的估计值(即期望值)与估计的平均树围相同。但由于此处要预测的是个体值(而不是均值),个体数据点的变异性更大,必须将其纳入考虑。因此,预测区间要比置信区间更宽。
本文后面将给出这些区间的公式,并演示如何用 R 来计算它们。