
Kurs
Einführung in Data Science mit Python
4 Std.
502.2K
"Cosine distance." Bild von Dall-E.
Die Ähnlichkeit oder Unähnlichkeit zwischen Datenpunkten zu messen, ist in vielen Anwendungen hilfreich – von Textanalyse bis Empfehlungssystemen. Cosine Distance ist eine Distanzmetrik, die sich besonders für hochdimensionale oder spärliche Datensätze eignet, da sie die Orientierung von Vektoren statt deren Betrag in den Fokus stellt.
Wenn du die gängigen und wichtigen Konzepte des Machine Learnings auffrischen möchtest, starte mit unserem umfassenden Tutorial Demystifying Mathematical Concepts for Deep Learning. Lies außerdem den Artikel zur distanzbasierten Lernmethode What is Manhattan Distance?, um dein Verständnis für Distanzmetriken zu erweitern und die Unterschiede zwischen Cosine Distance und Manhattan Distance zu sehen.
Lass uns Cosine Distance anhand der Cosine-Distance-Formel definieren und dabei auch ihre Beziehung zur Cosine Similarity betrachten.
Cosine Distance misst die Unähnlichkeit zweier Vektoren, indem sie den Kosinus des Winkels zwischen ihnen berücksichtigt. Sie lässt sich als Eins minus Cosine Similarity definieren, wie in der folgenden Formel:

Ausführlicher und mit einer formalen mathematischen Darstellung wird Cosine Distance über die folgende Formel berechnet.
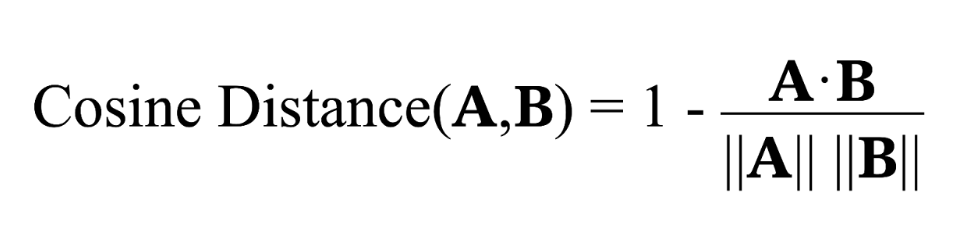
Hierbei steht A⋅B für das Skalarprodukt der Vektoren A und B, und ||A|| ||B|| für die Beträge bzw. euklidischen Normen der Vektoren.
Mit dieser Formel erhältst du Werte im Bereich von 0 bis 2. Eine Cosine Distance von 0 bedeutet, die Vektoren sind perfekt ausgerichtet (kein Winkel dazwischen) und damit maximal ähnlich, während ein Wert nahe 2 darauf hindeutet, dass sie entgegengesetzt sind und maximale Unähnlichkeit zeigen.
Wie gesehen misst Cosine Distance die Unähnlichkeit zwischen Vektoren über den Kosinus des Winkels zwischen ihnen, während Cosine Similarity über denselben Winkel deren Ähnlichkeit quantifiziert.
Cosine Similarity liegt zwischen -1 und 1. Ein Wert von 1 bedeutet perfekte Ausrichtung (kein Winkel) und maximale Ähnlichkeit, ein Wert von -1 steht für entgegengesetzte Richtung und maximale Unähnlichkeit. Werte nahe 0 deuten auf Orthogonalität hin.
Betrachten wir ein Beispiel mit zwei Vektoren: Vektor A (2,4) und Vektor B (4,2), und berechnen ihre Cosine Distance in diesen Schritten:
Mit einer Cosine Distance von 0,2 liegt das Ergebnis im unteren Bereich der Skala von 0 bis 2. Das deutet darauf hin, dass die Vektoren A und B hinsichtlich ihrer Richtung recht ähnlich sind.
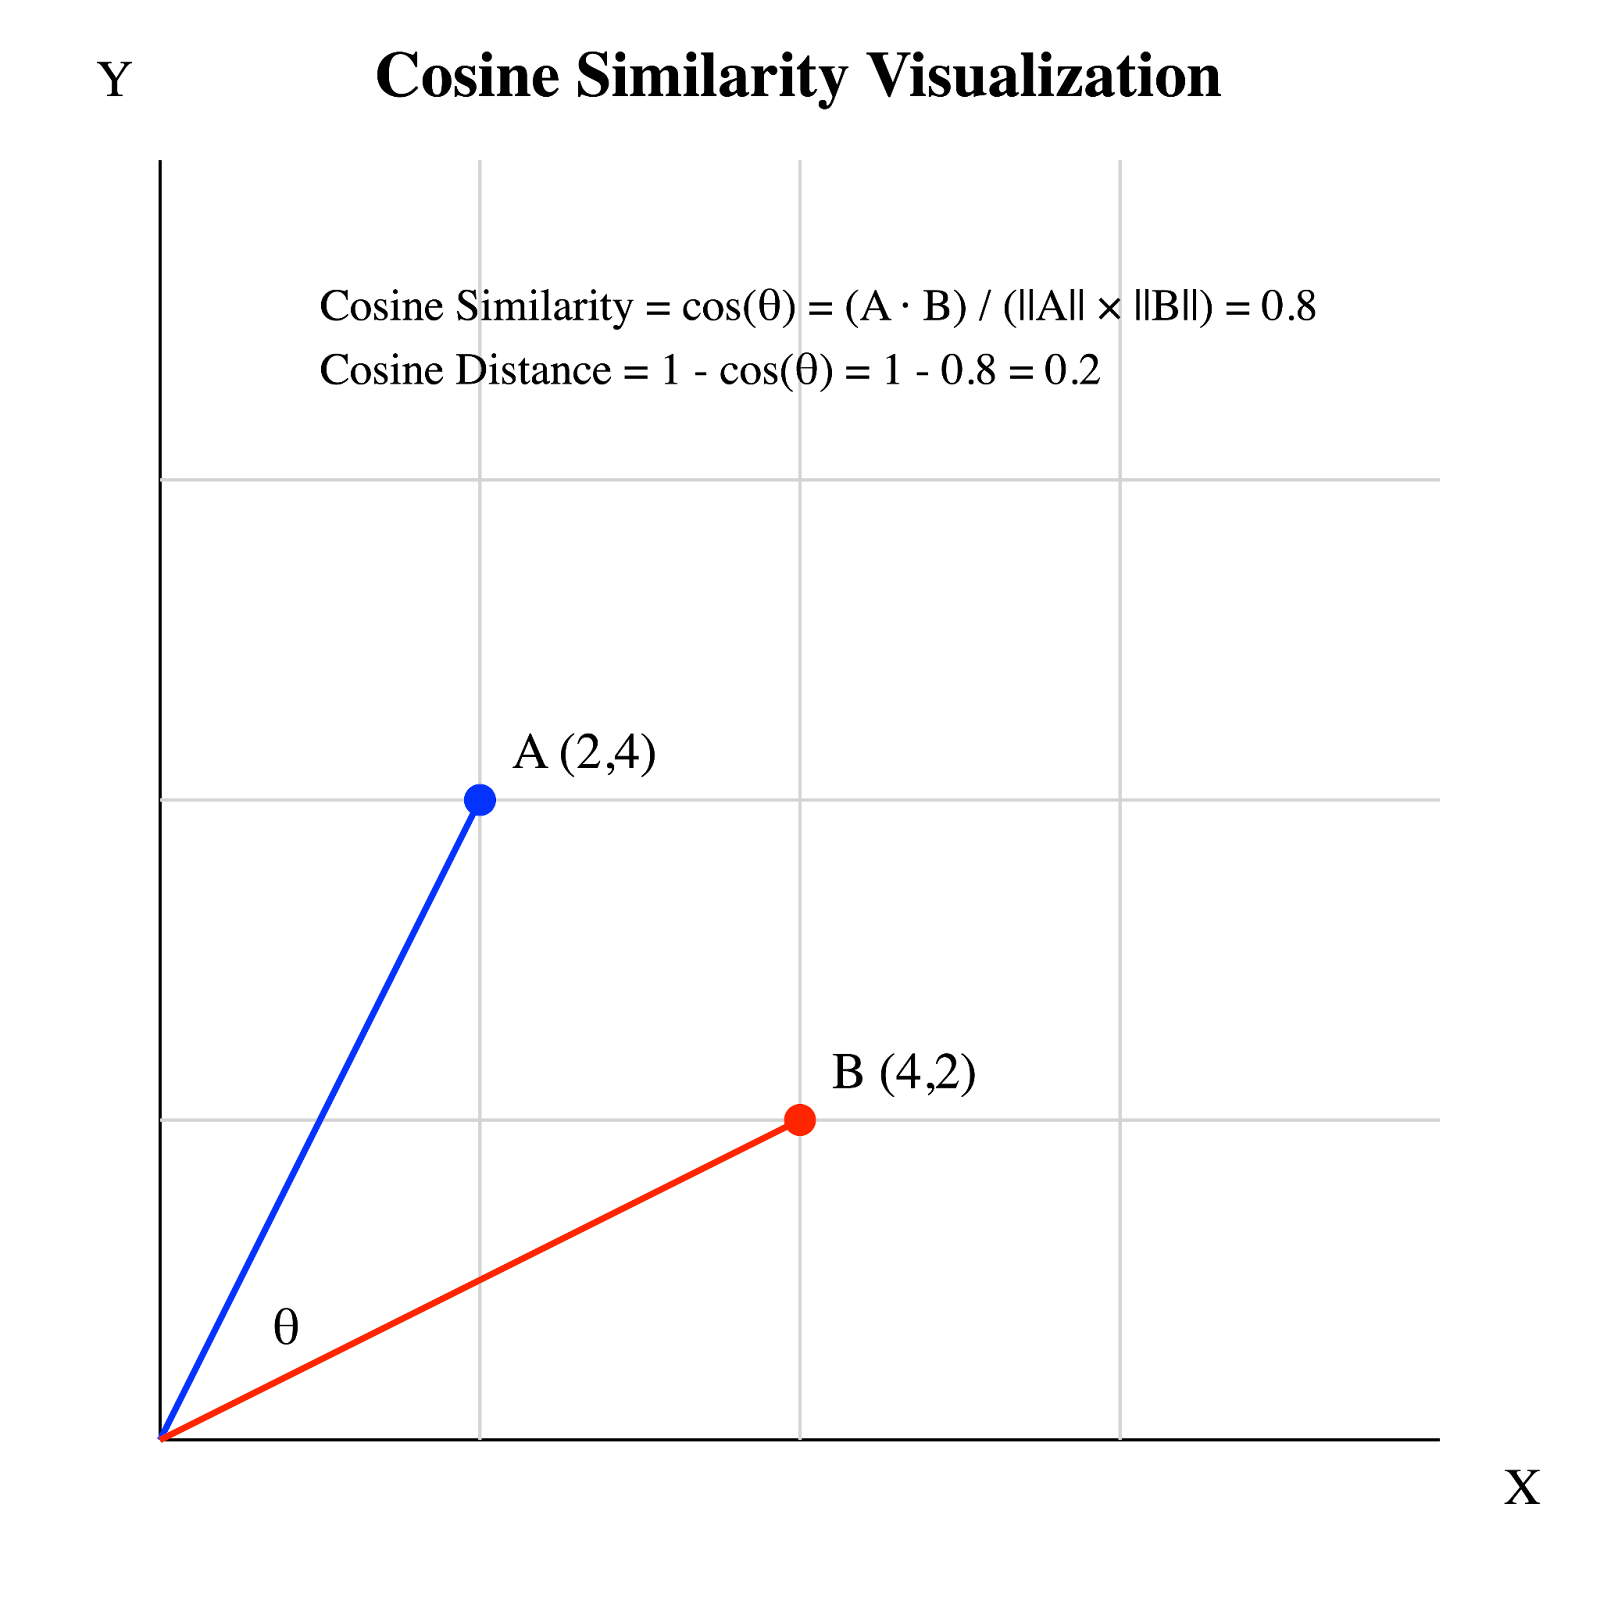 Cosine Distance und Cosine Similarity. Bild von der Autorin/dem Autor.
In dieser Darstellung:
Die Cosine Similarity (0,8) entspricht dem Kosinus des Winkels θ. Da die Vektoren ähnliche Richtungen haben, ist der Winkel klein, was zu einer hohen Cosine Similarity und einer geringen Cosine Distance (0,2) führt.
Da sich Cosine Distance auch als 1 - cos(θ) definieren lässt, wobei cos(θ) die Cosine Similarity ist, gilt:
Schauen wir uns einige wichtige Anwendungen an.
Cosine Distance spielt in verschiedenen Aufgaben des Natural Language Processing eine zentrale Rolle, da sie semantische Beziehungen zwischen Textrepräsentationen wie word2vec effektiv misst. Für einen kurzen Überblick findest du unser Tutorial Understanding Text Classification in Python hilfreich.
In der Dokumentenklassifikation misst Cosine Distance die Inhaltsähnlichkeit, indem die Winkel zwischen Dokumentenvektoren verglichen werden. Jedes Dokument wird in einen Vektor überführt, dessen Dimensionen die TF-IDF-Werte der Wörter widerspiegeln. Ähnliche Dokumente zeigen in ähnliche Richtungen, was zu kleineren Cosine-Distance-Werten führt.
Cosine Distance glänzt bei Clustering-Aufgaben wie dem K-Means-Clustering und gruppiert semantisch verwandte Dokumente, selbst wenn sie nicht dieselben Wörter verwenden. Sie ist ideal für hochdimensionale, spärliche Daten, wie sie in der Textverarbeitung üblich sind. Durch das Erfassen der Vektorausrichtung ermöglicht sie präzisere thematische Cluster. Diese Technik wird häufig im Unsupervised Learning genutzt, um natürliche Gruppierungen in Dokumentmengen zu entdecken, etwa um Nachrichtenartikel nach Themen zu ordnen.
Im Information Retrieval vergleicht Cosine Distance Suchanfragen mit Dokumenten über ihre Vektoren. Suchmaschinen finden dann die Dokumente, die dem Query-Vektor hinsichtlich Cosine Distance am nächsten sind, und ranken die mit der kleinsten Distanz als relevanteste.
Über die Dokumentebene hinaus ist Cosine Distance in Word Embeddings wie Word2Vec oder GloVe wichtig, in denen Wörter als hochdimensionale Vektoren dargestellt werden. Diese Einbettungen erfassen semantische Bedeutungen, sodass ähnliche Wörter im Vektorraum nahe beieinanderliegen. Cosine Distance hilft, die ähnlichsten Wörter zu einem gegebenen Wort zu finden, Synonyme zu erkennen oder Features in komplexeren Modellen zu unterstützen, etwa für Sentimentanalyse oder maschinelle Übersetzung.
In der Bilderkennung vergleicht Cosine Distance die aus Bildern extrahierten Feature-Vektoren. Ob Gesichter in einer Menge erkannt oder Naturfotos klassifiziert werden: Entscheidend ist die Ähnlichkeit in der Ausrichtung der Vektoren, nicht deren Größe. Dieser Fokus hilft, Bilder treffsicher zu kategorisieren und steigert Genauigkeit und Effizienz bildbasierter Systeme.
Stell dir Cosine Distance als digitalen Matchmaker vor, der Nutzerinnen und Nutzer mit Filmen oder Produkten zusammenbringt, die zu ihren bisherigen Vorlieben passen. Indem Profile von Nutzenden und Items im Vektorraum verglichen werden, sagen Empfehlungssysteme mit erstaunlicher Genauigkeit voraus, was dir als Nächstes gefallen könnte.
Cosine Distance besitzt besondere mathematische Eigenschaften, die sie von anderen Distanzmaßen unterscheiden. Diese Eigenschaften zu verstehen, ist wichtig, um Cosine Distance korrekt zu interpretieren und in verschiedenen Kontexten anzuwenden.
In der Mathematik ist eine Metrik oder Distanzfunktion eine Funktion, die die Entfernung zwischen je zwei Elementen einer Menge definiert. Damit eine Funktion eine echte Metrik ist, muss sie vier Bedingungen erfüllen:
Nichtnegativität: d(x, y) ≥ 0
Identität der Ununterscheidbaren: d(x, y) = 0 genau dann, wenn x = y
Symmetrie: d(x, y) = d(y, x)
Dreiecksungleichung: d(x, z) ≤ d(x, y) + d(y, z)
Cosine Distance erfüllt die ersten drei Bedingungen, verletzt aber nicht immer die Dreiecksungleichung. Das bedeutet, dass in manchen Fällen die Summe der Cosine-Distanzen zwischen A und B und zwischen B und C kleiner sein kann als die Cosine-Distanz zwischen A und C.
Eine wichtige Eigenschaft der Cosine Distance ist ihre Skaleninvarianz. Das heißt, die Cosine Distance zwischen zwei Vektoren bleibt gleich, selbst wenn du einen oder beide Vektoren mit einem Skalar (ungleich Null) multiplizierst. Mathematisch gilt für beliebige von Null verschiedene Skalare a und b sowie Vektoren x und y:
Cosine Distance(ax, by) = Cosine Distance(x, y)
Diese Skaleninvarianz unterscheidet Cosine Distance von vielen anderen Distanzmaßen.
Hier zeigen wir, wie du Cosine Distance in Python und R berechnest.
In Python können wir NumPy verwenden, um Cosine Distance und Cosine Similarity zu berechnen. Dazu bestimmen wir das Skalarprodukt und die Normen unserer Vektoren.
import numpy as np

# Define the vectors
A = np.array([2, 4])
B = np.array([4, 2])

# Calculate cosine similarity
cos_similarity = np.dot(A, B) / (np.linalg.norm(A) * np.linalg.norm(B))

# Calculate cosine distance
cos_distance = 1 - cos_similarity

print("Cosine Similarity: {:.2f}".format(cos_similarity))
print("Cosine Distance: {:.2f}".format(cos_distance))
Ausgabe:
Cosine Similarity: 0.80
Cosine Distance: 0.20
Alternativ lässt sich Cosine Distance auch mit SciPy und der Funktion cosine() bestimmen.
import numpy as np
from scipy.spatial.distance import cosine

# Define the vectors
A = np.array([2, 4])
B = np.array([4, 2])

# Calculate cosine distance
cos_distance = cosine(A, B)  # Uses scipy's cosine for cosine distance

print("Cosine Distance: {:.2f}".format(cos_distance))
Ausgabe:
Cosine Distance: 0.20In R kannst du Cosine Similarity und Cosine Distance mit einfachen Vektoroperationen berechnen. So geht's:
# Define the vectors
A <- c(2, 4)
B <- c(4, 2)

# Calculate cosine similarity
cos_similarity <- sum(A * B) / (sqrt(sum(A^2)) * sqrt(sum(B^2)))
# Note: We can also use %*% operator for matrix multiplication.
# %*%, when applied to two vectors, calculates the dot product.
# For example: cos_similarity <- A %*% B / (sqrt(sum(A^2)) * sqrt(sum(B^2)))

# Calculate cosine distance
cos_distance <- 1 - cos_similarity

# Print the result
print(paste("Cosine Similarity:", cos_similarity))
print(paste("Cosine Distance:", cos_distance))
Ausgabe:
“Cosine Similarity: 0.80”
“Cosine Distance: 0.20”
Im R-Beispiel wird die Cosine Similarity analog zum Python-Beispiel mit manuellen Operationen für Skalarprodukt und Normen berechnet – vollständig mit Bordmitteln von R. Beachte, dass sich die Cosine Distance ergibt, indem du die Cosine Similarity von 1 abziehst.
Die folgende Visualisierung erweitert unser Ausgangsbeispiel und zeigt mithilfe unterschiedlicher Farben drei Distanztypen für dieselben Vektoren:
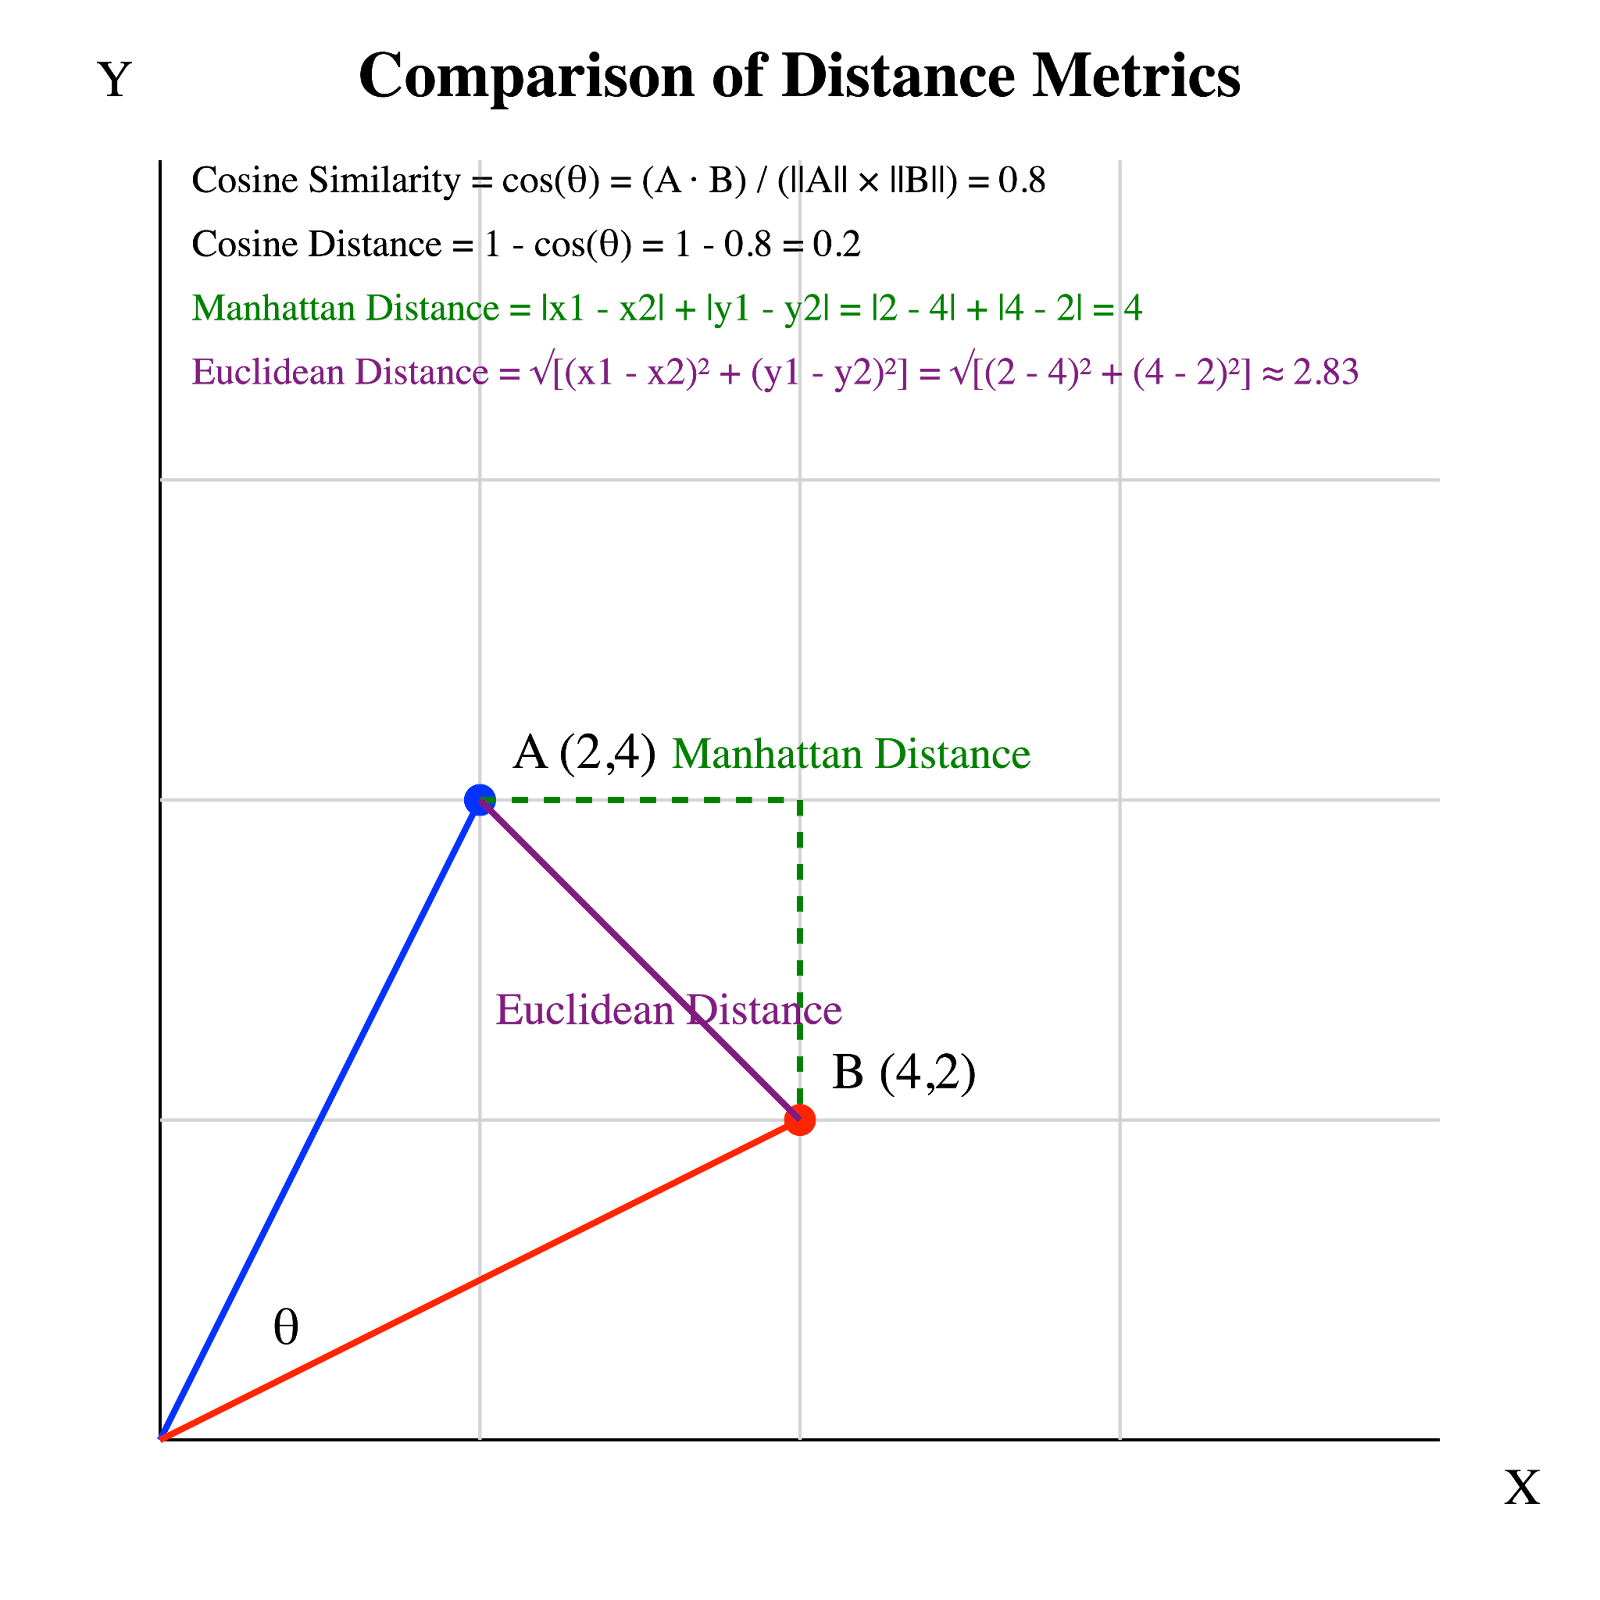
Cosine Distance vs. euklidische Distanz vs. Manhattan Distance. Bild von der Autorin/dem Autor.
Jede dieser Distanzen liefert eigene Einblicke in Daten. Euklidische und Manhattan-Distanzen sind geometrische Distanzen, die die Beträge der Vektorkomponenten berücksichtigen und sich daher für physische Messungen im Raum eignen. Cosine Distance hingegen fokussiert den Winkel zwischen Vektoren und ist ideal, um Orientierung und Richtung zu verstehen – besonders in hochdimensionalen Räumen wie in der Textanalyse und anderen Bereichen der Data Science.
Cosine Distance und ihr Gegenstück, die Cosine Similarity, sind starke Werkzeuge in Data Science und Machine Learning. Diese Metriken liefern einzigartige Einblicke in Beziehungen zwischen Vektoren, insbesondere in hochdimensionalen Räumen, in denen klassische Distanzmaße an Grenzen stoßen.
Da Daten weiter an Komplexität und Dimensionalität zulegen, werden Metriken wie Cosine Distance voraussichtlich noch wichtiger, um verborgene Muster und Zusammenhänge aufzudecken. Ob du an Natural Language Processing, Empfehlungssystemen oder generell mit hochdimensionalen Vektorräumen arbeitest: Das Verständnis und die Anwendung von Cosine Distance liefern wertvolle Erkenntnisse und verbessern die Performance deiner Modelle. Als nächsten Schritt empfehlen wir unseren interaktiven Kurs Designing Machine Learning Workflows in Python, der ein ganzes Kapitel zu distanzbasiertem Lernen und unsupervisierten Workflows enthält.
Lerne mit DataCamp
Kurs
Kurs
Kurs