Kurs
Einführung in R
4 Std.
3.1M
Eines der wichtigsten Ziele in der Netzwerkanalyse ist es, die Zentralität eines Knotens innerhalb eines sozialen Netzwerks zu bestimmen. Anders gesagt: Hast du ein Netzwerk zur Analyse, willst du herausfinden, welcher Knoten die größte Wirkung auf die anderen hat. Genau darum geht es in diesem Tutorial. Du lernst unter anderem:
Heute ist es für alle Forschenden in der Netzwerkforschung entscheidend, die zentralen Knoten eines Netzwerks identifizieren zu können. Je weiter du gehst, desto größer und komplexer werden Netzwerke in unterschiedlichen Disziplinen. Eine akribische Analyse jedes einzelnen Knotens ist daher kostspielig, zeitaufwendig und teils schlicht unmöglich. Die Beschreibung der Zentralität beantwortet die Frage: „Welcher Knoten ist der wichtigste im Netzwerk?“.
Formal ist es eine Funktion, die jedem Knoten eines Netzwerks abhängig von seinem Einfluss auf andere einen Zahlenwert zuweist. Die Bedeutung eines Knotens ergibt sich aus seiner Position im Netzwerk. Je nach Netzwerktype kannst du definieren, was „wichtig“ heißt: etwa eine besonders einflussreiche Person in einem sozialen Netzwerk oder kritische Infrastrukturknoten in städtischen Netzen.
Zentralitätsindizes lassen sich in lokale und globale Kategorien einteilen.
Ein Beispiel für ein lokales Maß ist die Degree-Zentralität. Sie zählt die Anzahl der Verbindungen eines Knotens und zeigt auf, welche Personen schnell Anschluss an das gesamte Netzwerk finden. Sie ist lokal, weil sie den Rest des Netzwerks nicht berücksichtigt; die Bedeutung ihres Werts hängt stark von der Netzwerkgröße ab.
Beliebte Zentralitätsmaße wie Degree kannst du mit dem Paket igraph berechnen. Du lädst es mit der Funktion library():
library(igraph)Bevor du Zentralität berechnest, brauchst du ein Netzwerk. Dafür kannst du eine der Zufallsalgorithmen nutzen, etwa das Erdős–Rényi-Modell, um einen Beispielgraphen zu erzeugen.
Das Erdős–Rényi-Modell wurde 1959 von Paul Erdős und Alfréd Rényi, zwei herausragenden Mathematikern, eingeführt. Es dient zur Erzeugung zufälliger Graphen, in denen jedes Knotenpaar mit gleicher Wahrscheinlichkeit durch eine Kante verbunden wird. In diesem Modell haben die meisten Knoten annähernd gleich viele Verbindungen, und die Gradverteilung ist in der Regel binomial oder Poisson-verteilt. Das ist nützlich, um mit probabilistischen Methoden die Existenz von Graphen mit bestimmten Eigenschaften zu zeigen oder reale Netzwerke strukturell zu vergleichen.
Ein Beispiel für das Erdős–Rényi-Modell erhältst du mit der Funktion sample_gnm() aus dem Paket igraph.
# n = Anzahl der Knoten, m = Anzahl der Kanten
erdos.gr <- sample_gnm(n=10, m=25)

plot(erdos.gr)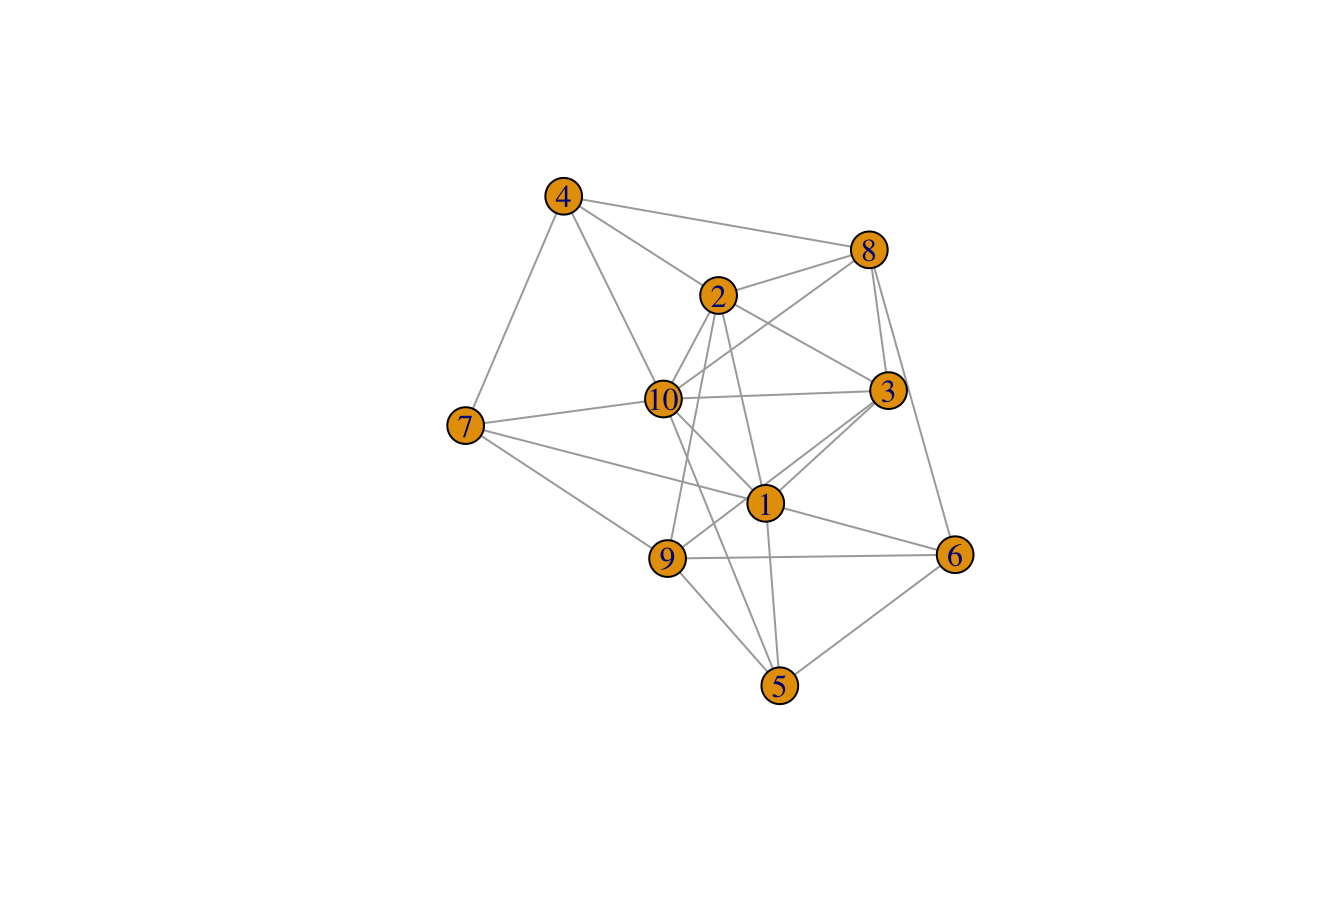
Dies ist ein ungerichtetes Netzwerk, also ein Graph mit bidirektionalen Kanten – im Gegensatz zu einem gerichteten Graphen, bei dem die Richtung von Kanten berücksichtigt wird – mit 10 Knoten und 25 Kanten.
Die Degree-Zentralität dieses Graphen berechnest du mit der Funktion centr_degree():
degree.cent <- centr_degree(erdos.gr, mode = "all")
degree.cent$res

##  [1] 2 3 5 6 7 7 6 3 6 5
Wie zu sehen ist, hat Knoten 1 im Beispielnetzwerk den höchsten Degree-Zentralitätswert.
Globale Zentralitätsmaße berücksichtigen hingegen das gesamte Netzwerk. Eines der am häufigsten verwendeten globalen Maße ist die Closeness-Zentralität. Sie bewertet jeden Knoten danach, wie nah er im Mittel zu allen anderen Knoten im Netzwerk liegt.
Dazu werden die kürzesten Pfade zwischen allen Knoten berechnet und jedem Knoten ein Score auf Basis der Summe seiner kürzesten Pfade zugewiesen. Das ist hilfreich, um die Akteure zu finden, die das gesamte Netzwerk am schnellsten beeinflussen können.
Es empfiehlt sich, Closeness zu verwenden, um zentrale Knoten innerhalb eines einzelnen Clusters zu finden. Du berechnest sie mit der Funktion closeness() im Paket igraph.
closeness.cent <- closeness(erdos.gr, mode="all")
closeness.cent

##  [1] 0.05882353 0.06250000 0.07142857 0.08333333 0.09090909 0.09090909
##  [7] 0.08333333 0.06250000 0.08333333 0.07692308
Den Ergebnissen der Closeness-Zentralität zufolge haben – anders als bei Degree – die Knoten 1 und 9 die höchsten Zentralitätswerte im gesamten Netzwerk. Das heißt, beide spielen eine gleich wichtige Rolle im Fluss des Netzwerks.
Obwohl es viele Arten von Zentralitätsmaßen gibt, um die einflussreichsten Knoten eines Netzwerks zu bestimmen, existiert in der Netzwerkforschung noch keine einheitliche Vorgehensweise, um für ein gegebenes Netzwerk das optimal passende Maß auszuwählen und anzuwenden.
Zur Veranschaulichung zeigt die folgende Grafik ein Streudiagramm zwischen zwei Zentralitätsmaßen, „Subgraph Centrality“ und „Topological Coefficient“. Die rote Linie weist auf einen starken negativen Zusammenhang zwischen beiden hin.
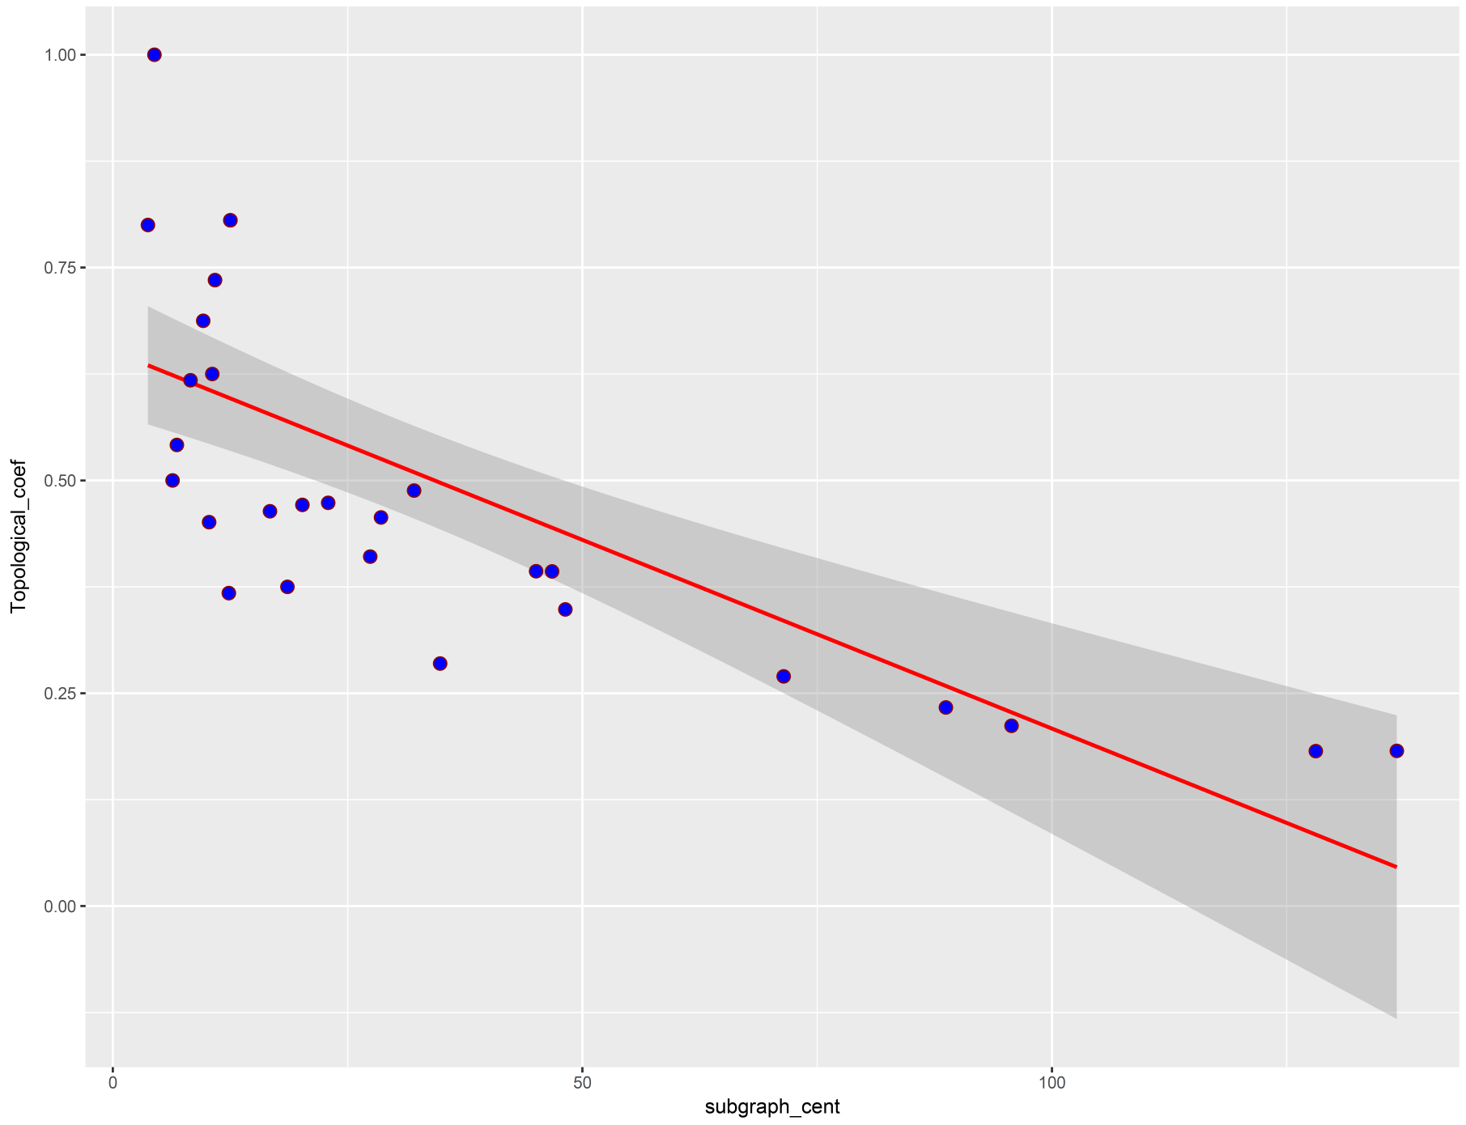
Daraus lässt sich schließen: Da diese beiden Zentralitäten invers zusammenhängen, identifizieren sie zentrale Knoten anhand unterschiedlicher Muster. Entsprechend variiert das Ergebnis der Zentralitätsberechnung je nach gewähltem Maß.
Es gibt derzeit mehr als 140 gebräuchliche Kennzahlen, um zentrale Knoten zu bestimmen – doch welches davon solltest du nutzen, um die einflussreichen Knoten zu berechnen?
Außerdem beeinflussen die topologischen Eigenschaften eines Netzwerks das Ergebnis der Zentralitätsberechnungen. Du solltest daher ein Kriterium wählen, das bezogen auf die Netzwerktopologie die meiste Information über die einflussreichen Knoten liefert.
CINNA (Central Informative Nodes in Network Analysis) ist ein R-Paket zur Berechnung, Analyse und zum Vergleich von Zentralitätsmaßen und ist auf CRAN verfügbar.
Um zu sehen, wie du das Paket nutzt, startest du mit einem enthaltenen Datensatz namens Zachary. Er zeigt Freundschaften unter Mitgliedern eines Universitäts-Karateclubs:
library(CINNA)

data("zachary")

plot(zachary)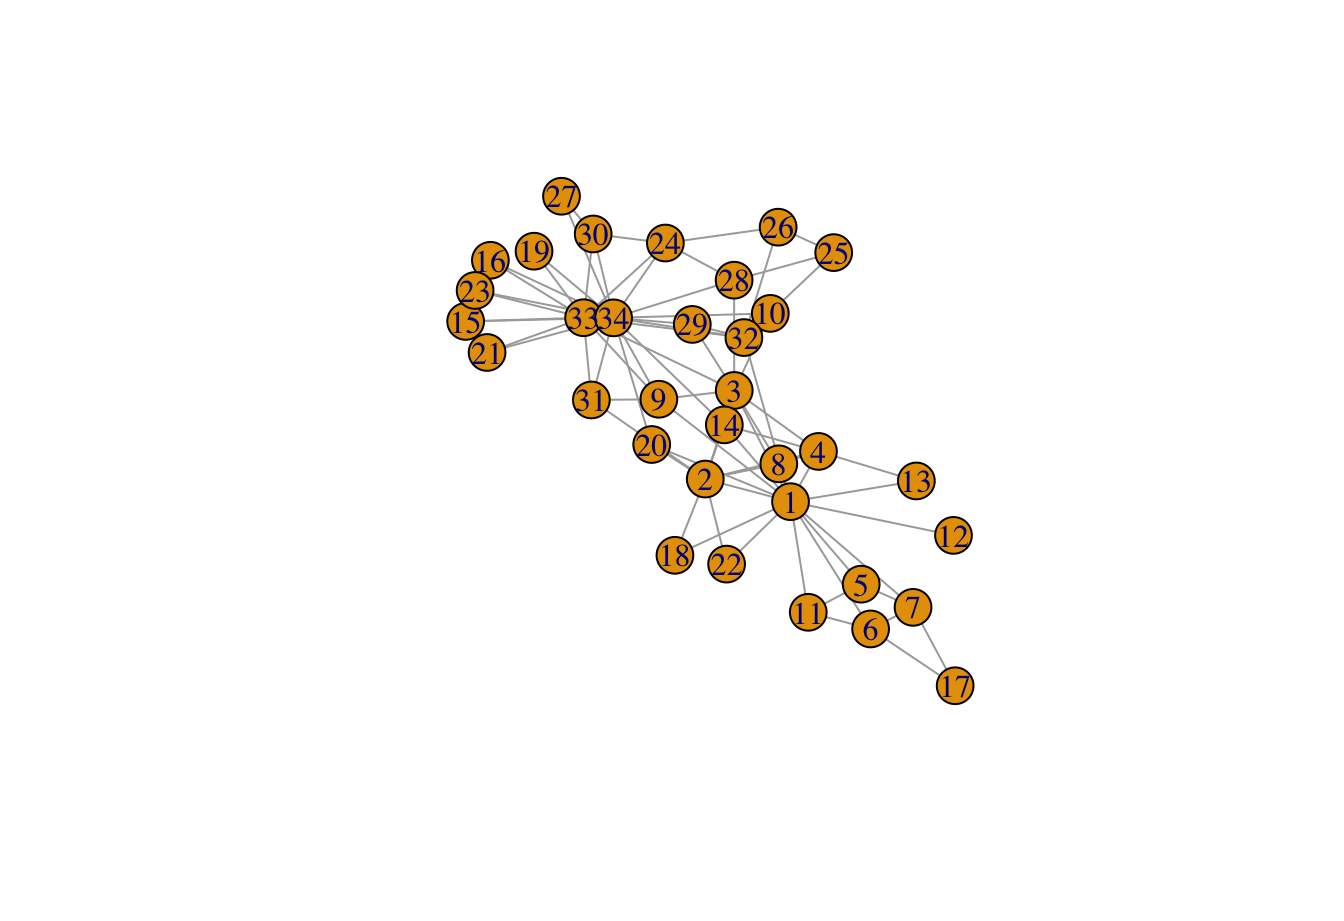
Dies ist ein ungerichteter Graph mit 34 Knoten und 78 Kanten. Merke: In einem ungerichteten Graphen haben Kanten keine Orientierung, sie sind bidirektional. Zum Beispiel: A<--->B == B<--->A.
Um die für die Graphstruktur berechenbaren Zentralitätstypen zu ermitteln, hilft die Funktion proper_centralities().
pr_cent<-proper_centralities(zachary)

##  [1] "subgraph centrality scores"
##  [2] "Topological Coefficient"
##  [3] "Average Distance"
##  [4] "Barycenter Centrality"
##  [5] "BottleNeck Centrality"
##  [6] "Centroid value"
##  [7] "Closeness Centrality (Freeman)"
##  [8] "ClusterRank"
##  [9] "Decay Centrality"
## [10] "Degree Centrality"
## [11] "Diffusion Degree"
## [12] "DMNC - Density of Maximum Neighborhood Component"
## [13] "Eccentricity Centrality"
## [14] "eigenvector centralities"
## [15] "K-core Decomposition"
## [16] "Geodesic K-Path Centrality"
## [17] "Katz Centrality (Katz Status Index)"
## [18] "Kleinberg's authority centrality scores"
## [19] "Kleinberg's hub centrality scores"
## [20] "clustering coefficient"
## [21] "Lin Centrality"
## [22] "Lobby Index (Centrality)"
## [23] "Markov Centrality"
## [24] "Radiality Centrality"
## [25] "Shortest-Paths Betweenness Centrality"
## [26] "Current-Flow Closeness Centrality"
## [27] "Closeness centrality (Latora)"
## [28] "Communicability Betweenness Centrality"
## [29] "Community Centrality"
## [30] "Cross-Clique Connectivity"
## [31] "Entropy Centrality"
## [32] "EPC - Edge Percolated Component"
## [33] "Laplacian Centrality"
## [34] "Leverage Centrality"
## [35] "MNC - Maximum Neighborhood Component"
## [36] "Hubbell Index"
## [37] "Semi Local Centrality"
## [38] "Closeness Vitality"
## [39] "Residual Closeness Centrality"
## [40] "Stress Centrality"
## [41] "Load Centrality"
## [42] "Flow Betweenness Centrality"
## [43] "Information Centrality"
Das Ergebnis listet 43 gängige Zentralitätsmaße, die für eine ungerichtete, ungewichtete Struktur relevant sind.
Wähle nun die ersten fünf Maße aus der Liste und übergib sie an die Funktion calculate_centralities(), da die Berechnung aller möglichen Zentralitäten sehr zeitintensiv wäre.
Im nächsten Schritt nutzt du die Hauptkomponentenanalyse (PCA), um das informativste Zentralitätsmaß zu bestimmen.
Merke: PCA ist ein dimensionsreduzierendes Verfahren für lineare Analysen.
In diesem Analyseschritt entspricht jedes Zentralitätsmaß einer Variable. Zentralitäten, die stark mit den Hauptkomponenten korrelieren, sind am wichtigsten, um zentrale Knoten zu identifizieren. Das Beitragskriterium der PCA zeigt, wie stark Variablen zu den Hauptkomponenten beitragen.
Anders gesagt: Die Beiträge der Variablen messen die erklärten Varianzen relativ zu den Hauptkomponenten (in Prozent). Dank dieses Kriteriums in der PCA erkennst du, welche Zentralitäten besonders viele Informationen über zentrale Knoten enthalten und damit ein Netzwerk am besten beschreiben. Sortierte Beitragswerte der Zentralitäten können dann wie unten visualisiert werden.
Anschließend führst du diese beiden Schritte nacheinander mit dem Pipe-Operator %>% aus:
calculate_centralities(zachary, include = pr_cent[1:5])%>%
  pca_centralities(scale.unit = TRUE)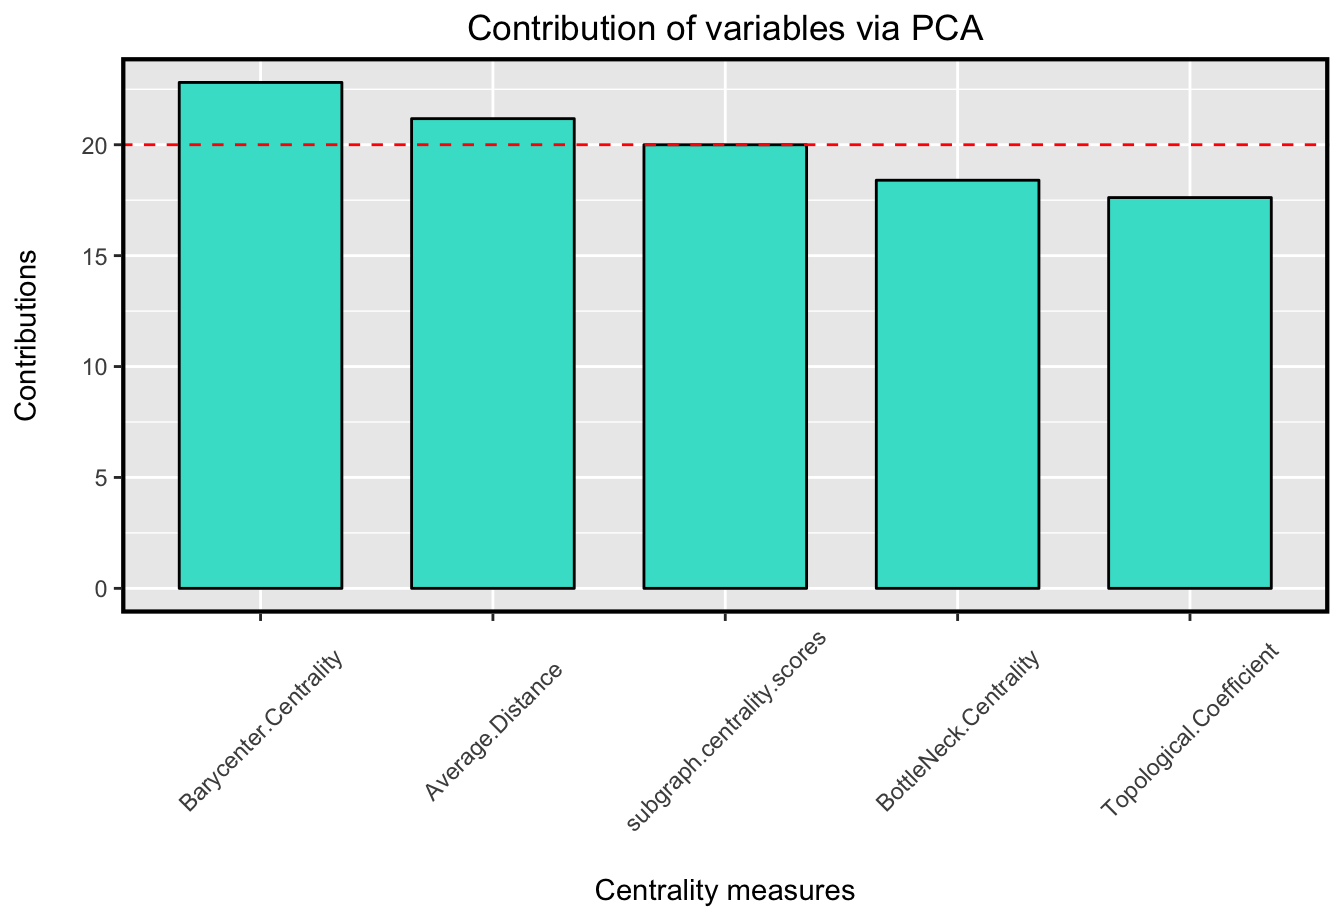
Wie der Plot zeigt, hat die Barycenter Centrality unter den fünf Indizes den höchsten Beitragswert.
Mit anderen Worten: Sie enthält von den berechneten Zentralitätsmaßen die meisten Informationen über die einflussreichen Knoten. Damit identifiziert sie zentrale Knoten genauer als die übrigen gewählten Maße.
Eine Darstellung des Graphen, in der die Knotengröße den jeweiligen Zentralitätswert abbildet, sieht so aus:
visualize_graph( zachary , centrality.type="Barycenter Centrality")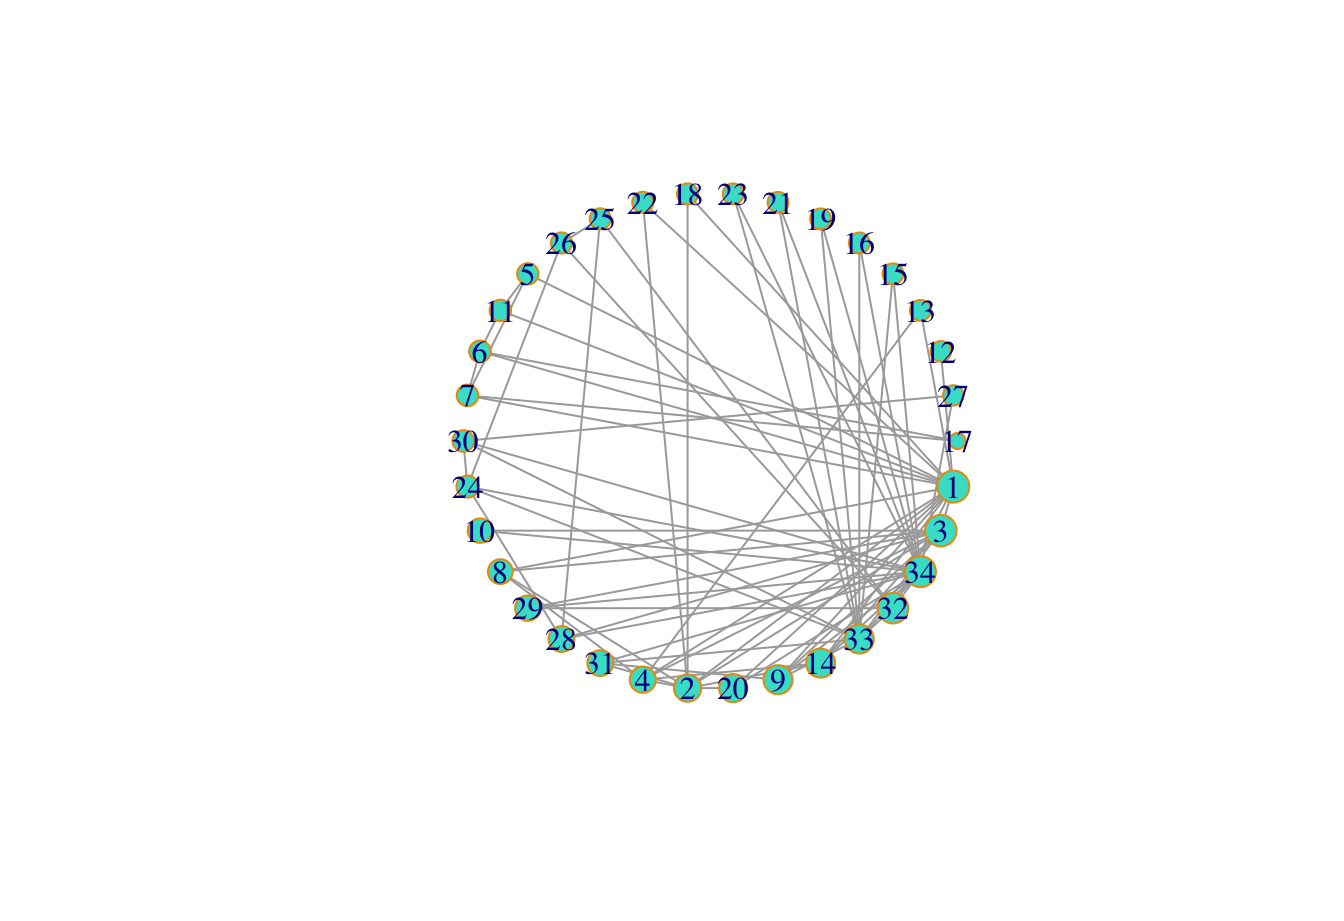
Dementsprechend ist Knoten 1 der zentralste Knoten insgesamt.
Um die Konnektivität eines Netzwerks zu quantifizieren, empfiehlt es sich, auf Basis der Netzstruktur mehrere Zentralitätsmaße zu berechnen, anschließend eine PCA anzuwenden und das informativste Maß auszuwählen – gemessen an seinem maximalen Beitrag zu den entsprechenden Hauptkomponenten.
In diesem Tutorial hast du zunächst die Definition von Zentralität hergeleitet und einige populäre Maße vorgestellt. Dann wurde betont, dass die globalen Eigenschaften eines Netzwerks die Erkennung zentraler Komponenten beeinflussen – und die einflussreichen Knoten je nach Topologie variieren.
Im nächsten Schritt kam das Paket CINNA zum Einsatz, das alle nötigen Funktionen für Zentralitätsanalysen in Netzwerken bereitstellt. Damit konntest du die Analyse direkt auf deinem Netzwerk durchführen – mit spürbar höherer Genauigkeit bei der Bestimmung zentraler Knoten.
Wenn du tiefer einsteigen und sehen willst, wie das in der Praxis aussieht, lies dieses Paper und auch dieses hier.
Bei Fragen oder Anmerkungen erreichst du mich auf Minoo_Ashtiani.
Wenn du mehr über R lernen willst, schau dir unser Tutorial Basic Programming Skills in R und die folgenden Kurse an:
R-Kurse
Kurs
Kurs
Kurs