Curso
Introdução à Ciência de Dados em Python
4 h
502.5K
"Cosine distance." Imagem por Dall-E.
Medir a similaridade ou a dissimilaridade entre pontos de dados é útil em várias aplicações, de análise de texto a sistemas de recomendação. Cosine distance é uma métrica de distância especialmente eficaz para dados de alta dimensionalidade ou conjuntos esparsos, pois foca na orientação dos vetores, não na magnitude.
Se quiser relembrar conceitos comuns e importantes de machine learning, comece pelo nosso tutorial completo, Demystifying Mathematical Concepts for Deep Learning. Vale também ler outro artigo sobre aprendizagem baseada em distância, What is Manhattan Distance? para ampliar seu entendimento sobre métricas de distância e ver as diferenças entre cosine distance e Manhattan distance.
Agora vamos definir cosine distance de acordo com a fórmula de cosine distance. Para isso, também consideramos sua relação com cosine similarity.
Cosine distance mede a dissimilaridade entre dois vetores calculando o cosseno do ângulo entre eles. Ela pode ser definida como um menos a cosine similarity, como vemos na fórmula abaixo:

De forma mais detalhada, com uma expressão matemática mais formal, a cosine distance é calculada usando a fórmula abaixo.
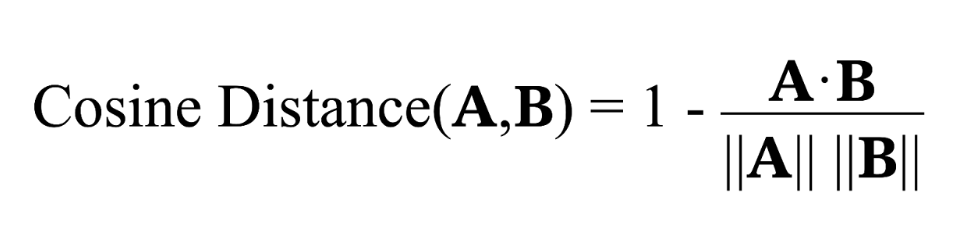
Aqui, A⋅B representa o produto escalar dos vetores A e B, e ||A|| ||B|| são as magnitudes, ou normas euclidianas, dos vetores.
Com essa fórmula, quantificamos a cosine distance em um intervalo de 0 a 2. Uma distância de 0 significa que os vetores estão perfeitamente alinhados (sem ângulo entre eles), indicando máxima similaridade, enquanto um valor próximo de 2 sugere que são diametralmente opostos, indicando máxima dissimilaridade.
Como vimos, enquanto a cosine distance mede a dissimilaridade entre vetores calculando o cosseno do ângulo entre eles, a cosine similarity quantifica o quão similares dois vetores são com base no cosseno do mesmo ângulo.
A cosine similarity varia de -1 a 1. Um valor de 1 significa que os vetores estão perfeitamente alinhados (sem ângulo entre eles), indicando máxima similaridade, enquanto um valor de -1 implica que são diametralmente opostos, refletindo máxima dissimilaridade. Valores próximos de zero indicam ortogonalidade.
Vamos a um exemplo com dois vetores: vetor A (2,4) e vetor B (4,2), e calcular sua cosine distance seguindo estes passos:
Com uma cosine distance de 0,2, o resultado fica bem baixo na escala de 0 a 2. Isso sugere que os vetores A e B são bastante similares em termos da direção para a qual apontam.
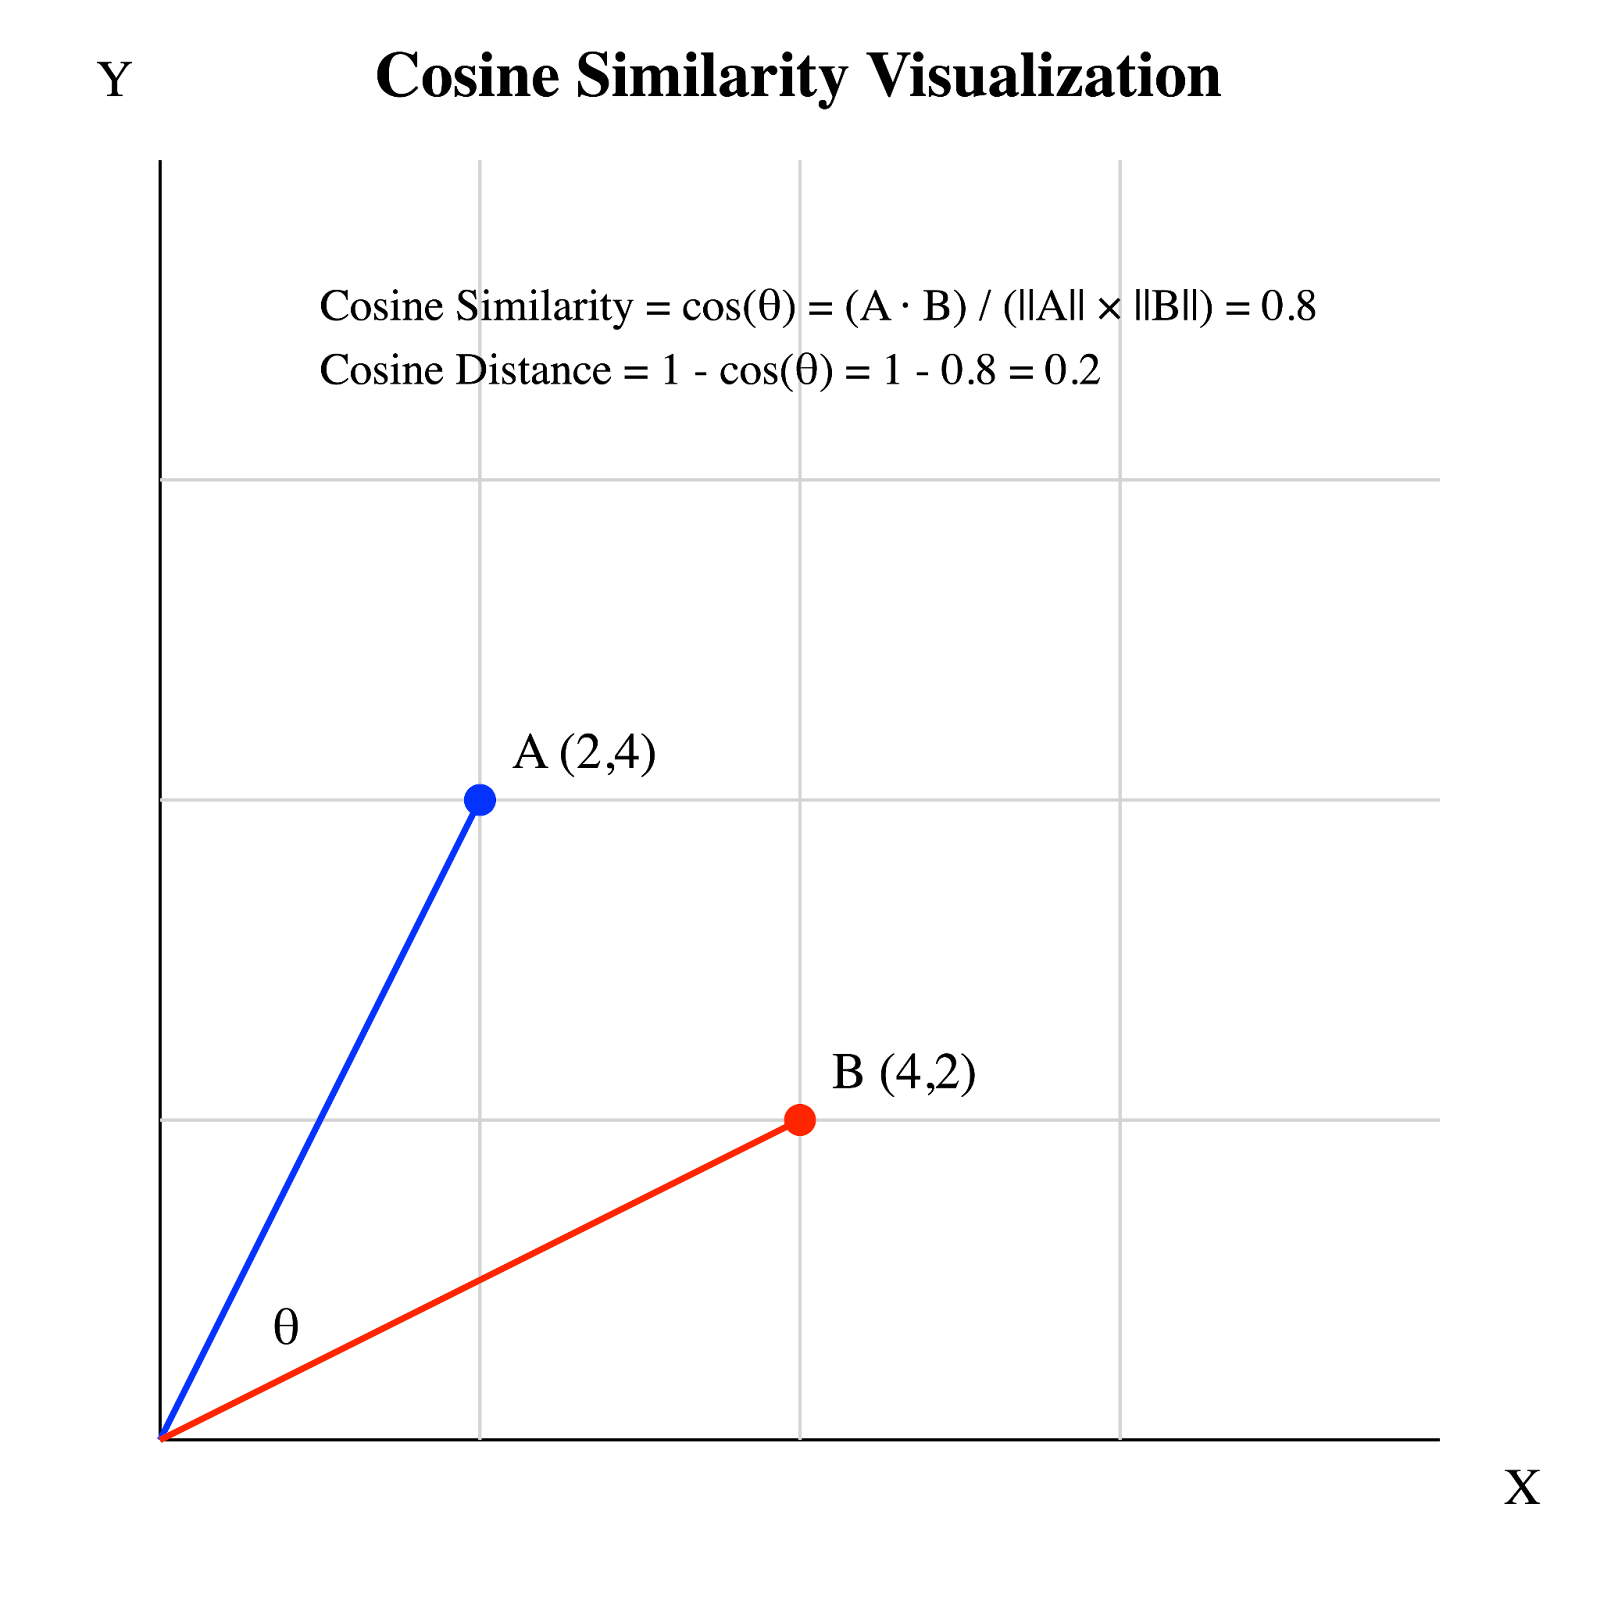 Cosine distance e cosine similarity. Imagem do autor.
Nesta representação:
A cosine similarity (0,8) representa o cosseno do ângulo θ. Como os vetores têm direções próximas, o ângulo é pequeno, resultando em alta cosine similarity e baixa cosine distance (0,2).
Como a cosine distance também pode ser definida como 1 - cos(θ), em que cos(θ) é a cosine similarity, isso implica:
Veja algumas aplicações importantes.
Cosine distance tem um papel essencial em várias tarefas de processamento de linguagem natural, medindo de forma eficaz relações semânticas entre representações de texto como word2vec. Para uma visão geral rápida desses conceitos, nosso tutorial Understanding Text Classification in Python pode ser útil.
Na classificação de documentos, a cosine distance mede a similaridade de conteúdo comparando os ângulos entre vetores de documentos. Cada documento é convertido em um vetor, com dimensões refletindo os escores TF-IDF das palavras. Documentos similares apontam para direções parecidas, resultando em distâncias cosseno menores.
Cosine distance se destaca em tarefas de clustering como K-means, agrupando documentos semanticamente relacionados mesmo que não usem as mesmas palavras. É ideal para dados de alta dimensionalidade e esparsos, comuns no processamento de texto. Ao capturar a orientação dos vetores, permite agrupamentos temáticos mais precisos. Essa técnica é frequentemente usada em aprendizado não supervisionado para descobrir agrupamentos naturais em coleções de documentos, como agrupar notícias por tema.
Em recuperação da informação, cosine distance relaciona consultas de busca a documentos por comparação de vetores. Os buscadores encontram os documentos mais próximos do vetor da consulta em termos de cosine distance, ranqueando mais alto aqueles com menores distâncias por relevância.
Além da análise em nível de documento, cosine distance é fundamental em embeddings de palavras como Word2Vec ou GloVe, em que palavras são representadas como vetores de alta dimensionalidade. Esses embeddings capturam significado semântico de modo que palavras com sentidos semelhantes fiquem próximas no espaço vetorial. Cosine distance pode ser usada para encontrar as palavras mais similares a uma palavra dada, apoiar a detecção de sinônimos ou até alimentar recursos em modelos mais complexos, como os usados para análise de sentimento ou tradução automática.
No reconhecimento de imagens, cosine distance entra em cena para comparar vetores de características extraídos das imagens. Seja para identificar rostos em uma multidão ou classificar fotos da natureza, ela observa o quão similares são os vetores na orientação, não apenas no tamanho. Esse foco ajuda a acertar as categorias corretas para as imagens, aumentando a precisão e a eficácia de sistemas baseados em imagem.
Pense na cosine distance como uma casamenteira do mundo digital, conectando usuários a filmes ou produtos alinhados com seus gostos anteriores. Ao observar o quão próximos os perfis de usuários e itens ficam em seus espaços vetoriais, os sistemas de recomendação conseguem prever com ótima precisão o que você provavelmente vai curtir em seguida.
Cosine distance tem propriedades matemáticas únicas que a diferenciam de outras medidas de distância. Entender essas propriedades é importante para interpretar e aplicar corretamente a cosine distance em diferentes contextos.
Em matemática, uma métrica ou função de distância é uma função que define a distância entre cada par de elementos de um conjunto. Para ser considerada uma métrica verdadeira, uma função deve satisfazer quatro condições:
Não negatividade: d(x, y) ≥ 0
Identidade dos indiscerníveis: d(x, y) = 0 se, e somente se, x = y
Simetria: d(x, y) = d(y, x)
Desigualdade triangular: d(x, z) ≤ d(x, y) + d(y, z)
Cosine distance satisfaz as três primeiras condições, mas nem sempre satisfaz a desigualdade triangular. Isso significa que, em alguns casos, a soma das distâncias cosseno entre os pontos A e B e entre B e C pode ser menor do que a distância cosseno entre A e C.
Uma propriedade notável de cosine distance é sua invariância a escala. Isso significa que a distância cosseno entre dois vetores permanece a mesma mesmo que você multiplique um ou ambos os vetores por um escalar (constante diferente de zero). Matematicamente, para quaisquer escalares não nulos a e b, e vetores x e y:
Cosine Distance(ax, by) = Cosine Distance(x, y)
Essa propriedade de invariância a escala diferencia a cosine distance de muitas outras medidas de distância.
Aqui, vamos ver como calcular cosine distance usando Python e R.
Em Python, podemos usar NumPy para calcular cosine distance e cosine similarity. Fazemos isso encontrando o produto escalar e a norma dos vetores.
import numpy as np

# Define the vectors
A = np.array([2, 4])
B = np.array([4, 2])

# Calculate cosine similarity
cos_similarity = np.dot(A, B) / (np.linalg.norm(A) * np.linalg.norm(B))

# Calculate cosine distance
cos_distance = 1 - cos_similarity

print("Cosine Similarity: {:.2f}".format(cos_similarity))
print("Cosine Distance: {:.2f}".format(cos_distance))
Saída:
Cosine Similarity: 0.80
Cosine Distance: 0.20
Como alternativa, podemos calcular cosine distance usando o pacote SciPy e a função cosine().
import numpy as np
from scipy.spatial.distance import cosine

# Define the vectors
A = np.array([2, 4])
B = np.array([4, 2])

# Calculate cosine distance
cos_distance = cosine(A, B)  # Uses scipy's cosine for cosine distance

print("Cosine Distance: {:.2f}".format(cos_distance))
Saída:
Cosine Distance: 0.20Em R, você pode calcular cosine similarity e cosine distance usando operações vetoriais básicas. Veja como:
# Define the vectors
A <- c(2, 4)
B <- c(4, 2)

# Calculate cosine similarity
cos_similarity <- sum(A * B) / (sqrt(sum(A^2)) * sqrt(sum(B^2)))
# Note: We can also use %*% operator for matrix multiplication.
# %*%, when applied to two vectors, calculates the dot product.
# For example: cos_similarity <- A %*% B / (sqrt(sum(A^2)) * sqrt(sum(B^2)))

# Calculate cosine distance
cos_distance <- 1 - cos_similarity

# Print the result
print(paste("Cosine Similarity:", cos_similarity))
print(paste("Cosine Distance:", cos_distance))
Saída:
“Cosine Similarity: 0.80”
“Cosine Distance: 0.20”
No exemplo em R, a cosine similarity é calculada usando operações manuais para produto escalar e normas, semelhante ao exemplo em Python, mas totalmente com funcionalidades básicas do R. Note como a cosine distance é obtida subtraindo a cosine similarity de 1.
A imagem abaixo amplia nosso exemplo original, mas agora usa cores diferentes para representar três tipos de medidas de distância usando os mesmos vetores:
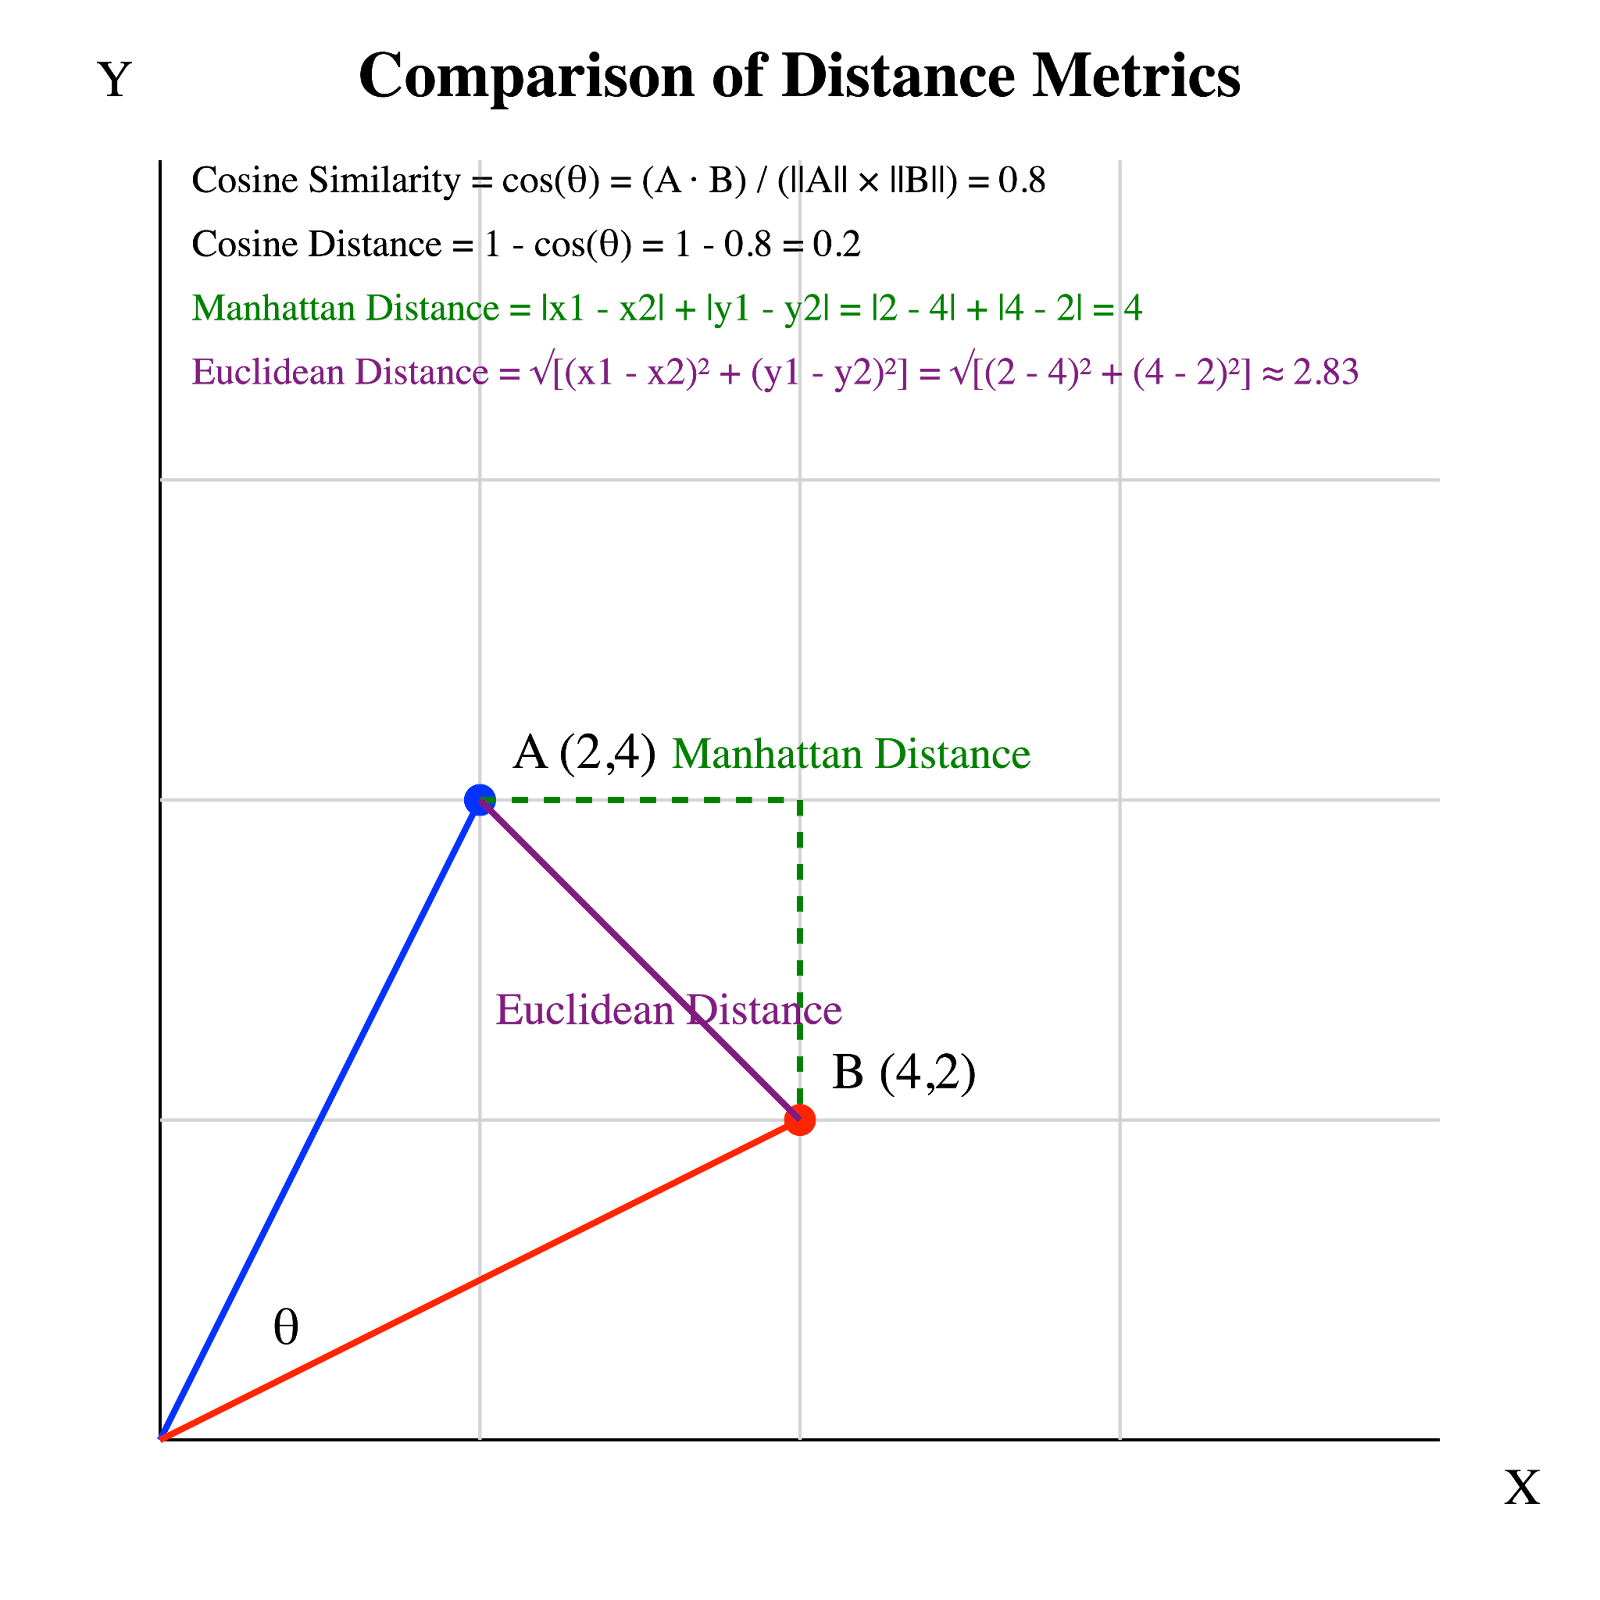
Cosine distance vs. distância euclidiana vs. Manhattan distance. Imagem do autor.
Cada uma dessas distâncias oferece insights únicos sobre os dados. As distâncias euclidiana e Manhattan são geométricas e levam em conta a magnitude dos componentes do vetor, o que as torna adequadas para medições físicas no espaço. Já a cosine distance foca no ângulo entre vetores, sendo ideal para entender orientação e direcionalidade, especialmente em espaços de alta dimensionalidade, como os usados em análise de texto e outras áreas de data science.
Cosine distance e sua complementar, a cosine similarity, são ferramentas poderosas em data science e machine learning. Essas métricas oferecem insights únicos sobre os relacionamentos entre vetores, principalmente em espaços de alta dimensionalidade onde medidas tradicionais podem falhar.
À medida que os dados continuam a crescer em complexidade e dimensionalidade, métricas como cosine distance tendem a ganhar ainda mais importância para revelar padrões e relações ocultas. Seja trabalhando com processamento de linguagem natural, sistemas de recomendação ou qualquer área que lide com espaços vetoriais de alta dimensão, entender e aplicar cosine distance pode gerar insights valiosos e melhorar a performance dos seus modelos. Como próximo passo, faça nosso curso interativo completo, Designing Machine Learning Workflows in Python, que tem um capítulo inteiro sobre aprendizagem baseada em distância e fluxos não supervisionados.
Aprenda com a DataCamp
Curso
Curso
Curso
Tutorial
Abid Ali Awan
14 min
Tutorial
Kevin Babitz
8 min
Tutorial
Eugenia Anello
8 min
Tutorial
DataCamp Team
3 min
Tutorial
Kurtis Pykes
13 min
Tutorial
Abid Ali Awan
11 min