

pandas installieren
Installiere pandas im Terminal mit dem Befehl pip install. pandas 3 erfordert Python 3.11 oder neuer; auf älteren Python-Versionen installiert pip die neueste unterstützte pandas-2.x-Version.
pip install pandasAlternativ kannst du es via conda installieren:
conda install pandasNach der Installation lohnt es sich, die installierte Version zu prüfen, um sicherzustellen, dass alles korrekt funktioniert:
import pandas as pd
print(pd.__version__) # Prints the pandas versionSo bestätigst du die korrekte Installation von pandas und prüfst die Kompatibilität mit anderen Paketen.
Was sich in pandas 3.0 und 3.1 geändert hat
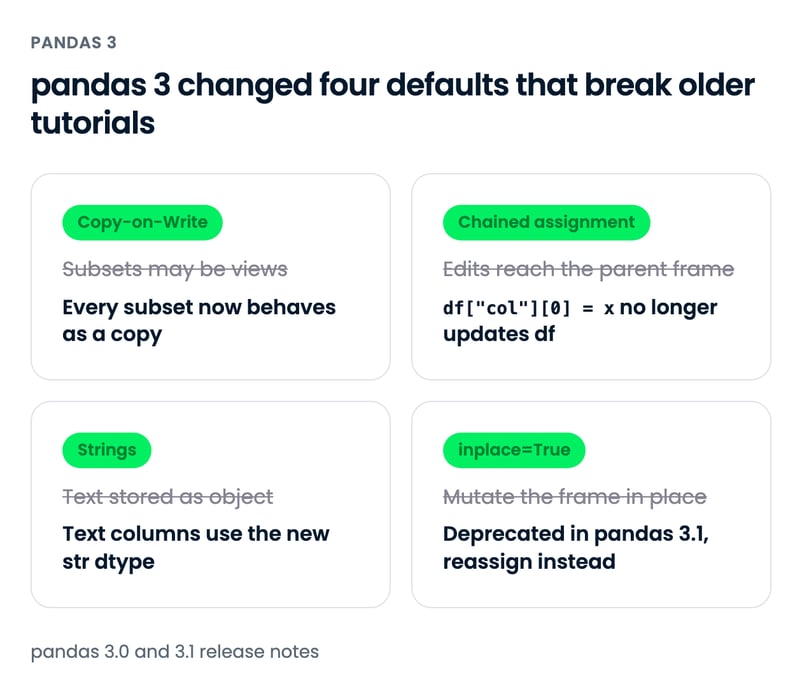
pandas 3.0 (Januar 2026) hat das Verhalten von Kopien, Strings und Zuweisungen geändert; pandas 3.1 (Oktober 2026) hat die meisten Verwendungen von inplace=True veraltet. Älterer Tutorial-Code läuft meist noch, aber vier Änderungen sorgen oft für Stolperfallen:
- Copy-on-Write ist Standard. Jede Teilmenge oder Methodenausgabe verhält sich wie eine Kopie, Änderungen daran ändern nie das ursprüngliche DataFrame. Die
SettingWithCopyWarningist verschwunden – ebenso der Bedarf an defensiven.copy()-Aufrufen. - Verkettete Zuweisung funktioniert nicht mehr.
df["Age"][0] = 35aktualisiert nur eine temporäre Kopie und lässtdfunverändert; pandas warnt mitChainedAssignmentError. Verwende stattdessen eine einzelne.loc[]-Anweisung. - Strings haben einen eigenen Datentyp. Textspalten werden jetzt als
strstattobjecterkannt, unterstützt durch PyArrow, wenn installiert. inplace=Trueist veraltet fürsort_values(),reset_index(),dropna(),drop_duplicates(),rename()und weitere Methoden. Weise stattdessen das Ergebnis neu zu:df = df.dropna().
So sieht die Änderung bei verketteter Zuweisung an einem kleinen DataFrame aus:
import pandas as pd
patients = pd.DataFrame({"name": ["Ana", "Ben", "Chloe"], "age": [34, 51, 28]})
patients["age"][0] = 35 # chained assignment: patients is not changed
patients.loc[0, "age"] = 35 # a single .loc[] call: patients is updated
print(patients.dtypes)name str
age int64
dtype: objectJedes Beispiel in diesem Tutorial befolgt die Regeln von pandas 3. Die vollständige Liste der Änderungen findest du in den offiziellen Release Notes zu pandas 3.0 und pandas 3.1. Wenn du älteren Code pflegst, erklärt unser Leitfaden zur SettingWithCopyWarning das Verhalten, das Copy-on-Write ersetzt hat.
Daten in pandas importieren
Um mit pandas zu arbeiten, importiere das Python-Paket wie unten gezeigt. Das gängigste Alias ist pd.
import pandas as pdCSV-Dateien importieren
Nutze read_csv() mit dem Pfad zur Datei, um eine CSV-Datei einzulesen (mehr Details in unserem Tutorial zum Import mit read_csv()).
df = pd.read_csv("diabetes.csv")Dieser Lesevorgang lädt diabetes.csv in ein pandas-DataFrame namens df. In diesem Tutorial verwenden wir den Pima Indians Diabetes Datensatz: 768 Patientinnen und Patienten, acht Gesundheitsmesswerte wie Glucose, BMI und Age sowie eine Spalte Outcome, in der 1 eine diagnostizierte Diabetes-Erkrankung bedeutet.
Textdateien importieren
Das Einlesen von Textdateien funktioniert ähnlich wie bei CSV. Du musst lediglich mit dem Argument sep den Trenner angeben. Der Trenner ist das Zeichen, das die Werte (Spalten) in jeder Zeile trennt. Komma (sep=","), Tab (sep="\t"), Doppelpunkt (sep=":") und Whitespace (sep=r"\s+") sind am gebräuchlichsten. r"\s+" ist ein regulärer Ausdruck für ein oder mehr Leerzeichen; das Präfix r macht daraus einen Raw String, damit Python \s nicht als ungültige Escape-Sequenz behandelt.
df = pd.read_csv("diabetes.txt", sep=r"\s+")Excel-Dateien importieren (einzelnes Blatt)
Lies Excel-Dateien mit der Funktion read_excel() und übergib den Dateipfad. pandas benötigt dafür ein zusätzliches Engine-Paket: Installiere openpyxl für .xlsx-Dateien oder xlrd für ältere .xls-Dateien.
df = pd.read_excel('diabetes.xlsx')Du kannst weitere Argumente angeben, z. B. header, um festzulegen, welche Zeile zur Kopfzeile wird. Standard ist 0, also die erste Zeile als Spaltennamen. Alternativ kannst du Spaltennamen als Liste über names setzen. Das Argument index_col (Standard None) verwendest du, wenn die Datei einen expliziten Zeilenindex enthält.
Hinweis: In einem pandas-DataFrame oder einer Series ist der Index ein Bezeichner, der auf die Position einer Zeile oder Spalte zeigt. Kurz gesagt: Der Index beschriftet Zeilen oder Spalten und ermöglicht dir, gezielt per Index darauf zuzugreifen. Ein Zeilenindex kann ein Zahlenbereich (z. B. 0 bis 303), eine Zeitreihe (Daten oder Timestamps), eine eindeutige ID (z. B. employee_ID in einer employees-Tabelle) oder andere Typen sein. Spaltenindizes sind in der Regel Strings (Spaltennamen).
Excel-Dateien importieren (mehrere Blätter)
Das Einlesen mehrerer Blätter unterscheidet sich nur durch ein zusätzliches Argument: sheet_name. Übergebe den Blattnamen als String oder die Position als Integer (Python verwendet 0-basiertes Indexing, das erste Blatt erreichst du mit sheet_name = 0).
# Das zweite Blatt auslesen, da Python 0-basiert indexiert
df = pd.read_excel('diabetes_multi.xlsx', sheet_name=1)JSON-Datei importieren
Ähnlich wie read_csv() liest read_json() JSON-Dateien (mehr dazu in diesem Tutorial zu JSON- und HTML-Import). Der folgende Code liest eine JSON-Datei von der Festplatte und erstellt ein DataFrame df.
df = pd.read_json("diabetes.json")Wenn du mehr über das Importieren mit pandas lernen möchtest, schau dir dieses Cheat Sheet zum Einlesen verschiedener Dateitypen mit Python an.
Daten aus SQL-Datenbanken importieren
Um Daten aus einer relationalen Datenbank zu laden, nutze pd.read_sql() zusammen mit einer Datenbankverbindung.
import sqlite3
# Verbindung zu einer SQLite-Datenbank aufbauen
conn = sqlite3.connect("my_database.db")
# Daten aus einer Tabelle lesen
df = pd.read_sql("SELECT * FROM my_table", conn)Für andere Datenbanken wie PostgreSQL oder MySQL übergib statt einer sqlite3-Verbindung eine SQLAlchemy-Engine. Für große Tabellen setzt du chunksize, um Ergebnisse in Batches einzulesen.
Daten aus einer API importieren (JSON-Format)
Kommen deine Daten aus einer Web-API, kann pandas sie direkt mit pd.read_json() einlesen:
df = pd.read_json("https://api.example.com/data.json")Ist die API-Antwort verschachteltes JSON, flachst du sie mit pd.json_normalize() ab. Das erzeugt punktgetrennte Spalten aus verschachtelten Schlüsseln:
records = [
{"id": 1, "vitals": {"glucose": 148, "bmi": 33.6}},
{"id": 2, "vitals": {"glucose": 85, "bmi": 26.6}},
]
pd.json_normalize(records) id vitals.glucose vitals.bmi
0 1 148 33.6
1 2 85 26.6Daten in pandas exportieren
So wie pandas Daten aus verschiedenen Formaten importiert, kannst du sie auch in diverse Formate exportieren. Das ist besonders hilfreich, wenn du Daten transformiert hast und lokal speichern willst. So gibst du DataFrames in verschiedene Formate aus:
Ein DataFrame als CSV-Datei ausgeben
Speichere ein pandas-DataFrame (hier df) mit .to_csv() als CSV. Übergebe den Pfad und setze index=False, außer du brauchst den Zeilenindex in der Datei (Standard index=True schreibt ihn als zusätzliche, unbenannte Spalte). Unser Tutorial zum Speichern eines DataFrames als CSV deckt weitere Argumente ab.
df.to_csv("diabetes_out.csv", index=False)Ein DataFrame als JSON-Datei ausgeben
Exportiere ein DataFrame in eine JSON-Datei mit .to_json().
df.to_json("diabetes_out.json")Hinweis: Eine JSON-Datei speichert ein tabellarisches Objekt wie ein DataFrame als Key-Value-Paare. Daher findest du in JSON wiederholte Spaltennamen.
Ein DataFrame als Textdatei ausgeben
Wie beim Schreiben in CSV verwendest du auch hier .to_csv(). Unterschiede: die Ausgabedatei hat die Endung .txt und du gibst einen Trenner über sep an.
df.to_csv('diabetes_out.txt', header=df.columns, index=None, sep=' ')Ein DataFrame als Excel-Datei ausgeben
Rufe .to_excel() auf, um als .xlsx zu speichern (benötigt openpyxl). pandas kann keine alten .xls-Dateien mehr schreiben.
df.to_excel("diabetes_out.xlsx", index=False)DataFrames in pandas ansehen und verstehen
Nach dem Einlesen als DataFrame möchtest du einen schnellen Überblick gewinnen – entweder mit einer Stichprobe der Zeilen oder mit zusammenfassenden Kennzahlen.
So zeigst du Daten mit .head() und .tail() an
Die ersten bzw. letzten Zeilen eines DataFrames siehst du mit .head() bzw. .tail(). Über das Argument n legst du die Zeilenanzahl fest (Standard ist 5).
df.head()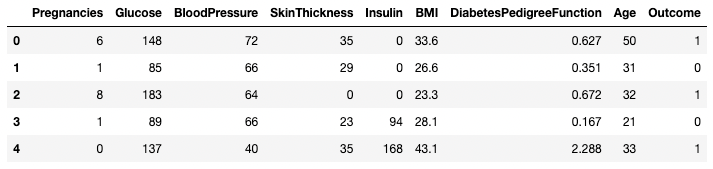
Die ersten fünf Zeilen des DataFrames
df.tail(n = 10)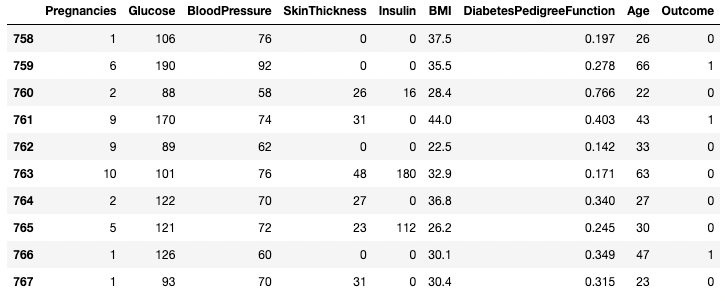
Die letzten 10 Zeilen des DataFrames
Daten verstehen mit .describe()
.describe() gibt die Zusammenfassungsstatistik aller numerischen Spalten aus – etwa Anzahl, Mittelwert, Standardabweichung, Spannweite und Quartile.
df.describe()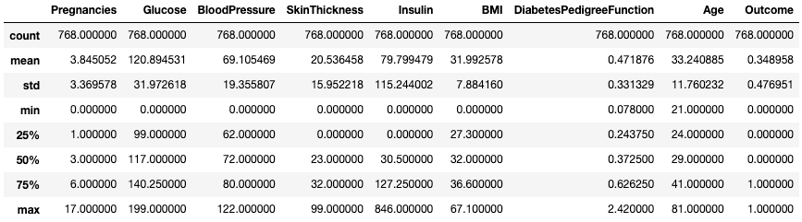
Zusammenfassende Statistik mit .describe()
So bekommst du schnell ein Gefühl für Größenordnungen, Schiefe und Verteilungen der numerischen Daten.
Du kannst die Quartile über das Argument percentiles anpassen. Hier betrachten wir z. B. die 30-, 50- und 70-Prozent-Perzentile der numerischen Spalten in df.
df.describe(percentiles=[0.3, 0.5, 0.7])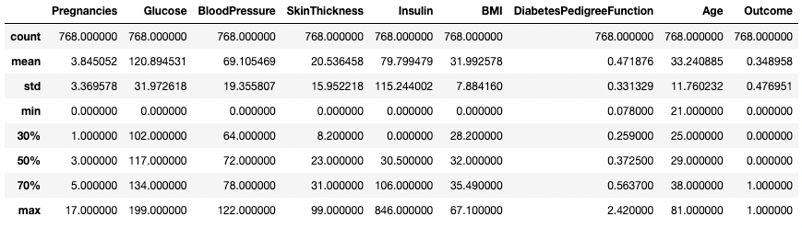
Zusammenfassende Statistik mit spezifischen Perzentilen
Mit dem Argument include kannst du bestimmte Datentypen gezielt einbeziehen. Hier fassen wir nur Spalten mit Datentyp integer zusammen.
df.describe(include=[int])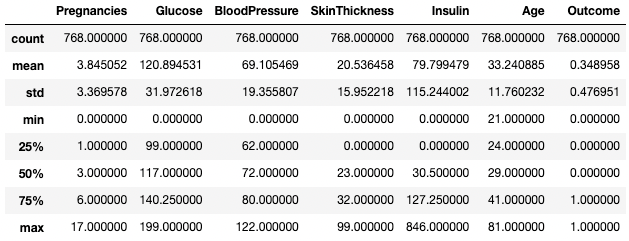
Zusammenfassende Statistik nur für Integer-Spalten
Ebenso kannst du bestimmte Datentypen über exclude ausschließen.
df.describe(exclude=[int]) BMI DiabetesPedigreeFunction
count 768.000000 768.000000
mean 31.992578 0.471876
std 7.884160 0.331329
min 0.000000 0.078000
25% 27.300000 0.243750
50% 32.000000 0.372500
75% 36.600000 0.626250
max 67.100000 2.420000
Oft ist es praktischer, die Ausgabe mit dem Attribut .T zu transponieren.
df.describe().T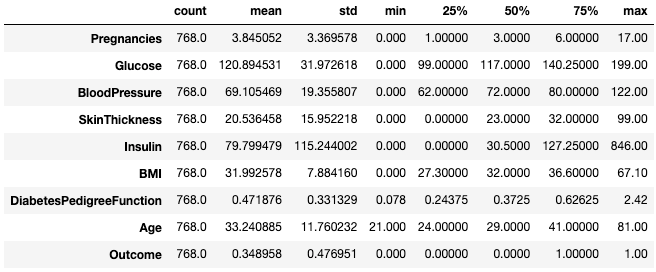
Zusammenfassende Statistik mit .T transponieren
Mehr zu Beschreibungsfunktionen findest du in diesem Cheat Sheet.
Daten verstehen mit .info()
Die Methode .info() liefert schnell Datentypen, fehlende Werte und Größe eines DataFrames. Hier setzen wir show_counts auf True, um die Anzahl nicht-fehlender Werte je Spalte zu sehen. Außerdem setzen wir memory_usage auf True, um die Gesamtspeichernutzung der DataFrame-Elemente auszugeben. Mit verbose=True erhältst du die vollständige Zusammenfassung.
df.info(show_counts=True, memory_usage=True, verbose=True)<class 'pandas.DataFrame'>
RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Pregnancies 768 non-null int64
1 Glucose 768 non-null int64
2 BloodPressure 768 non-null int64
3 SkinThickness 768 non-null int64
4 Insulin 768 non-null int64
5 BMI 768 non-null float64
6 DiabetesPedigreeFunction 768 non-null float64
7 Age 768 non-null int64
8 Outcome 768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KBDatenform mit .shape prüfen
Die Anzahl der Zeilen und Spalten eines DataFrames erhältst du über das Attribut .shape. Es gibt ein Tupel (Zeilen, Spalten) zurück, das du indexieren kannst, um nur die Zeilen- bzw. Spaltenanzahl zu bekommen.
df.shape # Anzahl Zeilen und Spalten
df.shape[0] # Nur die Zeilenanzahl
df.shape[1] # Nur die Spaltenanzahl(768,9)
768
9Alle Spalten und Spaltennamen abrufen
Der Zugriff auf das Attribut .columns eines DataFrames liefert die Spaltennamen als Index-Objekt. Zur Erinnerung: Ein pandas-Index ist die Adresse/Bezeichnung einer Zeile oder Spalte.
df.columnsIndex(['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI',
'DiabetesPedigreeFunction', 'Age', 'Outcome'],
dtype='str')Mit list() wandelst du ihn in eine Liste um.
list(df.columns)['Pregnancies',
'Glucose',
'BloodPressure',
'SkinThickness',
'Insulin',
'BMI',
'DiabetesPedigreeFunction',
'Age',
'Outcome']Fehlende Werte in pandas mit .isnull() prüfen
Das Beispiel-DataFrame hat keine fehlenden Werte. Wir fügen ein paar hinzu. Mit .copy() erstellst du eine Kopie des Original-DataFrames, sodass df für spätere Beispiele unverändert bleibt. Per .loc (später erklärt) setzen wir die Zeilen mit den Labels 2 bis 5 in der Spalte Pregnancies auf fehlend. Weil fehlende Werte als NaN (Float) gespeichert werden, ändert pandas den Spaltentyp von int64 zu float64.
df2 = df.copy()
df2.loc[2:5,'Pregnancies'] = None
df2.head(7)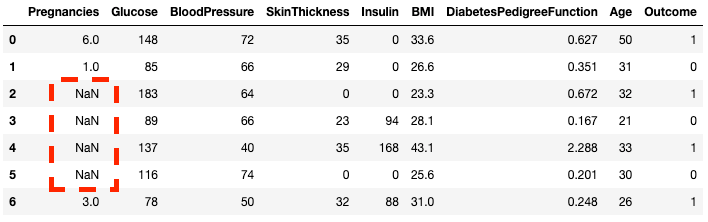
Du siehst, dass die Zeilen 2 bis 5 nun NaN sind.
Ob jedes Element eines DataFrames fehlt, prüfst du mit .isnull().
df2.isnull().head(7)Da es oft hilfreicher ist zu wissen, wie viel fehlt, kombinierst du .isnull() mit .sum(), um die Anzahl fehlender Werte je Spalte zu zählen.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Mit einer doppelten Summe bekommst du die Gesamtanzahl fehlender Werte im DataFrame.
df2.isnull().sum().sum()4Sortieren, Aufteilen und Auswählen von Daten in pandas
pandas bietet mehrere Wege, um DataFrames zu sortieren, zu unterteilen, zu filtern und Daten zu isolieren. Hier sind die gängigsten Methoden.
Daten sortieren
Sortiere ein DataFrame nach einer Spalte mit .sort_values(). Es liefert ein neues, sortiertes DataFrame und lässt df unverändert – weise das Ergebnis zu, wenn du es behalten willst:
df.sort_values(by="Age", ascending=False) # Nach Age absteigend sortierenDu kannst auch nach mehreren Spalten sortieren:
df.sort_values(by=["Age", "Glucose"], ascending=[False, True])Index zurücksetzen
Nach Sortieren oder Filtern bleiben die ursprünglichen Zeilenlabels erhalten, der Index ist also nicht mehr fortlaufend. Mit .reset_index() erhältst du einen frischen 0-basierten Index (siehe unser Reset-Index-Tutorial für weitere Optionen):
df_sorted = df.sort_values(by="Age", ascending=False).reset_index(drop=True) # drop=True verwirft den alten Index
df_sorted[["Age", "Glucose", "Outcome"]].head(3) Age Glucose Outcome
0 81 134 0
1 72 119 0
2 70 145 1Eine Spalte isolieren mit [ ]
Du kannst eine einzelne Spalte mit eckigen Klammern [ ] und dem Spaltennamen isolieren. Die Ausgabe ist eine pandas-Series. Eine Series ist ein eindimensionales Array, das Daten beliebigen Typs enthalten kann. Ein DataFrame besteht aus vielen Series, die als Spalten fungieren.
df['Outcome']0 1
1 0
2 1
3 0
4 1
..
763 0
764 0
765 0
766 1
767 0
Name: Outcome, Length: 768, dtype: int64Zwei oder mehr Spalten isolieren mit [[ ]]
Übergebe eine Liste von Spaltennamen innerhalb der Klammern, um mehrere Spalten zu holen. Die äußeren Klammern markieren die Teilmenge des DataFrames, die inneren bilden die Liste.
df[['Pregnancies', 'Outcome']] Pregnancies Outcome
0 6 1
1 1 0
2 8 1
3 1 0
4 0 1
.. ... ...
763 10 0
764 2 0
765 5 0
766 1 1
767 1 0
[768 rows x 2 columns]Eine Zeile isolieren mit [ ]
Eine einzelne Zeile holst du, indem du eine Boolesche Series mit genau einem True übergibst. Im Beispiel unten wird die zweite Zeile mit index = 1 zurückgegeben. .index liefert die Zeilenlabels, der Vergleich erzeugt ein boolesches Array.
df[df.index==1]
Eine Zeile in pandas isolieren
Zwei oder mehr Zeilen isolieren mit [ ]
Mehrere Zeilen erhältst du ähnlich mit .isin() statt dem Operator ==.
df[df.index.isin(range(2,10))]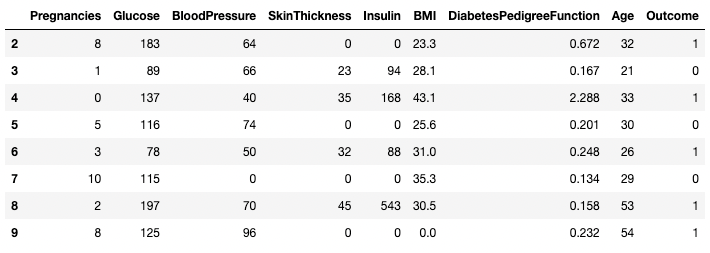
Bestimmte Zeilen in pandas isolieren
Zeilen mit .loc[] und .iloc[] holen
Mit .loc[] und .iloc[] kannst du Zeilen nach Labels oder Positionen holen ("location" und "integer location"). .loc[] nutzt Labels für Zeilen, Spalten oder Zellen, .iloc[] numerische Positionen. Unser Leitfaden zu loc vs iloc deckt alle Unterschiede ab. Um den wichtigsten hier zu zeigen, ändern wir den Index von df2, damit Labels und Positionen nicht mehr übereinstimmen.
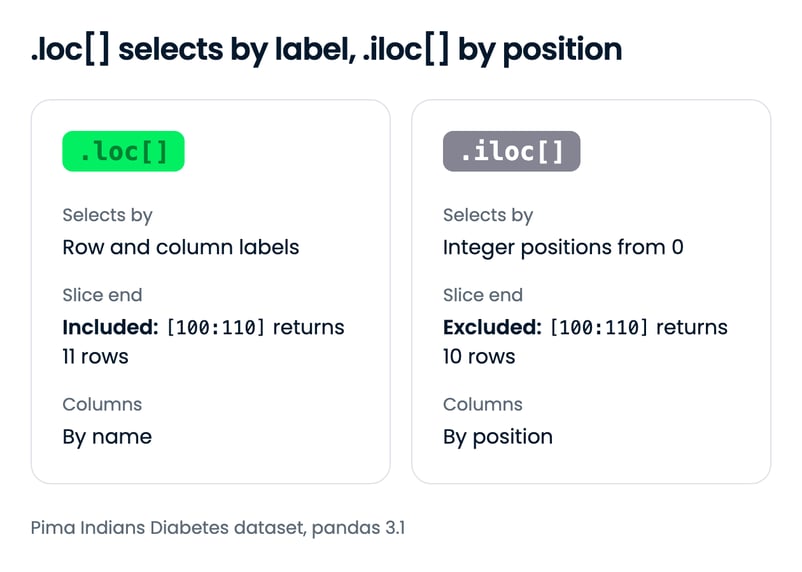
df2.index = range(1,769)Im folgenden Beispiel gibt pandas eine Series statt eines DataFrames zurück. Bei .loc[1] ist 1 ein Label und liefert die Zeile mit Label 1 (die erste nach dem Re-Indexing). Bei .iloc[1] ist 1 eine 0-basierte Position und liefert die zweite Zeile, die das Label 2 trägt.
df2.loc[1]Pregnancies 6.000
Glucose 148.000
BloodPressure 72.000
SkinThickness 35.000
Insulin 0.000
BMI 33.600
DiabetesPedigreeFunction 0.627
Age 50.000
Outcome 1.000
Name: 1, dtype: float64df2.iloc[1]Pregnancies 1.000
Glucose 85.000
BloodPressure 66.000
SkinThickness 29.000
Insulin 0.000
BMI 26.600
DiabetesPedigreeFunction 0.351
Age 31.000
Outcome 0.000
Name: 2, dtype: float64Du kannst auch Bereiche angeben. Die beiden Accessoren behandeln das Ende des Bereichs unterschiedlich: .loc[100:110] schließt das Label 110 ein und liefert 11 Zeilen; .iloc[100:110] stoppt vor Position 110 und liefert 10 Zeilen.
df2.loc[100:110]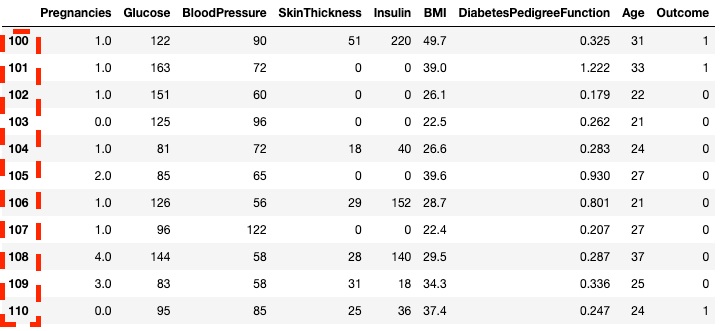
Zeilen in pandas mit .loc[] isolieren
df2.iloc[100:110]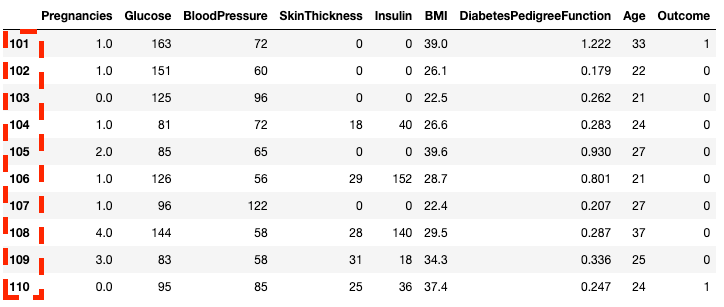
Zeilen in pandas mit .iloc[] isolieren
Du kannst auch mit einer Liste statt eines Bereichs unterteilen.
df2.loc[[100, 200, 300]]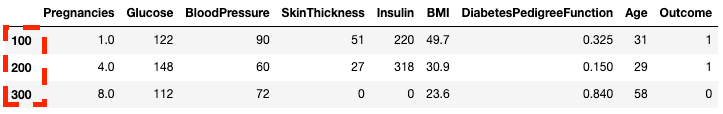
Zeilen per Liste mit .loc[] auswählen
df2.iloc[[100, 200, 300]]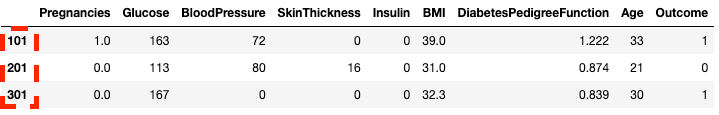
Zeilen per Liste mit .iloc[] auswählen
Du kannst zusammen mit den Zeilen auch bestimmte Spalten wählen. Hier unterscheidet sich .iloc[] von .loc[] – es erwartet Spaltenpositionen statt Spaltenlabels.
df2.loc[100:110, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
100 1.0 122 90
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85df2.iloc[100:110, :3] Pregnancies Glucose BloodPressure
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85Für schnellere Workflows kannst du den Startindex eines Bereichs ab Zeile übergeben.
df2.loc[760:, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
760 6.0 190 92
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70df2.iloc[760:, :3] Pregnancies Glucose BloodPressure
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70Werte aktualisieren kannst du, indem du .loc[] mit dem Zuweisungsoperator = kombinierst. Baue die Bedingung aus demselben DataFrame, das du aktualisierst: Eine Bedingung aus df passt nicht mehr zum neuen Index von df2, und pandas wirft einen Fehler.
df2.loc[df2["Age"] == 81, "Age"] = 80Zeilen mit Bedingungen filtern
pandas erlaubt das Filtern per Bedingungen über Zeilen-/Spaltenwerte. Das Beispiel unten wählt Zeilen, in denen BloodPressure exakt 122 ist. Wir isolieren Zeilen mit den Klammern [ ], wie zuvor gezeigt. Statt Indizes oder Spaltennamen übergeben wir eine Bedingung df.BloodPressure == 122.
df[df.BloodPressure == 122]
Zeilen anhand einer Bedingung in pandas isolieren
Das nächste Beispiel holt alle Zeilen mit Outcome gleich 1. df.Outcome wählt die Spalte, df.Outcome == 1 ergibt eine boolesche Series, die markiert, wo der Wert 1 ist, und [] nimmt die Teilmenge von df, wo diese Series True ist.
df[df.Outcome == 1]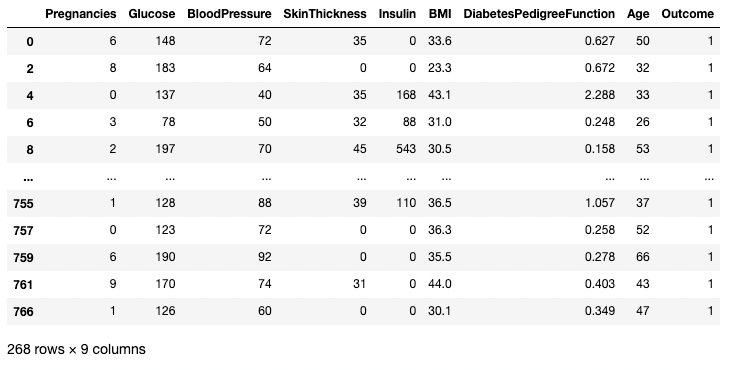
Zeilen anhand einer Bedingung in pandas isolieren
Mit dem Operator > kannst du Vergleiche ziehen. Der folgende Code holt Pregnancies, Glucose und BloodPressure für alle Zeilen mit BloodPressure größer 100.
df.loc[df['BloodPressure'] > 100, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
43 9 171 110
84 5 137 108
106 1 96 122
177 0 129 110
207 5 162 104
362 5 103 108
369 1 133 102
440 0 189 104
549 4 189 110
658 11 127 106
662 8 167 106
672 10 68 106
691 13 158 114Daten in pandas bereinigen
Datenbereinigung ist eine der häufigsten Aufgaben in Data Science. Mit pandas bereitest du Daten für jeden Zweck vor – unter anderem für das Training von Machine- und Deep-Learning-Modellen. Wir nutzen df2 mit vier fehlenden Werten, um typische Fälle zu zeigen. Zur Erinnerung: So siehst du, wie viele fehlende Werte ein DataFrame hat.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Umgang mit fehlenden Werten #1: Zeilen/Spalten entfernen
Eine Möglichkeit ist, fehlende Werte zu löschen – sinnvoll, wenn du genügend Daten hast und der Verlust weniger Zeilen unkritisch ist. Verwende .dropna() wie unten. Hier speichern wir das Ergebnis in df3.
df3 = df2.copy()
df3 = df3.dropna()
df3.shape(764, 9) # das sind 4 Zeilen weniger als df2Mit dem Argument axis bestimmst du, ob Zeilen oder Spalten mit fehlenden Werten entfernt werden. Standardmäßig entfernt axis=0 Zeilen. Mit axis = 1 entfernst du Spalten mit mindestens einem NaN. Wie in allen Beispielen in diesem Tutorial weisen wir das Ergebnis neu zu statt inplace=True zu nutzen, das in pandas 3.1 für .dropna() veraltet ist.
df3 = df2.dropna(axis=1)
list(df3.columns)['Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DiabetesPedigreeFunction', 'Age', 'Outcome']Standardmäßig löscht .dropna() eine Zeile, wenn irgendein Wert fehlt. Setze how auf 'all', um nur Zeilen zu entfernen, in denen alle Werte fehlen. In df2 ist keine Zeile komplett leer, daher wird nichts entfernt:
df3 = df2.dropna(how="all")
df3.shape(768, 9)Umgang mit fehlenden Werten #2: Werte ersetzen
Statt zu löschen, kannst du fehlende Werte mit Kennzahlen oder festen Werten füllen. Fehlt z. B. ein Tag in einer Woche Temperaturmessungen, erhältst du mit dem Wochenmittel die Zeile und verlierst wenig Information. Unten füllen wir fehlende Pregnancies-Werte mit dem Spaltenmittel.
df3 = df2.copy()
# Mittelwert von Pregnancies bestimmen
mean_value = df3["Pregnancies"].mean()
# Nur fehlende Werte dieser Spalte füllen
df3["Pregnancies"] = df3["Pregnancies"].fillna(mean_value)
df3["Pregnancies"].head(7)1 6.000000
2 1.000000
3 3.846859
4 3.846859
5 3.846859
6 3.846859
7 3.000000
Name: Pregnancies, dtype: float64Umgang mit Duplikaten
Fügen wir dem Original Duplikate hinzu, um das Entfernen zu üben. Mit pd.concat() hängen wir df2 unter sich selbst – jede Zeile liegt damit doppelt vor.
df3 = pd.concat([df2, df2])
df3.shape(1536, 9)Alle doppelten Zeilen entfernst du mit .drop_duplicates().
df3 = df3.drop_duplicates()
df3.shape(768, 9)Spalten umbenennen
Ein häufiger Bereinigungsschritt ist das Umbenennen von Spalten. Übergebe .rename() ein columns-Dictionary von alten zu neuen Namen:
df3 = df3.rename(columns={"DiabetesPedigreeFunction": "DPF"})
df3[["Glucose", "BMI", "DPF", "Age"]].head() Glucose BMI DPF Age
1 148 33.6 0.627 50
2 85 26.6 0.351 31
3 183 23.3 0.672 32
4 89 28.1 0.167 21
5 137 43.1 2.288 33Alternativ kannst du eine vollständige Liste an .columns zuweisen. Die Liste muss alle Spalten in aktueller Reihenfolge enthalten: pandas weist Namen positionsbasiert zu, eine falsch sortierte Liste beschriftet deine Daten stillschweigend falsch.
df3.columns = ["Pregnancies", "Glucose", "BloodPressure", "SkinThickness", "Insulin", "BMI", "DPF", "Age", "Outcome"]
list(df3.columns)['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DPF', 'Age', 'Outcome']Für strukturierte Bereinigungsabläufe hilft dir diese Checkliste mit gängigen Data-Cleaning-Aufgaben.
DataFrames in pandas kombinieren
pandas kombiniert DataFrames auf zwei Arten: .merge() verbindet Tabellen über gemeinsame Schlüsselspalten wie ein SQL-Join, und pd.concat() stapelt Tabellen unter- oder nebeneinander.
DataFrames mit .merge() zusammenführen
Nutze .merge(), wenn zwei Tabellen eine Schlüsselspalte teilen. Angenommen, eine zweite Tabelle ordnet jedem Outcome-Code ein Label zu. Ein Left-Join auf Outcome fügt dieses Label in jeder Patientenzeile hinzu:
outcome_labels = pd.DataFrame({"Outcome": [0, 1], "Diagnosis": ["Non-diabetic", "Diabetic"]})
df_labeled = df.merge(outcome_labels, on="Outcome", how="left")
df_labeled[["Glucose", "Outcome", "Diagnosis"]].head(3) Glucose Outcome Diagnosis
0 148 1 Diabetic
1 85 0 Non-diabetic
2 183 1 DiabeticÜber how steuerst du den Join-Typ: "left" behält alle Zeilen aus df, "inner" nur Zeilen mit Treffern in beiden Tabellen, "outer" alle Zeilen aus beiden. Unser Tutorial zum Joinen von DataFrames behandelt .join() und alle Join-Arten im Detail.
DataFrames mit pd.concat() verketten
Nutze pd.concat(), wenn Tabellen dieselben Spalten haben und du Zeilen stapeln willst, z. B. Patientendaten in zwei Batches. Setze ignore_index=True, um einen frischen 0-basierten Index zu erhalten statt die Batch-Labels zu behalten:
batch_1 = df.iloc[:500]
batch_2 = df.iloc[500:]
df_combined = pd.concat([batch_1, batch_2], ignore_index=True)
df_combined.shape(768, 9)Mit axis=1 stellt pd.concat() Tabellen nebeneinander, abgeglichen über die Indexlabels:
measurements = df[["Glucose", "BMI"]]
outcomes = df[["Outcome"]]
pd.concat([measurements, outcomes], axis=1).head(3) Glucose BMI Outcome
0 148 33.6 1
1 85 26.6 0
2 183 23.3 1Für praktisches Üben mit beiden Methoden: Joining Data with pandas.
Datenanalyse in pandas
Die große Stärke von pandas liegt in schneller Datenanalyse. In diesem Abschnitt zeigen wir Analyse-Techniken, die du direkt anwenden kannst.
Kennzahlen (Mean, Mode, Median)
Wie zuvor gesehen, erhältst du die Mittelwerte je Spalte mit .mean().
df.mean()Pregnancies 3.845052
Glucose 120.894531
BloodPressure 69.105469
SkinThickness 20.536458
Insulin 79.799479
BMI 31.992578
DiabetesPedigreeFunction 0.471876
Age 33.240885
Outcome 0.348958
dtype: float64Den Modus berechnest du ähnlich mit .mode().
df.mode()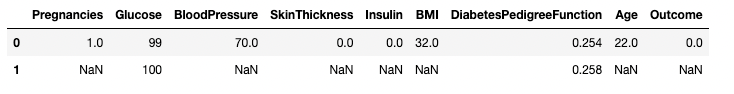
Den Modus der Spalten in pandas ausgeben
Die Mediane je Spalte bekommst du mit .median().
df.median()Pregnancies 3.0000
Glucose 117.0000
BloodPressure 72.0000
SkinThickness 23.0000
Insulin 30.5000
BMI 32.0000
DiabetesPedigreeFunction 0.3725
Age 29.0000
Outcome 0.0000
dtype: float64Neue Spalten aus bestehenden berechnen
pandas ermöglicht schnelle Berechnungen, indem du Spalten wie Skalare kombinierst. Unten teilen wir Glucose durch Insulin und erhalten die neue Spalte Glucose_Insulin_Ratio.
df2['Glucose_Insulin_Ratio'] = df2['Glucose']/df2['Insulin']
df2.head()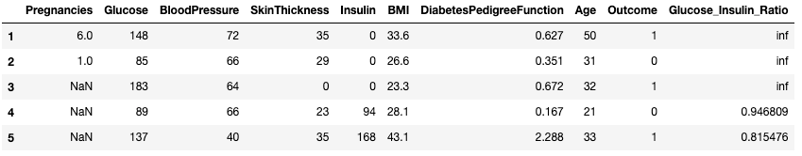
Neue Spalte aus bestehenden in pandas erstellen
Zeilen mit Insulin gleich 0 zeigen inf, weil Division durch 0 unendlich ist. In diesem Datensatz bedeutet 0 bei Insulin eine fehlende Messung (374 von 768 Zeilen). Behandle diese Nullen zuerst als fehlend, bevor du teilst:
df2["Glucose_Insulin_Ratio"] = df2["Glucose"] / df2["Insulin"].where(df2["Insulin"] > 0)
df2["Glucose_Insulin_Ratio"].head()1 NaN
2 NaN
3 NaN
4 0.946809
5 0.815476
Name: Glucose_Insulin_Ratio, dtype: float64.where() behält Werte, die die Bedingung erfüllen, und ersetzt den Rest durch NaN. So ist das Verhältnis für diese Zeilen fehlend statt unendlich. Mehr Wege zum Ableiten neuer Spalten zeigt unser Tutorial zum Hinzufügen von Spalten.
Zählen mit .value_counts()
Bei kategorischen Spalten willst du oft wissen, wie viele Beobachtungen in jede Kategorie fallen. Das erledigt .value_counts(). Hier zählen wir die Beobachtungen mit Outcome 1 (diabetisch) und 0 (nicht-diabetisch).
df['Outcome'].value_counts()Outcome
0 500
1 268
Name: count, dtype: int64Mit dem Argument normalize bekommst du Anteile statt absoluter Häufigkeiten.
df['Outcome'].value_counts(normalize=True)Outcome
0 0.651042
1 0.348958
Name: proportion, dtype: float64
Schalte die automatische Sortierung der Ergebnisse über sort aus (Standard True). Standardmäßig wird nach Häufigkeit absteigend sortiert.
df['Outcome'].value_counts(sort=False)Outcome
1 268
0 500
Name: count, dtype: int64Du kannst .value_counts() auch auf ein DataFrame und bestimmte Spalten darin anwenden. Hier nutzen wir das Argument subset mit einer Spaltenliste.
df.value_counts(subset=['Pregnancies', 'Outcome'])Pregnancies Outcome
1 0 106
2 0 84
0 0 73
3 0 48
4 0 45
0 1 38
5 0 36
6 0 34
1 1 29
3 1 27
7 1 25
4 1 23
8 1 22
5 1 21
7 0 20
2 1 19
9 1 18
6 1 16
8 0 16
10 0 14
1 10
9 0 10
11 1 7
13 0 5
1 5
12 0 5
11 0 4
12 1 4
14 1 2
15 1 1
17 1 1
Name: count, dtype: int64Daten mit .groupby() aggregieren
Mit .groupby() fasst du Werte anhand bestimmter Spalten zusammen und kombinierst das mit einer Kennzahlenfunktion. Unten berechnen wir die Mittelwerte numerischer Spalten gruppiert nach Outcome.
df.groupby('Outcome').mean()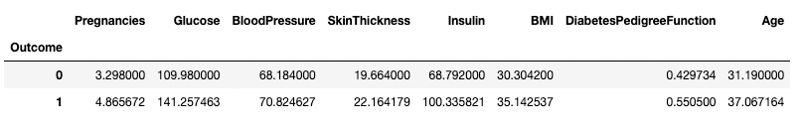
Daten nach einer Spalte in pandas aggregieren
.groupby() erlaubt auch Gruppierungen über mehrere Spalten, indem du eine Liste übergibst:
df.groupby(['Pregnancies', 'Outcome']).mean()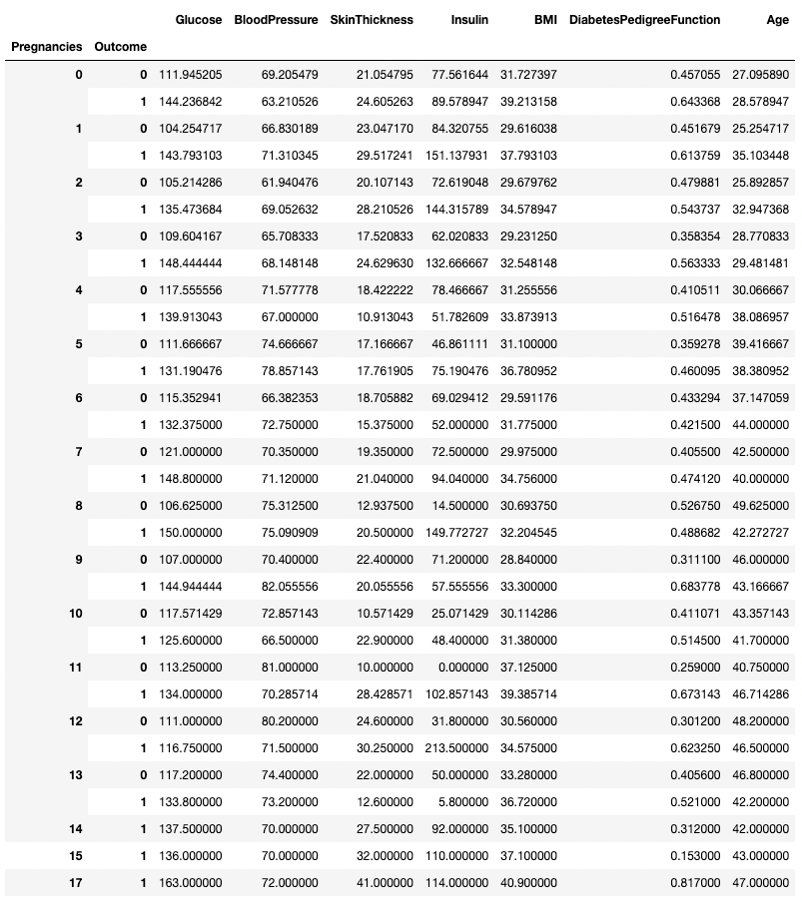
Daten nach zwei Spalten in pandas aggregieren
Du kannst jede Kennzahlenmethode mit .groupby() kombinieren, z. B. .min(), .max(), .mean(), .median(), .sum() und mehr. Unser GroupBy-Tutorial zeigt Mehrfachaggregationen mit .agg() und weitere Muster.
Pivot-Tabellen
pandas kann Kennzahlen auch als Pivot-Tabellen berechnen. Damit ziehst du Schlüsse aus Kombinationen von Variablen. Unten wählen wir Zeilen als eindeutige Werte von Pregnancies, Spalten als eindeutige Werte von Outcome und Zellen als durchschnittlichen BMI in der jeweiligen Gruppe.
Beispiel: Für Pregnancies = 5 und Outcome = 0 beträgt der durchschnittliche BMI 31,1.
pd.pivot_table(df, values="BMI", index='Pregnancies',
columns=['Outcome'], aggfunc='mean')Outcome 0 1
Pregnancies
0 31.727397 39.213158
1 29.616038 37.793103
2 29.679762 34.578947
3 29.231250 32.548148
4 31.255556 33.873913
5 31.100000 36.780952
6 29.591176 31.775000
7 29.975000 34.756000
8 30.693750 32.204545
9 28.840000 33.300000
10 30.114286 31.380000
11 37.125000 39.385714
12 30.560000 34.575000
13 33.280000 36.720000
14 NaN 35.100000
15 NaN 37.100000
17 NaN 40.900000Datenvisualisierung in pandas
pandas bietet bequeme Wrapper für Matplotlib, damit du DataFrames schnell visualisieren kannst. Unten siehst du gängige Visualisierungen mit pandas.
Liniendiagramme in pandas
Mit Liniendiagrammen stellst du Beziehungen zwischen Variablen dar. Unten siehst du ein Liniendiagramm von BMI und Glucose über dem Zeilenindex.
df[['BMI', 'Glucose']].plot.line()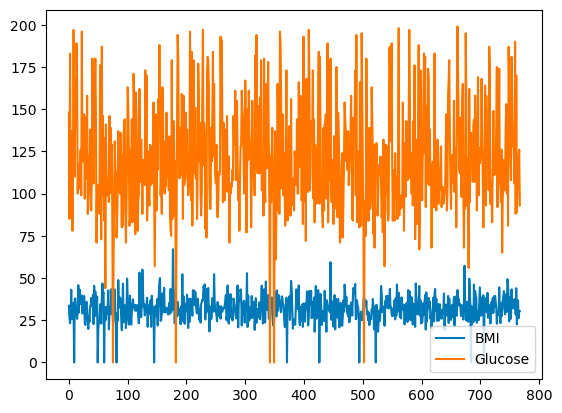
Einfaches Liniendiagramm mit pandas
Über das Argument color legst du die Farben fest.
df[['BMI', 'Glucose']].plot.line(color={"BMI": "red", "Glucose": "blue"})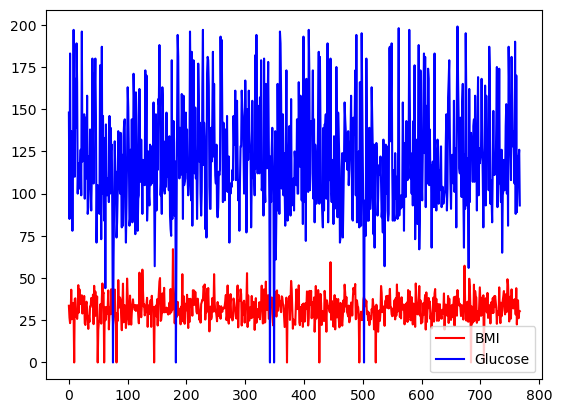
Einfaches Liniendiagramm mit pandas – mit eigenen Farben
Alle Spalten von df kannst du mit subplots auf separaten Skalen und Achsen plotten.
df.plot.line(subplots=True)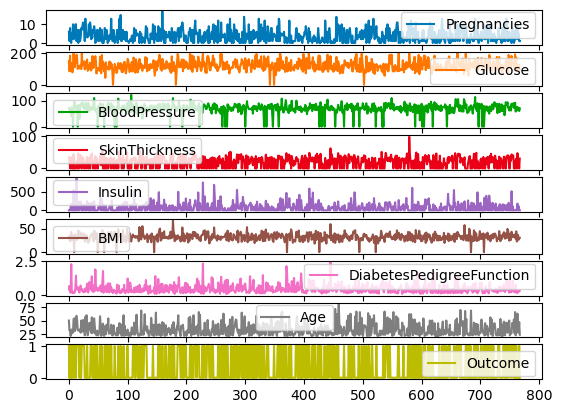
Subplots für Liniendiagramme mit pandas
Balkendiagramme in pandas
Für diskrete Spalten kannst du die Verteilung per Balkendiagramm der Kategorien zählen. Unten visualisieren wir die binäre Variable Outcome.
df['Outcome'].value_counts().plot.bar()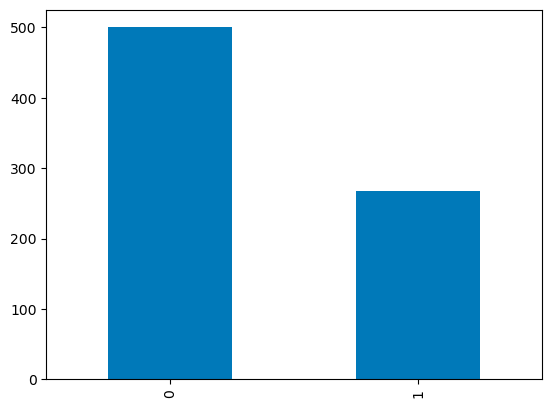
Balkendiagramme in pandas
Boxplots in pandas
Die Quartilsverteilung kontinuierlicher Variablen visualisierst du mit Boxplots. Der folgende Code erzeugt einen Boxplot in pandas.
df.boxplot(column=['BMI'], by='Outcome')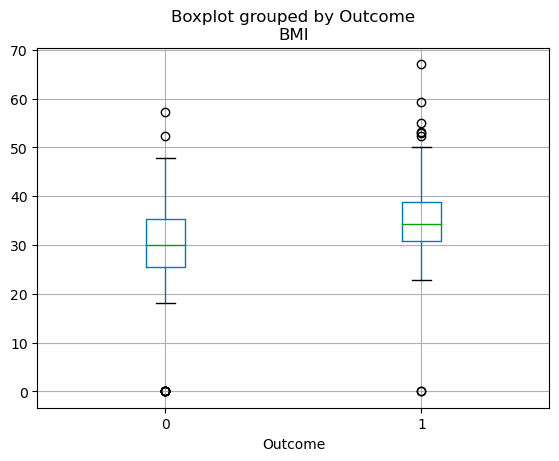
Boxplots in pandas
Fazit
Du beherrschst jetzt den zentralen pandas-Workflow: Datei in ein DataFrame einlesen, mit .head(), .info() und .describe() inspizieren, Zeilen mit .loc[] und .iloc[] auswählen, fehlende Werte und Duplikate bereinigen, Tabellen mergen und mit .groupby() sowie Pivot-Tabellen zusammenfassen.
Wenn du pandas vor 2026 gelernt hast, lohnt sich eine Gewohnheitsänderung: Ergebnisse neu zuweisen statt inplace=True, und jede Aktualisierung in einer einzigen .loc[]-Anweisung vornehmen. Am schnellsten verinnerlichst du den Rest, wenn du den Workflow an einem Datensatz übst, der dir wichtig ist. Diese Ressourcen helfen dir weiter:
- [Cheat Sheets] Viele Python- und pandas-Cheat-Sheets als Nachschlagewerk
- [Live-Trainings] Unsere kostenlosen Live-Code-Alongs – viele davon mit pandas
- [Kurse] Data Manipulation with pandas und Joining Data with pandas für interaktives Üben
- [Interview-Vorbereitung] Unsere Top-pandas-Interviewfragen, um dein Wissen zu testen
- [Weitere Tutorials] Entdecke mehr zu pandas und dem PyData-Ökosystem, z. B. Gleitende Durchschnitte in pandas und die pandas-Methode .apply()
pandas FAQs
What is pandas in Python?
pandas ist eine Open-Source-Python-Bibliothek für tabellarische Daten. Die beiden Kernstrukturen – DataFrame (Tabelle) und Series (einzelne Spalte) – bringen Funktionen zum Importieren, Bereinigen, Umformen, Aggregieren und Plotten mit. Deshalb ist pandas das Standardwerkzeug für Datenanalyse in Python.
Why should I learn pandas?
Wenn du in Python mit Daten arbeitest, führt an pandas kaum ein Weg vorbei. Es vereinfacht das Handling und die Analyse, damit du dich auf Erkenntnisse und Wertschöpfung konzentrieren kannst. Ob kleine Datensätze oder große Datenmengen: pandas macht dir mit Tempo, Flexibilität und intuitiven Strukturen das Leben leichter.
How do I install pandas?
Führe pip install pandas im Terminal aus oder conda install pandas, wenn du conda verwendest. pandas 3 benötigt Python 3.11 oder neuer. Anaconda bringt pandas standardmäßig mit, und in DataCamps DataLab ist es vorinstalliert.
What are the basic data structures in pandas?
Die beiden wichtigsten Datenstrukturen in pandas sind Series und DataFrame. Eine Series entspricht im Wesentlichen einer Spalte, ein DataFrame ist eine mehrdimensionale Tabelle aus mehreren Series. Beide sind flexibel und können unterschiedliche Datentypen enthalten (z. B. Integer, String, Float).
Is pandas good for large datasets?
pandas kommt mit Millionen Zeilen gut zurecht – solange die Daten in den Arbeitsspeicher passen. Wenn nicht, lies sie mit dem Argument chunksize in Batches ein oder wechsle zu einem Tool für größere Daten wie Polars, Dask oder PySpark.
How do I import data into pandas?
pandas kann Daten aus CSV, Excel, SQL-Datenbanken, JSON und vielen weiteren Formaten lesen. Die Befehle pd.read_csv(), pd.read_excel(), pd.read_sql() und pd.read_json() importieren aus den jeweiligen Quellen. Alle geben ein DataFrame zurück, das du mit pandas weiterverarbeiten kannst.
What changed in pandas 3.0?
pandas 3.0 (Januar 2026) hat Copy-on-Write als Standard eingeführt, sodass jede Teilmenge wie eine Kopie behandelt wird und verkettete Zuweisungen wie df["col"][0] = x das Original nicht mehr ändern. Außerdem werden Textspalten nun als eigener Datentyp str statt object erkannt. Erforderlich ist Python 3.11 oder neuer. pandas 3.1 hat dann inplace=True u. a. bei dropna() und sort_values() veraltet.
What is the difference between loc and iloc in pandas?
.loc[] wählt Zeilen und Spalten nach Label, .iloc[] nach ganzzahliger Position ab 0. Auch Slices unterscheiden sich: .loc[100:110] schließt das Endlabel ein, .iloc[100:110] stoppt vor Position 110. Mehr Beispiele findest du in unserem loc-vs.-iloc-Guide.
How do I merge two DataFrames in pandas?
Nutze df1.merge(df2, on="key", how="left"), um zwei DataFrames über eine gemeinsame Spalte wie in SQL zu verbinden. Mit how wählst du den Join-Typ ("left", "right", "inner" oder "outer"). Zum Stapeln von DataFrames verwendest du pd.concat().

Ich bin KI-Stratege und Ethiker und arbeite an der Schnittstelle von Datenwissenschaft, Produkt und Technik, um skalierbare maschinelle Lernsysteme zu entwickeln. Als einer der "Top 200 Business and Technology Innovators" der Welt bin ich auf der Mission, das maschinelle Lernen zu demokratisieren und den Fachjargon zu überwinden, damit jeder an diesem Wandel teilhaben kann.


pandas ist das Standard-Python-Paket für Datenanalyse – mit über 500 Millionen Downloads im Monat auf PyPI. Es liest und schreibt CSV, Excel, JSON, SQL und viele weitere Formate und deckt mit seinen Funktionen die typische Arbeit an tabellarischen Daten ab: bereinigen, umformen, aggregieren und visualisieren.
In diesem pandas-Tutorial gehen wir den kompletten Workflow anhand eines realen Datensatzes durch: pandas installieren, Daten importieren und exportieren, ein DataFrame inspizieren, Zeilen auswählen und filtern, fehlende Werte und Duplikate bereinigen, Tabellen kombinieren, aggregieren und plotten. Jedes Beispiel läuft auf pandas 3.1, der aktuellen Version, und wir markieren die Änderungen in pandas 3, die älteren Tutorial-Code brechen.
Du brauchst grundlegende Python-Kenntnisse, aber keine Vorerfahrung mit pandas. Für einen längeren Lernplan sieh dir unseren Beitrag How to learn pandas an. Für interaktives Üben empfehlen wir den Kurs Data Manipulation with pandas.
TL;DR
pip install pandas; pandas 3 benötigt Python 3.11 oder neuer..loc[]wählt nach Label,.iloc[]nach Position..loc[]-Anweisung.df = df.dropna()) statt das veralteteinplace=Truezu verwenden.Was ist pandas?
pandas ist ein Python-Paket zur Datenmanipulation für tabellarische Daten – also Daten in Zeilen und Spalten, bekannt als DataFrames. Anschaulich kannst du dir ein DataFrame wie ein Excel-Blatt vorstellen.
Die Funktionen von pandas reichen von Transformationen wie Zeilen sortieren und Teilmengen ziehen, über Kennzahlen wie Mittelwerte bis hin zum Umformen und Zusammenführen von DataFrames. pandas spielt gut mit dem PyData-Ökosystem zusammen, darunter
Wofür wird pandas verwendet?
pandas begleitet den gesamten Datenanalyse-Workflow. Mit pandas kannst du:
pandas bietet außerdem Funktionen für Zeitreihenanalyse und Textdaten.
Die wichtigsten Vorteile von pandas
pandas bietet fünf handfeste Vorteile für den Alltag mit Daten:
So installierst du pandas
Bevor du pandas verwendest, musst du es installieren. Du kannst diesen Schritt überspringen, wenn du dich kostenlos bei DataCamp registrierst und DataLab nutzt – eine Cloud-IDE, die pandas (neben den wichtigsten Python-Data-Science-Paketen) bereits mitbringt.