Kurs
Importing und Verwalten finanzieller Daten in R
5 Std.
21K
Du bist Data Scientist (oder auf dem Weg dorthin) und hast einen Kunden, der ein Einzelhandelsgeschäft betreibt. Dein Kunde gibt dir Transaktionsdaten: Artikel, die im Zeitverlauf von verschiedenen Kundinnen und Kunden gekauft wurden. Er bittet dich, diese Daten zu nutzen, um sein Geschäft zu pushen. Deine Ergebnisse fließen nicht nur in das Ändern/Aktualisieren/Erweitern des Sortiments ein, sondern auch in die Gestaltung des Ladenlayouts oder des Onlineshops. Um aussagekräftige Ergebnisse zu liefern, nutzt du die Market Basket Analysis (MBA), die Assoziationsregel-Mining auf den Transaktionsdaten anwendet.
In diesem Tutorial lernst du:
Assoziationsregel-Mining kommt zum Einsatz, wenn du Zusammenhänge zwischen Objekten in einer Menge finden willst, etwa häufige Muster in einer Transaktionsdatenbank, relationalen Datenbanken oder anderen Informationsspeichern. Typische Anwendungen sind Marketing, Warenkorbanalyse (Market Basket Analysis) im Handel, Clustering und Klassifikation. Durch das Generieren von Assoziationsregeln zeigt dir das Verfahren, welche Artikel Kundinnen und Kunden häufig zusammen kaufen. Vereinfacht gesagt liefert es Regeln der Form wenn dies, dann das. Unternehmen nutzen diese Regeln für zahlreiche Marketingstrategien:
Betrachte das folgende Beispiel:
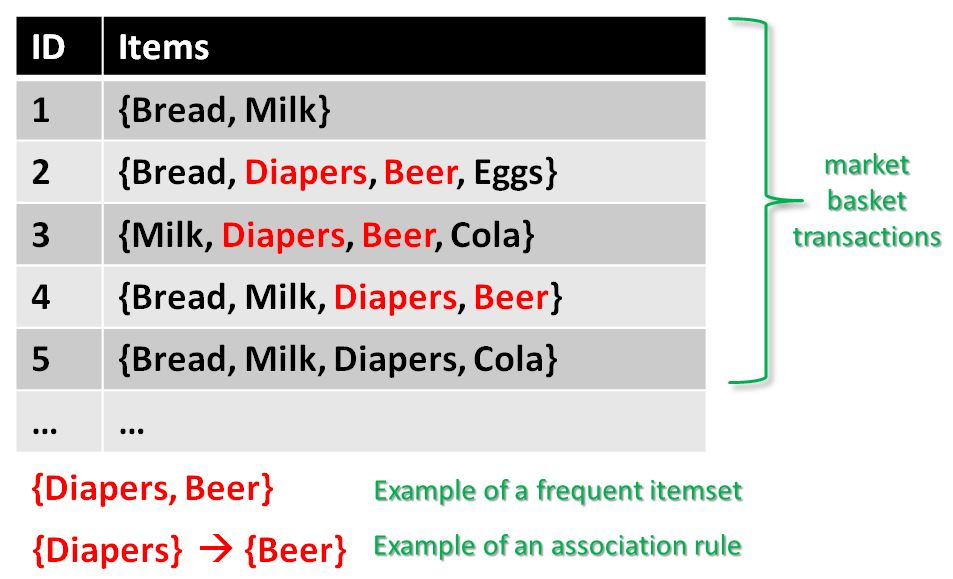
Gegeben ist ein Satz von Transaktionsdaten. Du siehst Transaktionen mit den Nummern 1 bis 5. Jede Transaktion zeigt die darin gekauften Artikel. Du erkennst, dass Windeln zusammen mit Bier in drei Transaktionen gekauft werden. Ähnlich wird Brot zusammen mit Milch in drei Transaktionen gekauft, was beide zu häufigen Itemsets macht. Assoziationsregeln werden wie folgt notiert:
$A=>B[Support,Confidence]$
Der Teil vor $=>$ ist das wenn (Antezedens), der Teil nach $=>$ das dann (Konsequens).
Wobei A und B Mengen von Artikeln in den Transaktionsdaten sind. A und B sind disjunkt.
$Computer=>Anti-virus Software[Support=20\%,confidence=60\%]$
Die obige Regel bedeutet:
Im nächsten Abschnitt lernst du die Grundbegriffe des Assoziationsregel-Minings kennen:
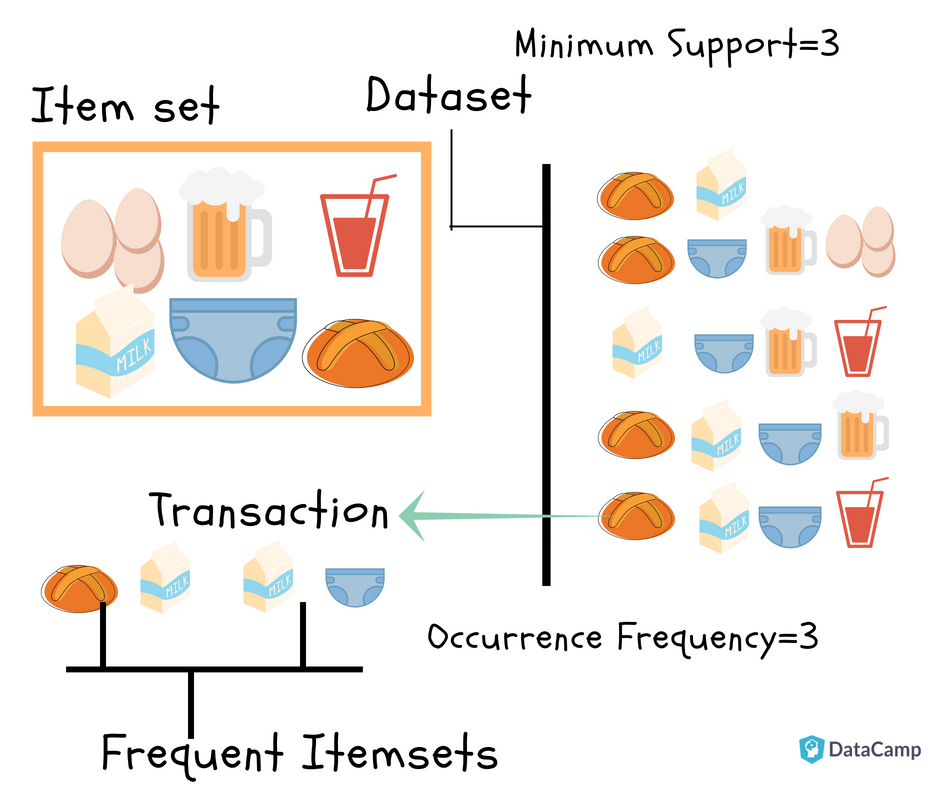
Itemset: Sammlung aus einem oder mehreren Items. K-Itemset bezeichnet eine Menge mit k Items.
Support Count: Häufigkeit des Auftretens eines Itemsets.
Support (s): Anteil der Transaktionen, die das Itemset „X“ enthalten.
$Support(X)=\frac{frequency(X)}{N}$
Für eine Regel A=>B gilt für den Support:
$Support(A=>B)=\frac{frequency(A,B)}{N}$
Hinweis: P(A∪B) ist die Wahrscheinlichkeit, dass A und B gemeinsam auftreten. P bezeichnet die Wahrscheinlichkeit.
Probiere als Übung, den Support für Milch=>Windeln zu berechnen.
$Confidence(A=>B)=\frac{P(A\cap B)}{P(A)}=\frac{frequency(A,B)}{frequency(A)}$
Also die Anzahl der Transaktionen mit A und B geteilt durch die Gesamtzahl der Transaktionen mit A.
$Confidence(Bread=>Milk)=\frac{3}{4}=0.75=75\%$
Berechne nun die Confidence für Milch=>Windeln.
Hinweis: Support und Confidence messen, wie interessant eine Regel ist. Sie werden über minimale Schwellwerte min_support und min_confidence festgelegt. Diese vom Kunden definierten Schwellen erlauben, die Stärke der Regeln im gewünschten Kontext zu bewerten. Je näher an (oder über) der Schwelle, desto nützlicher ist die Regel für den Kunden.
Frequent Itemsets: Itemsets, deren Support größer oder gleich dem minimalen Support (min_sup) ist. Im obigen Beispiel ist min_sup=3. Dieser Wert wird vom Nutzer festgelegt.
Starke Regeln: Eine Regel A=>B[Support, Confidence] ist stark, wenn sie min_sup und min_confidence erfüllt.
Lift: Der Lift gibt die Korrelation zwischen A und B in der Regel A=>B an. Er zeigt, wie sich das Itemset A auf das Itemset B auswirkt.
$Lift(A=>B)=\frac{Support}{Supp(A)Supp(B)}$
Für die Regel {Bread}=>{Milk} ergibt sich der Lift wie folgt:
$support(Bread)=\frac{4}{5}=0.8$
$support(Milk)=\frac{4}{5}=0.8$
$Lift(Bread=>Milk)=\frac{0.6}{0.8*0.8}=0.9$
Hat die Regel einen Lift von 1, sind A und B unabhängig und es lässt sich keine nützliche Regel ableiten.
Ist der Lift > 1, hängen A und B voneinander ab; der Grad der Abhängigkeit zeigt sich im Lift-Wert.
Ist der Lift < 1, wirkt sich das Vorhandensein von A negativ auf B aus.
Wendest du Assoziationsregel-Mining auf einen gegebenen Transaktionssatz T an, möchtest du alle Regeln finden mit:
In diesem Teil des Tutorials lernst du den Algorithmus kennen, der in R-Bibliotheken für die Marktkorbanalyse zum Einsatz kommt. Das hilft dir, deine Kundschaft besser zu verstehen und Analysen gezielter durchzuführen. Wenn du den APRIORI-Algorithmus bereits kennst, spring direkt zum Coding-Teil.
Assoziationsregel-Mining besteht aus zwei Schritten:
Generierung häufiger Itemsets: Finde alle häufigen Itemsets mit Support >= vorgegebenem min_support.
Regelerzeugung: Liste alle Assoziationsregeln aus den häufigen Itemsets auf. Berechne Support und Confidence für alle Regeln. Schneide Regeln weg, die min_support und min_confidence nicht erfüllen.
Die Generierung häufiger Itemsets ist der rechenintensivste Schritt, da dafür die gesamte Datenbank gescannt werden muss.
Im obigen Beispiel siehst du nur 5 Transaktionen. In der Praxis können Handelsdaten jedoch bis in den GB- oder TB-Bereich gehen. Dafür braucht es einen optimierten Algorithmus, der Itemsets frühzeitig aussondert, die später nicht helfen. Hier kommt der APRIORI-Algorithmus ins Spiel. Er besagt:
Jede Teilmenge eines häufigen Itemsets muss ebenfalls häufig sein. Anders ausgedrückt: Kein Superset eines seltenen Itemsets darf erzeugt oder getestet werden.
Das wird im Itemset-Gitter (Itemset Lattice) dargestellt, einer grafischen Repräsentation des Apriori-Prinzips. Es besteht aus Knoten für k-Itemsets und deren Teilmengenbeziehungen.
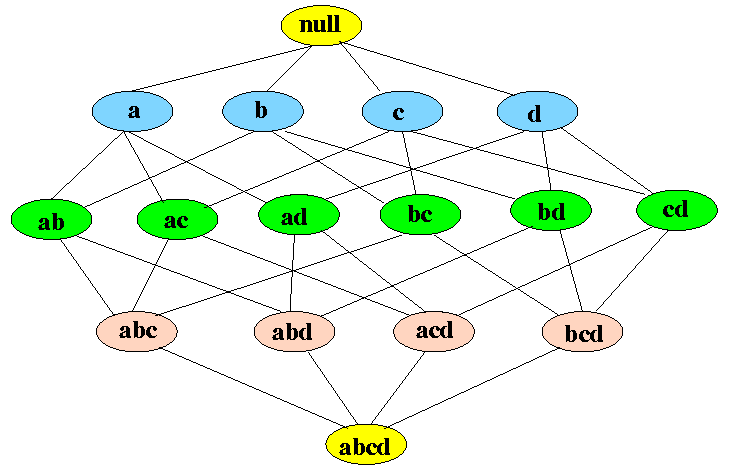
Du siehst oben: Am unteren Rand stehen alle Items der Transaktionsdaten, von dort gehst du nach oben und bildest Teilmengen bis zur leeren Menge. Bei d Items hat das Gitter die Größe $2^d$. Das zeigt, wie aufwendig es wäre, für jede Kombination den Support zu berechnen. Die folgende Abbildung zeigt, wie stark APRIORI die Zahl der zu erzeugenden Mengen reduziert:
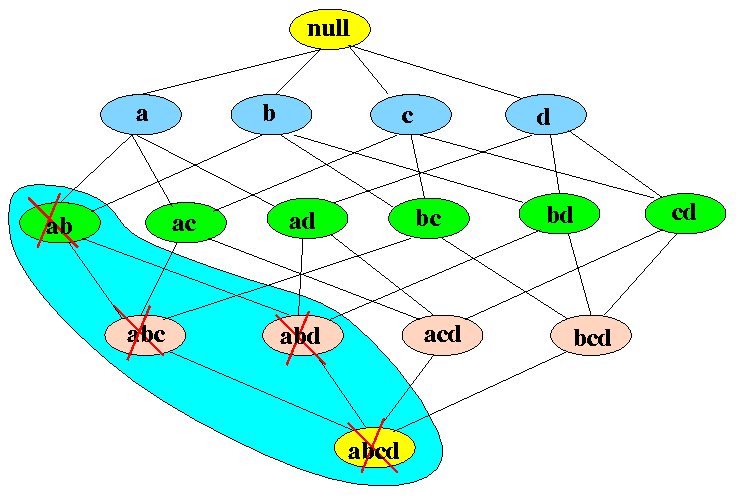
Ist das Itemset {a,b} nicht häufig, müssen all seine Supersets nicht betrachtet werden.
Verstehen wir das an einem Beispiel. Im Folgenden siehst du, warum APRIORI so effektiv ist und wie Schritt für Schritt starke Assoziationsregeln entstehen. Schnapp dir Block und Stift und mach mit!
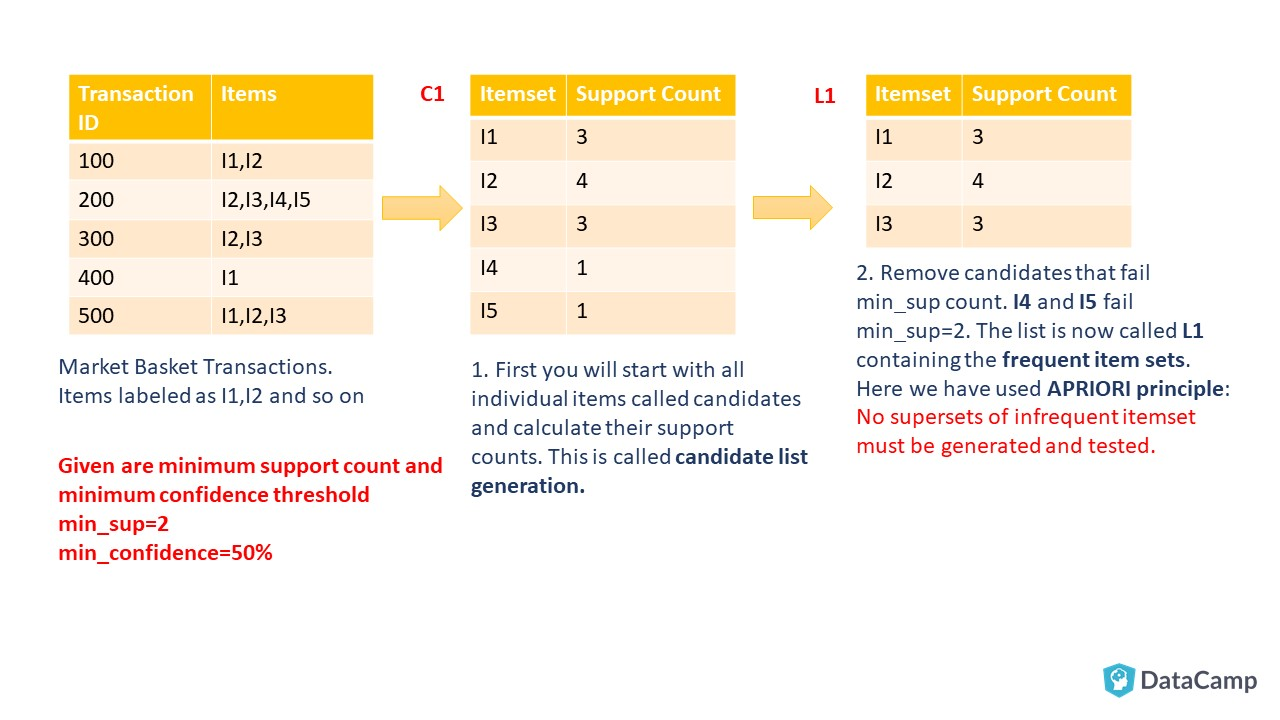
Wie du siehst, startest du mit einer Kandidatenliste für 1-Itemsets, die alle in den Transaktionsdaten vorkommenden Items einzeln umfasst. Bei echten Retail-Daten erkennst du, wie teuer diese Kandidatenerzeugung ist. APRIORI reduziert hier die Kandidatenzahl deutlich, und am Ende entstehen nützliche Regeln. In den folgenden Schritten siehst du, wie wir das Ende der Generierung häufiger Itemsets erreichen – also Schritt 1 des Assoziationsregel-Minings.
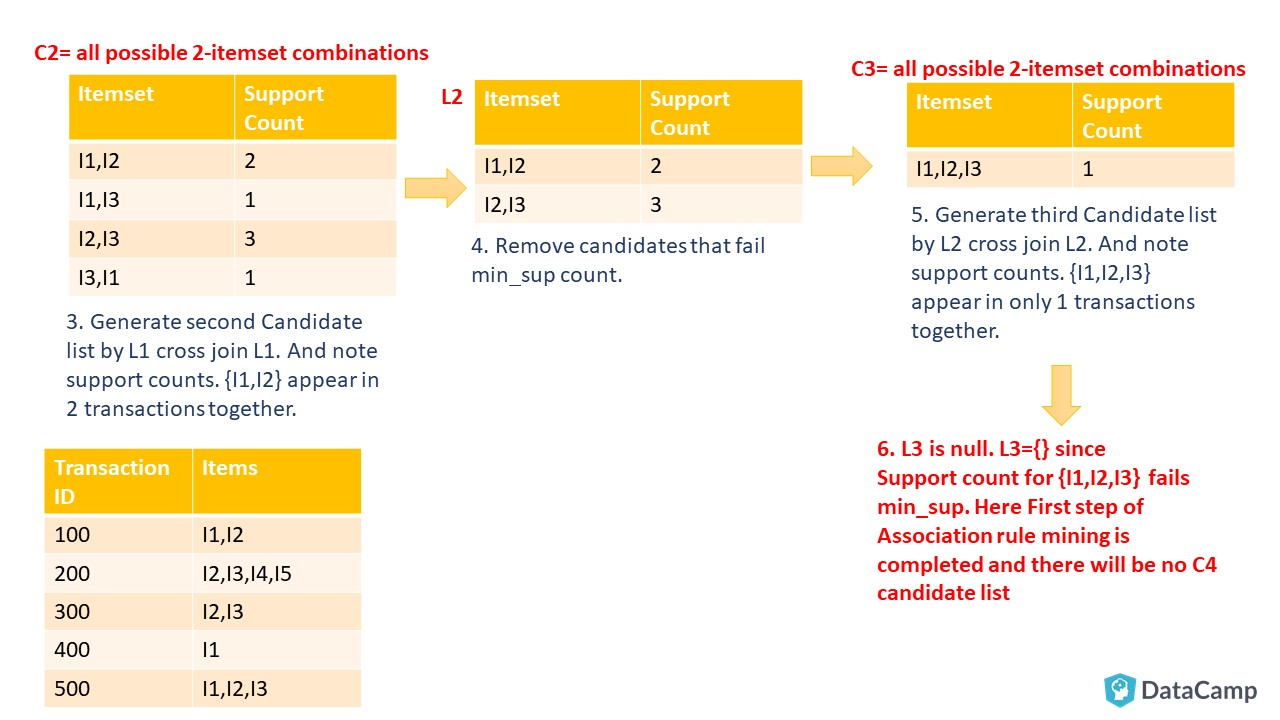
Als Nächstes listest du alle häufigen Itemsets auf. Du nimmst das letzte nichtleere häufige Itemset – in diesem Beispiel ist das L2={I1, I2},{I2, I3}. Dann bildest du alle nichtleeren Teilmengen der in dieser Liste enthaltenen Itemsets. Folge der Illustration unten:
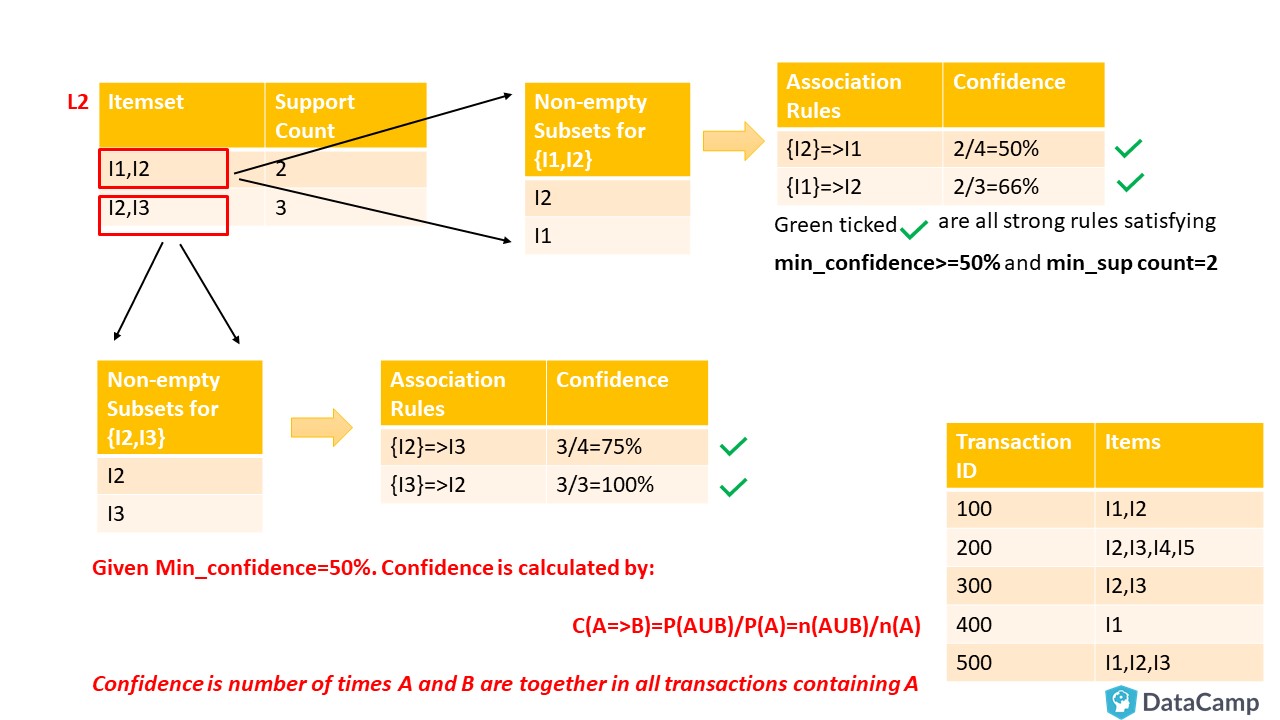
Oben siehst du vier starke Regeln. Zum Beispiel besagt ${I2}=>I3$ mit einer Confidence von 75%, dass 75% der Personen, die I2 gekauft haben, auch I3 gekauft haben.
Du hast nun den APRIORI-Algorithmus vollständig kennengelernt – einen der meistgenutzten Algorithmen im Data Mining. Weiter geht’s mit dem Code, puh!
In diesem Tutorial verwendest du ein Dataset aus dem UCI Machine Learning Repository. Das Dataset heißt Online-Retail und du kannst es hier herunterladen. Es enthält Transaktionsdaten vom 01.12.2010 bis 09.12.2011 für einen im Vereinigten Königreich registrierten Onlinehändler ohne stationäres Geschäft. Wir nutzen dieses Dataset statt eines R-Beispieldatensatzes, weil du in der Praxis eher Daten in dieser Form erhältst und erst eine Datenvorverarbeitung nötig ist.
Als Erstes lädst du die benötigten Bibliotheken. Eine kurze Beschreibung (aus Here) findest du in der folgenden Tabelle, damit du weißt, wofür jedes Paket da ist:
| Package | Description |
|---|---|
arules |
Stellt Infrastruktur zum Repräsentieren, Bearbeiten und Analysieren von Transaktionsdaten und Mustern (häufige Itemsets und Assoziationsregeln) bereit. |
arulesViz |
Erweitert das Paket „arules“ um verschiedene Visualisierungstechniken für Assoziationsregeln und Itemsets. Enthält außerdem interaktive Visualisierungen für die Regel-Exploration. |
tidyverse |
Der Tidyverse ist eine kuratierte Sammlung von R-Paketen für Data Science. |
readxl |
Excel-Dateien in R einlesen. |
plyr |
Werkzeuge zum Aufteilen, Anwenden und Zusammenführen von Daten. |
ggplot2 |
Grafiken und Diagramme erstellen. |
knitr |
Dynamische Berichtserstellung in R. |
lubridate |
Erleichtert die Arbeit mit Datums- und Zeitangaben in R. |
#install and load package arules
#install.packages("arules")
library(arules)
#install and load arulesViz
#install.packages("arulesViz")
library(arulesViz)
#install and load tidyverse
#install.packages("tidyverse")
library(tidyverse)
#install and load readxml
#install.packages("readxml")
library(readxl)
#install and load knitr
#install.packages("knitr")
library(knitr)
#load ggplot2 as it comes in tidyverse
library(ggplot2)
#install and load lubridate
#install.packages("lubridate")
library(lubridate)
#install and load plyr
#install.packages("plyr")
library(plyr)
library(dplyr)Nutze read_excel(path to file), um das heruntergeladene Dataset in R einzulesen. Gib den vollständigen Pfad inklusive Dateiname in read_excel(path-to-file-with-filename) an.
#read excel into R dataframe
retail <- read_excel('D:/Documents/Online_Retail.xlsx')
#complete.cases(data) will return a logical vector indicating which rows have no missing values. Then use the vector to get only rows that are complete using retail[,].
retail <- retail[complete.cases(retail), ]
#mutate function is from dplyr package. It is used to edit or add new columns to dataframe. Here Description column is being converted to factor column. as.factor converts column to factor column. %>% is an operator with which you may pipe values to another function or expression
retail %>% mutate(Description = as.factor(Description))
retail %>% mutate(Country = as.factor(Country))#Converts character data to date. Store InvoiceDate as date in new variable
retail$Date <- as.Date(retail$InvoiceDate)
#Extract time from InvoiceDate and store in another variable
TransTime<- format(retail$InvoiceDate,"%H:%M:%S")
#Convert and edit InvoiceNo into numeric
InvoiceNo <- as.numeric(as.character(retail$InvoiceNo))NAs introduced by coercion#Bind new columns TransTime and InvoiceNo into dataframe retail
cbind(retail,TransTime)cbind(retail,InvoiceNo)#get a glimpse of your data
glimpse(retail)Observations: 406,829
Variables: 9
$ InvoiceNo <chr> "536365", "536365", "536365", "536365", "536365", "536365", "53...
$ StockCode <chr> "85123A", "71053", "84406B", "84029G", "84029E", "22752", "2173...
$ Description <chr> "WHITE HANGING HEART T-LIGHT HOLDER", "WHITE METAL LANTERN", "C...
$ Quantity <dbl> 6, 6, 8, 6, 6, 2, 6, 6, 6, 32, 6, 6, 8, 6, 6, 3, 2, 3, 3, 4, 4,...
$ InvoiceDate <dttm> 2010-12-01 08:26:00, 2010-12-01 08:26:00, 2010-12-01 08:26:00,...
$ UnitPrice <dbl> 2.55, 3.39, 2.75, 3.39, 3.39, 7.65, 4.25, 1.85, 1.85, 1.69, 2.1...
$ CustomerID <dbl> 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, ...
$ Country <chr> "United Kingdom", "United Kingdom", "United Kingdom", "United K...
$ Date <date> 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 20...Nun enthält der Dataframe retail 10 Attribute, mit zwei zusätzlichen Attributen Date und Time.
Bevor wir MBA/Assoziationsregel-Mining anwenden, müssen wir den Dataframe in Transaktionsdaten umwandeln, sodass alle gemeinsam in einer Rechnung gekauften Items in einer Zeile stehen. Im glimpse-Output siehst du, dass jede Transaktion in atomarer Form vorliegt, d. h. alle Produkte zu einer Rechnung sind wie in relationalen Datenbanken atomar gespeichert. Dieses Format wird auch Singles-Format genannt.
Du musst die Daten im retail-Dataframe gruppieren – entweder nach CustomerID, CustomerID und Date oder auch nach InvoiceNo und Date. Diese Gruppierung benötigen wir, um eine Funktion darauf anzuwenden und das Ergebnis in einem neuen Dataframe zu speichern. Das geht mit ddply.
Die folgenden Codezeilen fassen alle Produkte einer Kombination aus InvoiceNo und Date zusammen und speichern sie als eine Zeile, in der die Items mit , getrennt sind.
library(plyr)
#ddply(dataframe, variables_to_be_used_to_split_data_frame, function_to_be_applied)
transactionData <- ddply(retail,c("InvoiceNo","Date"),
                       function(df1)paste(df1$Description,
                       collapse = ","))
#The R function paste() concatenates vectors to character and separated results using collapse=[any optional charcater string ]. Here ',' is usedtransactionDataDa InvoiceNo und Date für das Regel-Mining nicht benötigt werden, setzt du sie auf NULL.
#set column InvoiceNo of dataframe transactionData
transactionData$InvoiceNo <- NULL
#set column Date of dataframe transactionData
transactionData$Date <- NULL
#Rename column to items
colnames(transactionData) <- c("items")
#Show Dataframe transactionData
transactionDataDieses Transaktionsformat nennt man Basket-Format. Als Nächstes speicherst du diese Transaktionsdaten in eine .csv-Datei (Comma Separated Values). Dafür nutzt du write.csv().
write.csv(transactionData,"D:/Documents/market_basket_transactions.csv", quote = FALSE, row.names = FALSE)
#transactionData: Data to be written
#"D:/Documents/market_basket.csv": location of file with file name to be written to
#quote: If TRUE it will surround character or factor column with double quotes. If FALSE nothing will be quoted
#row.names: either a logical value indicating whether the row names of x are to be written along with x, or a character vector of row names to be written.
Prüfe, ob deine Transaktionsdaten korrekt formatiert sind:
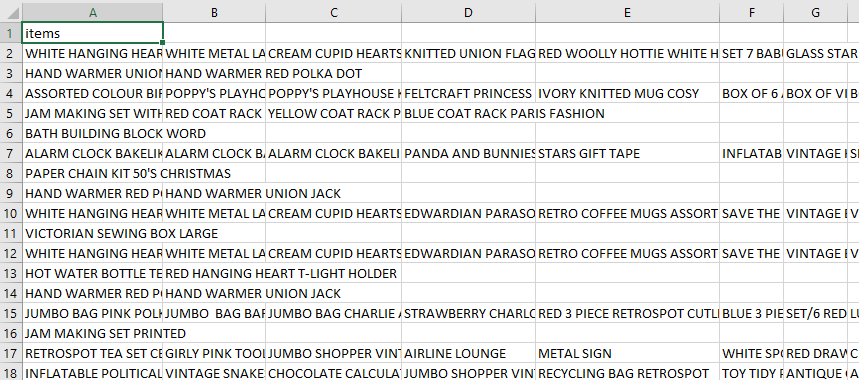
Nun lädst du diese Transaktionsdaten in ein Objekt der Klasse transactions. Das erledigt die R-Funktion read.transactions aus dem Paket arules.
Die folgende Codezeile liest die Datei D:/Documents/market_basket_transactions.csv im Basket-Format ein und wandelt sie in ein Objekt der Klasse transactions um.
tr <- read.transactions('D:/Documents/market_basket_transactions.csv', format = 'basket', sep=',')
#sep tell how items are separated. In this case you have separated using ','
Wenn du den obigen Code ausführst, siehst du eventuell viele Meldungen wie EOF within quoted string. Keine Sorge.
Wenn du Transaktionsdaten bereits in einem Dataframe hast, kannst du sie so in ein transactions-Objekt umwandeln:
`trObj<-as(dataframe.dat,"transactions")`Zeige das Transaktionsobjekt tr an:
tr
transactions in sparse format with
 22191 transactions (rows) and
30066 items (columns) summary(tr)transactions in sparse format with
22191 transactions (rows) and
7876 items (columns)
transactions as itemMatrix in sparse format with
22191 rows (elements/itemsets/transactions) and
7876 columns (items) and a density of 0.001930725
most frequent items:
WHITE HANGING HEART T-LIGHT HOLDER REGENCY CAKESTAND 3 TIER
1803 1709
JUMBO BAG RED RETROSPOT PARTY BUNTING
1460 1285
ASSORTED COLOUR BIRD ORNAMENT (Other)
1250 329938
element (itemset/transaction) length distribution:
sizes
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
3598 1594 1141 908 861 758 696 676 663 593 624 537 516 531 551 522 464
18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34
441 483 419 395 315 306 272 238 253 229 213 222 215 170 159 138 142
35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51
134 109 111 90 113 94 93 87 88 65 63 67 63 60 59 49 64
52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68
40 41 49 43 36 29 39 30 27 28 17 25 25 20 27 24 22
69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85
15 20 19 13 16 16 11 15 12 7 9 14 15 12 8 9 11
86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102
11 14 8 6 5 6 11 6 4 4 3 6 5 2 4 2 4
103 104 105 106 107 108 109 110 111 112 113 114 116 117 118 120 121
4 3 2 2 6 3 4 3 2 1 3 1 3 3 3 1 2
122 123 125 126 127 131 132 133 134 140 141 142 143 145 146 147 150
2 1 3 2 2 1 1 2 1 1 2 2 1 1 2 1 1
154 157 168 171 177 178 180 202 204 228 236 249 250 285 320 400 419
3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1
Min. 1st Qu. Median Mean 3rd Qu. Max.
1.00 3.00 10.00 15.21 21.00 419.00
includes extended item information - examples:
labels
1 1 HANGER
2 10 COLOUR SPACEBOY PEN
3 12 COLOURED PARTY BALLOONSsummary(tr) ist sehr hilfreich und liefert Infos zu unserem Transaktionsobjekt. Was sagt der Output oben?
Es gibt 22191 Transaktionen (Zeilen) und 7876 Items (Spalten). Beachte: 7876 sind die Produktbeschreibungen im Dataset und 22191 Transaktionen sind Kombinationen daraus.
Dichte (Density) gibt den Anteil nicht-nuller Zellen in der Sparse-Matrix an. Du kannst es auch als Anzahl gekaufter Items geteilt durch die möglichen Items in der Matrix verstehen. Über die Dichte lässt sich die Anzahl gekaufter Items schätzen: 22191x7876x0.001930725=337445
Info! Sparse-Matrix: Eine Sparse-Matrix ist eine Matrix, in der die meisten Elemente null sind. Sind die meisten Elemente ungleich null, spricht man von einer dichten Matrix. Die Anzahl der Nullelemente geteilt durch die Gesamtzahl der Elemente ist die Sparsity (1 minus der Dichte).
Die Zusammenfassung zeigt auch die häufigsten Items.
Längendistrubition der Elemente (Itemset/Transaktion): Zeigt, wie viele Transaktionen es für 1-Itemsets, 2-Itemsets usw. gibt. Die erste Zeile zeigt die Anzahl Items, die zweite die Anzahl Transaktionen.
Beispiel: Es gibt nur 3598 Transaktionen mit einem Item, 1594 Transaktionen mit zwei Items und die längste Transaktion enthält 419 Items.
Du kannst mit itemFrequencyPlot ein Balkendiagramm der Item-Häufigkeiten erstellen, um die Verteilung auf Basis der itemMatrix zu sehen (z. B. >transactions oder Items in >itemsets und >rules).
# Create an item frequency plot for the top 20 items
if (!require("RColorBrewer")) {
  # install color package of R
install.packages("RColorBrewer")
#include library RColorBrewer
library(RColorBrewer)
}
itemFrequencyPlot(tr,topN=20,type="absolute",col=brewer.pal(8,'Pastel2'), main="Absolute Item Frequency Plot")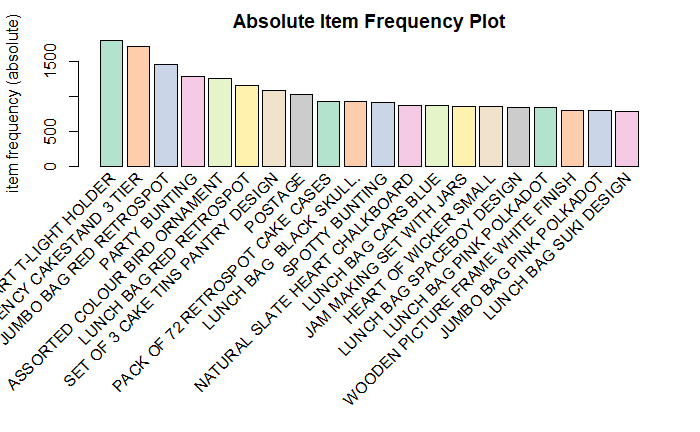
In
itemFrequencyPlot(tr,topN=20,type="absolute")ist das erste Argument das zu plottende Transaktionsobjekt tr. Mit topN wählst du die Top-N-Items nach Häufigkeit. type kann type="absolute" oder type="relative" sein. Absolut plottet die numerische Häufigkeit je Item, relativ zeigt, wie oft Items im Vergleich zu anderen auftreten.
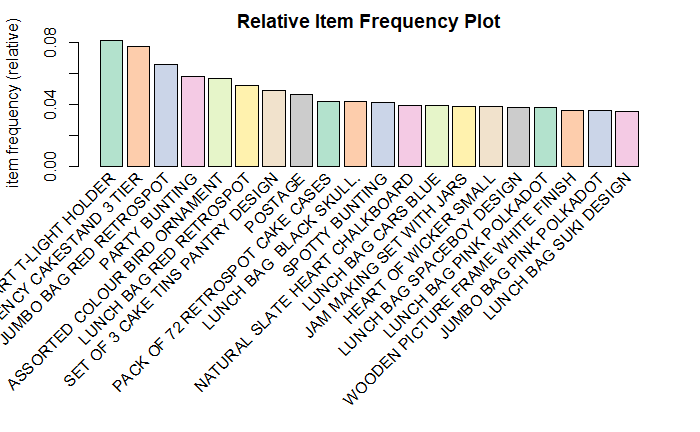
itemFrequencyPlot(tr,topN=20,type="relative",col=brewer.pal(8,'Pastel2'),main="Relative Item Frequency Plot")Dieser Plot zeigt, dass „WHITE HANGING HEART T-LIGHT HOLDER“ und „REGENCY CAKESTAND 3 TIER“ am häufigsten verkauft werden. Um den Absatz von „SET OF 3 CAKE TINS PANTRY DESIGN“ zu steigern, könnte der Händler es in der Nähe von „REGENCY CAKESTAND 3 TIER“ platzieren.
Weitere Optionen für itemFrequencyPlot findest du hier.
Als Nächstes werden mit dem APRIORI-Algorithmus Regeln gemined. Die Funktion apriori() stammt aus dem Paket arules.
# Min Support as 0.001, confidence as 0.8.
association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=10))
Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.11s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.70s].
writing ... [49122 rule(s)] done [0.06s].
creating S4 object ... done [0.06s]. set of 49122 rules
rule length distribution (lhs + rhs):sizes
2 3 4 5 6 7 8 9 10
105 2111 6854 16424 14855 6102 1937 613 121
Min. 1st Qu. Median Mean 3rd Qu. Max.
2.000 5.000 5.000 5.499 6.000 10.000
summary of quality measures:
support confidence lift count
Min. :0.001036 Min. :0.8000 Min. : 9.846 Min. : 23.00
1st Qu.:0.001082 1st Qu.:0.8333 1st Qu.: 22.237 1st Qu.: 24.00
Median :0.001262 Median :0.8788 Median : 28.760 Median : 28.00
Mean :0.001417 Mean :0.8849 Mean : 64.589 Mean : 31.45
3rd Qu.:0.001532 3rd Qu.:0.9259 3rd Qu.: 69.200 3rd Qu.: 34.00
Max. :0.015997 Max. :1.0000 Max. :715.839 Max. :355.00
mining info:
data ntransactions support confidence
tr 22191 0.001 0.8apriori erhält tr als Transaktionsobjekt, auf dem gemined wird. Über parameter setzt du min_sup und min_confidence. Standardwerte sind Support 0.1, Confidence 0.8, maximal 10 Items (maxlen).
summary(association.rules) zeigt Folgendes:
Parameter-Spezifikation: min_sup=0.001 und min_confidence=0.8 bei maximal 10 Items pro Regel.
Gesamtzahl der Regeln: 49122 Regeln.
Längendistribution: Länge 5 hat die meisten Regeln: 16424; Länge 2 hat am wenigsten: 105.
Qualitätsmaße: Min/Max für Support, Confidence und Lift.
Mining-Infos: Die Daten sowie Support und Confidence, die wir übergeben haben.
Da es 49122 Regeln sind, geben wir nur die Top 10 aus:
inspect(association.rules[1:10]) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82000 28
[2] {WOBBLY CHICKEN} => {DECORATION} 0.001261773 1 443.82000 28
[3] {DECOUPAGE} => {GREETING CARD} 0.001036456 1 389.31579 23
[4] {BILLBOARD FONTS DESIGN} => {WRAP} 0.001306836 1 715.83871 29
[5] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82000 34
[6] {WOBBLY RABBIT} => {DECORATION} 0.001532153 1 443.82000 34
[7] {FUNK MONKEY} => {ART LIGHTS} 0.001712406 1 583.97368 38
[8] {ART LIGHTS} => {FUNK MONKEY} 0.001712406 1 583.97368 38
[9] {BLACK TEA} => {SUGAR JARS} 0.002072912 1 238.61290 46
[10] {BLACK TEA} => {COFFEE} 0.002072912 1 69.34687 46 Aus dem Output lassen sich Analysen ableiten wie:
100% der Kundinnen und Kunden, die „WOBBLY CHICKEN“ kaufen, kaufen auch „METAL“.
100% der Kundinnen und Kunden, die „BLACK TEA“ kaufen, kaufen auch „SUGAR JARS“.
Wie begrenzt man Größe und Anzahl der generierten Regeln? Über die parameters in apriori. Erhöhe z. B. conf für stärkere Regeln und maxlen für längere Regeln.
shorter.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=3))Du kannst Regeln entfernen, die Teilmengen größerer Regeln sind. Nutze den folgenden Code, um solche Regeln zu entfernen:
subset.rules <- which(colSums(is.subset(association.rules, association.rules)) > 1) # get subset rules in vector
length(subset.rules)  #> 3913
[1] 44014subset.association.rules. <- association.rules[-subset.rules] # remove subset rules.
which() gibt die Positionen der Elemente im Vektor zurück, für die der Wert TRUE ist.
colSums() berechnet Spaltensummen für Dataframes und numerische Arrays.
is.subset() prüft, ob Elemente eines Vektors alle Elemente eines anderen enthalten.
Manchmal willst du ein bestimmtes Produkt betrachten. Wenn du herausfinden willst, was den Kauf von Item X beeinflusst, kannst du die Option appearance in apriori nutzen. Damit legst du LHS (IF-Teil) und RHS (THEN-Teil) der Regel fest.
Beispiel: Um zu sehen, was Kundinnen und Kunden vor dem Kauf von „METAL“ kaufen, führe Folgendes aus:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(default="lhs",rhs="METAL"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.21s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.63s].
writing ... [5 rule(s)] done [0.07s].
creating S4 object ... done [0.02s]. # Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[2] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34
[3] {DECORATION} => {METAL} 0.002253166 1 443.82 50
[4] {DECORATION,WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[5] {DECORATION,WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34 Umgekehrt, um die Frage Kundinnen und Kunden, die METAL gekauft haben, kauften außerdem … zu beantworten, setzt du METAL auf die lhs:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(lhs="METAL",default="rhs"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.10s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 done [0.01s].
writing ... [1 rule(s)] done [0.00s].
creating S4 object ... done [0.01s].# Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {METAL} => {DECORATION} 0.002253166 1 443.82 50 Da je nach Daten Hunderte oder Tausende Regeln entstehen, brauchst du verschiedene Möglichkeiten, deine Ergebnisse zu präsentieren. ItemFrequencyPlot haben wir bereits genutzt – ebenfalls hilfreich, um Topseller zu identifizieren.
Wir betrachten folgende Visualisierungen:
Eine einfache Visualisierung von Assoziationsregeln ist das Streudiagramm mit plot() aus arulesViz. Auf den Achsen stehen Support und Confidence. Zusätzlich wird standardmäßig die dritte Kennzahl Lift zur Einfärbung (Graustufen) der Punkte genutzt.
# Filter rules with confidence greater than 0.4 or 40%
subRules<-association.rules[quality(association.rules)$confidence>0.4]
#Plot SubRules
plot(subRules)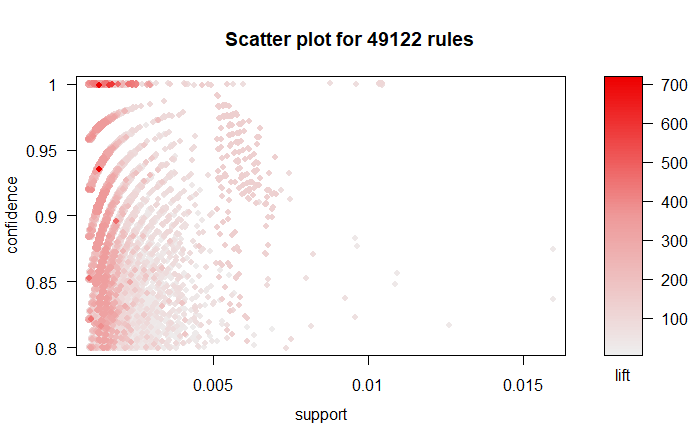
Der Plot zeigt, dass Regeln mit hohem Lift meist geringen Support haben. Du kannst die folgenden Optionen für den Plot nutzen:
plot(rulesObject, measure, shading, method)rulesObject: Das zu plottende Regelobjekt.
measure: Kennzahlen für die Interessantheit der Regeln. Möglich sind Support, Confidence, Lift oder Kombinationen – abhängig von method.
shading: Kennzahl zur Einfärbung der Punkte (Support, Confidence, Lift). Standard ist Lift.
method: Zu nutzende Visualisierung (scatterplot, two-key plot, matrix3D).
plot(subRules,method="two-key plot")
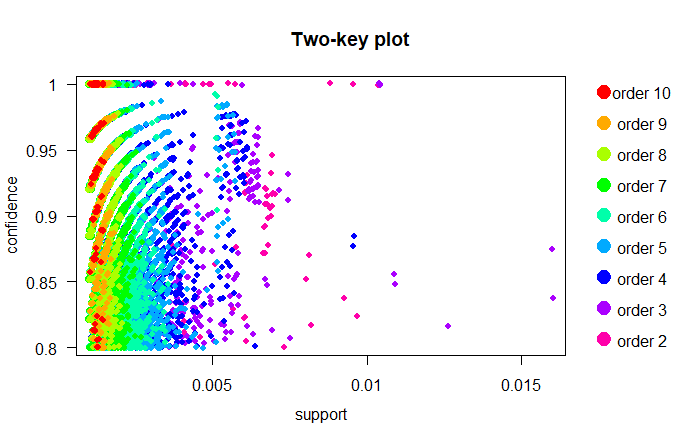
Der Two-Key-Plot nutzt Support und Confidence auf x- bzw. y-Achse. Für die Farbgebung wird die Order (Anzahl Items in der Regel) verwendet.
Eine großartige interaktive Darstellung kombiniert arulesViz und plotly. Beim Hover siehst du alle Qualitätsmaße (Support, Confidence, Lift).
plotly_arules(subRules)'plotly_arules' is deprecated.
Use 'plot' instead.
See help("Deprecated")plot: Too many rules supplied. Only plotting the best 1000 rules using measure lift (change parameter max if needed)To reduce overplotting, jitter is added! Use jitter = 0 to prevent jitter.Graphbasierte Techniken visualisieren Assoziationsregeln mit Knoten und Kanten: Knoten sind mit Itemnamen beschriftet, Itemsets oder Regeln werden als zweite Knotenmenge dargestellt. Items sind mit Itemsets/Regeln über gerichtete Pfeile verbunden. Pfeile von Items zu Regelknoten markieren LHS-Items, ein Pfeil von einer Regel zu einem Item markiert die RHS. Größe und Farbe der Knoten repräsentieren oft Interessantheitsmaße.
Graphplots sind sehr aussagekräftig, werden aber schnell unübersichtlich, wenn die Zahl der Regeln steigt. Daher besser nur wenige Regeln graphbasiert visualisieren.
Wählen wir 10 Regeln aus subRules mit der höchsten Confidence.
top10subRules <- head(subRules, n = 10, by = "confidence")Jetzt plotten wir einen interaktiven Graphen:
Hinweis: Du kannst alle Plots interaktiv machen, indem du in plot den Parameter engine=htmlwidget setzt.
plot(top10subRules, method = "graph", engine = "htmlwidget")
Mit arulesViz können Graphen von Regelsätzen als GraphML oder Graphviz dot-Dateien exportiert und z. B. in Gephi untersucht werden. Beispielsweise exportierst du die 1000 Regeln mit dem höchsten Lift so:
saveAsGraph(head(subRules, n = 1000, by = "lift"), file = "rules.graphml")Diese Darstellung heißt auch Parallel Coordinates Plot. Sie ist nützlich, um zu sehen, welche Produkte zusammen mit welchen Items welchen Effekt auf den Verkauf haben.
Wie oben erwähnt, ist die RHS der Konsequens, also das Item, dessen Kauf wir prognostizieren. Die Positionen auf der LHS zeigen die Reihenfolge: 2 ist die jüngste Ergänzung im Warenkorb, 1 das zuvor enthaltene Item.
# Filter top 20 rules with highest lift
subRules2<-head(subRules, n=20, by="lift")
plot(subRules2, method="paracoord")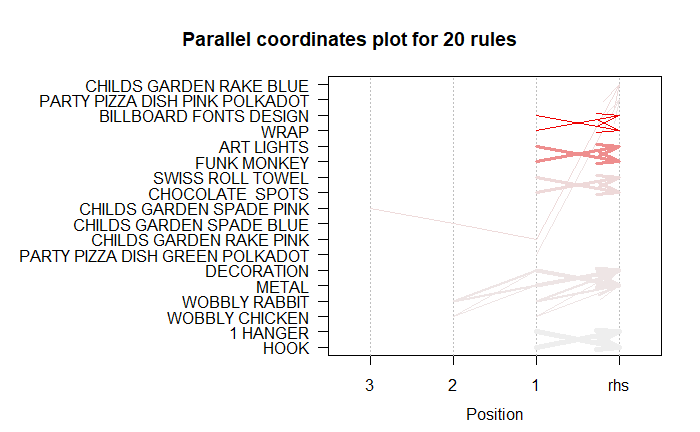
Sieh dir den obersten Pfeil an. Er zeigt: Wenn „CHILDS GARDEN SPADE PINK“ und „CHILDS GARDEN RAKE PINK“ im Warenkorb liegen, ist es wahrscheinlich, dass auch „CHILDS GARDEN RAKE BLUE“ dazu gekauft wird.
Glückwunsch! Du hast APRIORI kennengelernt, einen der am häufigsten genutzten Algorithmen im Data Mining. Du weißt nun, wie Assoziationsregel-Mining funktioniert, wofür es eingesetzt wird und wie es im Handel als Market Basket Analysis Anwendung findet. Außerdem kannst du die Marktkorbanalyse in R umsetzen und deine Regeln mit starken Visualisierungen präsentieren. Viel Erfolg beim Lernen!
Wenn du mehr über R lernen möchtest, belege den DataCamp-Kurs Importing and Managing Financial Data in R.
Erfahre mehr über R
Kurs
Kurs
Kurs