Cours
Importer et gérer des données financières avec R
5 h
21K
Vous êtes data scientist (ou en passe de le devenir) et vous travaillez avec un client qui gère un magasin. Il vous confie les données de toutes les transactions — les articles achetés par plusieurs clients sur une période donnée — et vous demande d'exploiter ces données pour stimuler son activité. Votre client utilisera vos conclusions pour modifier, mettre à jour ou ajouter des références en stock, mais aussi pour repenser l'agencement du magasin physique ou de la boutique en ligne. Pour obtenir des résultats utiles, vous allez appliquer la Market Basket Analysis (MBA), qui s'appuie sur le fouillage de règles d'association à partir des données de transaction fournies.
Dans ce tutoriel, vous allez apprendre :
Le fouillage de règles d'association sert à mettre en évidence des liens entre différents objets d'un ensemble, à détecter des motifs fréquents dans une base de transactions, des bases relationnelles ou tout autre référentiel d'information. Ses applications couvrent le marketing, l'analyse des paniers (Market Basket Analysis) en retail, le clustering et la classification. Il permet d'identifier les articles que les clients achètent souvent ensemble en générant un ensemble de règles appelées règles d'association. En termes simples, il produit des règles du type si ceci alors cela. Les clients peuvent exploiter ces règles pour de nombreuses stratégies marketing :
Considérez l'exemple suivant :
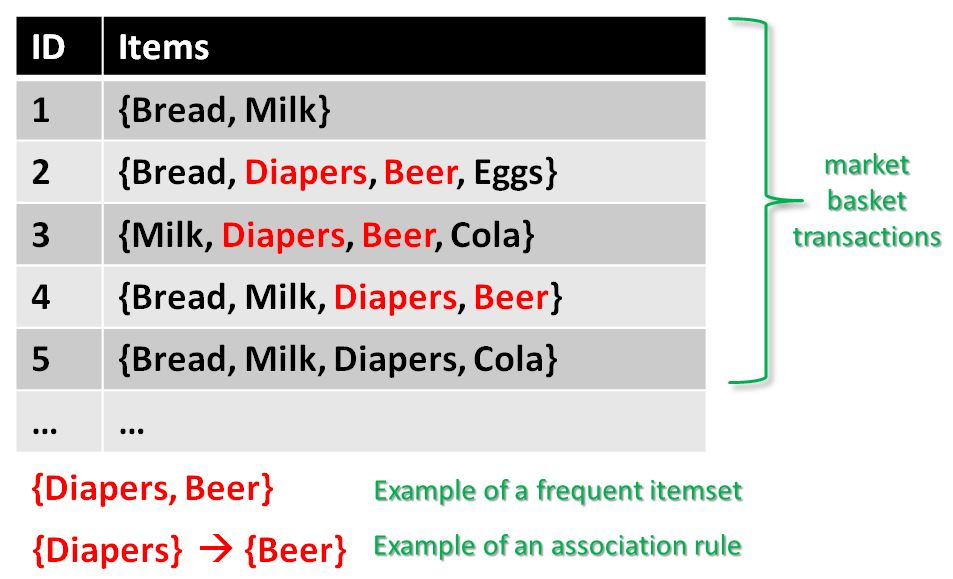
On dispose d'un ensemble de transactions. Elles sont numérotées de 1 à 5 et listent les articles achetés dans chaque transaction. Vous pouvez observer que des couches sont achetées avec de la bière dans trois transactions. De même, du pain est acheté avec du lait dans trois transactions : ce sont donc des itemsets fréquents. Les règles d'association s'écrivent sous la forme :
$A=>B[Support,Confidence]$
La partie avant $=>$ correspond au si (antécédent) et la partie après $=>$ au alors (conséquent).
Où A et B sont des ensembles d'articles dans les données de transaction. A et B sont disjoints.
$Computer=>Anti-virus Software[Support=20\%,confidence=60\%]$
Cette règle signifie :
Dans la section suivante, vous verrez les concepts de base des règles d'association :
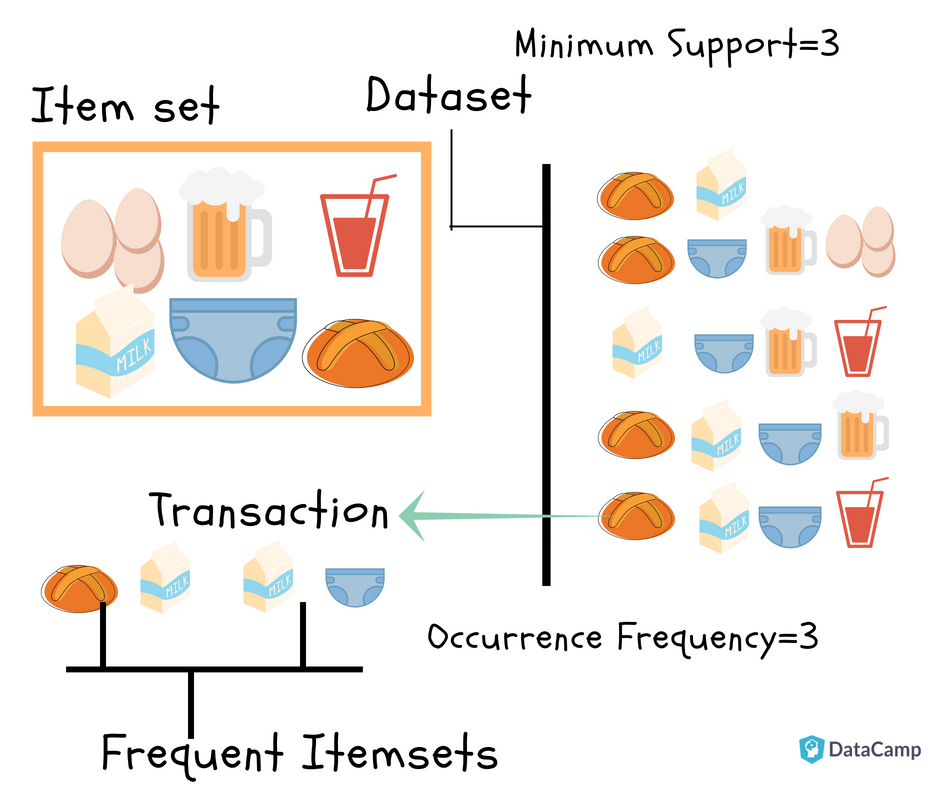
Itemset (ensemble d'articles) : Collection d'un ou plusieurs articles. Un k-itemset contient k articles.
Support count (compte de support) : Fréquence d'apparition d'un itemset.
Support (s) : Fraction des transactions qui contiennent l'itemset « X »
$Support(X)=\frac{frequency(X)}{N}$
Pour une règle A=>B, le support est :
$Support(A=>B)=\frac{frequency(A,B)}{N}$
Remarque : P(A∪B) est la probabilité que A et B surviennent ensemble. P désigne la probabilité.
Allez-y, calculez le support pour Lait=>Couches en exercice.
$Confidence(A=>B)=\frac{P(A\cap B)}{P(A)}=\frac{frequency(A,B)}{frequency(A)}$
Le nombre de transactions contenant A et B divisé par le nombre total de transactions contenant A.
$Confidence(Bread=>Milk)=\frac{3}{4}=0.75=75\%$
À vous de trouver la confiance pour Lait=>Couches.
Remarque : Le support et la confiance mesurent l'intérêt d'une règle. On fixe des seuils minimaux de support et de confiance. Ces seuils, définis avec le client, permettent d'évaluer la solidité des règles selon vos objectifs. Plus on s'en approche, plus la règle est utile pour le client.
Itemsets fréquents : Itemsets dont le support est supérieur ou égal au seuil minimal de support (min_sup). Dans l'exemple ci-dessus, min_sup=3. Ce seuil est au choix de l'utilisateur.
Règles fortes : Une règle A=>B[Support, Confidence] qui satisfait min_sup et min_confidence est dite forte.
Lift : Le lift mesure la corrélation entre A et B dans la règle A=>B. Il indique l'effet de l'itemset A sur l'itemset B.
$Lift(A=>B)=\frac{Support}{Supp(A)Supp(B)}$
Par exemple, pour la règle {Bread}=>{Milk}, le lift se calcule ainsi :
$support(Bread)=\frac{4}{5}=0.8$
$support(Milk)=\frac{4}{5}=0.8$
$Lift(Bread=>Milk)=\frac{0.6}{0.8*0.8}=0.9$
Si le lift vaut 1, A et B sont indépendants et aucune règle utile n'en découle.
Si le lift est > 1, A et B sont dépendants, avec un degré donné par la valeur du lift.
Si le lift est < 1, la présence de A a un effet négatif sur B.
Lorsque vous appliquez les règles d'association à un ensemble de transactions T, l'objectif est de trouver toutes les règles avec :
Dans cette partie, vous allez découvrir l'algorithme sous-jacent utilisé par les bibliothèques R pour la Market Basket Analysis. Cela vous aidera à mieux comprendre vos clients et à mener des analyses plus fines. Si vous maîtrisez déjà APRIORI et son fonctionnement, passez directement à la partie code.
Le fouillage de règles d'association suit une approche en deux étapes :
Génération des itemsets fréquents : trouver tous les itemsets fréquents avec un support >= au min_support défini.
Génération des règles : lister toutes les règles d'association issues des itemsets fréquents. Calculer support et confiance pour chaque règle. Élaguer les règles qui ne satisfont pas les seuils min_support et min_confidence.
La génération des itemsets fréquents est l'étape la plus coûteuse en calcul car elle nécessite un scan complet de la base.
Vous n'avez vu qu'un exemple avec 5 transactions, mais dans la réalité, les données retail atteignent des Go voire des To. Il faut donc un algorithme optimisé pour éliminer tôt les itemsets inutiles. C'est le rôle d'APRIORI, qui énonce :
Tout sous-ensemble d'un itemset fréquent est lui-même fréquent. Autrement dit, aucun sur-ensemble d'un itemset non fréquent ne doit être généré ni testé.
On le représente via un treillis d'itemsets (Itemset Lattice), représentation graphique du principe d'APRIORI. Il est composé de nœuds k-itemset et des relations de sous-ensembles correspondantes.
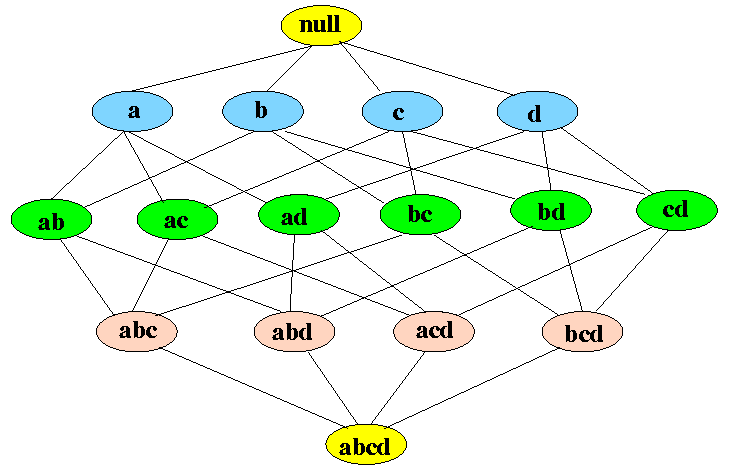
Comme montré ci-dessus, on part du bas avec tous les articles des transactions, puis on remonte en créant des sous-ensembles jusqu'à l'ensemble vide. Pour d articles, la taille du treillis est $2^d$. Cela illustre la difficulté de générer des itemsets fréquents en calculant le support de chaque combinaison. La figure suivante montre combien APRIORI réduit le nombre d'ensembles à générer :
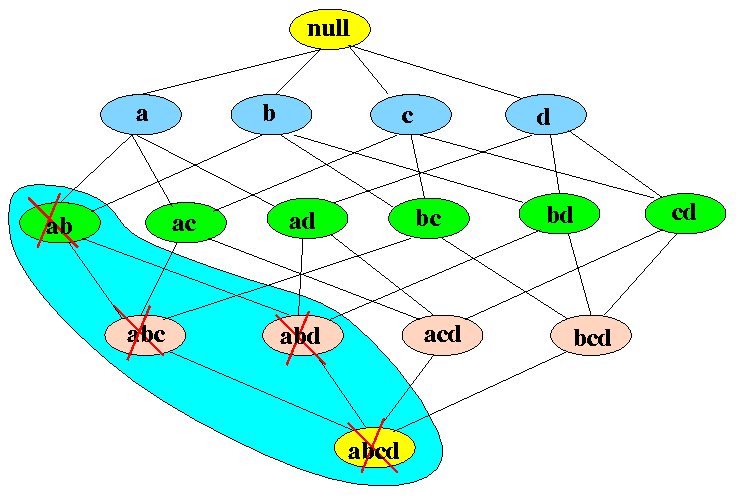
Si l'itemset {a,b} est non fréquent, il est inutile de considérer tous ses sur-ensembles.
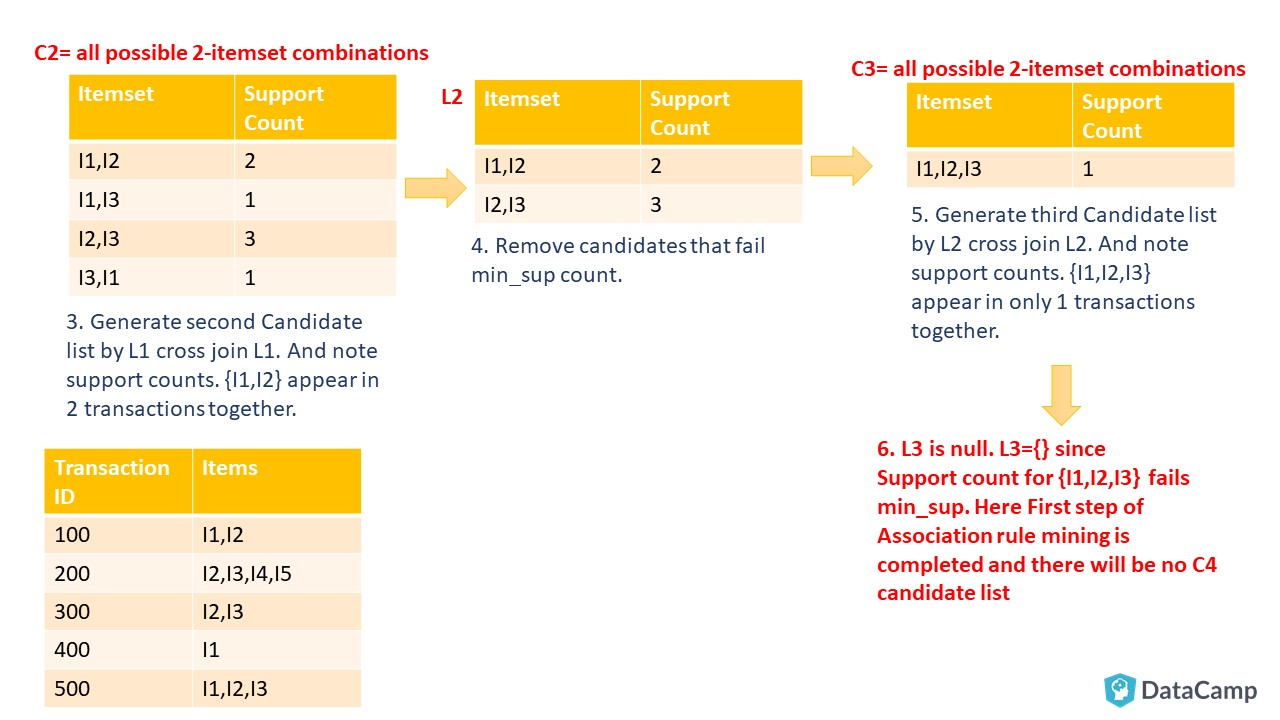
Voyons cela par un exemple. Vous allez comprendre pourquoi APRIORI est efficace et générer des règles fortes pas à pas. Prenez votre carnet et suivez le fil !
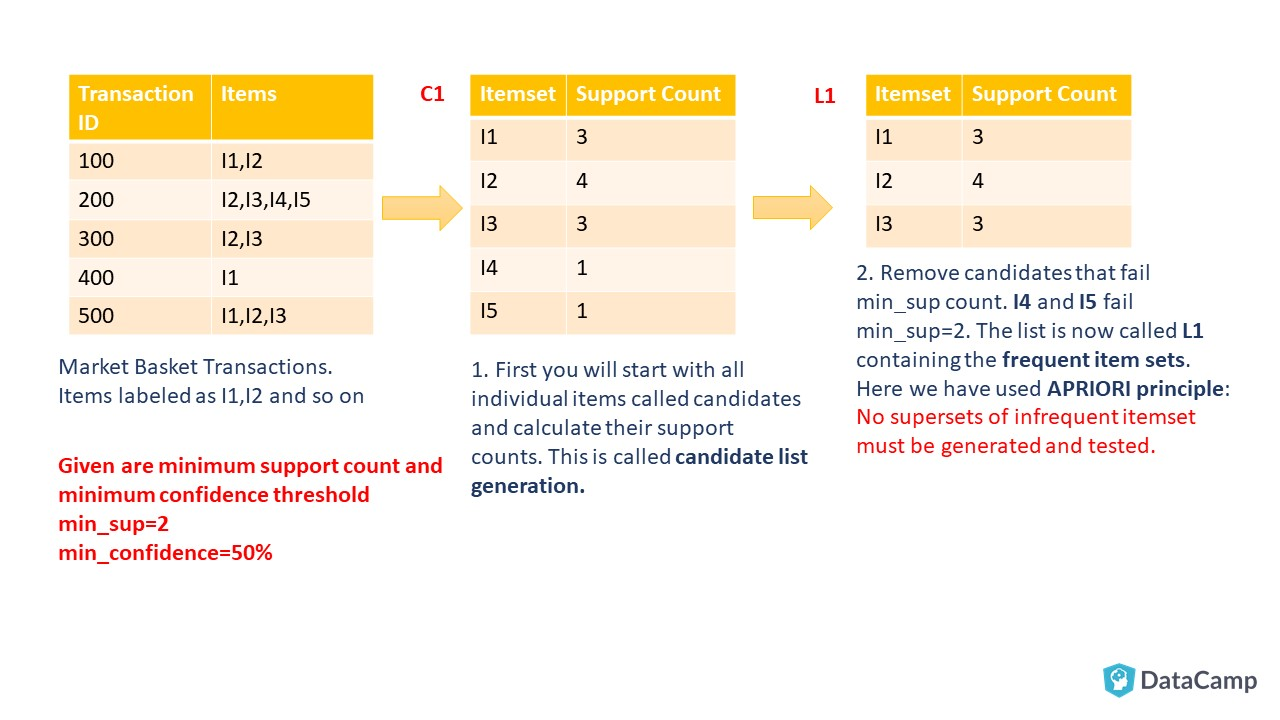
On commence par créer la liste des candidats pour les 1-itemsets, qui inclut individuellement tous les articles présents dans les données. Sur des données retail réelles, cette génération de candidats est coûteuse. APRIORI intervient pour réduire cette liste et, in fine, produire des règles utiles. Les étapes suivantes montrent comment on atteint la fin de la génération des itemsets fréquents, première étape du fouillage de règles d'association.
Étape suivante : lister tous les itemsets fréquents. Prenez le dernier itemset fréquent non vide, ici L2={I1, I2},{I2, I3}. Puis générez tous les sous-ensembles non vides des itemsets présents dans cette liste. Suivez l'illustration ci-dessous :
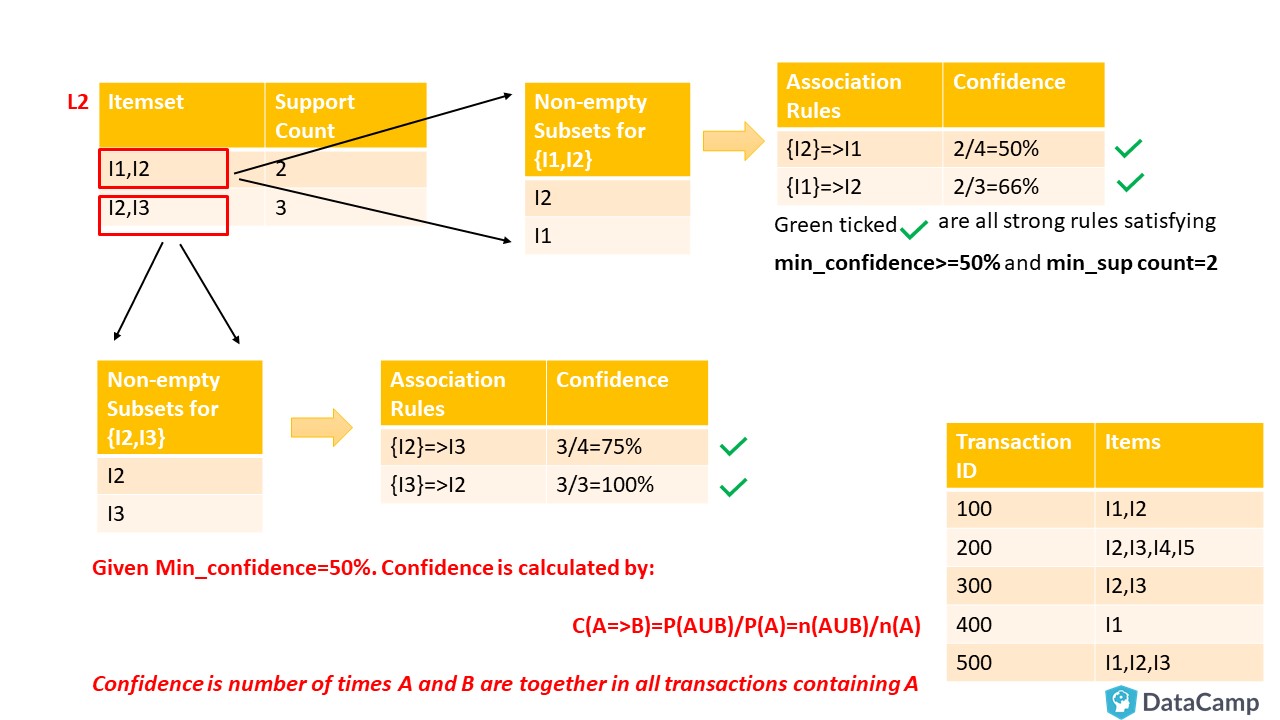
On obtient ci-dessus quatre règles fortes. Par exemple, ${I2}=>I3$ avec une confiance de 75 % indique que 75 % des personnes ayant acheté I2 ont aussi acheté I3.
Vous maîtrisez désormais l'algorithme APRIORI, l'un des plus utilisés en fouille de données. Passons au code, ouf !
Dans ce tutoriel, vous utiliserez un jeu de données du UCI Machine Learning Repository. Le dataset s'appelle Online-Retail et vous pouvez le télécharger ici. Il contient des transactions du 01/12/2010 au 09/12/2011 pour un e-commerçant britannique enregistré sans point de vente physique. Nous l'utilisons plutôt qu'un dataset R intégré, car vous recevrez plus souvent des données retail sous cette forme, nécessitant un prétraitement.
Commencez par charger les bibliothèques requises. Un bref descriptif (tiré de Here) figure dans le tableau suivant pour comprendre le rôle de chacune :
| Package | Description |
|---|---|
arules |
Fournit l'infrastructure pour représenter, manipuler et analyser des données de transactions et des motifs (itemsets fréquents et règles d'association). |
arulesViz |
Étend le package « arules » avec diverses techniques de visualisation pour les règles d'association et les itemsets, y compris des visualisations interactives pour explorer les règles. |
tidyverse |
Collection cohérente de packages R conçue pour la data science. |
readxl |
Lire des fichiers Excel dans R. |
plyr |
Outils pour scinder, appliquer et combiner des données. |
ggplot2 |
Créer des graphiques et visualisations. |
knitr |
Génération de rapports dynamiques sous R. |
lubridate |
Package R qui simplifie la manipulation des dates et des heures. |
#install and load package arules
#install.packages("arules")
library(arules)
#install and load arulesViz
#install.packages("arulesViz")
library(arulesViz)
#install and load tidyverse
#install.packages("tidyverse")
library(tidyverse)
#install and load readxml
#install.packages("readxml")
library(readxl)
#install and load knitr
#install.packages("knitr")
library(knitr)
#load ggplot2 as it comes in tidyverse
library(ggplot2)
#install and load lubridate
#install.packages("lubridate")
library(lubridate)
#install and load plyr
#install.packages("plyr")
library(plyr)
library(dplyr)Utilisez read_excel(path to file) pour lire le fichier téléchargé dans R. Indiquez le chemin complet, nom de fichier inclus, dans read_excel(path-to-file-with-filename).
#read excel into R dataframe
retail <- read_excel('D:/Documents/Online_Retail.xlsx')
#complete.cases(data) will return a logical vector indicating which rows have no missing values. Then use the vector to get only rows that are complete using retail[,].
retail <- retail[complete.cases(retail), ]
#mutate function is from dplyr package. It is used to edit or add new columns to dataframe. Here Description column is being converted to factor column. as.factor converts column to factor column. %>% is an operator with which you may pipe values to another function or expression
retail %>% mutate(Description = as.factor(Description))
retail %>% mutate(Country = as.factor(Country))#Converts character data to date. Store InvoiceDate as date in new variable
retail$Date <- as.Date(retail$InvoiceDate)
#Extract time from InvoiceDate and store in another variable
TransTime<- format(retail$InvoiceDate,"%H:%M:%S")
#Convert and edit InvoiceNo into numeric
InvoiceNo <- as.numeric(as.character(retail$InvoiceNo))NAs introduced by coercion#Bind new columns TransTime and InvoiceNo into dataframe retail
cbind(retail,TransTime)cbind(retail,InvoiceNo)#get a glimpse of your data
glimpse(retail)Observations: 406,829
Variables: 9
$ InvoiceNo <chr> "536365", "536365", "536365", "536365", "536365", "536365", "53...
$ StockCode <chr> "85123A", "71053", "84406B", "84029G", "84029E", "22752", "2173...
$ Description <chr> "WHITE HANGING HEART T-LIGHT HOLDER", "WHITE METAL LANTERN", "C...
$ Quantity <dbl> 6, 6, 8, 6, 6, 2, 6, 6, 6, 32, 6, 6, 8, 6, 6, 3, 2, 3, 3, 4, 4,...
$ InvoiceDate <dttm> 2010-12-01 08:26:00, 2010-12-01 08:26:00, 2010-12-01 08:26:00,...
$ UnitPrice <dbl> 2.55, 3.39, 2.75, 3.39, 3.39, 7.65, 4.25, 1.85, 1.85, 1.69, 2.1...
$ CustomerID <dbl> 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, ...
$ Country <chr> "United Kingdom", "United Kingdom", "United Kingdom", "United K...
$ Date <date> 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 20...Désormais, le dataframe retail contiendra 10 attributs, avec deux colonnes supplémentaires : Date et Time.
Avant d'appliquer la MBA/les règles d'association, il faut convertir le dataframe en données de transactions, de sorte que tous les articles achetés ensemble pour une facture figurent sur une seule ligne. Dans la sortie de glimpse, chaque transaction est au format atomique, c'est-à-dire que les produits d'une même facture sont séparés comme en base relationnelle. Ce format est aussi appelé format singles.
Vous devez regrouper les données du retail dataframe par CustomerID, CustomerID et Date, ou encore par InvoiceNo et Date. Nous allons regrouper puis appliquer une fonction et stocker le résultat dans un autre dataframe. On peut le faire avec ddply.
Les lignes suivantes combinent tous les produits d'un même InvoiceNo et d'une même Date sur une seule ligne, chaque article étant séparé par une ,
library(plyr)
#ddply(dataframe, variables_to_be_used_to_split_data_frame, function_to_be_applied)
transactionData <- ddply(retail,c("InvoiceNo","Date"),
                       function(df1)paste(df1$Description,
                       collapse = ","))
#The R function paste() concatenates vectors to character and separated results using collapse=[any optional charcater string ]. Here ',' is usedtransactionDataEnsuite, comme InvoiceNo et Date ne seront pas utiles pour l'extraction des règles, vous pouvez les définir à NULL.
#set column InvoiceNo of dataframe transactionData
transactionData$InvoiceNo <- NULL
#set column Date of dataframe transactionData
transactionData$Date <- NULL
#Rename column to items
colnames(transactionData) <- c("items")
#Show Dataframe transactionData
transactionDataCe format de données de transactions est appelé format basket. Enregistrez ensuite ces transactions dans un fichier .csv (Comma Separated Values) via write.csv()
write.csv(transactionData,"D:/Documents/market_basket_transactions.csv", quote = FALSE, row.names = FALSE)
#transactionData: Data to be written
#"D:/Documents/market_basket.csv": location of file with file name to be written to
#quote: If TRUE it will surround character or factor column with double quotes. If FALSE nothing will be quoted
#row.names: either a logical value indicating whether the row names of x are to be written along with x, or a character vector of row names to be written.
Vérifiez que vos transactions ont le bon format :
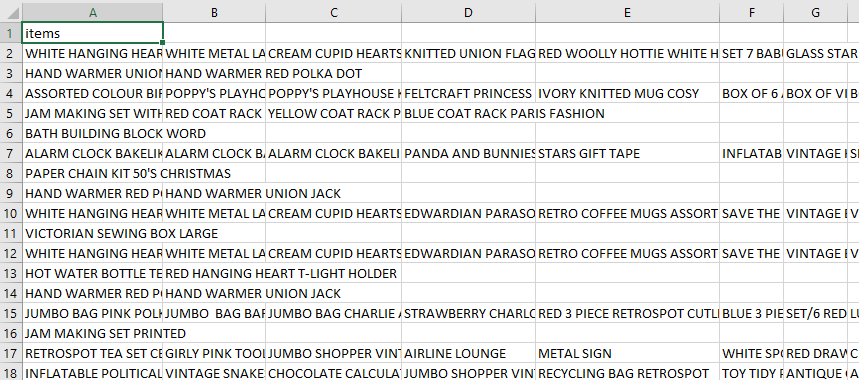
Chargez ensuite ces transactions dans un objet de classe transaction à l'aide de la fonction R read.transactions du package arules.
La ligne suivante lit le fichier D:/Documents/market_basket_transactions.csv au format basket et le convertit en objet transaction.
tr <- read.transactions('D:/Documents/market_basket_transactions.csv', format = 'basket', sep=',')
#sep tell how items are separated. In this case you have separated using ','
Lors de l'exécution, vous pouvez voir s'afficher des EOF within quoted string. Pas d'inquiétude.
Si vous avez déjà des transactions dans un dataframe, utilisez la ligne suivante pour le convertir en objet transaction :
`trObj<-as(dataframe.dat,"transactions")`Affichez l'objet tr :
tr
transactions in sparse format with
 22191 transactions (rows) and
30066 items (columns) summary(tr)transactions in sparse format with
22191 transactions (rows) and
7876 items (columns)
transactions as itemMatrix in sparse format with
22191 rows (elements/itemsets/transactions) and
7876 columns (items) and a density of 0.001930725
most frequent items:
WHITE HANGING HEART T-LIGHT HOLDER REGENCY CAKESTAND 3 TIER
1803 1709
JUMBO BAG RED RETROSPOT PARTY BUNTING
1460 1285
ASSORTED COLOUR BIRD ORNAMENT (Other)
1250 329938
element (itemset/transaction) length distribution:
sizes
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
3598 1594 1141 908 861 758 696 676 663 593 624 537 516 531 551 522 464
18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34
441 483 419 395 315 306 272 238 253 229 213 222 215 170 159 138 142
35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51
134 109 111 90 113 94 93 87 88 65 63 67 63 60 59 49 64
52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68
40 41 49 43 36 29 39 30 27 28 17 25 25 20 27 24 22
69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85
15 20 19 13 16 16 11 15 12 7 9 14 15 12 8 9 11
86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102
11 14 8 6 5 6 11 6 4 4 3 6 5 2 4 2 4
103 104 105 106 107 108 109 110 111 112 113 114 116 117 118 120 121
4 3 2 2 6 3 4 3 2 1 3 1 3 3 3 1 2
122 123 125 126 127 131 132 133 134 140 141 142 143 145 146 147 150
2 1 3 2 2 1 1 2 1 1 2 2 1 1 2 1 1
154 157 168 171 177 178 180 202 204 228 236 249 250 285 320 400 419
3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1
Min. 1st Qu. Median Mean 3rd Qu. Max.
1.00 3.00 10.00 15.21 21.00 419.00
includes extended item information - examples:
labels
1 1 HANGER
2 10 COLOUR SPACEBOY PEN
3 12 COLOURED PARTY BALLOONSsummary(tr) est une commande très utile qui renseigne sur l'objet transactions. Voici ce que dit la sortie ci-dessus :
Il y a 22191 transactions (lignes) et 7876 articles (colonnes). Notez que 7876 correspond aux libellés produits du dataset et que les 22191 transactions sont des combinaisons de ces articles.
La densité indique le pourcentage de cellules non nulles dans une matrice creuse. On peut l'interpréter comme le nombre total d'articles achetés divisé par le nombre d'articles possibles dans la matrice. Vous pouvez estimer le nombre d'articles achetés via la densité : 22191x7876x0.001930725=337445
Info ! Matrice creuse : une matrice creuse (sparse) contient majoritairement des zéros. À l'inverse, si la plupart des éléments sont non nuls, la matrice est dite dense. Le nombre d'éléments nuls divisé par le nombre total d'éléments s'appelle la parcimonie de la matrice (égale à 1 moins la densité).
Le résumé liste aussi les articles les plus fréquents.
Distribution de la longueur des itemsets/transactions : elle indique combien de transactions comportent 1 article, 2 articles, etc. La première ligne indique le nombre d'articles, la seconde le nombre de transactions.
Par exemple, il n'y a que 3598 transactions avec un seul article, 1594 avec 2 articles, et une transaction maximale de 419 articles.
Générez un itemFrequencyPlot pour afficher un histogramme de fréquence des articles à partir de l'itemMatrix (par ex., >transactions ou articles dans >itemsets et >rules), comme ici.
# Create an item frequency plot for the top 20 items
if (!require("RColorBrewer")) {
  # install color package of R
install.packages("RColorBrewer")
#include library RColorBrewer
library(RColorBrewer)
}
itemFrequencyPlot(tr,topN=20,type="absolute",col=brewer.pal(8,'Pastel2'), main="Absolute Item Frequency Plot")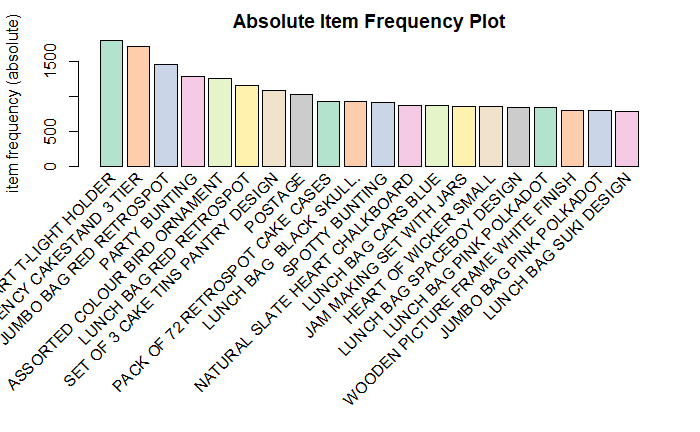
Dans
itemFrequencyPlot(tr,topN=20,type="absolute")le premier argument est l'objet transactions à tracer, ici tr. topN permet d'afficher les N articles les plus fréquents. type peut être type="absolute" ou type="relative". En absolu, on trace les fréquences brutes de chaque article. En relatif, on trace leur fréquence comparée aux autres.
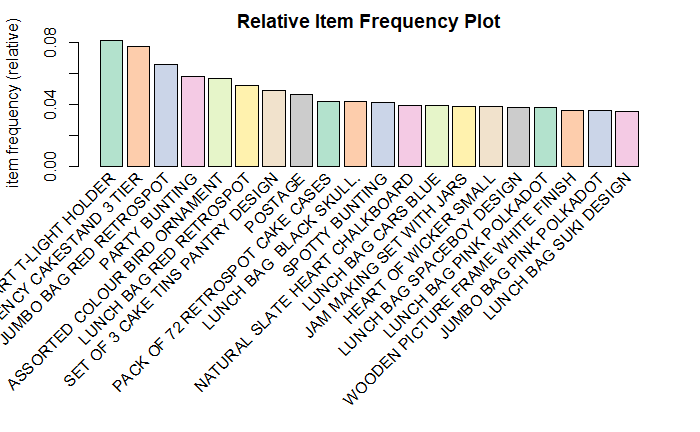
itemFrequencyPlot(tr,topN=20,type="relative",col=brewer.pal(8,'Pastel2'),main="Relative Item Frequency Plot")Ce graphique montre que « WHITE HANGING HEART T-LIGHT HOLDER » et « REGENCY CAKESTAND 3 TIER » se vendent le plus. Pour augmenter les ventes de « SET OF 3 CAKE TINS PANTRY DESIGN », le commerçant peut le placer près de « REGENCY CAKESTAND 3 TIER ».
Explorez les autres options de itemFrequencyPlot ici.
Étape suivante : extraire les règles avec l'algorithme APRIORI. La fonction apriori() appartient au package arules.
# Min Support as 0.001, confidence as 0.8.
association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=10))
Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.11s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.70s].
writing ... [49122 rule(s)] done [0.06s].
creating S4 object ... done [0.06s]. set of 49122 rules
rule length distribution (lhs + rhs):sizes
2 3 4 5 6 7 8 9 10
105 2111 6854 16424 14855 6102 1937 613 121
Min. 1st Qu. Median Mean 3rd Qu. Max.
2.000 5.000 5.000 5.499 6.000 10.000
summary of quality measures:
support confidence lift count
Min. :0.001036 Min. :0.8000 Min. : 9.846 Min. : 23.00
1st Qu.:0.001082 1st Qu.:0.8333 1st Qu.: 22.237 1st Qu.: 24.00
Median :0.001262 Median :0.8788 Median : 28.760 Median : 28.00
Mean :0.001417 Mean :0.8849 Mean : 64.589 Mean : 31.45
3rd Qu.:0.001532 3rd Qu.:0.9259 3rd Qu.: 69.200 3rd Qu.: 34.00
Max. :0.015997 Max. :1.0000 Max. :715.839 Max. :355.00
mining info:
data ntransactions support confidence
tr 22191 0.001 0.8apriori prend tr comme objet transactions à analyser. parameter permet de définir min_sup et min_confidence. Par défaut, le support minimal vaut 0,1, la confiance minimale 0,8 et la longueur maximale (maxlen) 10.
summary(association.rules) indique notamment :
Paramétrage : min_sup=0,001 et min_confidence=0,8 avec 10 articles au maximum par règle.
Nombre total de règles : 49122 règles.
Distribution des longueurs : les règles de longueur 5 sont les plus nombreuses (16424) ; celles de longueur 2 sont les moins nombreuses (105).
Résumé des mesures de qualité : min et max pour Support, Confiance et Lift.
Infos d'extraction : données, support et confiance fournis à l'algorithme.
Comme il y a 49122 règles, n'affichons que les 10 premières :
inspect(association.rules[1:10]) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82000 28
[2] {WOBBLY CHICKEN} => {DECORATION} 0.001261773 1 443.82000 28
[3] {DECOUPAGE} => {GREETING CARD} 0.001036456 1 389.31579 23
[4] {BILLBOARD FONTS DESIGN} => {WRAP} 0.001306836 1 715.83871 29
[5] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82000 34
[6] {WOBBLY RABBIT} => {DECORATION} 0.001532153 1 443.82000 34
[7] {FUNK MONKEY} => {ART LIGHTS} 0.001712406 1 583.97368 38
[8] {ART LIGHTS} => {FUNK MONKEY} 0.001712406 1 583.97368 38
[9] {BLACK TEA} => {SUGAR JARS} 0.002072912 1 238.61290 46
[10] {BLACK TEA} => {COFFEE} 0.002072912 1 69.34687 46 À partir de ces résultats, vous pouvez par exemple conclure :
100 % des clients qui achètent « WOBBLY CHICKEN » achètent aussi « METAL ».
100 % des clients qui achètent « BLACK TEA » achètent aussi « SUGAR JARS ».
Comment limiter la taille et le volume de règles générées ? En ajustant les parameters d'apriori. Augmentez conf pour obtenir des règles plus fortes et maxlen pour autoriser des règles plus longues.
shorter.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=3))Vous pouvez retirer les règles qui sont des sous-ensembles de règles plus larges. Utilisez le code ci-dessous :
subset.rules <- which(colSums(is.subset(association.rules, association.rules)) > 1) # get subset rules in vector
length(subset.rules)  #> 3913
[1] 44014subset.association.rules. <- association.rules[-subset.rules] # remove subset rules.
which() : renvoie les positions des éléments vrais dans un vecteur logique.
colSums() : calcule les sommes par colonnes pour dataframes et tableaux numériques.
is.subset() : détermine si les éléments d'un vecteur contiennent tous les éléments d'un autre.
Parfois, vous souhaitez vous concentrer sur un produit précis. Pour identifier ce qui influence l'achat d'un article X, utilisez l'option appearance dans apriori. appearance permet de fixer la LHS (partie SI) et la RHS (partie ALORS) de la règle.
Par exemple, pour savoir ce que les clients achètent avant « METAL », exécutez :
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(default="lhs",rhs="METAL"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.21s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.63s].
writing ... [5 rule(s)] done [0.07s].
creating S4 object ... done [0.02s]. # Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[2] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34
[3] {DECORATION} => {METAL} 0.002253166 1 443.82 50
[4] {DECORATION,WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[5] {DECORATION,WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34 De même, pour répondre à la question Les clients qui ont acheté METAL ont aussi acheté…, placez METAL en lhs :
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(lhs="METAL",default="rhs"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.10s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 done [0.01s].
writing ... [1 rule(s)] done [0.00s].
creating S4 object ... done [0.01s].# Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {METAL} => {DECORATION} 0.002253166 1 443.82 50 Comme les données peuvent générer des centaines ou milliers de règles, vous avez besoin de plusieurs façons de présenter vos résultats. Nous avons déjà vu ItemFrequencyPlot, très utile pour repérer les meilleures ventes.
Voici les visualisations abordées ici :
Une visualisation simple des règles d'association consiste à utiliser un scatter plot via plot() du package arulesViz. Les axes représentent le support et la confiance. Par défaut, une troisième mesure, le lift, colore les points (niveaux de gris).
# Filter rules with confidence greater than 0.4 or 40%
subRules<-association.rules[quality(association.rules)$confidence>0.4]
#Plot SubRules
plot(subRules)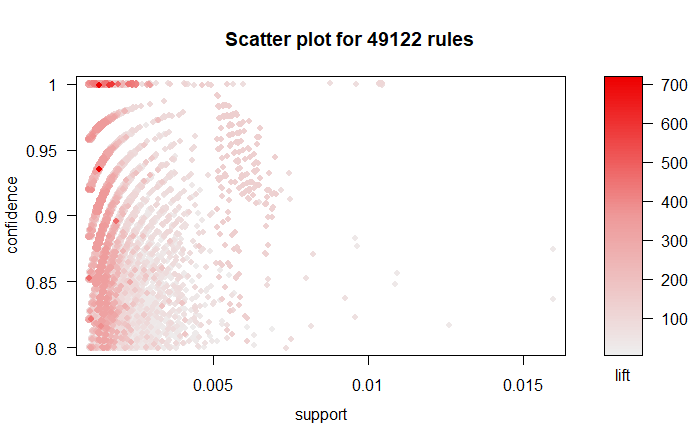
Ce graphique montre que les règles avec un lift élevé ont un support faible. Options disponibles :
plot(rulesObject, measure, shading, method)rulesObject : l'objet règles à tracer
measure : mesures d'intérêt (support, confiance, lift) seules ou combinées selon la method
shading : mesure utilisée pour la couleur (support, confiance, lift). Par défaut : lift.
method : méthode de visualisation (scatterplot, two-key plot, matrix3D).
plot(subRules,method="two-key plot")
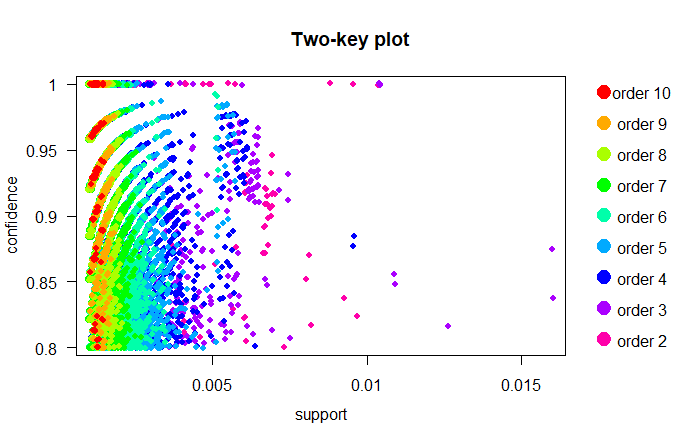
Le two-key plot place le support en abscisse et la confiance en ordonnée. La couleur encode l’order, c’est-à-dire le nombre d’articles dans la règle.
Un graphique interactif très parlant, basé sur arulesViz et plotly, permet de survoler chaque règle pour en voir les mesures (support, confiance, lift).
plotly_arules(subRules)'plotly_arules' is deprecated.
Use 'plot' instead.
See help("Deprecated")plot: Too many rules supplied. Only plotting the best 1000 rules using measure lift (change parameter max if needed)To reduce overplotting, jitter is added! Use jitter = 0 to prevent jitter.Les techniques basées sur des graphes représentent les règles via des sommets et des arêtes : les sommets sont étiquetés par les noms d’articles et un second ensemble de sommets représente les itemsets/règles. Des flèches orientées des articles vers les sommets « règles » indiquent la LHS, et une flèche d’une règle vers un article indique la RHS. La taille et la couleur des sommets peuvent refléter des mesures d’intérêt.
Ces graphes sont très parlants mais deviennent vite chargés si le nombre de règles est élevé. Il vaut mieux n’en visualiser qu’un petit nombre.
Sélectionnons 10 règles de subRules avec la confiance la plus élevée.
top10subRules <- head(subRules, n = 10, by = "confidence")Tracez maintenant un graphe interactif :
Remarque : vous pouvez rendre tous vos graphiques interactifs avec le paramètre engine=htmlwidget dans plot
plot(top10subRules, method = "graph", engine = "htmlwidget")
Depuis arulesViz, les graphes de règles peuvent être exportés en GraphML ou Graphviz dot pour exploration dans des outils comme Gephi. Par exemple, pour exporter les 1000 règles avec le lift le plus élevé :
saveAsGraph(head(subRules, n = 1000, by = "lift"), file = "rules.graphml")Aussi appelée Parallel Coordinates Plot. Utile pour visualiser quels produits, combinés à d'autres, entraînent quels achats.
Comme indiqué plus haut, la RHS est le conséquent — l'article que l'on suppose que le client achètera. Les positions en LHS indiquent l'ordre : 2 est l’ajout le plus récent au panier, 1 est l’article présent auparavant.
# Filter top 20 rules with highest lift
subRules2<-head(subRules, n=20, by="lift")
plot(subRules2, method="paracoord")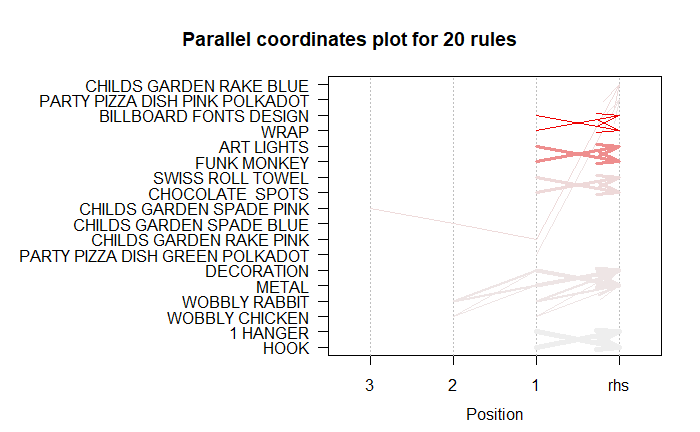
Regardez la flèche la plus haute : lorsque j'ai « CHILDS GARDEN SPADE PINK » et « CHILDS GARDEN RAKE PINK » dans mon panier, il est probable que j’achète aussi « CHILDS GARDEN RAKE BLUE ».
Félicitations ! Vous avez découvert APRIORI, l’un des algorithmes les plus utilisés en fouille de données. Vous avez vu les règles d'association, leurs applications, et leur mise en pratique en retail via la Market Basket Analysis. Vous savez maintenant implémenter la Market Basket Analysis en R et présenter vos règles avec des visualisations percutantes. Bonne continuation !
Pour aller plus loin avec R, suivez le cours Importing and Managing Financial Data in R de DataCamp.
En savoir plus sur R
Cours
Cours
Cours