Curso
Importando e Gerenciando Dados Financeiros em R
5 h
21K
Você é um cientista de dados (ou está se tornando um!) e recebe um cliente que tem uma loja de varejo. Esse cliente te entrega os dados de todas as transações — os itens comprados na loja por diversos clientes ao longo do tempo — e pede para você usar essas informações para impulsionar o negócio. As suas descobertas vão orientar não só ajustes no estoque (incluir/retirar/atualizar produtos), mas também mudanças no layout da loja física ou do e-commerce. Para gerar insights que ajudem seu cliente, você vai usar a Market Basket Analysis (MBA), que aplica mineração de regras de associação sobre os dados de transações.
Neste tutorial você vai aprender:
A mineração de regras de associação é usada quando queremos identificar associações entre diferentes objetos em um conjunto, encontrar padrões frequentes em um banco de transações, bancos relacionais ou qualquer outro repositório de informações. Suas aplicações aparecem em Marketing, análise de cesta (Market Basket Analysis) no varejo, clusterização e classificação. Ela mostra que itens os clientes costumam comprar juntos, gerando um conjunto de regras chamadas regras de associação. Em palavras simples, o resultado são regras no formato se isso, então aquilo. Os clientes podem usar essas regras em várias estratégias de marketing, como:
Considere o exemplo a seguir:
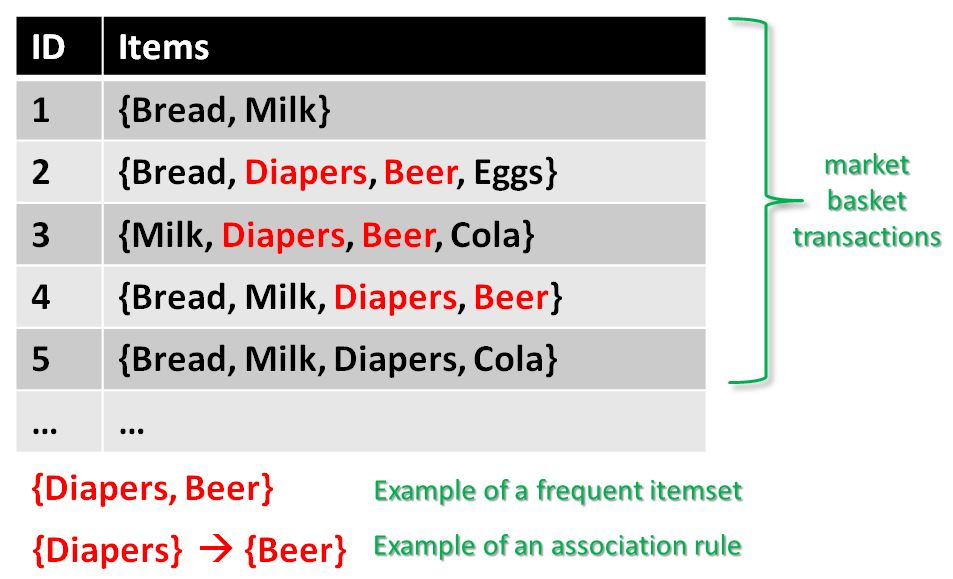
Temos um conjunto de dados de transações numeradas de 1 a 5. Cada transação lista os itens comprados. Note que fralda é comprada com cerveja em três transações. De forma parecida, pão é comprado com leite em três transações — ambos são conjuntos de itens frequentes. As regras de associação são escritas no formato abaixo:
$A=>B[Support,Confidence]$
A parte antes de $=>$ é o se (antecedente) e a parte depois é o então (consequente).
Onde A e B são conjuntos de itens nas transações. A e B são conjuntos disjuntos.
$Computer=>Anti-virus Software[Support=20\%,confidence=60\%]$
Essa regra diz que:
Na próxima seção você vai ver os conceitos básicos de mineração de regras de associação:
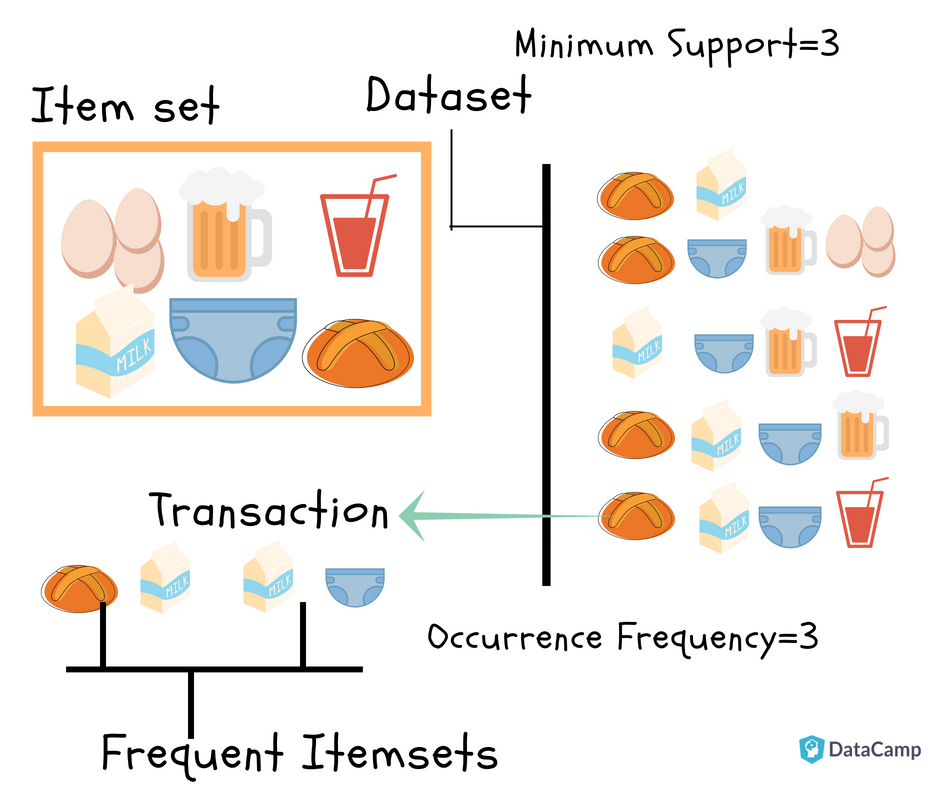
Itemset (conjunto de itens): Coleção de um ou mais itens. K-itemset é um conjunto com k itens.
Contagem de suporte: Frequência de ocorrência de um itemset.
Suporte (s): Fração de transações que contêm o itemset "X"
$Support(X)=\frac{frequency(X)}{N}$
Para uma regra A=>B, o suporte é dado por:
$Support(A=>B)=\frac{frequency(A,B)}{N}$
Observação: P(A∪B) é a probabilidade de A e B ocorrerem juntos. P denota probabilidade.
Tente calcular o suporte para Milk=>Diaper como exercício.
$Confidence(A=>B)=\frac{P(A\cap B)}{P(A)}=\frac{frequency(A,B)}{frequency(A)}$
Ou seja, o número de transações com A e B dividido pelo total de transações que têm A.
$Confidence(Bread=>Milk)=\frac{3}{4}=0.75=75\%$
Agora calcule a confiança de Milk=>Diaper.
Observação: Suporte e confiança medem o quão interessante é a regra. Definimos limites mínimos (min_support e min_confidence). Esses thresholds, definidos pelo cliente, ajudam a comparar a força das regras. Quanto mais próximos ou acima do limite, mais útil a regra tende a ser.
Itemsets frequentes: Conjuntos de itens cujo suporte é maior ou igual ao suporte mínimo (min_sup). No exemplo acima, min_sup=3. Esse valor é definido pelo usuário.
Regras fortes: Se uma regra A=>B[Support, Confidence] atende min_sup e min_confidence, ela é considerada forte.
Lift: O lift indica a correlação entre A e B na regra A=>B. A correlação mostra como o itemset A afeta o itemset B.
$Lift(A=>B)=\frac{Support}{Supp(A)Supp(B)}$
Por exemplo, para a regra {Bread}=>{Milk}, o lift é calculado assim:
$support(Bread)=\frac{4}{5}=0.8$
$support(Milk)=\frac{4}{5}=0.8$
$Lift(Bread=>Milk)=\frac{0.6}{0.8*0.8}=0.9$
Se o lift for 1, A e B são independentes e não há regra útil entre eles.
Se o lift for > 1, A e B são dependentes, e o grau dessa dependência é dado pelo valor do lift.
Se o lift for < 1, a presença de A tem efeito negativo sobre B.
Ao aplicar a mineração de regras de associação a um conjunto de transações T, seu objetivo é encontrar todas as regras com:
Nesta parte do tutorial, você vai conhecer o algoritmo por trás das bibliotecas de R para Market Basket Analysis. Isso ajuda a entender melhor o problema do cliente e a analisar com mais precisão. Se você já conhece o algoritmo APRIORI e como ele funciona, pode pular direto para a parte de código.
A mineração de regras de associação é vista como um processo em duas etapas:
Geração de itemsets frequentes: encontrar todos os itemsets frequentes com suporte >= min_support pré-definido
Geração de regras: listar todas as regras de associação a partir dos itemsets frequentes. Calcular suporte e confiança de todas as regras. Podar as regras que não atendem os thresholds de min_support e min_confidence.
Gerar itemsets frequentes é a etapa mais custosa computacionalmente porque exige varrer todo o banco de dados.
Entre as etapas acima, a geração de itemsets frequentes é a mais pesada em termos de computação.
Acima vimos um exemplo com apenas 5 transações, mas na prática os dados de varejo podem chegar a GBs e TBs — por isso é preciso um algoritmo otimizado para descartar itemsets que não ajudarão nas etapas seguintes. É aí que entra o algoritmo APRIORI. Ele estabelece que:
Qualquer subconjunto de um itemset frequente também deve ser frequente. Em outras palavras, não devemos gerar ou testar supersets de um itemset infrequente.
Isso é representado no itemset lattice, uma representação gráfica do princípio do APRIORI. Ele consiste em nós de k-itemsets e as relações de subconjuntos desse k-itemset.
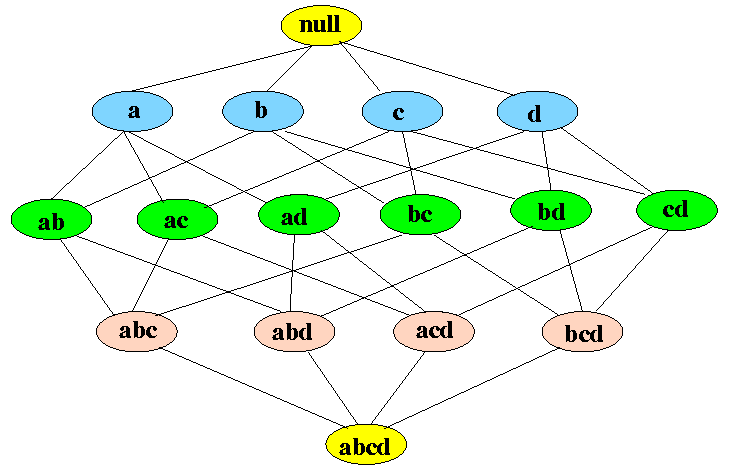
No diagrama acima, a base são todos os itens nos dados de transação; depois vamos subindo criando subconjuntos até o conjunto vazio. Para d itens, o tamanho do lattice será $2^d$. Isso mostra como seria custoso gerar itemsets frequentes calculando suporte para cada combinação. A figura seguinte mostra quanto o APRIORI ajuda a reduzir o número de conjuntos a gerar:
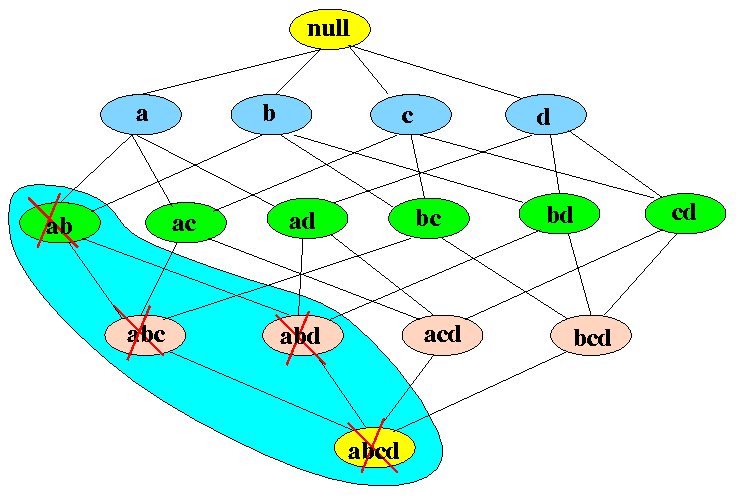
Se o itemset {a,b} é infrequente, não precisamos considerar nenhum de seus supersets.
Vamos entender com um exemplo. No exemplo a seguir, você verá por que o APRIORI é eficaz e também como gerar regras de associação fortes passo a passo. Pegue seu caderno e venha junto!
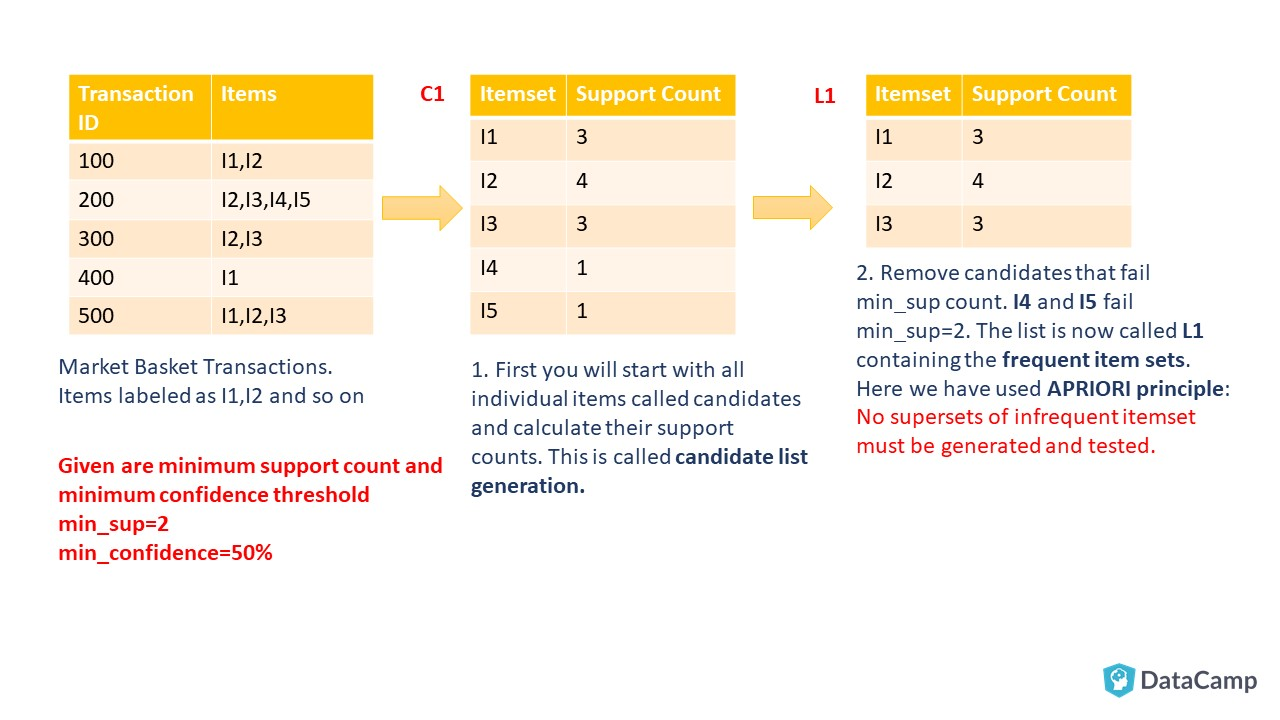
Como você vê, começamos criando a lista de candidatos para os 1-itemsets, que inclui individualmente todos os itens presentes nos dados. Considerando dados reais de varejo, dá para imaginar o custo de gerar candidatos. Aqui o APRIORI ajuda a reduzir a lista de candidatos e, ao final, regras úteis são geradas. Nos próximos passos, veremos como chegar ao fim da geração de itemsets frequentes — a primeira etapa da mineração de regras de associação.
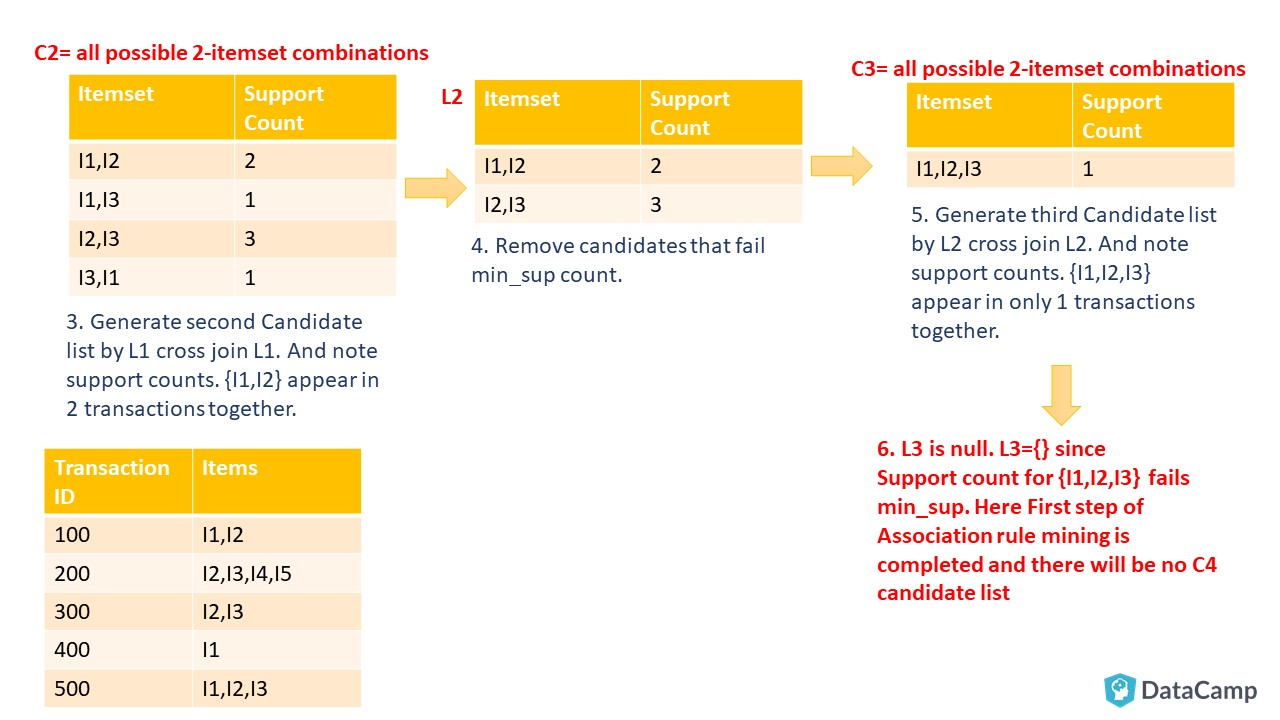
O próximo passo é listar todos os itemsets frequentes. Você vai pegar o último itemset frequente não vazio, que neste exemplo é L2={I1, I2},{I2, I3}. Em seguida, gerar todos os subconjuntos não vazios dos itemsets presentes nessa lista de itemsets frequentes. Acompanhe como na ilustração abaixo:
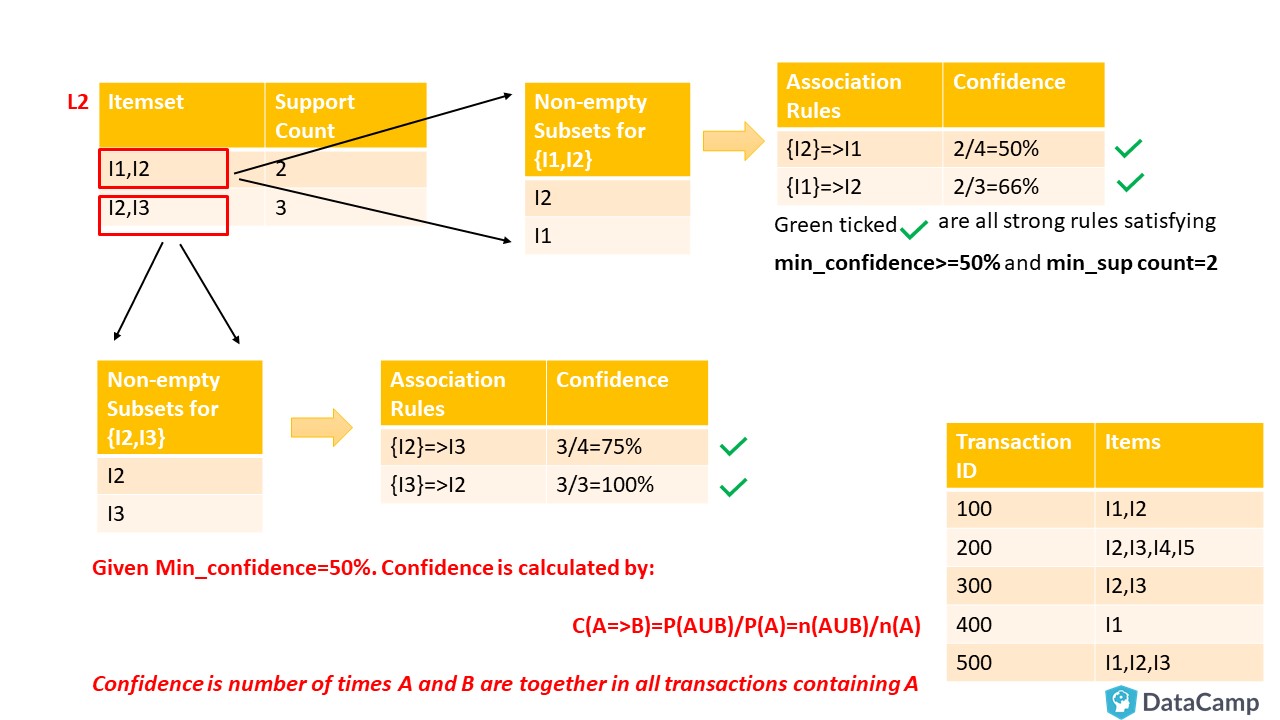
Acima vemos quatro regras fortes. Por exemplo, ${I2}=>I3$ com confiança de 75% indica que 75% das pessoas que compraram I2 também compraram I3.
Pronto: você aprendeu o algoritmo APRIORI, um dos mais usados em mineração de dados. Bora para o código!
Neste tutorial, vamos usar um dataset do UCI Machine Learning Repository. O conjunto se chama Online-Retail e pode ser baixado aqui. Ele contém transações de 01/12/2010 a 09/12/2011 de um varejista online sem loja física registrado no Reino Unido. O motivo de usar este, e não um dataset nativo do R, é que você provavelmente receberá dados de varejo neste formato e terá que fazer pré-processamento.
Primeiro, vamos carregar as bibliotecas necessárias. Uma breve descrição (retirada daqui) está na tabela a seguir para você saber o que cada uma faz:
| Package | Description |
|---|---|
arules |
Fornece a infraestrutura para representar, manipular e analisar dados de transações e padrões (itemsets frequentes e regras de associação). |
arulesViz |
Estende o pacote 'arules' com várias técnicas de visualização para regras de associação e itemsets. Inclui visualizações interativas para explorar regras. |
tidyverse |
Conjunto opinativo de pacotes R voltados a ciência de dados |
readxl |
Ler arquivos Excel no R |
plyr |
Ferramentas para dividir, aplicar e combinar dados |
ggplot2 |
Criar gráficos e visualizações |
knitr |
Geração de relatórios dinâmicos no R |
lubridate |
O lubridate facilita trabalhar com datas e horas no R. |
#install and load package arules
#install.packages("arules")
library(arules)
#install and load arulesViz
#install.packages("arulesViz")
library(arulesViz)
#install and load tidyverse
#install.packages("tidyverse")
library(tidyverse)
#install and load readxml
#install.packages("readxml")
library(readxl)
#install and load knitr
#install.packages("knitr")
library(knitr)
#load ggplot2 as it comes in tidyverse
library(ggplot2)
#install and load lubridate
#install.packages("lubridate")
library(lubridate)
#install and load plyr
#install.packages("plyr")
library(plyr)
library(dplyr)Use read_excel(path to file) para ler o arquivo baixado no R. Informe o caminho completo, incluindo o nome do arquivo, em read_excel(path-to-file-with-filename)
#read excel into R dataframe
retail <- read_excel('D:/Documents/Online_Retail.xlsx')
#complete.cases(data) will return a logical vector indicating which rows have no missing values. Then use the vector to get only rows that are complete using retail[,].
retail <- retail[complete.cases(retail), ]
#mutate function is from dplyr package. It is used to edit or add new columns to dataframe. Here Description column is being converted to factor column. as.factor converts column to factor column. %>% is an operator with which you may pipe values to another function or expression
retail %>% mutate(Description = as.factor(Description))
retail %>% mutate(Country = as.factor(Country))#Converts character data to date. Store InvoiceDate as date in new variable
retail$Date <- as.Date(retail$InvoiceDate)
#Extract time from InvoiceDate and store in another variable
TransTime<- format(retail$InvoiceDate,"%H:%M:%S")
#Convert and edit InvoiceNo into numeric
InvoiceNo <- as.numeric(as.character(retail$InvoiceNo))NAs introduced by coercion#Bind new columns TransTime and InvoiceNo into dataframe retail
cbind(retail,TransTime)cbind(retail,InvoiceNo)#get a glimpse of your data
glimpse(retail)Observations: 406,829
Variables: 9
$ InvoiceNo <chr> "536365", "536365", "536365", "536365", "536365", "536365", "53...
$ StockCode <chr> "85123A", "71053", "84406B", "84029G", "84029E", "22752", "2173...
$ Description <chr> "WHITE HANGING HEART T-LIGHT HOLDER", "WHITE METAL LANTERN", "C...
$ Quantity <dbl> 6, 6, 8, 6, 6, 2, 6, 6, 6, 32, 6, 6, 8, 6, 6, 3, 2, 3, 3, 4, 4,...
$ InvoiceDate <dttm> 2010-12-01 08:26:00, 2010-12-01 08:26:00, 2010-12-01 08:26:00,...
$ UnitPrice <dbl> 2.55, 3.39, 2.75, 3.39, 3.39, 7.65, 4.25, 1.85, 1.85, 1.69, 2.1...
$ CustomerID <dbl> 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, ...
$ Country <chr> "United Kingdom", "United Kingdom", "United Kingdom", "United K...
$ Date <date> 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 20...Agora o dataframe retail terá 10 atributos, com dois adicionais: Date e Time.
Antes de aplicar MBA/mineração de regras de associação, precisamos converter o dataframe em dados de transação, de forma que todos os itens comprados juntos em uma mesma nota fiquem em uma única linha. No output do glimpse dá para ver que cada transação está em formato atômico — todos os produtos de uma nota estão atomizados como em bancos relacionais. Esse formato também é chamado de singles.
Você precisa agrupar os dados do retail por CustomerID, CustomerID e Date, ou agrupar por InvoiceNo e Date. Vamos aplicar uma função nesse agrupamento e salvar a saída em outro dataframe. Isso pode ser feito com ddply.
As linhas abaixo combinam todos os produtos de um mesmo InvoiceNo e Date em uma linha, com cada item separado por ,
library(plyr)
#ddply(dataframe, variables_to_be_used_to_split_data_frame, function_to_be_applied)
transactionData <- ddply(retail,c("InvoiceNo","Date"),
                       function(df1)paste(df1$Description,
                       collapse = ","))
#The R function paste() concatenates vectors to character and separated results using collapse=[any optional charcater string ]. Here ',' is usedtransactionDataEm seguida, como InvoiceNo e Date não serão úteis na mineração de regras, podemos definir como NULL.
#set column InvoiceNo of dataframe transactionData
transactionData$InvoiceNo <- NULL
#set column Date of dataframe transactionData
transactionData$Date <- NULL
#Rename column to items
colnames(transactionData) <- c("items")
#Show Dataframe transactionData
transactionDataEsse formato de dados de transação é chamado de formato basket. Agora, salve esses dados em um arquivo .csv (Comma Separated Values) usando write.csv()
write.csv(transactionData,"D:/Documents/market_basket_transactions.csv", quote = FALSE, row.names = FALSE)
#transactionData: Data to be written
#"D:/Documents/market_basket.csv": location of file with file name to be written to
#quote: If TRUE it will surround character or factor column with double quotes. If FALSE nothing will be quoted
#row.names: either a logical value indicating whether the row names of x are to be written along with x, or a character vector of row names to be written.
Confira se os dados ficaram no formato correto:
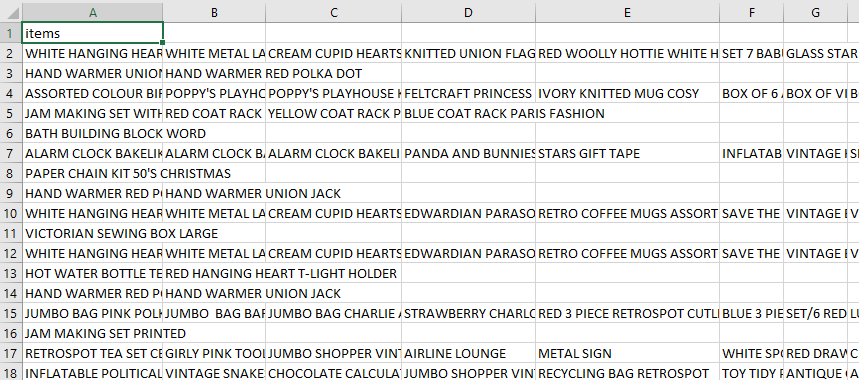
Agora vamos carregar esse CSV em um objeto da classe transaction. Use a função read.transactions do pacote arules.
O código abaixo lê o arquivo D:/Documents/market_basket_transactions.csv no formato basket e converte em um objeto da classe transaction.
tr <- read.transactions('D:/Documents/market_basket_transactions.csv', format = 'basket', sep=',')
#sep tell how items are separated. In this case you have separated using ','
Ao executar, você pode ver várias mensagens EOF within quoted string — não se preocupe.
Se você já tem os dados de transação em um dataframe, use a linha abaixo para converter em transaction:
`trObj<-as(dataframe.dat,"transactions")`Veja o objeto tr:
tr
transactions in sparse format with
 22191 transactions (rows) and
30066 items (columns) summary(tr)transactions in sparse format with
22191 transactions (rows) and
7876 items (columns)
transactions as itemMatrix in sparse format with
22191 rows (elements/itemsets/transactions) and
7876 columns (items) and a density of 0.001930725
most frequent items:
WHITE HANGING HEART T-LIGHT HOLDER REGENCY CAKESTAND 3 TIER
1803 1709
JUMBO BAG RED RETROSPOT PARTY BUNTING
1460 1285
ASSORTED COLOUR BIRD ORNAMENT (Other)
1250 329938
element (itemset/transaction) length distribution:
sizes
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
3598 1594 1141 908 861 758 696 676 663 593 624 537 516 531 551 522 464
18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34
441 483 419 395 315 306 272 238 253 229 213 222 215 170 159 138 142
35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51
134 109 111 90 113 94 93 87 88 65 63 67 63 60 59 49 64
52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68
40 41 49 43 36 29 39 30 27 28 17 25 25 20 27 24 22
69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85
15 20 19 13 16 16 11 15 12 7 9 14 15 12 8 9 11
86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102
11 14 8 6 5 6 11 6 4 4 3 6 5 2 4 2 4
103 104 105 106 107 108 109 110 111 112 113 114 116 117 118 120 121
4 3 2 2 6 3 4 3 2 1 3 1 3 3 3 1 2
122 123 125 126 127 131 132 133 134 140 141 142 143 145 146 147 150
2 1 3 2 2 1 1 2 1 1 2 2 1 1 2 1 1
154 157 168 171 177 178 180 202 204 228 236 249 250 285 320 400 419
3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1
Min. 1st Qu. Median Mean 3rd Qu. Max.
1.00 3.00 10.00 15.21 21.00 419.00
includes extended item information - examples:
labels
1 1 HANGER
2 10 COLOUR SPACEBOY PEN
3 12 COLOURED PARTY BALLOONSsummary(tr) é um comando bem útil que traz informações sobre o objeto de transações. O que esse output diz:
Existem 22191 transações (linhas) e 7876 itens (colunas). Note que 7876 são as descrições de produtos no dataset e 22191 transações são combinações desses itens.
Densidade indica a porcentagem de células não nulas na matriz esparsa. Dá para ver como o total de itens comprados dividido pelo total possível de células. Você pode estimar quantos itens foram comprados usando a densidade: 22191x7876x0.001930725=337445
Informação! Matriz esparsa: é uma matriz em que a maioria dos elementos é zero. Em contraste, se a maioria for diferente de zero, a matriz é densa. A razão entre elementos zero e o total é a esparsidade (que é 1 menos a densidade).
O summary também mostra os itens mais frequentes.
Distribuição do tamanho dos itemsets/transações: quantas transações existem com 1 item, 2 itens e assim por diante. A primeira linha mostra o nº de itens e a segunda, o nº de transações.
Por exemplo, há 3598 transações com um único item, 1594 com 2 itens, e existe uma transação com 419 itens — a mais longa.
Você pode gerar um itemFrequencyPlot (gráfico de barras) para ver a distribuição dos objetos com base em um itemMatrix (ex.: >transactions ou itens em >itemsets e >rules), que é o nosso caso.
# Create an item frequency plot for the top 20 items
if (!require("RColorBrewer")) {
  # install color package of R
install.packages("RColorBrewer")
#include library RColorBrewer
library(RColorBrewer)
}
itemFrequencyPlot(tr,topN=20,type="absolute",col=brewer.pal(8,'Pastel2'), main="Absolute Item Frequency Plot")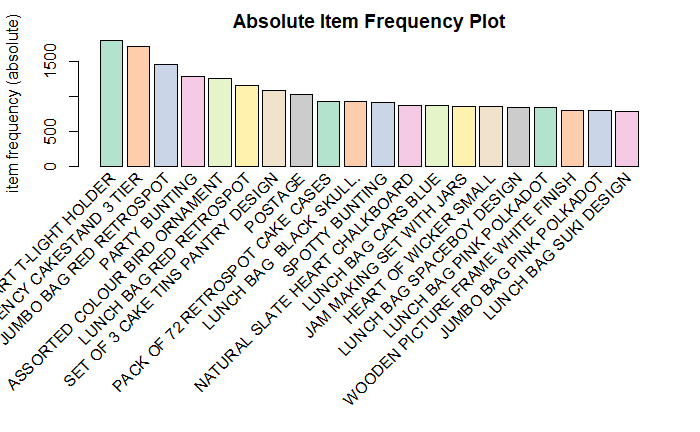
Em
itemFrequencyPlot(tr,topN=20,type="absolute")o primeiro argumento é o objeto de transações a ser plotado, tr. topN define quantos itens mais frequentes exibir. type pode ser type="absolute" ou type="relative". Em absoluto, plota as frequências numéricas de cada item. Em relativo, mostra quantas vezes os itens aparecem em comparação aos demais.
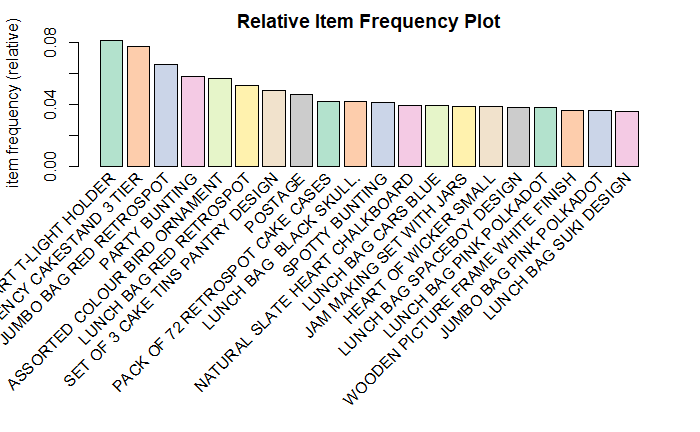
itemFrequencyPlot(tr,topN=20,type="relative",col=brewer.pal(8,'Pastel2'),main="Relative Item Frequency Plot")Esse gráfico mostra que 'WHITE HANGING HEART T-LIGHT HOLDER' e 'REGENCY CAKESTAND 3 TIER' são os mais vendidos. Para aumentar as vendas de 'SET OF 3 CAKE TINS PANTRY DESIGN', o varejista pode posicioná-lo perto de 'REGENCY CAKESTAND 3 TIER'.
Confira outras opções de itemFrequencyPlot aqui.
O próximo passo é minerar as regras usando o algoritmo APRIORI. A função apriori() é do pacote arules.
# Min Support as 0.001, confidence as 0.8.
association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=10))
Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.11s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.70s].
writing ... [49122 rule(s)] done [0.06s].
creating S4 object ... done [0.06s]. set of 49122 rules
rule length distribution (lhs + rhs):sizes
2 3 4 5 6 7 8 9 10
105 2111 6854 16424 14855 6102 1937 613 121
Min. 1st Qu. Median Mean 3rd Qu. Max.
2.000 5.000 5.000 5.499 6.000 10.000
summary of quality measures:
support confidence lift count
Min. :0.001036 Min. :0.8000 Min. : 9.846 Min. : 23.00
1st Qu.:0.001082 1st Qu.:0.8333 1st Qu.: 22.237 1st Qu.: 24.00
Median :0.001262 Median :0.8788 Median : 28.760 Median : 28.00
Mean :0.001417 Mean :0.8849 Mean : 64.589 Mean : 31.45
3rd Qu.:0.001532 3rd Qu.:0.9259 3rd Qu.: 69.200 3rd Qu.: 34.00
Max. :0.015997 Max. :1.0000 Max. :715.839 Max. :355.00
mining info:
data ntransactions support confidence
tr 22191 0.001 0.8apriori recebe tr como o objeto de transações a ser minerado. Em parameter você define min_sup e min_confidence. Os valores padrão são suporte mínimo 0.1, confiança mínima 0.8 e até 10 itens por regra (maxlen).
summary(association.rules) mostra:
Parâmetros: min_sup=0.001 e min_confidence=0.8, com no máximo 10 itens por regra.
Total de regras: 49122 regras
Distribuição do tamanho das regras: regras com 5 itens são a maioria: 16424; regras com 2 itens são as menos numerosas: 105
Resumo das medidas de qualidade: valores mínimos e máximos de suporte, confiança e lift.
Informações da mineração: dados, suporte e confiança usados.
Como são 49122 regras, vamos imprimir só as 10 primeiras:
inspect(association.rules[1:10]) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82000 28
[2] {WOBBLY CHICKEN} => {DECORATION} 0.001261773 1 443.82000 28
[3] {DECOUPAGE} => {GREETING CARD} 0.001036456 1 389.31579 23
[4] {BILLBOARD FONTS DESIGN} => {WRAP} 0.001306836 1 715.83871 29
[5] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82000 34
[6] {WOBBLY RABBIT} => {DECORATION} 0.001532153 1 443.82000 34
[7] {FUNK MONKEY} => {ART LIGHTS} 0.001712406 1 583.97368 38
[8] {ART LIGHTS} => {FUNK MONKEY} 0.001712406 1 583.97368 38
[9] {BLACK TEA} => {SUGAR JARS} 0.002072912 1 238.61290 46
[10] {BLACK TEA} => {COFFEE} 0.002072912 1 69.34687 46 A partir desse output, você pode concluir, por exemplo:
100% dos clientes que compraram 'WOBBLY CHICKEN' também compraram 'METAL'.
100% dos clientes que compraram 'BLACK TEA' também compraram 'SUGAR JARS'.
Como limitar a quantidade e o tamanho das regras geradas? Ajustando os parameters no apriori. Aumente conf para regras mais fortes e maxlen para permitir regras mais longas.
shorter.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=3))Você pode remover regras que são subconjuntos de regras maiores. Use o código abaixo para filtrar essas regras:
subset.rules <- which(colSums(is.subset(association.rules, association.rules)) > 1) # get subset rules in vector
length(subset.rules)  #> 3913
[1] 44014subset.association.rules. <- association.rules[-subset.rules] # remove subset rules.
which(): retorna as posições dos elementos TRUE em um vetor.
colSums(): soma por coluna em dataframes e arrays numéricos.
is.subset(): determina se elementos de um vetor contêm todos os elementos de outro.
Às vezes você quer focar em um produto específico. Para descobrir o que influencia a compra do item X, use a opção appearance em apriori. Com appearance você define o LHS (parte SE) e o RHS (parte ENTÃO) da regra.
Por exemplo, para descobrir o que os clientes compram antes de comprar 'METAL', rode:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(default="lhs",rhs="METAL"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.21s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.63s].
writing ... [5 rule(s)] done [0.07s].
creating S4 object ... done [0.02s]. # Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[2] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34
[3] {DECORATION} => {METAL} 0.002253166 1 443.82 50
[4] {DECORATION,WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[5] {DECORATION,WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34 Da mesma forma, para responder à pergunta Clientes que compraram METAL também compraram..., deixe METAL no lhs:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(lhs="METAL",default="rhs"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.10s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 done [0.01s].
writing ... [1 rule(s)] done [0.00s].
creating S4 object ... done [0.01s].# Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {METAL} => {DECORATION} 0.002253166 1 443.82 50 Como os dados podem gerar centenas ou milhares de regras, você precisa de boas formas de apresentar seus achados. Já falamos do ItemFrequencyPlot, ótimo para ver os itens mais vendidos.
Vamos ver as seguintes visualizações:
Uma visualização direta das regras é o scatter plot usando plot() do arulesViz. Os eixos usam suporte e confiança; o lift colore os pontos (tons de cinza por padrão).
# Filter rules with confidence greater than 0.4 or 40%
subRules<-association.rules[quality(association.rules)$confidence>0.4]
#Plot SubRules
plot(subRules)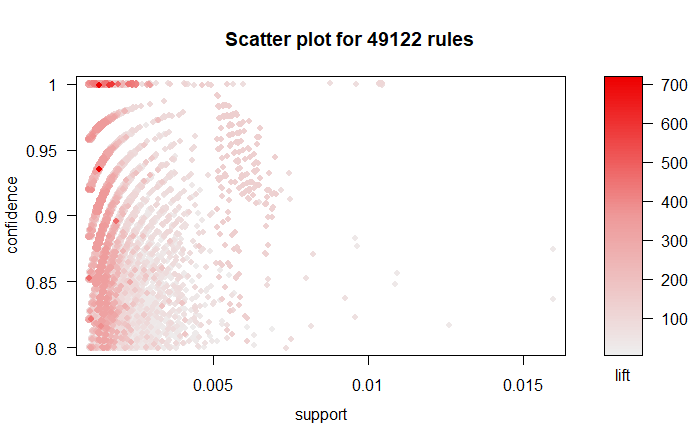
O gráfico acima mostra que regras com lift alto costumam ter suporte baixo. Você pode usar as opções abaixo:
plot(rulesObject, measure, shading, method)rulesObject: o objeto de regras a ser plotado
measure: medidas de interesse (Support, Confidence, lift) — ou combinações, conforme o method.
shading: medida usada para colorir os pontos (Support, Confidence, lift). Padrão: Lift.
method: método de visualização (scatterplot, two-key plot, matrix3D).
plot(subRules,method="two-key plot")
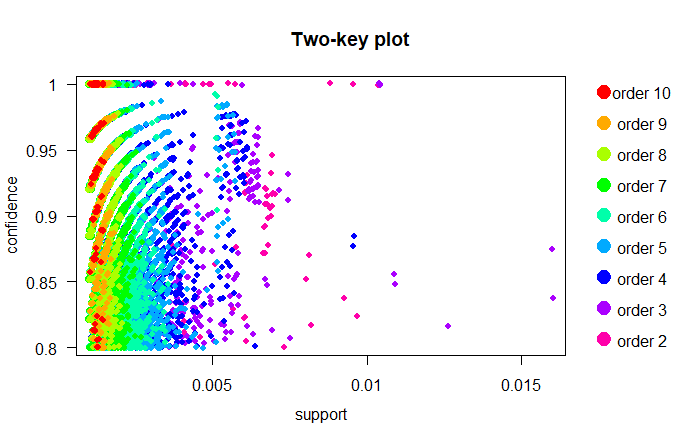
O two-key plot usa suporte (x) e confiança (y). A cor representa a ordem — o número de itens na regra.
Uma visualização interativa excelente combina arulesViz e plotly. Você pode passar o mouse sobre cada regra e ver todas as métricas (suporte, confiança e lift).
plotly_arules(subRules)'plotly_arules' is deprecated.
Use 'plot' instead.
See help("Deprecated")plot: Too many rules supplied. Only plotting the best 1000 rules using measure lift (change parameter max if needed)To reduce overplotting, jitter is added! Use jitter = 0 to prevent jitter.Técnicas baseadas em grafos representam regras com vértices e arestas: vértices rotulados com nomes de itens e um segundo conjunto de vértices para itemsets ou regras. Itens se conectam a itemsets/regras por setas direcionadas. Setas de itens para vértices de regra indicam LHS; de regra para item indicam RHS. Tamanho e cor dos vértices costumam representar medidas de interesse.
Gráficos em grafo são ótimos, mas ficam poluídos com muitas regras. Então é melhor visualizar menos regras nesses casos.
Vamos selecionar 10 regras de subRules com maior confiança.
top10subRules <- head(subRules, n = 10, by = "confidence")Agora, plote um grafo interativo:
Observação: Você pode tornar todos os gráficos interativos usando engine=htmlwidget em plot
plot(top10subRules, method = "graph", engine = "htmlwidget")
No arulesViz, grafos de conjuntos de regras de associação podem ser exportados em GraphML ou como Graphviz dot-file para ferramentas como o Gephi. Por exemplo, para exportar as 1000 regras com maior lift:
saveAsGraph(head(subRules, n = 1000, by = "lift"), file = "rules.graphml")Também chamada de parallel coordinates plot. Útil para visualizar quais produtos, combinados com outros itens, influenciam certos resultados de venda.
Como citado, o RHS é o consequente — o item que sugerimos que o cliente comprará; as posições no LHS mostram que 2 é a adição mais recente ao carrinho e 1 é o item previamente adicionado.
# Filter top 20 rules with highest lift
subRules2<-head(subRules, n=20, by="lift")
plot(subRules2, method="paracoord")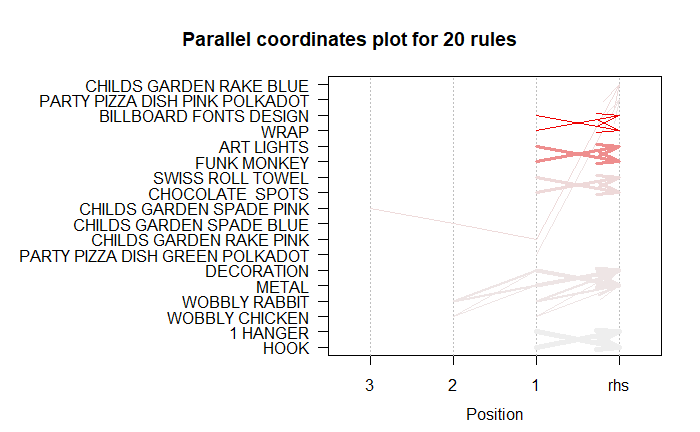
Veja a seta superior: quando tenho 'CHILDS GARDEN SPADE PINK' e 'CHILDS GARDEN RAKE PINK' no carrinho, é provável que eu compre também 'CHILDS GARDEN RAKE BLUE'.
Parabéns! Você aprendeu o APRIORI, um dos algoritmos mais usados em mineração de dados. Viu os fundamentos da mineração de regras de associação, suas aplicações e como isso se traduz no varejo com a Market Basket Analysis. Você também já está pronto para implementar Market Basket Analysis em R e apresentar suas regras com visualizações de impacto. Bons estudos!
Se você quer aprender mais sobre R, faça o curso da DataCamp Importing and Managing Financial Data in R.
Aprenda mais sobre R
Curso
Curso
Curso
blog
Javier Canales Luna
14 min
blog
Joleen Bothma
12 min
blog
Elena Kosourova
14 min
Tutorial
Eugenia Anello
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Arunn Thevapalan
15 min





