Kurs
Maschinelles Lernen mit caret in R
4 Std.
60.8K
Wenn du eine Einführung in Machine Learning brauchst, mach den DataCamp-Kurs Introduction to Machine Learning und sieh dir das Tutorial Introduction to Machine Learning in Python an.
Verwende unterschiedliche Machine-Learning-(ML-)Klassifikationsalgorithmen, um Schritt für Schritt Modelle zu bauen, die das Genre eines Songs und seinen möglichen Erfolg in den Billboard-Charts vorhersagen – allein auf Basis der Lyrics!
Dies ist Teil drei einer dreiteiligen Tutorial-Reihe. Du verwendest weiterhin R, um verschiedene Analysen anhand einer Fallstudie mit Songtexten der Musiklegende Prince sowie anderer Künstlerinnen, Künstler und Autorinnen/Autoren durchzuführen. Die drei Tutorials behandeln:
Als Data Scientist musst du überwachtes und unüberwachtes Lernen verstehen. Dieses Tutorial erklärt eine Form des überwachten Lernens – die Klassifikation – und zeigt einen musikalischen Anwendungsfall auf Basis der Liedtexte verschiedener Künstlerinnen und Künstler (sowie einiger Buchautorinnen und -autoren). Du lernst, wie du Modelle baust, die Songs ihrem Genre zuordnen und prüfst, ob sich aus Lyrics ein kommerzieller Erfolg ableiten lässt.
Hast du schon mal Musikstreaming mit automatischen Empfehlungen wie Pandora, iHeart Radio oder Spotify genutzt? Wenn du einen Hard-Rock-Sender einstellst, erwartest du wohl kaum einen Country-Song über Cowboy-Stiefel und Kleinstädte. Übliche Empfehlungssysteme fokussieren auf Klangeigenschaften; die Analyse von Lyrics taucht erst langsam in Forschungsarbeiten auf. Mit den Techniken in diesem Tutorial nutzt du aktuelle Methoden aus der Forschung, um neue Ideen für dieses wachsende Feld zu entwickeln.
Dieses Tutorial setzt Grundwissen im Text Mining mit tidytext voraus. Es ist eine mittlere Einführung in ML-Techniken anhand populärer Klassifikationsalgorithmen. Empfehlenswert sind solide R-Erfahrung, idealerweise mit Grundkenntnissen in Machine Learning, und der Wunsch, die Anwendung und Implementierung anhand praxisnaher Use Cases zu vertiefen. Die Algorithmen werden nur kurz erklärt, für tiefergehende Infos gibt es jeweils Links.
Im gesamten Artikel nutzt du das R-Framework mlr für Machine-Learning-Experimente. Auch wenn das Tutorial nicht über mlr selbst geht, setzt du es als Interface für den ML-Prozess intensiv ein. Ziel ist, mit mlr die Schritte zum Modellaufbau über verschiedene Algorithmen zu vereinfachen. Sehr zu empfehlen ist dieses umfassende Tutorial zum Paket.
ML hat viele Facetten – in diesem Tutorial kratzt du nur an der Oberfläche. Anders als in Teil eins und zwei bleiben möglicherweise mehr Fragen offen. Am meisten profitierst du, wenn du mit eigenen Daten und Code mitarbeitest und die Algorithmen in deinem Tempo recherchierst.
Hier ist der grobe Ablauf, um deine Modelle zu erstellen:
Abschnitt eins: Lerne, wie du Genres anhand lyrischer Merkmale vorhersagst.
Sieh dir die vorherigen Tutorials an, um Daten und Nuancen wirklich zu verstehen. Behalte im Hinterkopf: Mining und Predictive Analytics auf Songtexten sind komplexer als bei Sachtexten – Kontext, Bedeutung und subtile Botschaften liegen oft unter kreativen Nuancen verborgen. Wie in Teil zwei-B zum Topic Modeling arbeitest du weiter mit Künstlerinnen/Künstlern verschiedener Genres sowie mit Inhalten zweier Bücher zum Machine Learning (Genre Data Science – um eine weitere Textform einzubringen).
Starte mit dem Laden der Bibliotheken und wirf dann einen Blick auf die Datenstruktur.
 library(tidyverse) #tidyr, #dplyr, #magrittr, #ggplot2
library(tidytext) #unnesting text into single words
library(mlr) #machine learning framework for R
library(kableExtra) #create attractive tables
library(circlize) #cool circle plots
library(jpeg) #read in jpg files for the circle plots

#define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c( "condensed", "bordered"),
                full_width = FALSE)
}Wie in den vorherigen Tutorials wirkt der Code für den folgenden Kreisplot komplex, aber einer coolen Grafik kann ich nicht widerstehen. Er zeigt ein Album-/Buchcover für jede Künstlerin/jeden Künstler bzw. jede Autorin/jeden Autor in deinen Daten – für Trainings- und Testdaten. Mehr Details zum Paket circlize findest du in diesem Buch von Zuguang Gu.
 #read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)

#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#check out the circlize package for details!
circos.clear() #very important!
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)
Um den Fokus aufs Modellieren zu legen, habe ich die Datenaufbereitung außerhalb dieses Tutorials erledigt und stelle dir alles für die Analyse bereit. Zusammenfassung des Preprocessings:
pdf_text() aus dem Paket pdftools den Inhalt zweier Bücher gesammelt (jede Seite ist ein eigenes Dokument)Im Folgenden liest du Trainings- und Testdaten ein, die bereits getrennt vorliegen. Danach erzeugst du mit unnest() aus tidytext die Tidy-Version mit einem Wort pro Zeile.
 five_sources_data <- read.csv("five_sources_data_balanced.csv", stringsAsFactors = FALSE)

five_sources_tidy <- five_sources_data %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

five_sources_data_test <- read.csv("five_sources_data_test.csv", stringsAsFactors = FALSE)

five_sources_test_tidy <- five_sources_data_test %>%
  unnest_tokens(word, text) %>%
  anti_join(stop_words)

#very small file that has a couple of words that help to identify certain genres
explicit_words <- read.csv("explicit_words.csv", stringsAsFactors = FALSE)Jetzt, wo du Trainings- und Testdaten geladen und aufbereitet hast, siehst du, wie viele Songs pro Künstlerin/Künstler bzw. Autorin/Autor existieren. Da der Datensatz Songs und Buchseiten enthält, nenne ich beides ein Dokument. Die Features, die du erstellst, basieren auf Dokumenten und ihrer Metadaten – dieses Konzept ist wichtig. Weil es Künstlerinnen/Künstler und Autorinnen/Autoren gibt, bezeichne ich sie als Quelle jedes Dokuments.
 five_sources_data %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Training Dataset")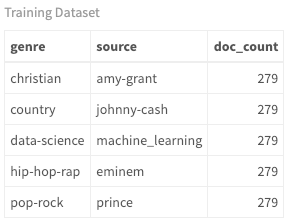
 five_sources_data_test %>%
  group_by(genre, source) %>%
  summarise(doc_count = n()) %>%
  my_kable_styling("Test Dataset")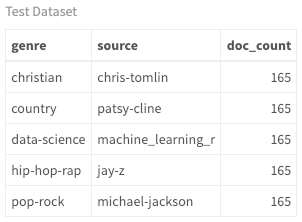
Obwohl du Genre, Quelle und Dokumentenzahl siehst, zeigt das folgende Chord-Diagramm diese Beziehungen anschaulicher. Im Verlauf des Tutorials erkennst du, wie sich diese Beziehungen mit deinen Modellen verändern. Aktuell besteht eine Eins-zu-eins-Beziehung zwischen Quelle und Genre, weil die Künstlerinnen und Künstler so klassifiziert sind; Crossovers sind jedoch häufig – das siehst du in späteren Diagrammversionen.
 #get SONG count per genre/source. Order determines top or bottom.
genre_chart <-  five_sources_data %>%
  count(genre, source)

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = "grey", "eminem" = "grey",
             "johnny-cash" = "grey", "machine_learning" = "grey",
             "prince" = "grey")
# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(genre_chart[[1]])) - 1), 15,
                         rep(5, length(unique(genre_chart[[2]])) - 1), 15))

chordDiagram(genre_chart, grid.col = grid.col, transparency = .2)
title("Relationship Between Genre and Source")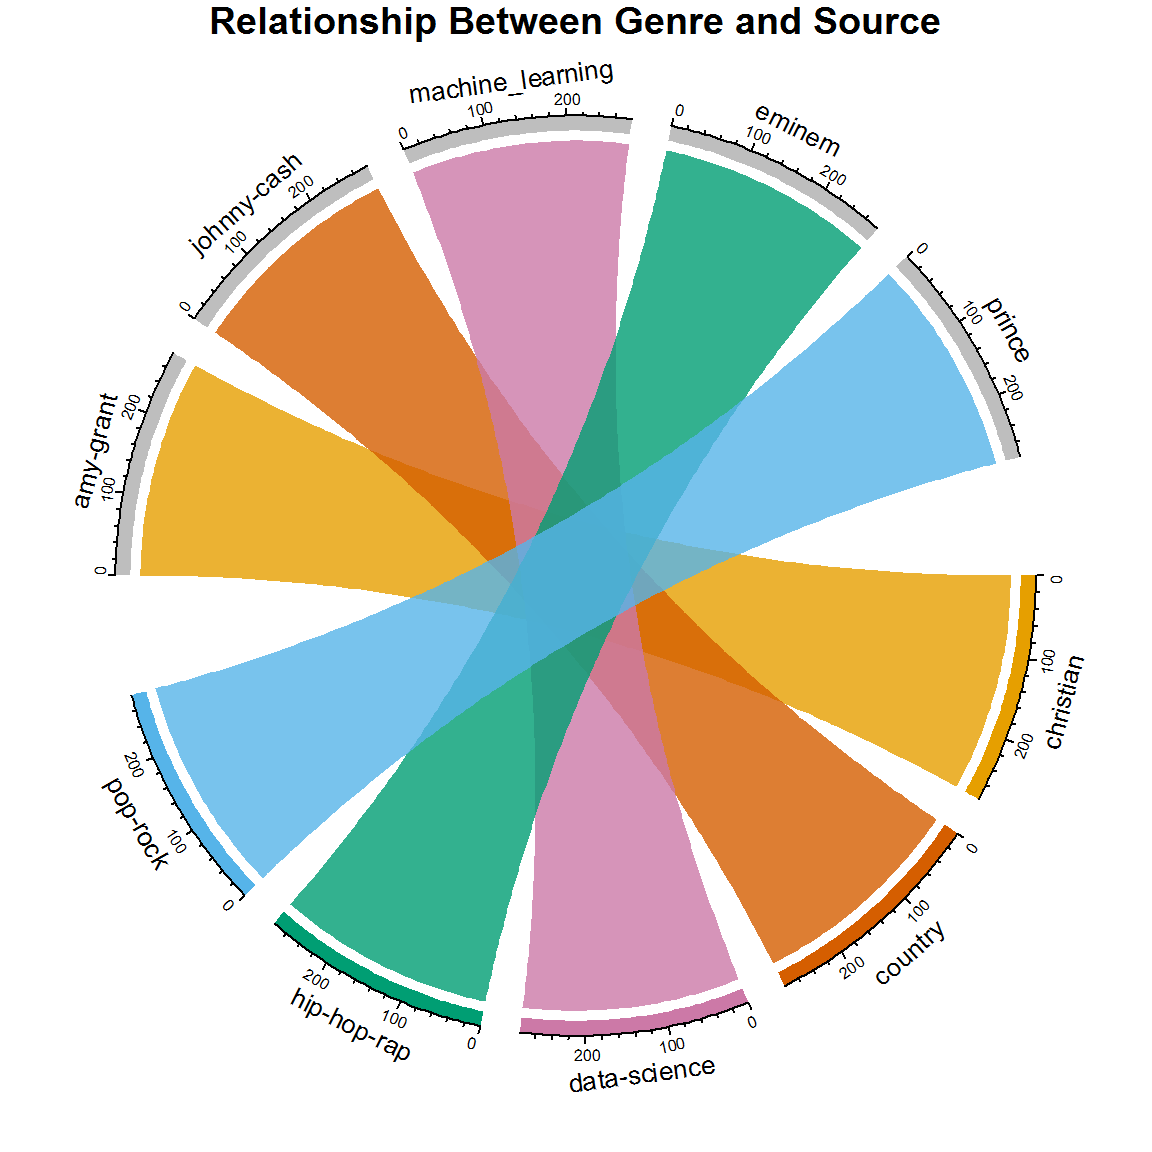
Überlege, wie dieses Diagramm aussähe, wenn es keine Eins-zu-eins-Beziehung gäbe. Wenn du das Genre nur aus Lyrics vorhersagen würdest – was denkst du, passiert dann?
Wenn dir zur Klassifikation eines Songs nur die Lyrics vorliegen, wie würdest du Prädiktorvariablen erzeugen? Denk zuerst über Songs und ihre lyrischen Unterschiede nach. Ein gemeinsames Motiv ist Wiederholung. Nutzen manche Genres Wiederholungen stärker? Wie sieht es mit Wortlängen aus? Werden eher lange oder kurze Wörter verwendet? Welche weiteren Faktoren beschreiben Lyrics? Wenn du diese Zählungen pro Song erfasst, hast du deinen ersten Satz an Prädiktoren!
Alle genannten Variablen sind quantitative Features (Zählungen, Längen etc.) auf Wortebene pro Song. Was ist aber mit genretypischen Einzelwörtern? In früheren Tutorials hast du Sentiment Analysis und Topic Modeling gemacht – dort standen wortspezifische Unterschiede zwischen Künstlerinnen/Künstlern oder Genres im Fokus. Gehst du einen Schritt weiter, kannst du besonders wichtige prädiktive Komponenten auf Basis des Inhalts (Kontexts) erstellen. Dieser kreative Schritt ist typisch für Text Analytics und liefert entscheidende Prädiktoren für deine Modelle.
Zuerst willst du die häufigsten Wörter je Genre ermitteln. Das hast du in Teil eins bereits gemacht. Starte mit der Gesamtwortzahl pro Genre. Gruppiere dann nach Wörtern je Genre und zähle deren Häufigkeit. Wähle anschließend die n häufigsten Wörter gemäß der Variablen number_of_words. Knifflig ist: Wie viele Wörter wählst du? Zu wenige – das Modell bleibt unter seinen Möglichkeiten. Zu viele – du überfittest und verzerrst die Ergebnisse. Die echte Lösung ist Ausprobieren. Für mich war 5500 optimal. Spiel mit dem Wert und schau, wie er das Ergebnis beeinflusst – vielleicht findest du etwas Besseres. Wenn der Schritt noch nicht klar ist: Bleib dran, es wird gleich schlüssiger.
Viele Wörter kommen genreübergreifend häufig vor (z. B. time, life). Ich habe solche Wörter mit der Variablen multi_genre unten entfernt. So entsteht eine sauberere Liste unterscheidender Wörter, die die Quellen besser trennen.
 #play with this number until you get the best results for your model.
number_of_words = 5500

top_words_per_genre <- five_sources_tidy %>%
  group_by(genre) %>%
  mutate(genre_word_count = n()) %>%
  group_by(genre, word) %>%
  #note that the percentage is also collected, when really you
  #could have just used the count, but it's good practice to use a %
  mutate(word_count = n(),
         word_pct = word_count / genre_word_count * 100) %>%
  select(word, genre, genre_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(desc(word_pct)) %>%
  top_n(number_of_words) %>%
  select(genre, word, word_pct)

#remove words that are in more than one genre
top_words <- top_words_per_genre %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_genre = n()) %>%
  filter(multi_genre < 2) %>%
  select(genre, top_word = word)

#create lists of the top words per genre
book_words <- lapply(top_words[top_words$genre == "data-science",], as.character)
country_words <- lapply(top_words[top_words$genre == "country",], as.character)
hip_hop_words <- lapply(top_words[top_words$genre == "hip-hop-rap",], as.character)
pop_rock_words <- lapply(top_words[top_words$genre == "pop-rock",], as.character)
christian_words <- lapply(top_words[top_words$genre == "christian",], as.character)
Jetzt nutzt du die genrespezifischen Wörter als Features in deinem Datensatz. Da du für mehrere Datensätze Features erzeugst, erstellst du eine Funktion, um Code zu sparen. In der Funktion tauchen die Begriffe lexikalische Diversität und Dichte auf. Eine Erklärung findest du in Teil eins.
Denk über jedes Feature unten nach und wie es sich je nach Genre unterscheiden kann. Anstatt jedes Feature im Detail zu erklären, konzentriere ich mich gleich auf die nachfolgenden ML-Schritte – nimm dir kurz Zeit, den Code durchzugehen. Vergiss die kritischen, genrespezifischen Prädiktoren nicht: country_word_count zählt z. B. einfach, wie viele Top-Country-Wörter in einem Song vorkommen. Beachte, dass ich explicit- und book-Wörtern mehr Gewicht gebe (10 bzw. 20 in sum()), weil sie sehr unterscheidend sind. Auch das entstand durch Ausprobieren!
features_func_genre <- function(data) {
  features <- data %>%
  group_by(document) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             document)) + 1L,
         title_length = nchar(document),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         #assign more weight to these words using "10" below
         explicit_word_count =
          sum(ifelse(word %in% explicit_words$explicit_word,10,0)),
         #assign more weight to these words using "20" below
         book_word_count =
           sum(ifelse(word %in% book_words$top_word,20,0)),
         christian_word_count =
           sum(ifelse(word %in% christian_words$top_word,1,0)),
         country_word_count =
           sum(ifelse(word %in% country_words$top_word,1,0)),
         hip_hop_word_count =
           sum(ifelse(word %in% hip_hop_words$top_word,1,0)),
         pop_rock_word_count =
           sum(ifelse(word %in% pop_rock_words$top_word,1,0))
         ) %>%
  select(-word) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$genre <- as.factor(features$genre)
return(features)
}
Rufe nun deine features()-Funktion für Trainings- und Testdatensatz auf.
 train <- features_func_genre(five_sources_tidy)
test <- features_func_genre(five_sources_test_tidy)Wenn du mlr noch nicht genutzt hast: Kein Problem. Schritt für Schritt siehst du, dass der Ablauf geradlinig ist. Ich empfehle erneut dieses Tutorial als umfassendste Dokumentation. Ein Blick auf mlr.org lohnt sich ebenfalls.
mlr (Machine Learning for R) ist ein Framework mit vielen gängigen Machine-Learning-Algorithmen. Statt Theorie zu jedem Algorithmus liegt der Fokus hier auf der Umsetzung. Am Ende hast du zahlreiche Klassifikationswerkzeuge praktisch angewandt – idealerweise parallel zum Code.
Nach dem Feature Engineering ist der ML-Prozess simpel: Task erstellen, Learner definieren, trainieren, testen. Diese Schritte gehst du:
Ein Task ist der Datensatz, auf dem ein Learner lernt. Da es sich um Klassifikation handelt, erstellst du mit makeClassifTask() einen Classification-Task. Über target gibst du die Zielvariable genre an.
Unten habe ich drei Tasks erstellt – mit unterschiedlichen Zwecken. Train und Test sind klar. Zusätzlich gibt es einen Datensatz nur mit quantitativen Basisfeatures (Dokumentzusammenfassungen und Zählungen). Dieser Task, task_train_subset, wird ohne die genrespezifischen Wortzähl-Features (z. B. country_word_count, pop_rock_word_count) erstellt, um deren Bedeutung zu veranschaulichen. Mit train[3:13] entfernst du diese Variablen. Außerdem solltest du beim Erstellen des Tasks immer Textspalten entfernen – hier sind das die Spalten eins und zwei.
 #create classification tasks to use for modeling

#this dataset does not include genre specific words
task_train_subset <- makeClassifTask(id = "Five Sources Feature Subset",
                                     data = train[3:13], target = "genre")

#create the training dataset task
task_train <- makeClassifTask(id = "Five Sources",
                              data = train[-c(1:2)], target = "genre")

#create the testing dataset task
task_test <- makeClassifTask(id = "New Data Test",
                             data = test[-c(1:2)], target = "genre")
Daten normalisieren ist kontextabhängig, nicht immer nötig, hier aber hilfreich. Dabei werden Werte auf einen einheitlichen Bereich (z. B. 0 bis 1) skaliert. Variablen mit sehr großen Skalen dominieren sonst das Modell. Normalisierung behebt das. Eine gute Diskussion zum Thema lohnt sich. mlr bietet dafür normalizeFeatures().
#scale and center the training and test datasets
task_train_subset <- normalizeFeatures(task_train_subset, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_train <- normalizeFeatures(task_train, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")

task_test <- normalizeFeatures(task_test, method = "standardize",
cols = NULL, range = c(0, 1), on.constant = "quiet")Einen Learner erzeugst du mit makeLearner(). Im Konstruktor gibst du die gewünschte Lernmethode an. Eine Liste möglicher Klassifikationsalgorithmen erhältst du mit listLearners("classif")[c("class","package")] – inklusive benötigter Pakete.
Für dieses Beispiel habe ich eine Auswahl getroffen, die mehr als zwei Klassen verarbeiten kann: von Entscheidungsbäumen über Random Forests, Support Vector Machines und Gradient Boosting bis zu Neuronalen Netzen. Es gibt viele Learner zur Auswahl (aktuell über 80 Klassifikations-Learner in mlr) – probier sie aus!
 #create a list of learners using algorithms you'd like to try out
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest", predict.type = "prob"),
makeLearner("classif.rpart", id = "RPART", predict.type = "prob"),
makeLearner("classif.xgboost", id = "xgBoost", predict.type = "prob"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.nnet", id = "Neural Net", predict.type = "prob")
)
Resampling ist zentral im ML und würde ein eigenes Tutorial füllen. Kurz gesagt: Es werden wiederholt Stichproben aus dem Trainingsset gezogen und das Modell jeweils neu gefittet. So erhältst du Informationen, die ein einmaliges Fitten nicht liefert.
Hier nutzt du k-fold Cross-Validation, angegeben durch "CV" in makeResampleDesc(), das ein Resample-Description-Objekt (rdesc) zurückgibt. Der Ansatz teilt die Daten zufällig in k gleich große Folds. Der erste Fold dient als Validierungsset, die übrigen als Training. Das wiederholt sich k-mal. Die Fehlerraten werden gemittelt.
Gerade am Anfang wirkt das abstrakt, ist aber essenziell. In unserem Beispiel nutzen wir 10-fold CV. „Bei Klassifikation ist es üblich, in jedem Fold ähnliche Klassenverteilungen zu haben.“ (Quelle) Nutze stratify = TRUE, um das sicherzustellen.
Mehr zu Resampling in mlr findest du hier.
 # n-fold cross-validation
#use stratify for categorical outcome variables
rdesc = makeResampleDesc("CV", iters = 10, stratify = TRUE)Ziel der Klassifikation ist meist hohe Treffergenauigkeit und wenige Fehler. In vielen Anwendungen sind Fehlerarten aber unterschiedlich kritisch. In der Medizin wäre ein übersehener positiver Fall z. B. gravierend. Unterschiedliche Metriken adressieren solche Nuancen. Für die Lyric-Analyse schauen wir hauptsächlich auf Accuracy und Fehler. Denk daran: Accuracy ist nicht immer das beste Maß für die Robustheit eines Modells – ein wichtiges Thema für später.
Accuracy ist der Anteil korrekter Vorhersagen an allen Vorhersagen. Um Fehlklassifikationen zu untersuchen, nutzt du außerdem eine Konfusionsmatrix (Predicted vs. Actual). Zunächst legst du die gewünschten Maße fest. Ich habe drei aufgenommen, wir betrachten hier acc. Hier findest du weitere Infos.
 #let the benchmark function know which measures to obtain
#accuracy, time to train
meas = list(acc, timetrain)In mlr kannst du Benchmark-Experimente durchführen, bei denen verschiedene Algorithmen auf deinen Datensatz angewendet und anhand ausgewählter Maße (z. B. Accuracy) verglichen werden. benchmark() trainiert die Modelle und erzeugt ein BenchmarkResult-Objekt zur Auswertung.
Jetzt wird es ernst. Starte mit dem Task ohne genrespezifische Wortzähl-Features. Übergib an benchmark deine Learner-Liste, den Subset-Task, die Resampling-Strategie (rdesc) und die gewünschten Maße.
 #it would be best to loop through this multiple times to get better results
#so consider adding a for loop here!
set.seed(123)
bmr <- benchmark(lrns, task_train_subset, rdesc, meas, show.info = FALSE)

#I'm just accessing an aggregated result directly so you can see
#the object structure and so I can use the result in markdown narrative
rf_perf <- round(bmr$results$`Five Sources Feature Subset`$`Random Forest`$aggr[[1]],2) * 100
## [1] "BenchmarkResult"class(bmr)
bmr## task.id learner.id acc.test.mean
## 1 Five Sources Feature Subset Random Forest 0.7282895
## 2 Five Sources Feature Subset RPART 0.6516754
## 3 Five Sources Feature Subset xgBoost 0.6871616
## 4 Five Sources Feature Subset KNN 0.6676070
## 5 Five Sources Feature Subset LDA 0.6632281
## 6 Five Sources Feature Subset SVM 0.6965042
## 7 Five Sources Feature Subset PART 0.6561634
## 8 Five Sources Feature Subset Naive Bayes 0.6184923
## 9 Five Sources Feature Subset Neural Net 0.7073271
## timetrain.test.mean
## 1 0.892
## 2 0.013
## 3 0.062
## 4 0.000
## 5 0.007
## 6 0.222
## 7 0.218
## 8 0.012
## 9 0.252Im BenchmarkResult-Objekt siehst du acc.test.mean für jeden Algorithmus. Das bezieht sich auf die Validierungsfolds aus der Cross-Validation beim Training. Das ist nicht der Testdatensatz, den du später nutzt. Merke: Es gibt während CV zurückgehaltene Validierungsdaten und einen separaten Testdatensatz für den finalen Check.
In diesem Benchmark performt Random Forest mit r rf_perf Prozent am besten (und brauchte am längsten fürs Training). Behalte den Wert im Kopf und starte das Experiment mit dem vollständigen Feature-Set erneut.
Jetzt nutzt du den Task mit genrespezifischen Wortzählungen pro Dokument. Diese Features zeigen z. B., ob ein Song mehr Country- oder Pop-Rock-Wörter enthält. Aus deiner gelabelten Stichprobe hast du die häufigsten Hip-Hop-Wörter in hip_hop_words gesammelt (thug, crib, drug usw.). In der Country-Liste stehen Wörter wie lonesome, coal, drunken, cattle. Du siehst das Prinzip.
mlr bietet mehrere Wege, Benchmark-Ergebnisse auszulesen. Ich nutze ein paar davon; um das Objekt kennenzulernen, helfen die getBMR*-Getter. Ein str() auf das Benchmark-Objekt kann dauern.
Bevor wir ins Detail gehen, vergleichen wir mehrere Tasks und stellen das vollständige Feature-Set dem Subset gegenüber – mit plotBMRSummary(). Dazu erstellst du eine Task-Liste für benchmark().
 #always set.seed to make sure you can replicate your results
set.seed(123)
task_list <- list(task_train, task_train_subset)
bmr_multi_task <- benchmark(lrns, task_list, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr_multi_task)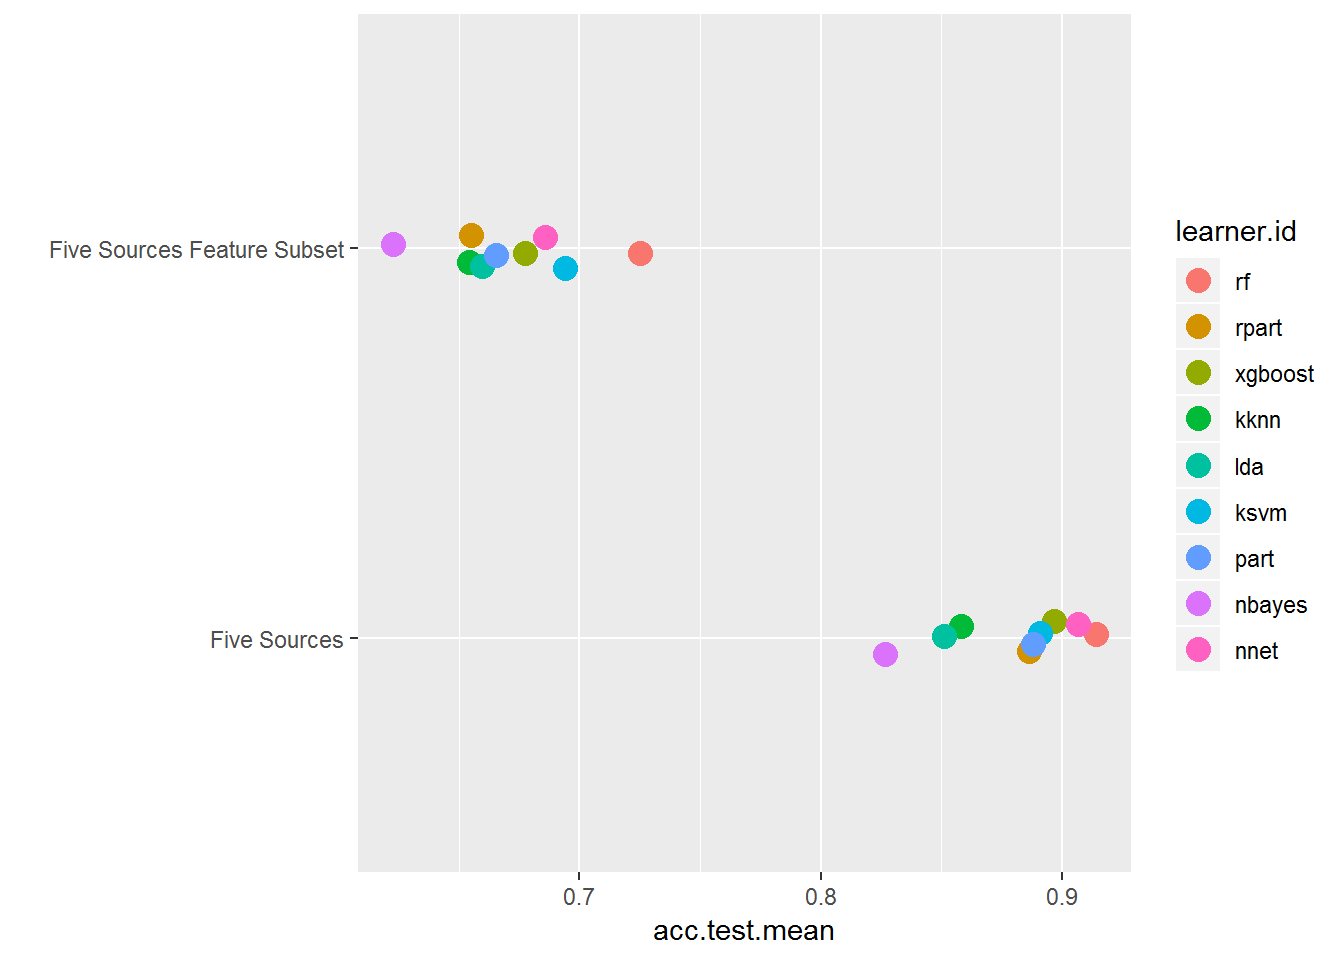
Hier siehst du: Die acc.test.mean des Subsets ohne genrespezifische Wortzählungen ist niedriger als beim vollständigen Set. Diese Features machen einen großen Unterschied – ein kreativer Schritt, den du speziell im Text-ML siehst.
Obwohl du Trainingsresultate aus bmr_multi_task auslesen könntest, benchmarken wir noch einmal nur mit dem Training-Task und schauen genauer mit getBMRAggrPerformances() und plotBMRBoxplots() hin.
 set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas, show.info = FALSE)

plotBMRSummary(bmr)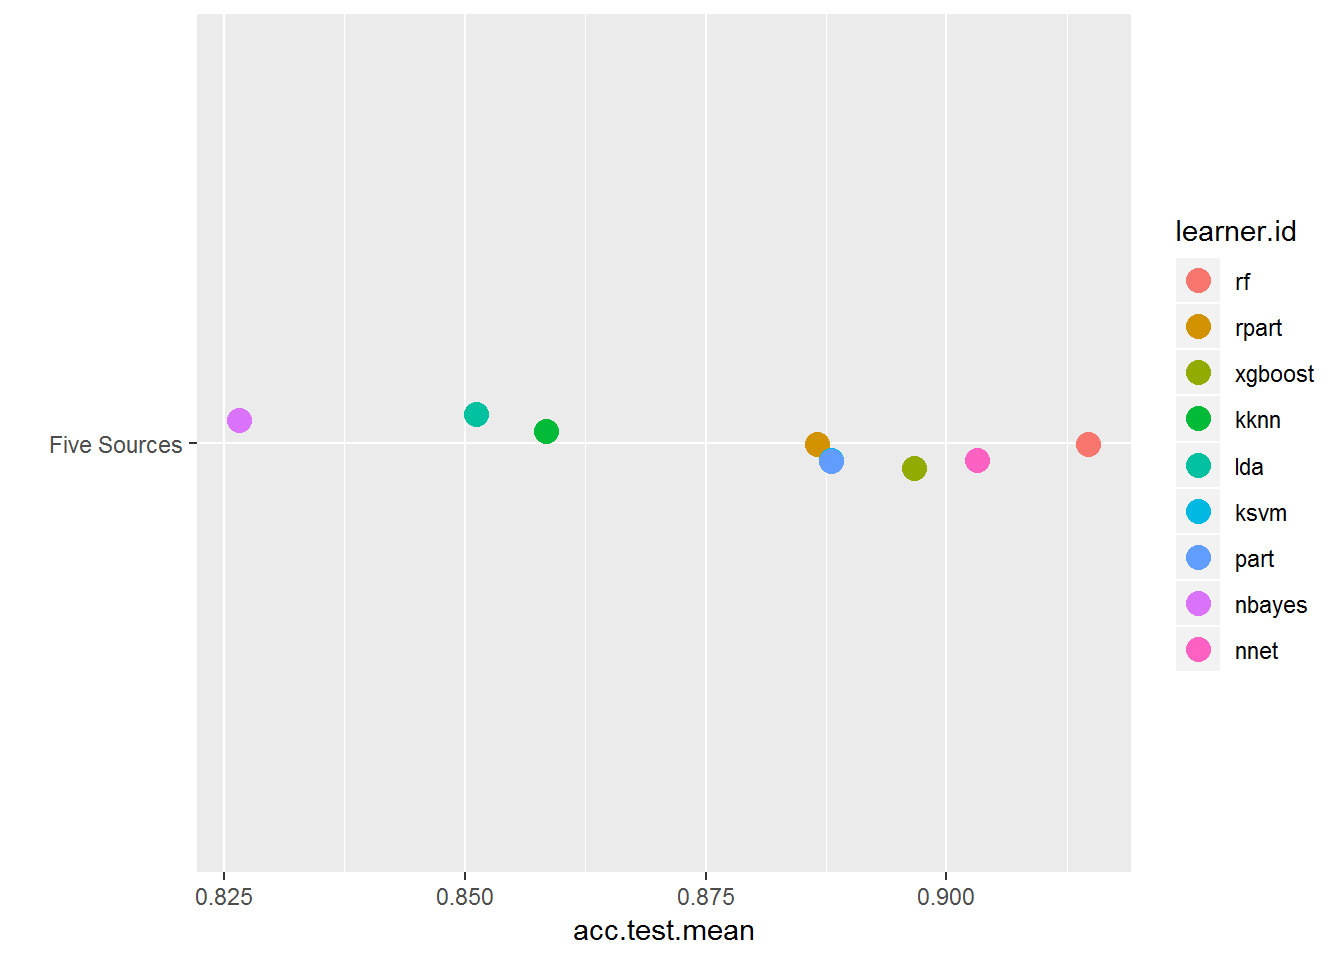
So zoomst du in die Resultate mit vollständigen Features. Jetzt erkennst du klarer die Unterschiede zwischen Algorithmen und dass random forest die anderen übertrifft.
 plotBMRBoxplots(bmr, measure = acc, style = "violin",
                pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))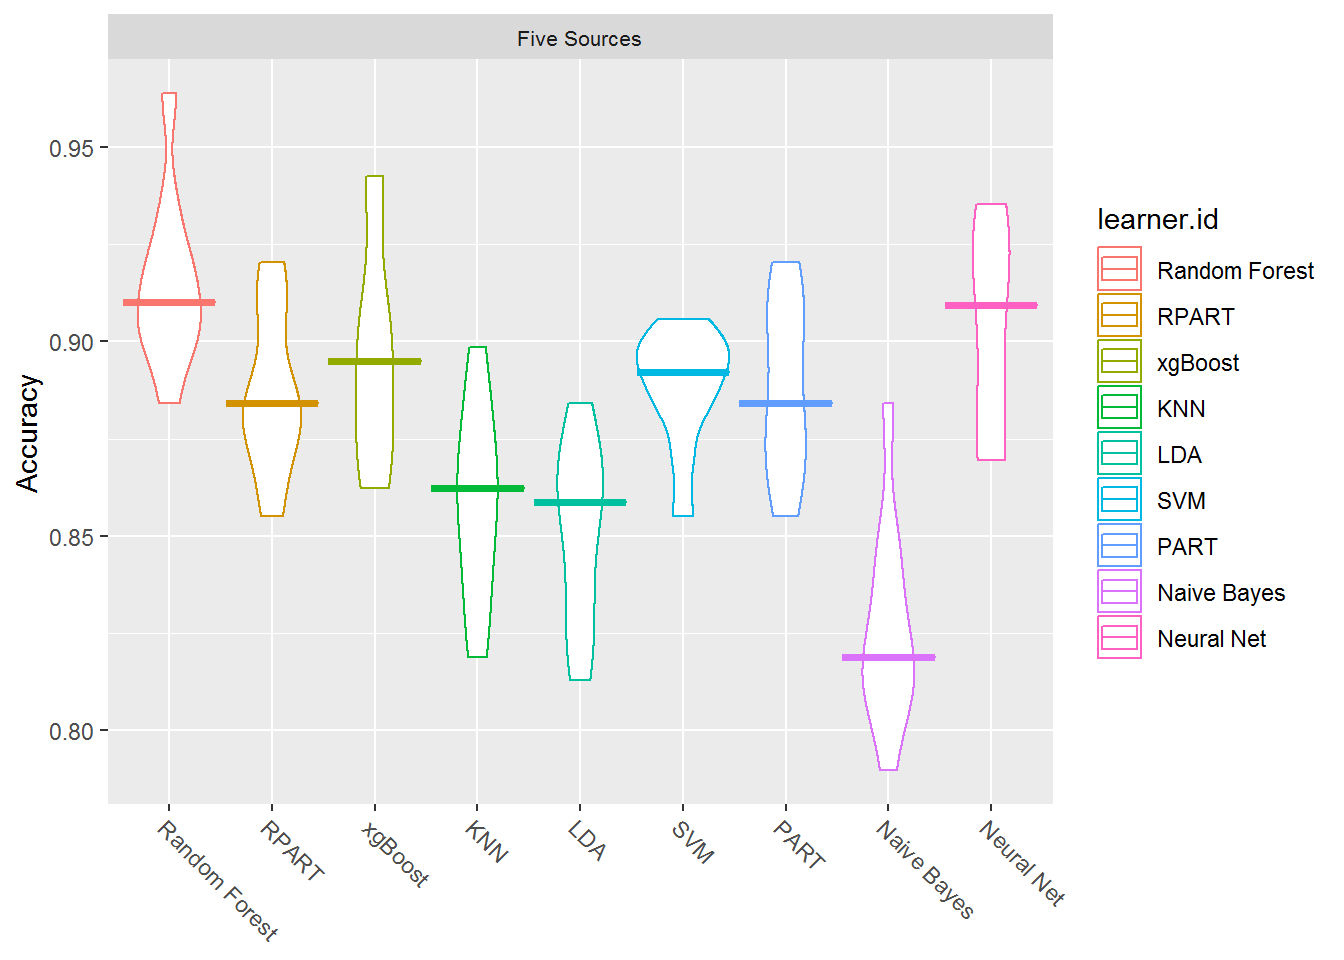
Die Boxplots zeigen die Ergebnisse je Methode über die Iterationen des Benchmarkings.
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

#just for use in markdown narrative
first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")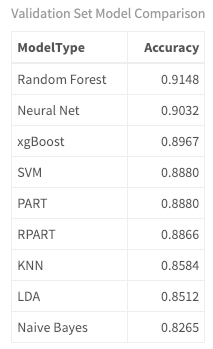
Hier ist die Accuracy am höchsten für Random Forest, Neural Net und xgBoost – mit r first_three Prozent. Was passiert im Modell? Wie wurden Songs tatsächlich klassifiziert? Welche Genres waren anhand der Lyrics am schwierigsten? Dafür betrachten wir die Konfusionsmatrix der Vorhersagen. Auf der Diagonalen stehen korrekte Zuordnungen, außerhalb die Fehlklassifikationen; die Ränder zeigen Fehlerzählungen. Spalten sind Vorhersagen, Zeilen die echten Werte. Mit getBMRPredictions() holst du die Vorhersagen (Training/Validierung). Dann schaust du dir das result der Konfusionsmatrix des Random-Forest-Modells an (Task-ID Five Sources).
 predictions <- getBMRPredictions(bmr)

calculateConfusionMatrix(predictions$`Five Sources`$`Random Forest`)$result  %>%
  my_kable_styling("Random Forest Confusion Matrix: Rows are True, Columns are Predictions")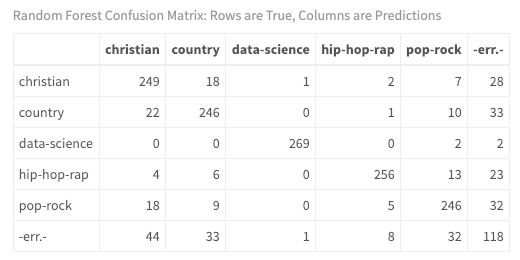
Endlich gibt es Einblick ins Modell! Erwartbar ist es leicht, Data-Science-Dokumente von Songtexten zu unterscheiden – nur eine Fehlklassifikation – dank deiner Text-Metafeatures. Auch hip-hop-rap ist mit nur acht Fehlklassifikationen sehr unterscheidbar. Zwischen Country, Christian und Pop-Rock ist die Abgrenzung hingegen geringer, wenn auch insgesamt auf hohem Niveau.
Das Ziel des Tutorials ist, ML-Techniken kennenzulernen und die Lyric-Analyse aus den vorherigen Teilen fortzuführen. Was bedeuten die Ergebnisse? Wenn du ein Empfehlungssystem mit lyrischen Insights ergänzen würdest – welche Überlegungen sind nötig? Könnte das System einem Christian-Music-Fan aus Versehen einen Hip-Hop-Artist mit explicit Lyrics empfehlen?
Erinnerst du dich ans Chord-Diagramm vom Anfang? Schau es dir erneut an – diesmal mit Vorhersagen statt echter Labels.
 train$id <- seq_len(nrow(train))
df <- predictions$`Five Sources`$`Random Forest`$data

chart <- train %>%
  inner_join(predictions$`Five Sources`$`Random Forest`$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "amy-grant" = my_colors[1], "prince" = my_colors[2],
             "eminem" = my_colors[3], "machine_learning" = my_colors[4],
             "johnny-cash" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Train")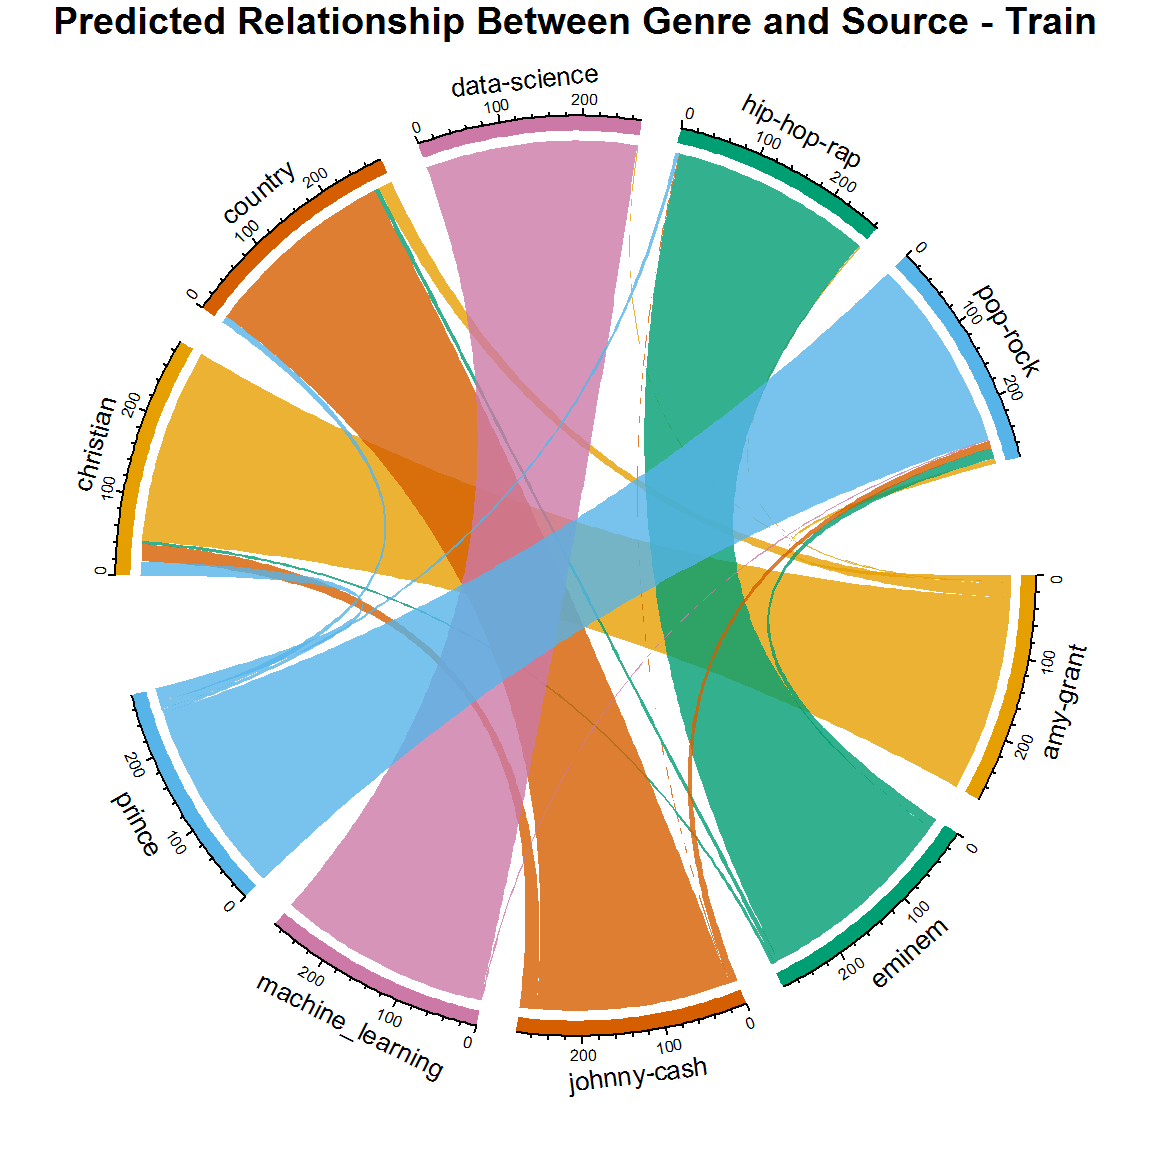
Ziemlich cool. Du siehst, wie gut es auf den Trainingsdaten lief. Die dünneren Linien sind Fehlklassifikationen. Wichtigster Punkt: Das sind Validierungsergebnisse – aber immer noch basierend auf gelabelten Trainingsdaten! Ohne Vorsicht kannst du dein Modell overfitten und hohe Varianz erzeugen – es reagiert dann stark auf die konkreten Trainingsdaten und ist anfällig für Rauschen in neuen Daten. Gleich folgt der echte Test mit wirklich neuen Daten.
Vor dem Test willst du ein Modell auswählen und tunen – über seine Hyperparameter. Ein derzeit sehr populärer Algorithmus ist Extreme Gradient Boosting (xgBoost), der viele Wettbewerbe dominiert. Auch wenn er im Benchmark nicht am besten war, wähle ich ihn hier fürs Tuning und den Test. Tuning ist anfangs die schwierigste Stelle. Eine konzeptionelle Einführung in Gradient Boosting hilft sehr – z. B. dieser Artikel von Prince Grover. Kurz gefasst:
Zuerst mit einfachen Modellen starten und deren Fehler analysieren. Diese Fehler markieren schwer zu modellierende Punkte. Spätere Modelle fokussieren stärker auf diese harten Fälle. Am Ende werden alle Prädiktoren gewichtet kombiniert.
(Hinweis: Der maxit-Wert 150 in makeTuneControlRandom() dauert recht lange. Starte ggf. mit kleineren Werten.)
 #experiment here!! this is where you can really improve your model
xgb_params <- makeParamSet(
  makeDiscreteParam("booster",values = c("gbtree")),
  makeIntegerParam("nrounds",lower=10,upper=20),
  makeIntegerParam("max_depth",lower = 4,upper = 6),
  makeNumericParam("min_child_weight",lower = 1L,upper = 10L),
  makeNumericParam("subsample",lower = 0.5,upper = 1),
  makeNumericParam("colsample_bytree",lower = 0.5,upper = 1),
  makeNumericParam("eta",lower = .01, upper = .2)
)
control <- makeTuneControlRandom(maxit = 150L)

xglearn <- makeLearner("classif.xgboost", predict.type = "prob", id="tuned xgboost")

library(parallelMap)
parallelStartSocket(2)
set.seed(123)
tuned_params <- tuneParams(
  learner = xglearn,
  task = task_train,
  resampling = rdesc,
  par.set = xgb_params,
  control = control,
  measures = acc,
  show.info = TRUE
)

xgb_tuned_learner <- setHyperPars(
  learner = xglearn,
  par.vals = tuned_params$x
)

tuned_params$x
## $booster
## [1] "gbtree"
##
## $nrounds
## [1] 16
##
## $max_depth
## [1] 5
##
## $min_child_weight
## [1] 1.395328
##
## $subsample
## [1] 0.6397534
##
## $colsample_bytree
## [1] 0.7986664
##
## $eta
## [1] 0.1917797
Die optimierten Parameter siehst du in der Ausgabe von tuneParams(). Jetzt erstellst du mit diesen Hyperparametern ein neues Modell und trainierst erneut auf dem Trainingsdatensatz.
lrns = list(makeLearner("classif.nnet", predict.type = "prob"),
            makeLearner("classif.PART", predict.type = "prob"),
            makeLearner("classif.randomForest", predict.type = "prob"),
            makeLearner("classif.xgboost", id="untunedxgboost" ,predict.type = "prob"),
            xgb_tuned_learner)

set.seed(123)
bmr = benchmark(lrns, task_train, rdesc, meas)
plotBMRBoxplots(bmr, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))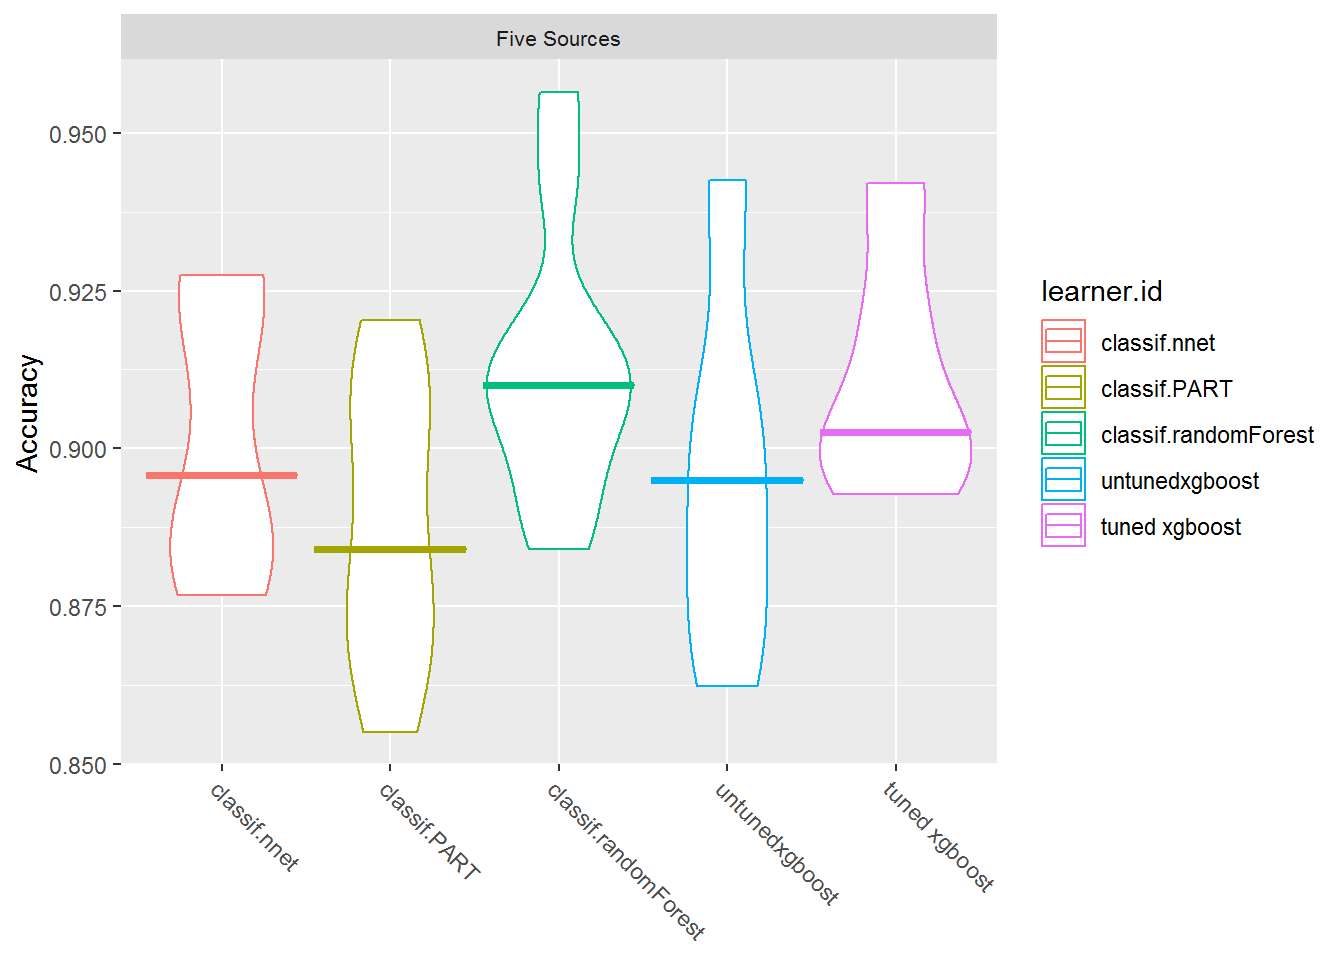
 performances <- getBMRAggrPerformances(bmr, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy))

# #used in markdown
# first_three <- round(performances$Accuracy[1:3],2) * 100

performances %>%
  my_kable_styling("Validation Set Model Comparison")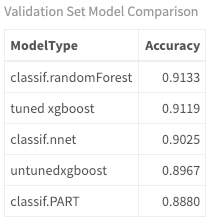
Das getunte xgBoost-Modell ist nur minimal besser als das ungetunte und weiterhin weniger genau als Random Forest. Aber wie schlagen sie sich auf den Testdaten?
Mit getuntem Modell und Benchmarks rufst du predict() für die Top drei Modelle auf dem bislang unbekannten Testdatensatz auf. Dieser enthält fünf komplett andere Quellen. Schau dir Performance und Klassifikationen an.
 set.seed(12)
rf_model = train("classif.randomForest", task_train)
result_rf <- predict(rf_model, task_test)
performance(result_rf, measures = acc)
## acc
## 0.6541262set.seed(12)
nnet_model = train("classif.nnet", task_train)## # weights: 68
## initial value 2500.439406
## iter 10 value 876.420114
## iter 20 value 531.977942
## iter 30 value 412.756436
## iter 40 value 334.449379
## iter 50 value 304.202353
## iter 60 value 295.229853
## iter 70 value 286.347519
## iter 80 value 282.524065
## iter 90 value 280.438058
## iter 100 value 278.713625
## final value 278.713625
## stopped after 100 iterationsresult_nnet <- predict(nnet_model, task_test)
performance(result_nnet, measures = acc)## acc
## 0.631068set.seed(12)
xgb_model = train(xgb_tuned_learner, task_train)
result_xgb <- predict(xgb_model, task_test)
test_perf <- performance(result_xgb, measures = acc)
test_perf## acc
## 0.6492718Spannend: Obwohl Random Forest auf dem Trainingsset besser war als das getunte xgBoost, ist es auf dem Testset leicht schwächer. Neural Net fällt auf dem Testset deutlich ab – neuronale Netze sind flexibel und neigen zum Overfitting.
Mit einer Test-Accuracy von r round(test_perf,2)*100% für getuntes xgBoost ist die Performance auf Testdaten deutlich schlechter als beim Training; das Tuning brachte hier nur geringe Verbesserungen (mit dieser minimalen Konfiguration!). Dieser Drop zwischen Train und Test ist üblich – genau deshalb testest du auf neuen Daten.
Schauen wir uns die Klassifikationen an.
 calculateConfusionMatrix(result_xgb)$result %>%
  my_kable_styling("TEST: xgBoost Confusion Matrix: Rows are True, Columns are Predictions")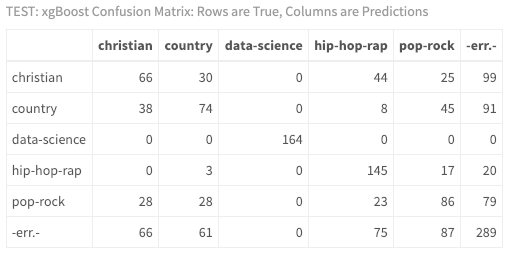
Die Matrix zeigt: Dieser Hip-Hop-Künstler, Jay-Z, war deutlich schwerer zu klassifizieren. Vielleicht kennst du die Musik nicht – die Ergebnisse deuten auf Unterschiede zwischen dem Trainingskünstler Eminem und Jay-Z im Test hin. Ideal wären mehr Daten, mehr Künstlerinnen/Künstler, intensiveres Tuning und mehrere Läufe!
Was könnte das bedeuten? Blick noch einmal auf das Chord-Diagramm:
 test$id <- seq_len(nrow(test))

chart <- test %>%
  inner_join(result_xgb$data) %>%
  group_by(source, response) %>%
  summarise(n())

circos.clear() #very important! Reset the circular layout parameters
#assign chord colors
grid.col = c("christian" = my_colors[1], "pop-rock" = my_colors[2],
             "hip-hop-rap" = my_colors[3], "data-science" = my_colors[4],
             "country" = my_colors[5],
             "chris-tomlin" = my_colors[1], "michael-jackson" = my_colors[2],
             "jay-z" = my_colors[3], "machine_learning_r" = my_colors[4],
             "patsy-cline" = my_colors[5])

# set the global parameters for the circular layout. Specifically the gap size
circos.par(gap.after = c(rep(5, length(unique(chart[[1]])) - 1), 15,
                         rep(5, length(unique(chart[[2]])) - 1), 15))

chordDiagram(chart, grid.col = grid.col, transparency = .2)
title("Predicted Relationship Between Genre and Source - Test")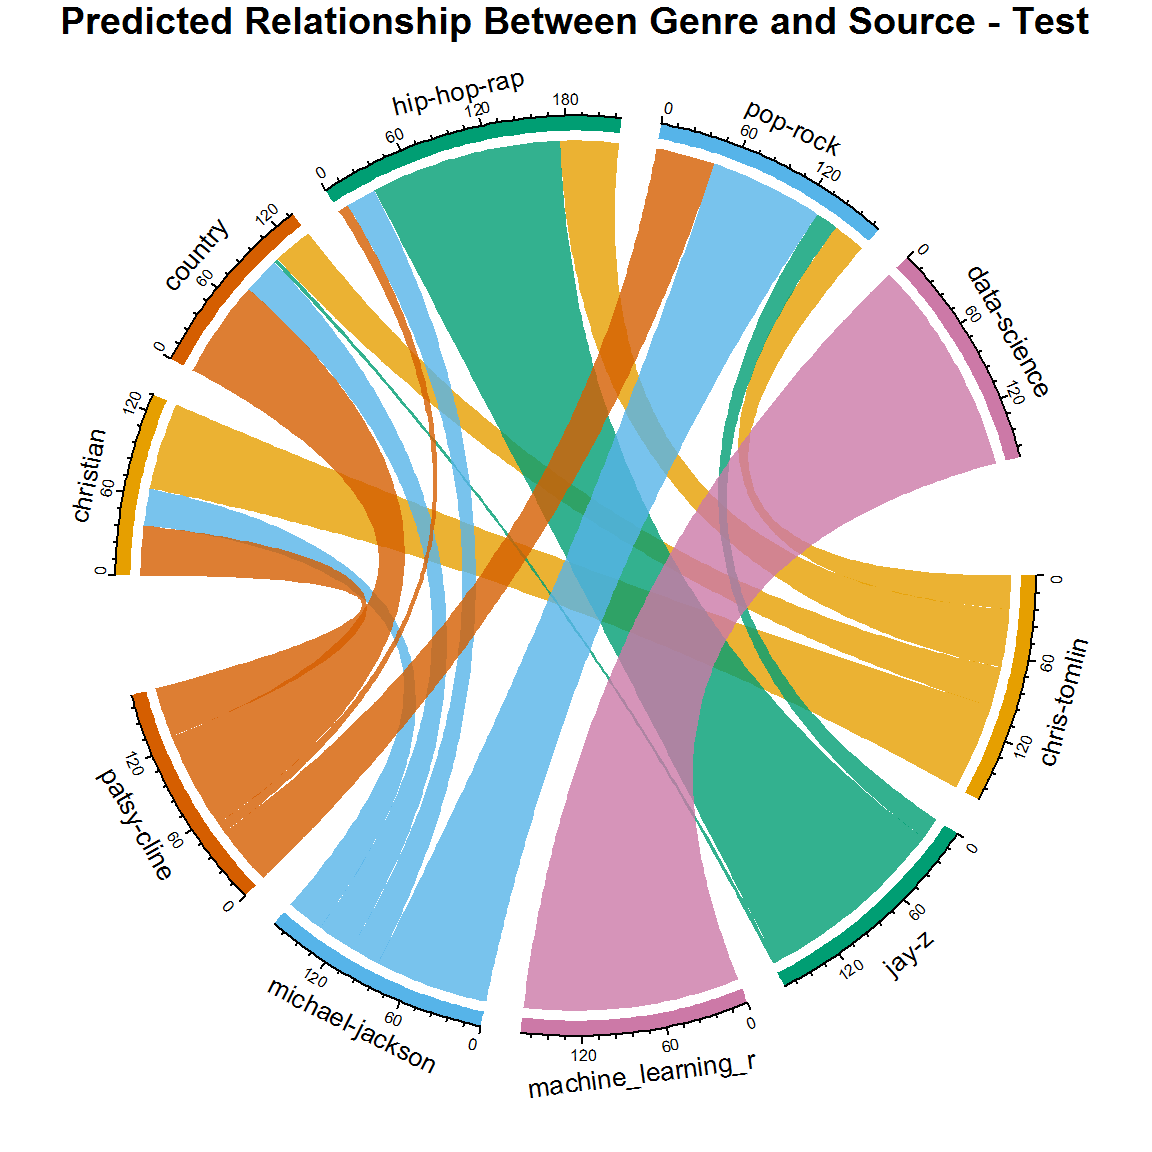
Ist das falsch? Ungenau? Oder aufschlussreich? Du bekommst einen realistischen Blick in die Musikwelt. Hat Michael Jackson mit Rap-Artists kollaboriert? Hat er über religiöse Themen gesungen? Sind Country-Künstlerinnen/Künstler in den Pop-Rock gewechselt? Dein neues Chord-Diagramm wirkt realistischer als das ursprüngliche – im echten Leben gibt es selten die reine Eins-zu-eins-Beziehung zwischen Artist und Genre, und genau diese Flexibilität steckt in deinem Modell.
Im nächsten Teil geht es um eine Idee, die sich auch in Marketing, Vertrieb, Wissenschaft oder Ökonomie anwenden lässt – hier auf Musik übertragen. Erfolg eines Songs ist subjektiv, kommerzieller Erfolg lässt sich über Branchenstandards fassen. Die Billboard-Charts (u. a.) sind solche Maße. Arbeitest du bei einem Label und willst entscheiden, wen du unter Vertrag nimmst oder promotest, wäre es spannend, die Chartchancen allein aus den Lyrics wissenschaftlich zu prognostizieren. Dafür bräuchtest du aktuelle Daten und viele Metadaten zu jedem Song. Hier testen wir die Idee anhand von Prince-Lyrics mit gelabelten Chartdaten.
In früheren Tutorials hast du einen Datensatz mit Prince-Songs erstellt, in dem die Mehrheit nicht gechartet ist. Wir nutzen ein balanciertes Set mit gleicher Anzahl gecharteter vs. nicht gecharteter Songs. Hier die Zahlen:
 prince_charted_data <- read.csv("prince_data_balanced.csv", stringsAsFactors = FALSE)

prince_charted_data %>%
  count(charted) %>%
  my_kable_styling("Prince Data")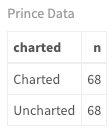
 prince_tidy <- prince_charted_data %>%
  unnest_tokens(word, lyrics) %>%
anti_join(stop_words)Erzeuge die Features wie oben in zwei Schritten – diesmal zählst du Wörter pro Chart-Status. Also: häufigste Wörter für gechartete und für nicht gechartete Songs ermitteln und in Listen speichern. Ich habe 1000 Wörter verwendet und damit gute Ergebnisse erzielt – probier eigene Werte aus. Beim Erstellen der Song-Features fügst du zwei Zähler hinzu, wie oft Wörter aus beiden Listen im Song vorkommen (analog zum Genre oben).
Beachte: Wörter, die in beiden Top-Listen vorkommen, habe ich entfernt. Außerdem habe ich einige polynomiale Features ergänzt (Quadrate der Eingaben). Statt den Algorithmus zu tunen, lässt sich ein Modell oft auch durch Transformation der Eingaben verbessern – ein Grundprinzip im ML.
 number_of_words <- 1000

top_words_per_chart <- prince_tidy %>%
  group_by(charted) %>%
  mutate(chart_word_count = n()) %>%
  group_by(charted, word) %>%
  mutate(word_count = n(),
         word_pct = word_count / chart_word_count * 100) %>%
  select(word, charted, chart_word_count, word_count, word_pct) %>%
  distinct() %>%
  ungroup() %>%
  arrange(word_pct) %>%
  top_n(number_of_words) %>%
  select(charted, word, word_pct)

top_words <- top_words_per_chart %>%
  ungroup() %>%
  group_by(word) %>%
  mutate(multi_chart = n()) %>%
  filter(multi_chart < 2) %>%
  select(charted, top_word = word)

charted_words <- lapply(top_words[top_words$charted == "Charted",],
                        as.character)
uncharted_words <- lapply(top_words[top_words$charted == "Uncharted",],
                          as.character)


features_func_chart <- function(data, remove) {
  features <- data %>%
  group_by(song) %>%
  mutate(word_frequency = n(),
         lexical_diversity = n_distinct(word),
         lexical_density = lexical_diversity/word_frequency,
         repetition = word_frequency/lexical_diversity,
         document_avg_word_length = mean(nchar(word)),
         title_word_count = lengths(gregexpr("[A-z]\\W+",
                                             song)) + 1L,
         title_length = nchar(song),
         large_word_count =
           sum(ifelse((nchar(word) > 7), 1, 0)),
         small_word_count =
           sum(ifelse((nchar(word) < 3), 1, 0)),
         charted_word_count =
           sum(ifelse(word %in% charted_words$top_word,1,0)),
         uncharted_word_count =
           sum(ifelse(word %in% uncharted_words$top_word,1,0)),
         div_sq = lexical_diversity^2,
         den_sq = lexical_density^2,
         large_word_count2 = large_word_count^2
         ) %>%
  select(-remove) %>%
  distinct() %>% #to obtain one record per document
  ungroup()

features$charted <- as.factor(features$charted)
return(features)
}

#remove these fields from the passed dataframe
remove <- c("word", "X", "X.1", "year", "album", "peak", "us_pop", "us_rnb", "decade", "chart_level")
song_summary <- features_func_chart(prince_tidy, remove)Wiederhol die obigen Schritte: Classifier-Task für den Prince-Datensatz mit Ziel charted erzeugen, normalisieren, Cross-Validation einrichten und eine Learner-Liste erstellen. Ich habe hier einige andere Algorithmen ergänzt, weil es sich um binäre Klassifikation handelt – nicht mehr Multiclass wie zuvor.
 task_prince <- makeClassifTask(id = "Prince", data = song_summary[-1],
                               target = "charted")

task_prince <- normalizeFeatures(task_prince, method = "standardize",
  cols = NULL, range = c(0, 1), on.constant = "quiet")


# n-fold cross-validation
rdesc <- makeResampleDesc("CV", iters = 10, stratify = TRUE)

## Create a list of learners
lrns = list(
makeLearner("classif.randomForest", id = "Random Forest"),
makeLearner("classif.logreg", id = "Logistic Regression"),
makeLearner("classif.rpart", id = "RPART"),
makeLearner("classif.xgboost", id = "xgBoost"),
makeLearner("classif.lda", id = "LDA"),
makeLearner("classif.qda", id = "QDA"),
makeLearner("classif.ksvm", id = "SVM"),
makeLearner("classif.PART", id = "PART"),
makeLearner("classif.naiveBayes", id = "Naive Bayes"),
makeLearner("classif.kknn", id = "KNN"),
makeLearner("classif.nnet", id = "Neural Net")
)

set.seed(123)
bmr_prince = benchmark(lrns, task_prince, rdesc, meas, show.info = FALSE)
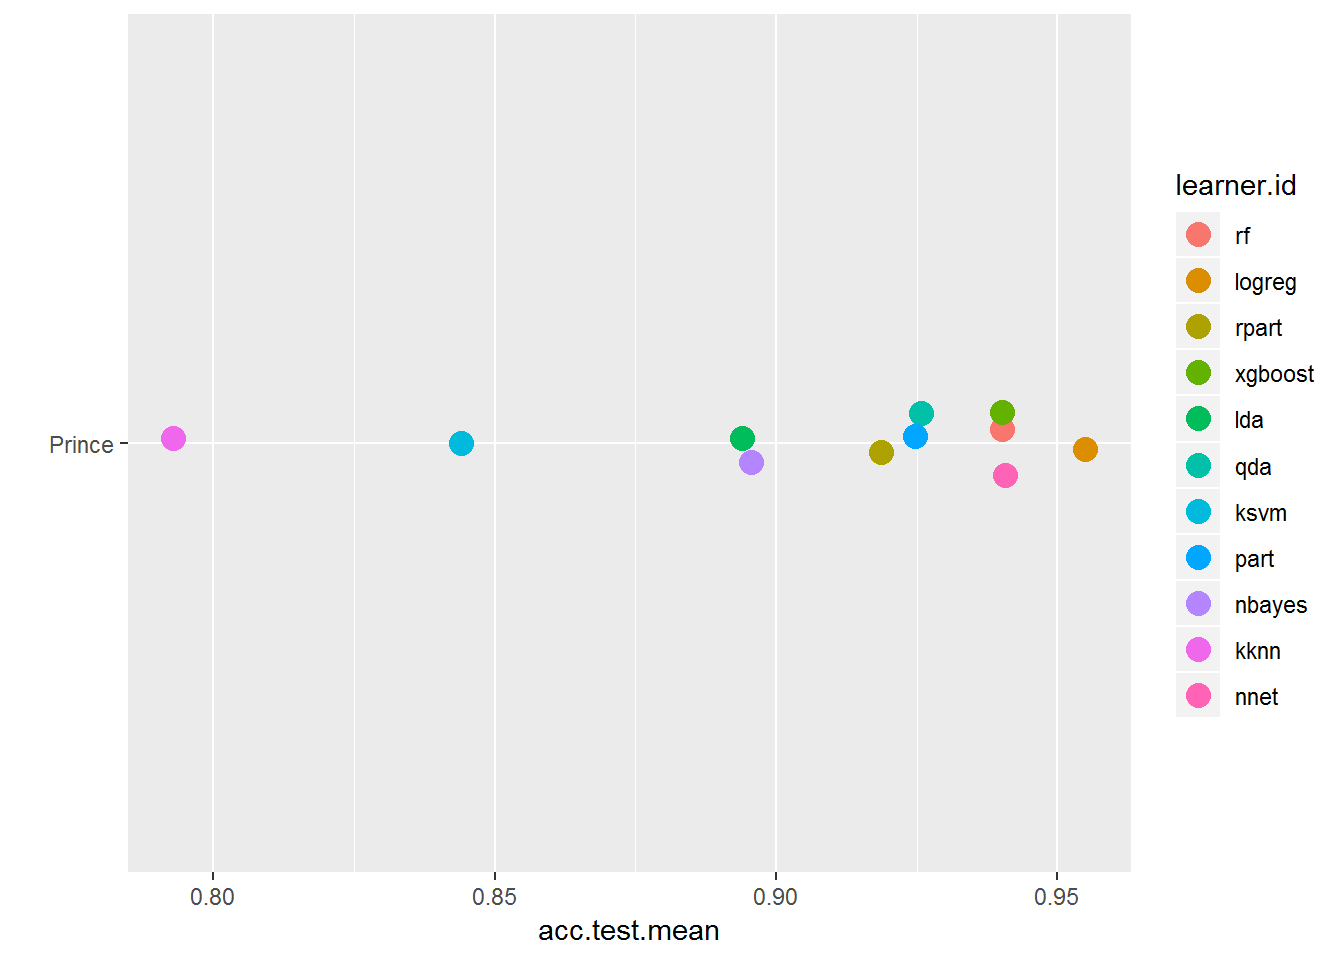
Nachdem die Benchmarks stehen, schaust du dir die Ergebnisse in mehreren Formaten an. Achte auf die Leistungsunterschiede im Vergleich zu oben.
plotBMRSummary(bmr_prince)
 plotBMRBoxplots(bmr_prince, measure = acc, style = "violin", pretty.names = FALSE) +
  aes(color = learner.id) +
  ylab("Accuracy") +
  theme(strip.text.x = element_text(size = 8))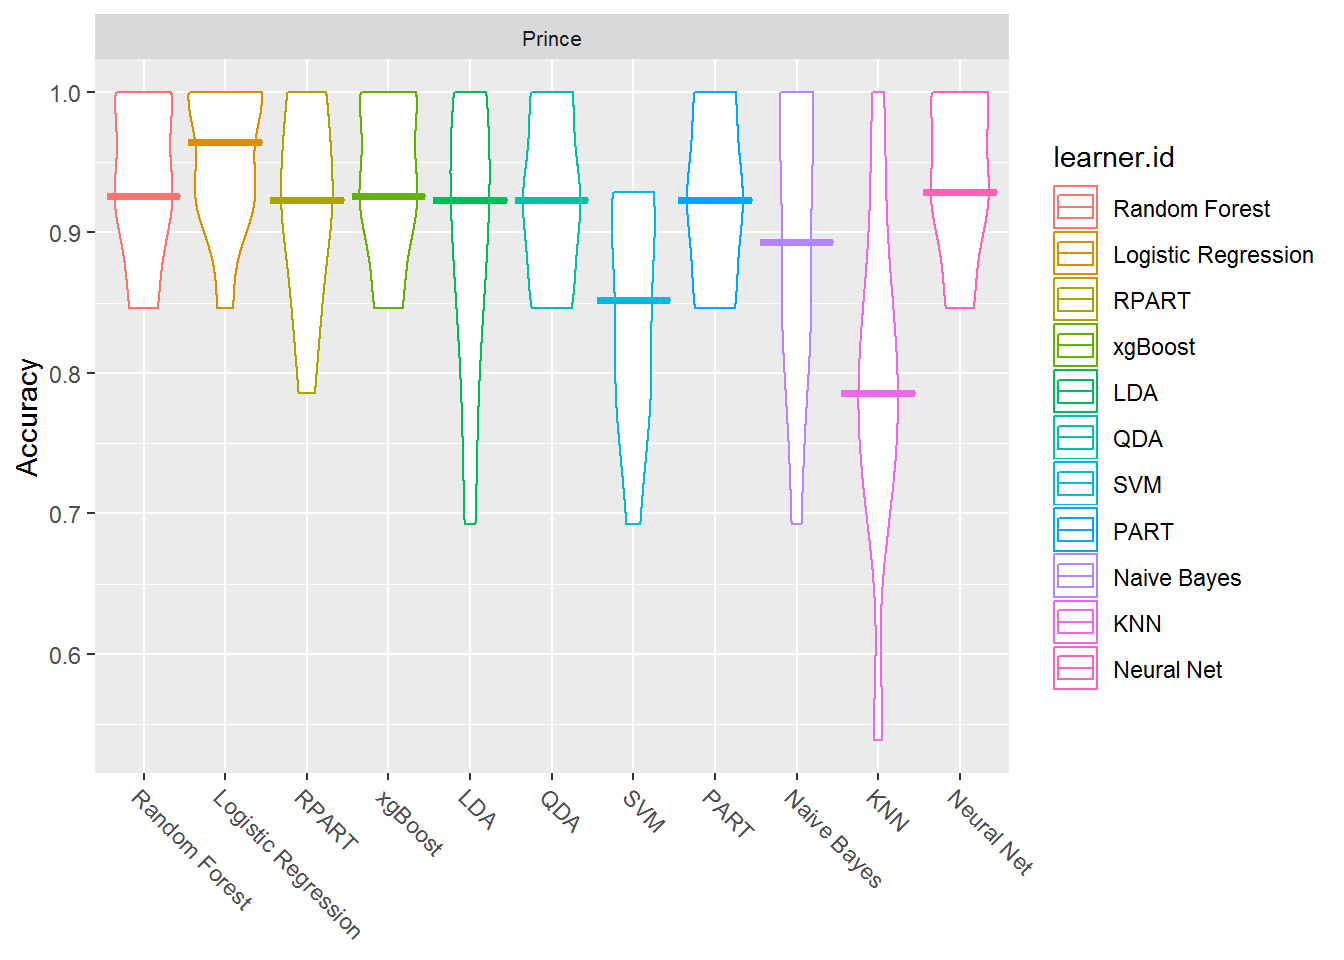
 #with knn so you can see the numbers
getBMRAggrPerformances(bmr_prince, as.df = TRUE) %>%
  select(ModelType = learner.id, Accuracy = acc.test.mean) %>%
  mutate(Accuracy = round(Accuracy, 4)) %>%
  arrange(desc(Accuracy)) %>%
  my_kable_styling("Validation Set Model Comparison")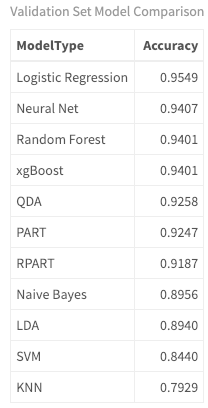
Bei der Chartvorhersage hast du ein Zwei-Klassen-Problem: gechartet oder nicht gechartet. Bei der Genreklassifikation hattest du Multiclass mit mehr als zwei Klassen (anders als Multi-Label, wo eine Beobachtung mehrere Klassen haben kann – auch spannend!). Daher habe ich QDA und Logistic Regression ergänzt, die sich oft gut für binäre Probleme eignen.
Logistic Regression ist für binäre Outcomes konzipiert und modelliert die Wahrscheinlichkeit, dass ein Song zu einer Kategorie gehört. Standardmäßig wird bei .5 getrennt – oberhalb Zielklasse, darunter andere Klasse. Der Schwellwert ist anpassbar. QDA (Quadratic Discriminant Analysis) ist flexibler für quadratische statt linearer Entscheidungsgrenzen. Ich streue hier technische Begriffe ein – nimm dir Zeit, Daten und Algorithmen zu prüfen und die Details nachzulesen. Ich hoffe, die Analyse motiviert dich dazu.
Als Nächstes schaust du dir die Vorhersagen und Klassifikationen an.
 predictions <- getBMRPredictions(bmr_prince)

calculateConfusionMatrix(predictions$Prince$`QDA`)$result %>%
  my_kable_styling("Logistic Regression Confusion Matrix: Rows are True, Columns are Predictions")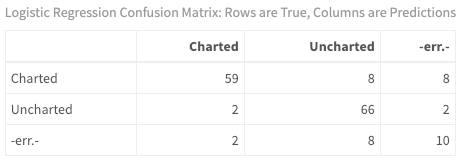
Es ist einfach zu prüfen, wie das Modell einzelne Songs klassifiziert hat. Bei binärer Klassifikation gibt es viele Metriken. Schau dir hier die False Positives an – Songs, die als gechartet vorhergesagt wurden, tatsächlich aber nicht in die Top 100 kamen.
 false_positives <- as.data.frame(predictions$Prince$`QDA`) %>%
  filter(truth == "Uncharted" & response == "Charted")

song_summary$id <- seq_len(nrow(song_summary))
song_summary %>%
  inner_join(false_positives) %>%
  inner_join(prince_charted_data) %>%
  select(song, response, truth, peak, album, year) %>%
  my_kable_styling("False Positive Prince Songs")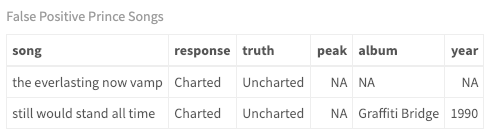
Auch wenn du beim Training Cross-Validation genutzt hast, solltest du dein Modell immer gegen einen separaten Datensatz laufen lassen (wie zuvor beim Genre). Das lasse ich dir als Übung und freue mich über Feedback. Für einen realistischen Test der Vorhersagekraft der Lyric-Analyse wären Songs eines anderen Pop-Rock-Künstlers aus einer ähnlichen Zeit wie Prince ideal. Alternativ kannst du eigene Artists für Training und Test wählen und vergleichen.
In diesem Tutorial hast du ein Modell gebaut, das das Genre eines Songs ausschließlich auf Basis seiner Lyrics vorhersagt. Du hast überwachte ML-Klassifikationsalgorithmen verwendet und Modelle auf einem Set aus fünf Artists und fünf Genres trainiert. Mit dem mlr-Framework hast du Tasks, Learner und Resampling-Strategien aufgebaut, Modelle getunt und anschließend auf einem unbekannten Testdatensatz mit anderen Artists geprüft. So konntest du erkennen, welche Algorithmen mit Defaults besser funktionieren und schließlich Genres neuer Songs vorhersagen.
Zur Lyric-Analyse: Auch wenn die Musikindustrie (und die Billboard-Charts) Genres pro Artist vorgeben, zeigt deine Analyse, dass Songs laut Lyrics Genres oft überschreiten – selten gibt es eine reine Eins-zu-eins-Beziehung. (Als Songwriterin ist mein Genre-Tagline übrigens „funkified, acoustic, rockin' soul!“). Mit denselben Techniken konntest du auch modellieren, ob ein Song allein anhand der Lyrics die Charts erreicht – mit ordentlicher Accuracy im Training. Deine Mission: Wende das auf deine Datensätze an!
Ich habe die dreiteilige (vier Tutorials umfassende) Serie zur Lyric-Analyse mit dir sehr genossen. Hoffentlich hast du die Komplexität dieser Textart und die Feinheiten gegenüber Sachtexten schätzen gelernt. Ich wünsche dir, dass du neue Kompetenzen mitnimmst und eigene Daten nutzt, um neue Themen zu erkunden. Machine Learning ist ein spannendes Feld – ob neu oder erfahren: Kreativität, Inspiration und Ausdauer heben dich von der Masse ab. Denk also ruhig mal „out of the box“ und hab Spaß beim Lernen!
„I put my foot on the starting line, and took off into a brand new day. I blew a kiss into the wind, closed my eyes and kicked the fear away. - Debbie Liske, New Day“
(Übrigens: Ich habe über 100 eigene Songs geschrieben und das letzte Modell auf meine Musik angewendet. Es hat 35 meiner Songs als charttauglich vorhergesagt! Hätte ich das früher gewusst!! Vielleicht schreibe ich als Nächstes darüber, wie man mit Lyric-Analyse einen Hit à la heutiger Artists schreibt ...)
Die folgenden Punkte habe ich nur gestreift – ich empfehle dir, sie zu vertiefen.
Stell deine Fragen gern in den Kommentaren!
Hier sind die Links zu den Datensätzen:
Erfahre mehr über R und Machine Learning
Kurs
Kurs
Kurs