Curso
Importación y gestión de datos financieros en R
5 h
21K
Eres científico de datos (¡o estás en ello!) y te llega un cliente que gestiona una tienda minorista. Te entrega los datos de todas las transacciones —los artículos que varios clientes compraron en la tienda durante un periodo— y te pide usarlos para impulsar su negocio. Tu cliente utilizará tus conclusiones no solo para cambiar/actualizar/añadir artículos en el inventario, sino también para modificar la disposición de la tienda física o de la tienda online. Para encontrar resultados útiles, usarás el análisis de la cesta de la compra (MBA), que aplica minería de reglas de asociación sobre los datos de transacciones.
En este tutorial aprenderás:
La minería de reglas de asociación se utiliza cuando quieres encontrar asociaciones entre distintos objetos de un conjunto, descubrir patrones frecuentes en una base de datos de transacciones, bases de datos relacionales u otros repositorios de información. Sus aplicaciones aparecen en marketing, análisis de cestas (Market Basket Analysis) en retail, clustering y clasificación. Permite identificar qué artículos compran los clientes con más frecuencia juntos generando un conjunto de reglas llamadas reglas de asociación. En pocas palabras, te devuelve reglas del tipo si pasa esto, entonces aquello. Los clientes pueden usar esas reglas en numerosas estrategias de marketing:
Considera el siguiente ejemplo:
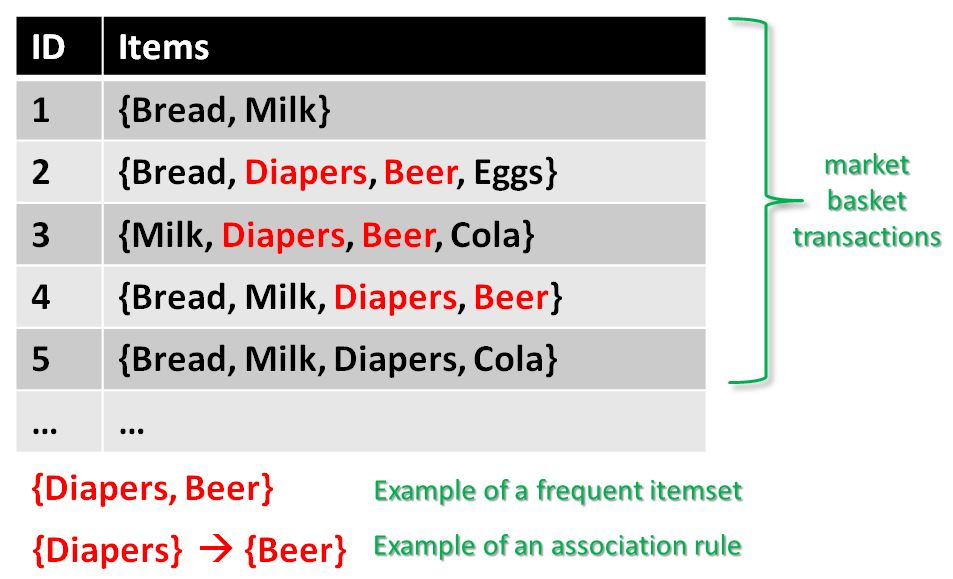
Se da un conjunto de datos de transacciones. Ves transacciones numeradas del 1 al 5. Cada transacción muestra los artículos comprados en esa operación. Puedes ver que diapers se compra con beer en tres transacciones. Del mismo modo, bread se compra con milk en tres transacciones, por lo que ambos forman conjuntos de artículos frecuentes. Las reglas de asociación se dan así:
$A=>B[Support,Confidence]$
La parte anterior a $=>$ es el si (antecedente) y la posterior a $=>$ es el entonces (consecuente).
Donde A y B son conjuntos de artículos en los datos de transacciones. A y B son conjuntos disjuntos.
$Computer=>Anti-virus Software[Support=20\%,confidence=60\%]$
La regla anterior dice:
En la siguiente sección verás los conceptos básicos de la minería de reglas de asociación:
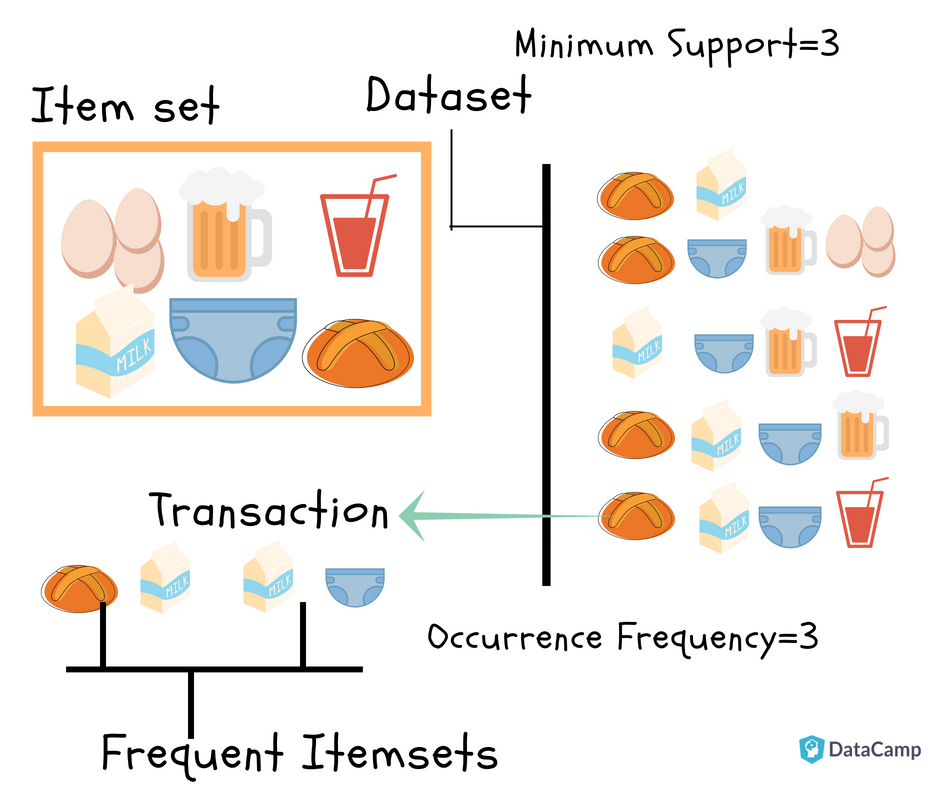
Itemset (conjunto de artículos): Colección de uno o más artículos. Un conjunto k-ítems contiene k artículos.
Support count (frecuencia): Número de ocurrencias de un conjunto de artículos.
Soporte (s): Fracción de transacciones que contienen el conjunto de artículos "X"
$Support(X)=\frac{frequency(X)}{N}$
Para una regla A=>B, el soporte es:
$Support(A=>B)=\frac{frequency(A,B)}{N}$
Nota: P(A∪B) es la probabilidad de que A y B ocurran juntos. P denota probabilidad.
Adelante, intenta calcular el soporte para Milk=>Diaper como ejercicio.
$Confidence(A=>B)=\frac{P(A\cap B)}{P(A)}=\frac{frequency(A,B)}{frequency(A)}$
Es el número de transacciones con A y B dividido por el total de transacciones que contienen A.
$Confidence(Bread=>Milk)=\frac{3}{4}=0.75=75\%$
Ahora calcula la confianza de Milk=>Diaper.
Nota: El soporte y la confianza miden lo interesante que es la regla. Se fijan con umbrales mínimos de soporte y confianza. Estos umbrales, definidos por el cliente, ayudan a comparar la fuerza de la regla según tus propios criterios o los del cliente. Cuanto más cerca estén del umbral (o por encima), más útil será la regla para el cliente.
Conjuntos frecuentes: Conjuntos de artículos cuyo soporte es mayor o igual que el soporte mínimo (min_sup). En el ejemplo anterior min_sup=3. Lo define el usuario.
Reglas fuertes: Si una regla A=>B[Support, Confidence] cumple min_sup y min_confidence, entonces es una regla fuerte.
Lift: El lift indica la correlación entre A y B en la regla A=>B. La correlación muestra cómo un conjunto A afecta al conjunto B.
$Lift(A=>B)=\frac{Support}{Supp(A)Supp(B)}$
Por ejemplo, para la regla {Bread}=>{Milk}, el lift se calcula así:
$support(Bread)=\frac{4}{5}=0.8$
$support(Milk)=\frac{4}{5}=0.8$
$Lift(Bread=>Milk)=\frac{0.6}{0.8*0.8}=0.9$
Si la regla tuviera un lift de 1, entonces A y B son independientes y no se puede derivar ninguna regla útil.
Si el lift es > 1, entonces A y B dependen entre sí, y el grado lo indica el valor de lift.
Si el lift es < 1, entonces la presencia de A tiene un efecto negativo sobre B.
Al aplicar minería de reglas de asociación sobre un conjunto de transacciones T, tu objetivo es encontrar todas las reglas con:
En esta parte del tutorial conocerás el algoritmo que ejecutan las librerías de R para el análisis de la cesta. Esto te ayudará a entender mejor a tus clientes y a analizar con más criterio. Si ya conoces el algoritmo APRIORI y cómo funciona, puedes ir directamente a la parte de código.
La minería de reglas de asociación se aborda en dos pasos:
Generación de conjuntos frecuentes: Encontrar todos los conjuntos frecuentes con soporte >= min_support predefinido
Generación de reglas: Listar todas las reglas de asociación a partir de los conjuntos frecuentes. Calcular soporte y confianza para todas. Podar las reglas que no superen los umbrales de min_support y min_confidence.
La generación de conjuntos frecuentes es el paso computacionalmente más costoso porque requiere escanear toda la base de datos.
Arriba viste un ejemplo con solo 5 transacciones, pero en el mundo real los datos de retail pueden llegar a GB y TB, por lo que se necesita un algoritmo optimizado que descarte conjuntos de artículos que no servirán en pasos posteriores. Para esto se usa el algoritmo APRIORI. Establece que:
Todo subconjunto de un conjunto frecuente también debe ser frecuente. En otras palabras, no se deben generar ni probar superconjuntos de un conjunto infrecuente.
Se representa mediante el retículo de conjuntos (Itemset Lattice), una representación gráfica del principio de APRIORI. Consta de nodos k-ítems y las relaciones de sus subconjuntos.
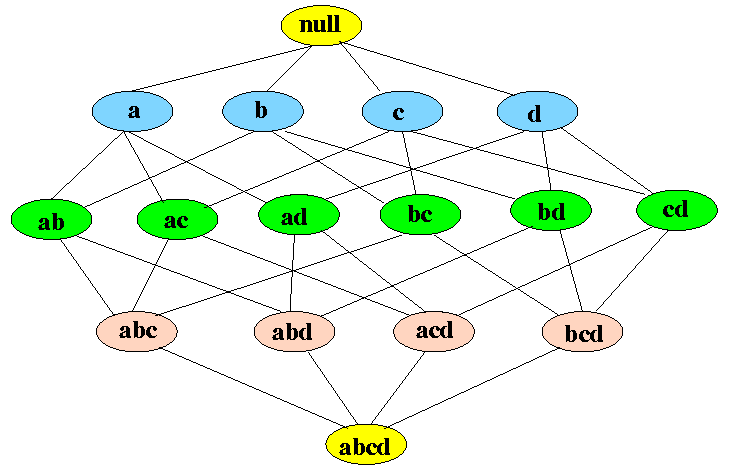
En la figura anterior, abajo están todos los artículos de los datos de transacciones y vas subiendo creando subconjuntos hasta el conjunto vacío. Para d artículos, el tamaño del retículo es $2^d$. Esto muestra lo difícil que sería generar los conjuntos frecuentes calculando el soporte de cada combinación. La siguiente figura muestra cuánto ayuda APRIORI a reducir el número de conjuntos a generar:
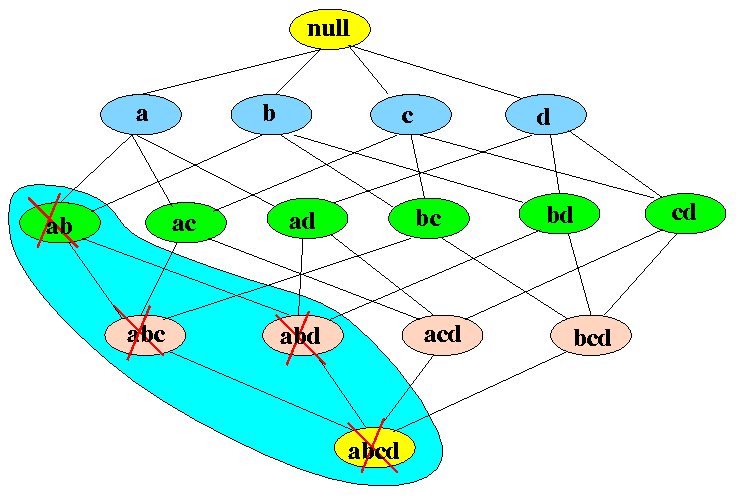
Si el conjunto {a,b} no es frecuente, no necesitamos considerar ninguno de sus superconjuntos.
Vamos a entenderlo con un ejemplo. A continuación verás por qué APRIORI es efectivo y cómo generar reglas de asociación fuertes paso a paso. ¡Sigue el proceso con tu cuaderno y bolígrafo!
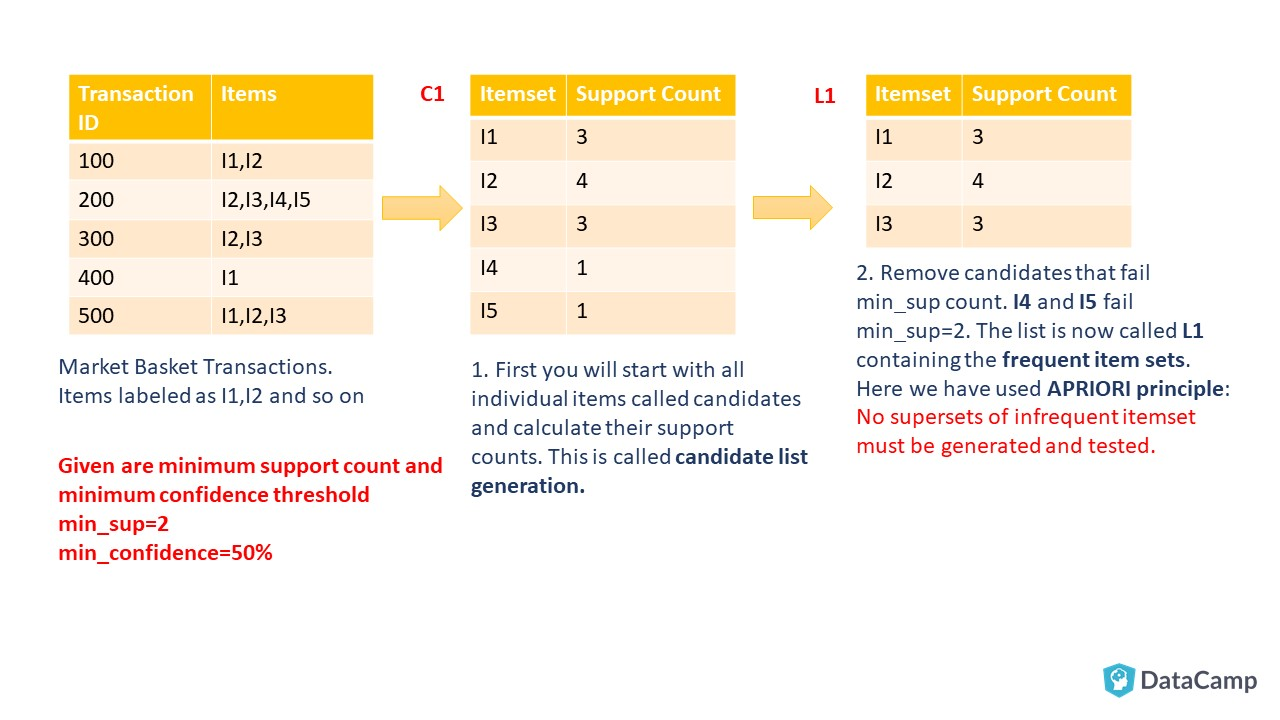
Como ves, empiezas creando la lista de candidatos para el conjunto de 1 ítem, que incluirá todos los artículos presentes en los datos de transacciones, de forma individual. Si piensas en datos reales de retail, puedes imaginar lo costosa que es esta generación de candidatos. Aquí APRIORI entra en juego y ayuda a reducir el tamaño de la lista de candidatos, de modo que al final se generan reglas útiles. En los siguientes pasos verás cómo llegamos al final de la generación de conjuntos frecuentes, el primer paso de la minería de reglas.
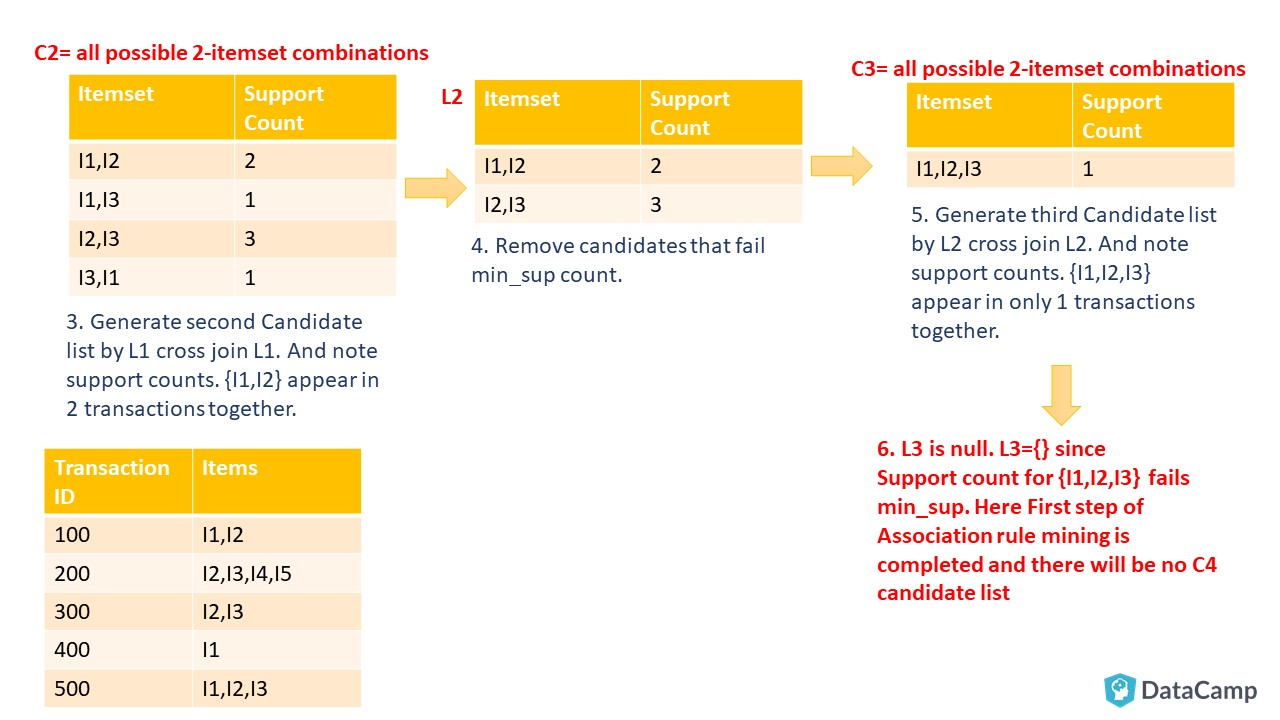
Tu siguiente paso será listar todos los conjuntos frecuentes. Tomarás el último conjunto frecuente no vacío, que en este ejemplo es L2={I1, I2},{I2, I3}. Luego crearás todos los subconjuntos no vacíos de los conjuntos presentes en esa lista de conjuntos frecuentes. Sigue el proceso como se ilustra a continuación:
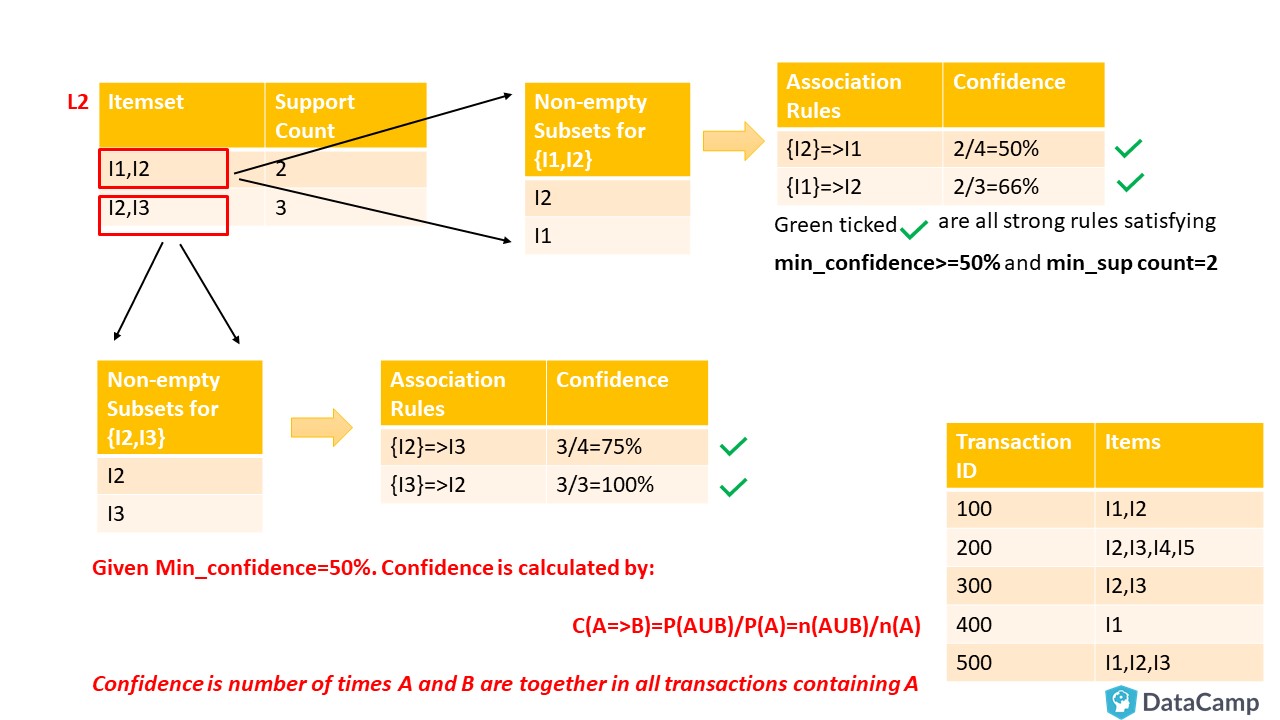
Arriba puedes ver cuatro reglas fuertes. Por ejemplo, toma ${I2}=>I3$ con una confianza del 75%: indica que el 75% de quienes compraron I2 también compraron I3.
Ya has aprendido el algoritmo APRIORI completo, uno de los más utilizados en minería de datos. ¡Vamos con el código, uf!
En este tutorial, usarás un dataset del UCI Machine Learning Repository. El dataset se llama Online-Retail y puedes descargarlo aquí. Contiene datos de transacciones desde el 01/12/2010 hasta el 09/12/2011 de un comercio electrónico sin tienda física registrado en Reino Unido. Usamos este y no un dataset de R porque es más probable que recibas datos de retail en este formato y tendrás que aplicar preprocesado.
Primero, carga las librerías necesarias. Una breve descripción (tomada de aquí) se muestra en la siguiente tabla para que sepas qué hace cada librería:
| Package | Descripción |
|---|---|
arules |
Proporciona la infraestructura para representar, manipular y analizar datos de transacciones y patrones (conjuntos frecuentes y reglas de asociación). |
arulesViz |
Amplía el paquete 'arules' con diversas técnicas de visualización para reglas de asociación y conjuntos de artículos. Incluye varias visualizaciones interactivas para explorar reglas. |
tidyverse |
Colección de paquetes de R pensados para ciencia de datos. |
readxl |
Leer archivos de Excel en R. |
plyr |
Herramientas para dividir, aplicar y combinar datos. |
ggplot2 |
Crear gráficos y visualizaciones. |
knitr |
Generación de informes dinámicos en R. |
lubridate |
Paquete de R que facilita trabajar con fechas y horas. |
#install and load package arules
#install.packages("arules")
library(arules)
#install and load arulesViz
#install.packages("arulesViz")
library(arulesViz)
#install and load tidyverse
#install.packages("tidyverse")
library(tidyverse)
#install and load readxml
#install.packages("readxml")
library(readxl)
#install and load knitr
#install.packages("knitr")
library(knitr)
#load ggplot2 as it comes in tidyverse
library(ggplot2)
#install and load lubridate
#install.packages("lubridate")
library(lubridate)
#install and load plyr
#install.packages("plyr")
library(plyr)
library(dplyr)Usa read_excel(path to file) para leer el dataset del archivo descargado en R. Indica la ruta completa al archivo, incluido el nombre, en read_excel(path-to-file-with-filename)
#read excel into R dataframe
retail <- read_excel('D:/Documents/Online_Retail.xlsx')
#complete.cases(data) will return a logical vector indicating which rows have no missing values. Then use the vector to get only rows that are complete using retail[,].
retail <- retail[complete.cases(retail), ]
#mutate function is from dplyr package. It is used to edit or add new columns to dataframe. Here Description column is being converted to factor column. as.factor converts column to factor column. %>% is an operator with which you may pipe values to another function or expression
retail %>% mutate(Description = as.factor(Description))
retail %>% mutate(Country = as.factor(Country))#Converts character data to date. Store InvoiceDate as date in new variable
retail$Date <- as.Date(retail$InvoiceDate)
#Extract time from InvoiceDate and store in another variable
TransTime<- format(retail$InvoiceDate,"%H:%M:%S")
#Convert and edit InvoiceNo into numeric
InvoiceNo <- as.numeric(as.character(retail$InvoiceNo))NAs introduced by coercion#Bind new columns TransTime and InvoiceNo into dataframe retail
cbind(retail,TransTime)cbind(retail,InvoiceNo)#get a glimpse of your data
glimpse(retail)Observations: 406,829
Variables: 9
$ InvoiceNo <chr> "536365", "536365", "536365", "536365", "536365", "536365", "53...
$ StockCode <chr> "85123A", "71053", "84406B", "84029G", "84029E", "22752", "2173...
$ Description <chr> "WHITE HANGING HEART T-LIGHT HOLDER", "WHITE METAL LANTERN", "C...
$ Quantity <dbl> 6, 6, 8, 6, 6, 2, 6, 6, 6, 32, 6, 6, 8, 6, 6, 3, 2, 3, 3, 4, 4,...
$ InvoiceDate <dttm> 2010-12-01 08:26:00, 2010-12-01 08:26:00, 2010-12-01 08:26:00,...
$ UnitPrice <dbl> 2.55, 3.39, 2.75, 3.39, 3.39, 7.65, 4.25, 1.85, 1.85, 1.69, 2.1...
$ CustomerID <dbl> 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, 17850, ...
$ Country <chr> "United Kingdom", "United Kingdom", "United Kingdom", "United K...
$ Date <date> 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 2010-12-01, 20...Ahora, el dataframe retail contendrá 10 atributos, con dos adicionales: Date y Time.
Antes de aplicar MBA/minería de reglas de asociación, necesitamos convertir el dataframe en datos de transacciones, de modo que todos los artículos comprados juntos en una factura queden en una sola fila. En la salida de glimpse ves que cada transacción está en forma atómica, es decir, todos los productos de una factura aparecen de forma atómica como en bases de datos relacionales. A este formato también se le llama formato singles.
Lo que debes hacer es agrupar los datos del dataframe retail por CustomerID, CustomerID y Date, o también puedes agrupar usando InvoiceNo y Date. Necesitamos este agrupamiento para aplicar una función y guardar la salida en otro dataframe. Esto puede hacerse con ddply.
Las siguientes líneas combinarán todos los productos de un InvoiceNo y Date y los unirán en una sola fila, con cada artículo separado por ,
library(plyr)
#ddply(dataframe, variables_to_be_used_to_split_data_frame, function_to_be_applied)
transactionData <- ddply(retail,c("InvoiceNo","Date"),
                       function(df1)paste(df1$Description,
                       collapse = ","))
#The R function paste() concatenates vectors to character and separated results using collapse=[any optional charcater string ]. Here ',' is usedtransactionDataDespués, como InvoiceNo y Date no aportarán al minado de reglas, puedes ponerlos a NULL.
#set column InvoiceNo of dataframe transactionData
transactionData$InvoiceNo <- NULL
#set column Date of dataframe transactionData
transactionData$Date <- NULL
#Rename column to items
colnames(transactionData) <- c("items")
#Show Dataframe transactionData
transactionDataA este formato de datos de transacción se le llama formato basket. Ahora debes guardar estos datos en un archivo .csv (valores separados por comas). Para ello, write.csv()
write.csv(transactionData,"D:/Documents/market_basket_transactions.csv", quote = FALSE, row.names = FALSE)
#transactionData: Data to be written
#"D:/Documents/market_basket.csv": location of file with file name to be written to
#quote: If TRUE it will surround character or factor column with double quotes. If FALSE nothing will be quoted
#row.names: either a logical value indicating whether the row names of x are to be written along with x, or a character vector of row names to be written.
Comprueba que tus datos de transacciones tienen el formato correcto:
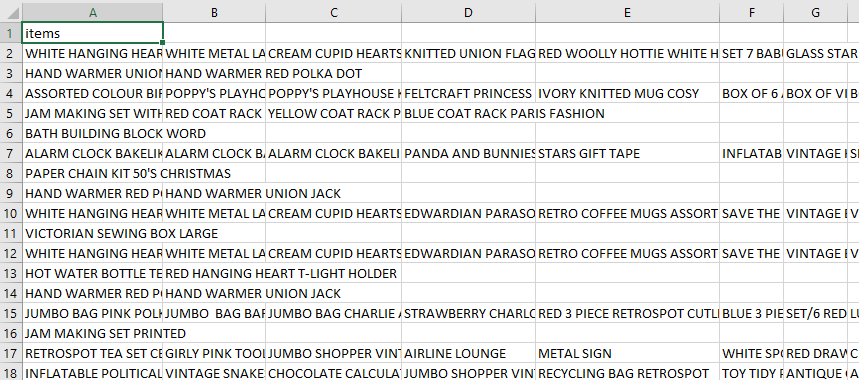
A continuación, debes cargar estos datos en un objeto de la clase transacción. Esto se hace con la función de R read.transactions del paquete arules.
La siguiente línea tomará el archivo D:/Documents/market_basket_transactions.csv en formato basket y lo convertirá en un objeto de clase transacción.
tr <- read.transactions('D:/Documents/market_basket_transactions.csv', format = 'basket', sep=',')
#sep tell how items are separated. In this case you have separated using ','
Al ejecutar las líneas anteriores puedes ver muchos EOF within quoted string en la salida; no te preocupes.
Si ya tienes los datos de transacciones en un dataframe, usa esta línea para convertirlo en objeto transacción:
`trObj<-as(dataframe.dat,"transactions")`Visualiza el objeto de transacción tr:
tr
transactions in sparse format with
 22191 transactions (rows) and
30066 items (columns) summary(tr)transactions in sparse format with
22191 transactions (rows) and
7876 items (columns)
transactions as itemMatrix in sparse format with
22191 rows (elements/itemsets/transactions) and
7876 columns (items) and a density of 0.001930725
most frequent items:
WHITE HANGING HEART T-LIGHT HOLDER REGENCY CAKESTAND 3 TIER
1803 1709
JUMBO BAG RED RETROSPOT PARTY BUNTING
1460 1285
ASSORTED COLOUR BIRD ORNAMENT (Other)
1250 329938
element (itemset/transaction) length distribution:
sizes
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17
3598 1594 1141 908 861 758 696 676 663 593 624 537 516 531 551 522 464
18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34
441 483 419 395 315 306 272 238 253 229 213 222 215 170 159 138 142
35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51
134 109 111 90 113 94 93 87 88 65 63 67 63 60 59 49 64
52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68
40 41 49 43 36 29 39 30 27 28 17 25 25 20 27 24 22
69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85
15 20 19 13 16 16 11 15 12 7 9 14 15 12 8 9 11
86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102
11 14 8 6 5 6 11 6 4 4 3 6 5 2 4 2 4
103 104 105 106 107 108 109 110 111 112 113 114 116 117 118 120 121
4 3 2 2 6 3 4 3 2 1 3 1 3 3 3 1 2
122 123 125 126 127 131 132 133 134 140 141 142 143 145 146 147 150
2 1 3 2 2 1 1 2 1 1 2 2 1 1 2 1 1
154 157 168 171 177 178 180 202 204 228 236 249 250 285 320 400 419
3 2 2 2 1 1 1 1 1 1 1 1 1 1 1 1 1
Min. 1st Qu. Median Mean 3rd Qu. Max.
1.00 3.00 10.00 15.21 21.00 419.00
includes extended item information - examples:
labels
1 1 HANGER
2 10 COLOUR SPACEBOY PEN
3 12 COLOURED PARTY BALLOONSsummary(tr) es un comando muy útil que da información sobre nuestro objeto transacción. Observa lo que dice la salida anterior:
Hay 22191 transacciones (filas) y 7876 artículos (columnas). Ten en cuenta que 7876 son las descripciones de producto del dataset y 22191 transacciones son combinaciones de esos artículos.
La densidad indica el porcentaje de celdas no nulas en una matriz dispersa. Puedes verla como el total de artículos comprados dividido por el número posible de artículos en esa matriz. Puedes calcular cuántos artículos se compraron usando la densidad: 22191x7876x0.001930725=337445
Información: Matriz dispersa (sparse matrix): es una matriz en la que la mayoría de elementos son cero. En contraste, si la mayoría son no cero, se considera densa. El número de elementos cero dividido por el total se llama dispersidad de la matriz (igual a 1 menos la densidad).
Summary también puede mostrarte los artículos más frecuentes.
Distribución de longitud de elementos (itemset/transacción): Indica cuántas transacciones hay de 1 ítem, de 2 ítems, etc. La primera fila muestra el número de ítems y la segunda, el número de transacciones.
Por ejemplo, hay solo 3598 transacciones de un único artículo, 1594 transacciones con 2 artículos, y hay 419 artículos en una transacción, que es la más larga.
Puedes generar un itemFrequencyPlot para crear un diagrama de barras de frecuencias de ítems y ver la distribución de objetos basada en itemMatrix (p. ej., >transactions o ítems en >itemsets y >rules), que es nuestro caso.
# Create an item frequency plot for the top 20 items
if (!require("RColorBrewer")) {
  # install color package of R
install.packages("RColorBrewer")
#include library RColorBrewer
library(RColorBrewer)
}
itemFrequencyPlot(tr,topN=20,type="absolute",col=brewer.pal(8,'Pastel2'), main="Absolute Item Frequency Plot")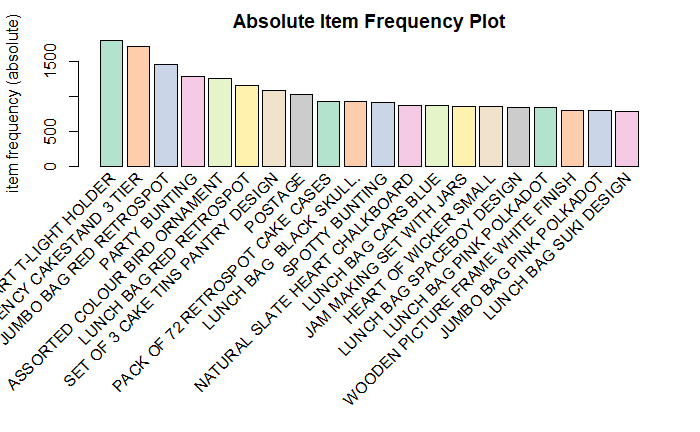
En
itemFrequencyPlot(tr,topN=20,type="absolute")el primer argumento es el objeto transacción a representar, tr. topN permite representar los N artículos con mayor frecuencia. type puede ser type="absolute" o type="relative". Si es absoluto, dibuja las frecuencias numéricas de cada artículo independientemente. Si es relativo, representa cuántas veces aparecen respecto al resto.
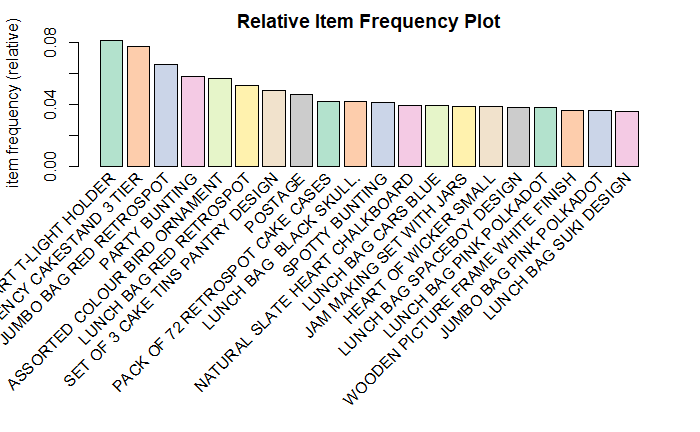
itemFrequencyPlot(tr,topN=20,type="relative",col=brewer.pal(8,'Pastel2'),main="Relative Item Frequency Plot")Este gráfico muestra que 'WHITE HANGING HEART T-LIGHT HOLDER' y 'REGENCY CAKESTAND 3 TIER' tienen más ventas. Así que, para aumentar las ventas de 'SET OF 3 CAKE TINS PANTRY DESIGN', el minorista puede colocarlo cerca de 'REGENCY CAKESTAND 3 TIER'.
Puedes explorar más opciones de itemFrequencyPlot aquí.
El siguiente paso es extraer las reglas usando el algoritmo APRIORI. La función apriori() es del paquete arules.
# Min Support as 0.001, confidence as 0.8.
association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=10))
Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[0 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.11s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.70s].
writing ... [49122 rule(s)] done [0.06s].
creating S4 object ... done [0.06s]. set of 49122 rules
rule length distribution (lhs + rhs):sizes
2 3 4 5 6 7 8 9 10
105 2111 6854 16424 14855 6102 1937 613 121
Min. 1st Qu. Median Mean 3rd Qu. Max.
2.000 5.000 5.000 5.499 6.000 10.000
summary of quality measures:
support confidence lift count
Min. :0.001036 Min. :0.8000 Min. : 9.846 Min. : 23.00
1st Qu.:0.001082 1st Qu.:0.8333 1st Qu.: 22.237 1st Qu.: 24.00
Median :0.001262 Median :0.8788 Median : 28.760 Median : 28.00
Mean :0.001417 Mean :0.8849 Mean : 64.589 Mean : 31.45
3rd Qu.:0.001532 3rd Qu.:0.9259 3rd Qu.: 69.200 3rd Qu.: 34.00
Max. :0.015997 Max. :1.0000 Max. :715.839 Max. :355.00
mining info:
data ntransactions support confidence
tr 22191 0.001 0.8apriori tomará tr como objeto de transacciones sobre el que minar. parameter te permite fijar min_sup y min_confidence. Los valores por defecto son soporte mínimo 0.1, confianza mínima 0.8 y máximo de 10 ítems (maxlen).
summary(association.rules) muestra lo siguiente:
Especificación de parámetros: min_sup=0.001 y min_confidence=0.8 con 10 ítems como máximo por regla.
Número total de reglas: Conjunto de 49122 reglas
Distribución de longitudes de regla: Las reglas de longitud 5 son las más numerosas: 16424, y de longitud 2, las menos: 105
Resumen de medidas de calidad: Valores mínimos y máximos de soporte, confianza y lift.
Información usada para crear reglas: Los datos, soporte y confianza proporcionados al algoritmo.
Como hay 49122 reglas, imprimamos solo las 10 primeras:
inspect(association.rules[1:10]) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82000 28
[2] {WOBBLY CHICKEN} => {DECORATION} 0.001261773 1 443.82000 28
[3] {DECOUPAGE} => {GREETING CARD} 0.001036456 1 389.31579 23
[4] {BILLBOARD FONTS DESIGN} => {WRAP} 0.001306836 1 715.83871 29
[5] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82000 34
[6] {WOBBLY RABBIT} => {DECORATION} 0.001532153 1 443.82000 34
[7] {FUNK MONKEY} => {ART LIGHTS} 0.001712406 1 583.97368 38
[8] {ART LIGHTS} => {FUNK MONKEY} 0.001712406 1 583.97368 38
[9] {BLACK TEA} => {SUGAR JARS} 0.002072912 1 238.61290 46
[10] {BLACK TEA} => {COFFEE} 0.002072912 1 69.34687 46 Con la salida anterior, puedes hacer análisis como:
El 100% de los clientes que compraron 'WOBBLY CHICKEN' también compraron 'METAL'.
El 100% de los clientes que compraron 'BLACK TEA' también compraron 'SUGAR JARS'.
¿Cómo puedes limitar el tamaño y la cantidad de reglas generadas? Ajustando los parameters en apriori. Si quieres reglas más fuertes, aumenta el valor de conf y, para reglas más largas, incrementa maxlen.
shorter.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8,maxlen=3))Puedes eliminar reglas que son subconjuntos de reglas más grandes. Usa el siguiente código para quitarlas:
subset.rules <- which(colSums(is.subset(association.rules, association.rules)) > 1) # get subset rules in vector
length(subset.rules)  #> 3913
[1] 44014subset.association.rules. <- association.rules[-subset.rules] # remove subset rules.
which(): devuelve la posición de los elementos del vector cuyo valor es TRUE.
colSums(): suma por columnas para dataframes y arrays numéricos.
is.subset(): determina si los elementos de un vector contienen todos los de otro.
A veces quieres centrarte en un producto específico. Si quieres averiguar qué influye en la compra del artículo X, puedes usar la opción appearance en apriori. appearance nos permite fijar la LHS (parte IF) y la RHS (parte THEN) de la regla.
Por ejemplo, para saber qué compran los clientes antes de comprar 'METAL', ejecuta:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(default="lhs",rhs="METAL"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.21s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 3 4 5 6 7 8 9 10Mining stopped (maxlen reached). Only patterns up to a length of 10 returned! done [0.63s].
writing ... [5 rule(s)] done [0.07s].
creating S4 object ... done [0.02s]. # Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[2] {WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34
[3] {DECORATION} => {METAL} 0.002253166 1 443.82 50
[4] {DECORATION,WOBBLY CHICKEN} => {METAL} 0.001261773 1 443.82 28
[5] {DECORATION,WOBBLY RABBIT} => {METAL} 0.001532153 1 443.82 34 De forma similar, para responder a Quienes compraron METAL también compraron... pondrás METAL en lhs:
metal.association.rules <- apriori(tr, parameter = list(supp=0.001, conf=0.8),appearance = list(lhs="METAL",default="rhs"))Apriori
Parameter specification:
confidence minval smax arem aval originalSupport maxtime support minlen maxlen target
0.8 0.1 1 none FALSE TRUE 5 0.001 1 10 rules
ext
FALSE
Algorithmic control:
filter tree heap memopt load sort verbose
0.1 TRUE TRUE FALSE TRUE 2 TRUE
Absolute minimum support count: 22
set item appearances ...[1 item(s)] done [0.00s].
set transactions ...[30066 item(s), 22191 transaction(s)] done [0.10s].
sorting and recoding items ... [2324 item(s)] done [0.02s].
creating transaction tree ... done [0.02s].
checking subsets of size 1 2 done [0.01s].
writing ... [1 rule(s)] done [0.00s].
creating S4 object ... done [0.01s].# Here lhs=METAL because you want to find out the probability of that in how many customers buy METAL along with other items
inspect(head(metal.association.rules)) lhs rhs support confidence lift count
[1] {METAL} => {DECORATION} 0.002253166 1 443.82 50 Como se generarán cientos o miles de reglas, necesitas varias formas de presentar tus hallazgos. Ya vimos ItemFrequencyPlot, que también es útil para ver los artículos más vendidos.
Aquí veremos estas visualizaciones:
Una visualización directa de las reglas de asociación es un scatter plot usando plot() del paquete arulesViz. Usa soporte y confianza en los ejes. Además, por defecto usa el lift para colorear (niveles de gris) los puntos.
# Filter rules with confidence greater than 0.4 or 40%
subRules<-association.rules[quality(association.rules)$confidence>0.4]
#Plot SubRules
plot(subRules)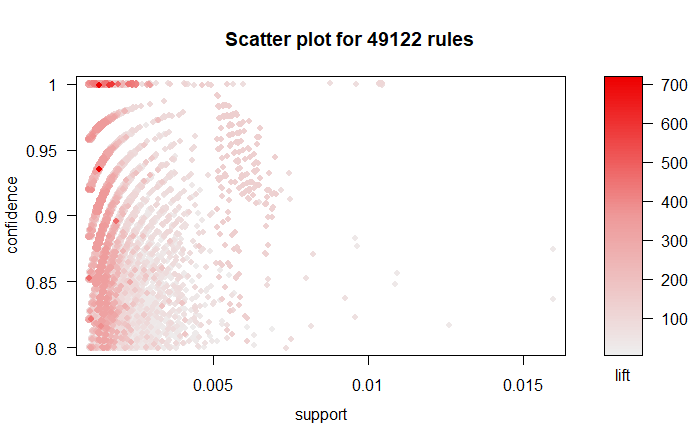
El gráfico muestra que las reglas con lift alto suelen tener soporte bajo. Puedes usar las siguientes opciones para el plot:
plot(rulesObject, measure, shading, method)rulesObject: el objeto de reglas a representar
measure: medidas de interés de las reglas. Puede ser Support, Confidence, lift o una combinación, según el method.
shading: medida usada para el color (Support, Confidence, lift). Por defecto es Lift.
method: método de visualización (scatterplot, two-key plot, matrix3D).
plot(subRules,method="two-key plot")
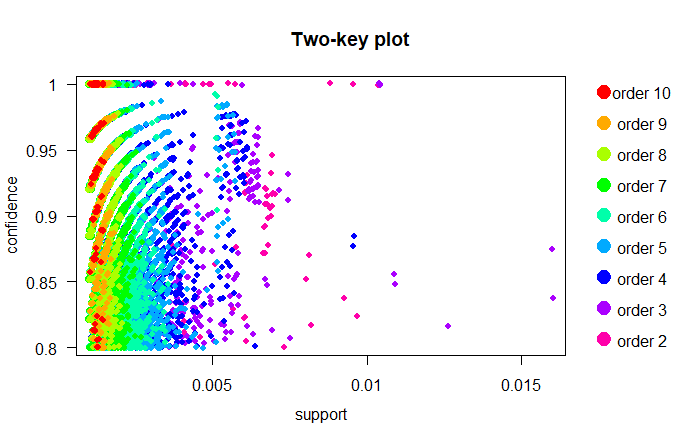
El two-key plot usa soporte y confianza en los ejes x e y, respectivamente. Utiliza order para colorear, que es el número de ítems en la regla.
Un gráfico interactivo excelente para presentar reglas usa arulesViz y plotly. Puedes pasar el ratón sobre cada regla y ver todas las medidas de calidad (soporte, confianza y lift).
plotly_arules(subRules)'plotly_arules' is deprecated.
Use 'plot' instead.
See help("Deprecated")plot: Too many rules supplied. Only plotting the best 1000 rules using measure lift (change parameter max if needed)To reduce overplotting, jitter is added! Use jitter = 0 to prevent jitter.Las técnicas basadas en grafos visualizan reglas de asociación con vértices y aristas, donde los vértices están etiquetados con nombres de artículos y los conjuntos/reglas se representan como un segundo conjunto de vértices. Los ítems se conectan con los conjuntos/reglas mediante flechas dirigidas. Las flechas desde ítems a vértices de reglas indican la LHS y una flecha desde una regla a un ítem indica la RHS. El tamaño y el color de los vértices suelen representar medidas de interés.
Los grafos son una forma estupenda de visualizar reglas pero tienden a congestionarse cuando hay muchas. Es mejor mostrar pocas reglas con este tipo de visualización.
Seleccionemos 10 reglas de subRules con la mayor confianza.
top10subRules <- head(subRules, n = 10, by = "confidence")Ahora, dibuja un grafo interactivo:
Nota: Puedes hacer interactivos todos tus plots usando el parámetro engine=htmlwidget en plot
plot(top10subRules, method = "graph", engine = "htmlwidget")
Desde arulesViz, los grafos de conjuntos de reglas de asociación pueden exportarse en formato GraphML o como dot-file de Graphviz para analizarlos en herramientas como Gephi. Por ejemplo, las 1000 reglas con mayor lift se exportan con:
saveAsGraph(head(subRules, n = 1000, by = "lift"), file = "rules.graphml")Esta representación también se llama Parallel Coordinates Plot. Es útil para visualizar qué productos, junto con qué artículos, provocan cierto tipo de ventas.
Como se mencionó arriba, la RHS es el consecuente o el artículo que proponemos que el cliente comprará; las posiciones en la LHS indican que 2 es la adición más reciente a nuestra cesta y 1 el artículo previo.
# Filter top 20 rules with highest lift
subRules2<-head(subRules, n=20, by="lift")
plot(subRules2, method="paracoord")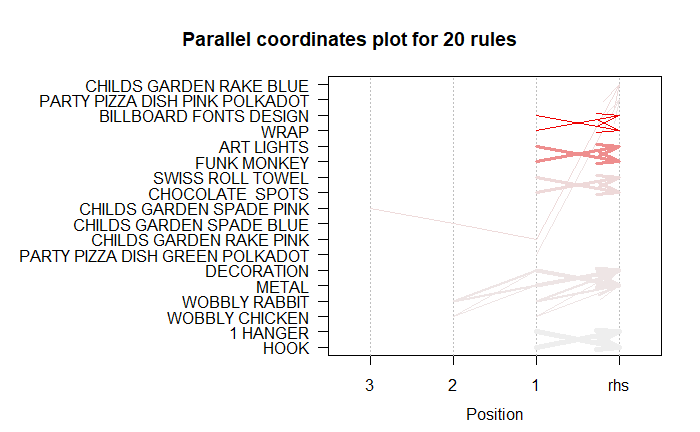
Fíjate en la flecha superior. Muestra que cuando tengo 'CHILDS GARDEN SPADE PINK' y 'CHILDS GARDEN RAKE PINK' en mi cesta, es probable que también compre 'CHILDS GARDEN RAKE BLUE'.
¡Enhorabuena! Has aprendido APRIORI, uno de los algoritmos más usados en minería de datos. Has visto qué es la minería de reglas de asociación, sus aplicaciones y su aplicación en retail como Market Basket Analysis. Ahora también eres capaz de implementar Market Basket Analysis en R y presentar tus reglas con gráficos potentes. ¡A seguir aprendiendo!
Si quieres aprender más sobre R, haz el curso de DataCamp Importing and Managing Financial Data in R.
Aprende más sobre R
Curso
Curso
Curso
blog
Javier Canales Luna
14 min
blog
Elena Kosourova
14 min
Tutorial
Eugenia Anello
8 min
Tutorial
Zoumana Keita
15 min
Tutorial
Eladio Montero Porras
15 min
Tutorial
Arunn Thevapalan
15 min




