Kurs
Einführung in R
4 Std.
3.1M
Eine Markov-Kette ist ein mathematisches System, das Übergänge von einem Zustand in einen anderen gemäß vorgegebenen Wahrscheinlichkeiten durchläuft. Markov-Ketten sind stochastische Prozesse, zeichnen sich aber dadurch aus, dass sie kein „Gedächtnis“ besitzen. Das heißt: Die Wahrscheinlichkeit für den nächsten Zustand hängt nur vom aktuellen Zustand ab, nicht von früheren. Das nennt man die Markov-Eigenschaft (siehe unten):

Für ein funktionsfähiges Markov-Ketten-Modell ist es entscheidend, eine Übergangsmatrix Pt zu definieren. Eine Übergangsmatrix enthält die Wahrscheinlichkeiten für die Übergänge zwischen den verschiedenen Zuständen im System. Damit eine Übergangsmatrix gültig ist, muss jede Zeile ein Wahrscheinlichkeitsvektor sein, dessen Summe 1 ergibt.
Übergangsmatrizen haben die Eigenschaft, dass das Produkt aufeinanderfolgender Matrizen die Übergangswahrscheinlichkeiten über ein Zeitintervall beschreibt. Daher lässt sich die Wahrscheinlichkeit, sich nach k Schritten in einem bestimmten Zustand zu befinden, wie folgt modellieren:

Dieses Tutorial behandelt außerdem absorbierende Markov-Ketten. Diese treten auf, wenn es mindestens einen Zustand gibt, den man, sobald er erreicht wurde, mit Wahrscheinlichkeit 1 nicht mehr verlässt.
Eine absorbierende Markov-Kette ist eine Markov-Kette, in der es unmöglich ist, bestimmte Zustände nach dem Eintritt wieder zu verlassen. Das ist jedoch nur eine der Voraussetzungen. Damit eine Markov-Kette absorbierend ist, müssen alle übrigen transienten Zustände den absorbierenden Zustand mit Wahrscheinlichkeit 1 erreichen können.
Absorbierende Markov-Ketten haben spezifische Eigenschaften, die sie von gewöhnlichen zeit-homogenen Markov-Ketten unterscheiden. Eine davon ist die Schreibweise der Übergangsmatrix. Bei einer Kette mit t transienten und r absorbierenden Zuständen lässt sich die Übergangsmatrix P in kanonischer Form wie folgt schreiben:

Dabei ist Q eine t x t-Matrix, R eine t x r-Matrix, 0 eine r x t-Nullmatrix und Ir eine r x r-Einheitsmatrix. Insbesondere ermöglicht die Zerlegung der Übergangsmatrix in die Fundamentalmatrix bestimmte Berechnungen wie die erwartete Schrittzahl bis zur Absorption aus jedem Zustand. Die Fundamentalmatrix N wird wie folgt berechnet:

Wobei It eine t x t-Einheitsmatrix ist.
Die erwartete Schrittzahl basiert auf der Linearität der Erwartung und wird wie folgt berechnet:

Wobei 1 ein Spaltenvektor der Länge der transienten Zustände ist, dessen Einträge alle 1 sind.
Außerdem können wir die Wahrscheinlichkeit berechnen, von einem bestimmten transienten Zustand aus in einen speziellen absorbierenden Zustand absorbiert zu werden. Diese Wahrscheinlichkeit berechnet sich wie folgt:

Markov-Ketten werden in vielen Bereichen eingesetzt, etwa in der Finanzwelt, Spieltheorie und Genetik. In diesem Tutorial nutzen wir sie, um die Länge eines Vertriebsprozesses zu modellieren, da dieser einem Markov-Prozess entsprechen kann. Das wurde überprüft, indem wir getestet haben, ob die Sequenzen der Phasen, die ein Deal bis zum erfolgreichen Abschluss durchlief, die Markov-Eigenschaft erfüllen.
Für die Analyse haben wir angenommen, dass die Wahrscheinlichkeiten für das Voranschreiten eines Deals im Vertriebsprozess innerhalb einer Branche von Monat zu Monat konstant sind, sodass wir zeit-homogene Markov-Ketten verwenden können. Dabei bleiben die Übergangswahrscheinlichkeiten zwischen Zuständen über die Zeit konstant, während die Zahl der Schritte k zunimmt.
Die berechneten Wahrscheinlichkeiten waren:
Diese Analyse wurde mit der Programmiersprache R durchgeführt. R bietet mit dem Paket markovchain ein praktisches Toolkit, das eine Vielzahl von Markov-Kettentypen abdecken kann.
Zu Beginn haben wir geprüft, ob unsere Vertriebssequenzen die Markov-Eigenschaft erfüllen. Dafür stellt das Paket markovchain die nützliche Funktion verifyMarkovProperty() bereit. Sie prüft mittels Chi-Quadrat-Tests auf einer Reihe von Kontingenztafeln aus der Ereignissequenz, ob die Markov-Eigenschaft gilt. Große p-Werte deuten darauf hin, dass die Nullhypothese, dass die Sequenz die Markov-Eigenschaft erfüllt, nicht verworfen werden sollte. Unten siehst du eine Beispielsequenz, die zeigt, in welcher Phase sich ein Deal jeden Monat vom ersten Meeting bis zum Abschluss befand:
library(markovchain)
library(dplyr)
# SDR Funnel sind die Phasen unserer Sales Representatives, AE Funnel die Phasen unserer Account Executives, und CW ist ein erfolgreich abgeschlossener Deal
seq <- c('SDR Funnel','SDR Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','AE Funnel','CW')
verifyMarkovProperty(seq)
## Testing markovianity property on given data sequence
## Chi - square statistic is: 0.5733333 degrees of freedom are: 27 and corresponding p-value is: 1Da der p-Wert über 0,05 liegt, verwerfen wir die Nullhypothese nicht und nehmen an, dass die Sequenz die Markov-Eigenschaft erfüllt.
Nach der Verifizierung haben wir die Struktur der Markov-Kette zusammen mit den aus den Daten abgeleiteten Übergangswahrscheinlichkeiten visualisiert. Der folgende Code erzeugt ein Markov-Ketten-Objekt, indem die Übergangsmatrix sowie die Zustandsnamen definiert werden. Anschließend werden die Kette und die Übergangswahrscheinlichkeiten dargestellt.
source('TransProb.R')
source('MatDataBase.R')
source('GatherTransMat.R')
transElec <- GatherTransMat('Manufacturing','Between 100M and 500M', 'Between 500 and 1k')
print(transElec)
markov2 <- new('markovchain',
transitionMatrix = transElec, # Dies sind die Übergangswahrscheinlichkeiten einer zufällig ausgewählten Branche
states = c('SDR','AE','CW'))
layout <- matrix(c(0,0,0,1,1,0), ncol = 2, byrow = TRUE)
plot(markov2, node.size = 10, layout = layout)## [,1] [,2] [,3]
## [1,] 0.5573215 0.4426785 0.0000000
## [2,] 0.0000000 0.8678118 0.1321882
## [3,] 0.0000000 0.0000000 1.0000000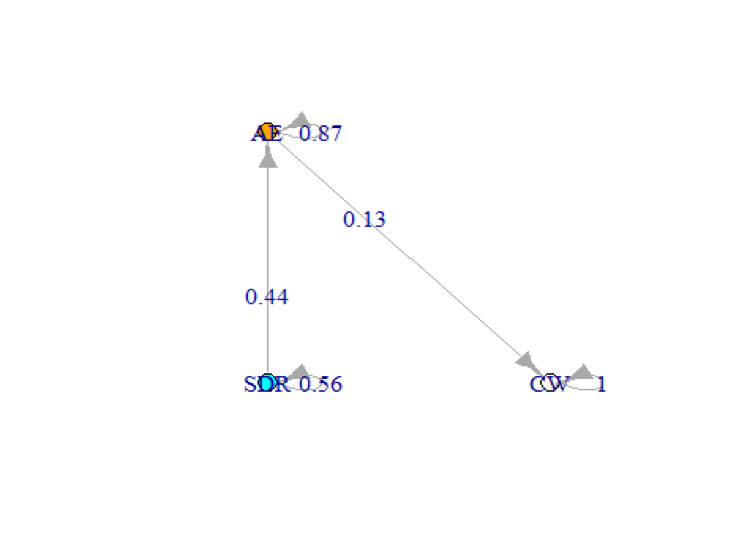
Da wir eine absorbierende Markov-Kette haben, berechnen wir die erwartete Zeit bis zur Absorption. Der erste Eintrag des Vektors gibt die erwartete Zahl an Schritten bis zum Abschluss an, wenn wir im SDR-Funnel starten, der zweite Eintrag entsprechend beim Start im AE-Funnel.
# Q aus der Übergangsmatrix extrahieren
Q <- transElec[1:2,1:2]
# It erzeugen
It <- diag(2)
# Fundamentalmatrix berechnen
N <- solve(It-Q)
# Spaltenvektor aus Einsen erzeugen
one <- t(t(c(1,1)))

# Erwartete Schritte per Matrixmultiplikation berechnen
expected <- N%*%one
print(expected)
## [,1]
## [1,] 9.823945
## [2,] 7.564969Wir können außerdem visualisieren, wie sich die Wahrscheinlichkeiten mit steigender Schrittzahl verändern, um die erwartete Schrittzahl zu kontrastieren. Daher haben wir die Wahrscheinlichkeiten geprüft, mit denen sich ein Deal über 24 Schritte in einem der drei Stadien befindet.
library(ggplot2)

initState <- c(1,0,0) # Der Anfangszustand ist der SDR Funnel (entspricht dem Setzen eines initialen Discovery-Termins)

# Wahrscheinlichkeitsvektoren initialisieren
SDRProb <- c()
AEProb <- c()
CW <- c()

# Wahrscheinlichkeiten für 24 Schritte berechnen
for(k in 1:24){
  nsteps <- initState*markov2^k
  SDRProb[k] <- nsteps[1,1]
  AEProb[k] <- nsteps[1,2]
  CW[k] <- nsteps[1,3]
}

# Data Frames erstellen und zusammenführen
SDRProb <- as.data.frame(SDRProb)
SDRProb$Group <- 'SDR'
SDRProb$Iter <- 1:24
names(SDRProb)[1] <- 'Value'

AEProb <- as.data.frame(AEProb)
AEProb$Group <- 'AE'
AEProb$Iter <- 1:24
names(AEProb)[1] <- 'Value'

CW <- as.data.frame(CW)
CW$Group <- 'CW'
CW$Iter <- 1:24
names(CW)[1] <- 'Value'

steps <- rbind(SDRProb,AEProb,CW)

# Wahrscheinlichkeiten mit ggplot visualisieren
ggplot(steps, aes(x = Iter, y = Value, col = Group))+
  geom_line() +
  xlab('Chain Step') +
  ylab('Probability') +
  ggtitle('24 Step Chain Probability Prediction')+
  theme(plot.title = element_text(hjust = 0.5))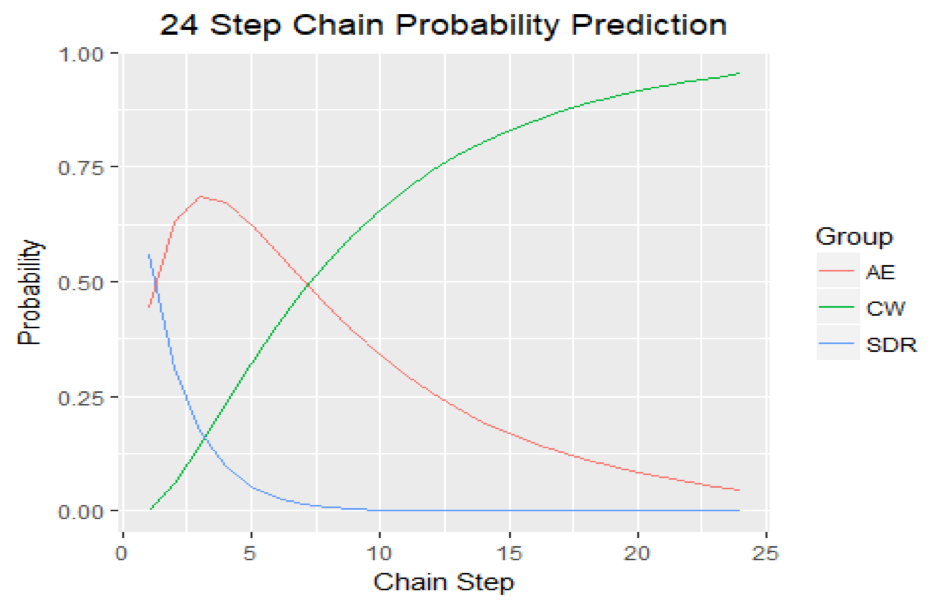
Kombiniert man beide Ergebnisse, wird deutlich, dass der Zustand CW nach 6–9 Schritten am wahrscheinlichsten wird. Da es sich bei den Übergangswahrscheinlichkeiten um monatliche Wahrscheinlichkeiten handelt, kann man argumentieren, dass die typische Sales Velocity von der ersten Terminvereinbarung bis zum erfolgreichen Abschluss in dieser Branche zwischen 6 und 9 Monaten liegt. Das ist ein recht langer Vertriebsprozess.
Ziel dieser Analyse war es zu zeigen, wie sich die Grundprinzipien von Markov-Ketten und absorbierenden Markov-Ketten nutzen lassen, um eine geschäftsrelevante Frage zu beantworten. In diesem Fall waren die Ergebnisse trotz der Annahme zeitlicher Homogenität erstaunlich präzise, denn weitere empirische Analysen ergaben, dass die durchschnittliche Sales Velocity in der hier betrachteten Branche bei 208 Tagen lag – also fast 7 Monate. Hoffentlich motiviert dich dieses Beispiel, Markov-Ketten weiter zu erkunden und auf deine eigenen Business-Fragen anzuwenden.
Wenn du mehr über R lernen möchtest, besuche den DataCamp-Kurs Intermediate R.
Sieh dir auch unser Markov Chains in Python: Beginner Tutorial an.
R-Kurse
Kurs
Kurs
Kurs