Kurs
Machine Learning verstehen
2 Std.
308K
Machine-Learning-Modelle haben Hyperparameter, die ihre Leistung stark beeinflussen. Diese Parameter sind wie die richtige Temperatur beim Kuchenbacken oder der richtige Winkel beim Pfannkuchenwenden. Im Reinforcement Learning beeinflussen Hyperparameter die Politik- und Belohnungsapproximationen. Mit besser abgestimmten Werten kann Hyperparameteroptimierung die Ergebnisse deutlich verbessern.
In diesem Artikel schauen wir uns Optuna an, ein leistungsstarkes Open-Source-Framework zur Optimierung von Hyperparametern. Wenn du neu im Thema bist, starte am besten mit Understanding Machine Learning — einer No-Code-Einführung. Für Praxis mit Python probiere unseren Kurs Machine Learning Fundamentals with Python, der scikit-learn verwendet. Anschließend hilft dir MLOps Concepts zu verstehen, wie du ML-Modelle von lokalen Notebooks in Produktionsumgebungen überführst. Und der Kurs Preprocessing for Machine Learning in Python ist für diesen Artikel besonders relevant, weil er dir zeigt, wie du Daten für ML-Modelle aufbereitest.
Optuna ist ein Open-Source-Framework zur Hyperparameteroptimierung, das die Suche nach optimalen Einstellungen automatisiert. Es lässt sich mit jedem Machine- oder Deep-Learning-Framework nutzen. Zu den wichtigsten Stärken von Optuna gehören:
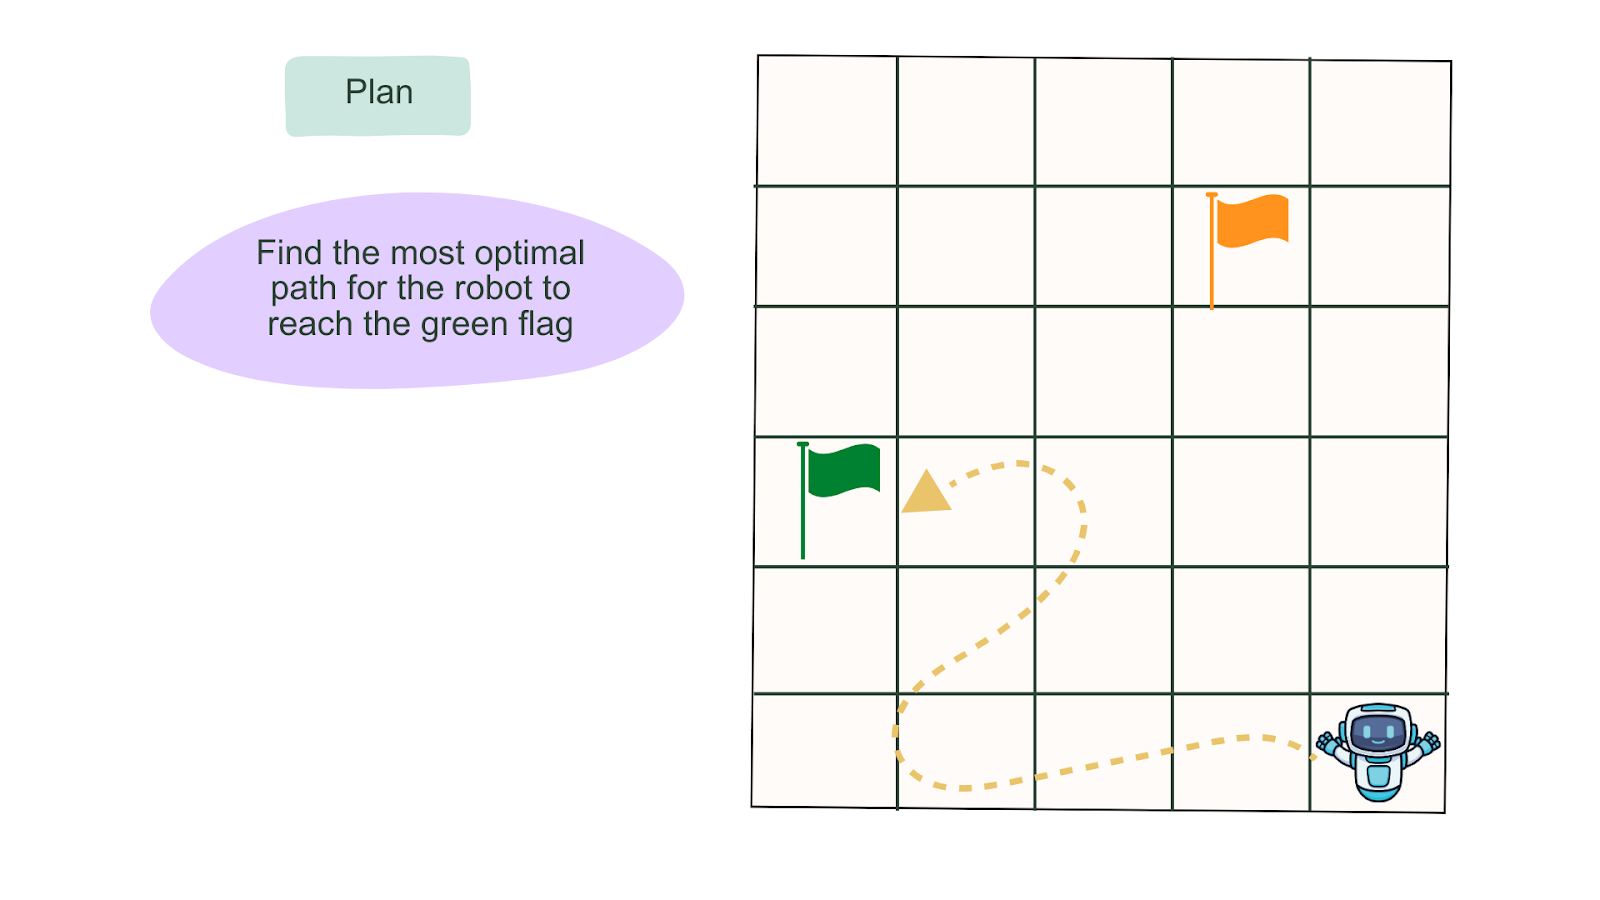
Den optimalen Pfad finden. Quelle: Bild der Autorin / des Autors
Reinforcement Learning (RL) vereint Machine Learning und Optimale Regelung. Es untersucht, wie ein intelligenter Agent in einer dynamischen Umgebung handeln sollte, um seine kumulative Belohnung zu maximieren. Kurz gesagt: Beim Reinforcement Learning bringen wir einem Agenten bei, Entscheidungen so zu treffen, dass er in seiner Umgebung möglichst viele Belohnungen erzielt. Die Belohnung für jeden Schritt kann positiv oder negativ sein, je nachdem, ob er dem Ziel näher kommt.
Im Gegensatz zu klassischem Machine Learning treffen RL-Algorithmen Entscheidungen, um ein möglichst gutes Ergebnis zu erreichen — ähnlich einem Trial-and-Error-Prozess, den wir selbst zum Erreichen unserer Ziele nutzen. Deep Reinforcement Learning unterscheidet sich dadurch, dass tiefe neuronale Netze genutzt werden, um komplexe Funktionen zu approximieren. Man kann auch sagen: Klassisches RL arbeitet eher deterministisch, während Deep RL stärker auf stochastische Ansätze setzt.
In einer Umgebung gibt es oft viele Wege zum Ziel. Im Vergleich zu überwachtem Lernen reagiert Deep Reinforcement Learning deutlich sensibler auf Hyperparameter wie Lernrate, Gamma, Anzahl der Schritte und mehr.
Eine unglückliche Wahl der Hyperparameter führt leicht zu schlechter oder instabiler Konvergenz. Erschwerend kommt hinzu, dass sich die Leistung je nach Zufalls-Seed (für die Initialisierung von Netzwerkgewichten und Umgebung) spürbar unterscheiden kann.
In diesem Abschnitt richten wir Optuna und die nötigen Abhängigkeiten ein, definieren den Suchraum und führen die Optimierung für den Algorithmus MountainCarContinuous-v0 durch. MountainCarContinuous-v0 ist einer der RL-Algorithmen im RL-Zoo, einem Trainings-Framework mit Skripten zur Agentenbewertung und Ergebnisvisualisierung. Der Algorithmus modelliert eine Umgebung, in der der Agent (ein Auto) versucht, sein Ziel zu erreichen (die Flagge zu erreichen).
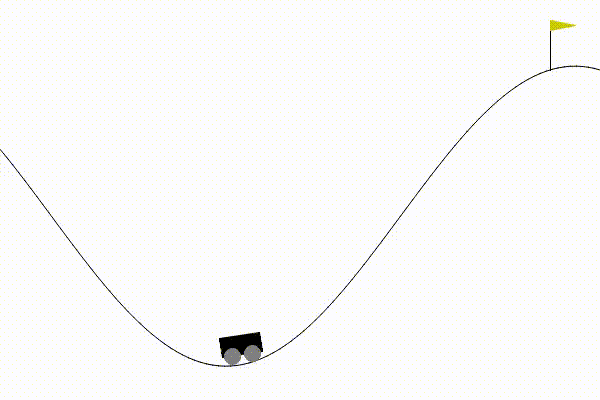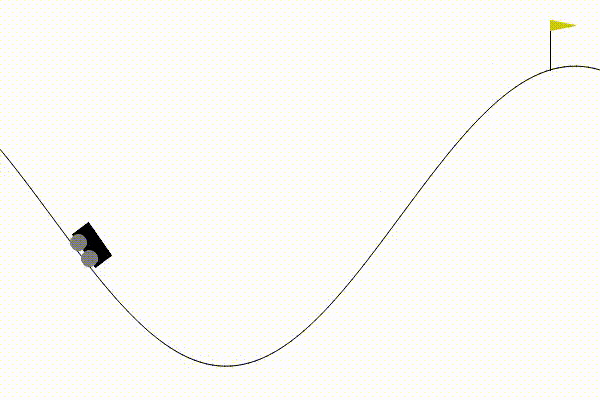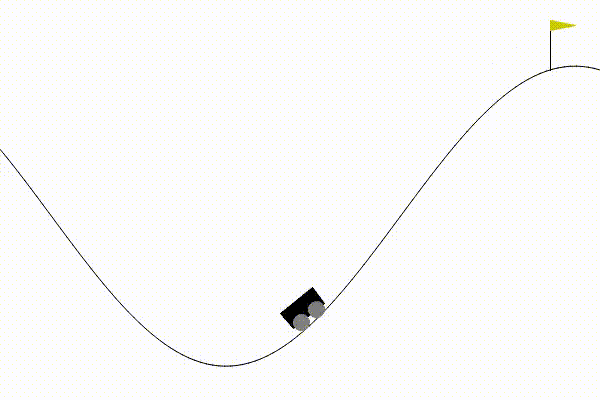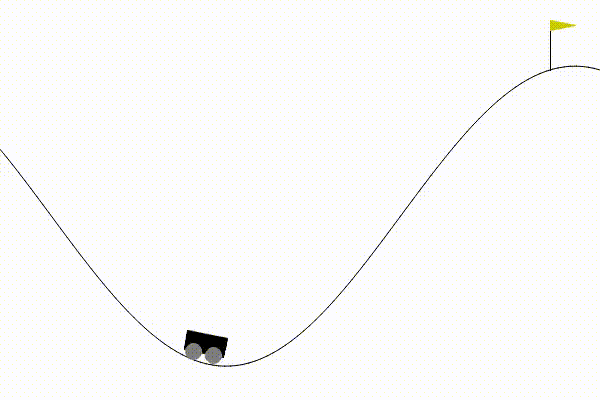
Darstellung des getunten MountainCarContinuous-v0-Algorithmus. Bild der Autorin / des Autors.
Für den Einstieg brauchst du:
Nachdem du eine neue virtuelle Umgebung erstellt hast, installierst du die Pakete. Hinweis: Optuna unterstützt Python 3.7 oder neuer. Wenn du die Einrichtung einer virtuellen Umgebung auffrischen möchtest, lies unser Tutorial Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribWir verwenden das Paket gym, um die Umgebung zu erstellen, in der der Agent agiert.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)In diesem Projekt nutzen wir MountainCarContinuous-v0 mit Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) — einer der Actor-Critic-Ansätze — kombiniert wertbasierte Methoden (bewerten die Belohnung einer Aktion) mit politikbasierten Methoden (steuern die Aktionen des Agenten), um das Training durch geringere Varianz zu stabilisieren.
Legen wir die Konfigurationen für diese Aufgabe fest.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Wir schlagen Wertebereiche für die Hyperparameter vor.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Wir definieren eine Callback-Funktion TrialEvalCallback(), weil wir regelmäßige Auswertungen der Optimierungsaufgaben zurückgeben wollen. Sieh dir für die Implementierung das Google-Colab-Notebook an.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardUnter Pruning versteht man das Beschneiden von Parametern oder Regionen im Suchraum, die voraussichtlich keine guten Ergebnisse liefern — hier also das Abbrechen nach einem bestimmten Budget. In Optuna werden Versuche verworfen, die in frühen Trainingsphasen schlechter abschneiden. So schrumpft der Parameterraum und die Zeit bis zum optimalen Ergebnis. Optuna bietet mehrere Pruner, darunter den Median Pruner, der eine Median-Stoppregel verwendet. Mehr dazu findest du in der Optuna-Dokumentation.
Der Median Pruner bricht ab, wenn das aktuelle beste Ergebnis schlechter als der Median der bisherigen Ergebnisse ist. Die Teilung durch drei sorgt dafür, dass erst nach einem Drittel des Maximalbudgets geprunt wird.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Wähle den Sampler, z. B. Random, TPESampler, CMAES usw.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Jetzt können wir eine Optuna-Study erstellen.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Schauen wir uns einige der fortgeschrittenen Funktionen von Optuna an.
Optuna stellt ein Dashboard bereit, mit dem du frühere und laufende Runs visualisieren, nachverfolgen und analysieren kannst. Früher musstest du dafür oft ein Tracking-Tool wie MLflow anbinden.
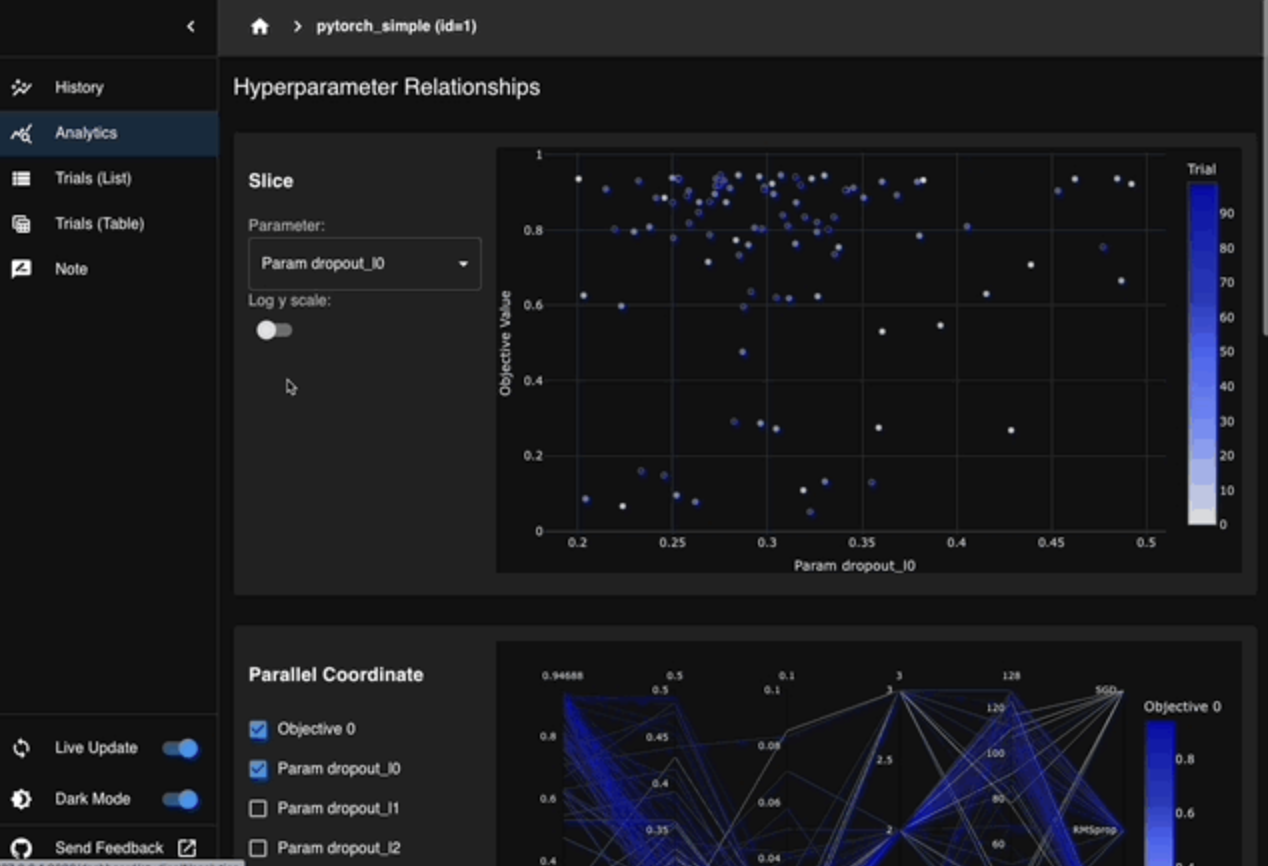
Optuna Dashboard. Quelle: Optuna
Dank Unterstützung für verteiltes Training kannst du Optuna mit Backends wie Kubernetes oder Dask verbinden und so mehr Rechenressourcen für großangelegte Experimente nutzen. Außerdem lässt sich ein Storage-Backend anbinden, um die Ergebnisse deiner Sessions zu speichern und zu verwalten — etwa Cloud-Storage, Dask-Storage oder SQLite für lokale Runs.
Hier sind ein paar Tipps, um typische Fallstricke beim Tuning zu vermeiden:
Lerne Machine Learning mit DataCamp
Kurs
Kurs
Kurs