Curso
Comprender el machine learning
2 h
308.6K
Los modelos de machine learning tienen hiperparámetros que influyen de forma decisiva en su rendimiento. Puedes pensar en ellos como la temperatura adecuada para hornear un bizcocho o el ángulo justo para dar la vuelta a una tortita. En aprendizaje por refuerzo, los hiperparámetros afectan a las aproximaciones de la política y la recompensa; con un buen ajuste, la optimización de hiperparámetros puede mejorar drásticamente los resultados.
En este artículo exploraremos Optuna, un potente framework de código abierto para optimizar hiperparámetros. Si es un tema nuevo para ti, te recomendamos empezar por Understanding Machine Learning, una introducción sin código. Para practicar con Python, prueba nuestro curso Machine Learning Fundamentals with Python, basado en scikit-learn. Después, MLOps Concepts te ayudará a entender cómo pasar de notebooks locales a entornos de producción. Por último, echa un vistazo a Preprocessing for Machine Learning in Python, muy relevante para este artículo porque te enseña a limpiar y preparar tus datos para modelos de machine learning.
Optuna es una herramienta de código abierto para la optimización de hiperparámetros que automatiza la búsqueda. Puede usarse con cualquier framework de machine learning o deep learning. Algunas de sus capacidades clave son:
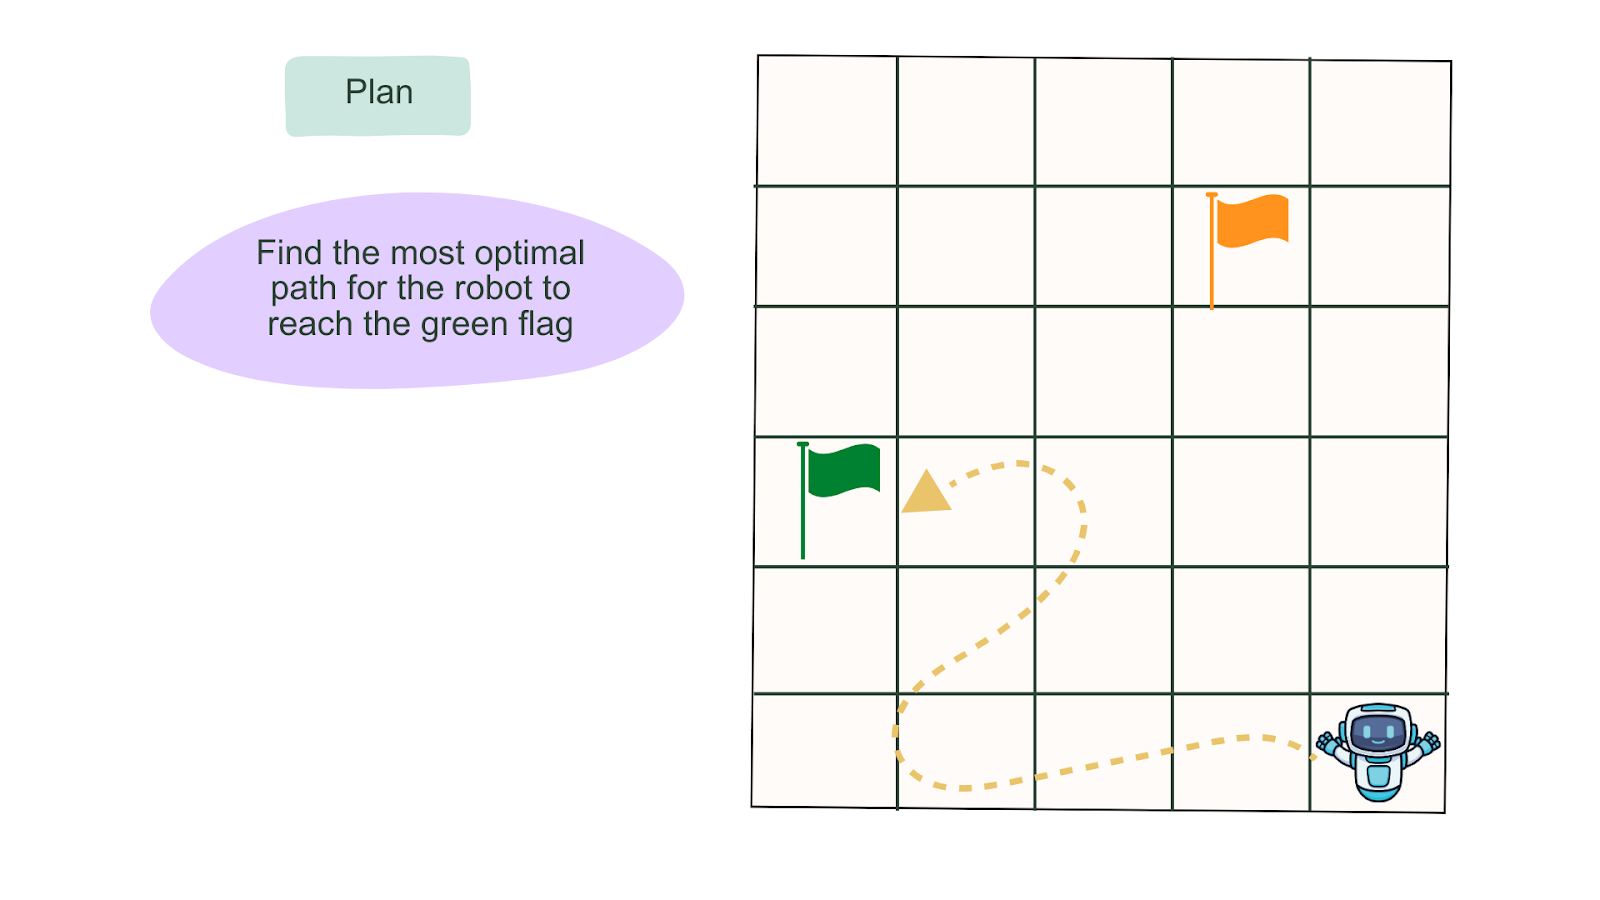
Encontrar la ruta óptima. Fuente: imagen del autor
El aprendizaje por refuerzo (RL) combina machine learning y control óptimo. Estudia cómo debe actuar un agente inteligente en un entorno dinámico para maximizar su recompensa acumulada. En pocas palabras, el RL consiste en enseñar a un agente a tomar decisiones óptimas que maximicen sus recompensas en un entorno. La recompensa en cada paso puede ser positiva o negativa según se acerque al objetivo.
A diferencia del machine learning supervisado, los algoritmos de RL toman decisiones para lograr el mejor resultado posible, de forma similar al aprendizaje por prueba y error que usamos para cumplir metas. El aprendizaje por refuerzo profundo se diferencia del RL clásico porque emplea redes neuronales profundas para aproximar funciones complejas. También podríamos decir que el RL más tradicional se centra en enfoques más deterministas, mientras que el profundo utiliza enfoques estocásticos.
En un entorno pueden existir muchas rutas hasta el destino. En comparación con el aprendizaje supervisado, el aprendizaje por refuerzo profundo es mucho más sensible a la elección de hiperparámetros como la tasa de aprendizaje, gamma, número de pasos, etc.
Una mala elección de hiperparámetros puede llevar a convergencias pobres o inestables. Este reto se agrava por la variabilidad del rendimiento según la semilla aleatoria (que inicializa los pesos de la red y el entorno).
En esta sección, veremos cómo configurar Optuna y sus dependencias, definir el espacio de búsqueda y ejecutar la optimización para el algoritmo MountainCarContinuous-v0. MountainCarContinuous-v0 es uno de los algoritmos de RL en RL-Zoo, un framework de entrenamiento que proporciona scripts para evaluar agentes y trazar resultados. MountainCarContinous-v0 modela un entorno en el que el agente (un coche) intenta alcanzar su objetivo (llegar a la bandera).
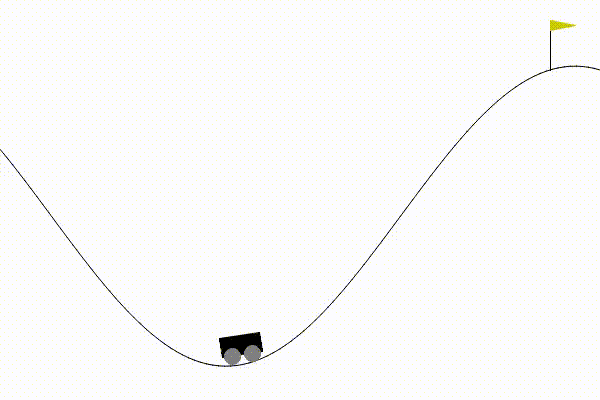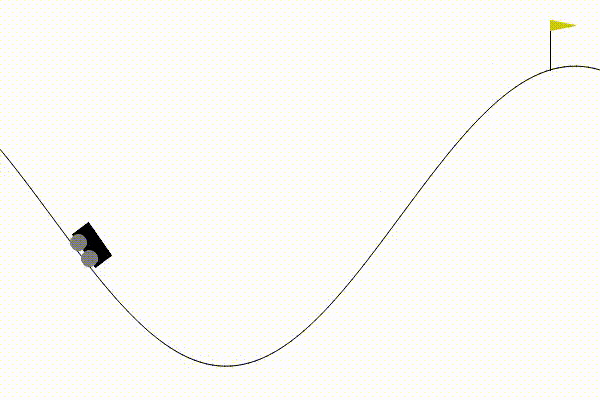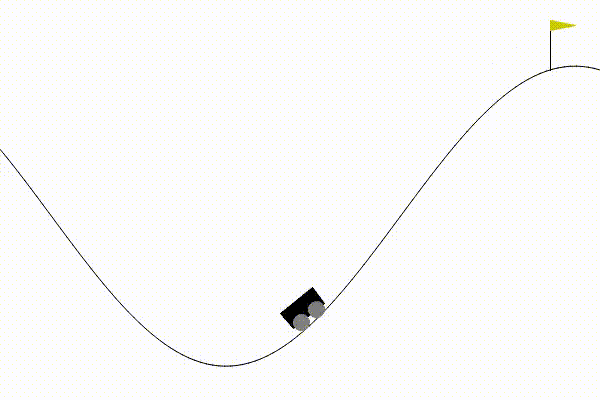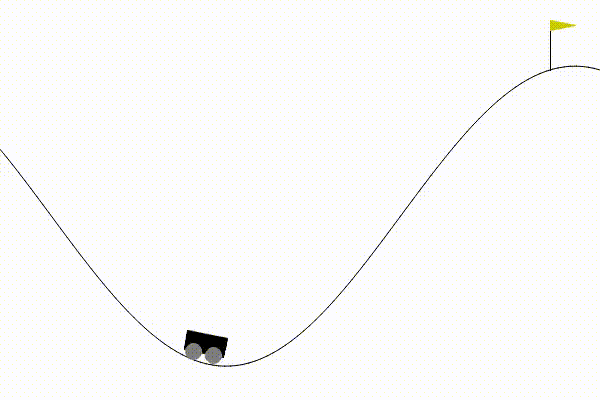
Representación del algoritmo MountainCarContinuous-v0 ajustado. Imagen del autor.
Para empezar, necesitas:
Tras crear un nuevo entorno virtual, instalamos los paquetes. Ten en cuenta que Optuna es compatible con Python 3.7 o superior. Si quieres repasar cómo crear un entorno virtual, lee nuestro tutorial Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribUsaremos el paquete gym para crear el entorno donde el agente realizará acciones.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Este proyecto usará el algoritmo MountainCarContinuous-v0 con Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C) , uno de los algoritmos Actor-Critic, es una arquitectura híbrida que combina métodos basados en valor (miden la recompensa de una acción) y basados en política (controlan las acciones del agente) para estabilizar el entrenamiento reduciendo la varianza.
Vamos a fijar las configuraciones que usaremos en esta tarea.
N_TRIALS = 100 # Maximum number of trialsN_JOBS = 1 # Number of jobs to run in parallelN_STARTUP_TRIALS = 5 # Stop random sampling after N_STARTUP_TRIALSN_EVALUATIONS = 2 # Number of evaluations during the trainingN_TIMESTEPS = 100000 # Training budgetEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Propondremos un rango de valores para los hiperparámetros.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Sample A2C hyperparameters for Optuna trial.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Se definió una función CallBack TrialEvalCallback() porque queremos devolver resultados de evaluación periódicos de las tareas de optimización. Consulta el notebook de Google Colab para la implementación del callback.
def objective(trial: optuna.Trial) -> float: """ This will be used by Optuna to evaluate one set of hyperparameters at a time.Given a trial object, it will sample hyperparameters, evaluate it and report the result. :param trial: Optuna trial object :return: Mean episodic reward after training """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Sample hyperparameters and update the keyword arguments kwargs.update(a2c_hyper_params(trial)) # 2. Create the RL model model = A2C(**kwargs) # 3. Create envs used for evaluation using make_vec_env, ENV_ID and N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Create the TrialEvalCallback callback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Train the model model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Sometimes, random hyperparams can generate NaN print(e) nan_encountered = True finally: # Free memory model.env.close() eval_envs.close() # Tell the optimizer that the trial failed if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardLa poda consiste en recortar parámetros o regiones del espacio de búsqueda con pocas probabilidades de ofrecer un resultado óptimo, en este caso tras un presupuesto específico. En Optuna, la poda elimina los ensayos que rinden peor en las primeras etapas del entrenamiento. Esto reduce el conjunto de parámetros y el tiempo para alcanzar el espacio de búsqueda óptimo. Optuna incluye varios podadores, entre ellos Median Pruner, que utiliza la regla de parada por mediana. Puedes leer más sobre los pruners de Optuna en la documentación de Optuna.
El algoritmo Median Pruner poda si el mejor resultado actual es peor que la mediana de los resultados previos. La división entre tres se usa porque solo queremos podar después de que se consuma 1/3 del presupuesto máximo.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Selecciona el sampler, que puede ser aleatorio, TPESampler, CMAES, etc.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Ya estamos listos para crear un estudio de Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Veamos algunas de las funciones más avanzadas de Optuna.
Optuna ofrece un panel que permite visualizar, hacer seguimiento y analizar ejecuciones actuales y pasadas. Antes quizá tenías que conectar tu herramienta de tracking, como MLFlow, para gestionar los resultados.
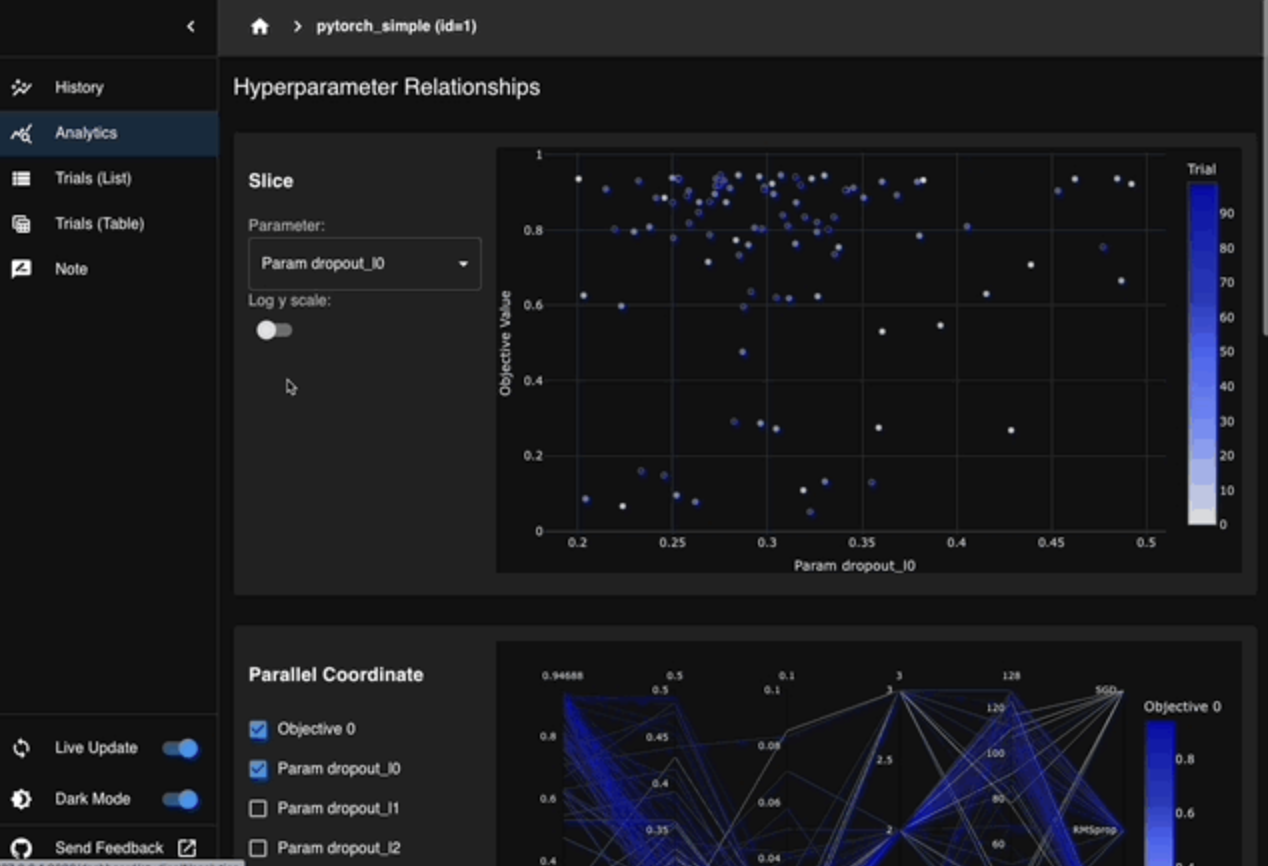
Optuna Dashboard. Fuente: Optuna
El soporte de Optuna para entrenamiento distribuido te permite conectar tu backend distribuido, como Kubernetes o Dask, y aprovechar más recursos de cómputo para experimentos a gran escala. También puedes conectar un backend de almacenamiento para guardar y gestionar los resultados de tus sesiones. Puedes usar almacenamiento en la nube como Dask storage o SQLite para ejecuciones locales.
Algunos consejos para evitar errores habituales al ajustar hiperparámetros:
Aprende machine learning con DataCamp
Curso
Curso
Curso
Tutorial
Tutorial
Abid Ali Awan
11 min
Tutorial
Kurtis Pykes
11 min
Tutorial
Zoumana Keita
12 min
Tutorial
DataCamp Team
10 min
Tutorial
Avinash Navlani
12 min