Cours
Comprendre le Machine Learning
2 h
308.2K
Les modèles d’apprentissage automatique ont des hyperparamètres qui influencent fortement leurs performances. On peut les comparer à la bonne température pour cuire un gâteau ou au bon angle pour retourner une crêpe. En apprentissage par renforcement, les hyperparamètres affectent les approximations de la politique et de la récompense ; bien réglés, ils peuvent améliorer considérablement les résultats.
Cet article vous présente Optuna, un puissant framework open source dédié à l’optimisation d’hyperparamètres. Si vous débutez, commencez par Understanding Machine Learning, une introduction sans code. Pour pratiquer en Python, suivez notre formation Machine Learning Fundamentals with Python, basée sur scikit-learn. Ensuite, MLOps Concepts vous aidera à passer de notebooks locaux à des environnements de production. Enfin, suivez Preprocessing for Machine Learning in Python, un cours particulièrement pertinent ici, qui vous apprend à nettoyer et préparer vos données pour vos modèles.
Optuna est un framework open source d’optimisation d’hyperparamètres qui automatise la recherche. Il s’emploie avec tout framework de machine learning ou de deep learning. Parmi ses principales capacités :
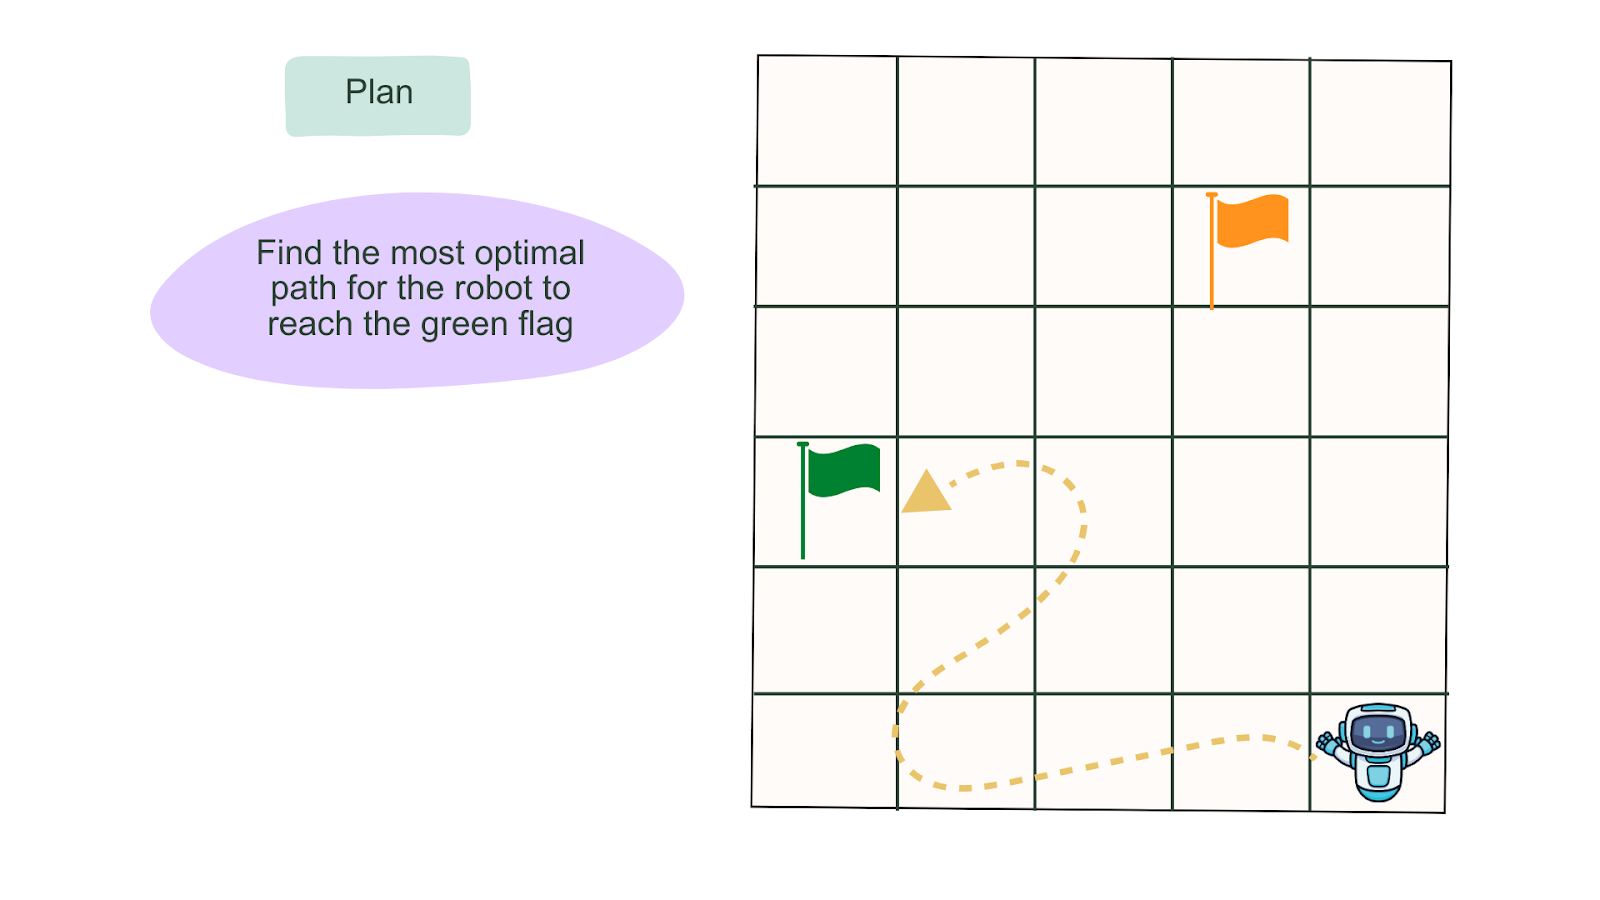
Trouver la trajectoire optimale. Source : image de l’auteur
L’apprentissage par renforcement (RL) combine apprentissage automatique et commande optimale. Il étudie comment un agent intelligent doit agir dans un environnement dynamique pour maximiser sa récompense cumulée. En bref, il s’agit d’apprendre à un agent à prendre des décisions optimales qui maximisent ses récompenses dans un environnement. À chaque étape, la récompense peut être positive ou négative selon la proximité de l’objectif visé.
Contrairement au machine learning supervisé, les algorithmes de RL prennent des décisions pour atteindre un résultat optimal, selon une logique d’essais-erreurs proche de notre façon d’apprendre. Le RL profond s’en distingue car il utilise des réseaux de neurones profonds pour approximer des fonctions complexes. On peut aussi dire que le RL « classique » privilégie des approches plus déterministes, tandis que le RL profond recourt à des approches stochastiques.
Dans un environnement, il existe souvent de multiples chemins pour atteindre la cible. Par rapport à l’apprentissage supervisé, le RL profond est bien plus sensible au choix des hyperparamètres (taux d’apprentissage, gamma, nombre d’étapes, etc.).
De mauvais réglages peuvent conduire à une convergence médiocre ou instable. La variabilité des performances selon les graines aléatoires (utilisées pour initialiser les poids du réseau et l’environnement) complique encore la donne.
Dans cette section, nous allons installer Optuna et ses dépendances, définir l’espace de recherche, puis lancer l’optimisation pour l’algorithme MountainCarContinuous-v0. MountainCarContinuous-v0 fait partie de RL-Zoo, un framework d’entraînement qui fournit des scripts pour évaluer les agents et tracer les résultats. MountainCarContinuous-v0 modélise un environnement où l’agent (une voiture) tente d’atteindre son but (atteindre le drapeau).
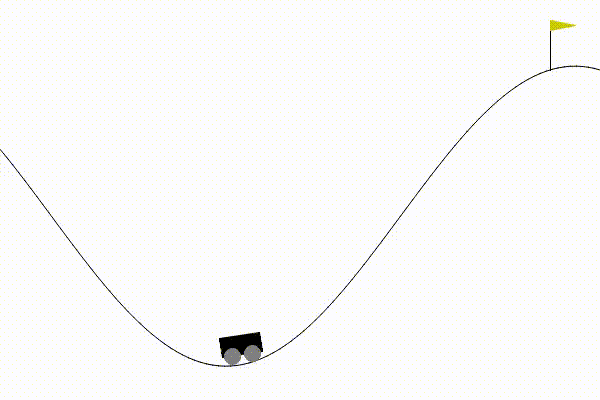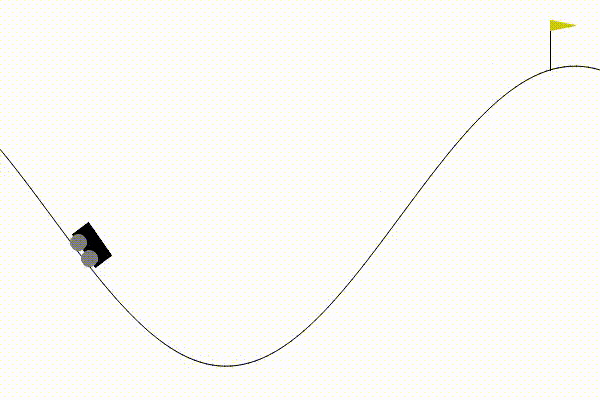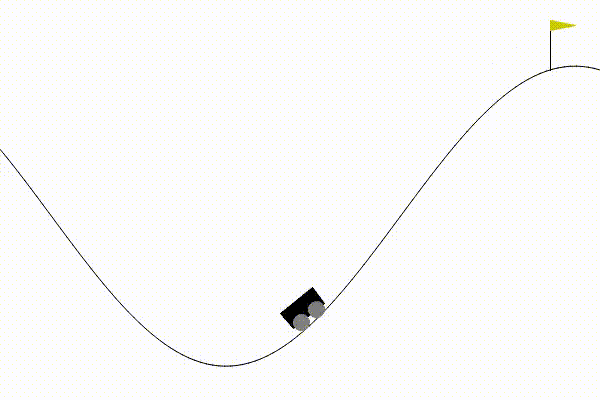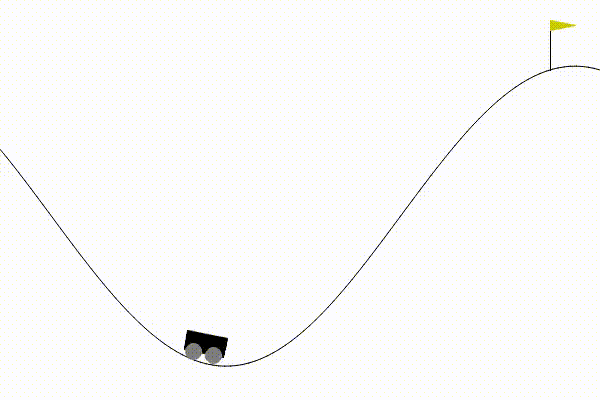
Représentation de l’algorithme MountainCarContinuous-v0 après réglage. Image de l’auteur.
Pour commencer, vous devez :
Après avoir créé un nouvel environnement virtuel, installez les packages. À noter : Optuna prend en charge Python 3.7 et versions ultérieures. Pour revoir la création d’un environnement virtuel, consultez notre tutoriel Virtual Environment in Python.
pip install optunapip install stable-baselines3pip install sb3-contribNous utiliserons le package gym pour créer l’environnement dans lequel l’agent exécutera des actions.
from stable_baselines3.common.env_util import make_vec_envfrom stable_baselines3 import A2Cimport gymimport optunafrom optuna.pruners import MedianPrunerfrom optuna.samplers import TPESamplerfrom optuna.visualization import plot_optimization_history, plot_param_importancesfrom typing import Any, Dictimport torchimport torch.nn as nnprint(optuna.__version__)Ce projet utilisera MountainCarContinuous-v0 avec Advantage Actor-Critic (A2C). Advantage Actor-Critic (A2C), l’un des algorithmes Actor-Critic, combine des approches basées valeur (mesure la récompense d’une action) et basées politique (contrôle les actions de l’agent) afin de stabiliser l’entraînement en réduisant la variance.
Paramétrons les configurations utilisées pour cette tâche.
N_TRIALS = 100 # Nombre maximal d'essaisN_JOBS = 1 # Nombre de jobs exécutés en parallèleN_STARTUP_TRIALS = 5 # Fin de l'échantillonnage aléatoire après N_STARTUP_TRIALSN_EVALUATIONS = 2 # Nombre d'évaluations pendant l'entraînementN_TIMESTEPS = 100000 # Budget d'entraînementEVAL_FREQ = int(N_TIMESTEPS / N_EVALUATIONS)N_EVAL_ENVS = 5N_EVAL_EPISODES = 10TIMEOUT = int(60 * 15) # 15 minutesENV_ID = "MountainCarContinuous-v0"DEFAULT_HYPERPARAMS = { "policy": "MlpPolicy", "env": ENV_ID,}Nous allons proposer un intervalle de valeurs pour les hyperparamètres.
def a2c_hyper_params(trial: optuna.Trial) -> dict: """Échantillonner les hyperparamètres A2C pour un essai Optuna.""" return { "learning_rate": trial.suggest_float("learning_rate", 1e-5, 1e-2), "gamma": trial.suggest_float("gamma", 0.9, 0.9999), "n_steps": trial.suggest_int("n_steps", 5, 2048), "ent_coef": trial.suggest_float("ent_coef", 1e-8, 1e-2), "vf_coef": trial.suggest_float("vf_coef", 0.1, 1.0), "max_grad_norm": trial.suggest_float("max_grad_norm", 0.3, 10) }Nous définissons une fonction CallBack TrialEvalCallback() afin de renvoyer des évaluations périodiques des tâches d’optimisation. Consultez le notebook Google Colab pour l’implémentation du callback.
def objective(trial: optuna.Trial) -> float: """ Utilisée par Optuna pour évaluer un jeu d'hyperparamètres à la fois.À partir d'un objet trial, on échantillonne les hyperparamètres, on les évalue et on reporte le résultat. :param trial: objet d'essai Optuna :return: Récompense épisodique moyenne après entraînement """ kwargs = DEFAULT_HYPERPARAMS.copy() # 1. Échantillonner les hyperparamètres et mettre à jour les arguments nommés kwargs.update(a2c_hyper_params(trial)) # 2. Créer le modèle de RL model = A2C(**kwargs) # 3. Créer les envs d'évaluation avec make_vec_env, ENV_ID et N_EVAL_ENVS eval_envs = make_vec_env(ENV_ID, n_envs=N_EVAL_ENVS) # 4. Créer le callback TrialEvalCallback eval_callback = TrialEvalCallback( eval_envs, trial, n_eval_episodes=N_EVAL_EPISODES, eval_freq=EVAL_FREQ, deterministic=True, verbose=0, ) nan_encountered = False try: # Entraîner le modèle model.learn(N_TIMESTEPS, callback=eval_callback) except AssertionError as e: # Parfois, des hyperparamètres aléatoires peuvent générer des NaN print(e) nan_encountered = True finally: # Libérer la mémoire model.env.close() eval_envs.close() # Indiquer à l'optimiseur que l'essai a échoué if nan_encountered: return float("nan") if eval_callback.is_pruned: raise optuna.exceptions.TrialPruned() return eval_callback.last_mean_rewardL’élagage consiste à écarter des paramètres ou des régions de l’espace de recherche peu susceptibles d’aboutir à un résultat optimal, ici après un certain budget. Dans Optuna, l’élagage supprime les essais peu performants dès les premières étapes de l’entraînement. Cela réduit l’ensemble de paramètres à tester et le temps nécessaire pour atteindre la zone optimale. Optuna propose plusieurs pruners, dont le Median Pruner, basé sur une règle d’arrêt médiane. Pour en savoir plus, consultez la documentation Optuna.
L’algorithme Median Pruner élague si le meilleur résultat courant est inférieur à la médiane des résultats précédents. La division par trois est utilisée car nous ne voulons élaguer qu’après 1/3 du budget maximal.
pruner = MedianPruner(n_startup_trials=N_STARTUP_TRIALS, n_warmup_steps=N_EVALUATIONS // 3)Choisissez l’échantillonneur : aléatoire, TPESampler, CMAES, etc.
sampler = TPESampler(n_startup_trials=N_STARTUP_TRIALS)Nous pouvons maintenant créer une étude Optuna.
study = optuna.create_study(sampler=sampler, pruner=pruner, direction="maximize")try:study.optimize(objective, n_trials=N_TRIALS, n_jobs=N_JOBS, timeout=TIMEOUT)except KeyboardInterrupt: passprint("Number of finished trials: ", len(study.trials))print("Best trial:")trial = study.best_trialprint(f" Value: {trial.value}")print(" Params: ")for key, value in trial.params.items(): print(f" {key}: {value}")print(" User attrs:")for key, value in trial.user_attrs.items(): print(f" {key}: {value}")Voyons quelques fonctionnalités plus avancées d’Optuna.
Optuna propose un tableau de bord pour visualiser, suivre et analyser les exécutions passées et en cours. Auparavant, il fallait souvent connecter un outil de suivi comme MLflow pour gérer les résultats.
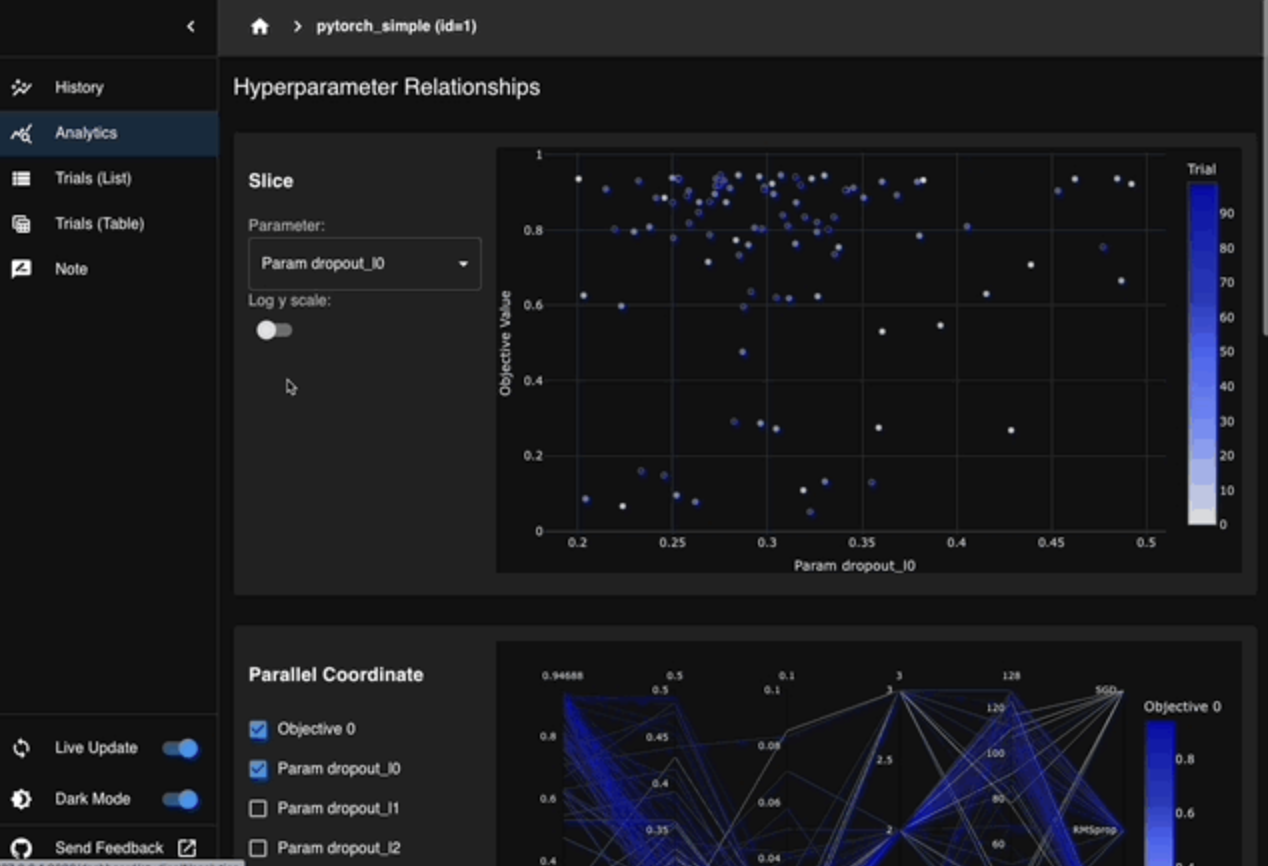
Optuna Dashboard. Source : Optuna
Grâce au support de l’entraînement distribué, Optuna se connecte à des backends comme Kubernetes ou Dask afin de tirer parti de davantage de ressources de calcul pour des expériences à grande échelle. Vous pouvez également connecter un backend de stockage pour conserver et gérer les résultats de vos sessions : stockage cloud compatible Dask, ou SQLite pour des exécutions locales.
Voici quelques conseils pour éviter les pièges courants lors du réglage d’hyperparamètres :
Apprenez le machine learning avec DataCamp
Cours
Cours
Cours