

Installer pandas
Installez pandas avec la commande pip install dans votre terminal. pandas 3 requiert Python 3.11 ou plus récent ; sur une version plus ancienne de Python, pip installera la dernière version 2.x compatible.
pip install pandasVous pouvez aussi l’installer via conda :
conda install pandasAprès l’installation, il est recommandé de vérifier la version installée pour s’assurer que tout fonctionne correctement :
import pandas as pd
print(pd.__version__) # Affiche la version de pandasCela confirme que pandas est correctement installé et vous permet de vérifier la compatibilité avec d’autres packages.
Qu’est-ce qui a changé dans pandas 3.0 et 3.1
pandas 3.0, publié en janvier 2026, a modifié le comportement des copies, des chaînes de caractères et des affectations, et pandas 3.1 (octobre 2026) a déprécié la plupart des usages de inplace=True. Le code des anciens tutoriels fonctionne encore en grande partie, mais quatre changements piègent souvent :
- Copy-on-Write par défaut. Tout sous‑ensemble ou résultat de méthode se comporte comme une copie, donc le modifier ne change jamais le DataFrame d’origine. Le
SettingWithCopyWarninga disparu, tout comme le besoin d’appels défensifs à.copy(). - L’affectation chaînée ne fonctionne plus.
df["Age"][0] = 35met à jour une copie temporaire et laissedfinchangé, et pandas émet unChainedAssignmentError. Utilisez un unique appel.loc[]à la place. - Les chaînes ont leur propre type. Les colonnes texte sont désormais inférées en
strplutôt qu’enobject, avec un support PyArrow si installé. inplace=Trueest déprécié poursort_values(),reset_index(),dropna(),drop_duplicates(),rename()et plusieurs autres méthodes. Réaffectez plutôt le résultat :df = df.dropna().
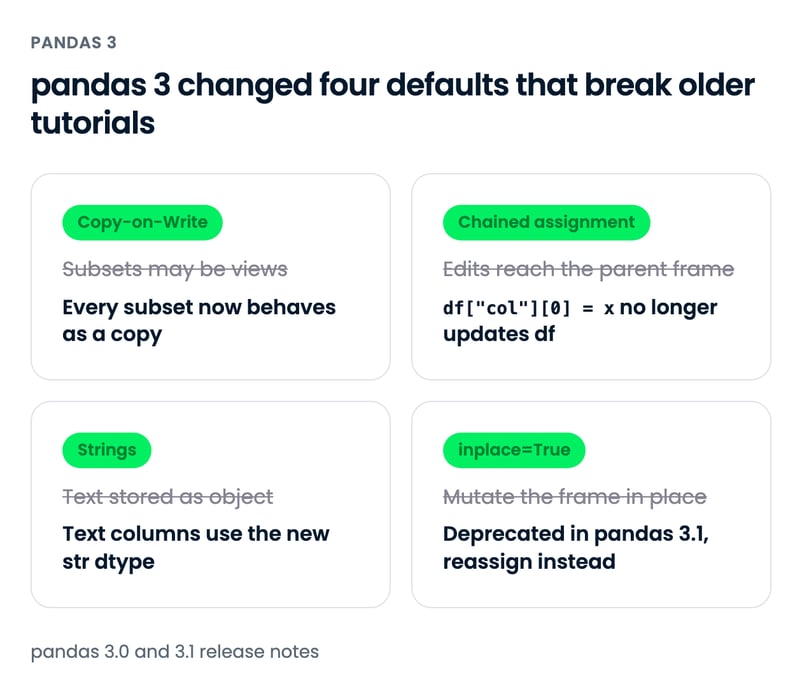
Voici le changement sur l’affectation chaînée avec un petit DataFrame :
import pandas as pd
patients = pd.DataFrame({"name": ["Ana", "Ben", "Chloe"], "age": [34, 51, 28]})
patients["age"][0] = 35 # affectation chaînée : patients n'est pas modifié
patients.loc[0, "age"] = 35 # un seul appel .loc[] : patients est mis à jour
print(patients.dtypes)name str
age int64
dtype: objectTous les exemples de ce tutoriel suivent les règles de pandas 3. Pour la liste complète des changements, consultez les notes de version officielles de pandas 3.0 et pandas 3.1. Si vous maintenez du code plus ancien, notre guide sur le SettingWithCopyWarning explique le comportement remplacé par Copy-on-Write.
Importer des données avec pandas
Pour commencer à travailler avec pandas, importez la bibliothèque Python comme ci‑dessous. L’alias le plus courant est pd.
import pandas as pdImporter des fichiers CSV
Utilisez read_csv() avec le chemin du fichier CSV pour lire un fichier de valeurs séparées par des virgules (voir notre tutoriel sur l’import avec read_csv() pour plus de détails).
df = pd.read_csv("diabetes.csv")Cette lecture charge le fichier CSV diabetes.csv dans un DataFrame pandas nommé df. Tout au long du tutoriel, nous utilisons le jeu de données Pima Indians Diabetes : 768 patients, huit mesures de santé comme Glucose, BMI et Age, et une colonne Outcome où 1 signifie que le patient a été diagnostiqué diabétique.
Importer des fichiers texte
La lecture de fichiers texte est similaire aux CSV. La nuance est que vous devez préciser un séparateur via l’argument sep, comme ci‑dessous. Le séparateur est le caractère qui sépare les valeurs (colonnes) de chaque ligne. Virgule (sep=","), tabulation (sep="\t"), deux‑points (sep=":") et espace (sep=r"\s+") sont les plus courants. r"\s+" est une expression régulière qui correspond à un ou plusieurs espaces ; le préfixe r indique une chaîne brute, pour que Python ne traite pas \s comme une séquence d’échappement invalide.
df = pd.read_csv("diabetes.txt", sep=r"\s+")Importer des fichiers Excel (une seule feuille)
Lisez des fichiers Excel avec la fonction read_excel(), en passant le chemin du fichier. pandas a besoin d’un moteur supplémentaire pour Excel : installez openpyxl pour les fichiers .xlsx, ou xlrd pour les anciens .xls.
df = pd.read_excel('diabetes.xlsx')Vous pouvez également préciser d’autres arguments, comme header pour définir la ligne d’en‑tête du DataFrame. Par défaut, 0 signifie que la première ligne contient les noms de colonnes. Vous pouvez aussi fournir une liste de noms via names. L’argument index_col (par défaut None) peut être utilisé si le fichier contient un index de lignes.
Remarque : Dans un DataFrame ou une Series pandas, l’index est un identifiant qui repère l’emplacement d’une ligne ou d’une colonne. En bref, l’index étiquette les lignes/colonnes et permet d’accéder à un élément via son index (vous le verrez plus loin). L’index des lignes d’un DataFrame peut être une plage (p. ex. 0 à 303), une série temporelle (dates ou timestamps), un identifiant unique (p. ex. employee_ID dans une table employees) ou d’autres types. Pour les colonnes, c’est généralement une chaîne (le nom de colonne).
Importer des fichiers Excel (plusieurs feuilles)
Lire un fichier Excel à plusieurs feuilles n’est pas très différent. Il suffit d’ajouter l’argument sheet_name, dans lequel vous pouvez passer soit le nom de la feuille (chaîne), soit sa position (entier). Rappel : Python utilise un indexage à partir de 0, donc la première feuille est sheet_name = 0.
# Extraction de la deuxième feuille (index 0-based en Python)
df = pd.read_excel('diabetes_multi.xlsx', sheet_name=1)Importer un fichier JSON
Comme pour read_csv(), vous pouvez utiliser read_json() pour les fichiers JSON en passant le nom du fichier (pour plus de détails, lisez ce tutoriel sur l’import de données JSON et HTML dans pandas). Le code ci‑dessous lit un fichier JSON sur disque et crée un DataFrame df.
df = pd.read_json("diabetes.json")Pour en savoir plus sur l’import de données avec pandas, consultez cette antisèche sur l’import de divers formats en Python.
Importer des données depuis des bases SQL
Pour charger des données depuis une base relationnelle, utilisez pd.read_sql() avec une connexion à la base.
import sqlite3
# Établir une connexion à une base SQLite
conn = sqlite3.connect("my_database.db")
# Lire les données d'une table
df = pd.read_sql("SELECT * FROM my_table", conn)Pour d’autres bases (PostgreSQL, MySQL, etc.), passez un moteur SQLAlchemy en guise de connexion plutôt qu’un objet sqlite3. Pour les grandes tables, utilisez l’argument chunksize pour lire le résultat par lots.
Importer des données depuis une API (format JSON)
Si vos données proviennent d’une API web, pandas peut les lire directement avec pd.read_json() :
df = pd.read_json("https://api.example.com/data.json")Si la réponse de l’API est un JSON imbriqué, aplatissez‑la avec pd.json_normalize(), qui transforme les clés imbriquées en colonnes séparées par des points :
records = [
{"id": 1, "vitals": {"glucose": 148, "bmi": 33.6}},
{"id": 2, "vitals": {"glucose": 85, "bmi": 26.6}},
]
pd.json_normalize(records) id vitals.glucose vitals.bmi
0 1 148 33.6
1 2 85 26.6Exporter des données avec pandas
De même que pandas sait importer des données depuis divers formats, il permet aussi d’exporter vers plusieurs formats. C’est utile lorsque vous avez transformé des données avec pandas et que vous devez les enregistrer localement. Voici comment exporter des DataFrames pandas dans différents formats.
Exporter un DataFrame en CSV
Un DataFrame pandas (ici df) se sauvegarde en CSV avec la méthode .to_csv(). Passez le chemin de fichier et fixez index=False sauf si vous avez besoin de l’index (par défaut, index=True l’écrit comme une colonne supplémentaire sans nom). Notre tutoriel sur l’enregistrement d’un DataFrame en CSV couvre les autres arguments.
df.to_csv("diabetes_out.csv", index=False)Exporter un DataFrame en JSON
Exportez un DataFrame en JSON avec la méthode .to_json().
df.to_json("diabetes_out.json")Remarque : un fichier JSON stocke un objet tabulaire comme un ensemble clé‑valeur, vous verrez donc les noms de colonnes répétés dans le fichier JSON.
Exporter un DataFrame en texte
Comme pour l’écriture en CSV, utilisez .to_csv(). Les différences : le fichier de sortie est en .txt et vous devez préciser un séparateur via l’argument sep.
df.to_csv('diabetes_out.txt', header=df.columns, index=None, sep=' ')Exporter un DataFrame en Excel
Appelez .to_excel() sur le DataFrame pour l’enregistrer en .xlsx (nécessite openpyxl). pandas ne peut plus écrire d’anciens fichiers .xls.
df.to_excel("diabetes_out.xlsx", index=False)Afficher et comprendre les DataFrames avec pandas
Après avoir lu des données tabulaires dans un DataFrame, vous voudrez en avoir un aperçu. Vous pouvez afficher un échantillon de lignes ou un résumé statistique.
Comment afficher les données avec .head() et .tail()
Affichez les premières ou dernières lignes d’un DataFrame avec .head() ou .tail(). Vous pouvez passer le nombre de lignes via l’argument n (valeur par défaut : 5).
df.head()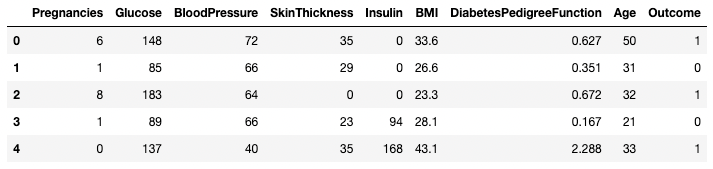
Premières cinq lignes du DataFrame
df.tail(n = 10)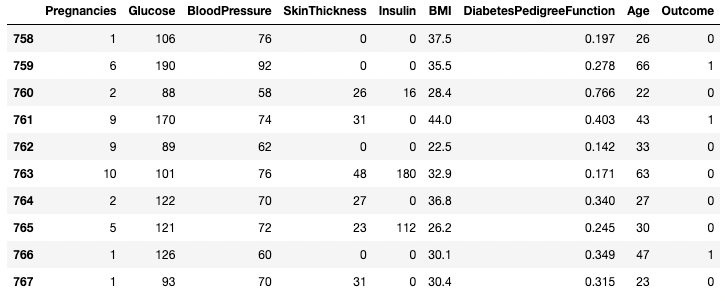
Dernières 10 lignes du DataFrame
Comprendre les données avec .describe()
La méthode .describe() affiche les statistiques descriptives des colonnes numériques : effectif, moyenne, écart‑type, étendue et quartiles.
df.describe()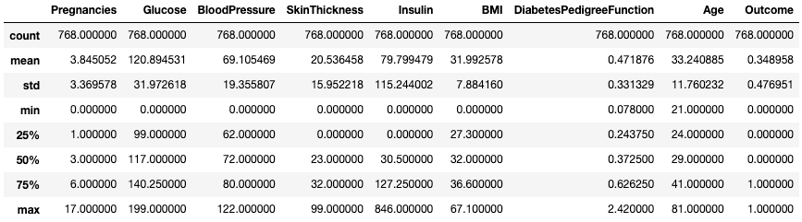
Obtenir des statistiques descriptives avec .describe()
Cela permet d’apprécier rapidement l’échelle, l’asymétrie et l’étendue des données numériques.
Vous pouvez aussi modifier les quantiles via l’argument percentiles. Ici, par exemple, nous regardons les percentiles 30 %, 50 % et 70 % des colonnes numériques de df.
df.describe(percentiles=[0.3, 0.5, 0.7])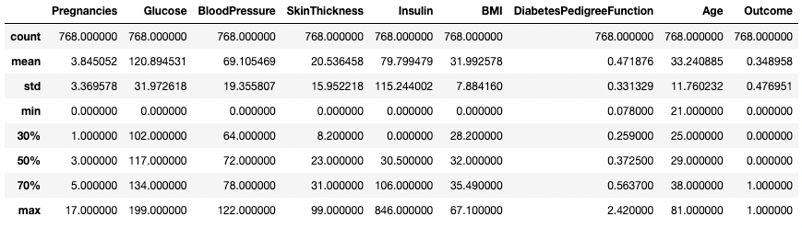
Obtenir des statistiques avec des percentiles spécifiques
Vous pouvez également limiter la sortie à certains types via l’argument include. Ici, par exemple, nous ne résumons que les colonnes de type integer.
df.describe(include=[int])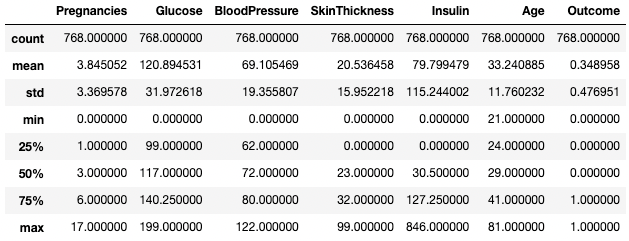
Statistiques descriptives des colonnes entières uniquement
De même, vous pouvez exclure certains types avec l’argument exclude.
df.describe(exclude=[int]) BMI DiabetesPedigreeFunction
count 768.000000 768.000000
mean 31.992578 0.471876
std 7.884160 0.331329
min 0.000000 0.078000
25% 27.300000 0.243750
50% 32.000000 0.372500
75% 36.600000 0.626250
max 67.100000 2.420000
Souvent, il est plus lisible de transposer ces statistiques avec l’attribut .T.
df.describe().T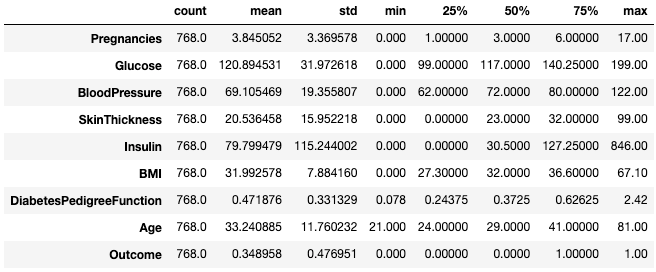
Transposer les statistiques descriptives avec .T
Pour en savoir plus sur la description des DataFrames, consultez cette antisèche.
Comprendre les données avec .info()
La méthode .info() offre un aperçu rapide des types de données, des valeurs manquantes et de la taille mémoire d’un DataFrame. Ici, nous définissons show_counts à True pour afficher le nombre de valeurs non manquantes par colonne. Nous fixons aussi memory_usage à True pour afficher l’utilisation totale de mémoire. Avec verbose=True, le résumé complet est imprimé.
df.info(show_counts=True, memory_usage=True, verbose=True)<class 'pandas.DataFrame'>
RangeIndex: 768 entries, 0 to 767
Data columns (total 9 columns):
# Column Non-Null Count Dtype
--- ------ -------------- -----
0 Pregnancies 768 non-null int64
1 Glucose 768 non-null int64
2 BloodPressure 768 non-null int64
3 SkinThickness 768 non-null int64
4 Insulin 768 non-null int64
5 BMI 768 non-null float64
6 DiabetesPedigreeFunction 768 non-null float64
7 Age 768 non-null int64
8 Outcome 768 non-null int64
dtypes: float64(2), int64(7)
memory usage: 54.1 KBComprendre vos données avec .shape
Le nombre de lignes et de colonnes d’un DataFrame est donné par l’attribut .shape. Il renvoie un tuple (lignes, colonnes) et peut être indexé pour n’obtenir que le nombre de lignes ou de colonnes.
df.shape # Nombre de lignes et de colonnes
df.shape[0] # Nombre de lignes uniquement
df.shape[1] # Nombre de colonnes uniquement(768,9)
768
9Obtenir toutes les colonnes et leurs noms
L’attribut .columns d’un DataFrame renvoie les noms de colonnes sous forme d’objet Index. Rappel : un index pandas est l’adresse/étiquette d’une ligne ou colonne.
df.columnsIndex(['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI',
'DiabetesPedigreeFunction', 'Age', 'Outcome'],
dtype='str')Vous pouvez le convertir en liste avec list().
list(df.columns)['Pregnancies',
'Glucose',
'BloodPressure',
'SkinThickness',
'Insulin',
'BMI',
'DiabetesPedigreeFunction',
'Age',
'Outcome']Vérifier les valeurs manquantes avec .isnull()
Le DataFrame d’exemple n’a pas de valeurs manquantes. Ajoutons‑en quelques‑unes. La méthode .copy() crée une copie du DataFrame source. Travailler sur une copie garde df intact pour les exemples suivants. À l’aide de .loc (vu plus loin), vous pouvez définir les lignes étiquetées 2 à 5 de la colonne Pregnancies comme manquantes. Comme les valeurs manquantes sont stockées en NaN, un float, pandas convertit la colonne de int64 en float64.
df2 = df.copy()
df2.loc[2:5,'Pregnancies'] = None
df2.head(7)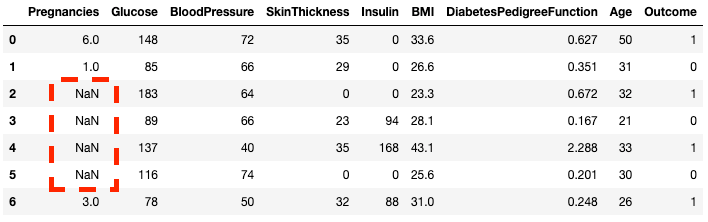
On voit que les lignes 2 à 5 sont NaN
Vous pouvez vérifier si chaque élément d’un DataFrame est manquant avec .isnull().
df2.isnull().head(7)Comme il est souvent plus utile de connaître la quantité de données manquantes, combinez .isnull() avec .sum() pour compter le nombre de valeurs nulles par colonne.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Vous pouvez aussi faire une double somme pour obtenir le total de valeurs nulles du DataFrame.
df2.isnull().sum().sum()4Trier, découper et extraire des données avec pandas
pandas propose plusieurs moyens de trier, sous‑sélectionner, filtrer et isoler des données dans vos DataFrames. Voici les approches les plus courantes.
Trier les données
Pour trier un DataFrame par une colonne, utilisez .sort_values(). Elle renvoie un nouveau DataFrame trié et laisse df inchangé ; affectez le résultat à une variable si vous voulez le conserver :
df.sort_values(by="Age", ascending=False) # Trier par Age décroissantVous pouvez trier par plusieurs colonnes :
df.sort_values(by=["Age", "Glucose"], ascending=[False, True])Réinitialiser l’index
Le tri ou le filtrage garde les étiquettes de lignes d’origine, l’index peut donc être hors ordre. Utilisez .reset_index() pour repartir sur un index 0‑based propre (voir notre tutoriel sur reset_index pour plus d’options) :
df_sorted = df.sort_values(by="Age", ascending=False).reset_index(drop=True) # drop=True supprime l'ancien index
df_sorted[["Age", "Glucose", "Outcome"]].head(3) Age Glucose Outcome
0 81 134 0
1 72 119 0
2 70 145 1Isoler une colonne avec [ ]
Vous pouvez isoler une seule colonne en utilisant des crochets [ ] avec le nom de la colonne. La sortie est une Series pandas, c’est‑à‑dire un tableau unidimensionnel typé. Un DataFrame est composé de plusieurs Series agencées en colonnes.
df['Outcome']0 1
1 0
2 1
3 0
4 1
..
763 0
764 0
765 0
766 1
767 0
Name: Outcome, Length: 768, dtype: int64Isoler deux colonnes ou plus avec [[ ]]
Vous pouvez aussi fournir une liste de noms de colonnes à l’intérieur des crochets pour en récupérer plusieurs. Ici, les crochets sont utilisés de deux manières : les crochets externes pour indiquer un sous‑ensemble du DataFrame, et les crochets internes pour créer une liste.
df[['Pregnancies', 'Outcome']] Pregnancies Outcome
0 6 1
1 1 0
2 8 1
3 1 0
4 0 1
.. ... ...
763 10 0
764 2 0
765 5 0
766 1 1
767 1 0
[768 rows x 2 columns]Isoler une ligne avec [ ]
Une unique ligne peut être récupérée en passant une série booléenne contenant une seule valeur True. Dans l’exemple ci‑dessous, la seconde ligne avec index = 1 est renvoyée. Ici, .index renvoie les étiquettes de lignes, et la comparaison produit un tableau booléen unidimensionnel.
df[df.index==1]
Isoler une ligne dans pandas
Isoler deux lignes ou plus avec [ ]
De même, deux lignes ou plus peuvent être renvoyées avec la méthode .isin() plutôt qu’un opérateur ==.
df[df.index.isin(range(2,10))]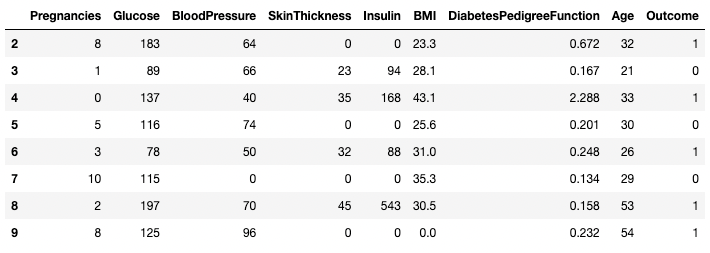
Isoler des lignes spécifiques dans pandas
Utiliser .loc[] et .iloc[] pour récupérer des lignes
Vous pouvez récupérer des lignes par étiquettes ou positions avec .loc[] et .iloc[] ("location" et "integer location"). .loc[] utilise des étiquettes pour repérer lignes/colonnes/cellules, tandis que .iloc[] utilise la position numérique. Notre guide loc vs iloc détaille toutes les différences ; pour illustrer la principale, modifions l’index de df2 créé plus tôt pour que les étiquettes ne correspondent plus aux positions.
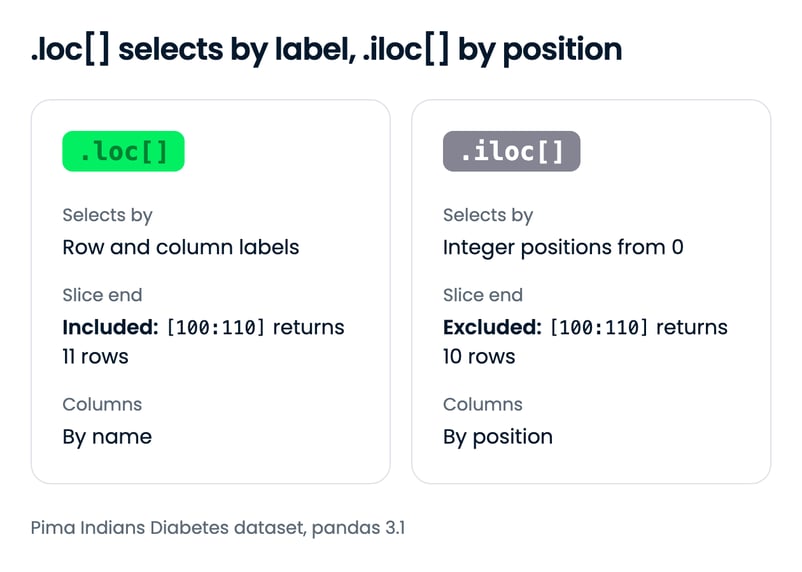
df2.index = range(1,769)Dans l’exemple ci‑dessous, le résultat est une Series plutôt qu’un DataFrame. Avec .loc[1], 1 est une étiquette, donc la ligne libellée 1 (la première après le réindexage) est renvoyée. Avec .iloc[1], 1 est une position 0‑based, donc la deuxième ligne (étiquette 2) est renvoyée.
df2.loc[1]Pregnancies 6.000
Glucose 148.000
BloodPressure 72.000
SkinThickness 35.000
Insulin 0.000
BMI 33.600
DiabetesPedigreeFunction 0.627
Age 50.000
Outcome 1.000
Name: 1, dtype: float64df2.iloc[1]Pregnancies 1.000
Glucose 85.000
BloodPressure 66.000
SkinThickness 29.000
Insulin 0.000
BMI 26.600
DiabetesPedigreeFunction 0.351
Age 31.000
Outcome 0.000
Name: 2, dtype: float64Vous pouvez aussi récupérer plusieurs lignes en fournissant un intervalle. Les deux accesseurs traitent différemment la fin de l’intervalle : .loc[100:110] inclut l’étiquette 110 (11 lignes), tandis que .iloc[100:110] s’arrête avant 110 (10 lignes).
df2.loc[100:110]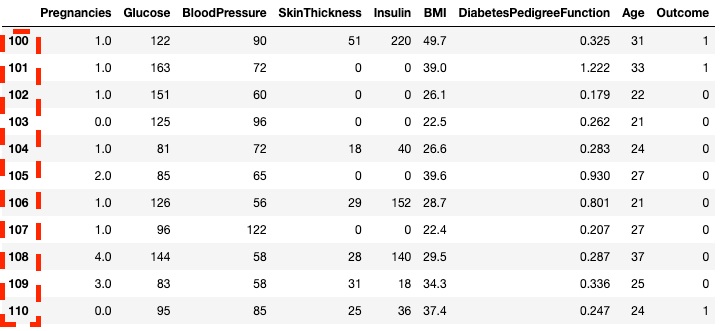
Isoler des lignes avec .loc[]
df2.iloc[100:110]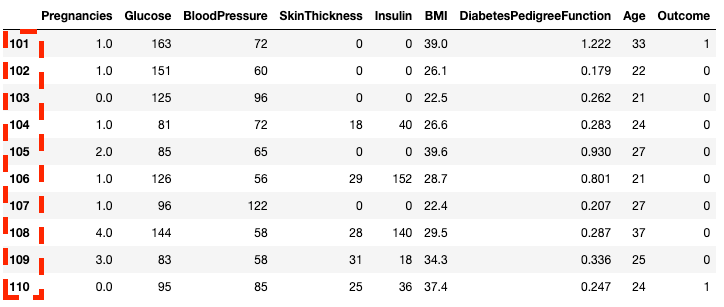
Isoler des lignes avec .iloc[]
Vous pouvez aussi sous‑sélectionner avec .loc[] et .iloc[] en passant une liste plutôt qu’un intervalle.
df2.loc[[100, 200, 300]]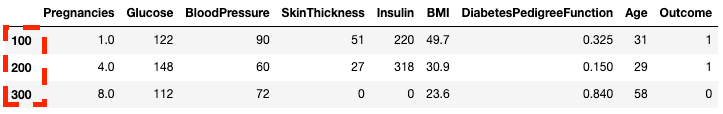
Isoler des lignes avec une liste via .loc[]
df2.iloc[[100, 200, 300]]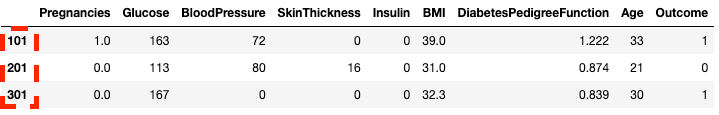
Isoler des lignes avec une liste via .iloc[]
Vous pouvez également sélectionner des colonnes spécifiques en plus des lignes. C’est ici que .iloc[] diffère de .loc[] : il requiert les positions de colonnes et non leurs étiquettes.
df2.loc[100:110, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
100 1.0 122 90
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85df2.iloc[100:110, :3] Pregnancies Glucose BloodPressure
101 1.0 163 72
102 1.0 151 60
103 0.0 125 96
104 1.0 81 72
105 2.0 85 65
106 1.0 126 56
107 1.0 96 122
108 4.0 144 58
109 3.0 83 58
110 0.0 95 85Pour aller plus vite, vous pouvez passer un index de départ comme tranche.
df2.loc[760:, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
760 6.0 190 92
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70df2.iloc[760:, :3] Pregnancies Glucose BloodPressure
761 2.0 88 58
762 9.0 170 74
763 9.0 89 62
764 10.0 101 76
765 2.0 122 70
766 5.0 121 72
767 1.0 126 60
768 1.0 93 70Vous pouvez mettre à jour des valeurs en combinant .loc[] avec l’opérateur d’affectation =. Construisez la condition depuis le même DataFrame que celui que vous mettez à jour : une condition construite depuis df ne s’alignera plus avec le nouvel index de df2, et pandas lèvera une erreur.
df2.loc[df2["Age"] == 81, "Age"] = 80Filtrer des lignes avec des conditions
pandas permet de filtrer selon des conditions sur les valeurs. Par exemple, le code ci‑dessous sélectionne la ligne où la pression artérielle est exactement 122. Ici, nous isolons des lignes en utilisant les crochets [ ] comme précédemment, mais au lieu d’indices ou de noms, nous passons une condition : BloodPressure égal à 122, notée df.BloodPressure == 122.
df[df.BloodPressure == 122]
Isoler des lignes selon une condition dans pandas
L’exemple ci‑dessous récupère toutes les lignes où Outcome vaut 1. df.Outcome sélectionne la colonne, df.Outcome == 1 renvoie une Series booléenne indiquant quelles lignes satisfont la condition, puis [] sous‑sélectionne df là où cette Series est True.
df[df.Outcome == 1]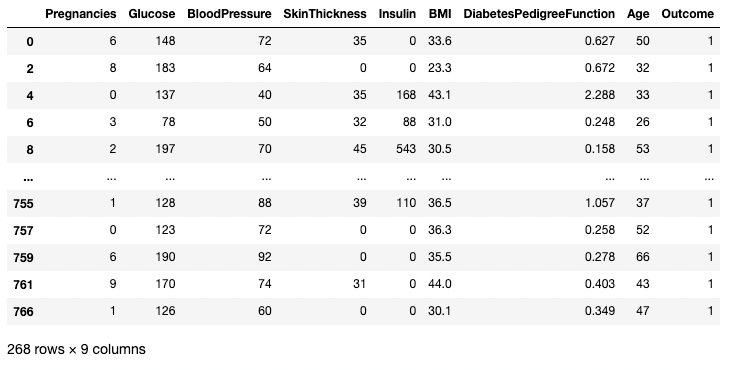
Isoler des lignes selon une condition dans pandas
Vous pouvez utiliser l’opérateur > pour comparer. Le code ci‑dessous récupère Pregnancies, Glucose et BloodPressure pour tous les enregistrements avec BloodPressure strictement supérieur à 100.
df.loc[df['BloodPressure'] > 100, ['Pregnancies', 'Glucose', 'BloodPressure']] Pregnancies Glucose BloodPressure
43 9 171 110
84 5 137 108
106 1 96 122
177 0 129 110
207 5 162 104
362 5 103 108
369 1 133 102
440 0 189 104
549 4 189 110
658 11 127 106
662 8 167 106
672 10 68 106
691 13 158 114Nettoyer des données avec pandas
Le nettoyage des données est l’une des tâches les plus courantes en data science. pandas vous permet de prétraiter des données pour tout usage, y compris l’entraînement de modèles de machine learning. Utilisons df2 de tout à l’heure, qui contient quatre valeurs manquantes, pour illustrer quelques cas de nettoyage. Rappel : voici comment compter les valeurs manquantes dans un DataFrame.
df2.isnull().sum()Pregnancies 4
Glucose 0
BloodPressure 0
SkinThickness 0
Insulin 0
BMI 0
DiabetesPedigreeFunction 0
Age 0
Outcome 0
dtype: int64Gérer les données manquantes #1 : supprimer les valeurs manquantes
Une approche consiste à supprimer les données manquantes. C’est utile lorsque vous avez suffisamment de données et que perdre une petite portion n’impactera pas l’analyse. Utilisez .dropna() comme ci‑dessous. Ici, nous enregistrons le résultat dans le DataFrame df3.
df3 = df2.copy()
df3 = df3.dropna()
df3.shape(764, 9) # soit 4 lignes de moins que df2L’argument axis permet de spécifier si vous supprimez des lignes ou des colonnes contenant des valeurs manquantes. Par défaut, axis=0 supprime les lignes contenant des NaN. Utilisez axis = 1 pour supprimer les colonnes contenant au moins un NaN. Comme dans tous les exemples de ce tutoriel, nous réaffectons le résultat au lieu d’utiliser inplace=True, déprécié dans pandas 3.1 pour .dropna().
df3 = df2.dropna(axis=1)
list(df3.columns)['Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DiabetesPedigreeFunction', 'Age', 'Outcome']Par défaut, .dropna() supprime une ligne dès qu’une de ses valeurs est manquante. Fixez how à 'all' pour ne supprimer que les lignes dont toutes les valeurs sont manquantes. Aucune ligne de df2 n’est totalement vide, donc rien n’est supprimé :
df3 = df2.dropna(how="all")
df3.shape(768, 9)Gérer les données manquantes #2 : remplacer les valeurs manquantes
Au lieu de supprimer, vous pouvez remplacer par une statistique de synthèse ou une valeur fixe. Par exemple, si une journée manque dans une semaine de températures, la remplir par la moyenne hebdomadaire conserve la ligne tout en perdant peu d’information. Le code ci‑dessous remplit les valeurs manquantes de Pregnancies par la moyenne de cette colonne.
df3 = df2.copy()
# Moyenne de Pregnancies
mean_value = df3["Pregnancies"].mean()
# Remplir uniquement les valeurs manquantes de cette colonne
df3["Pregnancies"] = df3["Pregnancies"].fillna(mean_value)
df3["Pregnancies"].head(7)1 6.000000
2 1.000000
3 3.846859
4 3.846859
5 3.846859
6 3.846859
7 3.000000
Name: Pregnancies, dtype: float64Gérer les doublons
Ajoutons des doublons aux données d’origine pour apprendre à les supprimer. Ici, nous utilisons pd.concat() pour concaténer df2 avec lui‑même, créant des doublons parfaits de chaque ligne de df2.
df3 = pd.concat([df2, df2])
df3.shape(1536, 9)Vous pouvez supprimer toutes les lignes dupliquées (par défaut) avec la méthode .drop_duplicates().
df3 = df3.drop_duplicates()
df3.shape(768, 9)Renommer des colonnes
Renommer des colonnes est une tâche fréquente de nettoyage. Passez à .rename() un dictionnaire columns qui mappe anciens noms vers nouveaux :
df3 = df3.rename(columns={"DiabetesPedigreeFunction": "DPF"})
df3[["Glucose", "BMI", "DPF", "Age"]].head() Glucose BMI DPF Age
1 148 33.6 0.627 50
2 85 26.6 0.351 31
3 183 23.3 0.672 32
4 89 28.1 0.167 21
5 137 43.1 2.288 33Vous pouvez aussi affecter une liste complète de noms à .columns. La liste doit nommer chaque colonne dans l’ordre actuel : pandas assigne par position, donc une liste mal ordonnée étiquettera mal vos données sans erreur apparente.
df3.columns = ["Pregnancies", "Glucose", "BloodPressure", "SkinThickness", "Insulin", "BMI", "DPF", "Age", "Outcome"]
list(df3.columns)['Pregnancies', 'Glucose', 'BloodPressure', 'SkinThickness', 'Insulin', 'BMI', 'DPF', 'Age', 'Outcome']Pour aller plus loin sur le nettoyage des données et des workflows plus fiables, consultez cette checklist qui recense les principales tâches de nettoyage.
Combiner des DataFrames avec pandas
pandas combine des DataFrames de deux façons : .merge() assemble des tables sur des colonnes clés communes, comme une jointure SQL, et pd.concat() empile des tables l’une au‑dessus de l’autre ou côte à côte.
Fusionner des DataFrames avec .merge()
Utilisez .merge() lorsque deux tables partagent une colonne clé. Supposons qu’une deuxième table associe chaque code Outcome à un libellé lisible. Une jointure à gauche sur Outcome ajoute ce libellé à chaque patient :
outcome_labels = pd.DataFrame({"Outcome": [0, 1], "Diagnosis": ["Non-diabetic", "Diabetic"]})
df_labeled = df.merge(outcome_labels, on="Outcome", how="left")
df_labeled[["Glucose", "Outcome", "Diagnosis"]].head(3) Glucose Outcome Diagnosis
0 148 1 Diabetic
1 85 0 Non-diabetic
2 183 1 DiabeticL’argument how fixe le type de jointure : "left" conserve toutes les lignes de df, "inner" ne garde que les correspondances dans les deux tables, et "outer" conserve toutes les lignes des deux. Notre tutoriel sur les jointures de DataFrames couvre .join() et tous les types de jointures.
Concaténer des DataFrames avec pd.concat()
Utilisez pd.concat() lorsque les tables ont les mêmes colonnes et que vous voulez empiler leurs lignes, par exemple des enregistrements patients arrivés en deux lots. Fixez ignore_index=True pour repartir sur un index 0‑based au lieu de conserver les étiquettes de chaque lot :
batch_1 = df.iloc[:500]
batch_2 = df.iloc[500:]
df_combined = pd.concat([batch_1, batch_2], ignore_index=True)
df_combined.shape(768, 9)Avec axis=1, pd.concat() place les tables côte à côte, en appariant les lignes par leurs étiquettes d’index :
measurements = df[["Glucose", "BMI"]]
outcomes = df[["Outcome"]]
pd.concat([measurements, outcomes], axis=1).head(3) Glucose BMI Outcome
0 148 33.6 1
1 85 26.6 0
2 183 23.3 1Pour vous entraîner sur ces deux méthodes, essayez notre cours Joining Data with pandas.
Analyse de données avec pandas
La vraie valeur de pandas réside dans sa rapidité d’analyse. Dans cette section, nous nous concentrons sur quelques techniques d’analyse à connaître.
Opérateurs de synthèse (moyenne, mode, médiane)
Comme vu plus haut, vous pouvez obtenir la moyenne de chaque colonne avec .mean().
df.mean()Pregnancies 3.845052
Glucose 120.894531
BloodPressure 69.105469
SkinThickness 20.536458
Insulin 79.799479
BMI 31.992578
DiabetesPedigreeFunction 0.471876
Age 33.240885
Outcome 0.348958
dtype: float64La mode se calcule de manière similaire avec .mode().
df.mode()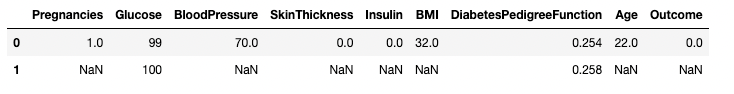
Affichage de la mode des colonnes dans pandas
De même, la médiane de chaque colonne se calcule avec .median().
df.median()Pregnancies 3.0000
Glucose 117.0000
BloodPressure 72.0000
SkinThickness 23.0000
Insulin 30.5000
BMI 32.0000
DiabetesPedigreeFunction 0.3725
Age 29.0000
Outcome 0.0000
dtype: float64Créer de nouvelles colonnes à partir de colonnes existantes
pandas permet des calculs rapides en combinant des colonnes comme des scalaires. Le code ci‑dessous divise chaque valeur de Glucose par la valeur correspondante de Insulin pour créer Glucose_Insulin_Ratio.
df2['Glucose_Insulin_Ratio'] = df2['Glucose']/df2['Insulin']
df2.head()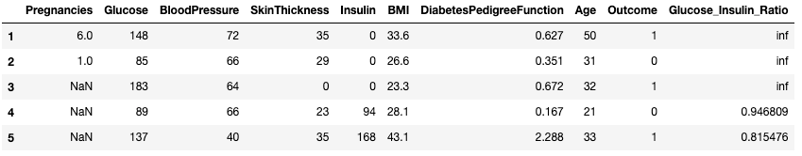
Créer une nouvelle colonne à partir d’existantes dans pandas
Les lignes où Insulin vaut 0 affichent inf, car une division par zéro donne l’infini. Dans ce jeu de données, 0 pour Insulin signifie que la mesure manque (374 lignes sur 768). Traitez ces zéros comme manquants avant de diviser :
df2["Glucose_Insulin_Ratio"] = df2["Glucose"] / df2["Insulin"].where(df2["Insulin"] > 0)
df2["Glucose_Insulin_Ratio"].head()1 NaN
2 NaN
3 NaN
4 0.946809
5 0.815476
Name: Glucose_Insulin_Ratio, dtype: float64.where() conserve les valeurs qui respectent la condition et remplace les autres par NaN, de sorte que le ratio soit manquant plutôt qu’infini pour ces lignes. Notre tutoriel sur l’ajout de colonnes présente d’autres méthodes.
Compter avec .value_counts()
Quand une colonne contient des catégories, vous voulez souvent compter les effectifs par catégorie. .value_counts() fait exactement cela. Ici, par exemple, nous comptons les observations avec Outcome diabétique (1) et non diabétique (0).
df['Outcome'].value_counts()Outcome
0 500
1 268
Name: count, dtype: int64En ajoutant l’argument normalize, vous obtenez des proportions au lieu des effectifs.
df['Outcome'].value_counts(normalize=True)Outcome
0 0.651042
1 0.348958
Name: proportion, dtype: float64
Désactivez le tri automatique des résultats avec l’argument sort (par défaut True). Le tri par défaut s’effectue sur les effectifs décroissants.
df['Outcome'].value_counts(sort=False)Outcome
1 268
0 500
Name: count, dtype: int64Vous pouvez aussi appliquer .value_counts() à un DataFrame et à des colonnes spécifiques plutôt qu’à une seule colonne. Ici, par exemple, nous l’appliquons à df via l’argument subset qui prend une liste de colonnes.
df.value_counts(subset=['Pregnancies', 'Outcome'])Pregnancies Outcome
1 0 106
2 0 84
0 0 73
3 0 48
4 0 45
0 1 38
5 0 36
6 0 34
1 1 29
3 1 27
7 1 25
4 1 23
8 1 22
5 1 21
7 0 20
2 1 19
9 1 18
6 1 16
8 0 16
10 0 14
1 10
9 0 10
11 1 7
13 0 5
1 5
12 0 5
11 0 4
12 1 4
14 1 2
15 1 1
17 1 1
Name: count, dtype: int64Agréger avec .groupby() dans pandas
pandas vous permet d’agréger des valeurs par groupes définis sur des colonnes. Combinez .groupby() avec une méthode de synthèse. Le code ci‑dessous affiche la moyenne des colonnes numériques regroupées par Outcome.
df.groupby('Outcome').mean()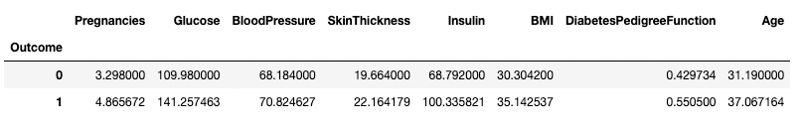
Agrégation par une colonne dans pandas
.groupby() permet de grouper par plusieurs colonnes en passant une liste, comme ci‑dessous.
df.groupby(['Pregnancies', 'Outcome']).mean()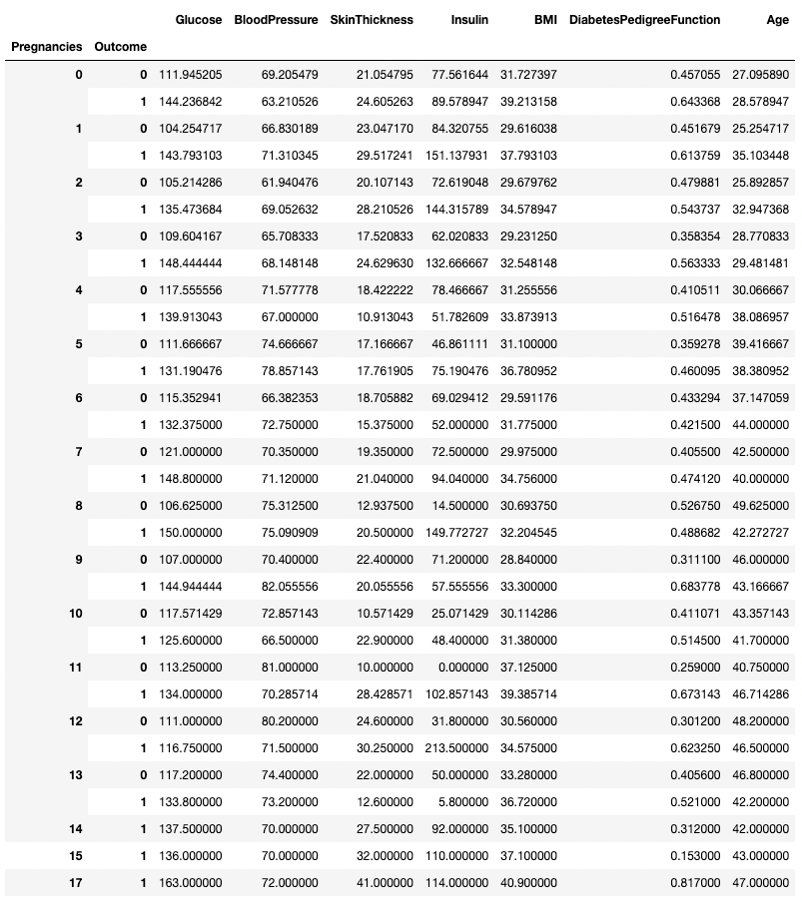
Agrégation par deux colonnes dans pandas
Toute méthode de synthèse peut être utilisée avec .groupby() : .min(), .max(), .mean(), .median(), .sum(), etc. Notre tutoriel sur GroupBy couvre les agrégations multiples avec .agg() et d’autres schémas.
Tableaux croisés dynamiques
pandas permet aussi de calculer des statistiques sous forme de tableaux croisés (pivot tables). Cela facilite les conclusions basées sur des combinaisons de variables. Le code ci‑dessous prend les valeurs uniques de Pregnancies comme lignes, les valeurs uniques de Outcome comme colonnes, et les cellules contiennent la moyenne de BMI du groupe correspondant.
Par exemple, pour Pregnancies = 5 et Outcome = 0, l’IMC moyen est de 31,1.
pd.pivot_table(df, values="BMI", index='Pregnancies',
columns=['Outcome'], aggfunc='mean')Outcome 0 1
Pregnancies
0 31.727397 39.213158
1 29.616038 37.793103
2 29.679762 34.578947
3 29.231250 32.548148
4 31.255556 33.873913
5 31.100000 36.780952
6 29.591176 31.775000
7 29.975000 34.756000
8 30.693750 32.204545
9 28.840000 33.300000
10 30.114286 31.380000
11 37.125000 39.385714
12 30.560000 34.575000
13 33.280000 36.720000
14 NaN 35.100000
15 NaN 37.100000
17 NaN 40.900000Visualiser des données avec pandas
pandas fournit des wrappers pratiques autour des fonctions de tracé de Matplotlib pour faciliter la visualisation de vos DataFrames. Ci‑dessous, vous verrez comment réaliser des visualisations courantes avec pandas.
Courbes (line plots) avec pandas
pandas permet de représenter les relations entre variables avec des graphiques en lignes. Ci‑dessous, une courbe de BMI et Glucose en fonction de l’index des lignes.
df[['BMI', 'Glucose']].plot.line()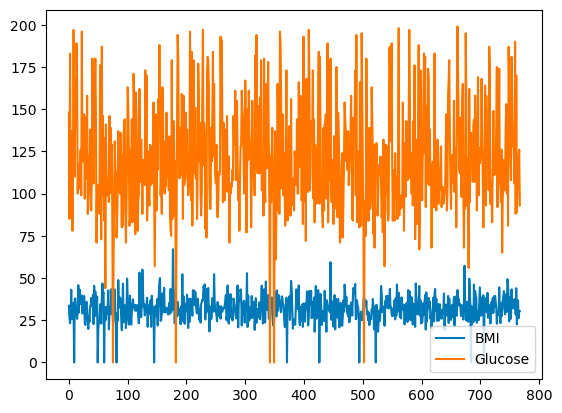
Courbe basique avec pandas
Vous pouvez choisir les couleurs via l’argument color.
df[['BMI', 'Glucose']].plot.line(color={"BMI": "red", "Glucose": "blue"})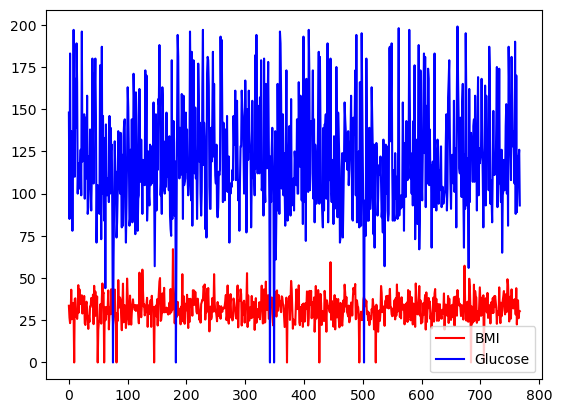
Courbe basique avec pandas, couleurs personnalisées
Toutes les colonnes de df peuvent aussi être tracées sur des axes distincts avec l’argument subplots.
df.plot.line(subplots=True)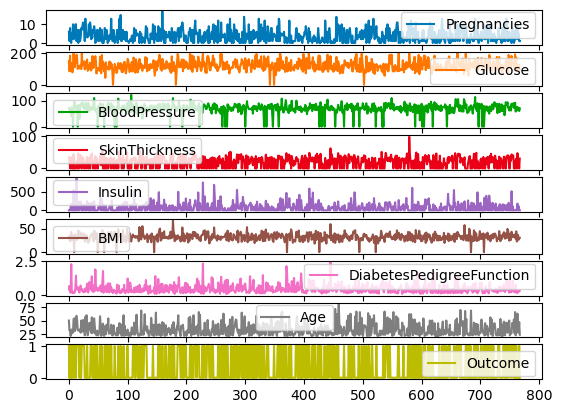
Sous‑graphiques pour courbes avec pandas
Diagrammes en barres
Pour les colonnes discrètes, utilisez un diagramme en barres des effectifs pour visualiser leur distribution. La variable binaire Outcome est visualisée ci‑dessous.
df['Outcome'].value_counts().plot.bar()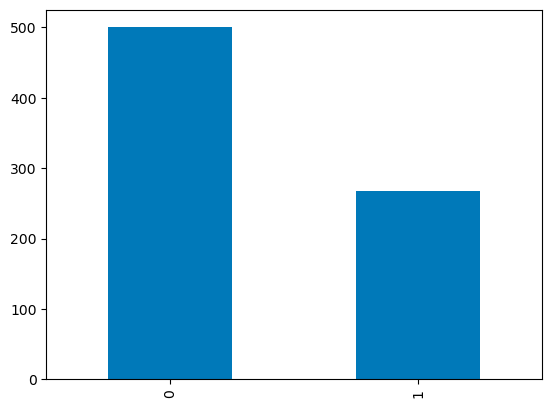
Diagrammes en barres dans pandas
Boîtes à moustaches (box plots) avec pandas
La distribution en quartiles des variables continues peut être visualisée avec un boxplot. Le code ci‑dessous crée un boxplot avec pandas.
df.boxplot(column=['BMI'], by='Outcome')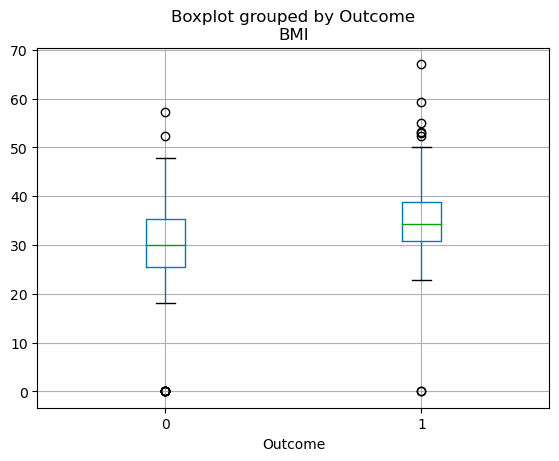
Boxplots dans pandas
En guise de conclusion
Vous maîtrisez maintenant le flux de travail pandas essentiel : lire un fichier dans un DataFrame, l’inspecter avec .head(), .info() et .describe(), sélectionner des lignes avec .loc[] et .iloc[], nettoyer valeurs manquantes et doublons, fusionner des tables et résumer avec .groupby() et des tableaux croisés.
Si vous avez appris pandas avant 2026, une habitude vaut la peine de changer : réaffectez les résultats plutôt que d’utiliser inplace=True, et effectuez chaque mise à jour avec un seul appel .loc[]. Le moyen le plus rapide de consolider le reste est de répéter ce flux sur un jeu de données qui vous tient à cœur. Ces ressources vous aideront à aller plus loin :
- [Antisèches] Un large choix d’antisèches Python et pandas pour vous accompagner
- [Formations en direct] Nos sessions de code en direct gratuites, dont beaucoup utilisent pandas
- [Cours] Data Manipulation with pandas et Joining Data with pandas pour une pratique interactive
- [Préparation aux entretiens] Nos meilleures questions d’entretien pandas pour vous évaluer
- [Plus de tutoriels] Découvrez nos autres tutoriels sur pandas et l’écosystème PyData, dont implémenter des moyennes mobiles et utiliser la méthode .apply() de pandas
FAQ pandas
Qu’est-ce que pandas en Python ?
pandas est une bibliothèque open source pour Python dédiée aux données tabulaires. Ses deux structures de base, le DataFrame (une table) et la Series (une colonne), offrent des fonctions pour importer, nettoyer, restructurer, agréger et visualiser les données, ce qui en fait l’outil de référence pour l’analyse de données en Python.
Pourquoi devrais-je apprendre pandas ?
Si vous travaillez des données en Python, pandas est quasiment incontournable. Il simplifie la manipulation et l’analyse pour que vous puissiez vous concentrer sur les insights et la création de valeur. Qu’il s’agisse de petits jeux de données ou de volumes importants, pandas vous facilite la vie par sa rapidité, sa flexibilité et ses structures de données conviviales.
Comment installer pandas ?
Exécutez pip install pandas dans votre terminal, ou conda install pandas si vous utilisez conda. pandas 3 nécessite Python 3.11 ou plus récent. Anaconda inclut pandas par défaut, et DataLab de DataCamp l’a préinstallé.
Quelles sont les structures de données de base dans pandas ?
Les deux structures de données principales de pandas sont la Series et le DataFrame. Une Series est essentiellement une colonne, et un DataFrame est une table multi‑dimensionnelle constituée d’un ensemble de Series. Ces structures sont flexibles : elles peuvent contenir différents types (entier, chaîne, flottant, etc.).
pandas est‑il adapté aux grands jeux de données ?
pandas gère confortablement des millions de lignes, tant que les données tiennent en mémoire. Pour des données qui n’y tiennent pas, lisez-les par lots avec l’argument chunksize, ou passez à un outil conçu pour de plus gros volumes, tel que Polars, Dask ou PySpark.
Comment importer des données dans pandas ?
pandas peut lire des données depuis divers formats : CSV, Excel, bases SQL, JSON, etc. Les commandes pd.read_csv(), pd.read_excel(), pd.read_sql() et pd.read_json() importent les données des formats respectifs. Elles renvoient toutes un DataFrame, que vous pouvez ensuite manipuler avec pandas.
Qu’est‑ce qui a changé dans pandas 3.0 ?
pandas 3.0, publié en janvier 2026, a activé Copy‑on‑Write par défaut : tout sous‑ensemble se comporte comme une copie et une affectation chaînée telle que df["col"][0] = x ne met plus à jour le DataFrame d’origine. Il infère aussi les colonnes texte avec un type str dédié plutôt que object, et nécessite Python 3.11 ou plus récent. pandas 3.1 a ensuite déprécié inplace=True pour des méthodes comme dropna() et sort_values().
Quelle est la différence entre loc et iloc dans pandas ?
.loc[] sélectionne lignes et colonnes par étiquette, et .iloc[] par position entière à partir de 0. Les tranches diffèrent aussi : .loc[100:110] inclut l’étiquette de fin, tandis que .iloc[100:110] s’arrête avant la position 110. Consultez notre guide loc vs iloc pour d’autres exemples.
Comment fusionner deux DataFrames dans pandas ?
Utilisez df1.merge(df2, on="key", how="left") pour joindre deux DataFrames sur une colonne commune, comme une jointure SQL. L’argument how choisit le type de jointure ("left", "right", "inner" ou "outer"). Pour empiler des DataFrames, utilisez plutôt pd.concat().

Je suis un stratège de l'IA et un éthicien qui travaille à l'intersection de la science des données, du produit et de l'ingénierie pour construire des systèmes d'apprentissage automatique évolutifs. Considéré comme l'un des 200 plus grands innovateurs commerciaux et technologiques au monde, je me suis donné pour mission de démocratiser l'apprentissage automatique et de briser le jargon pour que tout le monde puisse participer à cette transformation.


pandas est le standard Python pour l’analyse de données, avec plus de 500 millions de téléchargements par mois sur PyPI. Il lit et écrit des fichiers CSV, Excel, JSON, SQL et bien d’autres formats, et ses fonctions couvrent les tâches quotidiennes de nettoyage, de restructuration, d’agrégation et de visualisation de données tabulaires.
Dans ce tutoriel pandas, nous parcourons le flux de travail complet sur un jeu de données réel : installer pandas, importer et exporter des données, inspecter un DataFrame, sélectionner et filtrer des lignes, traiter les valeurs manquantes et les doublons, combiner des tables, agréger et tracer. Chaque exemple s’exécute avec pandas 3.1, la version actuelle, et nous signalons les changements de pandas 3 qui cassent le code de tutoriels plus anciens.
Vous avez besoin des bases de Python, sans expérience préalable de pandas. Pour un parcours d’apprentissage plus long, consultez notre article sur comment apprendre pandas, et pour vous entraîner de manière interactive, notre cours Data Manipulation with pandas.
À retenir
pip install pandas; pandas 3 nécessite Python 3.11 ou plus récent..loc[]sélectionne par étiquette,.iloc[]par position..loc[].df = df.dropna()) au lieu d’utiliser le paramètre obsolèteinplace=True.Qu’est-ce que pandas ?
pandas est une bibliothèque Python de manipulation de données tabulaires, c’est‑à‑dire des données sous forme de lignes et de colonnes, également appelées DataFrames. Intuitivement, vous pouvez voir un DataFrame comme une feuille Excel.
Les fonctionnalités de pandas couvrent les transformations de données, comme le tri des lignes et la création de sous‑ensembles, le calcul de statistiques descriptives (moyenne, etc.), la restructuration des DataFrames et leurs jointures. pandas s’intègre bien avec les autres bibliothèques phares de la data science en Python, l’écosystème PyData, dont :
À quoi sert pandas ?
pandas est utilisé tout au long du cycle d’analyse de données. Avec pandas, vous pouvez :
pandas propose aussi des fonctionnalités pour les séries temporelles et l’analyse de textes.
Principaux atouts de pandas
pandas présente cinq avantages pratiques pour le travail quotidien sur les données :
Comment installer pandas
Avant d’utiliser pandas, vous devez l’installer. Vous pouvez éviter cette étape en créant un compte DataCamp gratuit et en utilisant DataLab, un IDE cloud livré avec pandas (ainsi que les principales bibliothèques Python pour la data) préinstallé.