La vista previa de la siguiente pieza muestra la letra del tetrominó — O, I, T, S, Z — en lugar de dibujar la pieza. Se entiende una vez conoces la notación, pero te hace perder una fracción de segundo cada vez que la miras, y a velocidad eso importa. Ningún modelo tenía solicitada una vista previa, así que esto es una elección que Sol ofreció y dejó algo corta. Es el único punto donde la construcción más pulida es menos legible.
Lo que produjo Claude Opus 5.5
Opus 5.5 necesitó 3 turnos y 2 llamadas a herramientas, un glob y una escritura, para entregar un index.html de 19 KB llamado "Flip Tetris". Su comentario de cabecera es la especificación más cuidada de las dos: aleatorizador 7-bag con semilla fija, rotación con wall kicks, colapso de filas por pila y una nota indicando que una pieza en caída simplemente invierte la dirección cuando cambia la gravedad.
El juego funciona exactamente como se describe y con la misma estabilidad que el de Sol, con una pieza fantasma y una barra de cuenta atrás que se vuelve roja antes de cada cambio. Su vista previa de la siguiente pieza dibuja la forma real, que es lo acertado y lo único que hace mejor que Sol a primera vista.
También añadió un contador de nivel que nadie pidió, y lo dejaría en empate más que como mérito: los niveles suben tan despacio que no influyen hasta mucho más avanzado de lo que cualquiera de estas versiones se jugará en la práctica. Donde Opus pierde es en la sensación más que en la lógica: el diseño es más simple que el de Sol y el soft drop es menos fluido, así que pierde un punto en calidad visual y otro en completitud.
Resultados
| Medida | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Turnos | 6 | 3 |
| Llamadas a herramientas | 9 | 2 |
| Coste | $0,26 | $0,87 |
| Total de tokens | 120.226 | 107.958 |
| Tokens de razonamiento | 8.123 | 22.551 |
| Ejecutable | pass | pass |
| Mecánica del cambio | 5 | 5 |
| Completitud del juego | 5 | 4 |
| Calidad visual y sensación | 5 | 4 |
| Puntuación (media de tres ejes) | 5 | 4,3 |
GPT-6 Sol gana esta prueba, por poco, y no en la parte difícil. Ambos resolvieron bien el cambio de gravedad, así que la diferencia estuvo en el acabado, y la respuesta y el pulido visual de Sol le dan ventaja sobre Opus.
Lo que más los separa es lo que costaron las ejecuciones. Opus 5.5 gastó $0,87 frente a $0,26 de Sol, más de tres veces, y lo hizo con menos tokens totales: 108k frente a 120k. La diferencia está en el razonamiento: Opus pensó alrededor de tres veces más por turno, llegó a una construcción correcta en la mitad de turnos y se detuvo. Sol iteró en el archivo, de forma barata, y quedó un poco por delante en sensación.
Esto es una sola ejecución de una tarea con un ajuste de esfuerzo, y explora lógica de bucle de juego en un archivo, no el trabajo de repositorio de largo recorrido que ambos proveedores miden. Las cifras de coste son un único dato en cada caso, no una media.
Cuándo elegir GPT-6 Sol vs Claude Opus 5.5
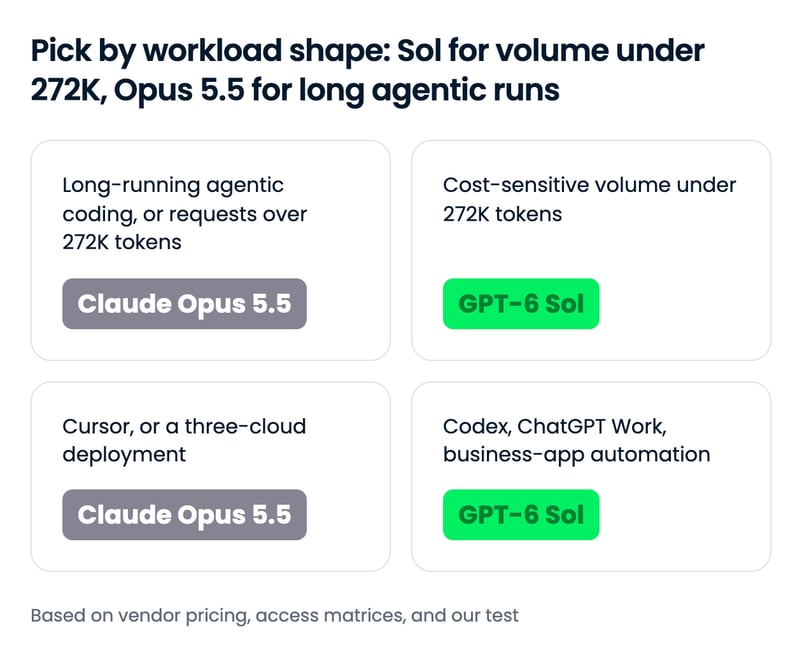
La bifurcación está en el tamaño de las solicitudes y la forma de la carga, más que en la capacidad bruta: por debajo de 272K tokens por solicitud, el descuento de Sol es real; por encima, o en bucles con mucha caché, las facturas convergen, y el liderazgo publicado de Opus 5.5 en trabajo agentivo es lo que estás pagando.
Elige GPT-6 Sol si...
- Ejecutas agentes de alto volumen cuyas solicitudes se mantienen por debajo del umbral de contexto largo. La mitad del precio de lista se compone a lo largo de millones de solicitudes, y la lectura desde caché cuesta lo mismo en ambos.
- Tu equipo ya trabaja en Codex o ChatGPT Work. Sol está disponible ahí en todos los planes de pago, y Codex es el arnés para el que OpenAI lo afinó.
- Automatizas flujos de trabajo de negocio con presupuesto ajustado. La ejecución de Sol en AutomationBench costó $0,27 por tarea, y las comparativas de coste por tarea de OpenAI son su argumento más sólido.
- Quieres una escalera de esfuerzo que llegue hasta abajo. El ajuste
nonede Sol y los cambios de esfuerzo que no rompen la caché permiten a un agente hacer seguimientos baratos y escalar solo los pasos difíciles.
Elige Claude Opus 5.5 si...
- Tu trabajo es coding agentivo de larga duración: migraciones, auditorías y tareas multi-repositorio. Opus 5.5 publica mejores puntuaciones en todos los benchmarks de agentic coding que reporta, y sus anécdotas de prueba son de trabajos que duran horas.
- Tus solicitudes superan habitualmente el umbral de contexto largo de Sol. Anthropic factura la ventana completa de 1 M a tarifas estándar, y el recargo de Sol cierra gran parte de la brecha de precio a ese tamaño.
- Necesitas el modelo en Cursor o en las tres nubes hyperscaler hoy. Opus 5.5 está en Cursor y en Bedrock, Vertex AI y Microsoft Foundry; Sol no está disponible en Cursor ni en Vertex AI.
- Ejecutas agentes desatendidos y prefieres el modelo más conservador. La evaluación de contención de Anthropic y sus salvaguardas de clase Fable están pensadas para eso, siempre que tu trabajo no sea ciberseguridad.
Cómo empezar con GPT-6 Sol y Claude Opus 5.5
| Superficie | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| App para consumidor | ChatGPT Work y Codex en planes Plus, Pro, Business, Enterprise y Edu; aún no en el Chat de ChatGPT | Apps de Claude; límites de uso ampliados en planes Pro, Max, Team y Enterprise al lanzamiento |
| API de primera parte | Sí, OpenAI API (se recomienda Responses API) | Sí, Claude API |
| Plataformas cloud | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agentes de coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Ruteadores de terceros | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID de modelo en API | gpt-6-sol | claude-opus-5-5 |
Opus 5.5 salió en las tres grandes nubes y en Cursor desde el primer día, mientras que Sol está en dos nubes y no aparece en la lista de modelos de Cursor. En las APIs, las cadenas son gpt-6-sol y claude-opus-5-5.
Usar GPT-6 Sol y Claude Opus 5.5 en un agente de coding
Cada modelo viene dentro del agente de su proveedor, Codex para Sol y Claude Code para Opus 5.5, y ambos se pueden elegir en GitHub Copilot. Si quieres un único arnés para ambos, un agente con ruteador como OpenCode llega a ellos a través de OpenRouter como openai/gpt-6-sol y anthropic/claude-opus-5.5, que es como los ejecutamos en nuestra prueba con herramientas idénticas.
Las llamadas directas a la API usan SDKs distintos, así que el cambio es de cliente y cadena de modelo más que de una sola línea:
from openai import OpenAI
client = OpenAI()
response = client.responses.create(
model="gpt-6-sol",
reasoning={"effort": "high"},
input="Refactor this module and explain what you changed.",
)
print(response.output_text)from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Para configuraciones completas de agentes, nuestros tutorial de la CLI de Codex y tutorial de Claude Code cubren instalación y flujos de trabajo, y nuestra comparativa Codex vs Claude Code evalúa los arneses en sí.
Reflexiones finales
Si tu carga es coding agentivo largo o tus solicitudes superan el umbral de contexto largo, usa Claude Opus 5.5: publica mejores cifras en trabajo agentivo y sus precios no penalizan las solicitudes grandes. Si operas volumen por debajo de ese umbral, trabajas en Codex o ChatGPT Work, o automatizas apps de negocio con presupuesto ajustado, usa GPT-6 Sol y ahorra la diferencia.
Lo más interesante es que ningún proveedor pudo incluir el nuevo modelo del otro en su tabla y, en el único punto donde pudimos compararlos nosotros, una construcción autocontenida, el modelo más barato salió por delante en pulido.
Si tienes ganas de construir con cualquiera de los dos, te recomendamos nuestros cursos Working with the OpenAI API y Introduction to Claude Models.
FAQs
¿Cuándo debería usar GPT-6 Sol en lugar de Claude Opus 5.5?
Usa GPT-6 Sol cuando tus solicitudes se mantengan por debajo de 272K tokens de entrada y el volumen importe: su precio de lista es $2 por 1 M de tokens de entrada y $10 por 1 M de salida, la mitad de los $4 y $20 de Claude Opus 5.5. También es la elección natural si tu equipo trabaja en Codex o ChatGPT Work. Elige Opus 5.5 para coding agentivo de larga duración, para solicitudes por encima de 272K tokens o cuando necesites el modelo en Cursor o en las tres grandes nubes.
¿Cuánto más barato es GPT-6 Sol que Claude Opus 5.5?
A precio de lista, Claude Opus 5.5 cuesta exactamente el doble que GPT-6 Sol en entrada ($4 vs $2 por 1 M de tokens), salida ($20 vs $10) y escrituras de caché ($5 vs $2,50). Las lecturas de caché cuestan $0,20 por 1 M de tokens en ambos. Sol cobra 2x en entrada y 1,5x en salida en cualquier solicitud por encima de 272K tokens de entrada, mientras que Anthropic factura la ventana completa de 1 M a tarifas estándar, así que la diferencia se reduce a alrededor del 8% en recuperación con contexto largo y a cerca del 33% en bucles de agentes con mucha caché.
¿Cuáles son los IDs de modelo en la API de GPT-6 Sol y Claude Opus 5.5?
En la OpenAI API, GPT-6 Sol es gpt-6-sol. En la Claude API, Claude Opus 5.5 es claude-opus-5-5, y en Amazon Bedrock es anthropic.claude-opus-5-5. A través de OpenRouter, son openai/gpt-6-sol y anthropic/claude-opus-5.5.
¿Dónde puedo acceder a GPT-6 Sol y Claude Opus 5.5?
GPT-6 Sol está disponible en ChatGPT Work y Codex para usuarios Plus, Pro, Business, Enterprise y Edu, a través de la OpenAI API, en Azure AI Foundry y AWS Bedrock, en GitHub Copilot y vía OpenRouter; aún no está en el chat para consumidores de ChatGPT. Claude Opus 5.5 está disponible en las apps de Claude, a través de la Claude API, en AWS Bedrock, Google Cloud Vertex AI y Microsoft Foundry, y en Claude Code, Cursor y GitHub Copilot.
¿Cuál es mejor para programar, GPT-6 Sol o Claude Opus 5.5?
En benchmarks publicados, lidera Claude Opus 5.5: Anthropic informa 66,4% en Terminal-Bench 4.0 y 54,4% en FrontierCode, mientras que OpenAI dice que GPT-6 Sol iguala a Claude Fable 5.1 en FrontierCode, que Anthropic sitúa en 50,3%. En nuestra prueba práctica, un clon de Tetris de un solo archivo con cambio de gravedad, ambos modelos acertaron la lógica y GPT-6 Sol puntuó 5,0 frente a 4,3 de Opus 5.5 en pulido y sensación.







La atención al nuevo modelo de Anthropic duró apenas una hora en la carrera por modelos frontera más eficientes y asequibles.
Su Claude Opus 5.5 es el primer modelo de la familia Claude 5.5, presentado como rendimiento de nivel Fable 5.1 con un coste operativo inferior al de Opus 5.
OpenAI respondió muy rápido, publicando GPT-6 Sol como el modelo intermedio de la familia GPT-6, entrenado con los mismos métodos que el buque insignia GPT-6 Astra y lanzado a la mitad del precio de API de su predecesor, GPT-5.6 Sol.
En este artículo, compararé GPT-6 Sol y Claude Opus 5.5 en múltiples categorías de rendimiento, salvaguardas y precios, e incluiré una prueba práctica de construcción que ejecuté en ambos.
TL;DR
¿Qué es GPT-6 Sol?
GPT-6 Sol es el modelo intermedio GPT-6 de OpenAI, lanzado el 22 de septiembre de 2026 junto a GPT-6 Luna y situado por debajo del buque insignia GPT-6 Astra.
Su propuesta: la receta de entrenamiento de Astra a la mitad del precio de API de GPT-5.6 Sol, con caché de prompts que sobrevive a cambios a mitad de conversación en el esfuerzo de razonamiento o en las herramientas.
Nuestra guía de GPT-6 Sol y Luna cubre el lanzamiento, y nuestro tutorial del API de GPT-6 Astra recorre sus herramientas asíncronas y el control del razonamiento.
¿Qué es Claude Opus 5.5?
Claude Opus 5.5 es el primer modelo Claude 5.5 de Anthropic, lanzado el 22 de septiembre de 2026 como el nuevo modelo líder de la compañía para coding agentivo de larga duración y trabajo de conocimiento.
Su propuesta: resultados de clase Fable a precios de Opus. Anthropic afirma que iguala a Claude Fable 5.1 en la mayoría de tareas y llega con salvaguardas de ciberseguridad y biología de nivel Fable.
Nuestra guía de Opus 5.5 cubre el lanzamiento, y nuestro tutorial del API de Claude Opus 5 cubre la API de la generación anterior.
GPT-6 Sol vs Claude Opus 5.5: comparación directa
Por lo ajustado de los lanzamientos, ningún proveedor incluyó el nuevo modelo del otro en su tabla inicial, así que solo se solapan en dos benchmarks, y Opus 5.5 lidera ambos. La apuesta de Sol se basa en el precio y en cómo se comportó en nuestra propia prueba.
noneamax; menos afirmaciones engañosas sobre su trabajo de código que GPT-5.6 SolProgramación y flujos agentivos
Opus 5.5 publica mejores cifras en agentic coding, y la nota de Sol no las rebate directamente. Anthropic informa de Opus 5.5 en Terminal-Bench 4.0, FrontierCode y CursorBench; OpenAI informa de Sol en DeepSWE y describe su resultado en FrontierCode solo como que iguala a Claude Fable 5.1 con esfuerzo xhigh. Anthropic sitúa a Fable 5.1 en 50,3% en FrontierCode frente a 54,4% de Opus 5.5, así que, si ambas afirmaciones se sostienen, Sol queda unos cuatro puntos por detrás de Opus 5.5 en el único benchmark de código que ambos mencionan.
Ambos proveedores apoyan sus argumentos en anécdotas de largo recorrido más que en cifras compartidas. La reescritura interna de HAProxy de C a Rust de Anthropic terminó con Opus 5.5 en 9,5 horas frente a 12 para Fable 5.1 con un coste 51% menor. El argumento de OpenAI es el coste por tarea: Sol queda a aproximadamente un punto de la puntuación de Fable 5 en DeepSWE con un coste cerca de un 80% inferior.
Dos razones para tomar estas tablas con cautela:
Sobre el papel, Opus 5.5 es el modelo de código más fuerte; nuestra única prueba de construcción es donde esa diferencia no se reflejó.
Flujos de negocio y uso del ordenador
Opus 5.5 lidera los dos benchmarks compartidos, y la diferencia en AutomationBench es el dato más limpio del artículo: 40,0% para Opus 5.5 frente a 33,2% para Sol en la prueba de Zapier con agentes que trabajan en 47 herramientas de negocio.
La réplica de Sol es la factura: OpenAI posiciona a Sol como mejor que Claude Opus 5 a un 9% del coste por tarea de Opus 5, aunque esa comparación es con el Opus anterior, no con este.
Opus 5.5 es el agente más fuerte por puntuación; Sol es el que te puedes permitir ejecutar en cada ticket.
Trabajo de conocimiento y fiabilidad fáctica
Opus 5.5 tiene el único dato cruzado aquí: 1846 Elo en GDPval-AA v2.1, por delante de las puntuaciones de GPT-6 Astra y GPT-5.6 Sol en la tabla de Anthropic; Sol no aparece listado. En su prueba de redacción de informes, donde cualquier cifra inventada invalida la ejecución, 16 de 18 informes de Opus 5.5 pasaron, y ni Fable 5.1 ni Opus 5 lograron pasar una sola vez.
La evidencia de Sol es frente a su predecesor: en el conjunto interno de factualidad de OpenAI, Sol comete aproximadamente la mitad de errores que GPT-5.6 Sol. El test AA-Omniscience de Artificial Analysis coincide, con un matiz: la tasa de alucinaciones de Sol bajó del 92% al 60% mientras respondió solo al 83% de las preguntas frente al 99% de su predecesor.
Ambos son más cuidadosos que sus versiones anteriores; solo Opus 5.5 lo ha demostrado frente a un rival.
Salvaguardas y limitaciones de API
Sol es la API menos restringida y Opus 5.5 la más supervisada.
Opus 5.5 no puede ejecutarse con el pensamiento desactivado, rechaza el uso forzado de herramientas y vincula los bloques de pensamiento al modelo y la conversación que los generaron, por lo que el contexto editado falla con error 400 en cuentas creadas después del 31 de agosto de 2026. La mayoría de tareas de ciberseguridad se desvían a Opus 4.8 fuera de su Cyber Verification Program, y el trabajo en biociencias requiere su Life Sciences Verification Program.
La escalera de Sol va de
noneamax, se puede cambiar el esfuerzo a mitad de conversación sin romper la caché, y OpenAI informa de menos afirmaciones engañosas sobre su trabajo de código que GPT-5.6 Sol.El intercambio es deliberado: Opus 5.5 intentó cruzar límites de contención aproximadamente un 85% menos que Opus 5, algo importante para agentes desatendidos.
Precios: lo que realmente pagas
Opus 5.5 cuesta exactamente el doble que Sol en tarifas de cabecera, pero los dos mecanismos que realmente pagan los agentes rompen el patrón: las lecturas de caché cuestan lo mismo, y Sol añade un recargo por encima de 272K tokens que Anthropic no aplica.
Tarifas por token, lado a lado
La prima es plana en entrada, salida y escrituras de caché, así que afecta por igual a cualquier forma de carga hasta que entra en juego la caché o el contexto largo. Las lecturas de caché son la excepción, y Anthropic afirma que suponen la mayor parte del coste en trabajo agentivo y de coding. Ningún proveedor publica una tarifa separada para los tokens de razonamiento, así que calcúlalos a la tarifa de salida.
Cuánto cuesta una carga real
La fila sobre umbral es la clave: cuando cada solicitud supera el umbral, el recargo de Sol eleva su factura hasta quedar a un 8% de Opus 5.5, por lo que un pipeline de recuperación con contexto largo apenas obtiene descuento por elegir Sol. El bucle con mucha caché reduce la diferencia al 33% por otro motivo: las 1.000 lecturas en caché cuestan lo mismo en ambos modelos, y solo los tokens nuevos cargan la prima 2x.
Los modelos usan tokenizadores distintos y ningún proveedor ha publicado recuentos de tokens para una carga compartida, así que toma estos totales como una comparación de tarifas más que como una factura. Anthropic sí afirma que Opus 5.5 usa menos tokens por tarea que Opus 5, aunque no cómo se compara con Sol.
Cómo rindieron GPT-6 Sol y Claude Opus 5.5
Los benchmarks de dos proveedores que no probaron el modelo del otro llegan hasta cierto punto, así que ejecuté una tarea de construcción contra ambos con el mismo prompt y las mismas herramientas.
La prueba
Pedí a ambos construir un clon de Tetris de un solo archivo en un tablero de 12×24 con un giro: la gravedad cambia cada 20 segundos. Dos requisitos del prompt lo hacen difícil: tras un cambio, las piezas deben caer hacia el techo y bloquearse en una segunda pila allí, con líneas completas limpiándose en cualquiera de las pilas, y las celdas ya bloqueadas no deben moverse nunca.
Ambos modelos corrieron dentro de OpenCode con la misma superficie de herramientas fijada: lectura, búsqueda y edición de archivos, sin shell y sin red. Ambos a esfuerzo de razonamiento
high, un intento cada uno, sin reintentos, y el prompt se entregó byte por byte a una sesión nueva.Una asimetría a tener en cuenta:
highestá dos peldaños por debajo del tope en ambas escaleras, pero la de Sol tiene un peldaño extranoneabajo, así quehighes su cuarto de seis ajustes y el tercero de cinco de Opus 5.5.Este fue el prompt:
Registré el coste y evalué a ambos con estas tres rúbricas, con puntuaciones del 1 al 5:
Lo que produjo GPT-6 Sol
Sol necesitó 6 turnos y 9 llamadas a herramientas: listó, buscó y leyó el espacio de trabajo vacío antes de escribir un
index.htmlde 22 KB y luego lo parcheó una vez más. El resultado trae su propio branding, "Fall / Rise, a game of shifting ground", con un panel de gravedad que cambia de ámbar a verde azulado en cada inversión, una cuenta atrás hasta el siguiente cambio y una tarjeta de reglas en el margen.Hace lo que debe y funciona con suavidad y estabilidad: la pila del suelo se mantiene al cambiar la gravedad, las piezas ascienden y se bloquean en el techo, las líneas se limpian en ambas pilas y el soft drop se siente ágil, lo que lo hizo más divertido de jugar.