{count, plural, one {Programa} other {Programas}}
IA para ingeniería de software
{hours} h
Anthropic ha lanzado Claude Opus 4.7, la última iteración de su gama insignia. La gran novedad es la autonomía: Anthropic presenta este modelo como aquel al que puedes delegar tus tareas de código y agentes más duras y de larga duración sin supervisión cercana.
En esta versión también sabemos que hay un techo por encima de Opus 4.7. El Mythos Preview interno de Anthropic puntúa más alto en varios benchmarks, pero se retrasa su lanzamiento amplio mientras Anthropic prueba salvaguardas de ciberseguridad. Para cualquiera que no sea investigador interno de Anthropic, Opus 4.7 es el techo actual.
En este artículo, repasamos qué trae realmente de nuevo Opus 4.7, analizamos los benchmarks y compartimos pruebas prácticas que puedes ejecutar tú mismo. También puedes consultar nuestras guías de modelos competidores publicados recientemente, como Muse Spark de Meta, nAI's GPT-5.5, y Gemini 3.1 de Google.
Actualización: el 28 de mayo de 2026, Anthropic lanzó el modelo sucesor. Descúbrelo en nuestra guía de Claude Opus 4.8.
Claude Opus 4.7 es el último gran modelo lingüístico insignia de Anthropic, situado en lo alto de la familia Claude por encima de Sonnet y Haiku. Llega tras Claude Opus 4.6 y está diseñado para las tareas más exigentes, como flujos agentivos complejos y razonamiento en múltiples pasos que requieren rendimiento sostenido durante sesiones largas.
Frente a Opus 4.6, la versión 4.7 se centra en tres áreas:
El Mythos Preview interno de Anthropic, que mencionamos antes y sobre el que también tenemos un FAQ, lidera varios benchmarks, pero no está disponible ampliamente. Opus 4.7 es, esencialmente, un modelo hermano entrenado con capacidades de ciberseguridad reducidas deliberadamente.
Anthropic informa de mejoras notables en varias áreas de capacidad en Opus 4.7.
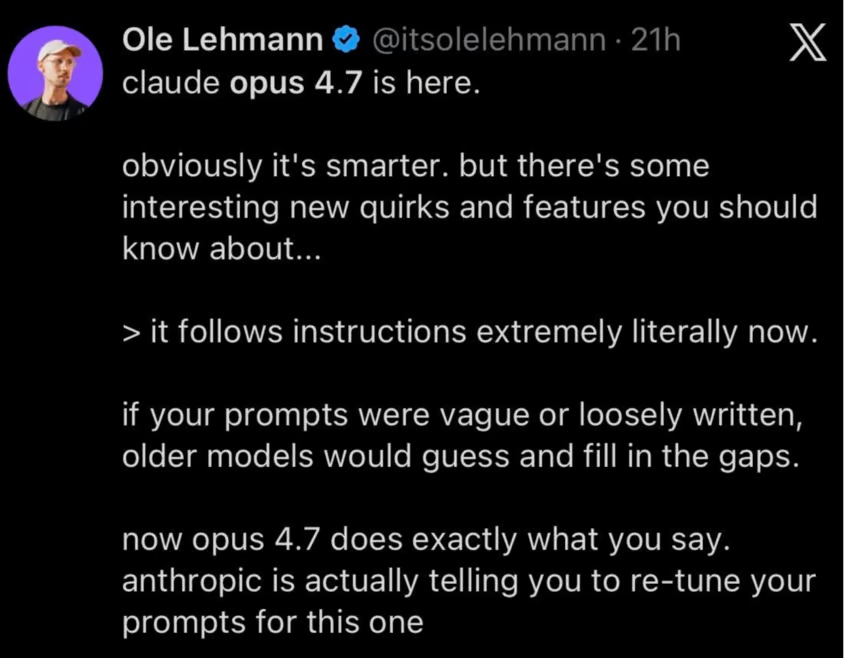
Opus 4.7 sigue las instrucciones más al pie de la letra que los modelos anteriores. Esto, claro, es útil para cualquier flujo de trabajo que dependa de la fiabilidad, pero puede tener efectos colaterales: Anthropic insta a reajustar prompts y arneses, ya que instrucciones que antes se pasaban por alto o se interpretaban de forma laxa ahora se tomarán literalmente.
Se ha mejorado la visión a alta resolución para admitir imágenes de hasta 3,75 megapíxeles, más del triple de lo que aceptaban los modelos anteriores. Los agentes de uso de ordenador y los flujos de extracción de datos pueden beneficiarse mucho de este aumento de detalle, ya que dependen de la legibilidad y la precisión, a veces a nivel de píxel.
Opus 4.7 mejora la memoria basada en sistema de archivos, un patrón en el que el modelo escribe notas en ficheros mientras trabaja y las relee en ejecuciones futuras.
Claude Code es el caso más claro: un fichero CLAUDE.md en la raíz del proyecto que Claude lee al empezar la sesión, actualiza conforme toma decisiones y reutiliza cuando retomas el trabajo.
«Mejor» aquí significa mejor criterio sobre qué merece la pena anotar y una recuperación más fiable en turnos posteriores. Anthropic afirma que esto permite que las nuevas tareas «necesiten menos contexto inicial» —si alguna vez has tenido que volver a explicar por quinta vez las convenciones de tu proyecto al modelo, como nos ha pasado, lo agradecerás.
La conclusión: si usas Opus 4.7 para trabajo en múltiples sesiones, deja que tome notas. Lo hará mejor que Opus 4.6, aunque ya nos parecía que 4.6 tomaba notas bastante decentes.
Anthropic nos asegura que Claude Opus 4.7 ha mejorado de forma significativa en estas áreas.
Creamos nuestras propias pruebas para poner a examen estas afirmaciones.
Para evaluar el seguimiento de instrucciones de Opus 4.7, usamos el siguiente prompt detallado para forzarlo al máximo. Tiene 12 restricciones distintas que podemos comprobar al final.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Y este fue el resultado:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Ahora toca puntuarlo. Aquí va nuestra rúbrica:
|
# |
Restricción |
Cómo comprobar |
|
1 |
Exactamente 4 párrafos (más la línea de cierre) |
Contar saltos de párrafo |
|
2 |
El párrafo 2 empieza con "Historically" |
Mirar la primera palabra |
|
3 |
Cada párrafo tiene 3–5 frases |
Contar frases por párrafo |
|
4 |
Sin palabras prohibidas |
Ctrl+F para cada una |
|
5 |
Exactamente 2 citas, ambas atribuidas; sin más material entrecomillado |
Contar comillas |
|
6 |
Un apellido de socio empieza por M |
Revisar atribuciones |
|
7 |
Línea final separada por un espacio en blanco |
Comprobación visual |
|
8 |
La línea final es una pregunta |
Termina en "?" |
|
9 |
Ortografía británica |
Ctrl+F para "organization", "color", "realize", etc. |
|
10 |
Sin viñetas, números ni encabezados |
Comprobación visual |
|
11 |
Cliente ficticio mencionado una vez y en cursiva |
Ctrl+F para asteriscos |
|
12 |
Recuento de 280–320 palabras |
Pegar en un contador |
Te ahorramos el repaso. El modelo sacó un 11/12.
Lo había hecho perfecto hasta el final, pero se pasó muy ligeramente del límite de palabras (325 frente a 320 máximo).
Aplicamos la misma prueba a Claude Sonnet 4.6 y también cumplió 11/12 instrucciones, fallando en lo mismo (recuento de palabras). Aun así, consideramos que Opus 4.7 mejora a Sonnet 4.6 porque este último se pasó mucho más (400 palabras).
Para la segunda prueba, le pasamos a Opus 4.7 una imagen difícil de leer:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Junto a estas instrucciones, le pasamos a Opus 4.7 una captura degradada del gráfico de comercio de Escocia de 1786 de Playfair, tomada de nuestro artículo sobre ejemplos de visualización de datos.
Sabíamos que podíamos validar la salida porque teníamos una versión de mayor resolución en Wikipedia. Esta es la imagen que vio Opus 4.7:
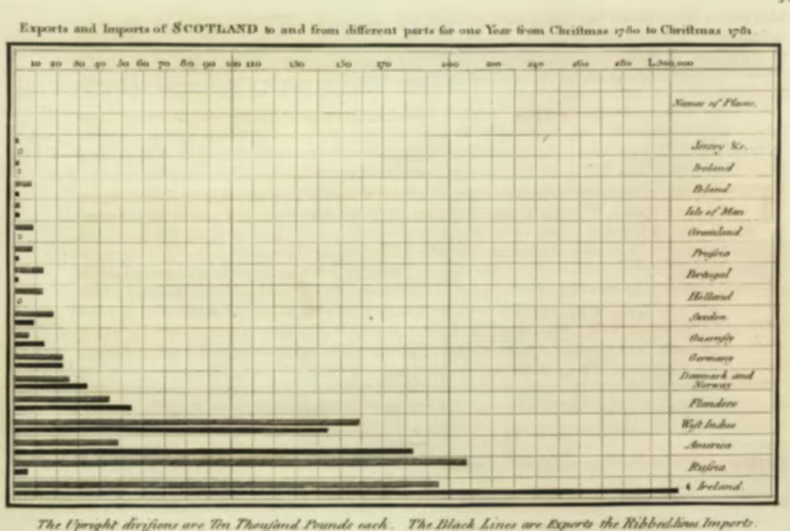
Esta fue la lectura de Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Sabíamos que esta prueba podía ser puñetera, ya que el eje x del gráfico de Playfair realmente cambia el conteo a mitad (de 10 en 10 hasta 110, luego decenas impares 130/150/170, y después pares 200/220/240/260/280). Aun así, Opus 4.7 leyó el eje correctamente a la primera pese a lo raro.
Algo que nos hizo gracia: está bien que los modelos de IA muestren su incertidumbre, pero "[?]oland" debería haberse leído con confianza como "Poland" y "Gr[oe]nland" como "Greenland". Aunque no teníamos una rúbrica oficial para esta, podemos darle justo un 9/10.
Opus 4.7 se evaluó en 14 benchmarks que cubren programación, razonamiento, uso de herramientas, uso de ordenador y razonamiento visual. La tabla de abajo muestra la comparación completa con Opus 4.6, GPT 5.4, Gemini 3.1 Pro y el aún no publicado Mythos Preview.
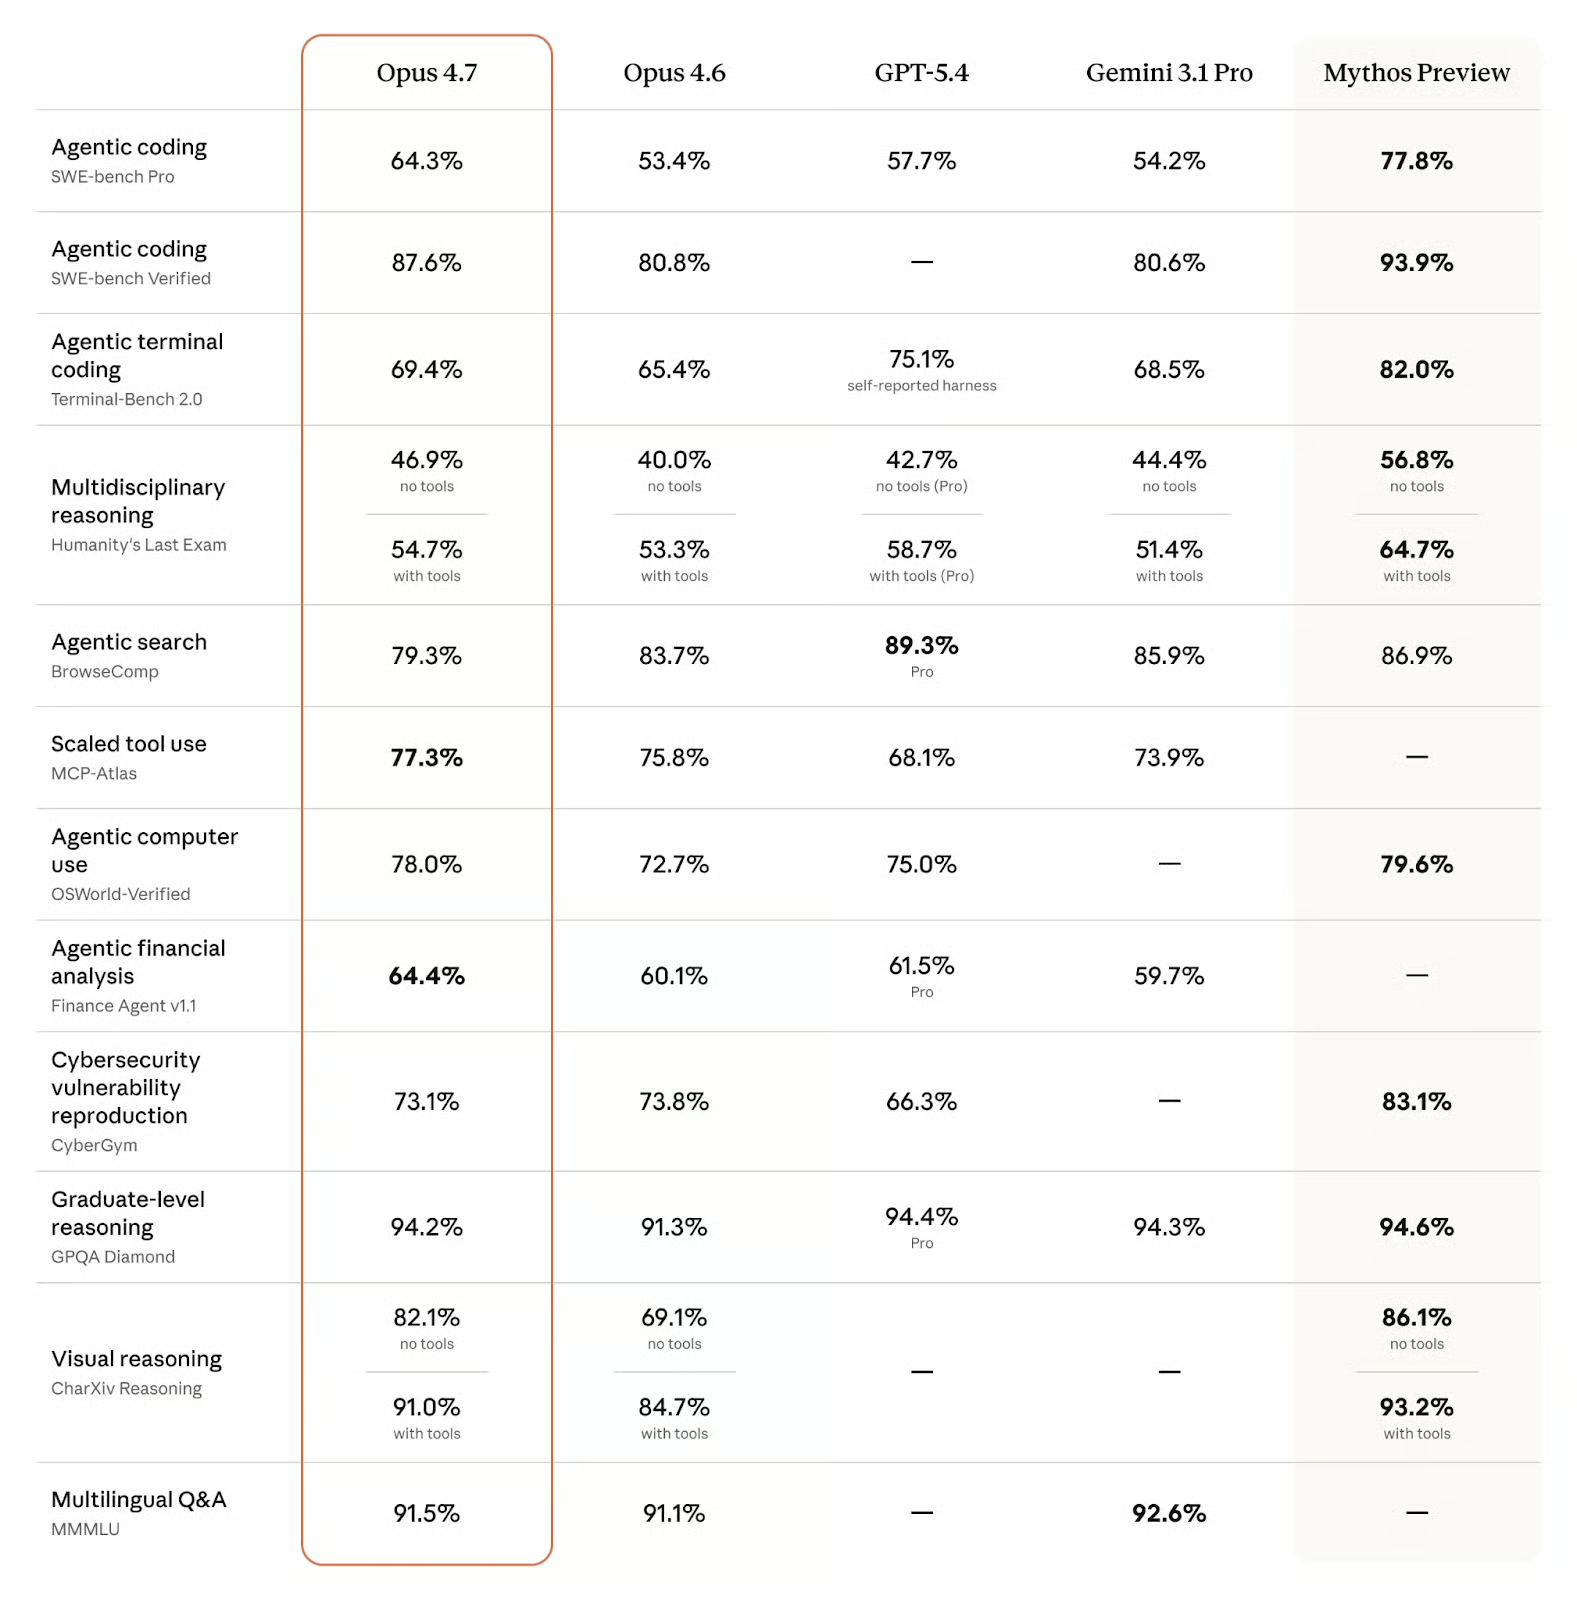
En SWE-bench Pro, Opus 4.7 logra un 64,3%, por delante de GPT-5.4 con 57,7%, Gemini 3.1 Pro con 54,2% y Opus 4.6 con 53,4%. En SWE-bench Verified, Opus 4.7 alcanza el 87,6% frente al 80,6% de Gemini 3.1 Pro y el 80,8% de Opus 4.6. GPT-5.4 no tiene puntuación publicada en SWE-bench Verified en esta comparación.
SWE-bench evalúa la capacidad de un modelo para resolver issues reales de GitHub en repositorios open source de Python. La versión Pro es más difícil y plantea problemas más complejos. La mejora de 10,9 puntos sobre Opus 4.6 en SWE-bench Pro es el mayor salto de esta versión (en puntos porcentuales) y sitúa a Opus 4.7 claramente por delante de ambos grandes competidores en esta tarea.
Solo el Mythos Preview interno de Anthropic alcanza un 77,8% en SWE-bench Pro y un 93,9% en SWE-bench Verified, lo que demuestra que aún hay margen por encima de Opus 4.7. Aun así, como Mythos no está disponible ampliamente, para uso en producción Opus 4.7 es el techo actual.
Los resultados en Terminal-Bench 2.0, el benchmark de referencia para programación agentiva en terminal, son interesantes. Opus 4.7 mejora ligeramente frente a su predecesor (69,4% vs. 65,4%) y supera a Gemini 3.1 Pro, que obtiene 68,5%.
Dicho esto, no puede competir con GPT-5.4 (75,1%) en este punto, aunque conviene tener en cuenta la salvedad auto-reportada del resultado de GPT-5.4 al comparar. Aun así, puede resultar decepcionante para Anthropic que su último modelo insignia (liberado) no lidere un benchmark tan central para el desarrollo de software agentivo.
Humanity's Last Exam es una colección de preguntas de nivel posgrado en ciencia, matemáticas y humanidades, diseñadas para ser difíciles para los modelos punteros actuales. Opus 4.7 lidera la variante sin herramientas, que evalúa el razonamiento puro sin recuperación externa. La diferencia a favor de GPT-5.4 (58,7%) con herramientas es el área más clara donde Opus 4.7 (54,7%) no lidera.
El razonamiento de nivel posgrado suele medirse con GPQA-Diamond, que hoy está bastante saturado: como el resto de modelos punteros, los cuatro comparados superan el 90% y están prácticamente empatados.
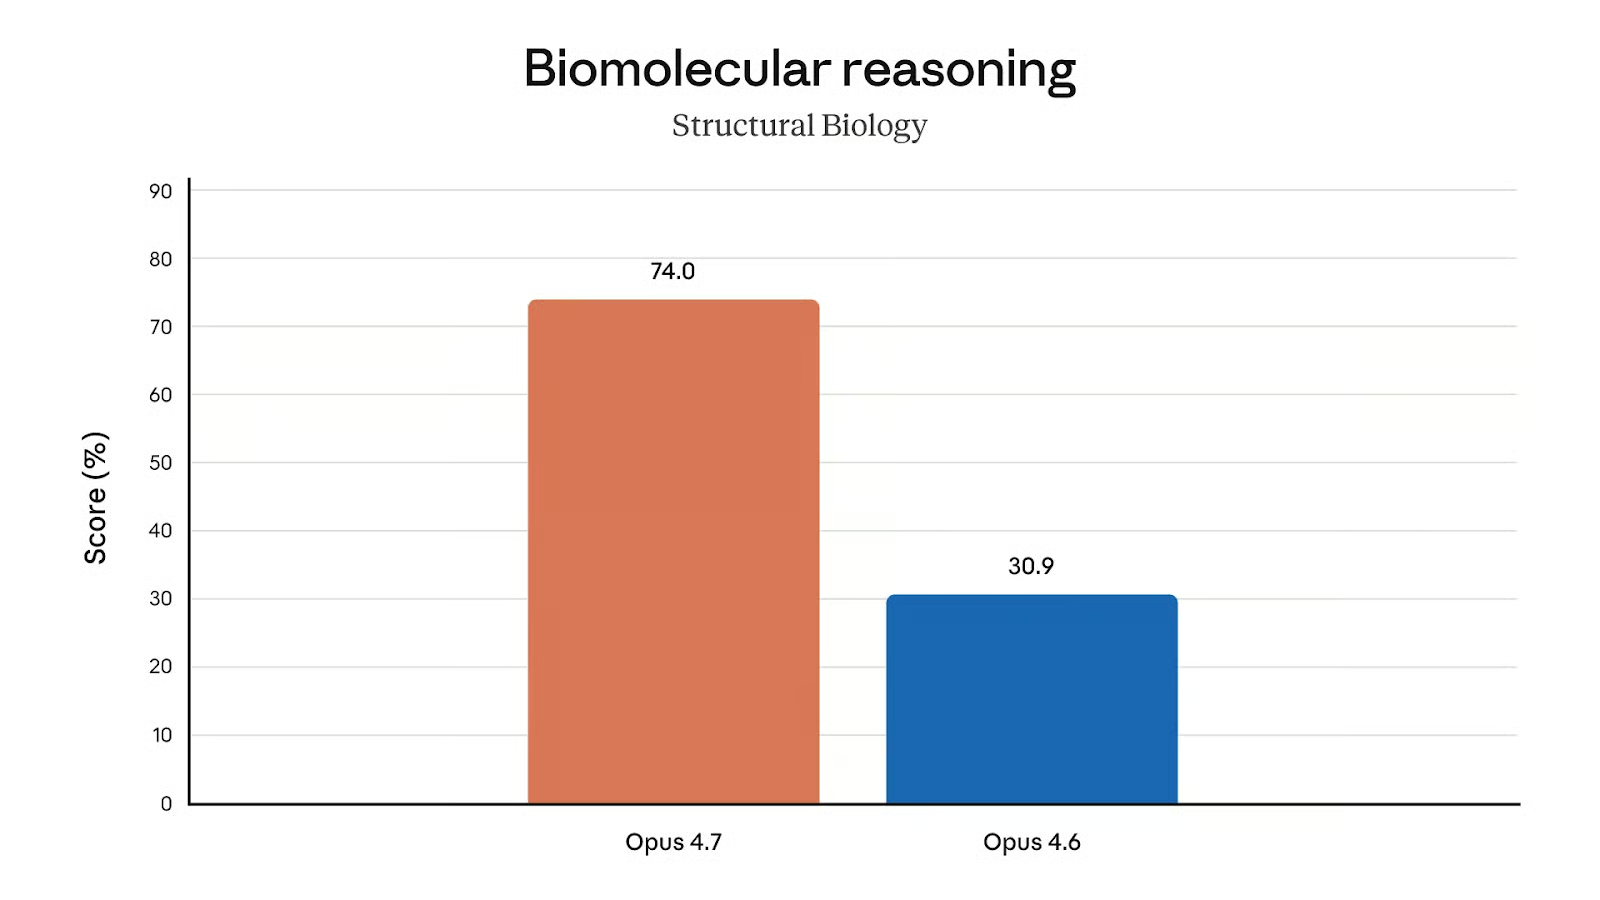
Un resultado más interesante apunta a biología, uno de los campos que también evalúa GPQA-Diamond. Aunque no podemos compararlo con los competidores, el salto entre Opus 4.6 (30,9%) y Opus 4.7 (74,0%) merece mención.
Los resultados en el benchmark CharXiv, que mide el razonamiento visual sobre gráficos y figuras científicas, confirman que esta fue una de las grandes áreas de foco en el desarrollo de Opus 4.7.
La mejora de 13 puntos sin herramientas es el mayor avance relativo de esta versión. Sin puntuaciones de competidores, es difícil ubicar a Opus 4.7 en el panorama general, pero la mejora frente a Opus 4.6 es notable.
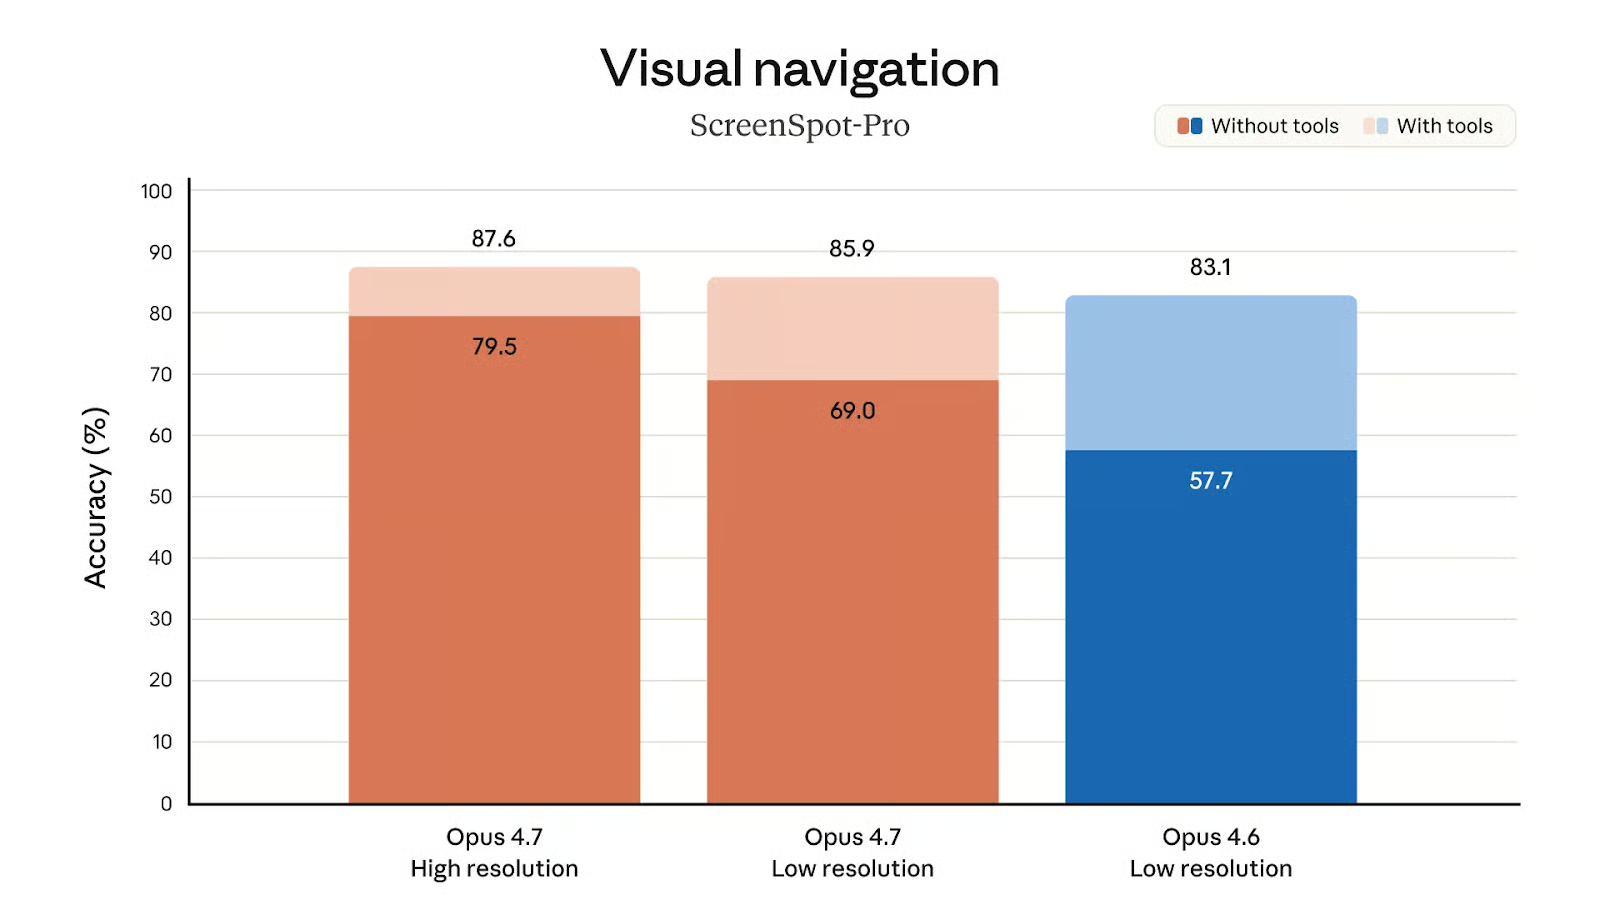
El soporte para imágenes de mayor resolución probablemente sea una de las razones del mejor razonamiento visual. El gráfico de puntuaciones en Screenspot-Pro a distintas resoluciones muestra el enorme salto de precisión que consigue Opus 4.7 con más resolución, especialmente sin herramientas (79,5% vs. 69,0%).
MCP-Atlas evalúa el rendimiento en flujos complejos con múltiples herramientas. Opus 4.7 marca un 77,3%, la puntuación más alta entre los modelos comparados. El único que supera ligeramente el resultado de Opus 4.7 es Muse Spark, con un 78,3%.
OSWorld mide la capacidad del modelo para completar tareas controlando una interfaz de ordenador: clics, escritura y navegación por aplicaciones. Opus 4.7 alcanza el 78,0%, frente al 72,7% de Opus 4.6. GPT-5.4 obtiene 75,0% y Gemini 3.1 Pro no tiene puntuación publicada. Mythos Preview llega al 79,6%, apenas por encima de Opus 4.7.
Este es, sin duda, un punto fuerte de Opus 4.7: lidera tanto MCP-Atlas como OSWorld-Verified con un margen significativo sobre los buques insignia de Google y OpenAI, una gran noticia para quienes construyen sistemas de agentes en producción que dependen de la orquestación de herramientas y agentes de uso de ordenador.
Las habilidades del modelo en análisis financiero merecen mención: Opus 4.7 encabeza el ranking de Finance Agent v1.1 (64,4%), por delante de GPT-5.4 (61,5%) y Gemini 3.1 Pro (59,7%).
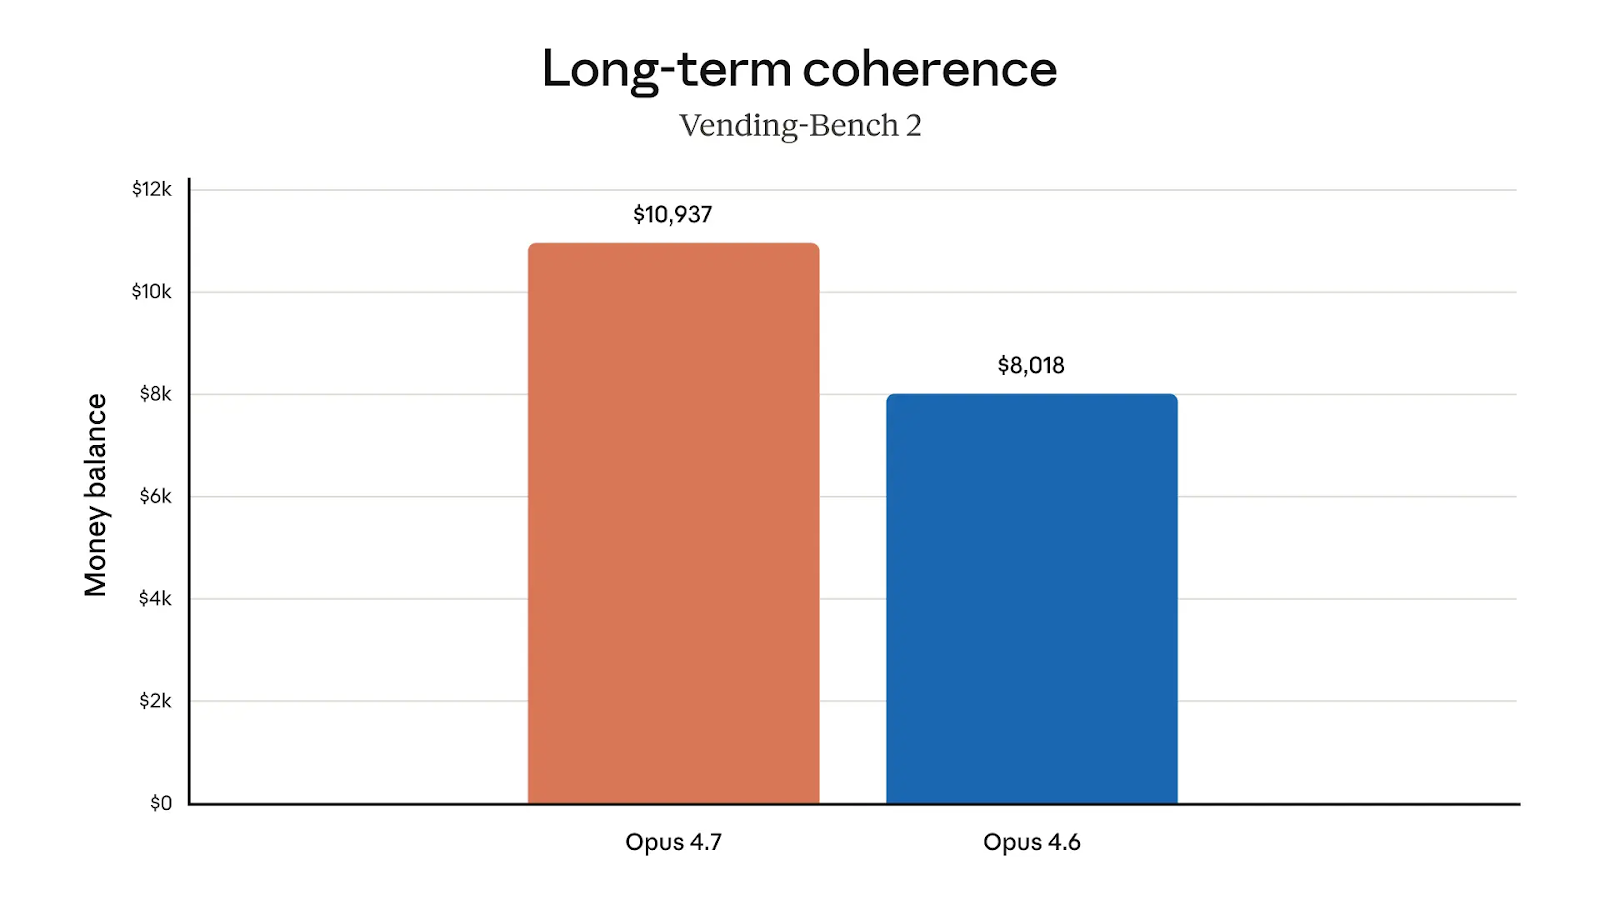
En el benchmark más práctico Vending-Bench 2, vemos que Opus 4.7 también maneja mejor el dinero. De media, el modelo terminó con 10.937 $, frente a 8.018 $ con Opus 4.6.
Anthropic no nos hace esperar. Opus 4.7 ya está disponible
En todos los productos Claude
En la API de Claude (claude-opus-4-7)
Vertex AI, y
Microsoft Foundry
Con los tiempos que corren, siempre preocupa la inflación. Por suerte, el precio es el mismo que en Opus 4.6: 5 $ por millón de tokens de entrada y 25 $ por millón de tokens de salida. (Tampoco hubo subida de precio entre Opus 4.6 y Opus 4.7.)
Como recordatorio general, si usas Opus en Claude.ai: cada mensaje que envías incluye toda la conversación hasta ese momento (tu nueva pregunta + todo el intercambio anterior) más la respuesta del modelo. Todo eso se mide en tokens. Tu plan, sea cual sea, tiene un presupuesto de tokens que se repone en una ventana continua.
Cada modelo consume ese presupuesto a un ritmo distinto. Opus es el más caro porque es el más potente. Relación publicada aproximada: Opus cuesta unas 5× más por token que Sonnet.
Anthropic ha incorporado varias novedades junto con el modelo que conviene conocer, sobre todo si usas Claude Code o construyes sobre la API.
Un nuevo nivel de esfuerzo xhigh ("extra alto") se sitúa ahora entre high y max. Te da una opción adicional al elegir entre profundidad de razonamiento y latencia. En Claude Code, el nivel de esfuerzo por defecto ha pasado a ser xhigh en todos los planes, y Anthropic recomienda empezar con high o xhigh al probar Opus 4.7 en tareas de programación y agentes.
Claude Code incorpora el nuevo comando de barra /ultrareview, que ejecuta una revisión dedicada de tus cambios y señala bugs o problemas de diseño que detectaría una revisión humana cuidadosa. Los usuarios Pro y Max obtienen tres ultrareviews gratis para probarlo.
Los usuarios Max ya tienen acceso al modo auto, un ajuste de permisos en el que Claude toma decisiones por ti. Es un punto intermedio entre aprobar cada paso y omitir permisos por completo.
Los presupuestos de tarea entran en beta pública en la API de Claude. Permiten a los desarrolladores limitar el gasto de tokens de Claude a lo largo de una ejecución, especialmente útil para flujos de agente largos en los que prefieres que el modelo dosifique en lugar de quemar su presupuesto.
Analizamos de cerca los resultados de los benchmarks, incluidos los comparativos con otros modelos. A alto nivel, comparemos directamente Opus 4.7 con GPT-5.4.
La idea clave: Opus 4.7 está optimizado para autonomía en horizontes largos. GPT-5.4 es un modelo unificado de propósito general con soporte de herramientas más amplio y precios más bajos en contextos cortos.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Mejor en | Ejecuciones largas de código, uso de ordenador de escritorio, visión densa |
Investigación en navegador, tareas de contexto corto, dirección a mitad de respuesta |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Precios | Tarifa plana hasta 1M de contexto | Más barato por debajo de 272K; re-precio de sesión completa por encima |
| Ventana de contexto | ~1M tokens | ~1M tokens |
Para la comparación completa con el modelo sucesor de OpenAI, GPT-5.5, consulta nuestro post Claude Opus 4.7 vs. GPT-5.5.
Algunos usuarios informan de que sus pipelines se desajustan porque Opus 4.7 sigue las instrucciones más literalmente que antes. Anthropic advirtió de la necesidad de retocar los prompts.
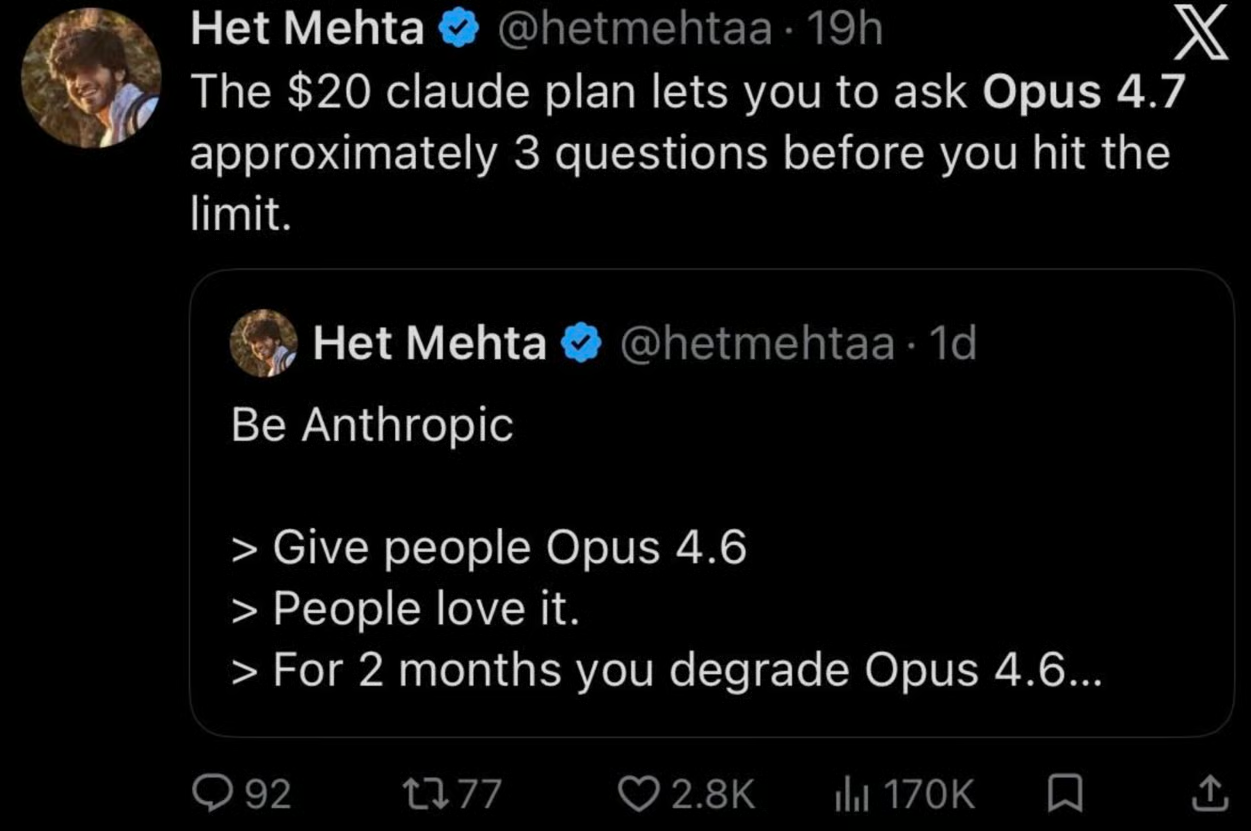
Otros usuarios están preocupados por el uso de tokens. Como parte del lanzamiento, Anthropic elevó los límites de tasa para todas las cuentas para compensar el mayor consumo de tokens, aunque no está del todo claro si compensa por completo.
Claude Opus 4.7 es el modelo más capaz que la mayoría puede usar hoy. Las mejoras apuntan todas en la misma dirección: trabajos de agentes más largos y con menos supervisión, con mejor programación, visión más nítida y mejor memoria entre sesiones como soporte.
Lo que hace interesante este lanzamiento es el encuadre de Mythos. Opus 4.7 es un vehículo de pruebas con límites cibernéticos camino hacia un lanzamiento más amplio de clase Mythos, lo que implica un techo claro por encima al que no puedes acceder —pero también que las salvaguardas que llegan con 4.7 adelantan cómo planea Anthropic gestionar lanzamientos punteros en el futuro.
Aprende con DataCamp
{count, plural, one {Programa} other {Programas}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {Curso} other {Cursos}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
9 min
{count, plural, one {blog} other {blogs}}
Josep Ferrer
8 min
{count, plural, one {blog} other {blogs}}
Matt Crabtree
12 min
{count, plural, one {Tutorial} other {Tutoriales}}
Dimitri Didmanidze
8 min
{count, plural, one {Tutorial} other {Tutoriales}}
Moez Ali
11 min
{count, plural, one {Tutorial} other {Tutoriales}}
Arunn Thevapalan
12 min