
Curso
Introducción a Git
2 h
96.9K
Estás trabajando en una rama de funcionalidad cuando un compañero te pide que revises su pull request. Podrías hacer stash de tus cambios, cambiar de rama y confiar en que recordarás por dónde ibas. O podrías hacer un commit a medias solo para no perder el trabajo. Luego llega el hotfix de emergencia: producción está caída y tú estás metido en una refactorización que toca medio repositorio. Cada cambio de contexto como este te cuesta 10–15 minutos de puesta a punto y te corta el flujo.
Git worktree lo resuelve permitiéndote tener varias ramas a la vez en directorios separados. En lugar de hacer stash o confirmar trabajo incompleto, simplemente haces cd a otro directorio donde ya está esa rama. Trabaja en el hotfix, despliega y luego vuelve con cd a tu funcionalidad justo como la dejaste.
En este tutorial, te enseñaré a crear y gestionar worktrees, evitar errores comunes e integrarlos en tu flujo de trabajo diario. Ya deberías entender las ramas de Git, los commits y las operaciones básicas en la línea de comandos. Si necesitas repasar los fundamentos de Git primero, te recomiendo el tutorial Introduction to Git de DataCamp para cubrir lo esencial.
Git worktree es una función integrada que crea directorios de trabajo adicionales enlazados al mismo repositorio. Tu directorio de trabajo principal es el worktree primario, y cada worktree adicional que crees tiene su propio directorio con su propia rama marcada. Todos estos worktrees se conectan al mismo repositorio .git.
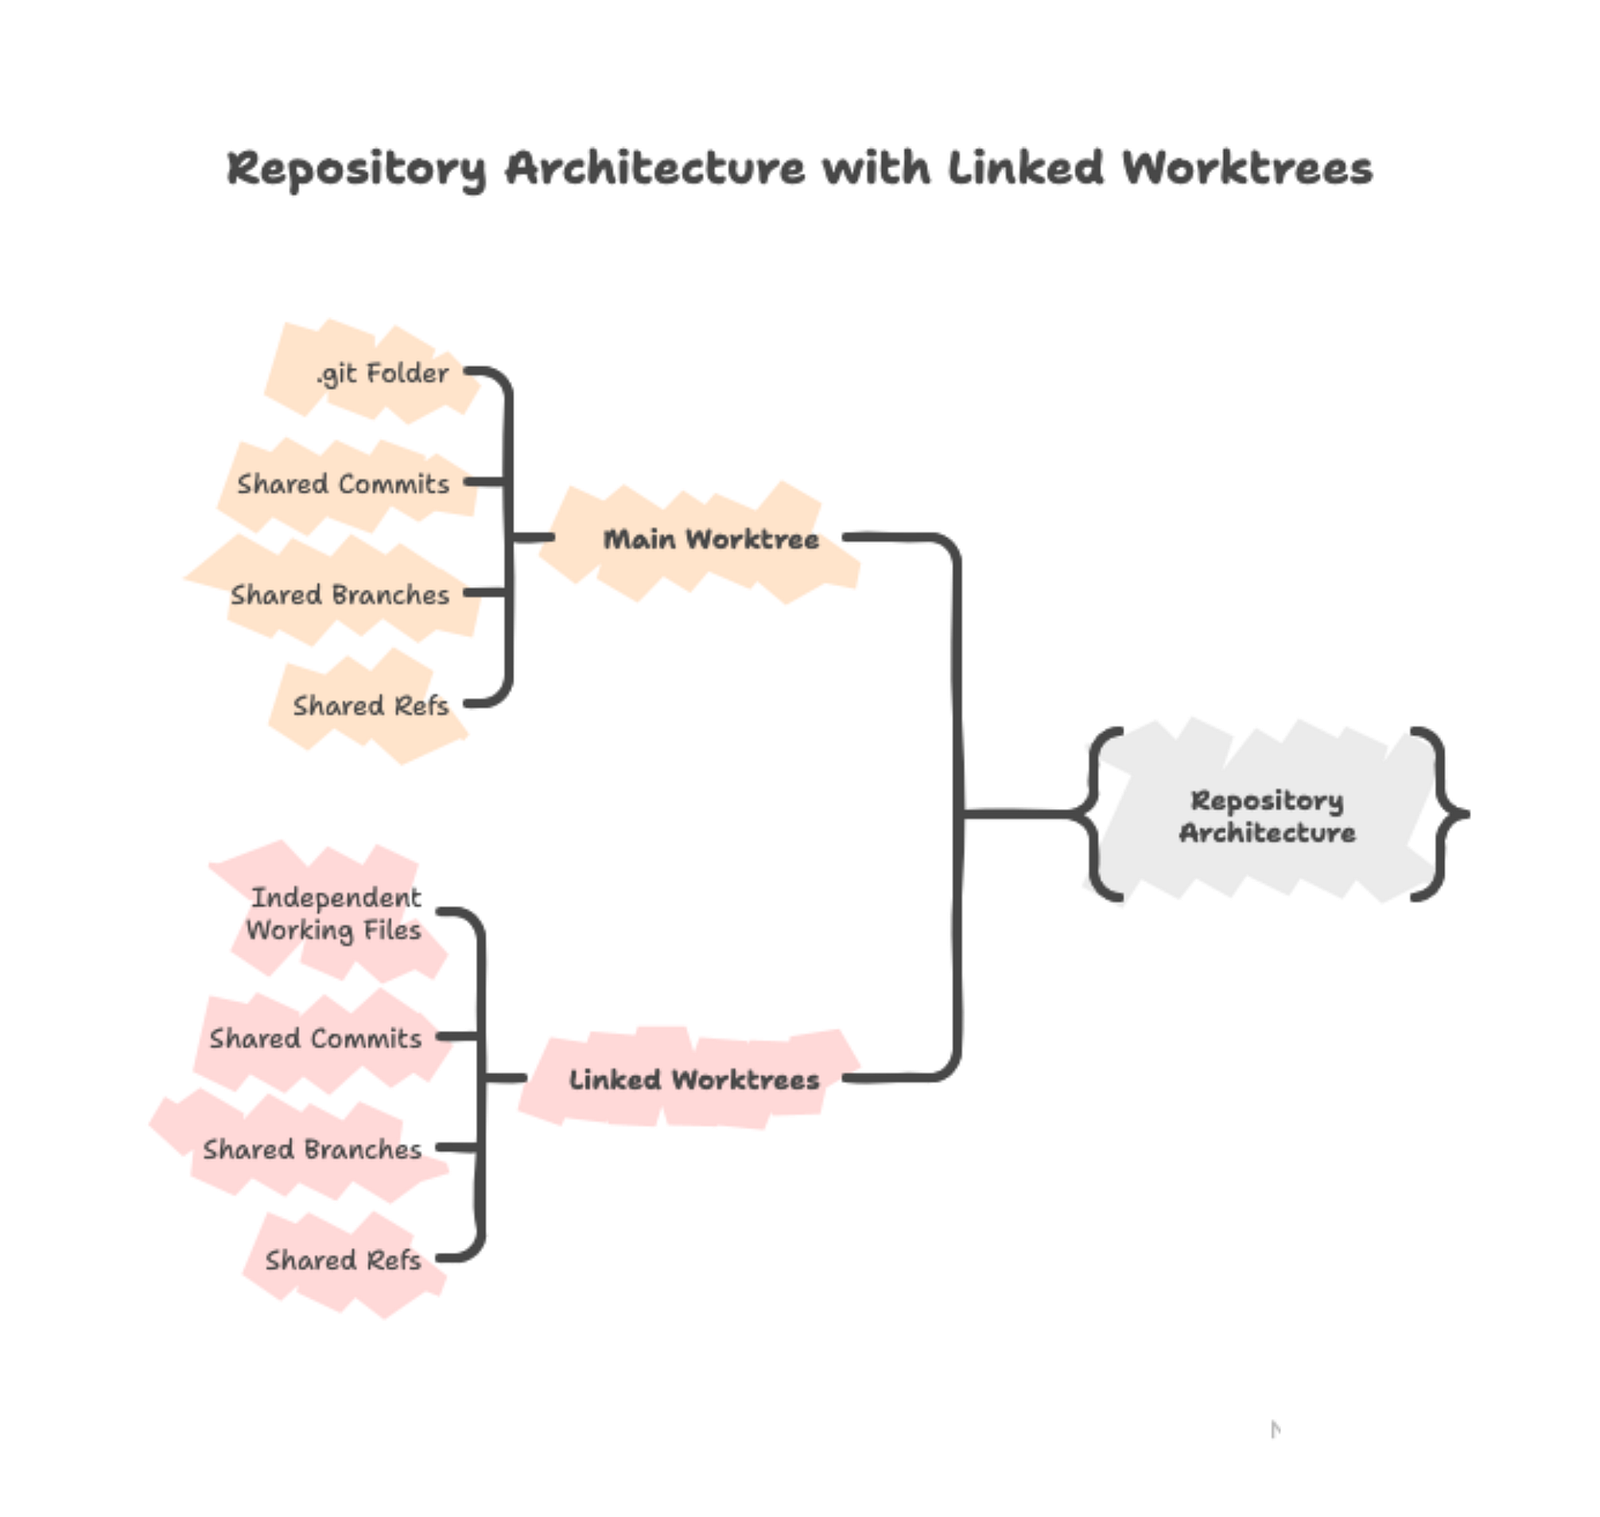
Esta arquitectura compartida implica que los commits que hagas en cualquier worktree aparecen de inmediato en la base de datos compartida de Git, accesibles desde los demás worktrees. Los archivos en sí permanecen independientes: editar train.py en un worktree solo afecta a ese directorio hasta que confirmes los cambios.
No puedes abrir varias terminales en el mismo directorio y trabajar en ramas distintas a la vez. Git solo permite una rama marcada por directorio. Cuando ejecutas git checkout feature-b en una terminal, cambia los archivos para todas las terminales que apuntan a ese directorio.
Git worktree lo soluciona dando a cada rama su propio directorio. Cada directorio es totalmente independiente con sus propios archivos, procesos en ejecución y artefactos de build. Cambiar entre ramas pasa a ser cd ../different-directory en lugar de git checkout different-branch.
Antes de usar git worktree, verifica tu configuración:
git --version para comprobarlo. Git worktree llegó en 2015, así que la mayoría de instalaciones lo incluyenComprueba que worktree está disponible:
git worktree --helpSi se muestra la página de ayuda, estás listo.
Git worktree va genial cuando cambiar de rama interrumpiría tu trabajo actual:
Sáltalo para tareas rápidas de menos de 10 minutos donde git checkout es más simple, o cuando te centras en una sola cosa y no esperas interrupciones.
La mejor forma de entender git worktree es crear uno y verlo en acción. Veremos los comandos básicos, exploraremos la estructura que crea Git y observaremos cómo fluyen los cambios entre worktrees.
Antes de lanzarte con los worktrees, necesitas un repositorio Git. Si ya tienes un proyecto en Python con varias ramas, salta a la siguiente sección. Si no, montemos rápido un pipeline de ML sencillo:
mkdir ml-pipeline
cd ml-pipeline
git init
Crea un README y un script de Python:
echo "# ML Pipeline" > README.md
echo "def load_data():" > train.py
echo "    print('Loading training data...')" >> train.py
Verifica que se han creado los archivos:
ls
# You should see: README.md  train.py
Confirma estos archivos y crea una rama de funcionalidad:
git add .
git commit -m "Initial commit"
git branch feature-preprocessing
Ahora tienes un repositorio con dos ramas: main (tu rama actual) y feature-preprocessing.
Crear un worktree para una rama existente requiere un solo comando. Marquemos feature-preprocessing en un directorio aparte:
git worktree add ../ml-pipeline-preprocessing feature-preprocessingEsto crea un nuevo directorio llamado ml-pipeline-preprocessing un nivel por encima de tu ubicación actual, marca allí la rama feature-preprocessing y lo enlaza a tu repositorio existente.
Git confirma la creación:
Preparing worktree (checking out 'feature-preprocessing')
HEAD is now at 0a7f986 Initial commit
Para trabajo totalmente nuevo, crea a la vez la rama y el worktree:
git worktree add -b feature-visualization ../ml-pipeline-vizLa opción -b crea una rama nueva llamada feature-visualization y la marca en el nuevo worktree.
Con el worktree creado, ahora tienes varios directorios en tu sistema de archivos. Para verlos todos:
git worktree list/Users/you/projects/ml-pipeline 0a7f986 [main]
/Users/you/projects/ml-pipeline-preprocessing 0a7f986 [feature-preprocessing]La primera línea muestra tu worktree principal —el directorio original que contiene la carpeta .git—. La segunda línea muestra tu worktree enlazado. Ambas muestran el hash del commit actual y la rama marcada.
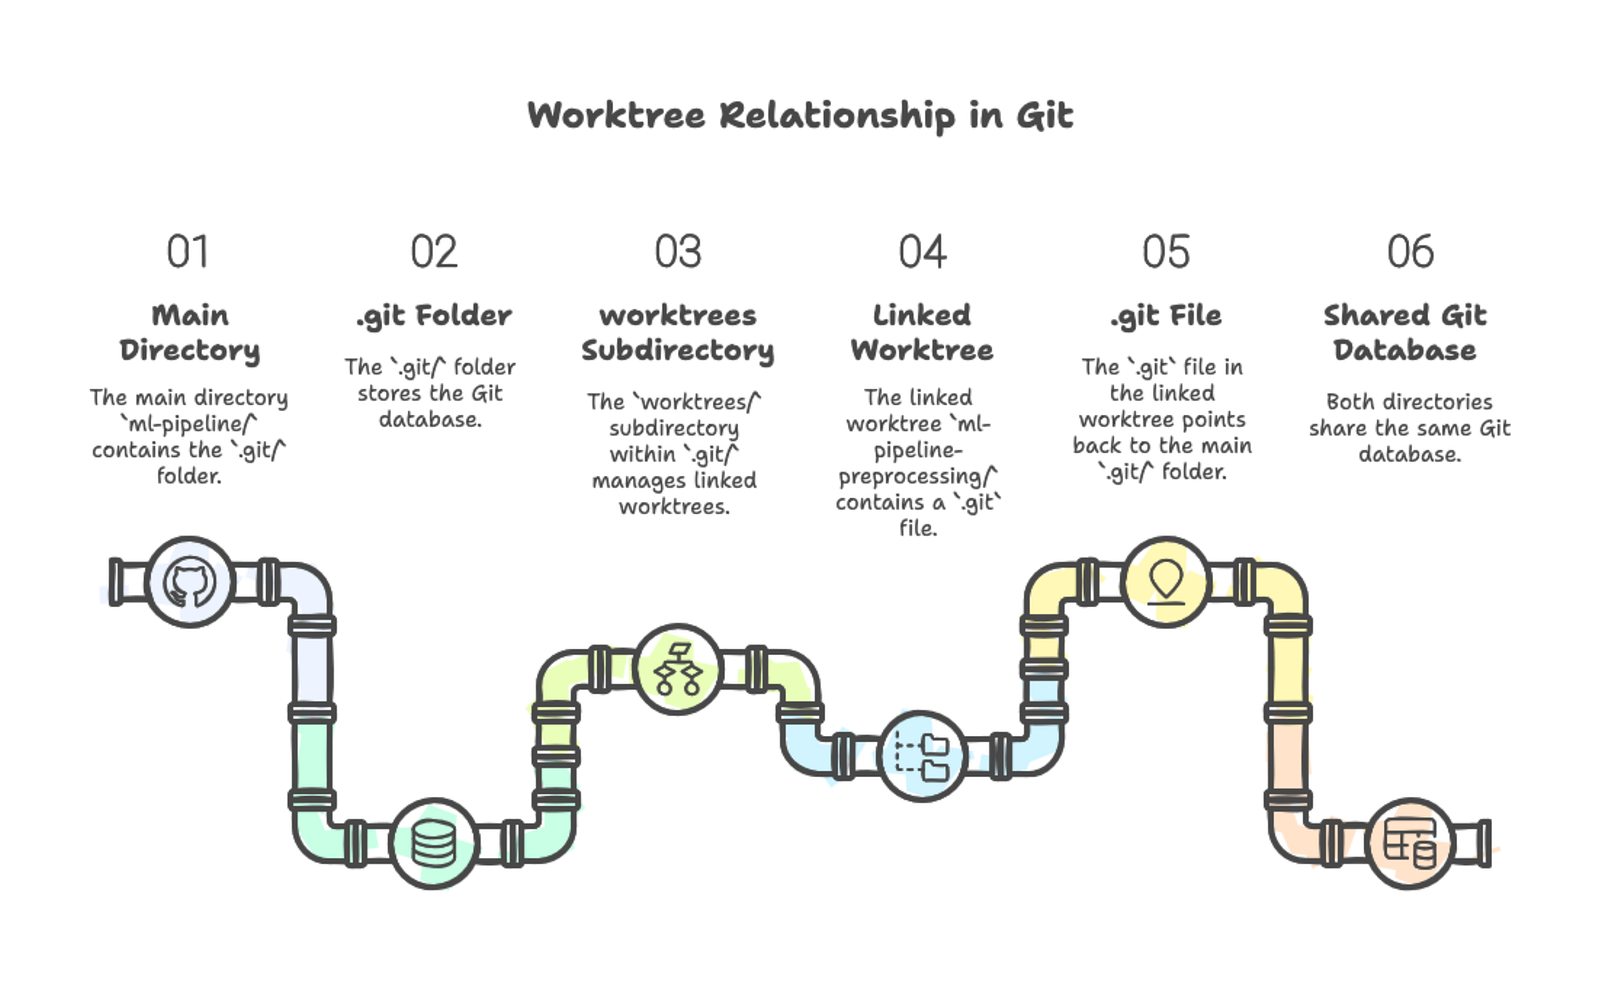
Cada directorio de worktree funciona como un repositorio Git completo. Puedes entrar, editar archivos, ejecutar git status y hacer commits. Los worktrees enlazados no contienen un directorio .git completo, sino un archivo .git que apunta al repositorio principal. Dentro del .git principal, una carpeta worktrees almacena metadatos de cada worktree enlazado.
Ve al worktree de feature-preprocessing y haz un commit:
cd ../ml-pipeline-preprocessing
cat >> train.py << 'EOF'

def preprocess_features(df):
   """Normalize numeric features."""
   return (df - df.mean()) / df.std()
EOF
git add train.py
git commit -m "Add feature preprocessing function"
El commit se realiza con normalidad:
[feature-preprocessing 7c8d4e2] Add feature preprocessing function
1 file changed, 3 insertions(+)
Vuelve a tu worktree principal y revisa el historial:
cd ../ml-pipeline
git log --oneline --all
Aparece tu nuevo commit:
7c8d4e2 Add feature preprocessing function
0a7f986 Initial commit
Fíjate en cómo el commit aparece de inmediato en ambas ubicaciones sin comandos adicionales.
Ahora que ya sabes crear y trabajar con worktrees, veamos escenarios prácticos donde resuelven problemas reales de desarrollo.
Tu compañero necesita feedback en su PR. En lugar de hacer stash y cambiar de rama, crea un directorio aparte para la revisión:
git worktree add ../ml-pipeline-review pr/update-training
cd ../ml-pipeline-review
pip install -r requirements.txt
python train_model.py --config experiments/baseline.yaml
Prueba los cambios y deja tus comentarios. Cuando termines:
cd ../ml-pipeline
git worktree remove ../ml-pipeline-review
Tu trabajo original permanece intacto. Sin stashes ni cambios de contexto. Para más estrategias de revisiones efectivas, echa un vistazo a la guía de buenas prácticas de código de DataCamp.
Sin worktrees:
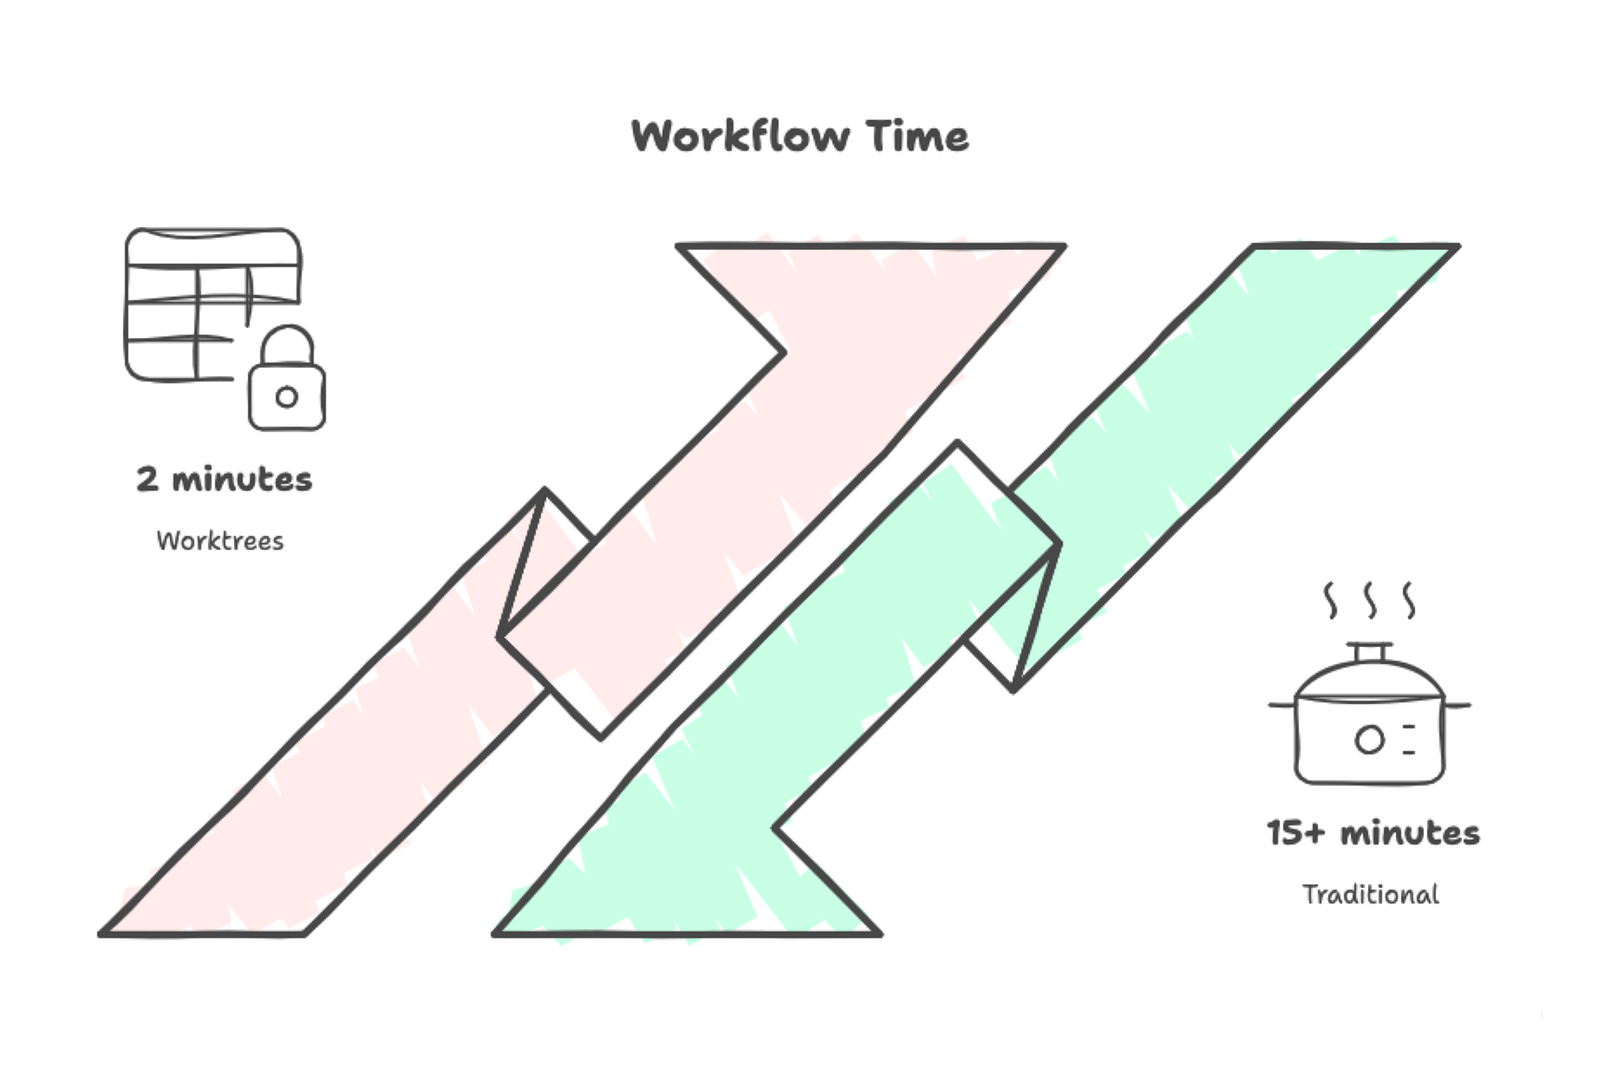
Con worktrees:
git worktree add ../ml-pipeline-hotfix main
cd ../ml-pipeline-hotfix
Corrige y despliega:
git add src/data/validation.py
git commit -m "Fix schema validation for nullable timestamp fields"
git push origin main
cd ../ml-pipeline
git worktree remove ../ml-pipeline-hotfix
En segundos vuelves a tu refactorización, con todos los archivos exactamente como los dejaste.
Estás implementando métricas personalizadas y un nuevo data loader: dos funcionalidades independientes. Crea un worktree para cada una:
git worktree add -b feature-custom-metrics ../ml-pipeline-metrics
git worktree add -b feature-streaming-loader ../ml-pipeline-loader
Tu sistema de archivos ahora se ve así:
~/projects/
 ml-pipeline/           [main] - tu trabajo habitual
 ml-pipeline-metrics/   [feature-custom-metrics]
 ml-pipeline-loader/    [feature-streaming-loader]
Ejecuta ambas funcionalidades en paralelo, cada una en su terminal:
# Terminal 1
cd ~/projects/ml-pipeline-metrics
python experiments/evaluate_custom_metrics.py

# Terminal 2
cd ~/projects/ml-pipeline-loader
pytest tests/test_data_loader.py -v
Ambos procesos se ejecutan a la vez sin conflictos. Cuando una funcionalidad esté lista, fusiónala y elimina el worktree:
cd ~/projects/ml-pipeline
git merge feature-custom-metrics
git worktree remove ../ml-pipeline-metrics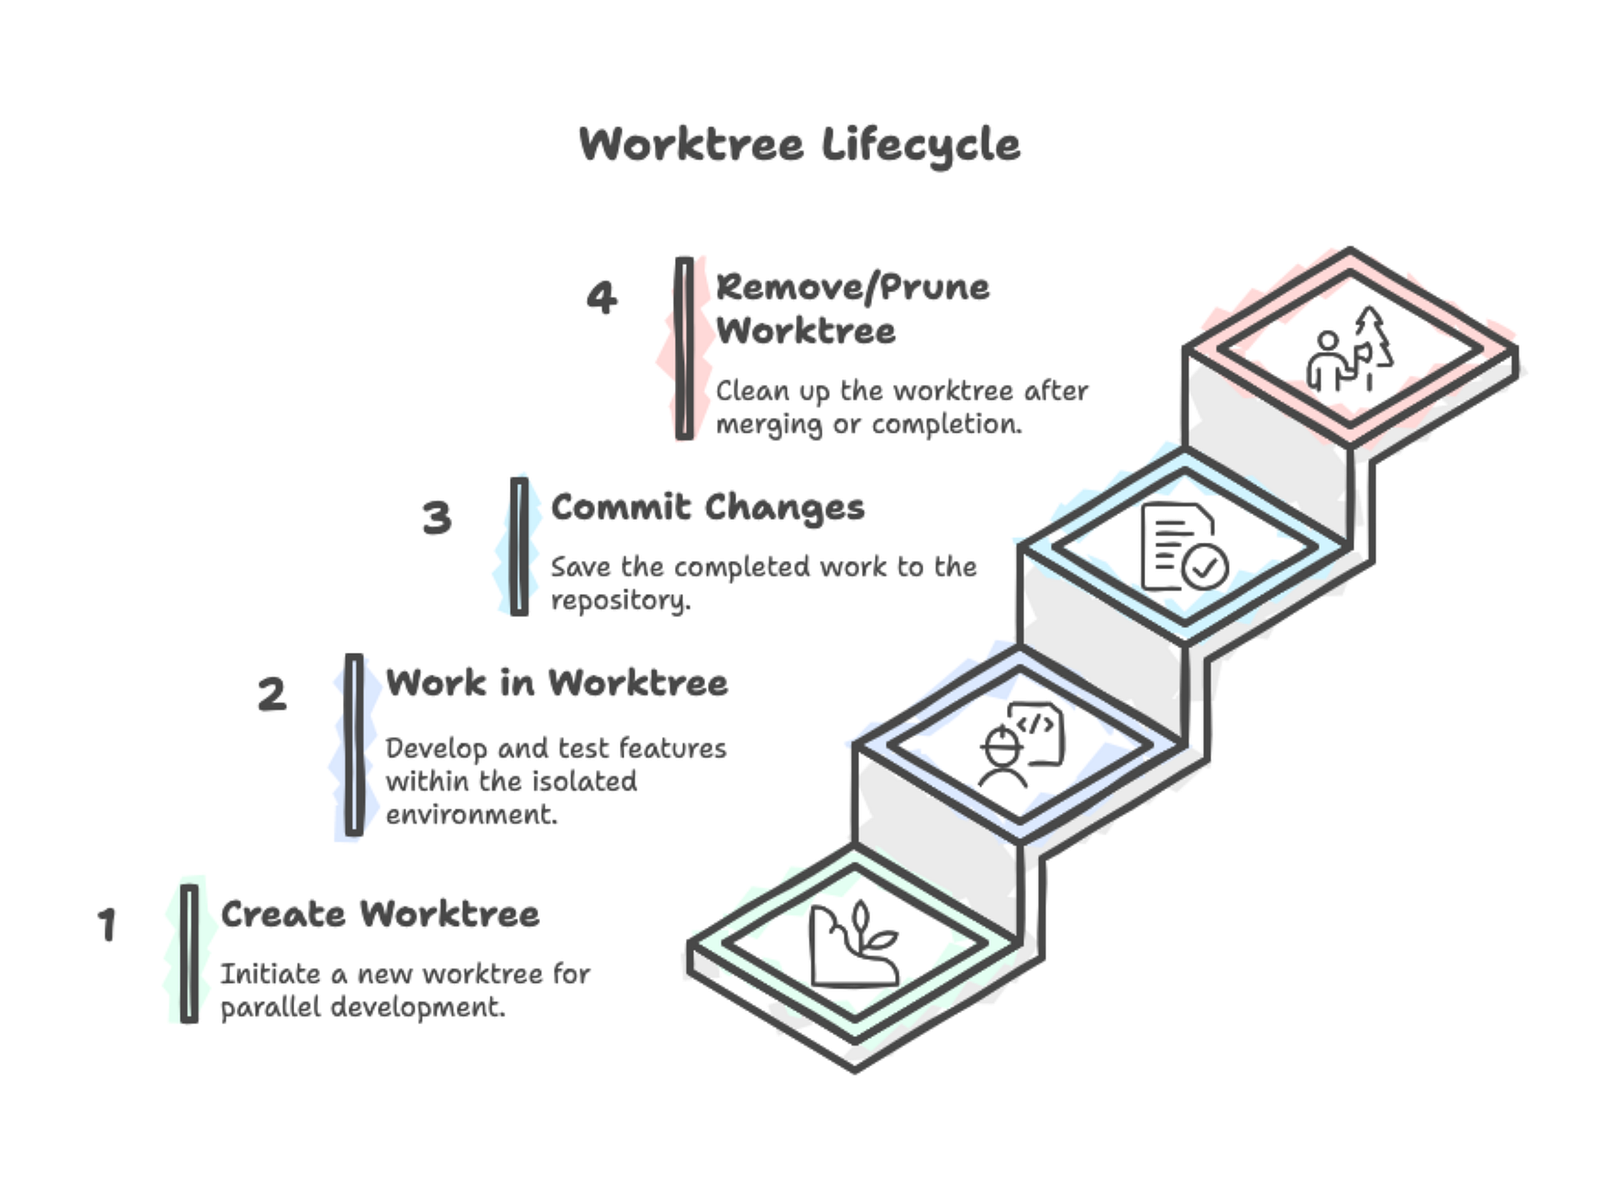
Para ver todos los worktrees de un repositorio:
git worktree list/Users/you/projects/ml-pipeline a3f9c81 [main]
/Users/you/projects/ml-pipeline-review b7d4e92 [pr/data-validation]
/Users/you/projects/ml-pipeline-hotfix a3f9c81 [hotfix/schema-bug]Cada línea muestra la ruta del directorio, el hash del commit actual y la rama marcada. La primera entrada es siempre tu worktree principal (que contiene la carpeta .git) y el resto son worktrees enlazados.
Para scripting o navegación rápida, extrae solo las rutas:
git worktree list | awk '{print $1}'Cuando termines de usar un worktree, elimínalo correctamente:
cd ~/projects/ml-pipeline
git worktree remove ../ml-pipeline-review
Git protege contra la pérdida de datos. Si tienes cambios sin confirmar:
git worktree remove ../ml-pipeline-reviewfatal: '../ml-pipeline-review' contains modified or untracked files, use --force to delete itFuerza la eliminación si estás seguro:
git worktree remove --force ../ml-pipeline-reviewSi un worktree está bloqueado, usa --force dos veces:
git worktree remove --force --force ../ml-pipeline-lockedSi borraste un worktree a mano (rm -rf o desde el explorador), Git lo seguirá rastreando internamente. Limpia las referencias obsoletas:
git worktree prunePrevisualiza qué se va a limpiar:
git worktree prune --dry-runVeamos cómo sacarle el máximo partido a los worktrees y cómo evitar errores habituales.
Dónde colocas los worktrees importa. La mayoría los pone como directorios hermanos del repositorio principal:
~/projects/
 ml-pipeline/                    # worktree principal
 ml-pipeline-feature-auth/       # worktree enlazado
 ml-pipeline-hotfix-login/       # worktree enlazado
Esta estructura mantiene todo junto y hace que las rutas sean previsibles. El patrón nombreproyecto-nombrerama te dice exactamente qué hay en cada directorio.
Algunos prefieren una carpeta dedicada:
~/projects/
 ml-pipeline/                    # worktree principal
 ml-pipeline-worktrees/
   feature-auth/
   hotfix-login/
Elige un enfoque y úsalo de forma consistente. Nombres descriptivos como ml-pipeline-user-authentication hacen que los directorios se expliquen solos, mientras que nombres genéricos como ml-pipeline-temp o ml-pipeline-2 te obligan a mirar dentro. Trata los worktrees como temporales: créalos para una tarea concreta y elimínalos al terminar.
Git impide marcar la misma rama en dos worktrees:
git worktree add ../ml-pipeline-duplicate mainfatal: 'main' is already used by worktree at '/Users/you/projects/ml-pipeline'Esta protección existe porque podrías hacer commits en conflicto. Si necesitas el mismo código en dos sitios, crea una rama nueva.
Cada worktree permanece en tu disco hasta que lo eliminas explícitamente. Los worktrees viejos se acumulan; hay proyectos con 15 o más worktrees olvidados que consumen gigas.
Cada worktree contiene una copia completa de los archivos del repositorio. Un repositorio de 500 MB con 5 worktrees ocupa 2,5 GB. Elimina worktrees cuando acabes:
git worktree list
git worktree remove ../ml-pipeline-old-featureNo crees un worktree dentro del directorio de otro worktree. Git lo permite, pero genera estructuras confusas y complica la limpieza.
Los alias de shell ahorran tiempo si creas worktrees a menudo:
alias gwl='git worktree list'
alias gwa='git worktree add'
alias gwr='git worktree remove'
Para configuraciones más complejas, escribe una función que cree un worktree y configure tu entorno de desarrollo en un paso:
wt() {
 git worktree add "../${PWD##*/}-$1" -b "$1"
 cd "../${PWD##*/}-$1"
 python -m venv .venv && source .venv/bin/activate && pip install -r requirements.txt
}
La variable ${PWD##*/} extrae el nombre de tu directorio actual. Al ejecutar wt feature-logging desde ml-pipeline se crea ml-pipeline-feature-logging, entras en él y se configura un entorno virtual de Python con dependencias.
Crear un worktree pasa a ser un solo comando:
wt feature-custom-metricsAdáptalo a tu lenguaje: sustituye la configuración de Python por bundle install en Ruby, cargo build en Rust o npm install en Node.js.
Tu editor o IDE funciona con worktrees sin configuración especial. Cada worktree es solo un directorio, así que ábrelo como cualquier proyecto. La mayoría de editores modernos permiten abrir varias raíces a la vez: puedes tener tres worktrees en una ventana y cambiar entre ellos desde la barra lateral.
Si usas asistentes de programación con IA, los worktrees desbloquean un potente flujo de trabajo en paralelo. Este enfoque ha ganado tracción entre desarrolladores y equipos en 2024–2025.
Crea worktrees separados para tareas distintas:
git worktree add -b feature-add-logging ../ml-pipeline-logging
git worktree add -b feature-optimize-preprocessing ../ml-pipeline-optim
git worktree add -b bugfix-memory-leak ../ml-pipeline-bugfix
Abre un panel de terminal para cada worktree y lanza tu asistente de IA:
# Pane 1
cd ~/projects/ml-pipeline-logging
claude

# Pane 2
cd ~/projects/ml-pipeline-optim
claude

# Pane 3
cd ~/projects/ml-pipeline-bugfix
claude
Cada instancia de IA trabaja en una funcionalidad distinta sin interferencias. Hay equipos que informan de completar trabajo en horas que antes llevaba días. Por ejemplo, incident.io ejecuta 4–5 agentes de Claude Code en paralelo usando este patrón. En un caso, Claude estimó una mejora de UI en 2 horas y la acabó en 10 minutos.
Aspectos a tener en cuenta:
Funciona bien para funcionalidades grandes e independientes (30+ minutos cada una) donde el trabajo no toca los mismos archivos y tienes cuota de API suficiente. Evítalo para bugs rápidos, funcionalidades muy acopladas o cuando estés cerca de los límites de la API.
Recuerda el escenario del principio: un compañero necesita una revisión de PR mientras tú estás a mitad de una funcionalidad. Ya sabes la solución: git worktree add ../ml-pipeline-review pr/branch-name y luego cd para empezar a revisar. Tu trabajo de funcionalidad se mantiene intacto. Sin stash, sin commits a medias, sin sobrecarga mental para reconstruir el contexto al volver. Dos directorios, dos ramas, cero fricción.
Git worktree no añade complejidad a tu flujo: la elimina. Cada worktree es solo un directorio con una rama marcada. Pero esa sencillez desbloquea algo potente: la capacidad de cambiar de contexto al instante sin la carga cognitiva de hacer stash, cambiar de rama y reconstruir tu modelo mental.
Cuando necesites integrar worktrees con la colaboración en equipo —como pull requests y revisiones de código—, el itinerario de habilidades GitHub Foundations de DataCamp cubre las prácticas esenciales para trabajar eficazmente con equipos distribuidos.
Los mejores cursos de Git
Curso
Curso
Curso