programa
Desarrollar grandes modelos lingüísticos
16 h
Tras la disrupción de DeepSeek en el mercado de la IA, otra empresa china, Qwen, ha lanzado varios modelos de vanguardia que superan incluso a los modelos de razonamiento avanzado de DeepSeek. A los pocos días del lanzamiento de DeepSeek, Qwen publicó modelos de primer nivel, específicos por tarea, que aportan valor real más allá de funcionar solo como chatbots.
Puedes leer el artículo I Tested QwQ 32B Preview: Alibaba’s Reasoning Model para conocer el modelo de razonamiento de Qwen similar a DeekSeek R1.
En este tutorial, exploraremos Qwen2.5-VL, un modelo de visión y lenguaje que ha superado a todos los modelos propietarios en capacidades de visión. También veremos cómo usarlo en local y cómo probar el modelo insignia en línea.
Imagen del autor
Si estás empezando con la IA y los grandes modelos de lenguaje (LLM), te recomendamos el curso Introduction to LLMs in Python. Este curso te ayudará a entender los LLM y la arquitectura transformer que los hace posibles.
Qwen2.5-VL es el nuevo modelo insignia de visión y lenguaje de Qwen y un gran salto respecto a su predecesor, Qwen2-VL. Este modelo marca un nuevo estándar en IA multimodal: no solo reconoce objetos comunes como flores, aves, peces e insectos, sino que además analiza textos complejos, gráficos, iconos, ilustraciones y maquetaciones dentro de las imágenes.
Además, Qwen2.5-VL está diseñado para ser altamente agente, capaz de razonar de forma dinámica y orquestar herramientas, tanto en ordenador como en móvil.
Entre sus funciones avanzadas están comprender vídeos de más de una hora, localizar eventos concretos en ellos y ubicar con precisión objetos en imágenes generando cajas delimitadoras o puntos. También ofrece salidas JSON estables con coordenadas y atributos, lo que garantiza precisión en tareas que requieren datos estructurados.
Asimismo, Qwen2.5-VL admite salidas estructuradas para documentos escaneados, como facturas, formularios y tablas, lo que lo hace especialmente útil en sectores como finanzas y comercio.
Fuente: Qwen2.5 VL
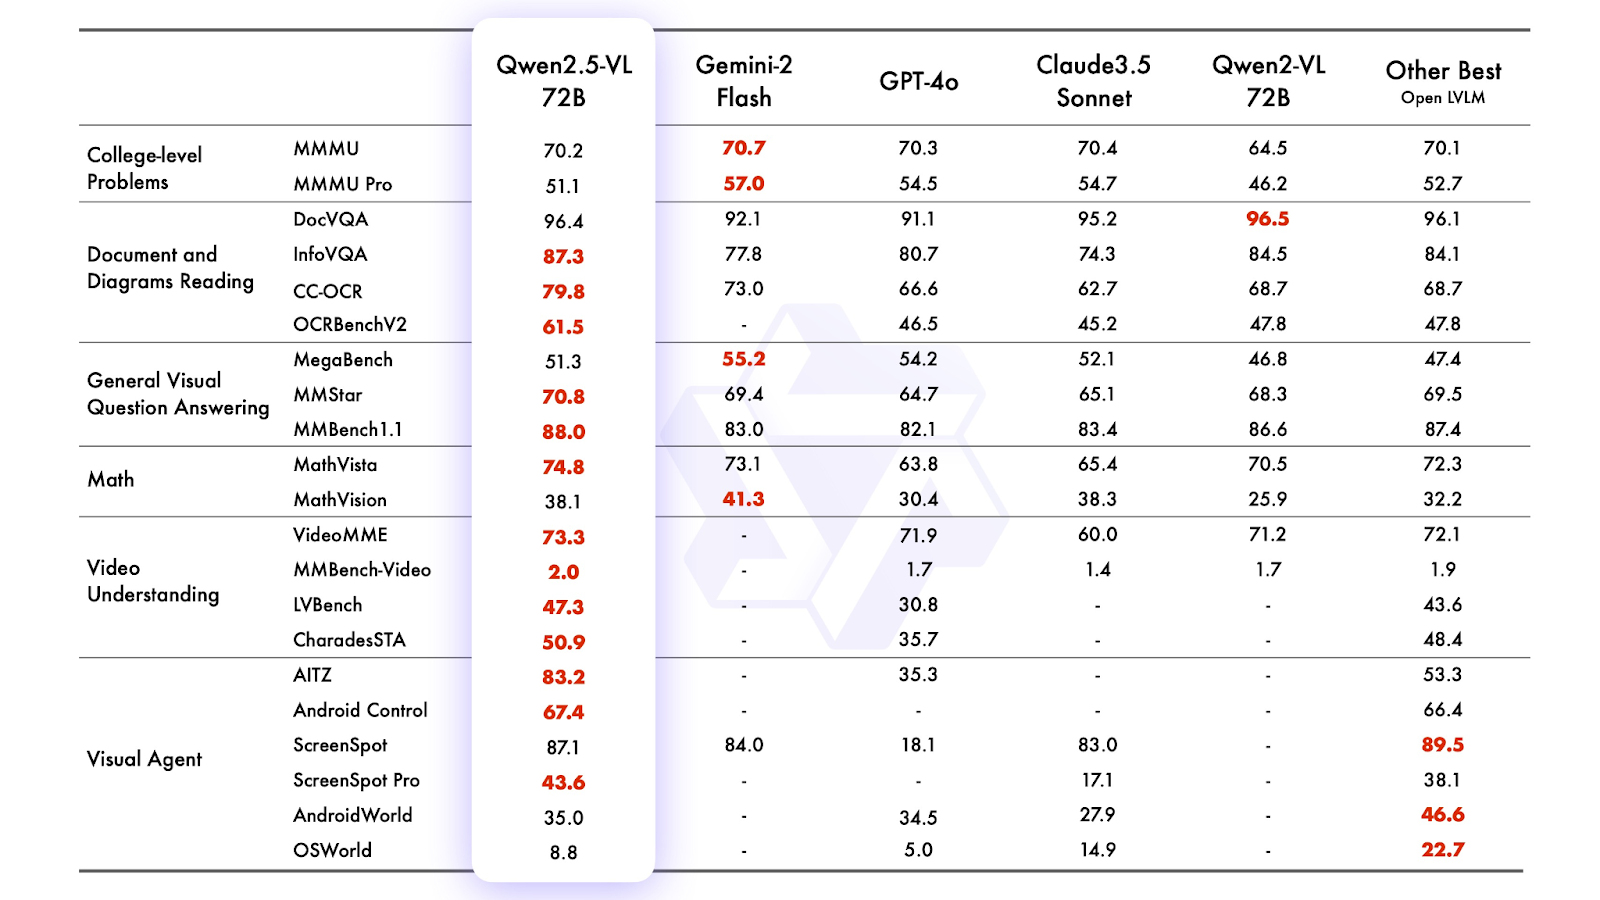
El modelo insignia Qwen2.5-VL-72B-Instruct ofrece un rendimiento excepcional en un amplio abanico de benchmarks, demostrando su versatilidad para abordar dominios y tareas diversas. Supera a modelos líderes como Gemini 2 Flash, GPT-4o y Claude 3.5 Sonnet, consolidándose como un modelo de visión y lenguaje de primer nivel.
También puedes evaluar el modelo de Qwen o cualquier LLM por tu cuenta siguiendo el tutorial Evaluate LLMs Effectively Using DeepEval.
Ahora veremos varias formas de ejecutar Qwen2.5-VL en local. Estas soluciones ya están disponibles en el repositorio de GitHub QwenLM/Qwen2.5-VL. Solo hay que preparar el entorno, corregir algunos errores comunes y ejecutar la aplicación web en local.
1. Empieza clonando el repositorio de GitHub de Qwen2.5-VL y accediendo al directorio del proyecto:
git clone https://github.com/QwenLM/Qwen2.5-VL

cd Qwen2.5-VL
2. Instala las dependencias necesarias para la aplicación web con el siguiente comando:
pip install -r requirements_web_demo.txt3. Para asegurar la compatibilidad con tu GPU, instala las últimas versiones de PyTorch, TorchVision y TorchAudio con soporte CUDA. Aunque ya tengas PyTorch instalado, puedes tener problemas al ejecutar la app web; lo mejor es actualizar:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu1244. Actualiza Gradio y Gradio Client para evitar errores de conexión y de interfaz; las versiones antiguas pueden dar problemas:
pip install -U gradio gradio_client 5. Ahora ejecuta la demo web usando el checkpoint del modelo pequeño de 3B. Es lo recomendado para portátiles con memoria de GPU limitada (p. ej., 8 GB de VRAM). El modelo de 7B podría funcionar, pero probablemente responderá con mucha lentitud:
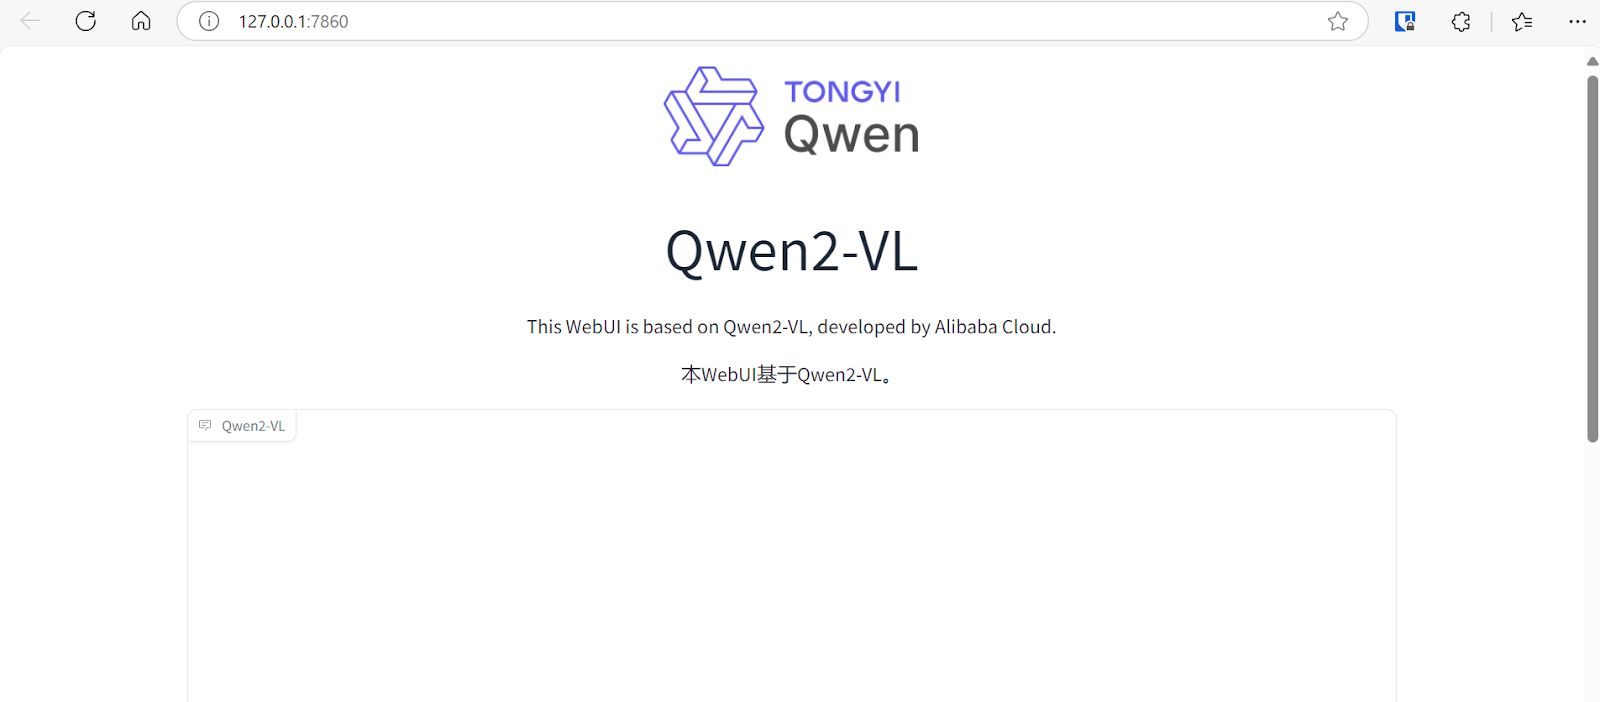
python web_demo_mm.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct" Como ves, primero descarga el modelo, luego carga el processor y el modelo, y la app web queda disponible en la URL local http://127.0.0.1:7860.
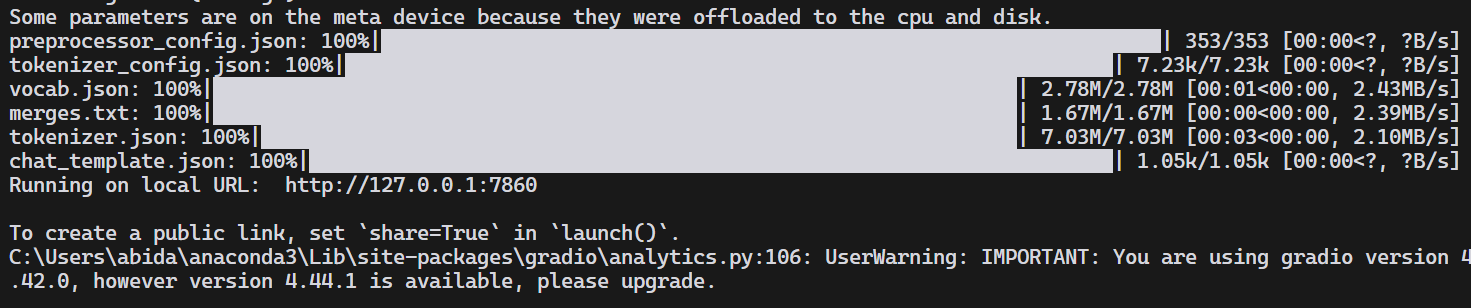
La app web funciona perfectamente.
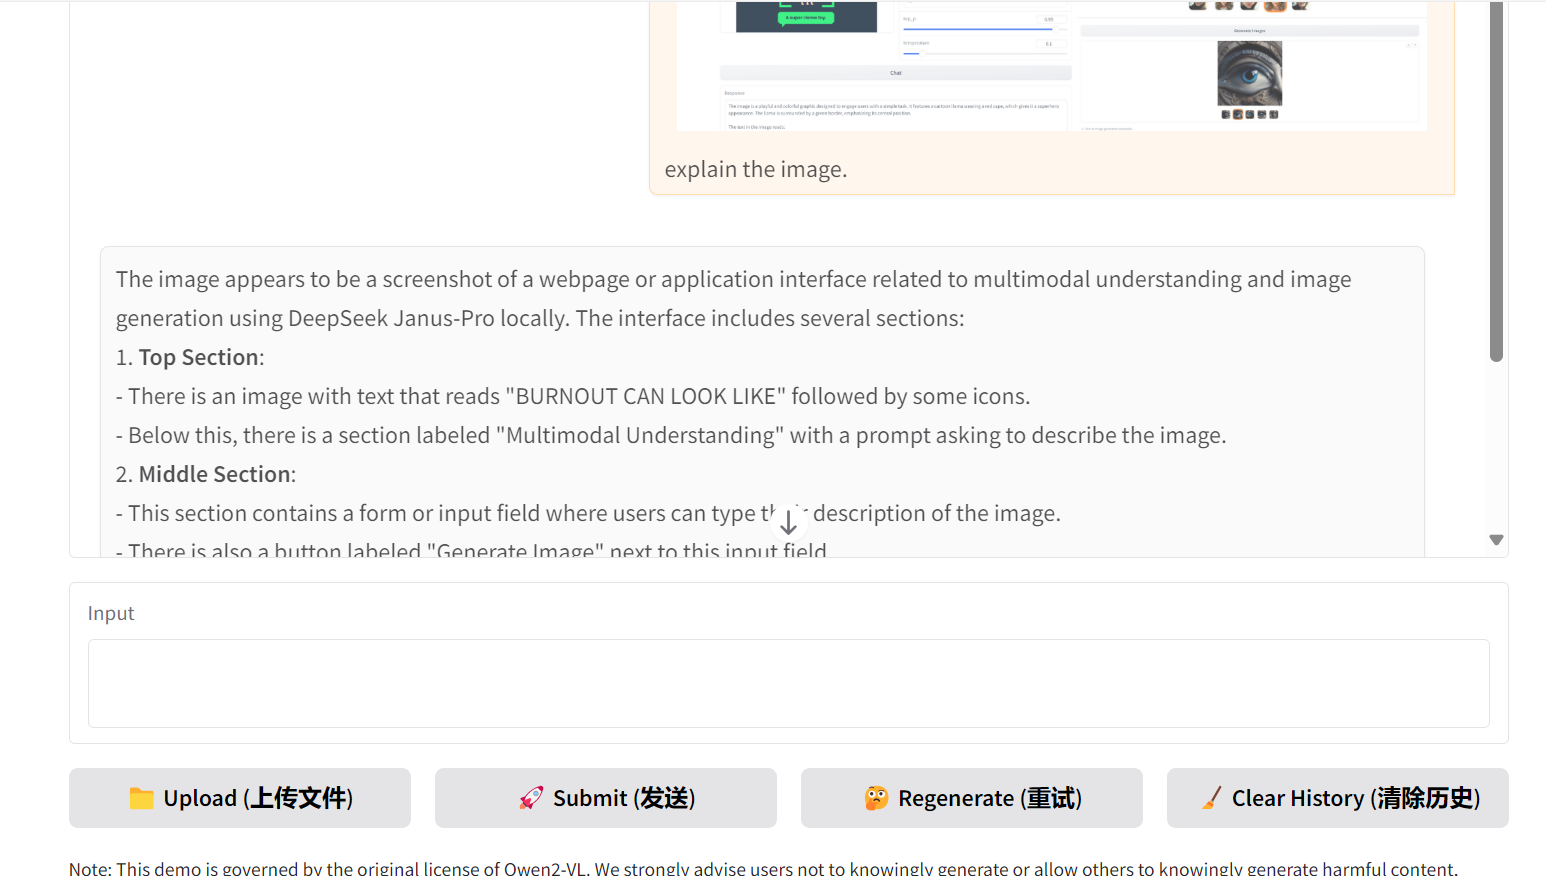
6. Puedes subir una imagen con texto y varias figuras y pedirle al modelo que la explique. Incluso el modelo pequeño de 3B ofrece un rendimiento notable, detectando detalles muy finos en la imagen.
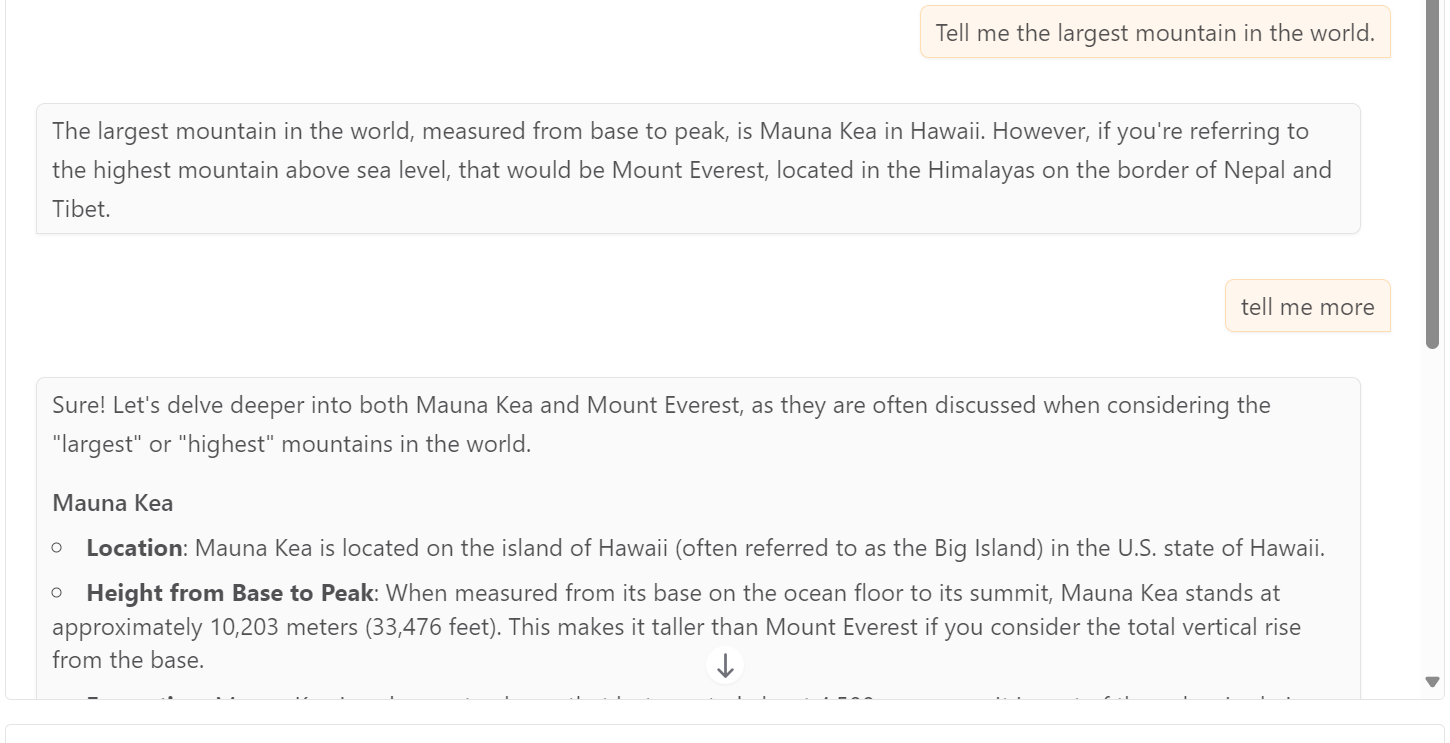
7. También puedes interactuar con el modelo sin aportar imagen. Generará respuestas de texto, como un gran modelo de lenguaje estándar.
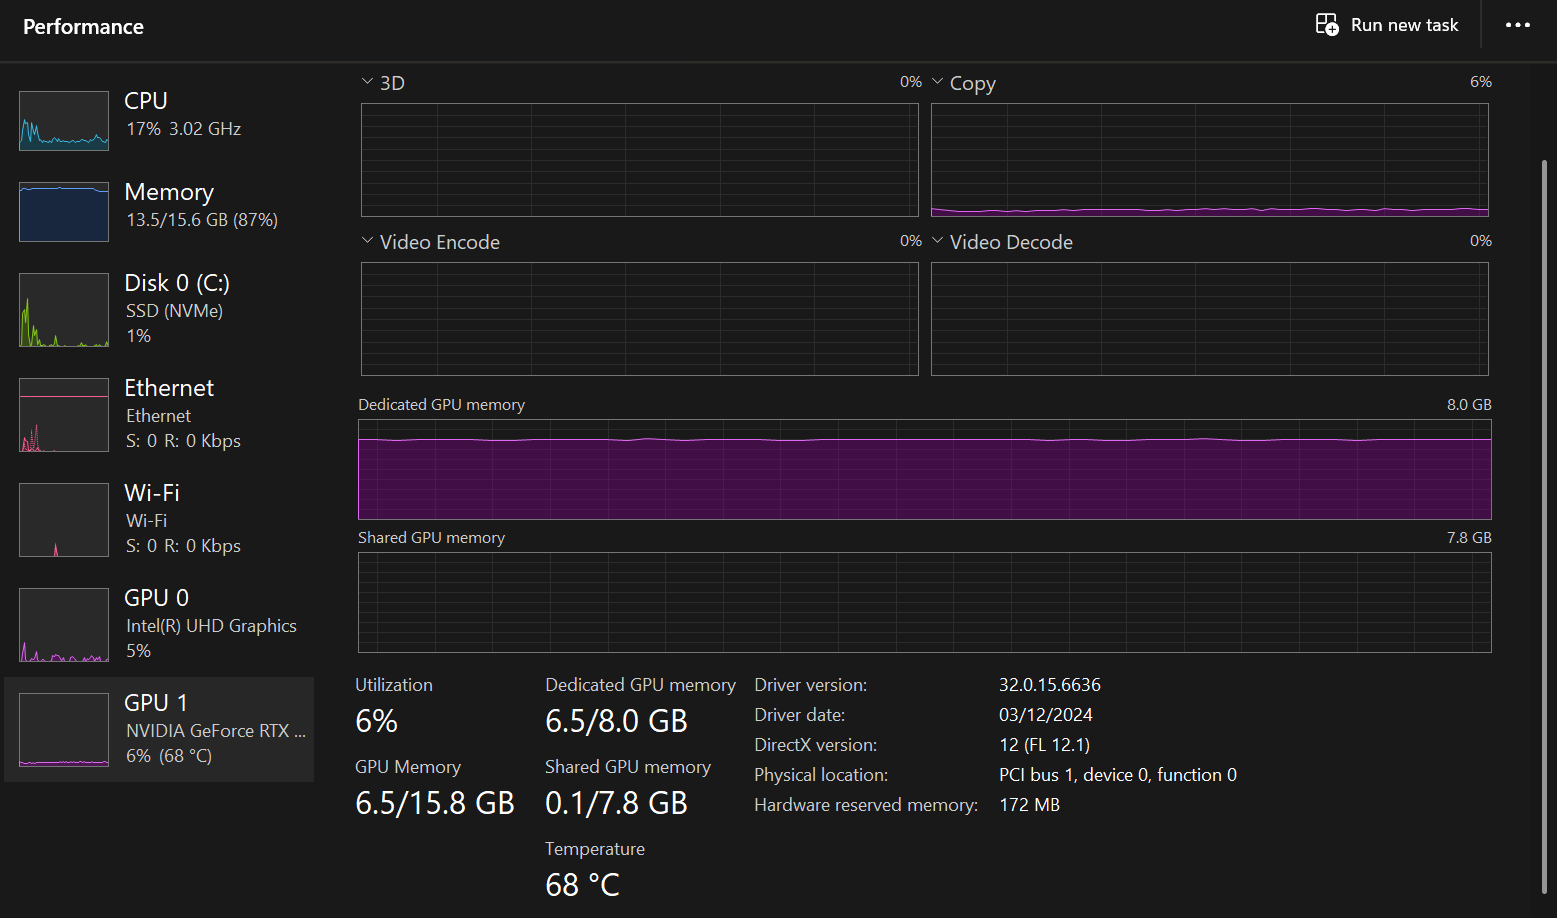
Si abres el Administrador de tareas y supervisas el rendimiento, verás que el uso de la GPU ronda el 6%, señal de que todo va fluido.
El repositorio de GitHub también incluye una demo experimental de chat con vídeo en streaming, en el directorio web_demo_streaming. Esta demo te permite interactuar con el modelo usando tu cámara web.
Para ejecutar la demo de chat por vídeo en streaming, ve al directorio correspondiente y lanza la aplicación con el checkpoint del modelo de 3B.
cd web_demo_streaming/
python app.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct"
Si tienes una GPU más potente, esta app web funcionará sin problemas. Solo concede acceso a tu cámara y empieza a hacer preguntas.
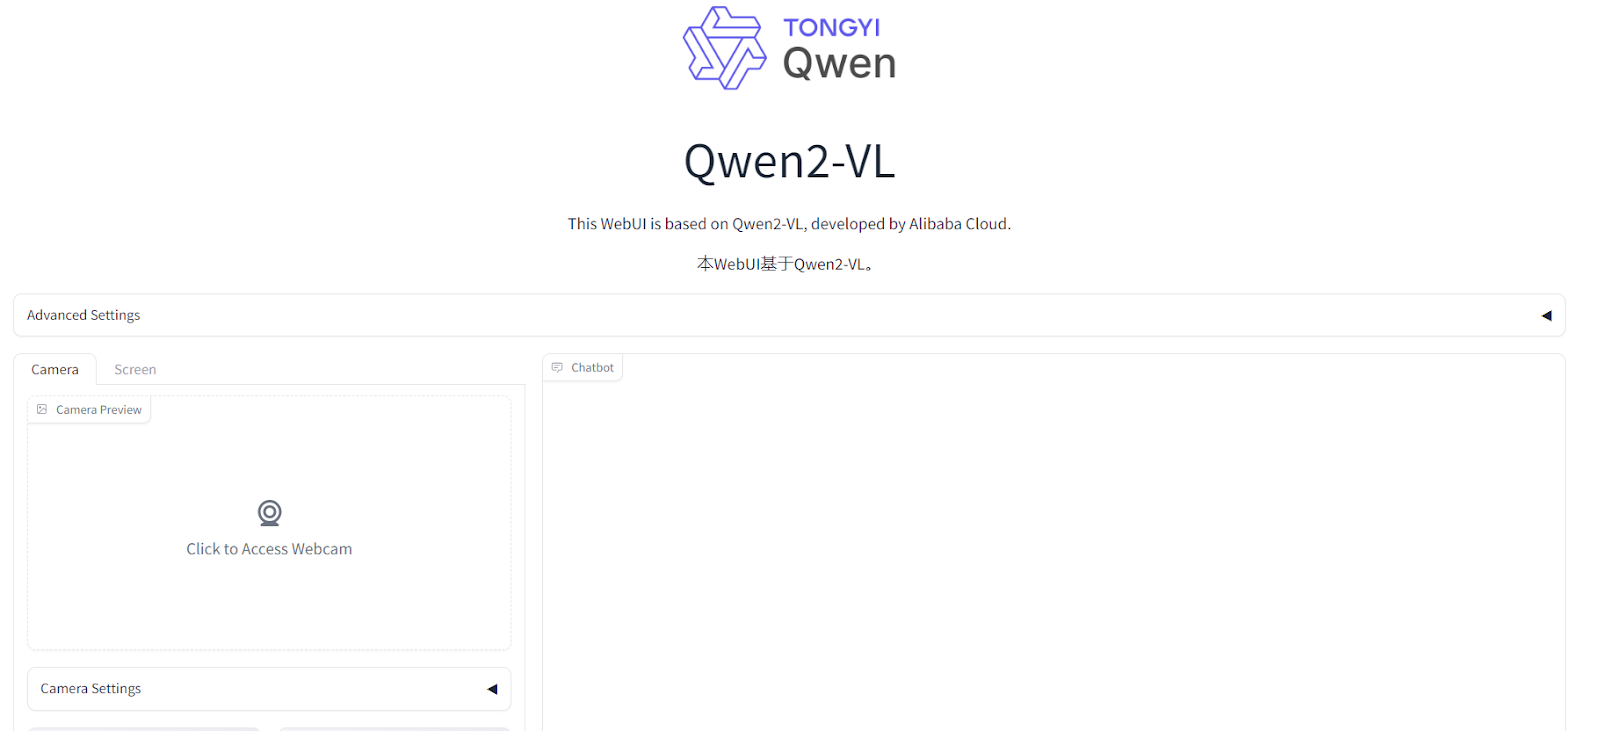
Aprende a usar el modelo desplegado en local y a construir una aplicación con una interfaz cuidada a su alrededor. Puedes hacerlo completando el curso Developing LLM Applications with LangChain.
La forma más estable de usar Qwen2.5-VL en local es ejecutándolo con Docker. El equipo de Qwen ofrece imágenes de Docker precompiladas con todo el entorno ya configurado.
1. Descarga e instala Docker Desktop desde el sitio oficial.
2. Para simplificar el despliegue, usa la imagen precompilada qwenllm/qwenvl. Instala los drivers necesarios y descarga los archivos del modelo para lanzar la demo.
docker run --gpus all --ipc=host --network=host --rm --name qwen2 -it qwenllm/qwenvl:2-cu121 bashPuedes conocer un modelo de generación de código llamado Qwen 2.5 Coder leyendo nuestra guía Qwen 2.5 Coder: A Guide With Examples.
Si quieres probar el modelo insignia Qwen2.5-VL 72B Instuct, ve a la web de Qwen Chat, crea una cuenta y empieza a usar el modelo igual que en ChatGPT. Puede que tengas que seleccionar el modelo antes de cargar la imagen.
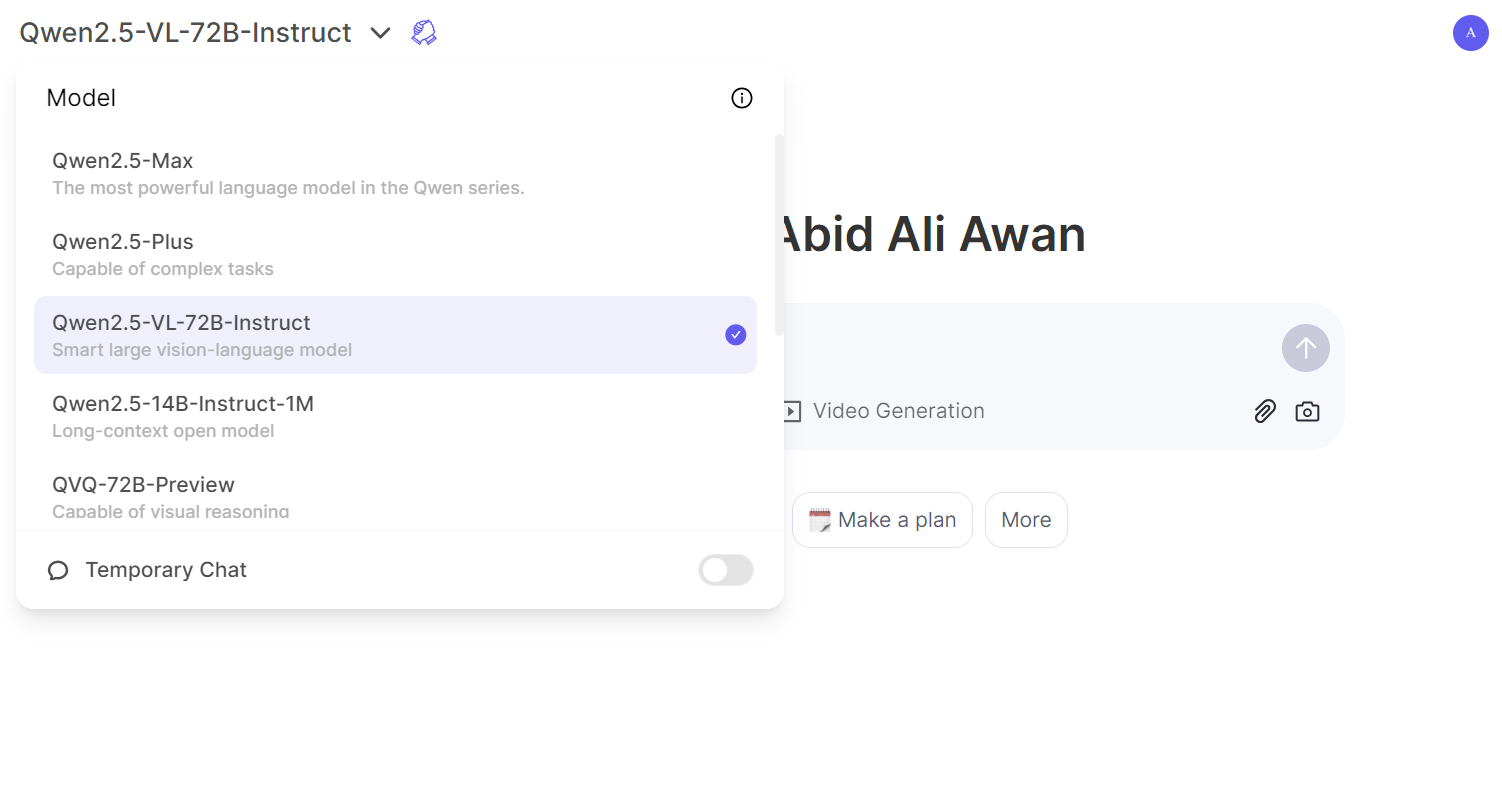
Carga la imagen y empieza a hacer preguntas sobre ella.
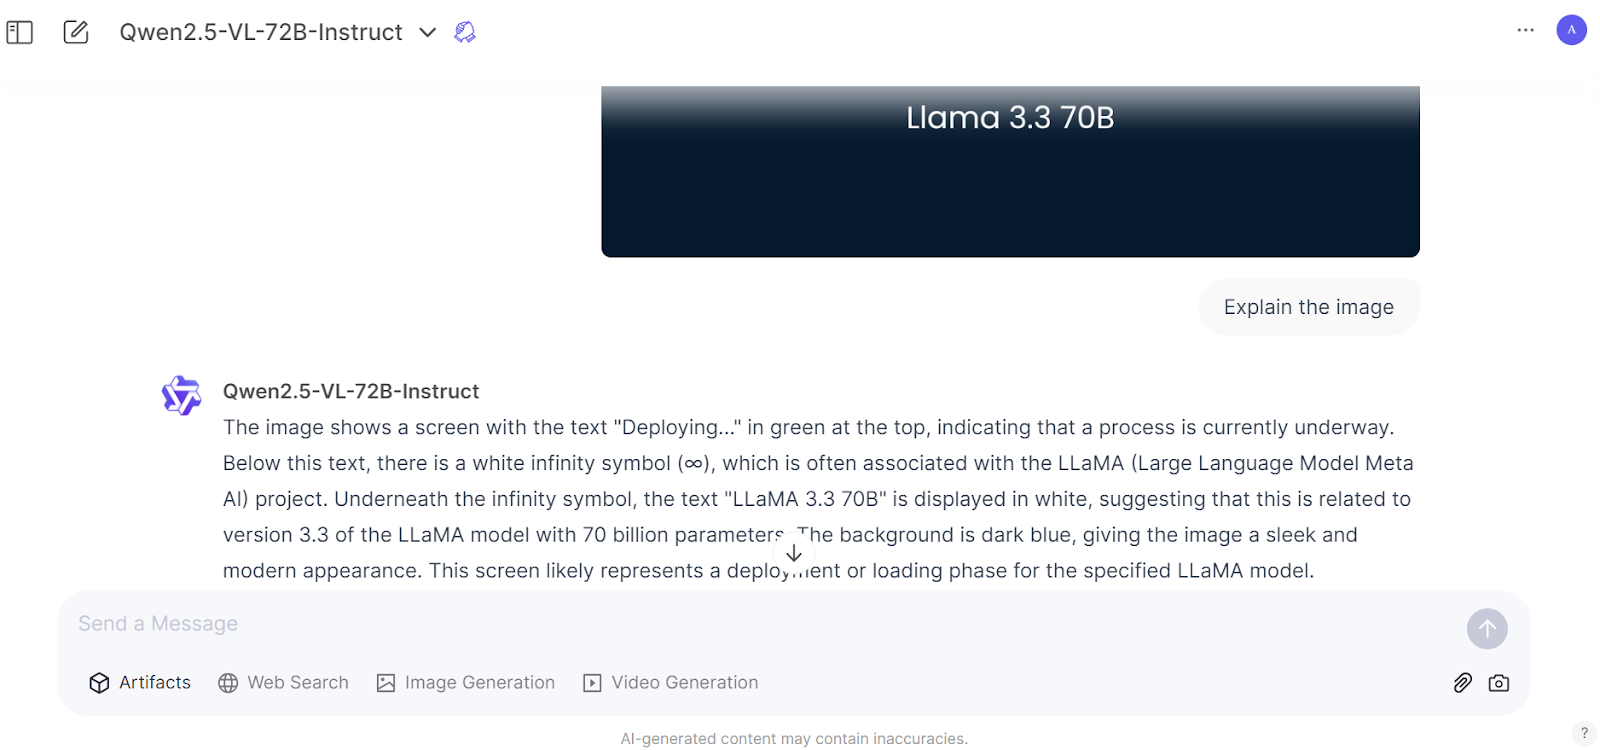
La generación de respuestas es rápida y precisa; con un poco de práctica, podrás probar un modelo de IA de primer nivel.
Alibaba Cloud ofrece todas las herramientas necesarias para acceder a distintos modelos de IA mediante API y afinarlos de forma similar a la plataforma de OpenAI. Lee el tutorial Qwen (Alibaba Cloud) Tutorial: Introduction and Fine-Tuning para saber más.
Qwen2.5-VL es un avance que anticipa el futuro de la IA y demuestra que la innovación en modelos avanzados no es exclusiva de EE. UU. ni de Occidente. Este modelo ofrece una precisión sobresaliente e integración fluida en distintos flujos de trabajo, lo que permite crear herramientas de IA a medida para automatizar tareas.
Por ejemplo, puedes usar Qwen2.5-VL para configurar una cuenta de LinkedIn, completarla con todos los datos necesarios e incluso publicar artículos por ti — todo con un esfuerzo mínimo.
En este tutorial hemos visto Qwen 2.5-VL, un modelo de visión capaz de capturar hasta los detalles más pequeños de una imagen. También hemos aprendido a usarlo en local en un portátil con GPU. Por último, creamos una cuenta en Qwen y usamos el modelo insignia en línea, de forma similar a ChatGPT.
Lee sobre Alibaba's Qwen 2.5-Max, un modelo que compite con GPT-4o, Claude 3.5 Sonnet y DeepSeek V3.
Los mejores cursos de DataCamp
programa
Curso
programa
blog
Ryan Ong
8 min
Tutorial
Dimitri Didmanidze
9 min
Tutorial
Moez Ali
11 min
Tutorial
Arunn Thevapalan
12 min
Tutorial
Abid Ali Awan
12 min
Tutorial
Dimitri Didmanidze
8 min