
Cursus
Développer des LLM
16 h
Après le bouleversement du marché de l’IA par DeepSeek, une autre entreprise chinoise, Qwen, a publié plusieurs modèles de pointe qui surpassent même les modèles avancés de raisonnement de DeepSeek. En quelques jours seulement après le lancement de DeepSeek, Qwen a dévoilé des modèles haut de gamme, spécialisés par tâche, qui apportent une vraie valeur d’usage et ne se limitent pas à des chatbots.
Vous pouvez lire l’article I Tested QwQ 32B Preview: Alibaba’s Reasoning Model pour découvrir le modèle de raisonnement de Qwen, comparable à DeekSeek R1.
Dans ce tutoriel, nous allons explorer Qwen2.5-VL, un modèle vision-langage qui dépasse tous les modèles propriétaires en matière de capacités visuelles. Nous verrons aussi comment l’utiliser en local et comment tester le modèle phare en ligne.
Image par l’auteur
Si vous débutez avec l’IA et les grands modèles de langage (LLM), pensez à suivre le cours Introduction to LLMs in Python. Ce cours vous aidera à comprendre les LLM et l’architecture Transformer révolutionnaire sur laquelle ils reposent.
Qwen2.5-VL est le nouveau modèle phare vision-langage de Qwen et représente un bond en avant par rapport à son prédécesseur, Qwen2-VL. Il établit un nouveau standard en IA multimodale : non seulement il reconnaît des objets courants comme les fleurs, oiseaux, poissons et insectes, mais il analyse aussi des textes complexes, graphiques, icônes, schémas et mises en page au sein des images.
En outre, Qwen2.5-VL est pensé pour être très agentique, capable de raisonnement dynamique et d’orchestration d’outils — que vous l’utilisiez sur ordinateur ou sur téléphone.
Parmi ses fonctionnalités avancées : la compréhension de vidéos de plus d’une heure, l’identification d’événements précis et la localisation exacte d’objets dans les images via des boîtes englobantes ou des points. Il fournit aussi des sorties JSON stables pour les coordonnées et attributs, garantissant la précision des tâches nécessitant des données structurées.
Par ailleurs, Qwen2.5-VL gère des sorties structurées pour des documents scannés — factures, formulaires, tableaux —, ce qui en fait un atout pour des secteurs comme la finance et le commerce.
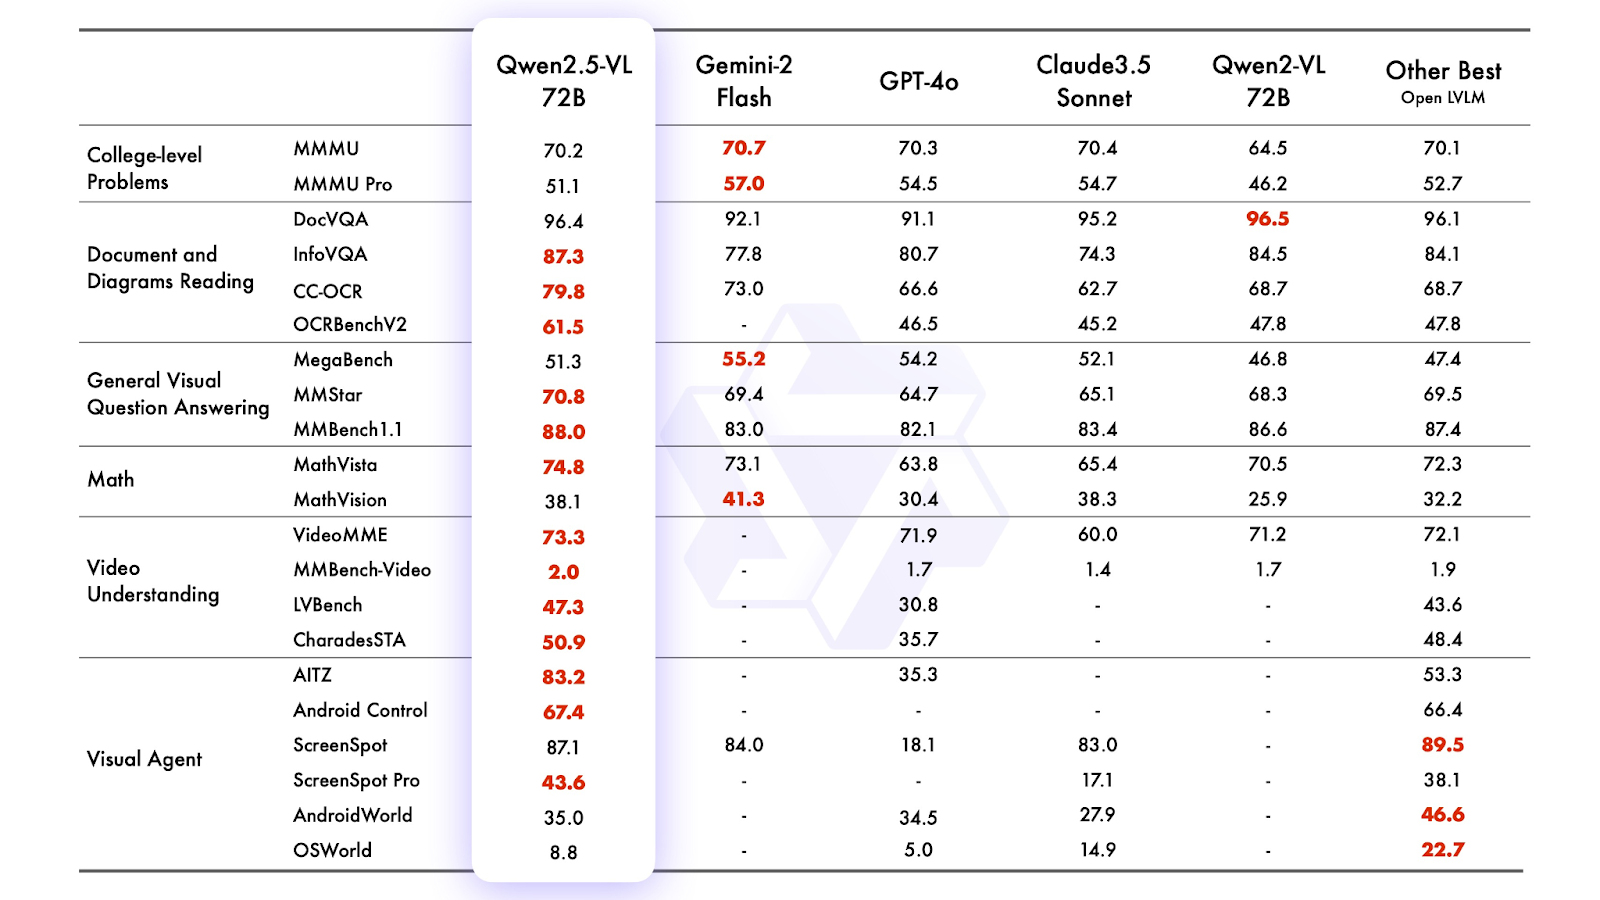
Source : Qwen2.5 VL
Le modèle phare Qwen2.5-VL-72B-Instruct offre des performances remarquables sur un large éventail de benchmarks, preuve de sa polyvalence sur des domaines et tâches variés. Il surpasse des modèles de premier plan comme Gemini 2 Flash, GPT-4o et Claude 3.5 Sonnet, confirmant son statut de modèle vision-langage de tout premier plan.
Vous pouvez aussi évaluer le modèle Qwen — ou tout autre LLM — par vous‑même en suivant le tutoriel Evaluate LLMs Effectively Using DeepEval.
Nous allons maintenant voir plusieurs façons d’exécuter Qwen2.5-VL en local. Ces solutions sont déjà disponibles dans le dépôt GitHub QwenLM/Qwen2.5-VL. Il suffit de préparer l’environnement, corriger quelques erreurs courantes et lancer l’application web en local.
1. Commencez par cloner le dépôt GitHub Qwen2.5-VL et placez‑vous dans le répertoire du projet :
git clone https://github.com/QwenLM/Qwen2.5-VL

cd Qwen2.5-VL
2. Installez les dépendances requises pour l’application web avec la commande suivante :
pip install -r requirements_web_demo.txt3. Pour garantir la compatibilité avec votre GPU, installez les dernières versions de PyTorch, TorchVision et TorchAudio avec le support CUDA. Même si PyTorch est déjà installé, vous pourriez rencontrer des problèmes au lancement de l’app web : mieux vaut mettre à jour.
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu1244. Mettez à jour Gradio et Gradio Client pour éviter des erreurs de connexion et d’interface, car les anciennes versions peuvent poser problème :
pip install -U gradio gradio_client 5. Lancez maintenant la démo web avec le point de contrôle du modèle 3B, plus léger. C’est la configuration recommandée pour les ordinateurs portables avec une mémoire GPU limitée (par ex. 8 Go de VRAM). Le modèle 7B peut fonctionner, mais la génération de réponse risque d’être lente :
python web_demo_mm.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct" Comme vous le voyez, le modèle est d’abord téléchargé, puis le processor et le modèle sont chargés, et l’app web tourne maintenant sur l’URL locale http://127.0.0.1:7860.
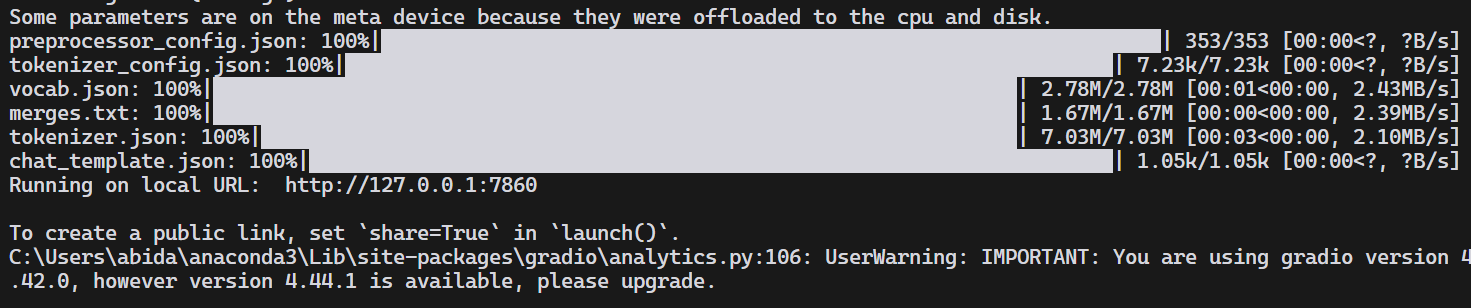
L’application web fonctionne parfaitement.
6. Vous pouvez téléverser une image contenant du texte et plusieurs figures et demander au modèle de l’expliquer. Même le petit modèle 3B s’en sort très bien en identifiant des détails subtils.
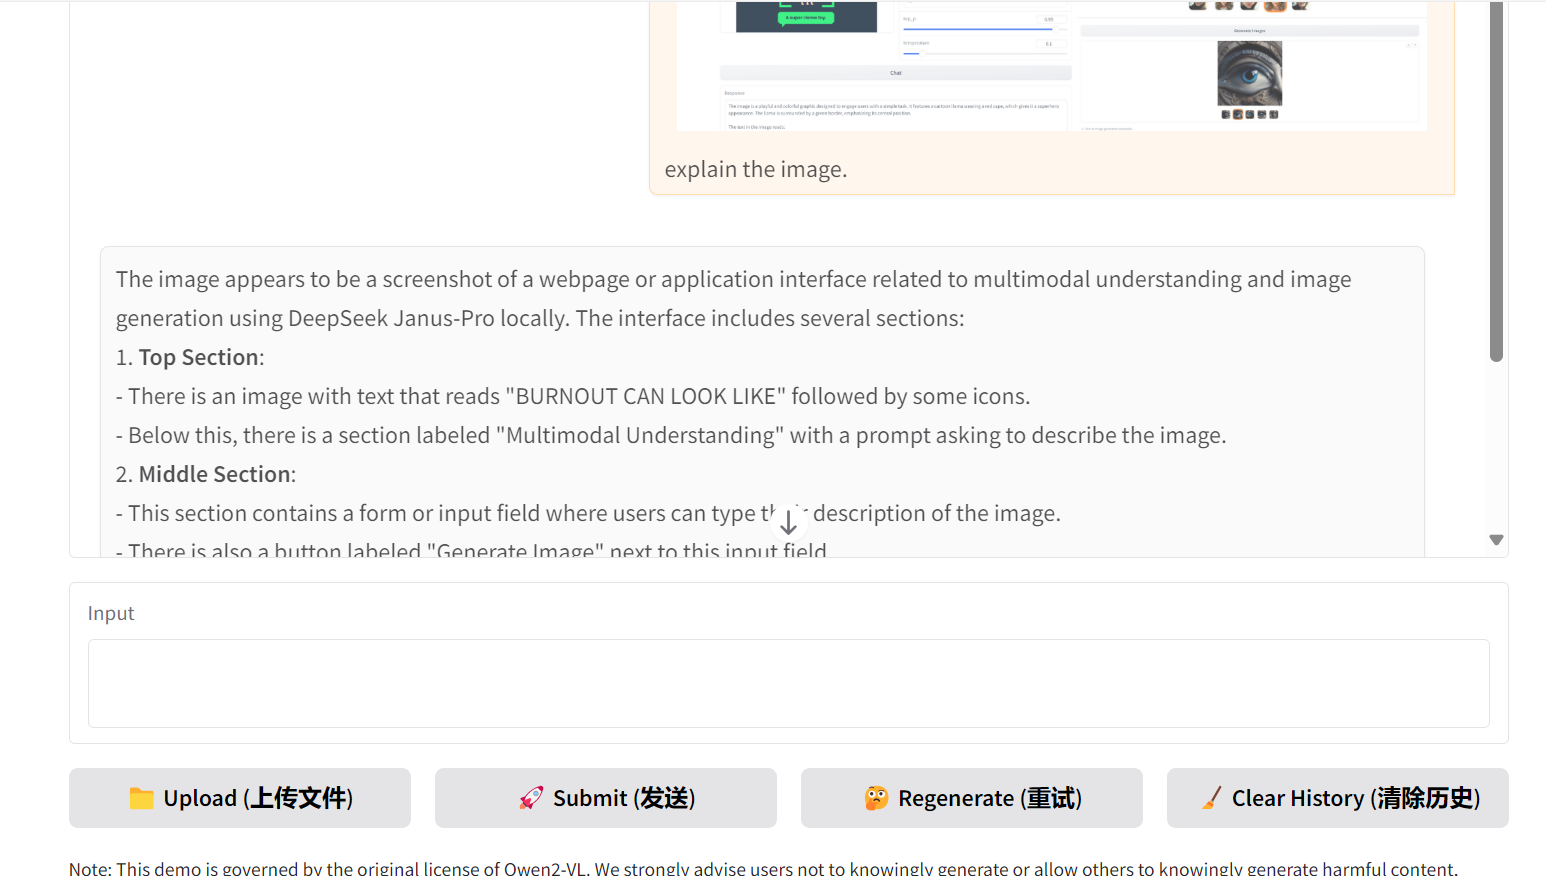
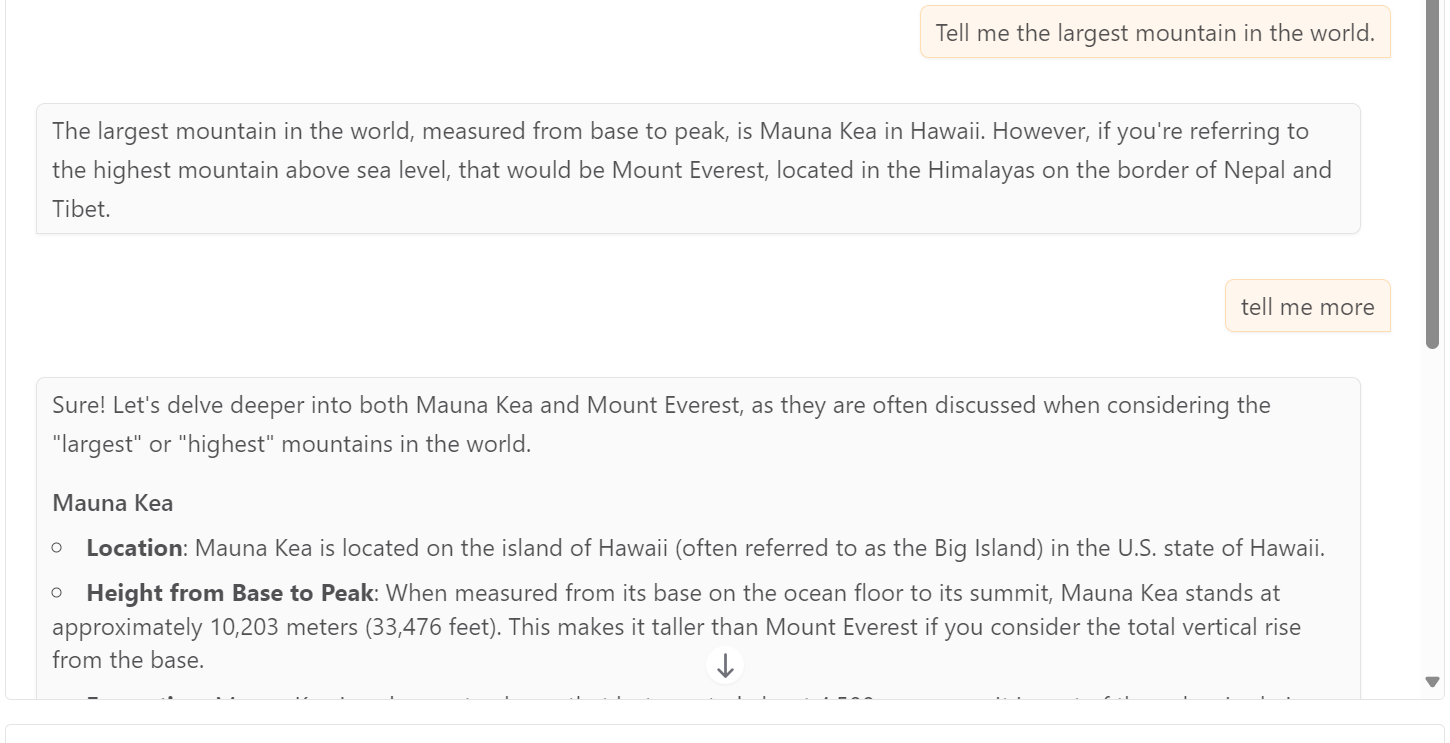
7. Vous pouvez aussi interagir avec le modèle sans fournir d’image. Il générera des réponses textuelles, comme un grand modèle de langage classique.
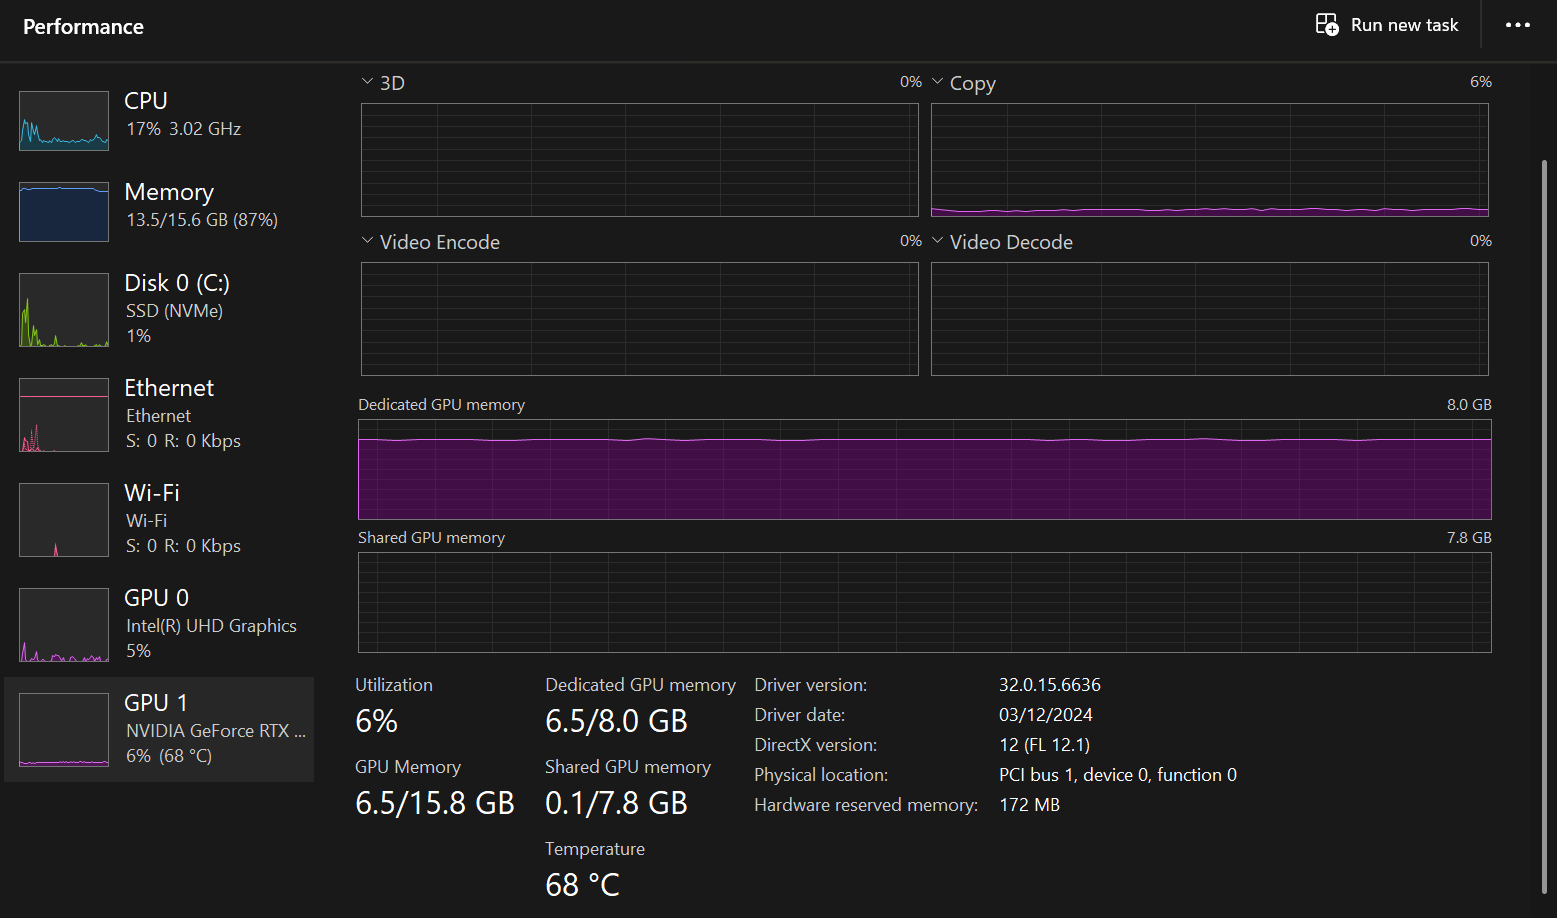
En ouvrant le Gestionnaire des tâches et en surveillant les performances, vous constaterez une utilisation GPU d’environ 6 %, signe d’un fonctionnement fluide.
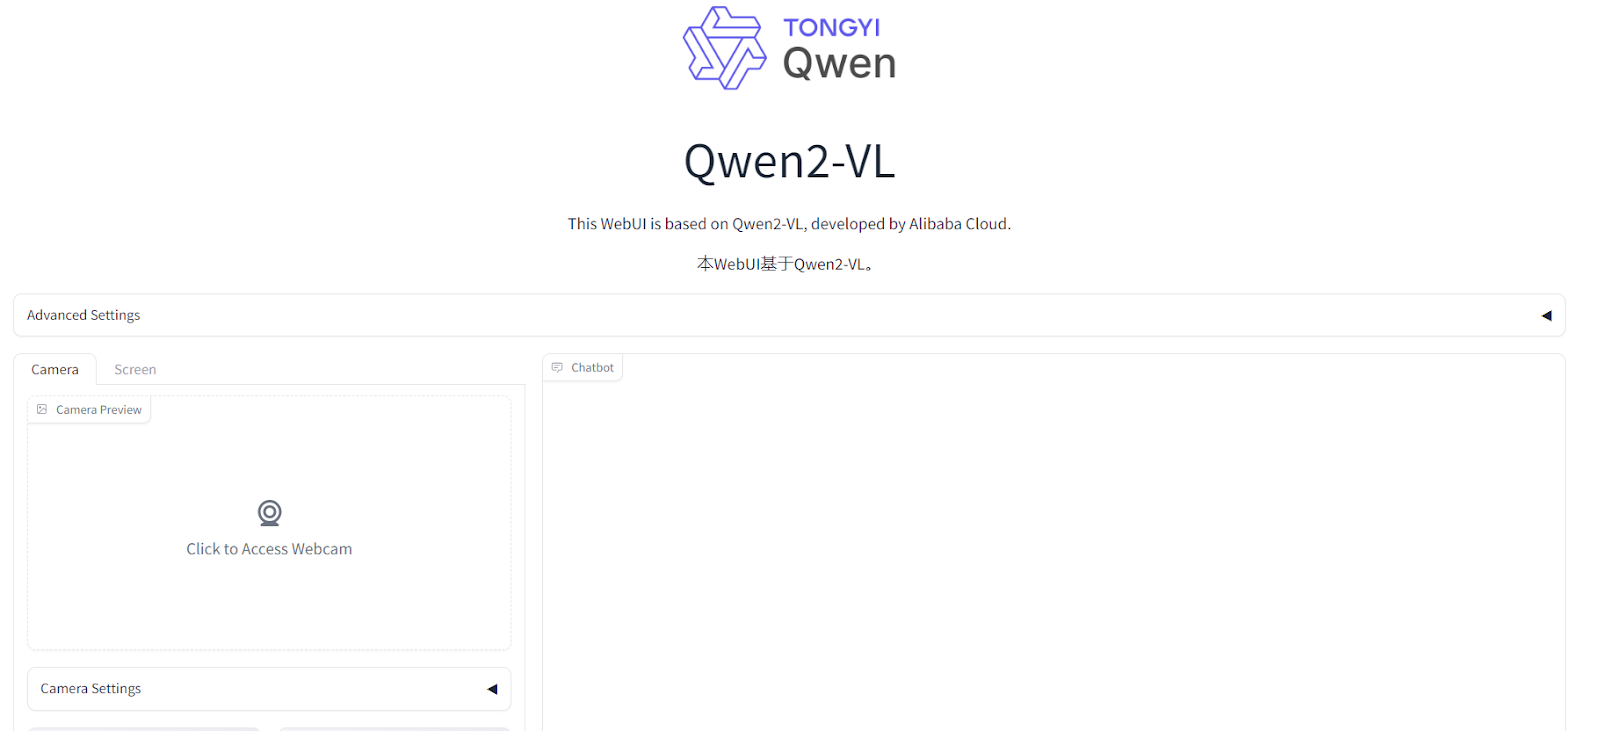
Le dépôt GitHub inclut aussi une démo expérimentale de chat vidéo en streaming, dans le répertoire web_demo_streaming. Cette démo vous permet d’interagir avec le modèle via votre webcam.
Pour lancer la démo de chat vidéo en streaming, accédez au répertoire de la démo et exécutez l’application avec le point de contrôle du modèle 3B.
cd web_demo_streaming/
python app.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct"
Si vous disposez d’un GPU plus puissant, cette application web tournera sans problème. Autorisez simplement l’accès à votre webcam et commencez à poser vos questions.
Apprenez à utiliser le modèle déployé en local et à construire une véritable application interface autour de celui‑ci en suivant le cours Developing LLM Applications with LangChain.
La méthode la plus stable pour utiliser Qwen2.5-VL en local consiste à le faire tourner via Docker. L’équipe Qwen fournit des images Docker préconfigurées avec tous les environnements nécessaires.
1. Téléchargez et installez Docker Desktop depuis le site officiel.
2. Pour simplifier le déploiement, utilisez l’image Docker précompilée qwenllm/qwenvl. Installez les pilotes requis et téléchargez les fichiers du modèle pour lancer la démo.
docker run --gpus all --ipc=host --network=host --rm --name qwen2 -it qwenllm/qwenvl:2-cu121 bashPour en savoir plus sur un modèle de génération de code appelé Qwen 2.5 Coder, consultez notre tutoriel Qwen 2.5 Coder : guide et exemples.
Si vous souhaitez tester le modèle phare Qwen2.5-VL 72B Instruct, rendez‑vous sur le site Qwen Chat, créez un compte et utilisez le modèle comme ChatGPT. Vous devrez peut‑être sélectionner le modèle avant de charger l’image.
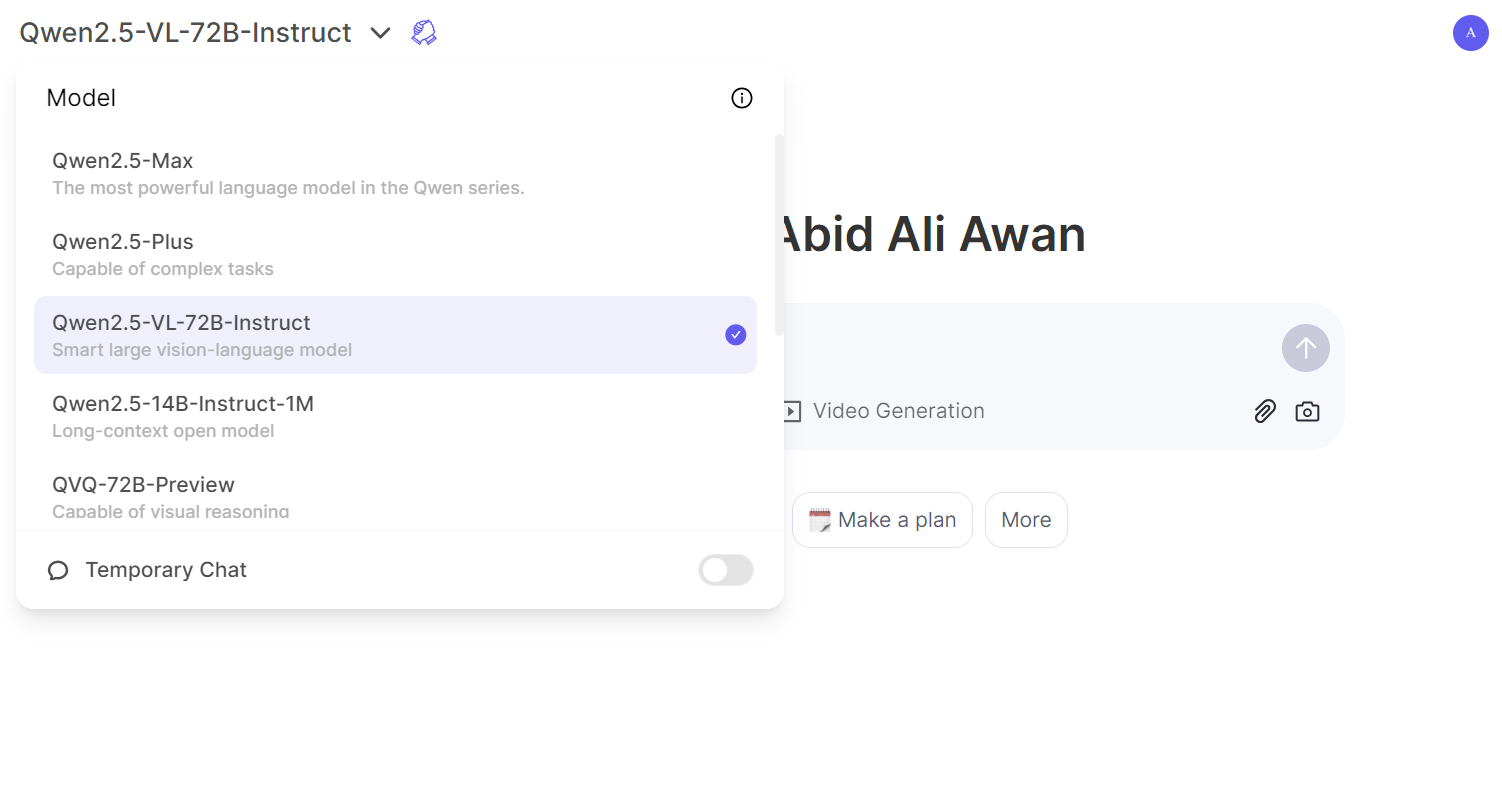
Chargez l’image et commencez à poser vos questions à son sujet.
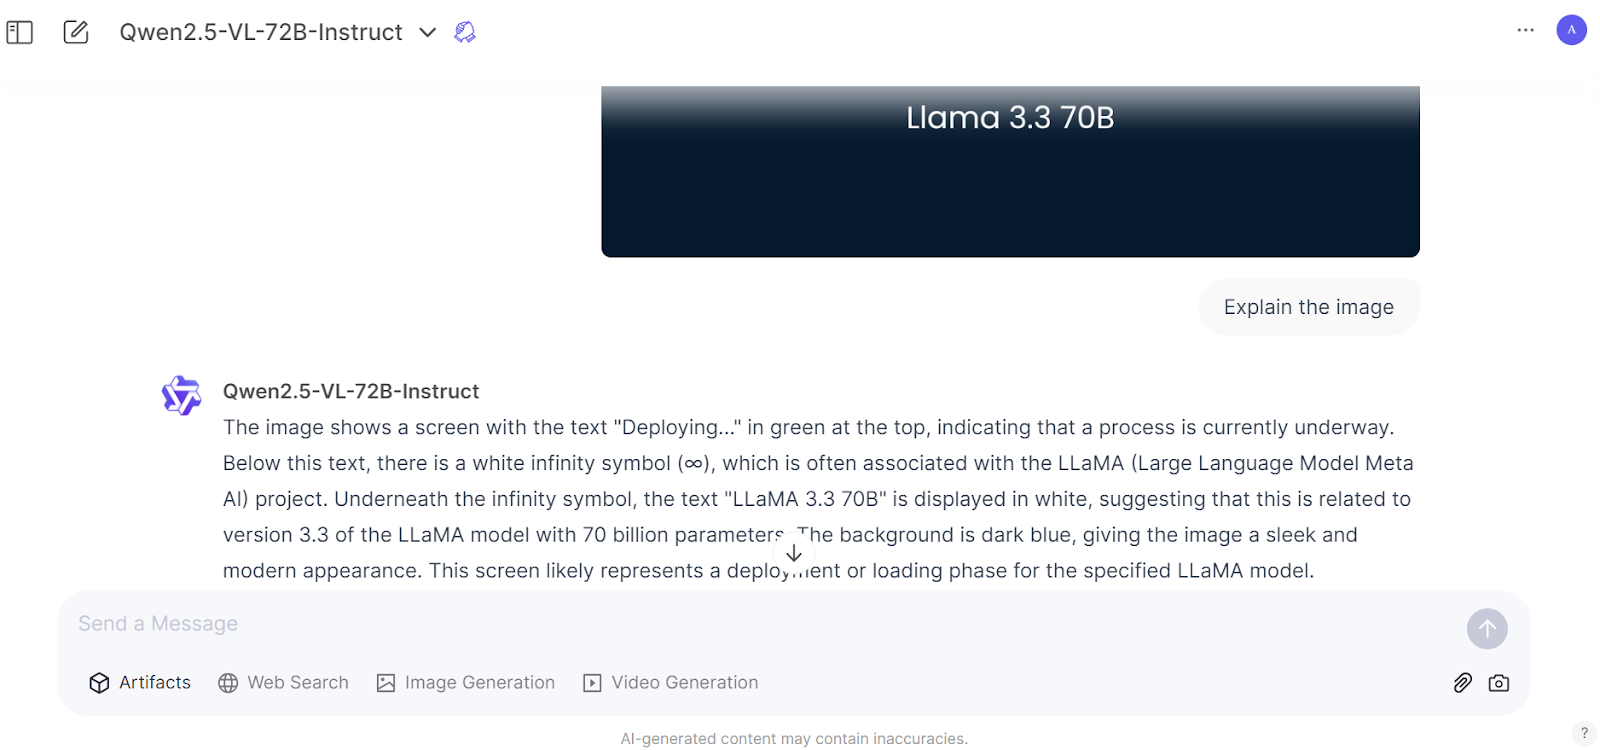
La génération de réponses est rapide et précise ; avec un peu de pratique, vous profiterez d’un modèle d’IA haut de gamme.
Alibaba Cloud fournit tous les outils nécessaires pour accéder à divers modèles d’IA via API, avec un affinage similaire à la plateforme OpenAI. Lisez le tutoriel Qwen (Alibaba Cloud) : introduction et fine‑tuning pour en savoir plus.
Qwen2.5-VL donne un aperçu de l’avenir de l’IA, prouvant que l’innovation en matière de modèles avancés n’est pas l’apanage des États‑Unis ou du monde occidental. Ce modèle se distingue par une précision exceptionnelle et une intégration fluide dans différents flux de travail, permettant de créer des outils d’IA sur mesure pour automatiser des tâches.
Par exemple, vous pouvez utiliser Qwen2.5-VL pour créer un compte LinkedIn, le compléter avec toutes les informations nécessaires et même publier des articles en votre nom — le tout avec un minimum d’effort.
Dans ce tutoriel, nous avons découvert Qwen 2.5‑VL, un modèle de vision capable de traiter les moindres détails d’une image. Nous avons également vu comment l’utiliser en local sur un ordinateur portable avec GPU. Enfin, nous avons créé un compte Qwen et utilisé le modèle phare en ligne, à la manière de ChatGPT.
Lisez aussi Alibaba’s Qwen 2.5‑Max, un modèle qui rivalise avec GPT‑4o, Claude 3.5 Sonnet et DeepSeek V3.
Les meilleurs cours DataCamp
Cursus
Cours
Cursus