

Entre os recursos avançados do modelo estão a capacidade de compreender vídeos com mais de uma hora, identificar eventos específicos e localizar com precisão objetos em imagens gerando bounding boxes ou pontos. Ele também oferece saídas JSON estáveis para coordenadas e atributos, garantindo precisão em tarefas que exigem dados estruturados.
Além disso, o Qwen2.5-VL suporta saídas estruturadas para documentos digitalizados, como notas fiscais, formulários e tabelas, o que é muito útil para setores como finanças e comércio.
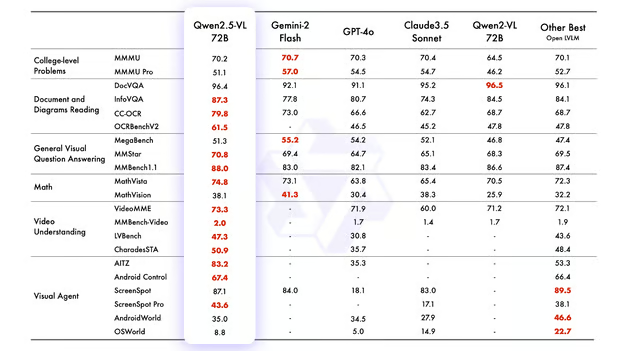
Fonte: Qwen2.5 VL
O modelo carro-chefe Qwen2.5-VL-72B-Instruct entrega desempenho excepcional em uma ampla gama de benchmarks, mostrando versatilidade para lidar com diferentes domínios e tarefas. Ele supera modelos líderes como Gemini 2 Flash, GPT-4o e Claude 3.5 Sonnet, consolidando sua posição como um dos melhores modelos de visão e linguagem.
Você também pode avaliar o Qwen ou qualquer LLM por conta própria seguindo o tutorial Evaluate LLMs Effectively Using DeepEval.
Usando o Qwen2.5-VL em um notebook com GPU
Agora vamos ver algumas formas de rodar o Qwen2.5-VL localmente. Essas soluções já estão disponíveis no repositório do GitHub QwenLM/Qwen2.5-VL. Basta configurar o ambiente, corrigir alguns erros comuns e rodar o app web localmente.
1. Rodando o app web do Qwen2.5-VL localmente
1. Comece clonando o repositório do Qwen2.5-VL no GitHub e navegando até a pasta do projeto:
git clone https://github.com/QwenLM/Qwen2.5-VL
cd Qwen2.5-VL2. Instale as dependências necessárias para o app web com o comando abaixo:
pip install -r requirements_web_demo.txt3. Para garantir compatibilidade com sua GPU, instale as versões mais recentes de PyTorch, TorchVision e TorchAudio com suporte a CUDA. Mesmo que já tenha PyTorch instalado, podem surgir problemas ao rodar o app web, então é melhor atualizar:
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu1244. Atualize o Gradio e o Gradio Client para evitar erros de conexão e de interface, pois versões antigas podem causar problemas:
pip install -U gradio gradio_client 5. Agora, rode o demo web usando o checkpoint menor, de 3B. Essa é a opção recomendada para notebooks com VRAM limitada (ex.: 8 GB). O modelo de 7B pode até funcionar, mas a geração de respostas tende a ficar lenta:
python web_demo_mm.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct" Como dá para ver, primeiro ele baixa o modelo, depois carrega o processor e o model, e o app web passa a rodar no endereço local http://127.0.0.1:7860.
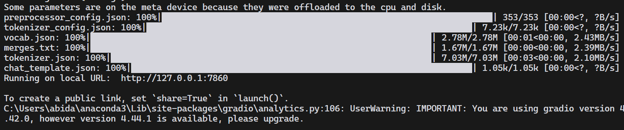
O app web está rodando direitinho.
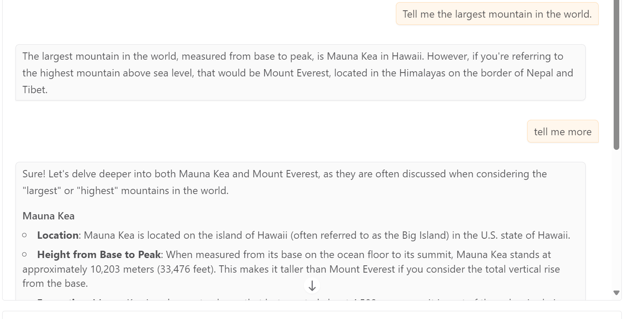
6. Você pode fazer upload de uma imagem com texto e várias figuras e pedir para o modelo explicá-la. Mesmo o modelo menor, de 3B, apresenta um desempenho impressionante, identificando detalhes finos na imagem.
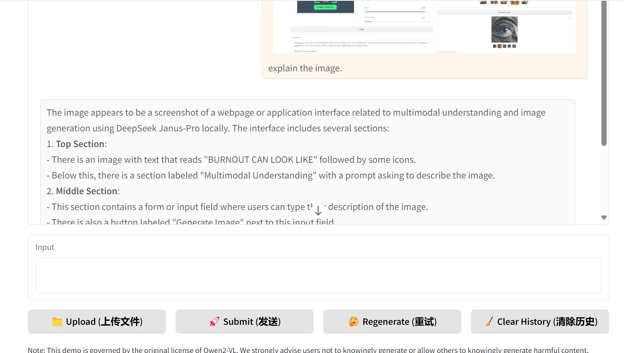
7. Você também pode interagir com o modelo sem fornecer imagem. Ele gera respostas em texto, funcionando como um LLM padrão.
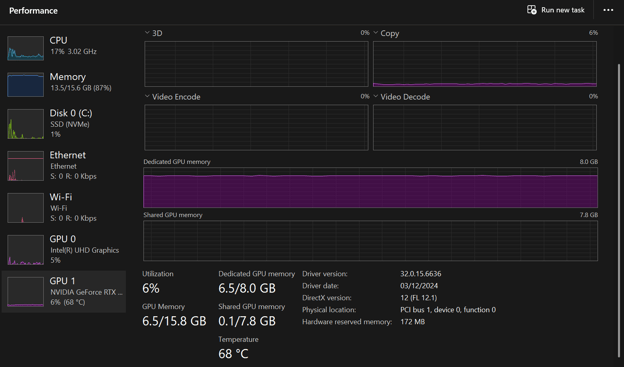
Se você abrir o Gerenciador de Tarefas e acompanhar o desempenho, vai notar uso de GPU por volta de 6%, indicando que está tudo fluindo bem.
2. Rodando um app web experimental do Qwen2.5-VL localmente
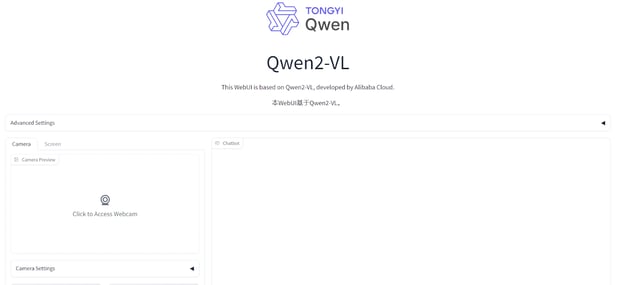
O repositório do GitHub também inclui um demo experimental de chat com vídeo em streaming, na pasta web_demo_streaming. Esse demo permite interagir com o modelo usando sua webcam.
Para rodar o demo de chat em vídeo, navegue até a pasta de streaming e execute o app com o checkpoint de 3B.
cd web_demo_streaming/
python app.py --checkpoint-path "Qwen/Qwen2.5-VL-3B-Instruct" Se você tiver uma GPU mais potente, esse app web roda liso. Basta conceder acesso à webcam e começar a fazer perguntas.
Aprenda a usar o modelo implantado localmente e a construir uma aplicação com interface adequada em torno dele. Você pode fazer isso concluindo o curso Developing LLM Applications with LangChain.
3. Rodando o Qwen2.5-VL localmente com Docker Desktop
A forma mais estável de usar o Qwen2.5-VL localmente é via Docker. A equipe da Qwen fornece imagens Docker prontas com todo o ambiente configurado.
1. Baixe e instale o Docker Desktop pelo site oficial.
2. Para simplificar a implantação, use a imagem Docker pronta qwenllm/qwenvl. Instale os drivers necessários e baixe os arquivos do modelo para iniciar o demo.
docker run --gpus all --ipc=host --network=host --rm --name qwen2 -it qwenllm/qwenvl:2-cu121 bashVocê pode conhecer um modelo de geração de código chamado Qwen 2.5 Coder lendo nosso guia Qwen 2.5 Coder: A Guide With Examples.
Usando o chatbot Qwen2.5-VL online
Se você quer experimentar o modelo carro-chefe Qwen2.5-VL 72B Instuct, acesse o site Qwen Chat, crie sua conta e use o modelo como se fosse o ChatGPT. Pode ser necessário selecionar o modelo antes de carregar a imagem.
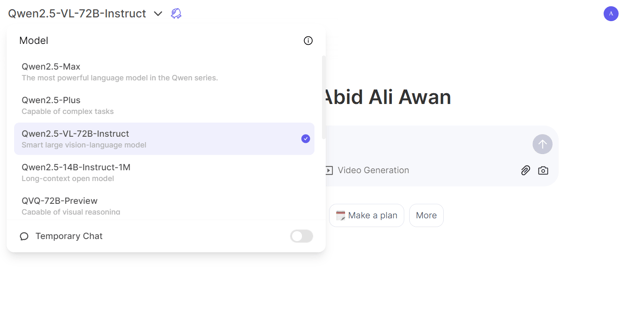
Carregue a imagem e comece a fazer perguntas sobre ela.
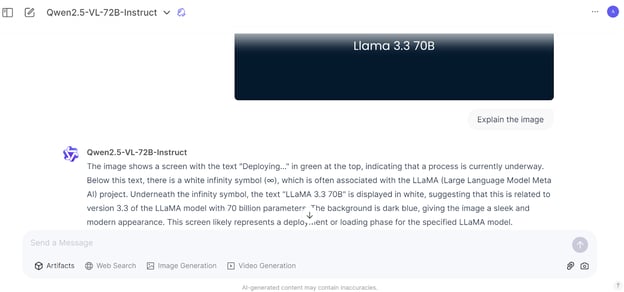
A geração de respostas é rápida e precisa, e com um pouco de dedicação você consegue experimentar um modelo de IA de altíssimo nível.
A Alibaba Cloud oferece todas as ferramentas para você acessar vários modelos de IA via API, com fine-tuning semelhante à plataforma da OpenAI. Leia o Qwen (Alibaba Cloud) Tutorial: Introduction and Fine-Tuning para saber mais.
Conclusão
O Qwen2.5-VL é um vislumbre do futuro da IA, provando que a inovação em modelos avançados não é exclusividade dos EUA ou do Ocidente. Ele oferece precisão excepcional e integração fluida a diferentes fluxos de trabalho, permitindo criar ferramentas de IA sob medida para automatizar tarefas.
Por exemplo, você pode usar o Qwen2.5-VL para configurar um perfil no LinkedIn, preencher todos os detalhes e até publicar artigos em seu nome — tudo com mínimo esforço.
Neste tutorial, você conheceu o Qwen 2.5-VL, um modelo de visão capaz de captar até os menores detalhes de uma imagem. Também vimos como usá-lo localmente em um notebook com GPU. Por fim, criamos uma conta na Qwen e usamos o modelo carro-chefe online, de forma semelhante ao ChatGPT.
Leia sobre a Qwen 2.5-Max da Alibaba, um modelo que compete com GPT-4o, Claude 3.5 Sonnet e DeepSeek V3.

Sou um cientista de dados certificado que gosta de criar aplicativos de aprendizado de máquina e escrever blogs sobre ciência de dados. No momento, estou me concentrando na criação e edição de conteúdo e no trabalho com modelos de linguagem de grande porte.








Depois que o DeepSeek sacudiu o mercado de IA, outra empresa chinesa, a Qwen, lançou vários modelos de ponta que estão superando até os modelos de raciocínio avançado do próprio DeepSeek. Em poucos dias após o lançamento do DeepSeek, a Qwen disponibilizou modelos topo de linha e orientados a tarefas que geram valor real, não apenas chatbots.
Você pode ler o blog I Tested QwQ 32B Preview: Alibaba’s Reasoning Model para saber mais sobre o modelo de raciocínio da Qwen, semelhante ao DeekSeek R1.
Neste tutorial, vamos explorar o Qwen2.5-VL, um modelo de visão e linguagem que superou todos os modelos proprietários em capacidades de visão. Também veremos como usá-lo localmente e como experimentar o modelo carro-chefe online.
Imagem do autor
Se você está começando em IA e em modelos de linguagem (LLMs), vale a pena fazer o curso Introduction to LLMs in Python. Esse curso ajuda você a entender os LLMs e a arquitetura revolucionária de transformers em que eles se baseiam.
Introdução ao Qwen2.5-VL
Qwen2.5-VL é o novo modelo de visão e linguagem carro-chefe da Qwen e representa um salto significativo em relação ao seu antecessor, o Qwen2-VL. Ele estabelece um novo padrão em IA multimodal, não só dominando o reconhecimento de objetos comuns como flores, pássaros, peixes e insetos, mas também analisando textos complexos, gráficos, ícones, ilustrações e layouts dentro de imagens.
Além disso, o Qwen2.5-VL foi projetado para ser altamente agente, capaz de raciocínio dinâmico e de orquestrar ferramentas — seja no computador ou no celular.