
TL;DR
- डेटा एनालिटिक्स प्रोजेक्ट्स वह व्यावहारिक पोर्टफोलियो बनाते हैं जिसे नियोक्ता चाहते हैं—सिर्फ ट्यूटोरियल नहीं, एंड-टू-एंड काम पर ध्यान दें
- शुरुआती डेटा क्लीनिंग और विज़ुअलाइज़ेशन से शुरू करें; उन्नत शिक्षार्थी प्रेडिक्टिव एनालिटिक्स और मशीन लर्निंग पर काम करें
- DataCamp Projects, Python, R, और SQL में गाइडेड और अनगाइडेड हैंड्स-ऑन काम प्रदान करते हैं
- 2026 में, AI-संचालित एनालिटिक्स (NLP, रीयल-टाइम डैशबोर्ड, LLM-असिस्टेड इनसाइट्स) पोर्टफोलियो के लिए सबसे तेजी से बढ़ता क्षेत्र है
- अंतिम-वर्ष के छात्र: वास्तविक डेटासेट्स पर स्पष्ट व्यावसायिक प्रश्न और मापने योग्य परिणामों के साथ रिसर्च-स्टाइल प्रोजेक्ट्स चुनें
- 10+ प्रोजेक्ट्स पूरे करने के बाद, अपनी भर्ती की संभावनाएं बढ़ाने के लिए Professional Data Analyst के रूप में प्रमाणित हों
डेटा एनालिटिक्स प्रोजेक्ट्स क्यों चुनें
आज की डेटा-केंद्रित दुनिया में उत्कृष्टता प्राप्त करने के इच्छुक किसी भी व्यक्ति के लिए डेटा एनालिटिक्स प्रोजेक्ट्स बेहद महत्वपूर्ण पड़ाव हैं। ये इसलिए आवश्यक हैं:
- व्यावहारिक कौशल का प्रयोग: ये हाथों-हाथ अनुभव देते हैं जो सैद्धांतिक ज्ञान और वास्तविक दुनिया के अभ्यास के बीच की खाई भरते हैं।
- उद्योगों में बहुउपयोगिता: डेटा एनालिटिक्स कई क्षेत्रों में अहम है। विविध प्रोजेक्ट्स पर काम करने से आपकी समझ और अनुकूलन क्षमता बढ़ती है।
- आलोचनात्मक सोच: ये प्रोजेक्ट्स आपको जटिल मुद्दों का विश्लेषण करने, पैटर्न पहचानने, और डेटा-आधारित समाधान बनाने की क्षमता विकसित करते हैं।
- तकनीकी दक्षता: प्रोजेक्ट्स में शामिल होकर आप प्रमुख टूल्स और भाषाओं में अपनी स्किल्स को तराशते हैं, जिससे आप और अधिक सक्षम और बहुमुखी विश्लेषक बनते हैं।
- प्रभावी संप्रेषण: ये आपको जटिल डेटा अंतर्दृष्टियों को समझने योग्य और क्रियान्वयन योग्य जानकारी में बदलना सिखाते हैं—जो किसी भी पेशेवर सेटिंग में अत्यधिक मूल्यवान है।
- कैरियर उन्नति: प्रोजेक्ट्स पूरा करने से आपका पोर्टफोलियो मजबूत होता है, संभावित नियोक्ताओं के सामने आपकी क्षमताओं का प्रदर्शन होता है, और अवसर बढ़ते हैं।
संक्षेप में, डेटा एनालिटिक्स प्रोजेक्ट्स न सिर्फ आपकी तकनीकी स्किल्स को निखारते हैं, बल्कि आपको आधुनिक कार्यस्थल की चुनौतियों और मांगों के लिए भी तैयार करते हैं।
शुरुआती के लिए डेटा एनालिटिक्स प्रोजेक्ट्स
शुरुआती के रूप में, आपको डेटा को इंपोर्ट करना, साफ करना, मैनिपुलेट करना और विज़ुअलाइज़ करना सीखना चाहिए।
- डेटा इंपोर्टिंग: SQL, Python, R या वेब स्क्रैपिंग का उपयोग करके डेटा इंपोर्ट करना सीखें।
- डेटा क्लीनिंग: डेटा को साफ और प्रोसेस करने के लिए विभिन्न Python और R लाइब्रेरीज़ का उपयोग करें।
- डेटा मैनिपुलेशन: डेटा विश्लेषण और विज़ुअलाइज़ेशन के लिए डेटासेट को आकार देने की तकनीकों का उपयोग करें।
- डेटा विज़ुअलाइज़ेशन: प्लॉट्स और ग्राफ़्स के जरिए डेटा प्रदर्शित करें।
डेटा इंपोर्टिंग और क्लीनिंग प्रोजेक्ट्स
1. NYC Airbnb मार्केट की पड़ताल
Exploring the NYC Airbnb Market प्रोजेक्ट में, आप न्यूयॉर्क के Airbnb मार्केट का विश्लेषण करने के लिए डेटा इंपोर्टिंग और क्लीनिंग स्किल्स लागू करेंगे। आप कई फ़ाइल प्रकारों से डेटा इन्गेस्ट और कंबाइन करेंगे, और सटीक जानकारी निकालने के लिए स्ट्रिंग्स को साफ करेंगे और तारीखों को फॉर्मैट करेंगे।
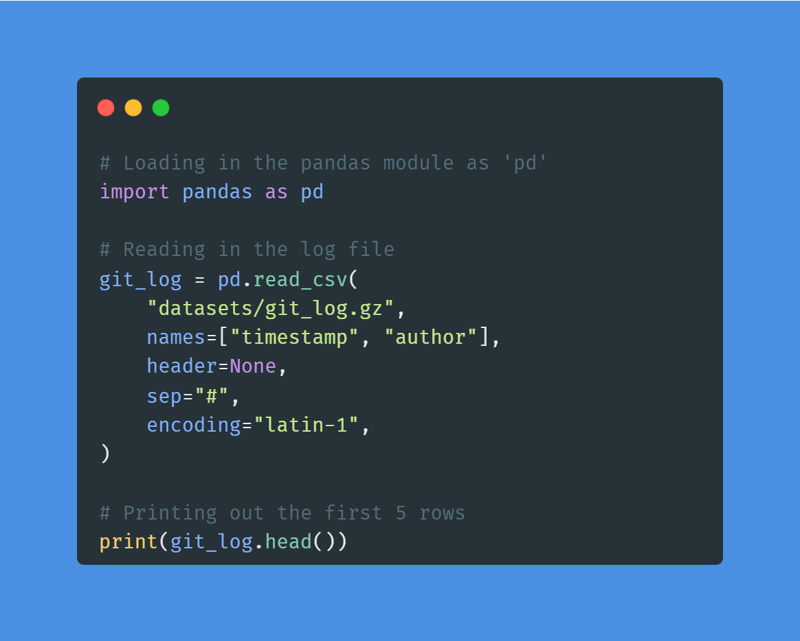
लेखक द्वारा छवि | प्रोजेक्ट का कोड
यह प्रोजेक्ट उन शुरुआती लोगों के लिए परफेक्ट है जो डेटा इंपोर्टिंग और क्लीनिंग का अनुभव लेना चाहते हैं। आप इसी तरह की विधियां इस Online Ticket Sales डेटासेट पर लागू कर सकते हैं ताकि डेटा हैंडलिंग और प्रोसेसिंग में और भी बेहतर हो सकें।
डेटा इंपोर्टिंग और क्लीनिंग के बारे में अधिक जानने के लिए शॉर्ट कोर्स करें:
2. क्लासिक उपन्यासों में शब्द आवृत्ति
Word Frequency in Classic Novels प्रोजेक्ट में, आप Project Gutenberg वेबसाइट से एक उपन्यास स्क्रैप करने के लिए requests और BeautifulSoup का उपयोग करेंगे। टेक्स्ट डेटा को स्क्रैप और साफ करने के बाद, आप NLP का उपयोग करके Moby Dick में सबसे अधिक बार आने वाले शब्द खोजेंगे। यह प्रोजेक्ट आपको Python वेब स्क्रैपिंग और नैचुरल लैंग्वेज प्रोसेसिंग की दुनिया से परिचित कराता है।
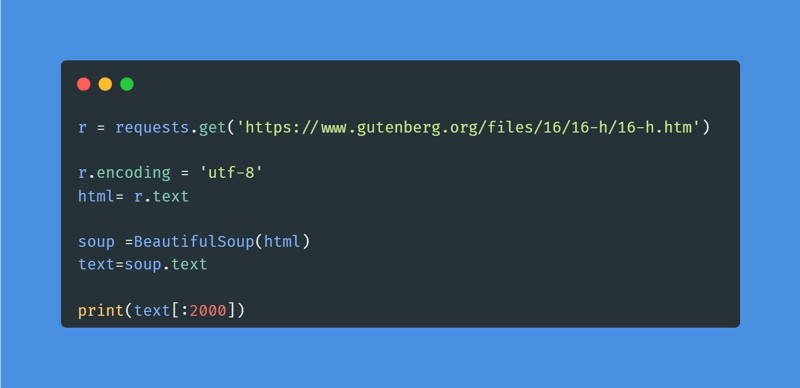
लेखक द्वारा छवि | प्रोजेक्ट का कोड
डेटा विश्लेषकों और डेटा वैज्ञानिकों के लिए, वेब स्क्रैपिंग एक आवश्यक स्किल है। HTML वेब पेज के टूल्स और घटकों को समझने के लिए आप Web Scraping with Python शॉर्ट कोर्स कर सकते हैं।
3. NYC पब्लिक स्कूल के टेस्ट स्कोर की पड़ताल
Exploring NYC Public School Test Result Scores प्रोजेक्ट में, आप न्यूयॉर्क सिटी के पब्लिक स्कूलों में मानकीकृत SAT प्रदर्शन का विश्लेषण करेंगे। आप कॉलम्स (Math, Reading, Writing) को साफ और सारांशित करेंगे, विभिन्न बरो में परिणामों की तुलना करेंगे, Math स्कोर के आधार पर स्कूलों की रैंकिंग करेंगे, और शहर के शीर्ष दस परफॉर्मर्स उजागर करेंगे। इस दौरान, आप कोर एनालिस्ट स्किल्स का अभ्यास करेंगे: टाइप्स सुधारना, मिसिंग वैल्यूज़ हैंडल करना, समूह सांख्यिकी निकालना, और स्कूल-स्तरीय कच्चे डेटा को स्पष्ट, निर्णय-तैयार इनसाइट्स में बदलना।
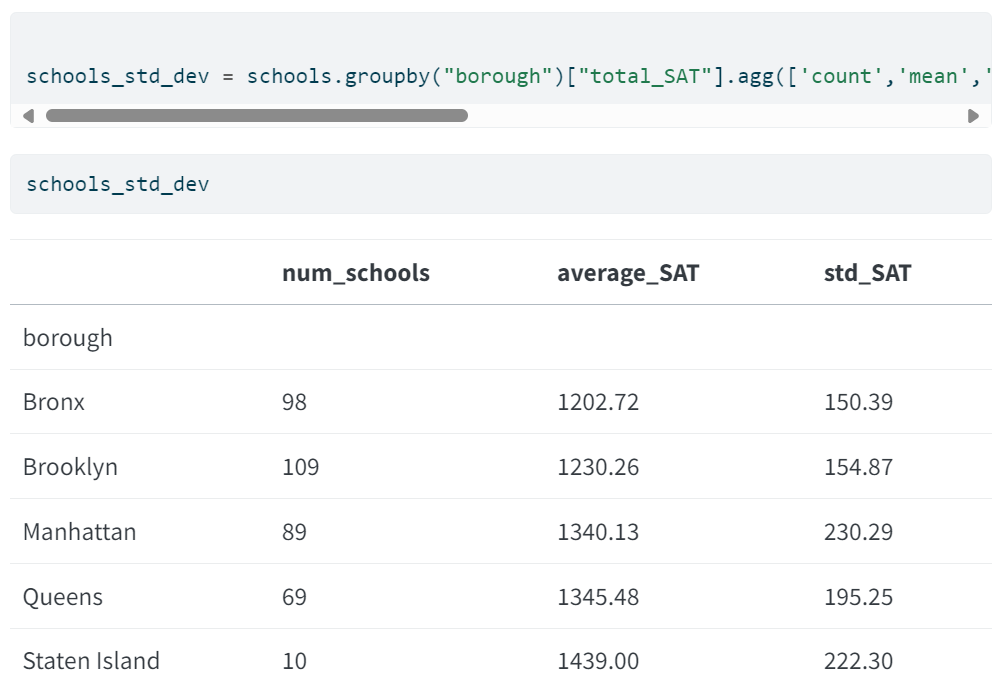
लेखक द्वारा छवि | प्रोजेक्ट का कोड
यह प्रोजेक्ट उन शुरुआती लोगों के लिए उपयुक्त है जो रैंकिंग, बेंचमार्किंग, और भौगोलिक स्लाइसिंग शामिल यथार्थवादी, बिज़नेस-स्टाइल EDA बनाना चाहते हैं। आप इसी कार्यप्रणाली को संबंधित डेटासेट्स, जैसे "Factors that Fuel Student Performance" या अपने स्थानीय जिले के ओपन डेटा पर लागू करके अपने पोर्टफोलियो में तुलनीय और पुनरुत्पाद्य विश्लेषण जोड़ सकते हैं।
डेटा मैनिपुलेशन प्रोजेक्ट्स
4. मोटरसाइकिल पार्ट्स की बिक्री का विश्लेषण
Analyzing Motorcycle Part Sales प्रोजेक्ट में, आप मल्टी-वेयरहाउस सेल्स डेटाबेस पर क्वेरी चलाकर समय, प्रोडक्ट लाइन्स और लोकेशंस में रेवेन्यू पैटर्न खोजेंगे। आप नेट रेवेन्यू (जहां लागू हो, डिस्काउंट/रिटर्न्स सहित) की गणना करेंगे, वेयरहाउस और तारीख के अनुसार सेगमेंट करेंगे, शीर्ष-प्रदर्शन करने वाली प्रोडक्ट कैटेगरीज़ की रैंकिंग करेंगे, और ग्रोथ बनाम डिक्लाइन को उजागर करने के लिए तुलना वाले स्लाइस बनाएंगे।
काफी प्रैक्टिकल SQL की उम्मीद रखें: जॉइन्स, डेट ट्रंकशन, कंडीशनल एग्रीगेशन, और विंडो फ़ंक्शंस—ताकि कच्चे ट्रांज़ैक्शंस को स्पष्ट, एग्जीक्यूटिव-रेडी रिपोर्ट्स में बदला जा सके।
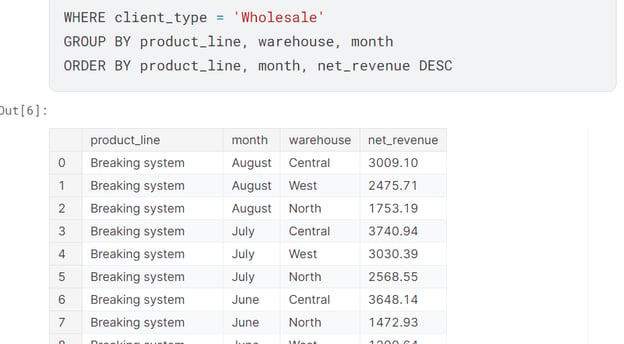
लेखक द्वारा छवि | प्रोजेक्ट का कोड
यह प्रोजेक्ट उन विश्लेषकों के लिए बेहतरीन है जो बिज़नेस-फेसिंग SQL अनुभव चाहते हैं जो वास्तविक काम जैसा हो: KPI परिभाषाएँ, रेवेन्यू रोलअप्स, वेयरहाउस बेंचमार्किंग, और समय-आधारित परफॉर्मेंस ट्रैकिंग—जिन्हें आप सीधे डैशबोर्ड या साप्ताहिक ऑप्स रिपोर्ट में प्लग कर सकते हैं।
5. बिटकॉइन क्रिप्टोकरेंसी मार्केट की पड़ताल
Exploring the Bitcoin Cryptocurrency Market प्रोजेक्ट में, आप बिटकॉइन और अन्य क्रिप्टोकरेंसी डेटा का अन्वेषण करेंगे। आप मार्केट कैपिटलाइज़ेशन के बिना क्रिप्टोकरेंसी को हटाकर डेटासेट को साफ करेंगे, बिटकॉइन की अन्य मुद्राओं से तुलना करेंगे, और विज़ुअलाइज़ेशन के लिए डेटा तैयार करेंगे।
 लेखक द्वारा छवि | प्रोजेक्ट का कोड
आप समान तरीकों को Stock Exchange Data पर लागू कर सकते हैं और डेटा विश्लेषण के लिए डेटा मैनिपुलेट करना सीख सकते हैं। साथ ही, आप Data Manipulation with pandas कोर्स लेकर डेटा ट्रांसफॉर्मेशन, एग्रीगेशन, स्लाइसिंग और इंडेक्सिंग सीख सकते हैं।
6. नोबेल पुरस्कार विजेताओं के इतिहास का विज़ुअलाइज़ेशन
Visualizing the History of Nobel Prize Winners प्रोजेक्ट में, आप एक सदी से भी अधिक के नोबेल पुरस्कार इतिहास की जांच करेंगे। Python का उपयोग करके, आप डेटा का विश्लेषण और विज़ुअलाइज़ेशन करेंगे ताकि फिजिक्स, केमिस्ट्री, लिटरेचर, और पीस जैसी कैटेगरीज़ में सम्मान के वितरण के पैटर्न और संभावित पूर्वाग्रहों को समझा जा सके।
आप pandas के साथ डेटा मैनिपुलेशन तकनीकें लागू करेंगे और Seaborn से प्रभावशाली विज़ुअलाइज़ेशन बनाएंगे ताकि डेटा से कहानी कही जा सके। यह प्रोजेक्ट डेटा विश्लेषण और विज़ुअलाइज़ेशन स्किल्स को निखारने के लिए उपयुक्त है, साथ ही दुनिया के सबसे प्रसिद्ध सम्मान में से एक की पड़ताल भी करता है।
डेटा विज़ुअलाइज़ेशन प्रोजेक्ट्स
7. Plotly के साथ स्टॉक मार्केट ट्रेंड्स की पड़ताल
Exploring Stock Market Trends with Plotly प्रोजेक्ट में, आप फास्ट-फूड दिग्गजों (जैसे McDonald’s, Starbucks) के कच्चे प्राइस डेटा को इंटरैक्टिव चार्ट्स में बदलेंगे जो सेक्टर की गति और पैटर्न दिखाते हैं। आप कैंडलस्टिक और लाइन चार्ट्स बनाएंगे, मूविंग एवरेज और रोलिंग स्टैट्स जोड़ेंगे, कई टिकर्स की तुलना करेंगे, और प्रमुख घटनाओं को एनोटेट करेंगे—ध्यान विज़ुअल स्टोरीटेलिंग पर होगा जो वोलैटिलिटी, सीज़नैलिटी और रिलेटिव परफॉर्मेंस को उजागर करती है।
यह एक विज़ुअलाइज़ेशन-फर्स्ट प्रोजेक्ट है—यदि आप इंटरैक्टिविटी (हॉवर, ज़ूम, रेंज स्लाइडर्स) के जरिए मार्केट इनसाइट दिखाने वाला साफ-सुथरा, पोर्टफोलियो-रेडी डैशबोर्ड बनाना चाहते हैं, तो बिल्कुल उपयुक्त।
8. COVID-19 का विज़ुअलाइज़ेशन
Visualizing COVID-19 प्रोजेक्ट में, आप सबसे लोकप्रिय R लाइब्रेरी ggplot का उपयोग करके COVID-19 डेटा का विज़ुअलाइज़ेशन करेंगे। आप विश्वभर में कन्फर्म्ड केस का विश्लेषण करेंगे, चीन की अन्य देशों से तुलना करेंगे, ग्राफ़ को एनोटेट करना सीखेंगे, और लॉगरिदमिक स्केल जोड़ेंगे। यह प्रोजेक्ट R प्रोग्रामर्स के लिए उच्च मांग वाली स्किल्स सिखाएगा।
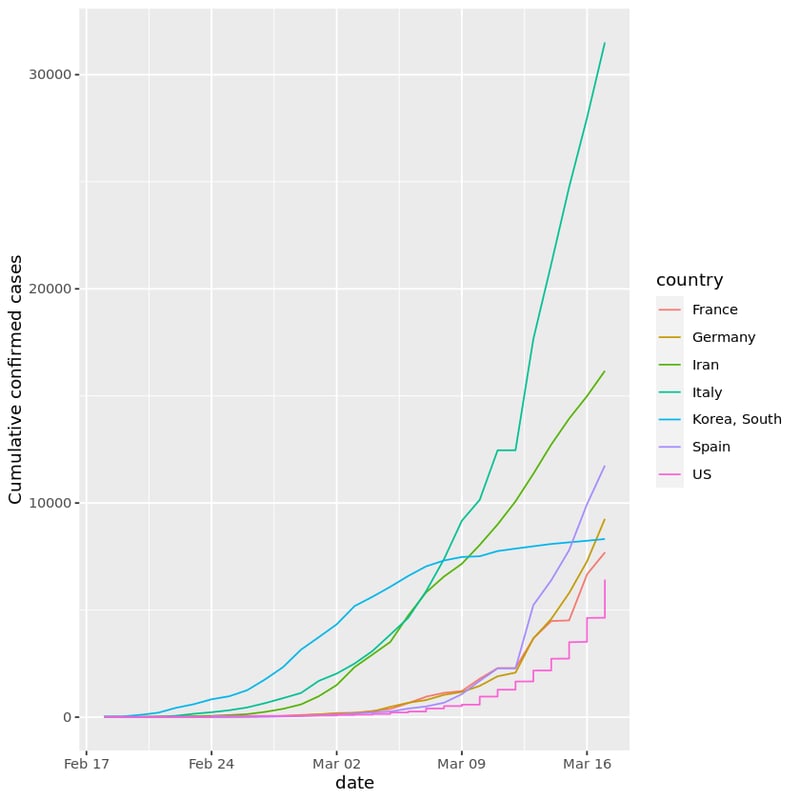
प्रोजेक्ट से छवि
आप Measles Data पर ggplot मेथड्स लागू कर सकते हैं और डेटा विज़ुअलाइज़ेशन व विश्लेषण में और अनुभव प्राप्त कर सकते हैं। इसके अलावा, आप Intermediate Data Visualization with the ggplot2 कोर्स लेकर सर्वश्रेष्ठ डेटा विज़ुअलाइज़ेशन प्रैक्टिसेज़ सीख सकते हैं।
9. सुपर बाउल व्यूअरशिप और विज्ञापन का विश्लेषण
Analyzing Super Bowl Viewership and Advertising प्रोजेक्ट में, आप सुपर बाउल के पीछे की कहानी—गेम्स, विज्ञापनों और हाफटाइम शो तक—की पड़ताल करेंगे। R का उपयोग करके, आप डेटा को मैनिपुलेट और विज़ुअलाइज़ करेंगे ताकि समझ सकें कि ये तत्व एक-दूसरे के साथ कैसे इंटरैक्ट करते हैं। ggplot2 और dplyr जैसे टूल्स के साथ डेटा विश्लेषण कौशल बनाने के लिए उपयुक्त।
इंटरैक्टिव डेटा विज़ुअलाइज़ेशन दिखाने के लिए कोड लिखना आसान है, लेकिन डेटा को समझना और उसकी व्याख्या करना कठिन। जटिल डेटा को संप्रेषित करने के लिए सर्वोत्तम तकनीकों और वितरण की व्याख्या सीखने हेतु Understanding Data Visualization कोर्स करें।
एडवांस्ड डेटा एनालिटिक्स प्रोजेक्ट्स
उन्नत डेटा एनालिटिक्स प्रोजेक्ट्स के लिए, आपको गणित, प्रायिकता, और सांख्यिकी पर पकड़ चाहिए। साथ ही, आप विस्तृत रूप से डेटा समझने के लिए EDA और प्रेडिक्टिव एनालिटिक्स करेंगे।
- प्रायिकता और सांख्यिकी: डेटा पर mean, median, standard deviation, probability distributions, और correlation जैसी गणनाएँ करें।
- एक्सप्लोरेटरी डेटा एनालिसिस: डेटा वितरण की पड़ताल करें, विभिन्न प्रकार के कॉलम्स समझें, और ट्रेंड्स व पैटर्न्स पहचानें।
- प्रेडिक्टिव एनालिटिक्स: मशीन लर्निंग एल्गोरिदम का उपयोग करके रिग्रेशन, क्लासिफिकेशन, क्लस्टरिंग, और फोरकास्टिंग करें।
प्रायिकता और सांख्यिकी प्रोजेक्ट्स
10. कार इंश्योरेंस क्लेम आउटकम्स का मॉडलिंग
Modeling Car Insurance Claim Outcomes प्रोजेक्ट में, आप Python और लॉजिस्टिक रिग्रेशन का उपयोग करके इंश्योरेंस क्लेम्स की भविष्यवाणी करेंगे। On the Road कार इंश्योरेंस के डेटा पर काम करते हुए, आप ऐसे प्रमुख फीचर्स की पहचान करेंगे जो सबसे सटीक प्रेडिक्शंस देते हैं। यह प्रोजेक्ट इंश्योरेंस इंडस्ट्री की वास्तविक व्यावसायिक समस्याओं पर मशीन लर्निंग तकनीक लागू करने में मदद करेगा।
11. पुरुषों और महिलाओं के सॉकर मैचों पर हाइपोथीसिस टेस्टिंग
Hypothesis Testing with Men's and Women's Soccer Matches प्रोजेक्ट में, आप ऐतिहासिक सॉकर डेटा का विश्लेषण करके यह परखेंगे कि क्या महिलाओं के अंतरराष्ट्रीय मैचों में पुरुषों की तुलना में अधिक गोल होते हैं। Python के साथ, आप सांख्यिकीय परीक्षण कौशल निखारेंगे और वैश्विक सॉकर रुझानों में पैटर्न पहचानेंगे।
यदि आप सबसे आम सांख्यिकीय तकनीकें, प्रायिकता, डेटा वितरण, सहसंबंध, और प्रायोगिक डिज़ाइन के बारे में सीखने में रुचि रखते हैं, तो Introduction to Statistics in Python कोर्स करें।
एक्सप्लोरेटरी डेटा एनालिसिस (EDA) प्रोजेक्ट्स
12. अंतरराष्ट्रीय ऋण सांख्यिकी का विश्लेषण
Analyze International Debt Statistics प्रोजेक्ट में, आप वर्ल्ड बैंक डेटासेट का उपयोग करके SQL क्वेरी लिखकर अंतरराष्ट्रीय ऋण का अन्वेषण और विश्लेषण करेंगे। SQL चलते-फिरते डेटा एनालिटिक्स करने का सबसे लोकप्रिय और आवश्यक टूल है।
इस प्रोजेक्ट में, आप निम्नलिखित खोजेंगे:
- अलग-अलग देश
- अलग-अलग ऋण संकेतक
- देशों द्वारा बकाया कुल ऋण राशि
- सबसे अधिक ऋण वाला देश
- संकेतकों में औसत ऋण राशि
- सर्वाधिक मूलधन पुनर्भुगतान की राशि
- सबसे सामान्य ऋण संकेतक
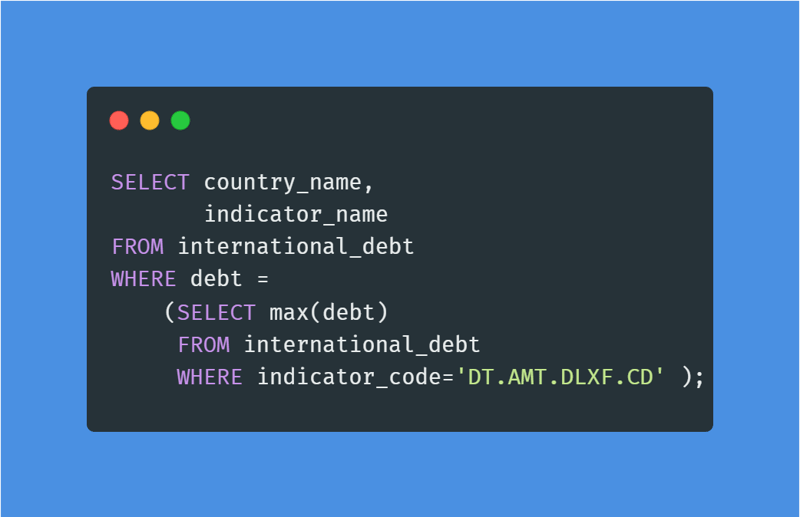
लेखक द्वारा छवि | प्रोजेक्ट का कोड
आप World Nations MariaDB डेटासेट से कनेक्ट करेंगे और समान क्वेरी लागू करके विभिन्न SQL डेटाबेस को हैंडल और विश्लेषित करने का अतिरिक्त अनुभव प्राप्त करेंगे। साथ ही, आप Exploratory Data Analysis in SQL कोर्स कर सकते हैं ताकि विभिन्न SQL डेटाबेस को हैंडल करने की उन्नत तकनीकें और क्वेरी सीख सकें।
13. लॉस एंजिल्स में अपराध का विश्लेषण
Analyzing Crime in Los Angeles प्रोजेक्ट में, आप LAPD के लिए डेटा जासूस की भूमिका निभाते हुए, घटनाओं के डेटा को साफ और सेगमेंट करेंगे ताकि यह जान सकें कि अपराध कब और कहां होने की सबसे अधिक संभावना है और कौन से अपराध प्रकार हावी हैं। आप दिन के समय, सप्ताह के दिन, पड़ोस, और श्रेणी के अनुसार स्लाइस करेंगे; हॉटस्पॉट सारांश निकालेंगे; और तुलना कट बनाएंगे जो सीधे संसाधन-आवंटन इनसाइट्स में बदलते हैं।
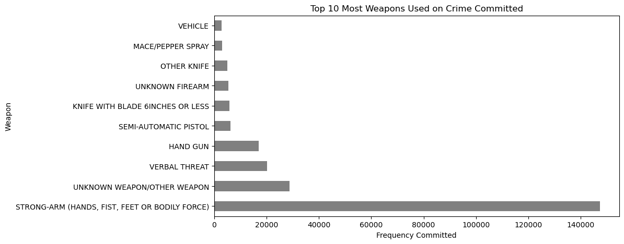
प्रोजेक्ट से छवि
आप अभ्यास करेंगे: डेटा क्लीनिंग, ग्रुपिंग और एग्रीगेशन, समय-आधारित बकेटिंग, रेट नॉर्मलाइज़ेशन (प्रति व्यक्ति या प्रति समय विंडो), शीर्ष-N पड़ोस/अपराधों की रैंकिंग, और निर्णय-निर्माण के लिए समझने योग्य टेबल/चार्ट बनाना।
14. Netflix फ़िल्में और The Office में गेस्ट स्टार्स की जांच
Investigating Netflix Movies and Guest Stars in The Office प्रोजेक्ट में, आप डेटा मैनिपुलेशन और विज़ुअलाइज़ेशन का उपयोग करके वास्तविक दुनिया की डेटा साइंस समस्या हल करेंगे। आप गहन EDA करेंगे और विस्तृत ग्राफ़्स से निष्कर्ष निकालेंगे।
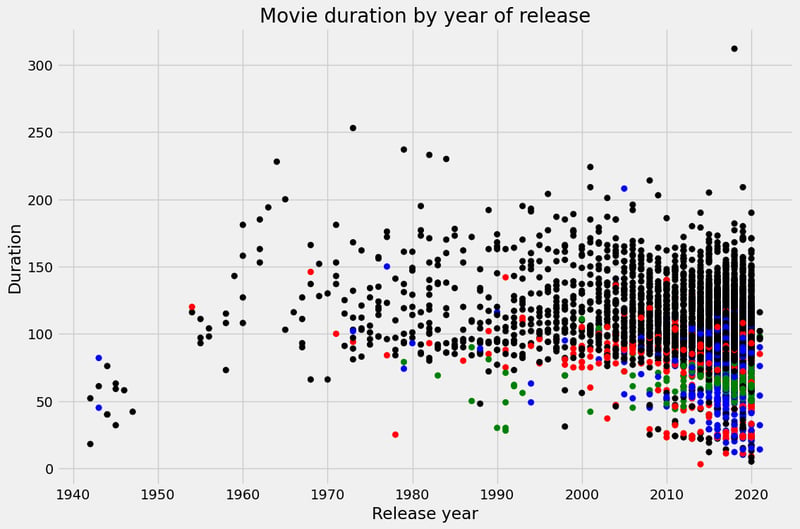
प्रोजेक्ट से छवि
आप नए डेटासेट Netflix Movie Data पर समान स्किल्स लागू करके एक पोर्टफोलियो प्रोजेक्ट पर काम कर सकते हैं। इसके अलावा, Exploratory Data Analysis in Python कोर्स लेकर डेटा क्लीनिंग और वैलिडेशन, संबंध और वितरण को समझना, और मल्टीवेरिएट रिलेशनशिप्स की पड़ताल करना सीखें।
प्रेडिक्टिव एनालिटिक्स प्रोजेक्ट्स
15. फास्ट-फूड मेनू आइटम्स की भविष्य की बिक्री का पूर्वानुमान
Predict Future Sales of Fast-Food Menu Items प्रोजेक्ट में, आप एक फास्ट-फूड चेन को ओवरस्पेंडिंग और जल्दबाजी के ऑर्डर्स कम करने में मदद करेंगे—टॉप मेनू आइटम्स के लिए सेल्स प्रेडिक्शन मॉडल बनाकर। आप बिज़नेस समस्या को फ्रेम करेंगे, कैलेंडर/प्रोमोशनल फीचर्स इंजीनियर करेंगे, समय-सचेत स्प्लिट्स बनाएंगे, R में रिग्रेशन मॉडल फिट और तुलना करेंगे, और RMSE/MAE से प्रभाव मापेंगे—ऐतिहासिक POS डेटा को अधिक सटीक और किफायती ऑर्डर प्लान्स में बदलते हुए।
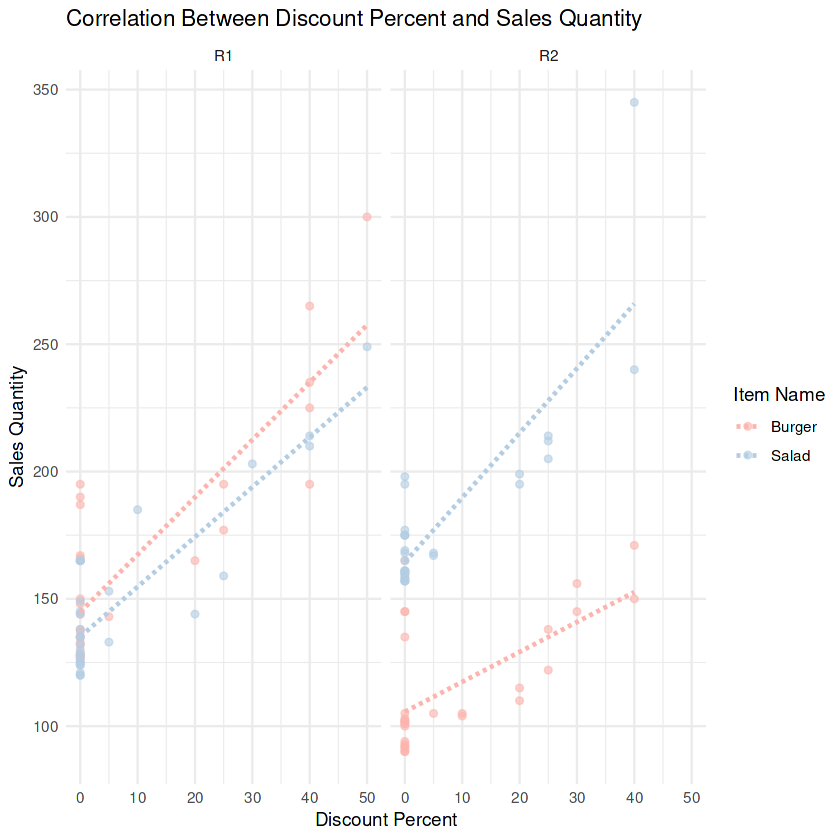
प्रोजेक्ट से छवि
आप फीचर इंजीनियरिंग का अभ्यास करेंगे—जैसे सप्ताह का दिन, छुट्टियां, और प्रमोशंस; लीक-सेफ ट्रेन/टेस्ट स्प्लिट्स; बेसलाइन बनाम ट्यून किए गए मॉडल; क्रॉस-वैलिडेशन; RMSE/MAE रिपोर्टिंग; सरल बैकटेस्टिंग; और मॉडल परिणामों को ऑर्डरिंग सिफारिशों में बदलना।
16. क्या यह ग्राहक आपका प्रोडक्ट खरीदेगा?
Will This Customer Purchase Your Product? प्रोजेक्ट में, आप सांख्यिकी और प्रायिकता तकनीकों का उपयोग करके ग्राहकों के शॉपिंग व्यवहार का विश्लेषण करेंगे। Python के साथ, आप नए और लौटकर आने वाले ग्राहकों के बीच के अंतर के बारे में इनसाइट्स खोजेंगे, जिससे मार्केटिंग टीमें ई-कॉमर्स प्लेटफॉर्म्स पर एंगेजमेंट को बेहतर समझ सकें।
17. क्रेडिट कार्ड अप्रूवल्स की भविष्यवाणी
Predicting Credit Card Approvals प्रोजेक्ट में, आप क्रेडिट कार्ड एप्लिकेशन अप्रूवल्स की भविष्यवाणी के लिए सबसे अच्छा प्रदर्शन करने वाला मशीन लर्निंग मॉडल बनाएंगे।
सबसे पहले, आप डेटा को समझेंगे और मिसिंग वैल्यूज़ को इम्प्यूट करेंगे। उसके बाद, आप डेटा को प्रीप्रोसेस करेंगे और ट्रेनिंग सेट पर लॉजिस्टिक रिग्रेशन मॉडल ट्रेन करेंगे। अंत में, आप परिणामों का मूल्यांकन करेंगे और ग्रिड सर्चिंग का उपयोग कर मॉडल परफॉर्मेंस में सुधार करेंगे।
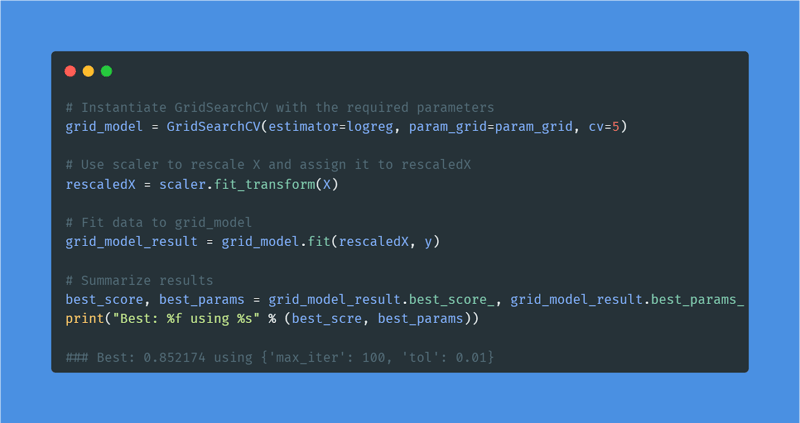
लेखक द्वारा छवि | प्रोजेक्ट का कोड
सरल मशीन लर्निंग एल्गोरिदम लागू करना एक डेटा विश्लेषक के काम का अहम हिस्सा है। आप नए डेटासेट Bank Marketing पर समान तरीकों को लागू करके अधिक अनुभव प्राप्त कर सकते हैं।
क्लासिफिकेशन, रिग्रेशन, फाइन-ट्यूनिंग, और प्रीप्रोसेसिंग के बारे में अधिक जानने के लिए Supervised Learning with the scikit-learn शॉर्ट कोर्स करें।
अंतिम-वर्ष के छात्रों के लिए डेटा एनालिटिक्स प्रोजेक्ट्स
अंतिम-वर्ष के छात्र प्रोजेक्ट्स आमतौर पर रिसर्च-आधारित होते हैं और इन्हें पूरा करने में कम से कम 2–3 महीने लगते हैं। आप एक विशिष्ट विषय पर काम करेंगे और विभिन्न सांख्यिकीय और प्रायिकता तकनीकों का उपयोग करके परिणामों में सुधार करने की कोशिश करेंगे।
नोट: डेटा एनालिटिक्स के अंतिम-वर्ष प्रोजेक्ट्स में मशीन लर्निंग प्रोजेक्ट्स की प्रवृत्ति बढ़ रही है।
18. लंदन के ट्रैवल नेटवर्क की पड़ताल
Exploring London’s Travel Network प्रोजेक्ट में, आप 12 वर्षों (2010–2022) के TfL यात्राओं के साथ एक वेयरहाउस (Snowflake/Redshift/BigQuery/Databricks) पर क्वेरी करेंगे ताकि समझ सकें कि लंदनवासी कैसे यात्रा करते हैं। आप सबसे लोकप्रिय परिवहन मोड्स की रैंकिंग करेंगे, उन अवधियों को चिन्हित करेंगे जब लंदन केबल कार असामान्य रूप से व्यस्त थी, और वे दुर्लभ समय-खिड़कियां पहचानेंगे जब अंडरग्राउंड सामान्य से शांत था—कच्ची यात्राओं को शेड्यूलिंग और क्षमता योजना के लिए ऑपरेशनल इनसाइट्स में बदलते हुए।
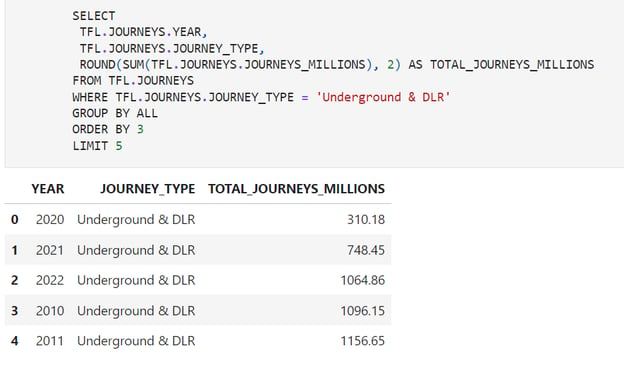
प्रोजेक्ट से छवि
आप समय बकेटिंग (माह/वर्ष), विंडो और एग्रीगेट फ़ंक्शंस, मोड/लाइन के अनुसार कंडीशनल एग्रीगेशन, विसंगतियों को पकड़ना (असामान्य रूप से व्यस्त या शांत अवधियाँ), सीज़नैलिटी (इवेंट्स/छुट्टियाँ) की जाँच, और ट्रांसपोर्ट ऑपरेशंस के लिए टिडी KPI टेबल्स बनाना—इन सबका अभ्यास करेंगे।
19. USA में ट्रैफिक मृत्यु दर कम करना
Reducing Traffic Mortality in the USA प्रोजेक्ट के लिए, आप USA में ट्रैफिक-संबंधित मौतों को कम करने की एक अच्छी रणनीति खोजेंगे। आप डेटा को इंपोर्ट, क्लीन, मैनिपुलेट और विज़ुअलाइज़ करेंगे। साथ ही, आप फीचर इंजीनियरिंग करेंगे और विभिन्न मशीन लर्निंग मॉडल (मल्टीवेरिएट लीनियर रिग्रेशन, KMeans क्लस्टरिंग) लागू करेंगे ताकि नीतिगत सिफारिशें बना सकें और परिणाम संप्रेषित कर सकें।
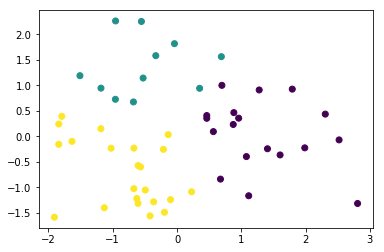
प्रोजेक्ट से छवि
यदि आप अनसुपरवाइज्ड लर्निंग के बारे में अधिक सीखना चाहते हैं, तो Cluster Analysis in Python कोर्स देखें।
20. चिकित्सा उपचारों की प्रभावशीलता का मूल्यांकन
Assessing the Effectiveness of Medical Treatments प्रोजेक्ट में, आप किडनी स्टोन उपचार अध्ययन में Simpson’s Paradox के रोचक मामले की पड़ताल करेंगे। R का उपयोग करते हुए, आप रिग्रेशन विश्लेषण लागू करेंगे ताकि छिपी अंतर्दृष्टियाँ सामने आ सकें और समझ सकें कि विभिन्न रोगी समूहों में परिणाम कैसे भिन्न होते हैं।
21. डिमांड फोरकास्टिंग मॉडल बनाना
Building a Demand Forecasting Model प्रोजेक्ट में, आप PySpark के साथ ई-कॉमर्स प्रोडक्ट डिमांड की भविष्यवाणी करेंगे, जैसे स्टॉक प्लानिंग और रीप्लेनिशमेंट फ्रीक्वेंसी जैसे वास्तविक सप्लाई-चेन प्रश्नों का उत्तर देते हुए। आप टेम्पोरल फीचर्स (सप्ताह का दिन, सीज़नैलिटी, छुट्टियाँ) इंजीनियर करेंगे, समय-सचेत वैलिडेशन स्प्लिट्स बनाएंगे, स्केल पर फोरकास्टिंग बेसलाइंस बनाम ML मॉडल ट्रेन और तुलना करेंगे, और रोलिंग बैकटेस्ट्स चलाकर स्थिरता मापेंगे—ऑर्डर हिस्ट्री को क्रियान्वयन योग्य परचेज़िंग प्लान्स में बदलते हुए।
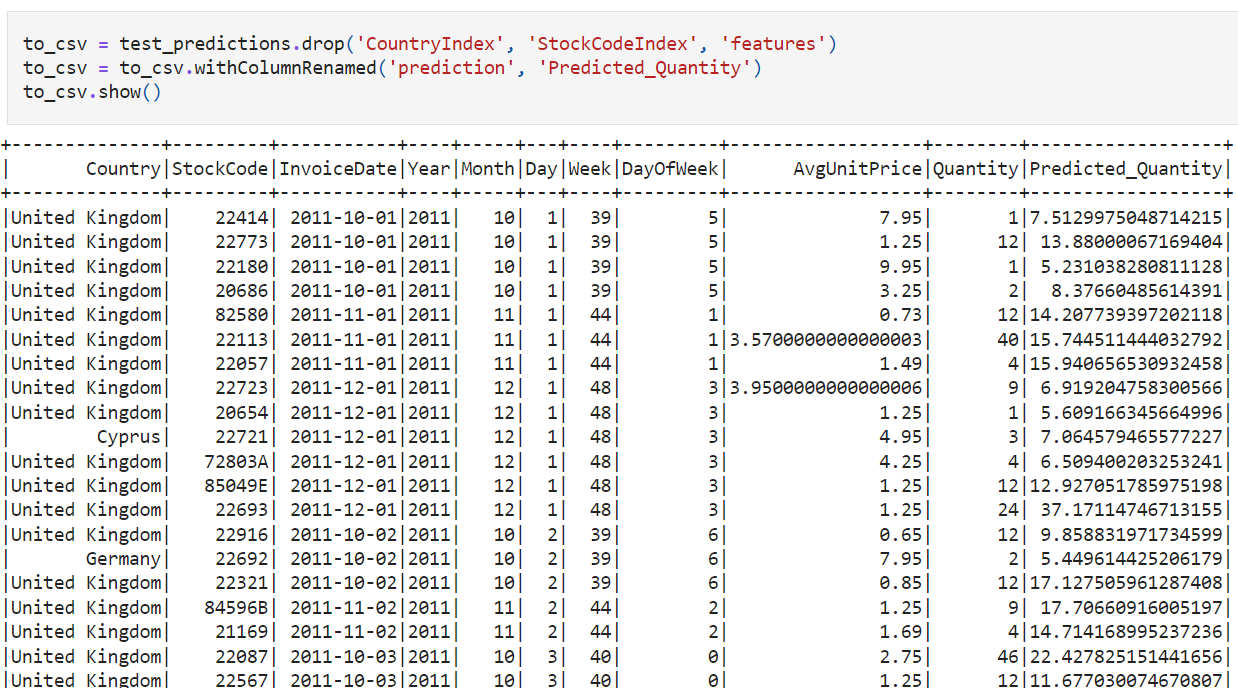
प्रोजेक्ट से छवि
आप बड़े पैमाने पर फीचर इंजीनियरिंग, Spark जॉइन्स/विंडो ऑपरेशन्स, लीक-सेफ वैलिडेशन, बेसलाइन बनाम ट्यून किए गए मॉडल, RMSE/MAE एरर विश्लेषण, रोलिंग/ब्लॉक्ड बैकटेस्ट्स, और परिदृश्य विश्लेषण (प्रमोशंस और सीज़नैलिटी सहित) का अभ्यास करेंगे।
22. सोशल नेटवर्क्स: एक Twitter नेटवर्क विश्लेषण
Social Networks: A Twitter Network Analysis प्रोजेक्ट में, आप pandas और NetworkX के साथ फॉलोअर डेटा का विश्लेषण करेंगे ताकि इन्फ्लुएंसर्स, ब्रिजेज़, और कम्युनिटी स्ट्रक्चर्स की पहचान कर सकें। आप एज लिस्ट्स को लोड/क्लीन करने के लिए रीउसएबल फ़ंक्शंस बनाएंगे, ग्राफ़ बनाएंगे, सेंट्रेलिटी मेट्रिक्स (डिग्री, बिट्वीननेस, आइगेनवेक्टर) की गणना करेंगे, कम्युनिटीज़ डिटेक्ट करेंगे, ईगो-नेट्स निरीक्षण करेंगे, और नेटवर्क टोपोलॉजी का विज़ुअलाइज़ेशन करेंगे—कच्चे कनेक्शंस को स्पष्ट, क्रियान्वयन योग्य इनसाइट्स में बदलते हुए।
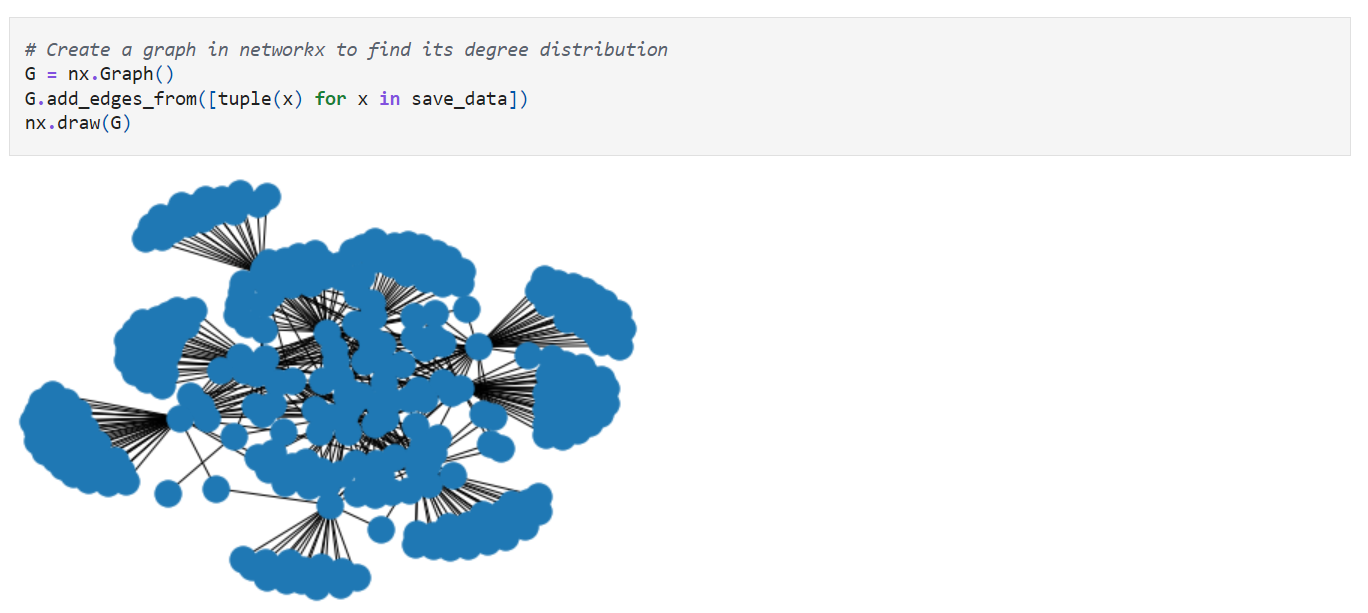
आप अभ्यास करेंगे: फॉलोअर डेटा से ग्राफ़ निर्माण, Pandas से डेटा क्लीनिंग, सेंट्रेलिटी और कम्युनिटी डिटेक्शन, प्रभावशाली अकाउंट्स की रैंकिंग, ईगो-नेट एक्सप्लोरेशन, और स्पष्ट निष्कर्षों वाले पठनीय नेटवर्क विज़ुअलाइज़ेशन बनाना।
23. विश्व जनसंख्या विश्लेषण
World Population Analysis प्रोजेक्ट गहन एक्सप्लोरेटरी विश्लेषण करने का बेहतरीन उदाहरण है। आप विभिन्न कॉलम्स की पड़ताल करेंगे, सबसे कम और सबसे अधिक आबादी वाले देशों का विज़ुअलाइज़ेशन करेंगे, और जनसंख्या घनत्व और वृद्धि दर का अन्वेषण करेंगे। साथ ही, आप देश रैंक वितरण और कोरिलेशन मैप प्रदर्शित करेंगे।
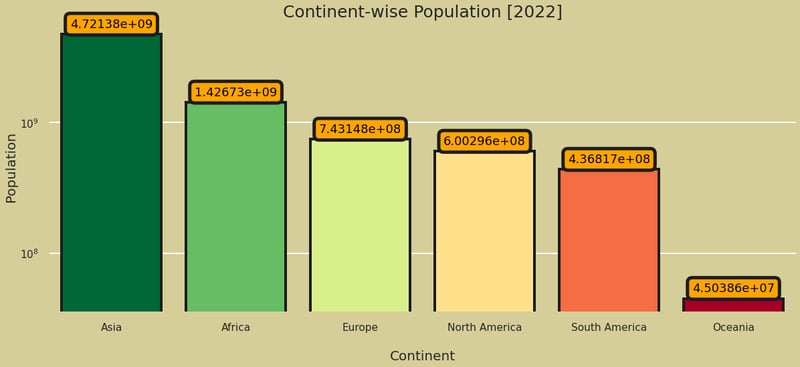
प्रोजेक्ट से छवि
Python में डेटा विज़ुअलाइज़ेशन प्लॉट करने के आसान तरीके सीखने के लिए Intermediate Data Visualization with Seaborn कोर्स पूरा करें।
24. उद्योग में डेटा साइंस और MLOps परिदृश्य
Data Science and MLOps Landscape in Industry प्रोजेक्ट डेटा मैनिपुलेशन, विज़ुअलाइज़ेशंस, EDA और जियोस्पैशियल विश्लेषण के लिए एक संपूर्ण संदर्भ है। आप बॉक्स प्लॉट्स, डोनट चार्ट्स, बार चार्ट्स, हीटमैप्स, पैरेलल कैटेगॉरिकल ग्राफ़्स, बबल चार्ट्स, फनल चार्ट्स, रडार चार्ट्स, आइसिकल चार्ट्स, और मैप्स का प्रभावी उपयोग करना सीखेंगे। साथ ही, आप विभिन्न प्रकार के ग्राफ़्स की व्याख्या करना भी सीखेंगे।
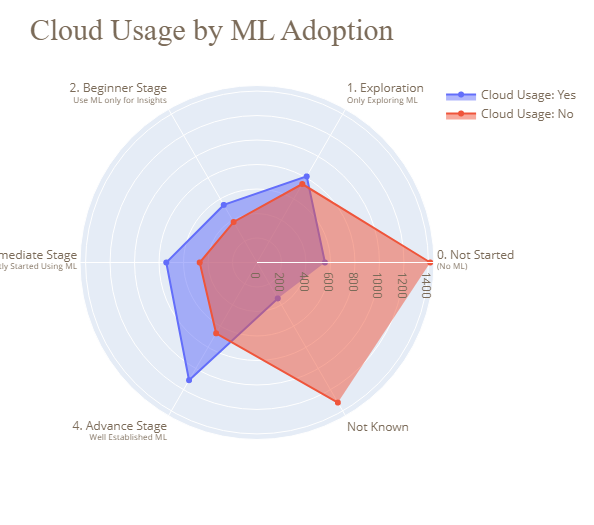
प्रोजेक्ट से छवि
Introduction to Data Visualization with Plotly in Python कोर्स करें ताकि उन्नत Plotly फीचर्स और कस्टमाइज़ेशन के बारे में जान सकें।
AI-संचालित डेटा एनालिटिक्स प्रोजेक्ट्स
2026 में, सबसे अधिक मांग वाले विश्लेषक पारंपरिक एनालिटिक्स को AI टूल्स के साथ मिलाते हैं। कंपनियां ऐसे प्रोफेशनल्स चाहती हैं जो अनस्ट्रक्चर्ड डेटा के साथ काम कर सकें, रीयल-टाइम पाइपलाइंस बना सकें, और इनसाइट्स को साधारण भाषा में समझा सकें। ये दो प्रोजेक्ट्स सीधे उसी कमी को संबोधित करते हैं।
25. ग्राहक समीक्षाओं पर सेंटिमेंट एनालिसिस
Sentiment Analysis Complete Project में, आप Python और NLP का उपयोग करके वास्तविक दुनिया के डेटासेट से हजारों अनस्ट्रक्चर्ड टेक्स्ट सैंपल्स को प्रीप्रोसेस करेंगे, टोकनाइज़ेशन और स्टॉप-वर्ड रिमूवल करेंगे, फिर सेंटिमेंट क्लासिफिकेशन और स्कोरिंग के लिए मशीन लर्निंग मॉडल लागू करेंगे। यह एंड-टू-एंड वर्कफ़्लो बिखरे हुए टेक्स्ट डेटा को स्पष्ट पॉज़िटिव/नेगेटिव प्रेडिक्शंस में बदलता है—एक्युरेसी मेट्रिक्स, मॉडल इवैल्युएशन, और विज़ुअलाइज़ेशंस के साथ।
यह टेक्स्ट प्रीप्रोसेसिंग और क्लासिफिकेशन में व्यावहारिक स्किल्स दिखाता है, जिससे यह ग्राहक इनसाइट्स या सोशल मीडिया मॉनिटरिंग भूमिकाओं पर केंद्रित डेटा विश्लेषक पोर्टफोलियो के लिए आदर्श बनता है।
अपने NLP कौशल को Introduction to Natural Language Processing in Python कोर्स के साथ गहरा करें।
26. Prophet के साथ स्टोर सेल्स फोरकास्टिंग
Store Sales Time-Series Forecasting प्रोजेक्ट में, आप 50+ स्टोर्स और 30 प्रोडक्ट फैमिलीज़ में इक्वाडोरियन ग्रोसरी चेन डेटा का उपयोग करते हुए एक वास्तविक Kaggle प्रतियोगिता का सामना करेंगे। Facebook की Prophet लाइब्रेरी लागू करके आप तेल की कीमतों, छुट्टियों, प्रमोशंस, और मल्टी-सीरीज़ सीज़नैलिटी को ध्यान में रखते हुए बिक्री का पूर्वानुमान लगाएंगे
प्रोजेक्ट में फीचर इंजीनियरिंग, क्रॉस-वैलिडेशन, और Prophet व LightGBM के एंसेंबल मॉडल शामिल हैं—प्रोडक्शन-ग्रेड एक्युरेसी के लिए।
एंड-टू-एंड डेटा एनालिटिक्स प्रोजेक्ट्स
एंड-टू-एंड प्रोजेक्ट्स आपके रिज्यूमे और डेटा एनालिटिक्स प्रोजेक्ट लाइफ साइकिल की समझ के लिए बेहतरीन हैं।
आम तौर पर, आप यह करेंगे:
- कई डेटासेट्स से निपटना
- डेटा वितरण को समझना
- डेटा क्लीनिंग और मैनिपुलेशन लागू करना
- प्रायिकता और सांख्यिकीय तकनीक लागू करना
- डेटा विश्लेषण और विज़ुअलाइज़ेशन करना
- प्रेडिक्टिव एनालिसिस के लिए मशीन लर्निंग मॉडल का उपयोग करना
- रिपोर्ट या डैशबोर्ड बनाना
27. यूनिकॉर्न कंपनियों का विश्लेषण
Analyzing Unicorn Companies प्रोजेक्ट में, आप SQL का उपयोग करके $1 बिलियन से अधिक मूल्यांकन वाली यूनिकॉर्न कंपनियों का अन्वेषण करेंगे। आप विश्लेषण करेंगे कि किन उद्योगों के मूल्यांकन सबसे अधिक हैं और 2019 से 2021 के बीच नए यूनिकॉर्न्स की वार्षिक वृद्धि जैसे उभरते रुझानों की पहचान करेंगे।
28. वित्तीय फ्रॉड डिटेक्शन मॉडल की मॉनिटरिंग
Monitoring a Financial Fraud Detection Model प्रोजेक्ट में, आप एक बड़े UK बैंक के लिए पोस्ट-डिप्लॉयमेंट डेटा वैज्ञानिक की भूमिका निभाएंगे। Python का उपयोग करके, आप एक फ्रॉड डिटेक्शन मॉडल के प्रदर्शन की निगरानी करेंगे और यह जांचेंगे कि यह उम्मीद के मुताबिक काम क्यों नहीं कर रहा हो सकता—ताकि ग्राहकों की वित्तीय सुरक्षा सुनिश्चित की जा सके।
29. Python के साथ टाइम सीरीज़ विश्लेषण और फोरकास्टिंग पर एंड-टू-एंड प्रोजेक्ट
Time Series Analysis and Forecasting प्रोजेक्ट में, आप ट्रेंड्स का गहराई से विश्लेषण करेंगे, फोरकास्टिंग के लिए ARIMA मॉडल लागू करेंगे, परिणामों की तुलना करेंगे, और फर्नीचर व ऑफिस सप्लाई—दोनों की बिक्री को समझने के लिए परिणामों का विज़ुअलाइज़ेशन करेंगे।
टाइम-सीरीज़ विश्लेषण और फोरकास्टिंग प्रोजेक्ट्स वित्तीय क्षेत्रों में उच्च मांग में हैं, और ये आपको उच्च वेतन वाली नौकरी दिलाने में मदद करेंगे। आपको बस अलग-अलग ट्रेंड्स की व्याख्या करनी है और संख्याओं का सटीक पूर्वानुमान लगाना है।
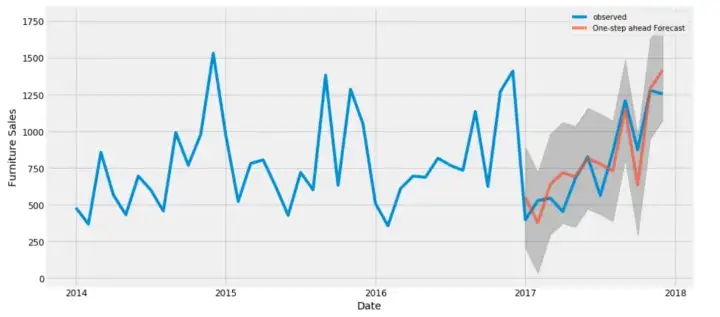
प्रोजेक्ट से छवि
यदि आपको विश्लेषण और फोरकास्टिंग में कठिनाई हो रही है, तो ARIMA Models in Python कोर्स पूरा करें—ARMA मॉडल, फ्यूचर फिटिंग, सर्वश्रेष्ठ मॉडल चयन, और सीज़नल ARIMA मॉडल ट्रेनिंग सीखने के लिए।
30. मल्टी-ऑब्जेक्टिव रिकमेन्डर सिस्टम बनाएं
Build a multi-objective recommender system प्रोजेक्ट का लक्ष्य ई-कॉमर्स क्लिक्स, कार्ट एडिशन्स, और ऑर्डर्स की भविष्यवाणी करना है। संक्षेप में, आप यूज़र सेशन में पिछले इवेंट्स के आधार पर एक मल्टी-ऑब्जेक्टिव रिकमेन्डर सिस्टम बनाएंगे।
प्रोजेक्ट पूरा करने पर, आप महारत हासिल करेंगे:
- डेटा मैनिपुलेशन और विश्लेषण
- सेशंस और इवेंट्स को समझना
- डेटा विज़ुअलाइज़ेशन और रिपोर्टिंग
- टाइम सीरीज़ डेटा हैंडल करना
- यूज़र बिहेवियर की पड़ताल हेतु टाइम सीरीज़ डेटा का विश्लेषण
- टॉप क्लिक्स, कार्ट्स, और ऑर्डर्स की भविष्यवाणी
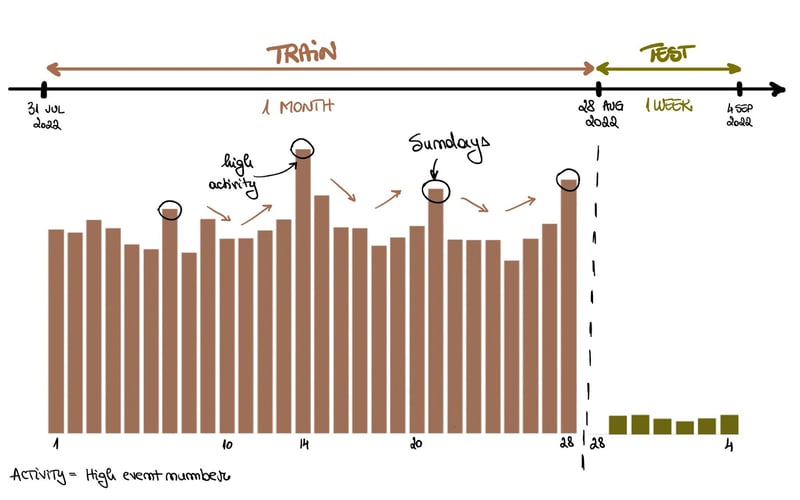
प्रोजेक्ट से छवि
अपने डेटा एनालिटिक्स प्रोजेक्ट्स को कैसे प्रदर्शित करें
किसी प्रोजेक्ट को पूरा करना आधा काम है—उसे नियोक्ताओं के सामने प्रभावी ढंग से प्रस्तुत करना उतना ही महत्वपूर्ण है। यहां बताया गया है कि अपने प्रोजेक्ट्स को खोजने योग्य पोर्टफोलियो एसेट्स में कैसे बदलें:
- GitHub: अपनी नोटबुक्स और कोड को एक स्ट्रक्चर्ड README के साथ अपलोड करें जो बिज़नेस समस्या, आपका दृष्टिकोण, और प्रमुख निष्कर्ष समझाए। रिक्रूटर्स कोड क्वालिटी और डाक्यूमेंटेशन आदतों का आकलन करने के लिए GitHub ब्राउज़ करते हैं।
- Kaggle: नोटबुक्स को सार्वजनिक रूप से प्रकाशित करें ताकि डेटा साइंस कम्युनिटी तक पहुंच बने, पद्धति पर फीडबैक मिले, और Kaggle के सर्च व प्रतियोगिता इकोसिस्टम के जरिए दृश्यता बढ़े।
- सारांश लिखें: अपने निष्कर्षों को ब्लॉग पोस्ट या LinkedIn आर्टिकल में डॉक्यूमेंट करें। अपनी सोच और निष्कर्ष समझाना—डेटा विश्लेषक में सबसे मूल्यवान कौशलों में से एक—का प्रदर्शन करता है।
- पोर्टफोलियो साइट: अपने सर्वश्रेष्ठ 3–5 प्रोजेक्ट्स को GitHub Pages या Notion साइट पर एकत्र करें। कुछ मजबूत प्रोजेक्ट्स का केंद्रित, पॉलिश्ड पोर्टफोलियो अधूरे प्रोजेक्ट्स की लंबी सूची से आमतौर पर अधिक प्रभावी होता है।
DataCamp for Business के साथ अपनी टीम की वृद्धि का समर्थन
जहां व्यक्तिगत प्रोजेक्ट्स व्यक्तिगत स्किल विकास के लिए आवश्यक हैं, वहीं संगठनों को यह भी सुनिश्चित करना होता है कि उनकी टीमें डेटा एनालिटिक्स की जटिलताओं को संभालने के लिए अच्छी तरह से सुसज्जित हों। DataCamp for Business अनुकूलित समाधान प्रदान करता है जो कंपनियों को डेटा साइंस, एनालिटिक्स, और मशीन लर्निंग में अपने कर्मचारियों को अपस्किल करने में मदद करता है। इंटरएक्टिव कोर्सेज़ की विशाल लाइब्रेरी, कस्टम लर्निंग ट्रैक्स, और वास्तविक दुनिया के प्रोजेक्ट्स तक पहुंच के साथ, टीमें डेटा इनजेशन, क्लीनिंग, मैनिपुलेशन, विज़ुअलाइज़ेशन, और प्रेडिक्टिव एनालिटिक्स—यानी इस ब्लॉग में हाइलाइट किए गए सभी प्रमुख क्षेत्रों—में अपनी स्किल्स बढ़ा सकती हैं।
चाहे आप एक छोटा स्टार्टअप हों या बड़ा एंटरप्राइज़, DataCamp for Business आज के बाजार में प्रतिस्पर्धी बने रहने के लिए अपस्किल, रिस्किल, और डेटा-ड्रिवन संस्कृति बनाने के टूल्स प्रदान करता है। अधिक जानने के लिए आप आज ही डेमो का अनुरोध करें।
निष्कर्ष
आवश्यक स्किल्स सीखने के बाद, अपने ज्ञान को प्रदर्शित करने के लिए आपको एक मजबूत पोर्टफोलियो बनाना चाहिए। साथ ही, आप नए टूल्स, फीचर्स, और कॉन्सेप्ट्स सीखते रहेंगे जो आपके प्रोफेशनल जीवन के लिए लाभदायक हैं।
इस पोस्ट में, हमने शुरुआती-अनुकूल प्रोजेक्ट्स, उन्नत प्रोजेक्ट्स, अंतिम-वर्ष के छात्र प्रोजेक्ट्स, और एंड-टू-एंड डेटा एनालिटिक्स प्रोजेक्ट्स के बारे में सीखा। इसके अलावा, हमने डेटा इनजेशन और क्लीनिंग, प्रायिकता और सांख्यिकी, डेटा मैनिपुलेशन और विज़ुअलाइज़ेशन, तथा एक्सप्लोरेटरी डेटा और प्रेडिक्टिव एनालिसिस पर आधारित प्रोजेक्ट्स कवर किए।
अब आगे क्या? कम से कम 12 प्रोजेक्ट्स पूरे करने के बाद, Professional Data Analyst के रूप में प्रमाणित होने की कोशिश करें। इससे नौकरी मिलने की आपकी संभावना बढ़ेगी। आप हमारे डेटा एनालिस्ट कैसे बनें और डेटा एनालिस्ट रिज्यूमे कैसे बनाएं वाले पोस्ट भी अधिक करियर टिप्स के लिए देख सकते हैं।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
डेटा एनालिटिक्स की बुनियादी बातें सीखने के बाद, अब प्रोजेक्ट्स पर काम करके अपनी स्किल्स लागू करने का समय है। कंपनियां ऐसे छात्रों को प्राथमिकता देती हैं जिनके पास कई प्रोजेक्ट्स का अनुभव हो, और वे ऐसे कर्मचारियों की तलाश में हैं जो डेटा इनजेशन और क्लीनिंग, डेटा मैनिपुलेशन, प्रायिकता और सांख्यिकी, प्रेडिक्टिव एनालिटिक्स, और रिपोर्टिंग में अच्छे हों।
यह नई भाषा या टूल्स सीखने के बारे में नहीं है। बात डेटा को समझने और महत्वपूर्ण जानकारी निकालने की है। आपको डेटा को बेहतर समझने और गैर-तकनीकी लोगों के लिए रिपोर्ट्स बनाने में निपुण होने के लिए कई प्रोजेक्ट्स पर काम करना होगा।
यह ब्लॉग शुरुआती, पेशेवरों, और अंतिम-वर्ष के छात्रों के लिए डेटा एनालिटिक्स प्रोजेक्ट्स को कवर करता है। साथ ही, आप एंड-टू-एंड प्रोजेक्ट्स के बारे में भी सीखेंगे, जिनमें डेटा इंपोर्टिंग से लेकर रिपोर्टिंग तक के सभी आवश्यक चरण शामिल होते हैं।
यदि आप ऐसे प्रोजेक्ट्स ढूंढ रहे हैं जो कृत्रिम बुद्धिमत्ता पर अधिक केंद्रित हों, तो आज से शुरू करने योग्य शीर्ष AI प्रोजेक्ट्स के लिए हमारी अलग गाइड देखें।