Last chance! 50% off DataCamp Premium
Sale ends in
Databricks एक ओपन एनालिटिक्स प्लेटफ़ॉर्म है, जो बड़े पैमाने पर डेटा, एनालिटिक्स और AI समाधानों के निर्माण, परिनियोजन और रखरखाव के लिए बनाया गया है। यह Apache Spark पर आधारित है और तीनों प्रमुख क्लाउड प्रदाताओं (AWS, Azure, या GCP) के साथ इंटीग्रेट होता है, जिससे हम अपनी ओर से क्लाउड इन्फ्रास्ट्रक्चर को मैनेज और डिप्लॉय कर सकते हैं, साथ ही लगभग हर वह डेटा साइंस एप्लिकेशन चला सकते हैं जिसकी आप कल्पना कर सकते हैं।
आज मैं आपको Databricks का एक व्यापक परिचय देना चाहता/चाहती हूं, जिसमें इसके मुख्य फीचर्स, व्यावहारिक उपयोग और संरचित लर्निंग पाथ शामिल हैं। पर्यावरण सेटअप से लेकर डेटा प्रोसेसिंग, ऑर्केस्ट्रेशन और विज़ुअलाइज़ेशन में महारत तक—यहां आपको Databricks शुरू करने के लिए सब कुछ मिलेगा।
Databricks सीखना और इसमें ठोस बुनियाद बनाना आपके लिए कई प्रमुख सकारात्मक फायदे ला सकता है:
Databricks के व्यापक उपयोग व्यवसायों को डेटा को रूपांतरित करने, साफ़ करने, प्रोसेस करने और बड़े डेटासेट्स का अनुकूलन करने में सक्षम बनाते हैं ताकि इनसाइट्स मिल सकें। यह डेटा एक्सप्लोरेशन और विज़ुअलाइज़ेशन के माध्यम से बेहतर निर्णय लेने के लिए उन्नत एनालिटिक्स सक्षम करता है; साथ ही यह प्रेडिक्टिव मॉडल्स और AI समाधानों के विकास और परिनियोजन का समर्थन करता है।
क्लाउड संगतता के साथ Databricks प्रतिस्पर्धात्मक बढ़त देता है। Apache Spark पर निर्मित होने के कारण, यह AWS, Azure और Google Cloud जैसे शीर्ष डेटा टूल्स के साथ इंटीग्रेट होता है। Databricks में महारत आपको किसी भी डेटा-केंद्रित उद्योग में अग्रणी स्थिति में रखती है।
Databricks डेटा इंजीनियरिंग, एनालिटिक्स और मशीन लर्निंग के लिए एक व्यापक प्लेटफ़ॉर्म है, जो पाँच मुख्य फीचर्स को समाहित करता है जो स्केलेबिलिटी, सहयोग और वर्कफ़्लो दक्षता बढ़ाते हैं।
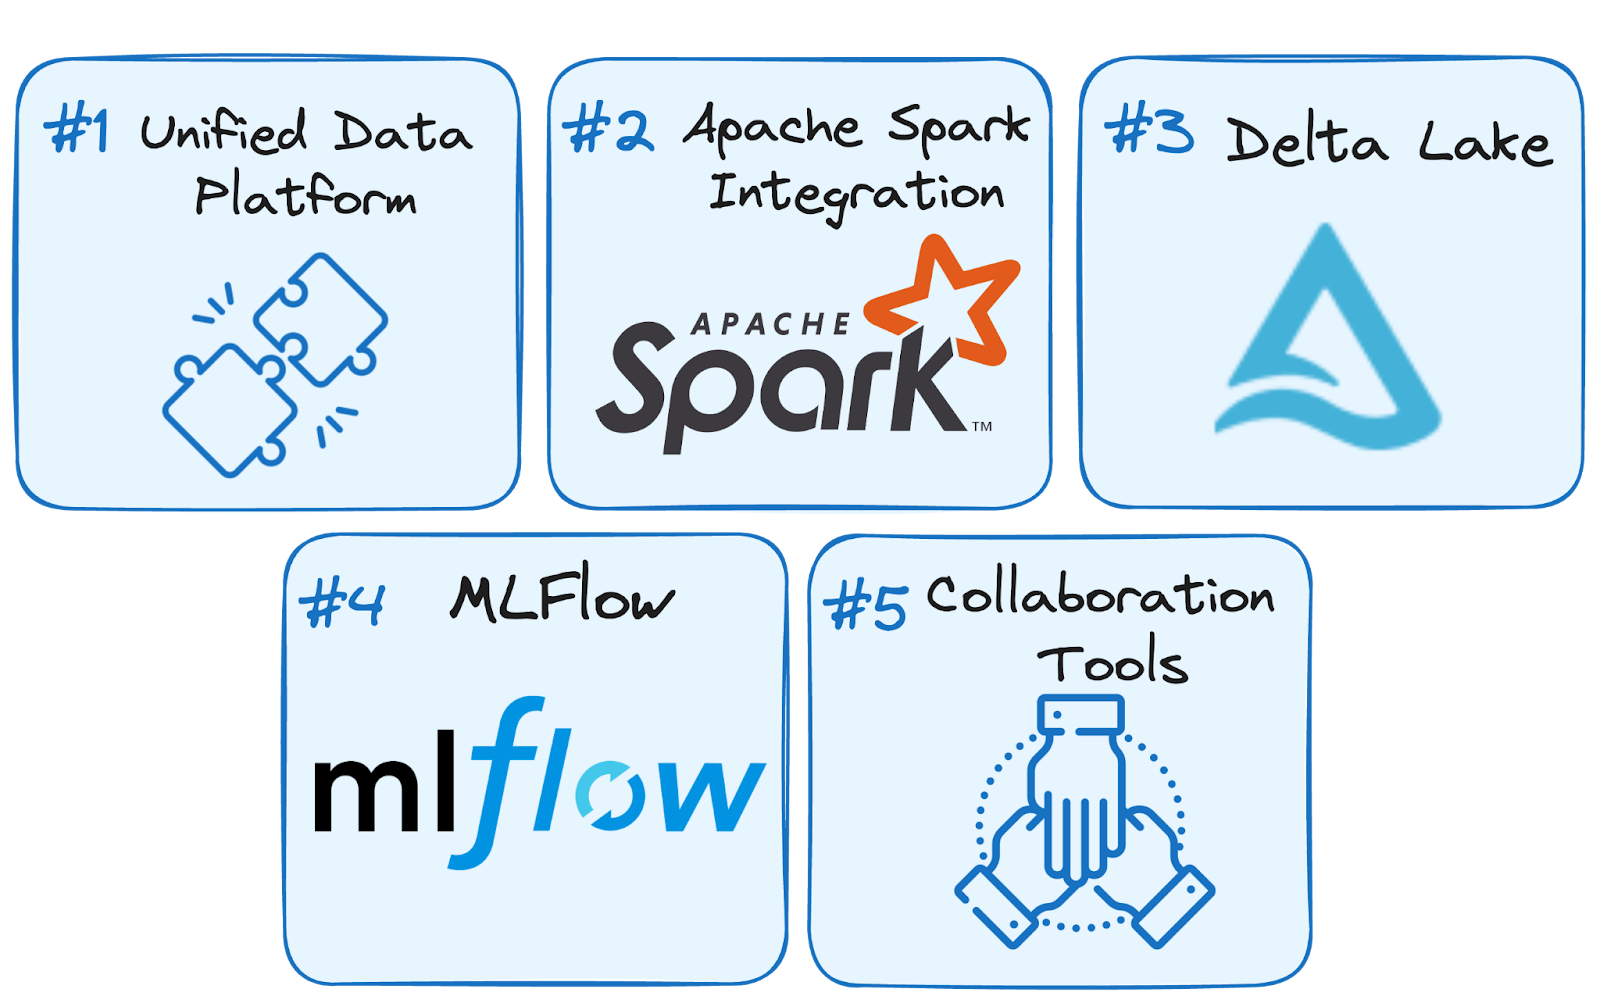
Databricks की प्रमुख विशेषताएं। चित्र: लेखक द्वारा।
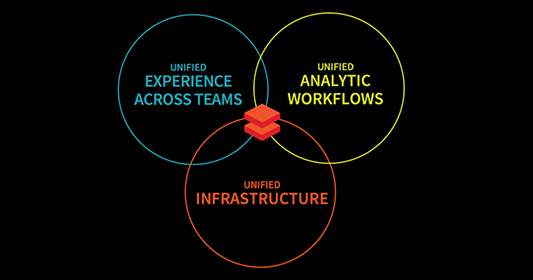
Databricks डेटा इंजीनियरिंग, डेटा साइंस और मशीन लर्निंग—तीनों वर्कफ़्लोज़ को एक ही प्लेटफ़ॉर्म में जोड़ता है। इससे डेटा प्रोसेसिंग, मॉडल ट्रेनिंग और डिप्लॉयमेंट सरल हो जाते हैं। इन क्षेत्रों को एकीकृत कर, Databricks AI पहलों में तेजी लाता है, जिससे व्यवसाय सिलो किए गए डेटा को क्रियात्मक इनसाइट्स में बदल पाते हैं और सहयोग को बढ़ावा मिलता है।
Apache Spark, अग्रणी डिस्ट्रिब्यूटेड कंप्यूटिंग फ़्रेमवर्क, Databricks में गहराई से एकीकृत है। इससे Databricks अपने आप Spark कॉन्फ़िगरेशन को संभाल लेता है। इस तरह, उपयोगकर्ता सेटअप की चिंता किए बिना डेटा समाधान बनाने पर ध्यान केंद्रित कर सकते हैं।
साथ ही, Spark की डिस्ट्रिब्यूटेड प्रोसेसिंग शक्ति बिग डेटा कार्यों के लिए आदर्श है, और Databricks इसे एंटरप्राइज़-स्तरीय सुरक्षा, स्केलेबिलिटी और ऑप्टिमाइज़ेशन से और बेहतर बनाता है।
Delta Lake, Databricks की Lakehouse आर्किटेक्चर की रीढ़ है, जो ACID ट्रांज़ैक्शंस, स्कीमा प्रवर्तन, और रियल-टाइम डेटा कंसिस्टेंसी जैसी विशेषताएं जोड़ता है। यह डेटा की विश्वसनीयता और सटीकता सुनिश्चित करता है, जिससे Delta Lake बैच और स्ट्रीमिंग—दोनों प्रकार के डेटा को मैनेज करने के लिए एक महत्वपूर्ण टूल बन जाता है।
MLflow मशीन लर्निंग के पूरे जीवनचक्र को मैनेज करने के लिए एक ओपन-सोर्स प्लेटफ़ॉर्म है। एक्सपेरिमेंट ट्रैकिंग से लेकर मॉडल डिप्लॉयमेंट मैनेजमेंट तक, MLflow ML मॉडल बनाने और उन्हें ऑपरेशनल बनाने की प्रक्रिया को सरल करता है।
इसके अलावा, OpenAI और Hugging Face जैसे जेनरेटिव AI टूल्स के नवीनतम इंटीग्रेशन्स के साथ, MLflow अपनी क्षमताओं का विस्तार करता है ताकि चैटबॉट्स, डॉक्यूमेंट समरीकरण और सेंटिमेंट एनालिसिस जैसी अत्याधुनिक एप्लिकेशंस भी शामिल हो सकें।
Databricks निम्न माध्यमों से सहयोग को बढ़ावा देता है:
Databricks के साथ शुरुआत करना उत्साहजनक होने के साथ-साथ थोड़ा भारी भी लग सकता है। इसलिए किसी भी नई तकनीक को सीखने का पहला कदम अपने लक्ष्यों—आप इसे क्यों सीखना चाहते हैं और इसे कैसे उपयोग करेंगे—को स्पष्ट रूप से समझना है।
शुरू करने से पहले, यह परिभाषित करें कि आप Databricks से क्या हासिल करना चाहते हैं।
क्या आप एक डेटा इंजीनियर के रूप में बिग डेटा प्रोसेसिंग को सुव्यवस्थित करना चाहते हैं? या आप प्रेडिक्टिव मॉडल बनाने और डिप्लॉय करने के लिए इसकी ML क्षमताओं का उपयोग करना चाहते हैं?
अपने मुख्य उद्देश्यों को परिभाषित करके, आप एक केंद्रित लर्निंग प्लान बना सकते हैं। आपके प्रमुख लक्ष्य के अनुसार कुछ सुझाव इस प्रकार हैं:
Databricks के साथ शुरुआत करना आपकी सोच से आसान हो सकता है। इसके लिए, मैं आपको चरण-दर-चरण दृष्टिकोण से मार्गदर्शन दूंगा/दूंगी, ताकि आप प्लेटफ़ॉर्म की आवश्यकताओं से आसानी से परिचित हो सकें।
शुरुआत करें एक मुफ़्त खाता बनाकर Databricks Community Edition पर, जो प्लेटफ़ॉर्म की कोर विशेषताओं तक निशुल्क पहुंच देता है। यह संस्करण हाथ-से-हाथ सीखने के लिए आदर्श है, जिससे आप वर्कस्पेसेज़, क्लस्टर्स और नोटबुक्स के साथ बिना पेड सब्सक्रिप्शन के प्रयोग कर सकते हैं।
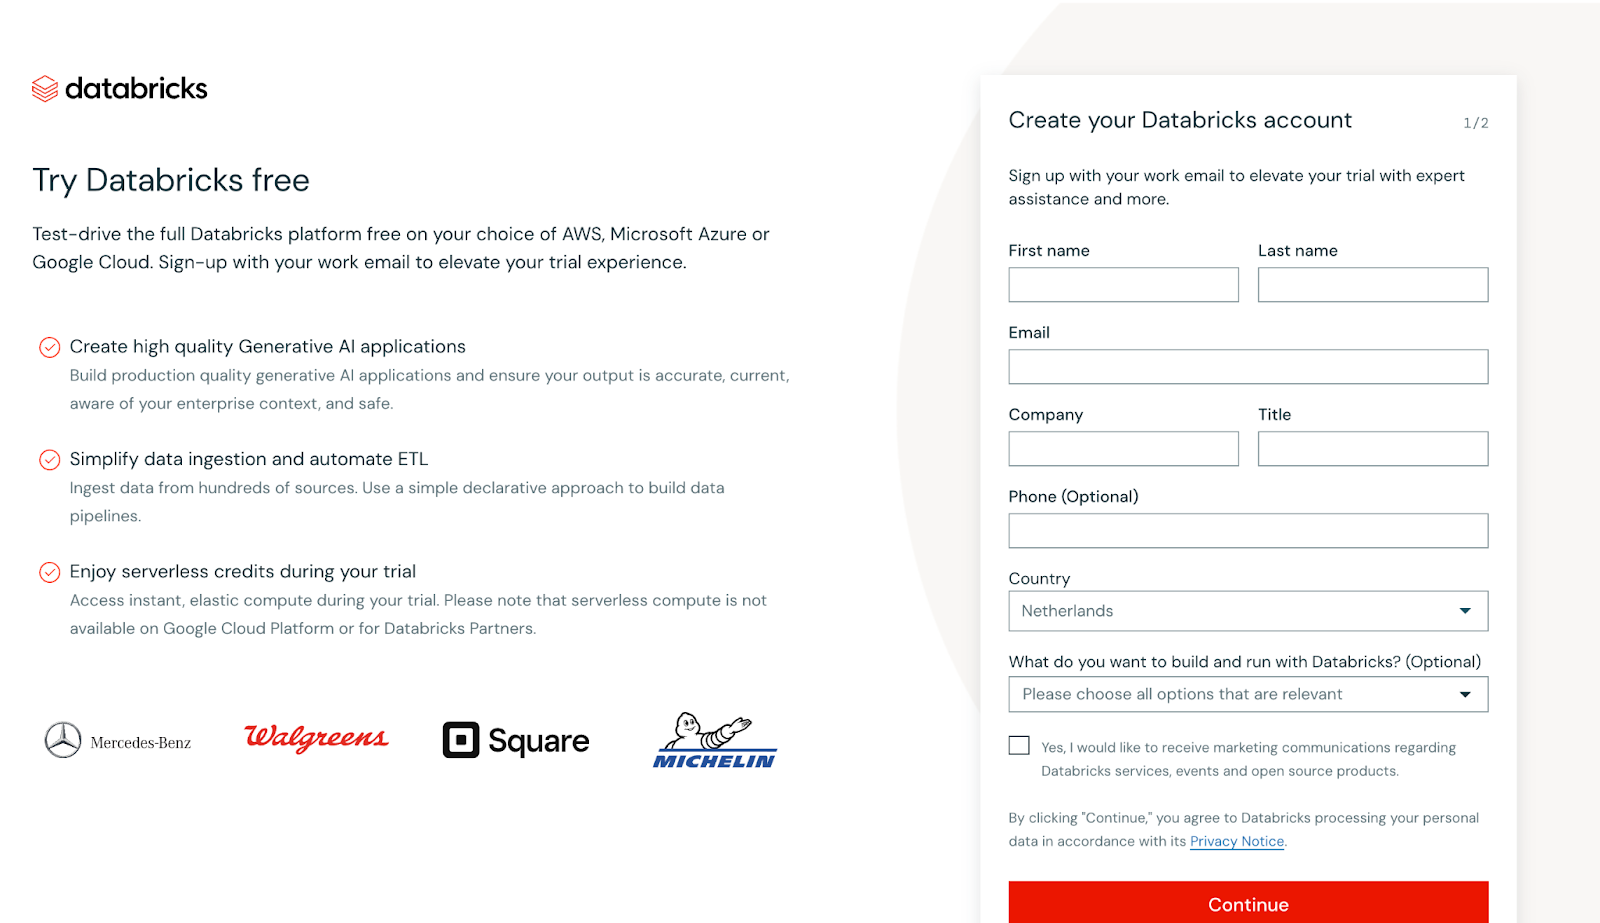
Databricks साइन-अप मुख्य दृश्य का स्क्रीनशॉट। चित्र: लेखक द्वारा
जब आप अपनी जानकारी देते हैं, तो अगला दृश्य दिखाई देगा।
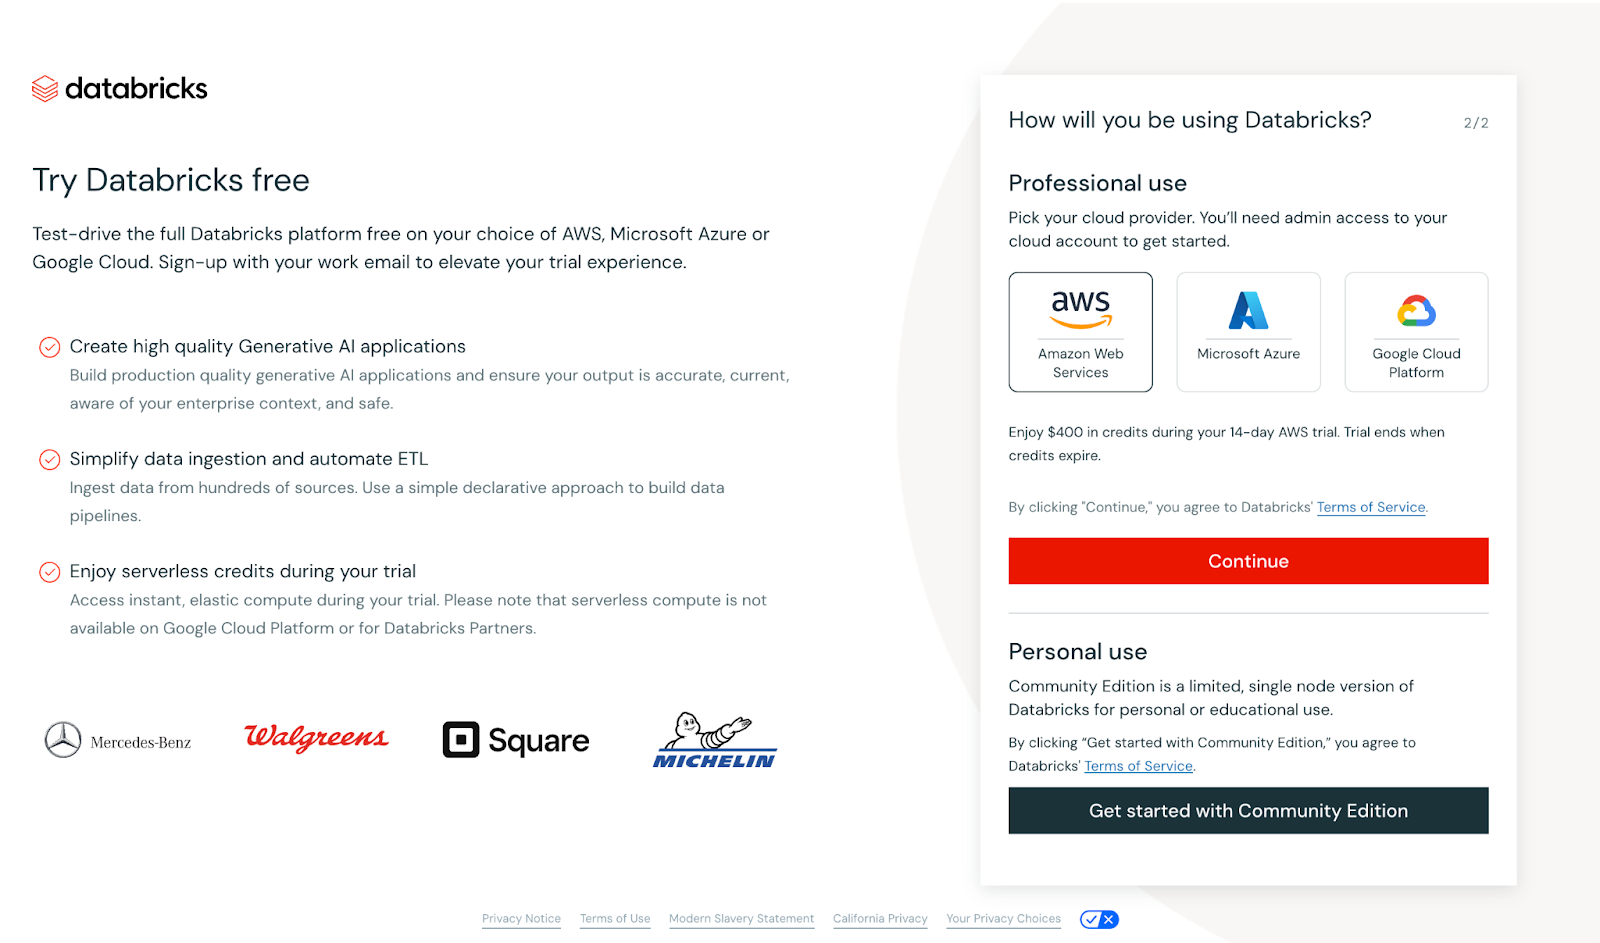
Databricks साइन-अप मुख्य दृश्य का स्क्रीनशॉट। चित्र: लेखक द्वारा
इस चरण में, आपको या तो किसी क्लाउड प्रदाता को सेट अप करने या Community Edition के साथ आगे बढ़ने के लिए कहा जाएगा। चीज़ों को सरल रखने के लिए, हम Community Edition का उपयोग करेंगे। भले ही इसमें एंटरप्राइज़ संस्करण की तुलना में कम फीचर्स हैं, यह ट्यूटोरियल जैसे छोटे उपयोग मामलों के लिए आदर्श है और क्लाउड प्रदाता सेटअप की आवश्यकता नहीं होती।
Community Edition चुनने के बाद, अपना ईमेल पता सत्यापित करें। सत्यापन के बाद, आपका स्वागत एक मुख्य डैशबोर्ड से होगा जो कुछ इस प्रकार दिखता है:
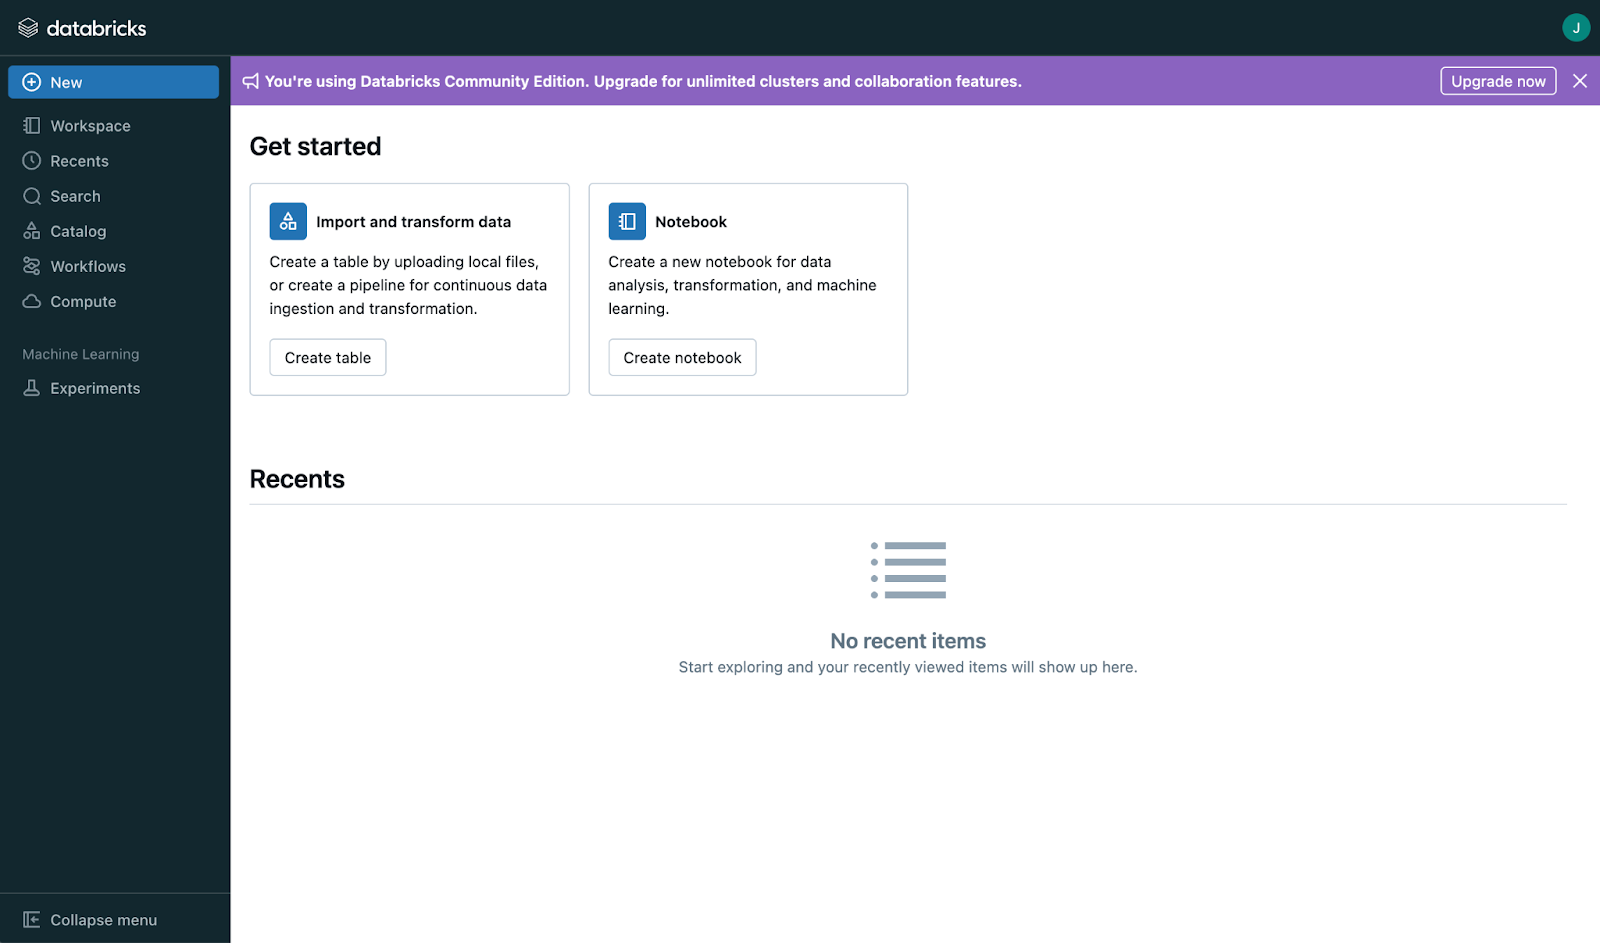
Databricks मुख्य पृष्ठ का स्क्रीनशॉट। चित्र: लेखक द्वारा
लॉगिन करने के बाद, लेआउट को समझने के लिए समय दें। पहली नज़र में इंटरफ़ेस बुनियादी लग सकता है, लेकिन जैसे-जैसे आप और आगे एक्सप्लोर करेंगे या अपना खाता अपग्रेड करेंगे, आपको कई बेहतरीन फीचर्स दिखाई देंगे:
Databricks की तीन मुख्य अवधारणाएं हैं जो इसे सीखने वाले किसी भी पेशेवर के लिए बुनियादी रहेंगी:
यहां तीन-चरणों वाला मेरा लर्निंग प्लान है।
अपनी यात्रा की शुरुआत Databricks Essentials में मजबूत आधार बनाकर करें।
किसी भी डेटा प्लेटफ़ॉर्म का केंद्र प्रभावी डेटा प्रबंधन है, और Databricks बड़े पैमाने पर डेटा लोडिंग, ट्रांसफ़ॉर्मेशन और संगठन के लिए मज़बूत टूल्स के साथ इस प्रक्रिया को सरल बनाता है। यहां Databricks में डेटा मैनेजमेंट के प्रमुख पहलुओं का अवलोकन है:
Databricks विभिन्न प्रकार के डेटा स्रोतों को सपोर्ट करता है, जिससे संरचित, अर्द्ध-संरचित और असंरचित फ़ॉर्मैट्स से डेटा लेना आसान हो जाता है।
डेटा इन्गेस्ट होने के बाद, Databricks उसे साफ़ करने और ट्रांसफ़ॉर्म करने के लिए शक्तिशाली टूल्स देता है, ताकि उसे एनालिटिक्स या मशीन लर्निंग वर्कफ़्लोज़ के लिए तैयार किया जा सके।
Databricks आपके वर्कफ़्लो के अलग-अलग चरणों में आपके डेटा का सुगम प्रबंधन सक्षम करता है।
Spark की मुख्य अवधारणाओं से परिचित हों, जिनमें शामिल हैं:
किसी भी नए टूल—जिसमें Databricks भी शामिल है—को सीखने का सबसे अच्छा तरीका है व्यावहारिक अभ्यास। आपने जो अवधारणाएं सीखी हैं उन्हें वास्तविक परिदृश्यों में लागू करके, आप न केवल आत्मविश्वास बढ़ाएंगे, बल्कि प्लेटफ़ॉर्म की शक्तिशाली क्षमताओं की गहन समझ भी विकसित करेंगे।
व्यावहारिक प्रोजेक्ट्स Databricks की विशेषताओं का पता लगाने और प्रमुख कौशल विकसित करने का उत्कृष्ट तरीका हैं। यहां कुछ स्टार्टर प्रोजेक्ट्स दिए गए हैं:
आप कई अन्य प्रोजेक्ट्स (इंटरमीडिएट से एडवांस्ड) इस प्रोजेक्ट-आधारित लर्निंग वेबसाइट पर पा सकते हैं। ये प्रोजेक्ट्स न केवल मुख्य अवधारणाओं को मज़बूत करने में मदद करते हैं बल्कि डेटा इंजीनियरिंग और मशीन लर्निंग में अधिक जटिल वर्कफ़्लोज़ के लिए भी तैयार करते हैं।
Databricks Community Edition एक मुफ़्त, क्लाउड-आधारित वातावरण देता है जो प्रयोग के लिए उत्तम है। इसका उपयोग इन तक पहुंचने के लिए करें:
विविध पोर्टफोलियो बनाना अपनी विशेषज्ञता दिखाने का उत्कृष्ट तरीका है। अपने प्रोजेक्ट्स का डॉक्यूमेंटेशन और प्रस्तुतीकरण बनाना, उन्हें बनाने जितना ही महत्वपूर्ण है। GitHub या व्यक्तिगत वेबसाइट का उपयोग करके:
हैंड्स-ऑन अनुभव को एक पॉलिश्ड पोर्टफोलियो के साथ मिलाकर, आप अपनी विशेषज्ञता को प्रभावी ढंग से प्रदर्शित करेंगे और प्रतिस्पर्धी Azure इकोसिस्टम में अलग दिखेंगे।
जब आप Databricks की मूल बातें में महारत हासिल कर लें और हाथ-से-हाथ अनुभव प्राप्त कर लें, तो अगला कदम अपने करियर लक्ष्यों के अनुरूप विशिष्ट क्षेत्रों पर ध्यान केंद्रित करना है। चाहे आपकी रुचि डेटा इंजीनियरिंग में हो, मशीन लर्निंग में, या अपनी स्किल्स को मान्य करने के लिए प्रमाणपत्र हासिल करने में—यह चरण उन्नत विशेषज्ञता बनाने में मदद करेगा।
डेटा इंजीनियरिंग स्केलेबल डेटा पाइपलाइन्स बनाने का केंद्र है, और Databricks इस कार्य के लिए शक्तिशाली टूल्स देता है। इस क्षेत्र में कौशल बढ़ाने के लिए:
| फोकस क्षेत्र | मुख्य गतिविधियां और सीखने के लक्ष्य |
|---|---|
| Delta Lake सीखें | ACID ट्रांज़ैक्शंस और स्कीमा प्रवर्तन जैसी विशेषताओं के साथ डेटा विश्वसनीयता और कंसिस्टेंसी सुनिश्चित करने में Delta Lake की भूमिका समझें एकीकृत प्लेटफ़ॉर्म पर बैच और स्ट्रीमिंग डेटा प्रोसेसिंग को Delta Lake कैसे सुगम बनाता है, यह एक्सप्लोर करें हाई-परफ़ॉर्मेंस एनालिटिक्स के लिए Delta टेबल्स बनाना, क्वेरी करना और ऑप्टिमाइज़ करना अभ्यास करें |
| स्ट्रीम प्रोसेसिंग में डूबें | रियल-टाइम डेटा पाइपलाइन्स बनाने के लिए Spark Structured Streaming का अध्ययन करें इवेंट स्ट्रीम प्रोसेसिंग, लॉग एनालिटिक्स और रियल-टाइम डैशबोर्ड्स जैसे उपयोग मामलों के साथ प्रयोग करें निरंतर डेटा फ़्लो मैनेजमेंट के लिए स्ट्रीमिंग डेटा को Delta Lake के साथ इंटीग्रेट करना सीखें |
Databricks का मशीन लर्निंग इकोसिस्टम मॉडल डेवलपमेंट और डिप्लॉयमेंट को तेज़ करता है। इस क्षेत्र में विशेषज्ञता के लिए:
| फोकस क्षेत्र | मुख्य गतिविधियां और सीखने के लक्ष्य |
|---|---|
| MLflow में महारत | अपने मॉडलों से एक्सपेरिमेंट्स ट्रैक करने, पैरामीटर्स लॉग करने और मेट्रिक्स का मूल्यांकन करने के लिए MLflow का उपयोग करें डेवलपमेंट से प्रोडक्शन तक मॉडल्स के पूरे जीवनचक्र को मैनेज करने के लिए MLflow Model Registry के बारे में जानें चैटबॉट्स और डॉक्यूमेंट समरीकरण जैसी एप्लिकेशंस बनाने हेतु GenAI सपोर्ट जैसी उन्नत विशेषताओं का पता लगाएं |
| डिप्लॉयमेंट पर फोकस | मशीन लर्निंग मॉडलों को REST APIs के रूप में या Azure ML और Amazon SageMaker जैसे फ़्रेमवर्क्स का उपयोग कर डिप्लॉय करने का अभ्यास करें Databricks Model Serving के साथ डिप्लॉयमेंट्स को कुशलता से स्केल करना एक्सप्लोर करें |
| उन्नत लाइब्रेरीज़ को शामिल करें | Databricks के भीतर उन्नत मॉडल बनाने के लिए TensorFlow, PyTorch या Hugging Face Transformers का उपयोग करें। |
प्रमाणपत्र आपकी विशेषज्ञता को मान्य करते हैं और नौकरी के बाज़ार में आपको अलग पहचान देते हैं। Databricks विभिन्न भूमिकाओं और कौशल स्तरों के अनुरूप कई प्रमाणपत्र प्रदान करता है:
| प्रमाणपत्र | विवरण |
|---|---|
| Databricks Certified Associate Developer for Apache Spark | डेवलपर्स के लिए डिज़ाइन किया गया—यह प्रमाणपत्र Spark प्रोग्रामिंग अवधारणाओं, DataFrame APIs और Spark SQL पर केंद्रित है। |
| Databricks Certified Data Engineer Associate | Delta Lake का उपयोग कर विश्वसनीय डेटा पाइपलाइन्स बनाना और एनालिटिक्स के लिए डेटा स्टोरेज का अनुकूलन जैसी प्रमुख स्किल्स को कवर करता है। |
| Databricks Certified Professional Data Scientist | एडवांस्ड प्रैक्टिशनर्स के लिए—यह प्रमाणपत्र Databricks टूल्स का उपयोग कर मशीन लर्निंग मॉडलों का निर्माण, डिप्लॉयमेंट और मॉनिटरिंग की आपकी क्षमता का परीक्षण करता है। |
Databricks में प्रभावी महारत हासिल करने के लिए संरचित कोर्सेज़, आधिकारिक डॉक्यूमेंटेशन और क्विक-रेफ़रेंस सामग्री का मिश्रण उपयोग करना आवश्यक है। नीचे प्रमुख संसाधन दिए गए हैं जो आपकी लर्निंग जर्नी में मार्गदर्शन करेंगे और विशेषज्ञता बनाते समय सहारा देंगे।
Databricks लगातार नए फीचर्स और संवर्द्धन के साथ विकसित होता रहता है, इसलिए अपडेटेड रहना आवश्यक है।
नवीनतम रुझानों की जानकारी और विशेषज्ञ साक्षात्कार सुनने के लिए DataFramed पॉडकास्ट को सब्सक्राइब करें। Databricks से संबंधित एक शानदार एपिसोड जिसकी मैं सिफारिश करता/करती हूं, Databricks के CTO को भी प्रस्तुत करता है: [AI and the Modern Data Stack] How Databricks is Transforming Data Warehousing and AI with Ari Kaplan, Head Evangelist & Robin Sutara, Field CTO at Databricks।
Databricks पेशेवरों को चुनौतियां सुलझाने और करियर अवसरों को अनलॉक करने में सशक्त बनाता है। मुझे खुशी है कि मैंने Databricks सीखा, और मैं आपको भी पढ़ाई जारी रखने के लिए प्रोत्साहित करता/करती हूं। याद रखें:
अपने लक्ष्य तय करें: अपनी लर्निंग पाथ को विशिष्ट उद्देश्यों—चाहे डेटा इंजीनियरिंग, AI या एनालिटिक्स—के साथ संरेखित करें।
संसाधनों का उपयोग करें: संरचित कोर्सेज़, कम्युनिटी एडिशन और हैंड्स-ऑन प्रोजेक्ट्स का लाभ उठाकर अनुभव हासिल करें।
जुड़े रहें: अपडेट्स फॉलो करें, Databricks कम्युनिटी में भाग लें, और आगे बने रहने के लिए निरंतर सीखने को अपनाएं।
जोसेप यूरोपीय परियोजनाओं में विशेषज्ञता रखने वाले फ्रीलांस डेटा साइंटिस्ट हैं, जिन्हें डेटा स्टोरेज, प्रोसेसिंग, उन्नत एनालिटिक्स, और प्रभावशाली डेटा स्टोरीटेलिंग में महारत है।
एक शिक्षक के रूप में, वे यूनिवर्सिटी ऑफ नवार्रा के मास्टर’s प्रोग्राम में बिग डेटा पढ़ाते हैं और Medium, KDNuggets, तथा DataCamp जैसे प्लेटफ़ॉर्म पर लेखों के माध्यम से अपने विचार साझा करते हैं। जोसेप अपनी न्यूज़लेटर Databites (databites.tech) में भी डेटा और टेक के बारे में लिखते हैं।
उन्होंने पॉलिटेक्निक यूनिवर्सिटी ऑफ कैटालोनिया से इंजीनियरिंग फिजिक्स में बीएस और पॉम्पेऊ फाब्रा यूनिवर्सिटी से इंटेलिजेंट इंटरएक्टिव सिस्टम्स में एमएस किया है।
Databricks एक ओपन एनालिटिक्स प्लेटफ़ॉर्म है, जो बड़े पैमाने पर डेटा, एनालिटिक्स और AI समाधानों के निर्माण, परिनियोजन और रखरखाव के लिए बनाया गया है। प्रमुख क्लाउड प्रदाताओं (AWS, Azure, GCP) के साथ इसका इंटीग्रेशन और मज़बूत टूल्स बड़े डेटा प्रोसेसिंग को सुव्यवस्थित कर, उन्नत एनालिटिक्स और मशीन लर्निंग सक्षम करते हुए, डेटा प्रोफेशनल्स के लिए इसे गेम-चेंजर बनाते हैं।
करियर ग्रोथ: उच्च मांग और कुशल पेशेवरों की कमी; 2) व्यापक उपयोग: डेटा ट्रांसफ़ॉर्मेशन, उन्नत एनालिटिक्स और मशीन लर्निंग सक्षम करता है; 3) प्रतिस्पर्धात्मक बढ़त: AWS, Azure, GCP के साथ संगतता प्रदान करता है और Apache Spark के साथ सहज इंटीग्रेशन करता है।
मुख्य विशेषताओं में एकीकृत डेटा प्लेटफ़ॉर्म शामिल है जो डेटा इंजीनियरिंग, एनालिटिक्स और मशीन लर्निंग को जोड़ता है; डिस्ट्रिब्यूटेड प्रोसेसिंग के लिए Apache Spark इंटीग्रेशन; डेटा कंसिस्टेंसी के लिए Delta Lake; मशीन लर्निंग जीवनचक्र मैनेजमेंट के लिए MLflow; और इंटरएक्टिव नोटबुक्स जैसे कोलैबोरेटिव टूल्स।
शुरुआती लोग अपने लर्निंग लक्ष्यों को परिभाषित करके, मुफ़्त Databricks Community Edition के लिए साइन अप करके, इंटरफ़ेस (वर्कस्पेसेज़, क्लस्टर्स, नोटबुक्स) की खोज करके, और ETL पाइपलाइन्स बनाना या MLflow के साथ प्रयोग जैसे हैंड्स-ऑन प्रोजेक्ट्स पर काम करके शुरुआत कर सकते हैं।
Delta Lake और MLflow जैसे कोर कॉन्सेप्ट्स को नियमित रूप से दोहराकर, Community Edition में नई विशेषताओं के साथ प्रयोग करके, Databricks आधिकारिक ब्लॉग को फॉलो करके, और फ़ोरम्स, कॉन्फ़्रेंसेज़ तथा यूज़र ग्रुप्स के माध्यम से Databricks कम्युनिटी से जुड़कर अपडेटेड रहें।
DataCamp के साथ Databricks सीखें
कोर्स
कोर्स
कोर्स
