
लर्निंग पाथ
प्राकृतिक भाषा प्रसंस्करण में Python
20 घंटा
आज की तेज़ी से बदलती टेक दुनिया में, आर्टिफ़िशियल इंटेलिजेंस एक अहम और सर्वव्यापी क्षेत्र के रूप में उभर कर आया है, जो बखूबी हमारे रोज़मर्रा के अनुभवों में घुलमिल गया है। इस AI लहर के केंद्र में है नेचुरल लैंग्वेज प्रोसेसिंग, जो ChatGPT और Bard जैसे लोकप्रिय संवादात्मक टूल्स को शक्ति देने वाला एक उन्नत क्षेत्र है।
क्या होगा अगर इन टूल्स को संभव बनाने वाले ज़्यादातर मॉडल सभी के लिए खुले हों—और एक ही जगह पर मिल जाएँ?
यहीं आता है: Hugging Face—मशीन लर्निंग और नैचुरल लैंग्वेज प्रोसेसिंग में एक गेम‑चेंजर, और AI के लोकतांत्रीकरण का एक प्रमुख कर्ता। ट्रांसफ़र लर्निंग की बदौलत, यह AI को अधिक सुलभ बनाने में अहम भूमिका निभा रहा है।
आज की तारीख़ में, इसके पास Python में सबसे लोकप्रिय NLP लाइब्रेरी है—GitHub पर 115k से अधिक सितारों के साथ—और यह AI उत्साहियों और पेशेवरों के लिए अपने मॉडल्स के साथ प्रयोग करने, उन्हें डिप्लॉय करने और स्केल करने का एक अहम प्लेटफ़ॉर्म बन चुका है।
चाहे आप डेटा प्रो हों या जिज्ञासु शुरुआती, Hugging Face के पास ऐसे टूल और संसाधन हैं जो आपके AI प्रोजेक्ट्स को जीवन दे सकते हैं और मशीन लर्निंग की संभावनाओं की सीमाएँ आगे बढ़ा सकते हैं।
तो आइए, जानते हैं कि Hugging Face आपके लिए क्या लेकर आया है!
हमारे कोड‑अलोंग के साथ Hugging Face पर ओपन‑सोर्स AI मॉडल्स का उपयोग कैसे करें, इसके बारे में और भी जान सकते हैं।
अधिकांश लोगों के लिए, Hugging Face शायद उनके फ़ोन कीबोर्ड पर मौजूद एक और इमोजी भर हो सकता है (🤗)
लेकिन टेक दुनिया में, यह ML जगत का GitHub है—एक सहयोगी प्लेटफ़ॉर्म, जिसमें ऐसे टूल्स भरे हैं जो किसी को भी ओपन‑सोर्स कोड के ज़रिए NLP और ML मॉडल बनाने, ट्रेन करने और डिप्लॉय करने में सक्षम बनाते हैं।
क्रांतिकारी बात?
ये मॉडल पहले से प्री‑ट्रेन आते हैं, जिससे NLP में उतरना और भी आसान हो जाता है। सीधे शब्दों में, डेवलपर्स अब शून्य से शुरू नहीं करते; वे Hugging Face हब से एक प्री‑ट्रेन मॉडल लोड करते हैं, अपनी विशिष्ट टास्क के लिए उसे फ़ाइन‑ट्यून करते हैं, और आगे बढ़ते हैं।
यह उपयोग‑सहजता विकास प्रक्रिया को बहुत सरल बना देती है।
इस तरह, Hugging Face एक ऐसा हब है जहाँ डेटा साइंटिस्ट, शोधकर्ता और ML इंजीनियर विचारों का आदान‑प्रदान करने, सहायता पाने और ओपन‑सोर्स पहलों में योगदान देने के लिए एकत्र होते हैं।
वे अपने को इस तरह वर्णित करते हैं:
“भविष्य का निर्माण करने वाला AI समुदाय।”
यही विज़न Hugging Face की सफलता के गुप्त तत्वों में से एक है: कम्युनिटी‑ड्रिवन अप्रोच।
इसके तीव्र विकास का एक और कारण है प्लेटफ़ॉर्म का सहज होना। सरल इंटरफ़ेस देने से नए और अनुभवी—दोनों—यूज़र्स के लिए शुरुआत करना आसान हो जाता है।
सबसे बड़े NLP और ML संसाधनों का संग्रह होस्ट करने के लक्ष्य के साथ, Hugging Face AI का लोकतांत्रीकरण करने और उसे वैश्विक समुदाय तक सुलभ बनाने के लिए प्रतिबद्ध है।
2016 में स्थापित, Hugging Face एक अमेरिकी‑फ्रांसीसी कंपनी थी जो किशोरों को लक्षित एक इंटरैक्टिव AI चैटबॉट विकसित करना चाहती थी। हालांकि, जब इस चैटबॉट को शक्ति देने वाले मॉडल को ओपन‑सोर्स किया गया, तो कंपनी ने जल्दी ही एक बड़े विज़न की ओर रुख किया: AI उद्योग को शक्तिशाली और सुलभ टूल्स से लैस करना।
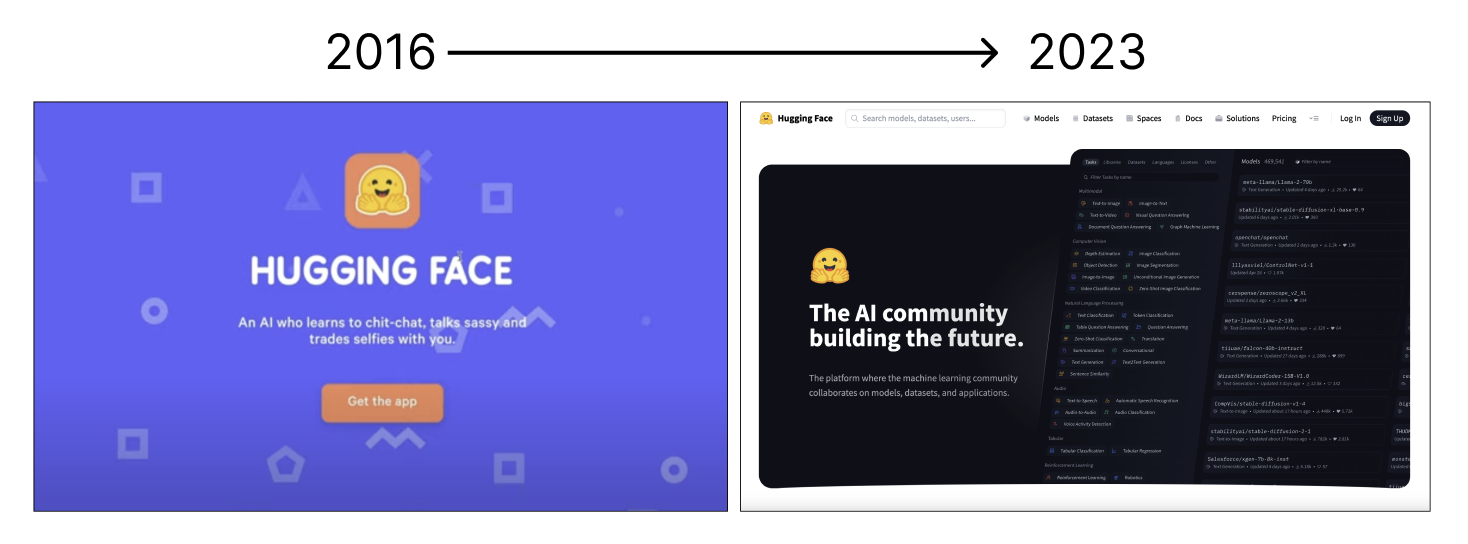
छवि: लेखक द्वारा।
2018 में इसके रूपांतरकारी Transformers लाइब्रेरी का लॉन्च AI समुदाय के लिए इसकी सबसे बड़ी और प्रसिद्ध देन में से एक था, जिसने BERT और GPT जैसे प्री‑ट्रेन मॉडल उपलब्ध कराए, जो NLP कार्यों में मानक बन चुके हैं।
आज, HuggingFace ने ML इकोसिस्टम को पूरी तरह बदल दिया है। ओपन‑सोर्स सहयोग के प्रति इसकी प्रतिबद्धता ने NLP में नवाचार को गति दी है, जिससे तकनीक का सामुदायिक विकास संभव हुआ है।
यह प्लेटफ़ॉर्म मॉडल और डेटासेट साझा करने का केंद्र बन गया है, जिसने AI में शोध और व्यावहारिक अनुप्रयोगों को आगे बढ़ाया है।
उनका मंत्र?
“अच्छी मशीन लर्निंग का लोकतांत्रीकरण, एक‑एक कमिट के साथ।”
रणनीतिक साझेदारियों और उन्नत NLP टूल्स को व्यापक रूप से उपलब्ध कराने की प्रतिबद्धता के माध्यम से, Hugging Face समुदाय का अभिन्न हिस्सा बन चुका है—AI की सीमाएँ निरंतर आगे बढ़ाते हुए और अत्याधुनिक तकनीक तक पहुँच का लोकतांत्रीकरण करते हुए।
Hugging Face अपनी मूलभूत इकाइयों और फीचर्स की विविधता के कारण आधुनिक NLP का आधारस्तंभ बन गया है, जो भाषा प्रसंस्करण की व्यापक ज़रूरतों को पूरा करते हैं।
तो आइए, इन्हें एक‑एक करके समझते हैं।
Transformers लाइब्रेरी अत्याधुनिक मशीन लर्निंग मॉडल्स का व्यापक सूट है, जो विशेष रूप से NLP के लिए डिज़ाइन किया गया है। इसमें प्री‑ट्रेन मॉडल्स का बड़ा संग्रह है, जो टेक्स्ट क्लासिफ़िकेशन, लैंग्वेज जनरेशन, अनुवाद, और सारांशण जैसे कार्यों के लिए अनुकूलित हैं।
Hugging Face ने आम NLP कार्यों को एक सरल `pipeline()` मेथड में एब्स्ट्रैक्ट कर दिया है—विविध कार्यों को करने के लिए आसान API। ये पाइपलाइंस यूज़र्स को जटिल मॉडल्स को वास्तविक दुनिया की समस्याओं पर सरलता से लागू करने देती हैं। यदि आप इस लाइब्रेरी के पीछे की बातों के बारे में अधिक जानना चाहते हैं, तो मैं An Introduction to Using Transformers and Hugging Face लेख पढ़ने की सिफ़ारिश करता/करती हूँ।
ये मॉडल्स आसानी से सुलभ और कस्टमाइज़ेबल हैं—डेवलपर्स और शोधकर्ताओं के लिए यह क्रांतिकारी रहा है और उन्नत NLP मॉडल्स को अधिक सुलभ बनाने में महत्वपूर्ण भूमिका निभाई है।
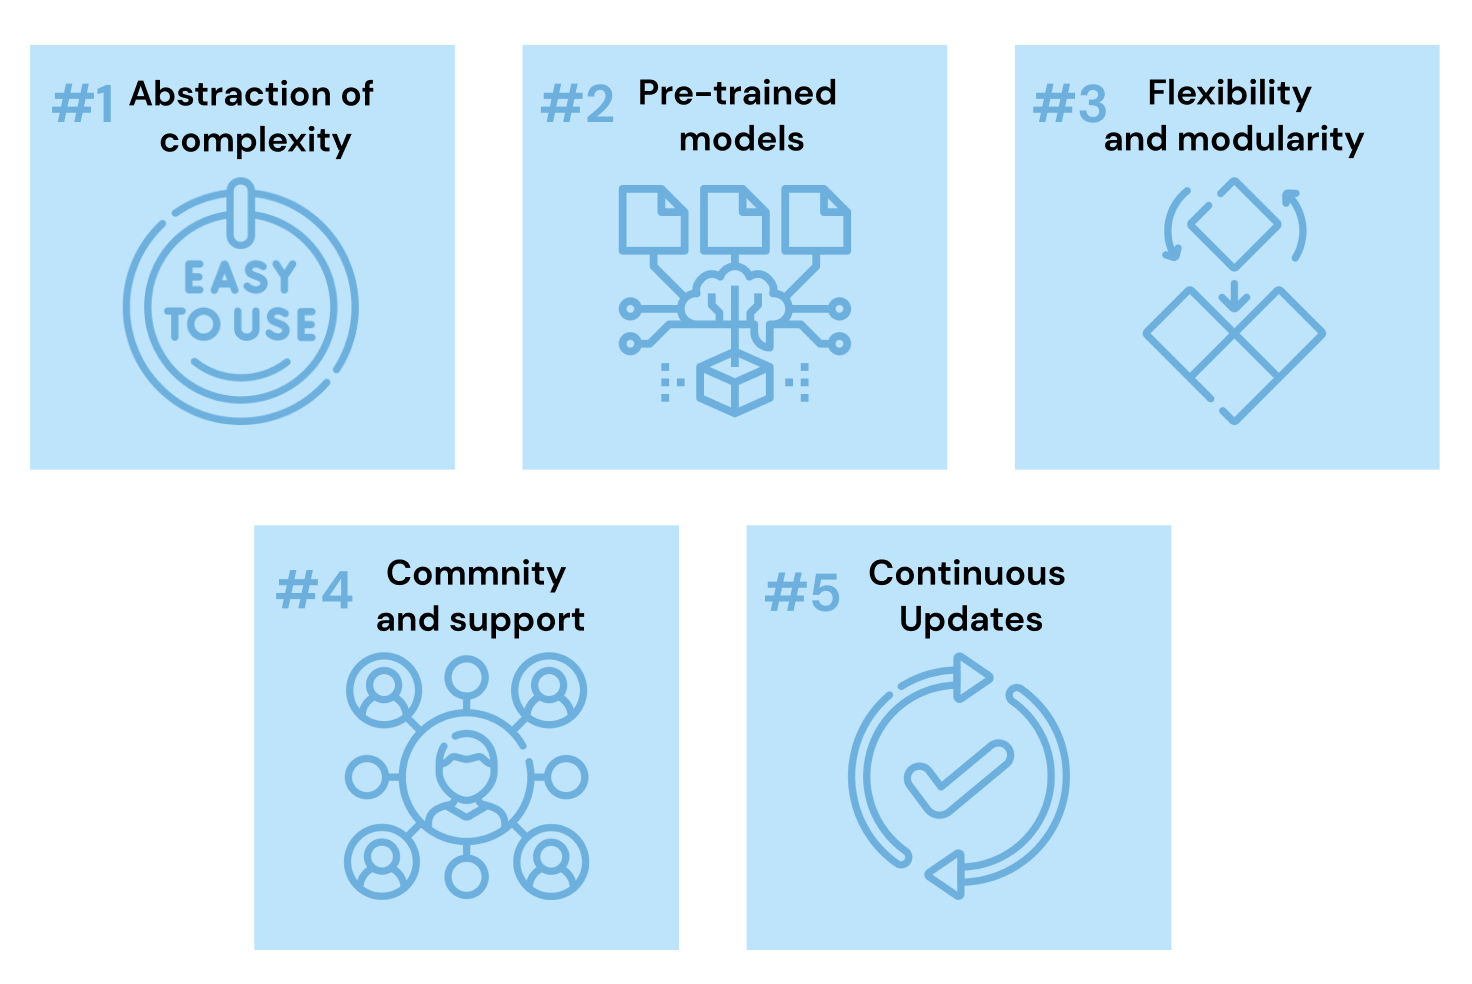
इसकी अहमियत इस क्षमता में है कि यह NLP मॉडल्स के प्रशिक्षण और परिनियोजन में शामिल जटिलताओं को एब्स्ट्रैक्ट कर देता है, जिससे न्यूनतम कोड में उन्नत NLP फीचर्स लागू करना आसान हो जाता है।
यह लाइब्रेरी प्री‑ट्रेन मॉडल्स का लाभ उठाने देती है—बिना अंतर्निहित एल्गोरिदम में उतरे।
Transformers लाइब्रेरी कई प्रमुख तरीकों से NLP मॉडल्स के इम्प्लीमेंटेशन को सरल बनाती है:
यदि आप प्रत्यक्ष रूप से देखना चाहते हैं कि Transformers लाइब्रेरी हमारे लिए कितना काम आसान करती है, तो Building a Transformer with PyTorch के साथ कोई NLP मॉडल डिप्लॉय करना सीखें।
मॉडल हब इस समुदाय का चेहरा है—एक ऐसा प्लेटफ़ॉर्म जहाँ हज़ारों मॉडल्स और डेटासेट्स आपकी उंगलियों पर होते हैं। यह एक अभिनव फीचर है जो यूज़र्स को समुदाय द्वारा योगदान किए गए मॉडल्स साझा करने और खोजने देता है, जिससे NLP विकास में सहयोगी अप्रोच को बढ़ावा मिलता है।
आप इसे उनकी आधिकारिक वेबसाइट पर देख सकते हैं। वहाँ नेविगेटर में Models बटन पर क्लिक कर आप आसानी से मॉडल हब चुन सकते हैं, और आपके सामने कुछ इस तरह का दृश्य आएगा:
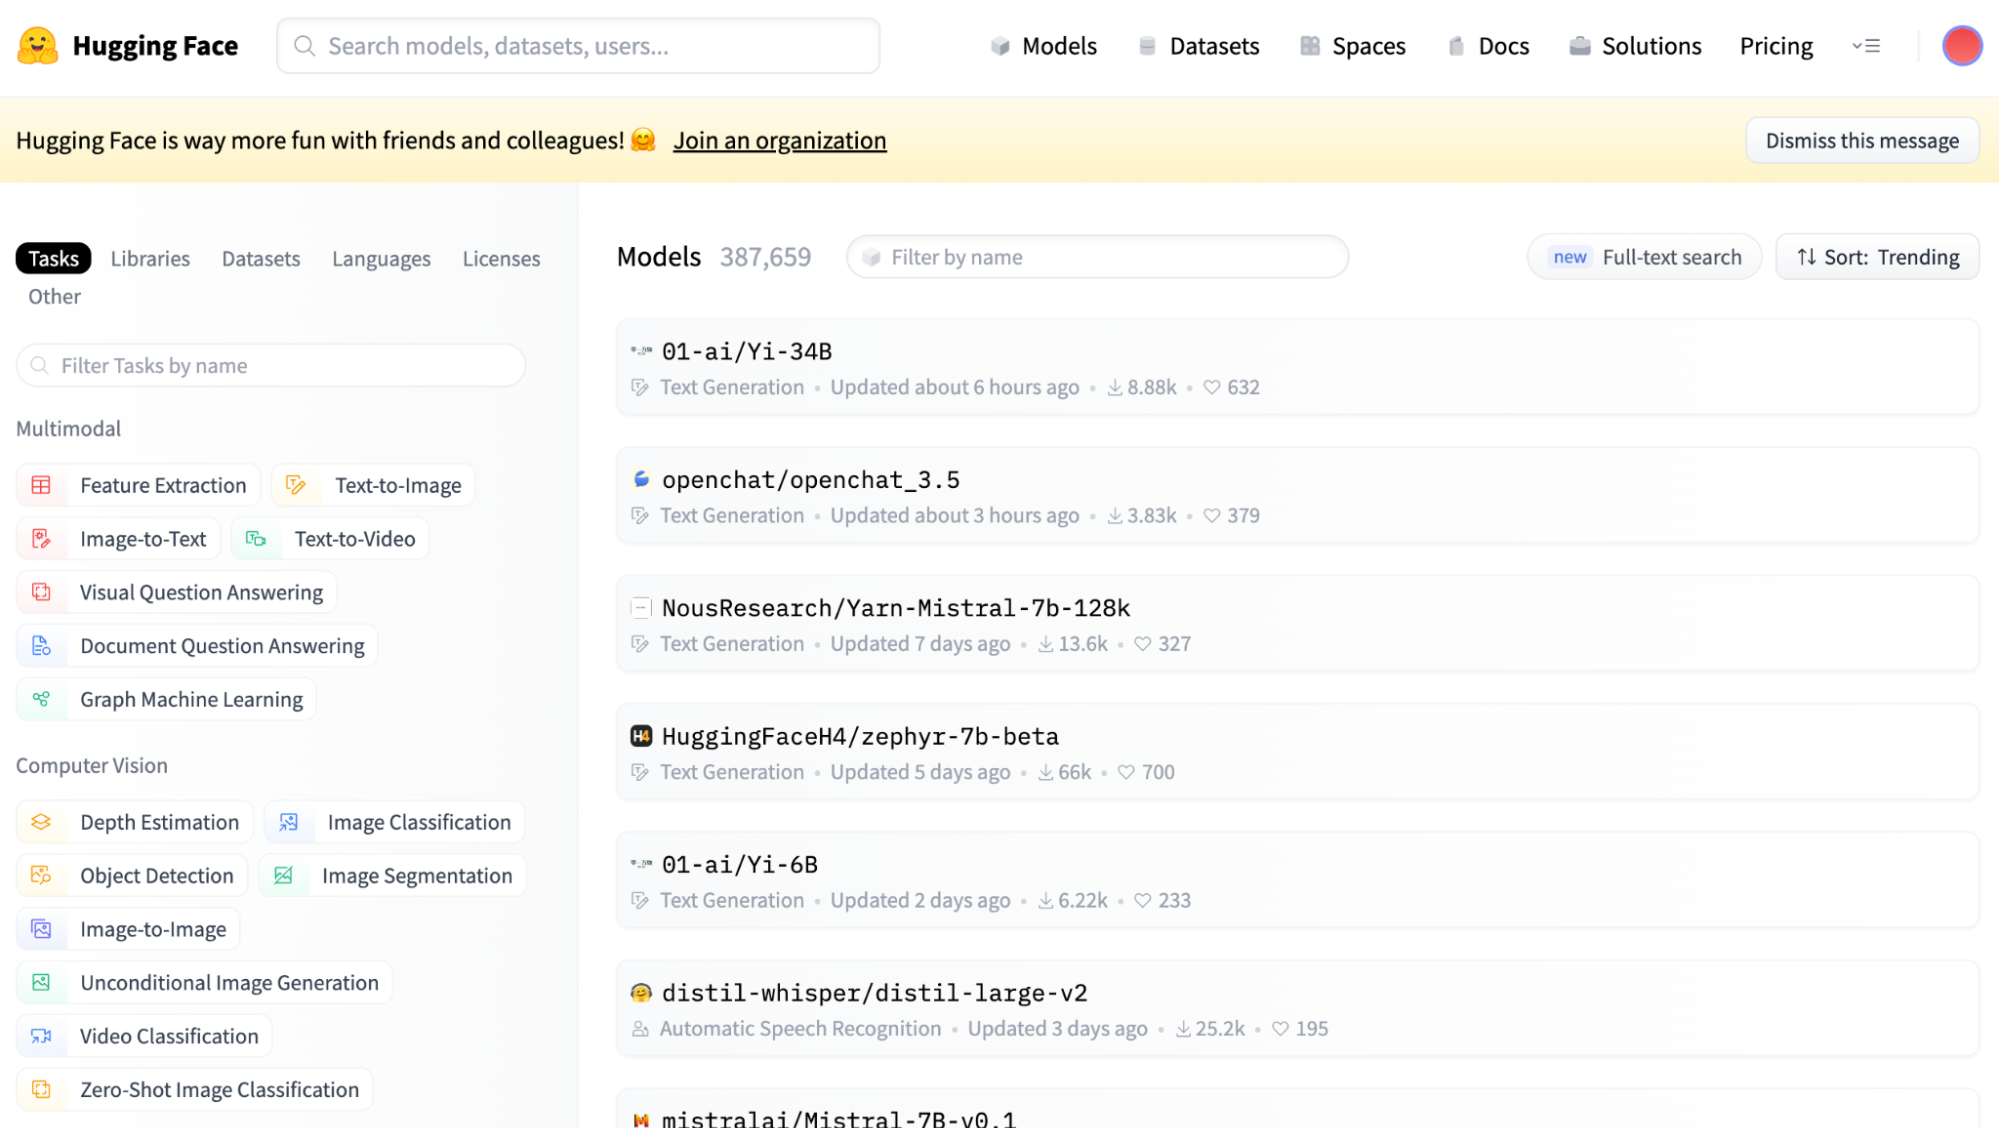
Hugging Face मॉडल हब—मुख्य दृश्य का स्क्रीनशॉट।
जैसा कि आप देख सकते हैं, बाएँ साइडबार में किए जाने वाले मुख्य कार्य से संबंधित कई फ़िल्टर हैं।
मॉडल हब में योगदान करना Hugging Face के टूल्स की वजह से सीधा है—ये यूज़र्स को अपने मॉडल अपलोड करने की प्रक्रिया में मार्गदर्शन करते हैं। एक बार योगदान करने के बाद, ये मॉडल पूरी कम्युनिटी के लिए उपलब्ध हो जाते हैं—सीधे हब के ज़रिए या Hugging Face Transformers लाइब्रेरी के इंटीग्रेशन से।
यह आसान पहुँच और योगदान एक गतिशील इकोसिस्टम बनाता है—जहाँ अत्याधुनिक मॉडल्स लगातार सुधारे और विस्तारित किए जाते हैं—जो NLP की प्रगति के लिए समृद्ध, सहयोगी आधार प्रदान करता है।
NLP में टोकनाइज़र्स बेहद अहम हैं—ये टेक्स्ट को ऐसे फ़ॉर्मैट में बदलते हैं जिसे मशीन लर्निंग मॉडल समझ सकें—जो अलग‑अलग भाषाओं और टेक्स्ट संरचनाओं को प्रोसेस करने के लिए ज़रूरी है।
ये टेक्स्ट को टोकन्स—जैसे शब्द, सबवर्ड या अक्षर—में तोड़ते हैं, ताकि डेटा मशीन लर्निंग मॉडल्स द्वारा प्रोसेस होने के लिए तैयार हो सके। यही टोकन्स वे बिल्डिंग ब्लॉक्स हैं जो मॉडल्स को मानव भाषा समझने और जनरेट करने में सक्षम बनाते हैं।
ये टोकन्स को मॉडल इनपुट के लिए वेक्टर रिप्रेज़ेंटेशन में बदलने, और समान अनुक्रम लंबाई के लिए पैडिंग और ट्रंकेशन संभालने में भी मदद करते हैं।
Hugging Face अपनी Transformers लाइब्रेरी के लिए अनुकूलित, उपयोग‑अनुकूल टोकनाइज़र्स की एक श्रृंखला प्रदान करता है—जो टेक्स्ट के सहज प्री‑प्रोसेसिंग की कुंजी हैं। आप टोकनाइज़ेशन पर अलग लेख पढ़ सकते हैं।
एक और प्रमुख घटक है Hugging Face Datasets लाइब्रेरी—NLP डेटासेट्स का विशाल भंडार—जो ML मॉडल्स के प्रशिक्षण और बेंचमार्किंग का समर्थन करता है।
यह लाइब्रेरी इस क्षेत्र के डेवलपर्स के लिए बेहद उपयोगी टूल है—यह विविधता भरे डेटासेट्स प्रदान करती है जिनका उपयोग व्यापक कार्यों में किसी भी NLP मॉडल को ट्रेन करने, टेस्ट करने और बेंचमार्क करने के लिए किया जा सकता है।
इसके मुख्य लाभों में से एक है सरल और उपयोग‑अनुकूल इंटरफ़ेस। आप Hugging Face हब में सभी डेटासेट्स ब्राउज़ और एक्सप्लोर कर सकते हैं, और कोड में उपयोग करने के लिए, datasets लाइब्रेरी के ज़रिए किसी भी डेटासेट को आसान से डाउनलोड कर सकते हैं।
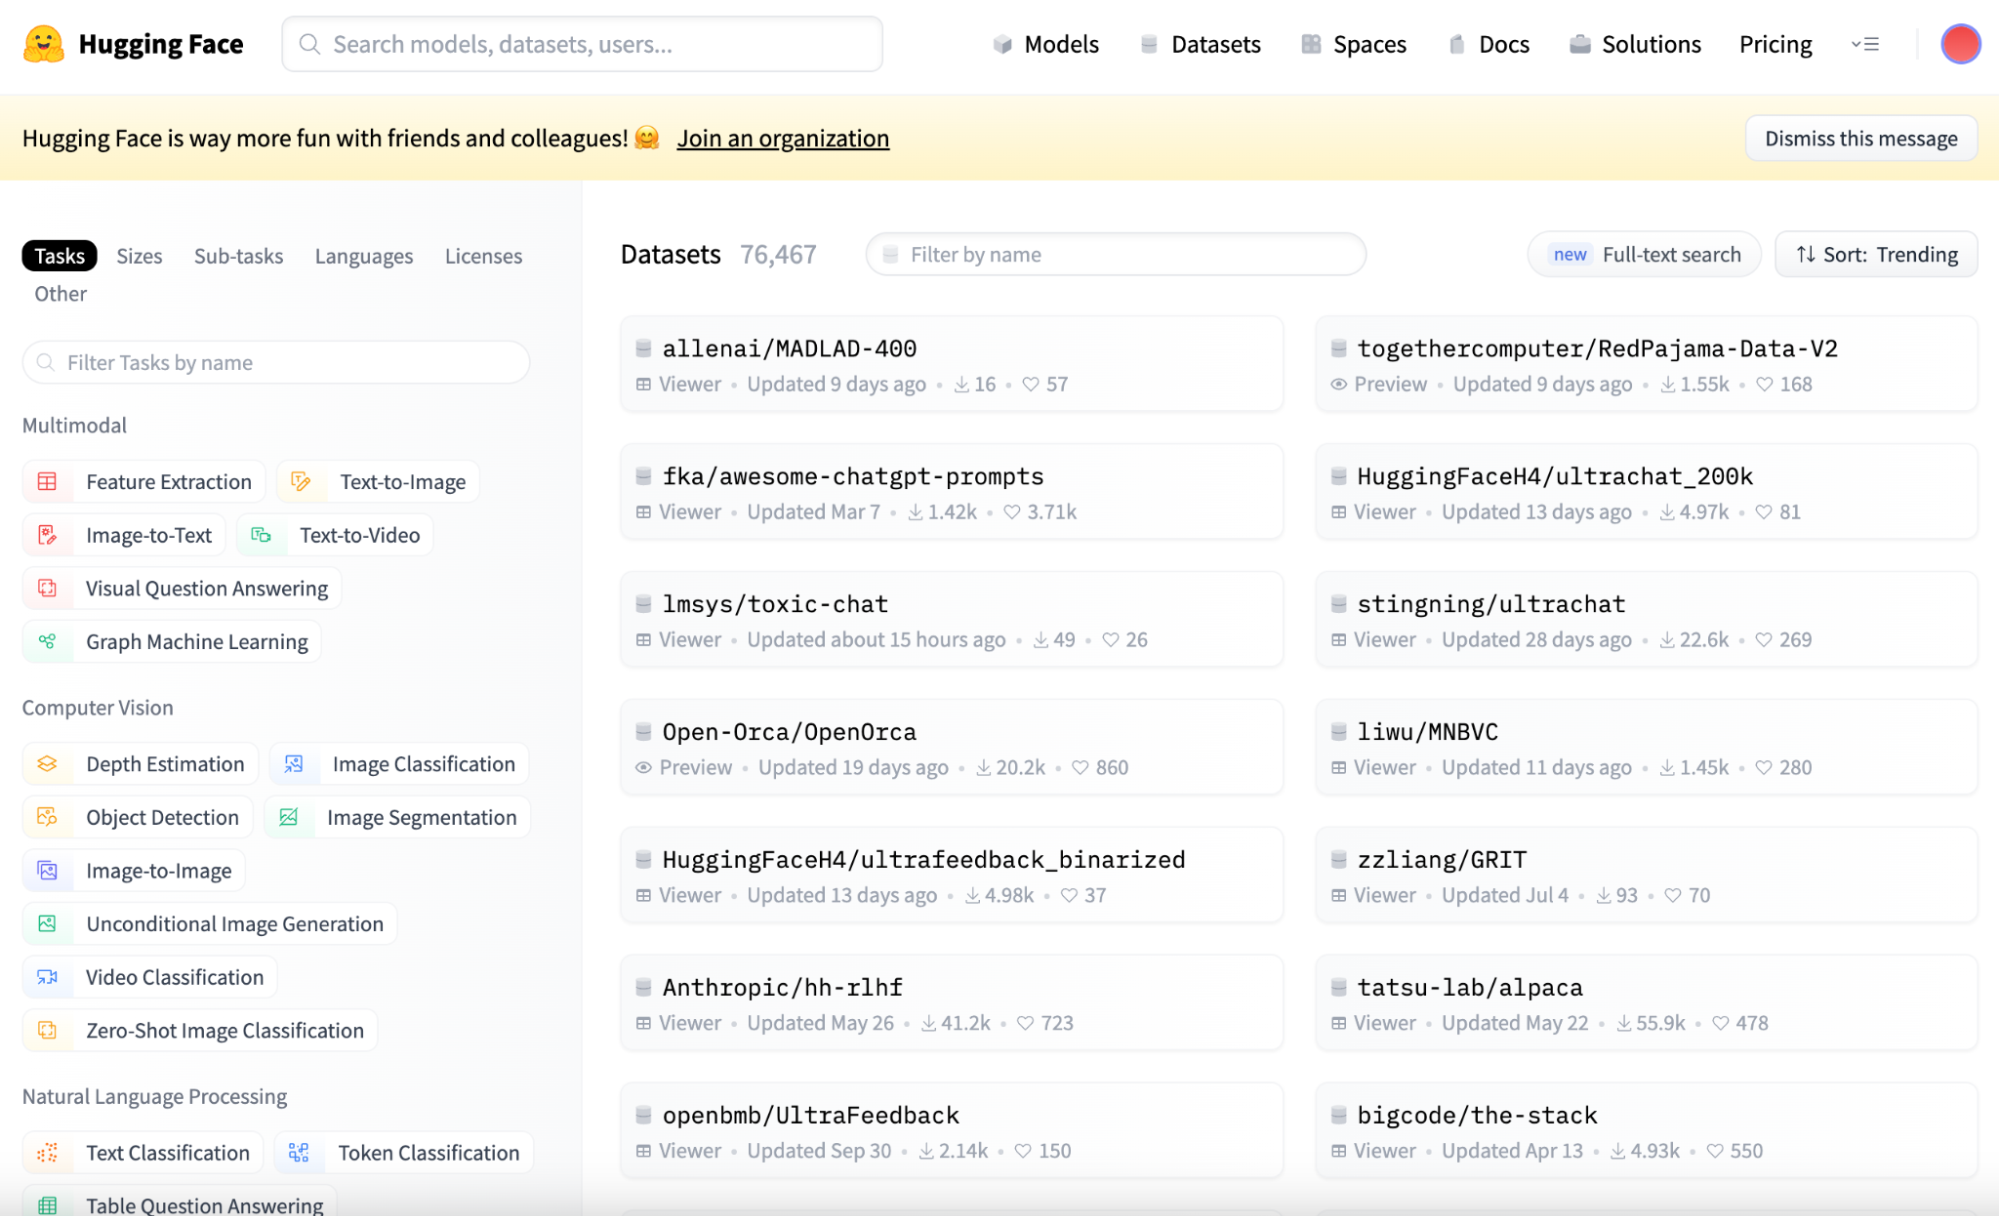
Hugging Face Datasets—मुख्य दृश्य का स्क्रीनशॉट।
इसमें टेक्स्ट क्लासिफ़िकेशन, अनुवाद और प्रश्न‑उत्तर जैसे आम कार्यों के लिए डेटासेट्स शामिल हैं, साथ ही क्षेत्र की विशिष्ट चुनौतियों के लिए और भी विशेष डेटासेट्स मौजूद हैं।
अब जब हम सभी एक ही पेज पर हैं और Hugging Face के मूल सिद्धांतों को समझ चुके हैं, तो आइए जानें कि इस तकनीकी रत्न का उपयोग कैसे करें।
यह गाइड आपको संक्षेप में Hugging Face के साथ शुरुआत करने की बुनियादी बातों से परिचित कराएगा—इंस्टॉलेशन, प्री‑ट्रेन मॉडल्स का उपयोग, फ़ाइन‑ट्यूनिंग और अपने मॉडल्स को समुदाय के साथ साझा करना।
सबसे पहले, आपको transformers लाइब्रेरी को अपनी पसंदीदा डीप लर्निंग लाइब्रेरी—TensorFlow या PyTorch—के साथ संयोजित करना चाहिए।
Transformers लाइब्रेरी को pip (Python का पैकेज इंस्टॉलर) से आसानी से इंस्टॉल किया जा सकता है।
pip install transformers
पूर्ण क्षमता के लिए, आपको datasets और tokenizers लाइब्रेरी भी इंस्टॉल करनी चाहिए।
pip install tokenizers, datasets
Hugging Face का मॉडल हब प्री‑ट्रेन मॉडल्स का विशाल संग्रह देता है, जिनका उपयोग आप विभिन्न NLP कार्यों के लिए कर सकते हैं। आइए अपना पहला प्री‑ट्रेन मॉडल उपयोग करना सीखें।
1. प्री‑ट्रेन मॉडल चुनें: सबसे पहले, आपको एक प्री‑ट्रेन मॉडल चुनना होगा। इसके लिए हम मॉडल हब पर जाते हैं।
मान लीजिए हम किसी टेक्स्ट स्ट्रिंग का सेंटिमेंट निकालना चाहते हैं। तो हम बाएँ साइडबार में Text Classification बटन चुनकर केवल वे मॉडल ब्राउज़ कर सकते हैं जो ‘Text Classification’ कार्य करते हैं।
Hugging Face मॉडल्स हमेशा Trending के आधार पर क्रमबद्ध दिखते हैं। सामान्यतः ऊपर के परिणाम सबसे ज़्यादा उपयोग किए जाते हैं। तो, हम दूसरे परिणाम का चयन करते हैं, जो सबसे अधिक उपयोग किया जाने वाला सेंटिमेंट एनालिसिस मॉडल है।
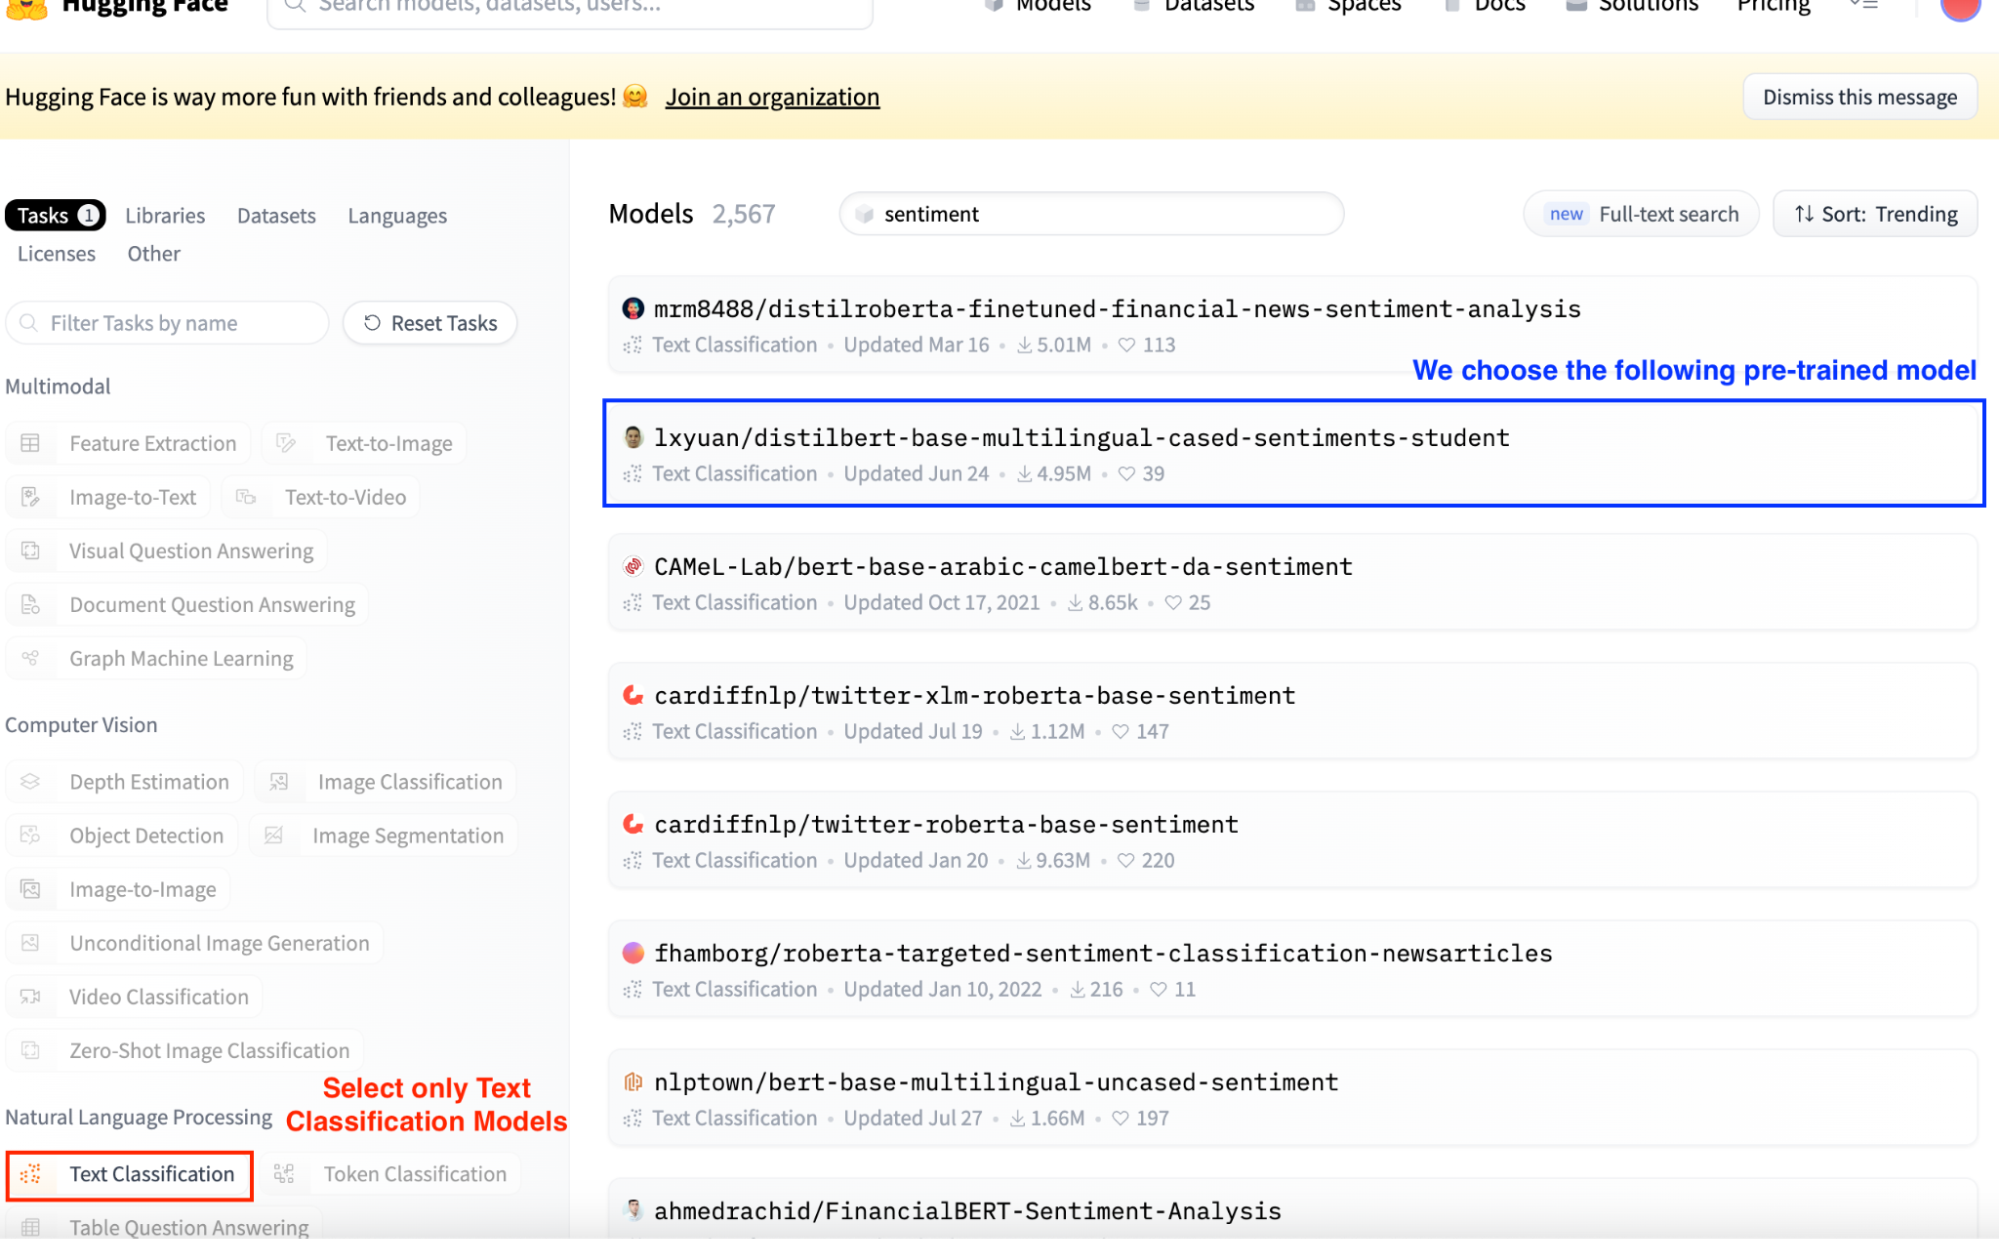
Hugging Face मॉडल हब—टेक्स्ट क्लासिफ़िकेशन मॉडल्स चुनते हुए (स्क्रीनशॉट)।
इसे उपयोग करने के लिए हमें मॉडल का नाम कॉपी करना होगा। यह उसके विशेष पेज के शीर्ष भाग में मिलता है।
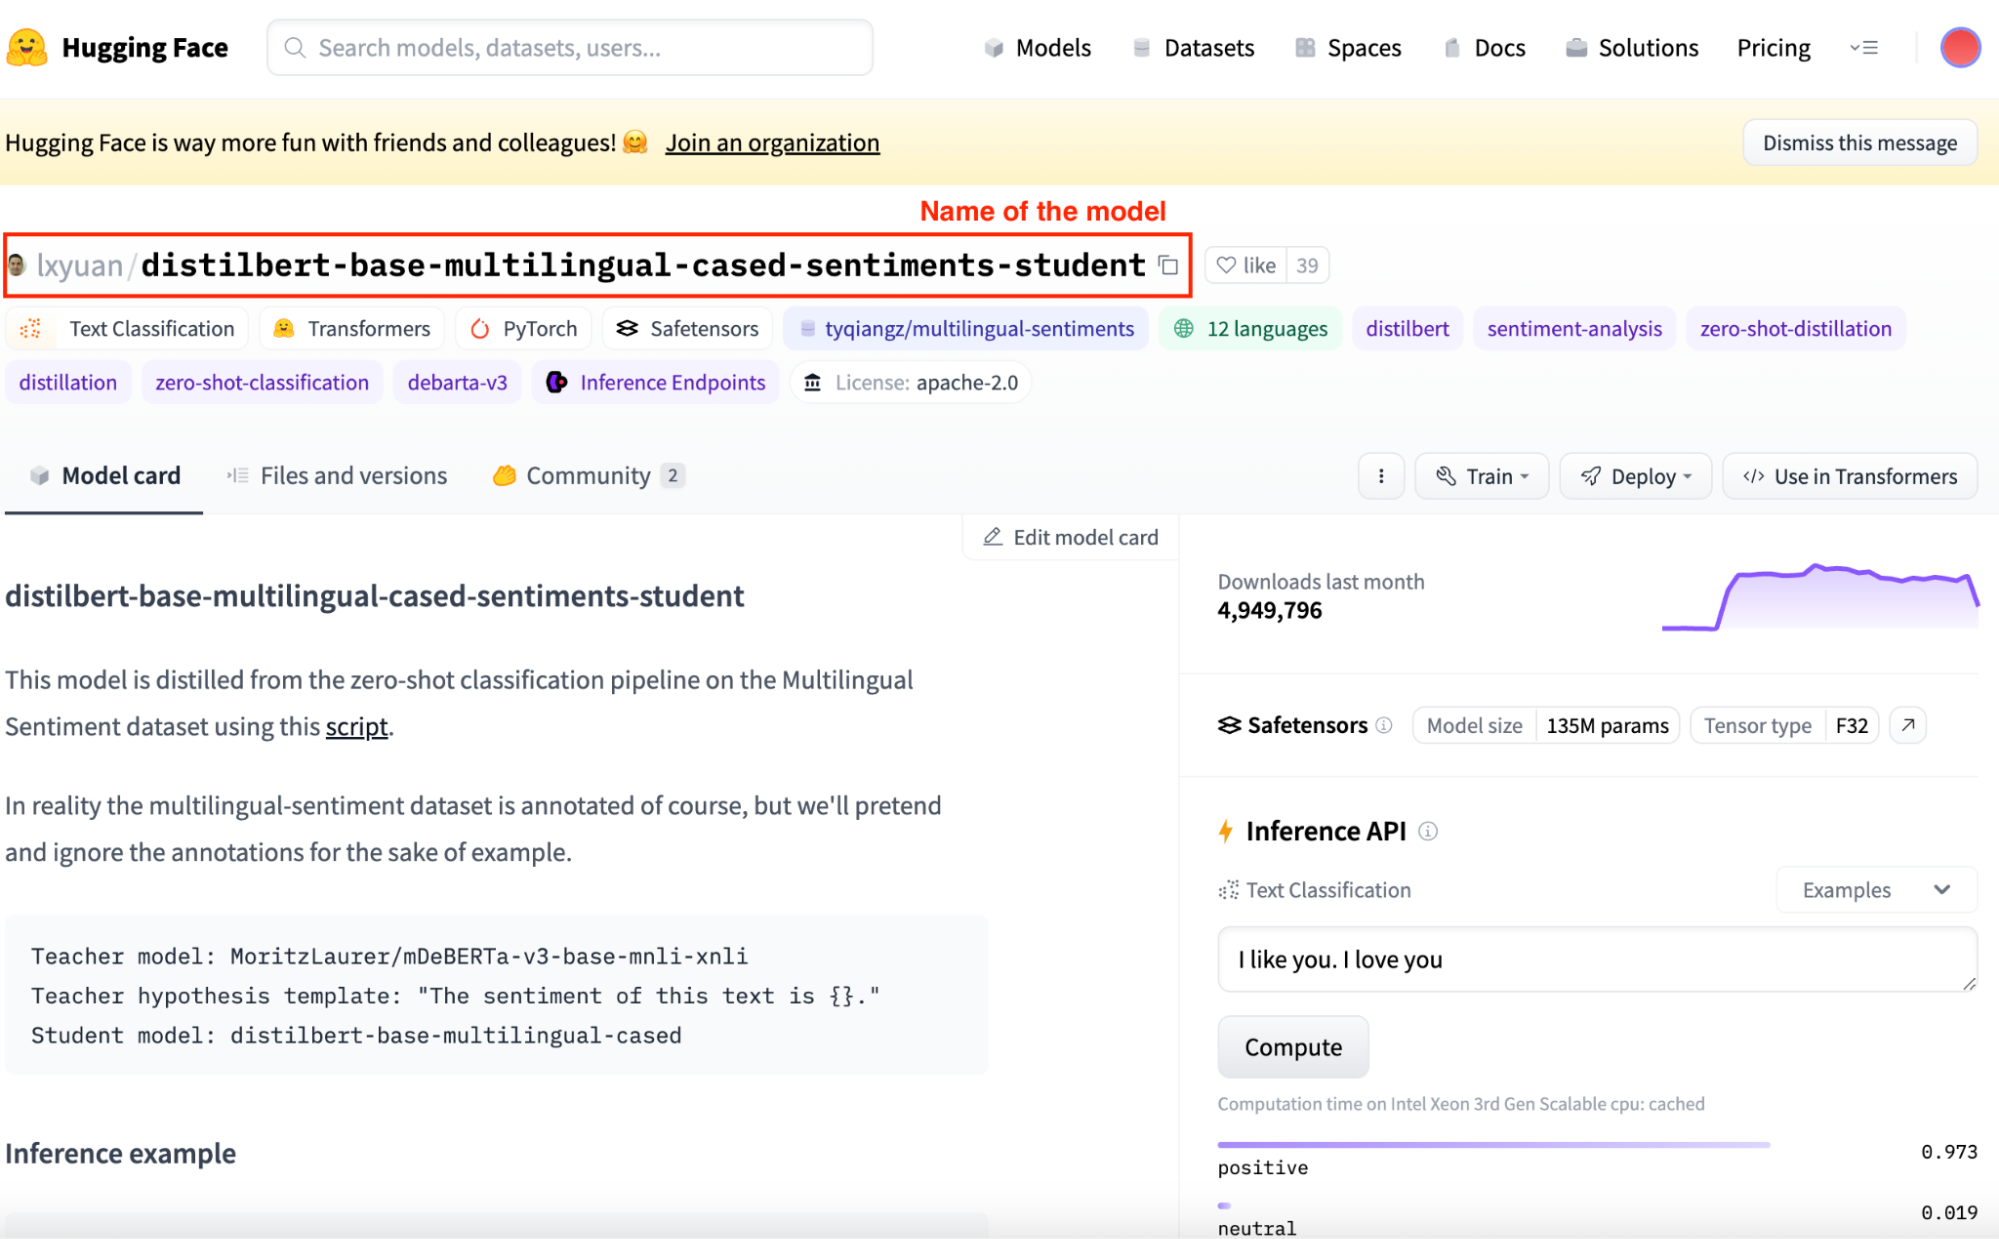
Hugging Face मॉडल हब—विशिष्ट मॉडल दृश्य का स्क्रीनशॉट।
1. प्री‑ट्रेन मॉडल लोड करें: अब जब हमें पता है कि कौन‑सा मॉडल उपयोग करना है, तो आइए इसे Python में उपयोग करें। पहले हम transformers से AutoTokenizer और AutoModelForSequenceClassification क्लासेस इम्पोर्ट करते हैं।
इन AutoModel क्लासेस का उपयोग करने पर, मॉडल के नाम से मॉडल आर्किटेक्चर स्वतः समझ लिया जाता है।
from transformers import AutoTokenizer, AutoModelForSequenceClassification

model_name = "lxyuan/distilbert-base-multilingual-cased-sentiments-student"

# We call define a model object
model = AutoModelForSequenceClassification.from_pretrained(model_name)
2. इनपुट तैयार करें: हमारे मॉडल के लिए एक टोकनाइज़र लोड करें। इस मामले में, transformers लाइब्रेरी प्रक्रिया को आसान बना देती है क्योंकि यह हमारे चुने हुए मॉडल के नाम से उपयुक्त टोकनाइज़र स्वतः निर्धारित कर लेती है।
#We call the tokenizer class
tokenizer = AutoTokenizer.from_pretrained(model_name)
3. मॉडल चलाएँ: चयनित मॉडल, टोकनाइज़र, और किए जाने वाले टास्क के साथ एक पाइपलाइन ऑब्जेक्ट बनाइए—हमारे मामले में सेंटिमेंट एनालिसिस। यदि आप क्लासिफ़ायर ऑब्जेक्ट को केवल टास्क के साथ इनिशियलाइज़ करते हैं, तो पाइपलाइन क्लास डिफ़ॉल्ट मानों से इसे भर देगी—हालाँकि प्रोडक्शन में यह अनुशंसित नहीं है।
# Initializing a classifier with a model and a tokenizer
classifier = pipeline("sentiment-analysis", model = model, tokenizer = tokenizer)
# When passing only the task, the pipeline command inferes both the model and tokenizer.
classifier = pipeline("sentiment-analysis")
हम कुछ इनपुट देकर इस मॉडल को चला सकते हैं।
output = classifier("I've been waiting for this tutorial all my life!")
4. आउटपुट की व्याख्या करें: मॉडल अपनी क्लास के अनुसार विभिन्न तत्त्वों वाला एक ऑब्जेक्ट लौटाएगा। जैसे, इस सेंटिमेंट एनालिसिस उदाहरण के लिए हमें यह मिलेगा:
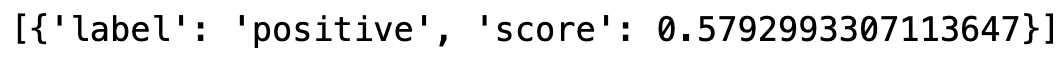
प्राप्त आउटपुट।
फ़ाइन‑ट्यूनिंग वह प्रक्रिया है जिसमें किसी प्री‑ट्रेन मॉडल को लिया जाता है और उसे आपकी टास्क‑विशिष्ट डेटासेट पर ट्रेन करके उसके पैरामीटर्स अपडेट किए जाते हैं। इससे आप मॉडल की सीखी हुई रिप्रेज़ेंटेशन्स का लाभ उठाकर उसे अपने उपयोग‑मामले के अनुरूप ढाल सकते हैं।
मान लीजिए हमें ट्वीट्स की सूची से सेंटिमेंट निकालने के लिए टेक्स्ट‑क्लासिफ़ायर मॉडल चाहिए। एक स्वाभाविक सवाल उठता है: क्या यह प्री‑ट्रेन मॉडल ठीक से काम करेगा?
पक्का करने के लिए, हम फ़ाइन‑ट्यूनिंग का लाभ उठा सकते हैं—ट्वीट्स और उनके सेंटिमेंट्स वाले डेटासेट पर किसी प्री‑ट्रेन Hugging Face मॉडल को ट्रेन करके—ताकि प्रदर्शन बेहतर हो।
यहाँ सीक्वेंस क्लासिफ़िकेशन के लिए फ़ाइन‑ट्यूनिंग का एक बुनियादी उदाहरण है:
1. प्री‑ट्रेन मॉडल और डेटासेट चुनें: अपनी टास्क के लिए उपयुक्त मॉडल आर्किटेक्चर चुनें। इस मामले में, हम वही सेंटिमेंट एनालिसिस मॉडल उपयोग करना चाहते हैं। हालाँकि, अब हमें अपने मॉडल को ट्रेन करने के लिए डेटा चाहिए।
यहीं पर datasets लाइब्रेरी काम आती है। हम मॉडल हब में सभी डेटासेट्स देख सकते हैं और जो सबसे उपयुक्त हो, उसे चुन सकते हैं।
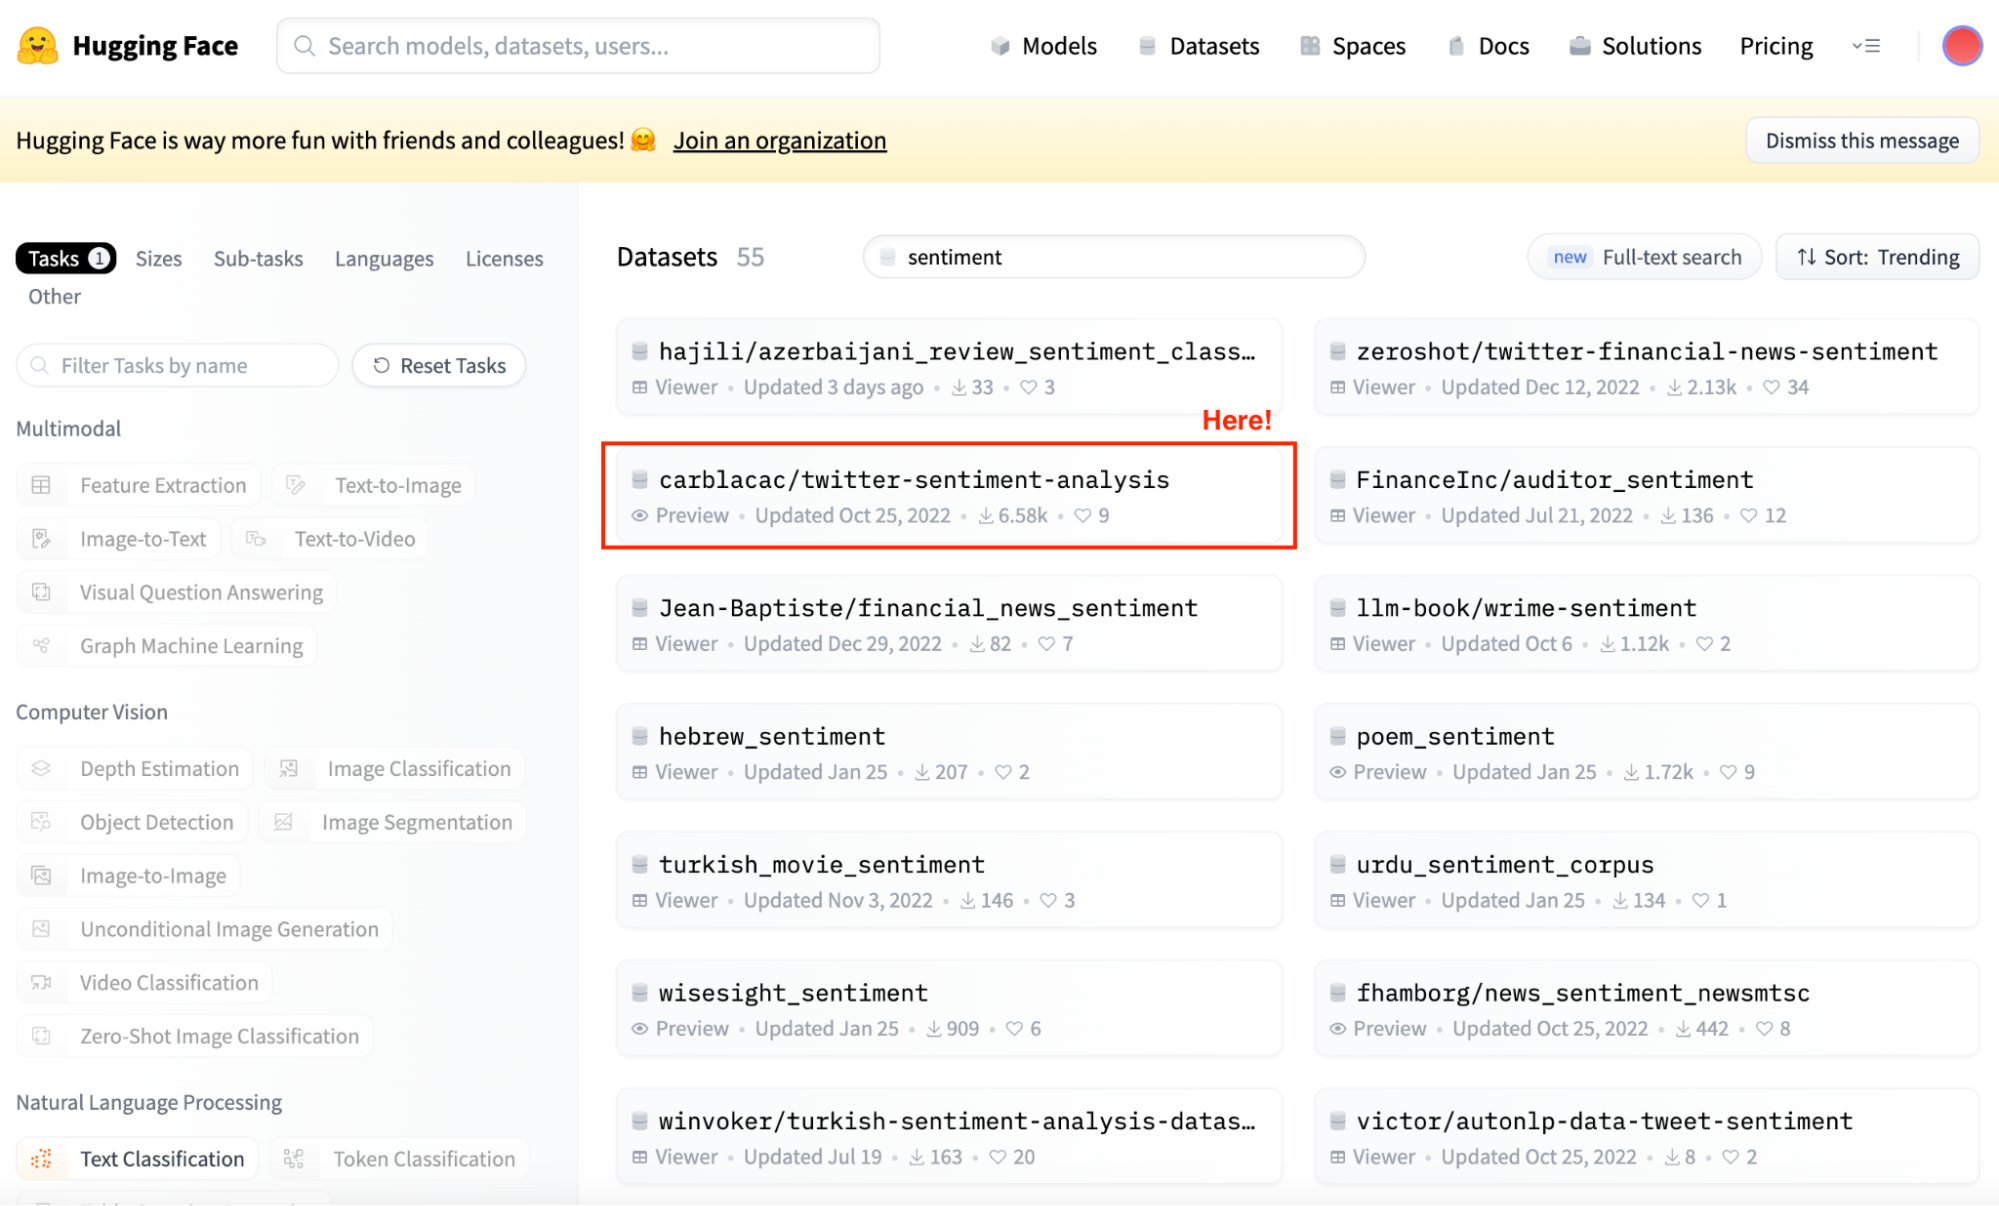
Hugging Face Datasets हब—सेंटिमेंट एनालिसिस डेटासेट्स चुनते हुए (स्क्रीनशॉट)।
अब जब मुझे पता है कि कौन‑सा डेटासेट चुनना है, तो हम सरलता से मॉडल और डेटासेट दोनों को इनिशियलाइज़ कर सकते हैं।
model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")
यदि हम अभी डाउनलोड किए गए डेटासेट की जाँच करें, तो यह ट्रेनिंग और टेस्टिंग के सबसेट्स वाला एक डिक्शनरी है। यदि हम ट्रेनिंग सबसेट को डेटा फ़्रेम में बदलें, तो यह कुछ इस तरह दिखेगा:
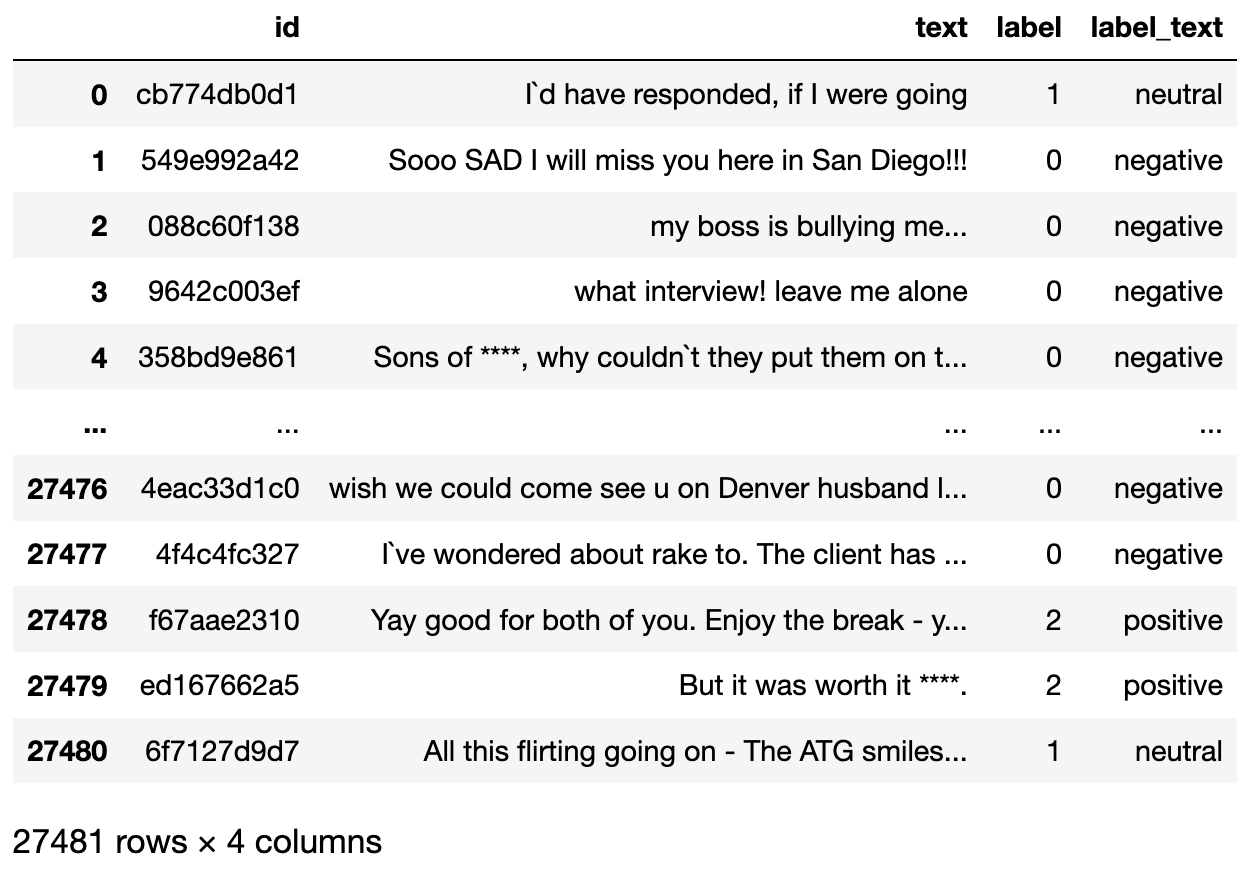
उपयोग किया जाने वाला डेटासेट।
2. अपना डेटासेट तैयार करें: अब जब हमारे पास डेटासेट है, तो हमें इसे अपने मॉडल द्वारा पार्स किए जाने के लिए तैयार करने हेतु एक टोकनाइज़र चाहिए। हमारे डेटासेट के टेक्स्ट वेरिएबल को टोकनाइज़ करना होगा ताकि हम अपने मॉडल को फ़ाइन‑ट्यून कर सकें।
इसीलिए दूसरा क़दम है—एक प्री‑ट्रेन टोकनाइज़र लोड करना और अपने डेटासेट को टोकनाइज़ करना—ताकि वह फ़ाइन‑ट्यूनिंग के लिए तैयार हो जाए।
tokenizer = AutoTokenizer.from_pretrained(model_name)

def tokenize_function(examples):
    return tokenizer(examples["text"], padding="max_length", truncation=True)

tokenized_datasets = dataset.map(tokenize_function, batched=True)
3. एन्कोडिंग्स के साथ PyTorch डेटासेट बनाएँ: तीसरा क़दम है—ट्रेन और टेस्टिंग डेटासेट तैयार करना। ट्रेनिंग सेट फ़ाइन‑ट्यूनिंग के लिए उपयोग होगा, जबकि टेस्टिंग सेट मूल्यांकन के लिए।
आम तौर पर, फ़ाइन‑ट्यूनिंग में काफी समय लगता है। ट्यूटोरियल को आसान बनाने के लिए, हम दोनों डेटासेट्स को रैंडम सैंपल करते हैं ताकि कंप्यूटेशन समय घटे।
from datasets import load_dataset

model = AutoModelForSequenceClassification.from_pretrained(model_name)

# Loading the dataset to train our model
dataset = load_dataset("mteb/tweet_sentiment_extraction")

small_train_dataset = tokenized_datasets["train"].shuffle(seed=42).select(range(1000))
small_eval_dataset = tokenized_datasets["test"].shuffle(seed=42).select(range(1000))
4. मॉडल को फ़ाइन‑ट्यून करें: अंतिम क़दम है—ट्रेनिंग आर्ग्युमेंट्स सेट करना और ट्रेनिंग शुरू करना। Transformers लाइब्रेरी में trainer() क्लास है—जो सब संभाल लेती है।
हम पहले ट्रेनिंग आर्ग्युमेंट्स और इवैल्यूएशन स्ट्रैटेजी परिभाषित करते हैं। सब परिभाषित होने के बाद, train() कमांड से मॉडल को आसानी से ट्रेन कर सकते हैं।
from transformers import Trainer, TrainingArguments
import numpy as np

training_args = TrainingArguments(output_dir="trainer_output", evaluation_strategy="epoch")

metric = evaluate.load("accuracy")

def compute_metrics(eval_pred):
    logits, labels = eval_pred
    predictions = np.argmax(logits, axis=-1)
    return metric.compute(predictions=predictions, references=labels)


trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=small_train_dataset,
    eval_dataset=small_eval_dataset,
    compute_metrics=compute_metrics,
)
trainer.train()
5. मॉडल का मूल्यांकन करें: ट्रेनिंग के बाद, मॉडल का प्रदर्शन वैलिडेशन या टेस्ट सेट पर जाँचिए। फिर से, trainer क्लास में पहले से एक evaluate मेथड है जो यह कर देता है।
import evaluate

trainer.evaluate()
हमारे फ़ाइन‑ट्यून किए गए मॉडल की सटीकता 70% है।
अब जब हमने अपना मॉडल बेहतर बना लिया है, तो इसे समुदाय के साथ कैसे साझा करें? यही हमें अंतिम क़दम पर लाता है।
एक बार जब आपने अपने मॉडल को फ़ाइन‑ट्यून कर लिया, तो आप उसे समुदाय के साथ साझा करना चाह सकते हैं।
Hugging Face इस प्रक्रिया को सीधा बना देता है। पहले, आपको huggingface_hub लाइब्रेरी इंस्टॉल करनी होगी।
इस अंतिम क़दम के लिए आपके Hugging Face खाते से कनेक्ट करने हेतु एक सक्रिय टोकन होना आवश्यक है। इस गाइडलाइऩ का पालन कर आप आसानी से एक टोकन प्राप्त कर सकते हैं। यदि आप Jupyter Notebook में काम कर रहे हैं, तो हम notebook_login लाइब्रेरी को आसानी से इम्पोर्ट कर सकते हैं।
from huggingface_hub import notebook_login

notebook_login()
यह हमारे Jupyter Notebook के भीतर लॉगिन जेनरेट करेगा। हमें बस अपना टोकन सबमिट करना है, और हमारा नोटबुक हमारे Hugging Face खाते से कनेक्ट हो जाएगा।
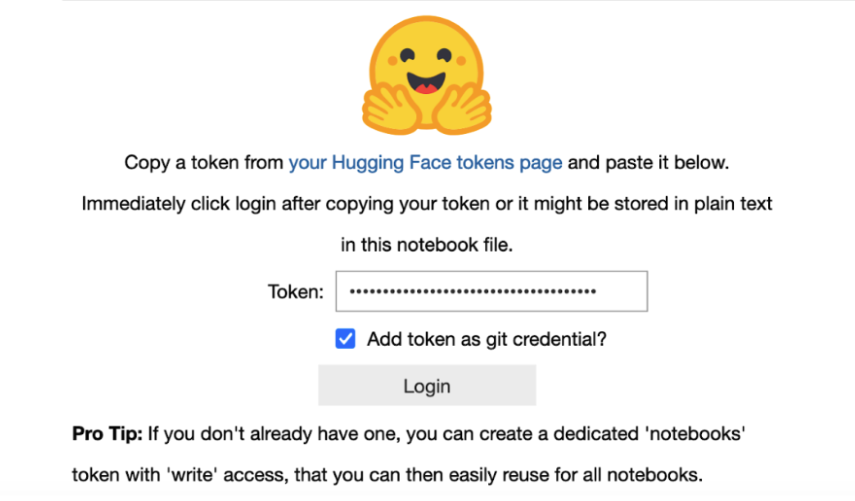
अब हमें push_to_hub कमांड का उपयोग करके अपना मॉडल अपलोड कर देना है।
finetuned_model.push_to_hub("my-awesome-model")
और इसके बाद, यह मॉडल हमारे Hugging Face प्रोफ़ाइल पर सभी के लिए उपलब्ध होगा।
यदि हम किसी भी NLP प्रक्रिया को मानकीकृत करना चाहें, तो Hugging Face के साथ यह आमतौर पर तीन सरल चरणों में—और पाँच से कम लाइनों में—संभव है:
1. पाइपलाइन क्लास (और संबंधित मॉडल व टोकनाइज़र) से एक मॉडल ऑब्जेक्ट परिभाषित करें।
2. इनपुट टेक्स्ट या प्रॉम्प्ट तय करें।
3. हमारे इनपुट के साथ प्री‑ट्रेन मॉडल चलाएँ और आउटपुट देखें।
टेक्स्ट क्लासिफ़िकेशन NLP का एक बुनियादी कार्य है—हर इनपुट टेक्स्ट को एक या अधिक श्रेणियाँ सौंपी जाती हैं। इसका उपयोग स्पैम डिटेक्शन, सेंटिमेंट एनालिसिस, टॉपिक लेबलिंग आदि में किया जा सकता है।
आप नीचे दिए उदाहरण कोड में देख सकते हैं कि पिछले सेक्शन के तीन सरल चरणों से हम कैसे एक टेक्स्ट क्लासिफ़िकेशन मॉडल लागू कर सकते हैं।
# We import the pipeline module from the transformers library
from transformers import pipeline

# We load the pre-trained text classification model.
classifier = pipeline("text-classification",model='lxyuan/distilbert-base-multilingual-cased-sentiments-student')

# Input to be classified
input_ = "I absolutely love the transformers library!"

# Perform classification
output_ = classifier(input_)

# Observer the result
print(output_)
आसान है, है ना?
तो चलिए दूसरे उपयोग‑मामले पर चलते हैं—और यह सबसे ज़्यादा इस्तेमाल किए जाने वालों में से एक है।
आपमें से अधिकांश ChatGPT या Google Bard से परिचित होंगे—ऐसे टूल्स जो इनपुट प्रॉम्प्ट से टेक्स्ट जनरेट करते हैं। इस प्रक्रिया को “टेक्स्ट जनरेशन” कहा जाता है—यह NLP का एक रोचक पक्ष है, जहाँ मॉडल किसी शुरुआती इनपुट से इंसान‑समान टेक्स्ट उत्पन्न करता है।
इसके कई अनुप्रयोग हैं—चैटबॉट जवाब बनाने से लेकर रचनात्मक लेखन जनरेट करने तक।
मुख्य विचार है—किसी बड़े टेक्स्ट कॉर्पस पर मॉडल को ट्रेन करना—ताकि वह भाषा के पैटर्न, शैली और संरचनाएँ सीख सके। जैसा कि आप समझ सकते हैं, सबसे महँगा हिस्सा है—मॉडल का प्रशिक्षण।
लेकिन Hugging Face हमें पिछले उदाहरण की तरह ही—सिर्फ़ पाँच लाइनों के कोड में—ऐसा मॉडल लागू करने देता है।
उदाहरण देखें:
from transformers import pipeline

generator = pipeline('text-generation', model='gpt2')

prompt = "In a world dominated by AI,"

generated_text = generator(prompt, max_length=50)[0]['generated_text']

print(generated_text)
प्रश्न‑उत्तर—जिसे आमतौर पर QA कहा जाता है—NLP का वह क्षेत्र है जो ऐसे सिस्टम बनाता है जो नैचुरल लैंग्वेज में पूछे गए मानव प्रश्नों के उत्तर अपने आप दे सकें।
QA सिस्टम्स का व्यापक उपयोग वर्चुअल असिस्टेंट्स, कस्टमर सपोर्ट और इन्फ़ॉर्मेशन रिट्रीवल सिस्टम्स में होता है।
QA सिस्टम्स को व्यापक रूप से दो प्रकारों में बाँटा जा सकता है:
ये सिस्टम प्रायः प्रश्न की व्याख्या के लिए नैचुरल लैंग्वेज अंडरस्टैंडिंग और प्रासंगिक उत्तर खोजने के लिए इन्फ़ॉर्मेशन रिट्रीवल का संयोजन करते हैं।
फिर से, Hugging Face का उपयोग कर ऐसे मॉडल्स को लागू करना तेज़ और आसान है।
from transformers import pipeline

qa_pipeline = pipeline('question-answering', model='distilbert-base-uncased-distilled-squad')

context = """Paris is the capital and most populous city of France. The city has an area of 105 square kilometers and a population of 2,140,526 residents."""
question = "What is the population of Paris?"

answer = qa_pipeline(question=question, context=context)
print(answer)
अंतिम उपयोग‑मामला है—अनुवाद। मशीन ट्रांसलेशन कम्प्यूटेशनल लिंग्विस्टिक्स का एक उपक्षेत्र है—जो टेक्स्ट या वाणी को एक भाषा से दूसरी भाषा में सॉफ़्टवेयर की मदद से अनुवादित करने पर केंद्रित है। डीप लर्निंग के आगमन के साथ मशीन ट्रांसलेशन में भारी प्रगति हुई है—खासकर बड़े न्यूरल नेटवर्क्स वाले Neural Machine Translation (NMT) मॉडल्स के साथ।
आधुनिक NMT सिस्टम पारंपरिक नियम‑आधारित या सांख्यिकीय अनुवाद मॉडल्स से अलग हैं—ये बड़े पैमाने पर द्विभाषी टेक्स्ट डेटासेट्स पर ट्रेन होकर अनुवाद करना सीखते हैं। ये सीक्वेंस‑टू‑सीक्वेंस आर्किटेक्चर का उपयोग करते हैं—जहाँ नेटवर्क का एक भाग स्रोत टेक्स्ट को एन्कोड करता है और दूसरा भाग उसे लक्ष्य भाषा में डिकोड करता है—और अक्सर काफ़ी द्रुत और सटीक होते हैं।
Hugging Face का एक सरल उदाहरण इस प्रकार होगा:
from transformers import pipeline

# Load the translation pipeline for English to Spanish
translator = pipeline('translation_en_to_de')

# Text to translate from English to Spanish
text_to_translate = "This is a great day for science!"

# Perform the translation
translation = translator(text_to_translate, max_length=40)

# Print the translated text
print(translation[0]['translation_text'])
Hugging Face आर्टिफ़िशियल इंटेलिजेंस और नैचुरल लैंग्वेज प्रोसेसिंग के क्षेत्र में एक रूपांतरकारी शक्ति के रूप में उभरा है। इसकी व्यापक टूलकिट—क्रांतिकारी Transformers लाइब्रेरी, सहयोगी मॉडल हब और विस्तृत Datasets लाइब्रेरी—ने उन्नत NLP क्षमताओं तक पहुँच का लोकतांत्रीकरण कर दिया है।
एक ऐसे वातावरण को बढ़ावा देकर जहाँ नवाचार खुलकर साझा किया जाता है और सामूहिक रूप से आगे बढ़ाया जाता है, Hugging Face न केवल AI की प्रगति में योगदान दे रहा है—बल्कि एक ऐसा भविष्य गढ़ रहा है जहाँ तकनीक अधिक सुलभ, समावेशी और प्रभावशाली है।
जैसे‑जैसे हम AI क्रांति को देखते और उसमें भाग लेते जा रहे हैं, Hugging Face यह याद दिलाता है कि सबसे गहरे तकनीकी उन्नयन वे हैं जो खुले, साझा और साथ मिलकर बनाए जाएँ।
बात केवल और ज़्यादा स्मार्ट मशीनें बनाने की नहीं है, बल्कि डेवलपर्स, शोधकर्ताओं और उत्साहियों के एक और स्मार्ट, अधिक जुड़े समुदाय को बढ़ावा देने की है—जो संभावनाओं की सीमाओं को आगे बढ़ाने को तत्पर है।
आज ही अपनी AI और NLP यात्रा शुरू करें!
लर्निंग पाथ
लर्निंग पाथ
कोर्स