
प्रारंभिक HR डेटा इंजीनियर इंटरव्यू प्रश्न
प्रारंभिक HR इंटरव्यू राउंड में, HR मैनेजर आपसे आपके कार्य अनुभव और कंपनी के लिए आपके मूल्य योगदान के बारे में प्रश्न पूछेगा। यह चरण आपके बैकग्राउंड, पारस्परिक कौशल, और कंपनी संस्कृति के अनुरूपता का आकलन करने के लिए बनाया गया है।
1. आपको क्यों लगता है कि आप इस पद के लिए सर्वश्रेष्ठ उम्मीदवार हैं?
यदि हायरिंग मैनेजर ने आपको फोन इंटरव्यू के लिए चुना है, तो निश्चित रूप से उन्हें आपकी प्रोफ़ाइल में कुछ पसंद आया होगा। आत्मविश्वास के साथ इस प्रश्न का सामना करें और अपने अनुभव और करियर ग्रोथ के बारे में बात करें।
इंटरव्यू से पहले कंपनी की प्रोफाइल और जॉब डिस्क्रिप्शन की समीक्षा करना महत्वपूर्ण है। इससे आपको समझने में मदद मिलेगी कि हायरिंग मैनेजर क्या ढूंढ रहा है और आप अपने उत्तर को उसी अनुसार ढाल सकेंगे।
उन विशेष कौशलों और अनुभवों पर ध्यान दें जो नौकरी की आवश्यकताओं से मेल खाते हैं, जैसे डेटा पाइपलाइनों का डिजाइन और प्रबंधन, मॉडलिंग, और ETL प्रक्रियाएं। बताएं कि कैसे आपके कौशल, अनुभव, और ज्ञान का अनोखा संयोजन आपको अलग बनाता है।
2. एक डेटा इंजीनियर की दैनिक जिम्मेदारियां क्या होती हैं?
हालांकि इसका कोई पूर्णतः निर्धारित उत्तर नहीं है, पिछले नौकरियों से अपने अनुभव साझा करना और जॉब डिस्क्रिप्शन का हवाला देना एक व्यापक उत्तर प्रदान कर सकता है। सामान्यतः, डेटा इंजीनियरों की दैनिक जिम्मेदारियों में शामिल हैं:
- डाटाबेस विकसित करना, परीक्षण करना, और उनका रखरखाव करना।
- व्यावसायिक आवश्यकताओं के आधार पर डेटा समाधान बनाना।
- डेटा अधिग्रहण और एकीकरण।
- ETL प्रक्रियाओं, मॉडलिंग, ट्रांसफॉर्मेशन, और सर्विंग के लिए डेटा पाइपलाइनों का विकास, सत्यापन, और रखरखाव।
- कुछ मामलों में मशीन लर्निंग मॉडल्स की तैनाती और प्रबंधन।
- डेटा को साफ़ कर, सत्यापित कर, और डेटा स्ट्रीम्स की निगरानी करके डेटा गुणवत्ता बनाए रखना।
- सिस्टम की विश्वसनीयता, प्रदर्शन, और गुणवत्ता में सुधार करना।
- डेटा गवर्नेंस और सुरक्षा दिशानिर्देशों का पालन करना ताकि अनुपालन और डेटा अखंडता सुनिश्चित हो सके।
3. डेटा इंजीनियर होने के नाते आपको सबसे कठिन क्या लगता है?
यह प्रश्न व्यक्तिगत अनुभवों पर निर्भर करेगा, लेकिन सामान्य चुनौतियों में शामिल हैं:
- तेजी से बदलती तकनीकों के साथ तालमेल रखना और डेटा सिस्टम्स के प्रदर्शन, सुरक्षा, विश्वसनीयता, और ROI बढ़ाने के लिए नए टूल्स का एकीकरण करना।
- जटिल डेटा गवर्नेंस और सुरक्षा प्रोटोकॉल को समझना और लागू करना।
- डिजास्टर रिकवरी प्लान का प्रबंधन करना और अप्रत्याशित घटनाओं के दौरान डेटा उपलब्धता और अखंडता सुनिश्चित करना।
- व्यावसायिक आवश्यकताओं और तकनीकी सीमाओं के बीच संतुलन बनाना और भविष्य की डेटा मांगों का पूर्वानुमान करना।
- बड़े डेटा वॉल्यूम्स को कुशलतापूर्वक संभालना और डेटा गुणवत्ता व स्थिरता सुनिश्चित करना।
4. आपके पास किन डेटा टूल्स या फ्रेमवर्क्स का अनुभव है? क्या कोई ऐसे हैं जिन्हें आप अन्य के ऊपर प्राथमिकता देते हैं?
आपका उत्तर आपके अनुभव पर आधारित होगा। आधुनिक टूल्स और थर्ड-पार्टी इंटीग्रेशंस से परिचित होना आपको आत्मविश्वास के साथ उत्तर देने में मदद करेगा। इन टूल्स पर चर्चा करें:
- डाटाबेस प्रबंधन (जैसे MySQL, PostgreSQL, MongoDB)
- डेटा वेयरहाउजिंग (जैसे Amazon Redshift, Google BigQuery, Snowflake)
- डेटा ऑर्केस्ट्रेशन (जैसे Apache Airflow, Prefect)
- डेटा पाइपलाइंस (जैसे Apache Kafka, Apache NiFi)
- क्लाउड मैनेजमेंट (जैसे AWS, Google Cloud Platform, Microsoft Azure)
- डेटा क्लीनिंग, मॉडलिंग, और ट्रांसफॉर्मेशन (जैसे pandas, dbt, Spark)
- बैच और रियल-टाइम प्रोसेसिंग (जैसे Apache Spark, Apache Flink)
याद रखें, इस प्रश्न का कोई गलत उत्तर नहीं है। इंटरव्यूअर आपके कौशल और अनुभव का आकलन कर रहा है।
5. आप डेटा इंजीनियरिंग में नवीनतम रुझानों और प्रगतियों से कैसे अपडेट रहते हैं?
यह प्रश्न आपके निरंतर सीखने की प्रतिबद्धता और अपने क्षेत्र में अद्यतन रहने का मूल्यांकन करता है।
आप इंडस्ट्री न्यूज़लेटर्स की सदस्यता, प्रभावशाली ब्लॉग्स को फॉलो करना, ऑनलाइन फोरम और कम्युनिटीज़ में भाग लेना, वेबिनार और कॉन्फ्रेंस में शामिल होना, और ऑनलाइन कोर्स करना उल्लेख कर सकते हैं। उन विशिष्ट स्रोतों या प्लेटफ़ॉर्म्स को हाइलाइट करें जिनका आप उपयोग करते हैं।
6. क्या आप कोई ऐसा समय बता सकते हैं जब आपने किसी क्रॉस-फ़ंक्शनल टीम के साथ मिलकर कोई प्रोजेक्ट पूरा किया?
डेटा इंजीनियरिंग में अक्सर डेटा साइंटिस्ट्स, एनालिस्ट्स, और IT स्टाफ सहित विभिन्न टीमों के साथ काम करना शामिल होता है।
एक विशिष्ट उदाहरण साझा करें जहाँ आपने सफलतापूर्वक सहयोग किया, अपनी संचार कुशलता, विभिन्न दृष्टिकोणों को समझने की क्षमता, और परियोजना की सफलता में अपने योगदान पर जोर देते हुए। जिन चुनौतियों का सामना किया, उन्हें बताएं और इच्छित परिणाम पाने के लिए आपने कैसे उन्हें पार किया।
तकनीकी डेटा इंजीनियर इंटरव्यू प्रश्न
डेटा इंजीनियरिंग अत्यधिक तकनीकी है, इसलिए यह आश्चर्य की बात नहीं है कि आपके इंटरव्यू का अधिकांश भाग तकनीकी प्रश्नों और अभ्यासों से भरा होगा। इस खंड में, हम अलग-अलग प्रकार के तकनीकी प्रश्नों और उत्तरों को कवर करेंगे, जिनमें शुरुआती, Python, SQL, प्रोजेक्ट-आधारित, और मैनेजमेंट से जुड़े प्रश्न शामिल हैं।
जूनियर डेटा इंजीनियर इंटरव्यू प्रश्न
जूनियर इंजीनियरिंग इंटरव्यू टूल्स, Python, और SQL क्वेरीज़ पर केंद्रित होते हैं। इनमें डाटाबेस प्रबंधन और ETL प्रक्रियाओं से जुड़े प्रश्न भी हो सकते हैं, जिनमें कोडिंग चुनौतियाँ और टेक-होम टेस्ट शामिल हैं।
जब कंपनियाँ नए ग्रेजुएट्स को हायर करती हैं, तो वे सुनिश्चित करना चाहती हैं कि आप उनके डेटा और सिस्टम्स को प्रभावी ढंग से संभाल सकते हैं।
7. क्या आप डेटा मॉडलिंग से जुड़े डिजाइन स्कीमाज़ समझा सकते हैं?
तीन प्रमुख डेटा मॉडलिंग डिजाइन स्कीमाज़ हैं: स्टार, स्नोफ्लेक, और गैलेक्सी।
- स्टार स्कीमा: इस स्कीमा में विभिन्न डाइमेंशन टेबल्स एक केंद्रीय फैक्ट टेबल से जुड़ी होती हैं। यह सरल और समझने में आसान है, जिससे यह सीधे-सादे क्वेरीज़ के लिए उपयुक्त बनता है।
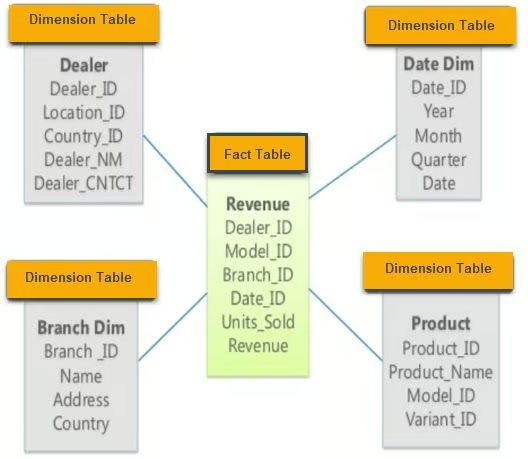
स्टार स्कीमा का उदाहरण। चित्र guru99 से
- स्नोफ्लेक स्कीमा: स्टार स्कीमा का विस्तार, स्नोफ्लेक स्कीमा में एक फैक्ट टेबल और कई डाइमेंशन टेबल्स होती हैं, जिनमें सामान्यीकरण की अतिरिक्त परतें होती हैं, जो एक स्नोफ्लेक जैसी संरचना बनाती हैं। यह दोहराव को कम करता है और डेटा अखंडता में सुधार करता है।
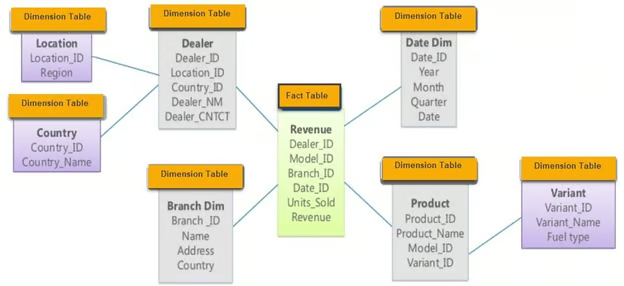
स्नोफ्लेक स्कीमा का उदाहरण। चित्र guru99 से
- गैलेक्सी स्कीमा: जिसे फैक्ट कांस्टीलेशन स्कीमा भी कहा जाता है, इसमें दो या अधिक फैक्ट टेबल्स होती हैं जो डाइमेंशन टेबल्स साझा करती हैं। यह स्कीमा उन जटिल डेटाबेस सिस्टम्स के लिए उपयुक्त है जिन्हें कई फैक्ट टेबल्स की आवश्यकता होती है।
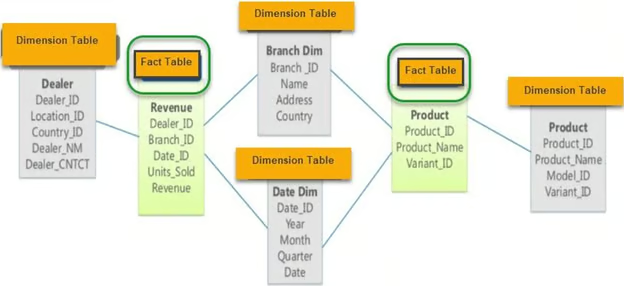
गैलेक्सी स्कीमा का उदाहरण। चित्र guru99 से
8. आपने किन ETL टूल्स के साथ काम किया है? आपका पसंदीदा कौन-सा है और क्यों?
इस प्रश्न का उत्तर देते समय, उन ETL टूल्स का उल्लेख करें जिनमें आप निपुण हैं और बताएं कि आपने विशेष प्रोजेक्ट्स के लिए विशिष्ट टूल्स क्यों चुने। प्रत्येक टूल के फायदे-नुकसान और वे आपके वर्कफ़्लो में कैसे फिट होते हैं, इस पर चर्चा करें। लोकप्रिय ओपन-सोर्स टूल्स में शामिल हैं:
- dbt (data build tool): आपके वेयरहाउस में SQL का उपयोग करके डेटा ट्रांसफॉर्म करने के लिए बेहतरीन।
- Apache Spark: बड़े पैमाने पर डेटा प्रोसेसिंग और बैच प्रोसेसिंग के लिए उत्कृष्ट।
- Apache Kafka: रियल-टाइम डेटा पाइपलाइंस और स्ट्रीमिंग के लिए उपयोगी।
- Airbyte: एक ओपन-सोर्स डेटा इंटीग्रेशन टूल जो डेटा एक्सट्रैक्शन और लोडिंग में मदद करता है।
यदि आपको ETL नॉलेज रिफ्रेश करने की ज़रूरत है, तो Introduction to Data Engineering कोर्स करने पर विचार करें।
9. डेटा ऑर्केस्ट्रेशन क्या है, और इसे करने के लिए आप किन टूल्स का उपयोग कर सकते हैं?
डेटा ऑर्केस्ट्रेशन एक स्वचालित प्रक्रिया है जिसमें कई स्रोतों से कच्चे डेटा तक पहुंचना, डेटा क्लीनिंग, ट्रांसफॉर्मेशन और मॉडलिंग तकनीकों को लागू करना, और उसे विश्लेषणात्मक कार्यों के लिए सर्व करना शामिल है। यह सुनिश्चित करता है कि विभिन्न सिस्टम्स और प्रोसेसिंग चरणों के बीच डेटा सुचारू रूप से प्रवाहित हो।
डेटा ऑर्केस्ट्रेशन के लोकप्रिय टूल्स में शामिल हैं:
- Apache Airflow: वर्कफ़्लोज़ को शेड्यूल और मॉनिटर करने के लिए व्यापक रूप से उपयोग किया जाता है।
- Prefect: डेटा फ्लो पर केंद्रित एक आधुनिक ऑर्केस्ट्रेशन टूल।
- Dagster: डेटा-इंटेंसिव वर्कलोड्स के लिए डिजाइन किया गया ऑर्केस्ट्रेशन टूल।
- AWS Glue: एक मैनेज्ड ETL सेवा जो एनालिटिक्स के लिए डेटा तैयारी को सरल बनाती है।
10. आप एनालिटिक्स इंजीनियरिंग के लिए किन टूल्स का उपयोग करते हैं?
एनालिटिक्स इंजीनियरिंग में प्रोसेस्ड डेटा को ट्रांसफॉर्म करना, सांख्यिकीय मॉडल लागू करना, और उसे रिपोर्ट्स और डैशबोर्ड्स के जरिए विजुअलाइज़ करना शामिल है।
एनालिटिक्स इंजीनियरिंग के लोकप्रिय टूल्स में शामिल हैं:
- dbt (data build tool): आपके वेयरहाउस में SQL का उपयोग करके डेटा ट्रांसफॉर्म करने के लिए।
- BigQuery: बड़े पैमाने पर डेटा एनालिटिक्स के लिए पूर्णतः मैनेज्ड, सर्वरलेस डेटा वेयरहाउस।
- Postgres: एक शक्तिशाली, ओपन-सोर्स रिलेशनल डेटाबेस सिस्टम।
- Metabase: एक ओपन-सोर्स टूल जो आपको अपने डेटा से सवाल पूछने और उत्तरों को समझने योग्य स्वरूप में प्रदर्शित करने देता है।
- Google Data Studio: डैशबोर्ड और विजुअल रिपोर्ट बनाने के लिए।
- Tableau: डेटा विज़ुअलाइज़ेशन के लिए अग्रणी प्लेटफ़ॉर्म।
ये टूल्स डेटा तक पहुंचने, उसे ट्रांसफॉर्म करने, और विजुअलाइज़ करने में मदद करते हैं ताकि सार्थक अंतर्दृष्टि निकाली जा सके और निर्णय-निर्माण प्रक्रियाओं को समर्थन मिले।
11. OLAP और OLTP सिस्टम्स में क्या अंतर है?
OLAP (Online Analytical Processing) ऐतिहासिक डेटा का विश्लेषण करता है और जटिल क्वेरीज़ का समर्थन करता है। यह रीड-हैवी वर्कलोड्स के लिए ऑप्टिमाइज़्ड होता है और अक्सर बिज़नेस इंटेलिजेंस कार्यों के लिए डेटा वेयरहाउसेज़ में उपयोग होता है। OLTP (Online Transaction Processing) रियल-टाइम ट्रांज़ैक्शनल डेटा के प्रबंधन के लिए डिजाइन किया गया है। यह राइट-हैवी वर्कलोड्स के लिए ऑप्टिमाइज़्ड होता है और रोज़मर्रा के व्यावसायिक संचालन के लिए ऑपरेशनल डेटाबेस में उपयोग होता है।
मुख्य अंतर इनके उद्देश्य में है: OLAP निर्णय-निर्माण का समर्थन करता है, जबकि OLTP दैनिक संचालन का।
यदि अभी भी संदेह है, तो मैं OLTP बनाम OLAP ब्लॉग पोस्ट पढ़ने की सलाह देता/देती हूँ।
Python डेटा इंजीनियर इंटरव्यू प्रश्न
Python अपनी बहुमुखी प्रतिभा और डेटा प्रोसेसिंग, विश्लेषण, और ऑटोमेशन के लिए उपलब्ध समृद्ध लाइब्रेरी इकोसिस्टम के कारण डेटा इंजीनियरिंग में सबसे लोकप्रिय भाषा है। यहाँ Python से जुड़े कुछ प्रश्न हैं जिनका सामना आपको डेटा इंजीनियरिंग इंटरव्यू में हो सकता है।
12. डेटा प्रोसेसिंग के लिए कौन-सी Python लाइब्रेरीज़ सबसे प्रभावी हैं?
Python में सबसे लोकप्रिय डेटा प्रोसेसिंग लाइब्रेरीज़ में शामिल हैं:
- pandas: डेटा मैनिपुलेशन और विश्लेषण के लिए आदर्श, जो DataFrames जैसी डेटा संरचनाएँ प्रदान करता है।
- NumPy: संख्यात्मक गणनाओं के लिए आवश्यक, जो बड़े मल्टी-डाइमेंशनल एरेज़ और मैट्रिसेज़ का समर्थन करता है।
- Dask: पैरेलल कंप्यूटिंग को सक्षम करता है और pandas जैसी सिंटैक्स के साथ मेमोरी से बड़े कम्प्यूटेशन संभाल सकता है।
- PySpark: Apache Spark के लिए Python API, बड़े पैमाने पर डेटा प्रोसेसिंग और रियल-टाइम एनालिटिक्स के लिए उपयोगी।
इनमें से प्रत्येक लाइब्रेरी के अपने फायदे-नुकसान हैं, और चुनाव विशिष्ट डेटा आवश्यकताओं और प्रोसेसिंग कार्यों के पैमाने पर निर्भर करता है।
13. आप Python में वेब स्क्रैपिंग कैसे करते हैं?
Python में वेब स्क्रैपिंग आमतौर पर निम्न चरणों में होती है:
1. requests लाइब्रेरी का उपयोग करके वेबपेज एक्सेस करें:
import requests
from bs4 import BeautifulSoup
url = 'http://example.com'
response = requests.get(url)
soup = BeautifulSoup(response.text, 'html.parser')2. BeautifulSoup का उपयोग करके टेबल्स और जानकारी निकालें:
tables = soup.find_all('table')3. इसे pandas का उपयोग करके स्ट्रक्चर्ड फॉर्मेट में बदलें:
import pandas as pd
data = []
for table in tables:
rows = table.find_all('tr')
for row in rows:
cols = row.find_all('td')
cols = [ele.text.strip() for ele in cols]
data.append(cols)
df = pd.DataFrame(data)4. pandas और NumPy का उपयोग करके डेटा को साफ़ करें:
df.dropna(inplace=True) # Drop missing values5. डेटा को CSV फ़ाइल के रूप में सहेजें:
df.to_csv('scraped_data.csv', index=False)कुछ मामलों में, pandas.read_html प्रक्रिया को सरल कर सकता है:
df_list = pd.read_html('http://example.com')
df = df_list[0] # Assuming the table of interest is the first one14. आप ऐसे बड़े डेटासेट्स को कैसे संभालते हैं जो मेमोरी में फिट नहीं होते?
मेमोरी में फिट न होने वाले बड़े डेटासेट्स को संभालने के लिए आउट-ऑफ-कोर कम्प्यूटेशन के लिए बने टूल्स और तकनीकों का उपयोग करना आवश्यक है:
- Dask: पैरेलल कंप्यूटिंग की सुविधा देता है और pandas-जैसी सिंटैक्स के साथ मेमोरी से बड़े डेटासेट्स पर काम करता है।
import dask.dataframe as dd
df = dd.read_csv('large_dataset.csv')- PySpark: डिस्ट्रिब्यूटेड डेटा प्रोसेसिंग सक्षम करता है, जो बड़े पैमाने के डेटा को संभालने में उपयोगी है।
from pyspark.sql import SparkSession
spark = SparkSession.builder.appName('data_processing').getOrCreate()
df = spark.read.csv('large_dataset.csv', header=True, inferSchema=True)- pandas के साथ चंकिंग: बड़े डेटासेट्स को चंक्स में पढ़ें।
import pandas as pd
chunk_size = 10000
for chunk in pd.read_csv('large_dataset.csv', chunksize=chunk_size):
process(chunk) # Replace with your processing function15. आप कैसे सुनिश्चित करते हैं कि आपका Python कोड कुशल और प्रदर्शन के लिए ऑप्टिमाइज़्ड है?
Python कोड को कुशल और प्रदर्शन के लिए ऑप्टिमाइज़्ड रखने के लिए निम्न प्रथाओं पर विचार करें:
- प्रोफाइलिंग: अपने कोड में बॉटलनेक्स की पहचान करने के लिए
cProfile,line_profiler, याmemory_profilerजैसे टूल्स का उपयोग करें।
import cProfile
cProfile.run('your_function()')- वेक्टराइज़ेशन: लूप्स की बजाय वेक्टराइज़्ड ऑपरेशंस के लिए
numpyयाpandasका उपयोग करें।
import numpy as np
data = np.array([1, 2, 3, 4, 5])
result = data * 2 # Vectorized operation- कुशल डेटा संरचनाएँ: अपने उपयोग-केस के आधार पर उपयुक्त डेटा स्ट्रक्चर्स (जैसे, lists, sets, dictionaries) चुनें।
data_dict = {'key1': 'value1', 'key2': 'value2'} # Faster lookups compared to lists- पैरेलल प्रोसेसिंग: ऐसे कार्यों के लिए मल्टी-थ्रेडिंग या मल्टी-प्रोसेसिंग का उपयोग करें जिन्हें समानांतर किया जा सकता है।
from multiprocessing import Pool
def process_data(data_chunk):
# Your processing logic here
return processed_chunk
with Pool(processes=4) as pool:
results = pool.map(process_data, data_chunks)- अनावश्यक कम्प्यूटेशंस से बचना: यदि किसी महंगे ऑपरेशन के परिणामों का पुन: उपयोग होना है, तो उन्हें कैश करें।
from functools import lru_cache
@lru_cache(maxsize=None)
def expensive_computation(x):
# Perform expensive computation
return result16. आप अपनी डेटा पाइपलाइंस में डेटा अखंडता और गुणवत्ता कैसे सुनिश्चित करते हैं?
विश्वसनीय डेटा इंजीनियरिंग के लिए डेटा अखंडता और गुणवत्ता महत्वपूर्ण हैं। श्रेष्ठ प्रथाओं में शामिल हैं:
- डेटा वैलिडेशन: डेटा पाइपलाइन के विभिन्न चरणों पर डेटा फ़ॉर्मैट, रेंज, और स्थिरता को मान्य करने के लिए चेक्स लागू करें।
def validate_data(df):
assert df['age'].min() >= 0, "Age cannot be negative"
assert df['salary'].dtype == 'float64', "Salary should be a float"
# Additional checks...- डेटा क्लीनिंग: मिसिंग वैल्यूज़ को संभालकर, डुप्लिकेट्स हटाकर, और त्रुटियों को ठीक करके डेटा की सफाई और प्रीप्रोसेसिंग के लिए
pandasजैसी लाइब्रेरीज़ का उपयोग करें।
df.dropna(inplace=True) # Drop missing values
df.drop_duplicates(inplace=True) # Remove duplicates- स्वचालित परीक्षण:
pytestजैसे फ़्रेमवर्क्स का उपयोग करके डेटा प्रोसेसिंग फ़ंक्शंस के लिए यूनिट टेस्ट विकसित करें।
import pytest
def test_clean_data():
raw_data = pd.DataFrame({'age': [25, -3], 'salary': ['50k', '60k']})
clean_data = clean_data_function(raw_data)
assert clean_data['age'].min() >= 0
assert clean_data['salary'].dtype == 'float64'- मॉनिटरिंग और अलर्ट्स: अपनी डेटा पाइपलाइंस के लिए मॉनिटरिंग सेट करें ताकि विसंगतियों का पता चल सके और डेटा गुणवत्ता मुद्दे आने पर अलर्ट भेजे जा सकें।
from airflow import DAG
from airflow.operators.dummy_operator import DummyOperator
from airflow.operators.email_operator import EmailOperator
# Define your DAG and tasks...17. आप अपने डेटासेट्स में मिसिंग डेटा को कैसे संभालते हैं?
मिसिंग डेटा को संभालना डेटा इंजीनियरिंग में एक सामान्य कार्य है। दृष्टिकोणों में शामिल हैं:
- हटाना: यदि वे महत्वपूर्ण नहीं हैं, तो मिसिंग डेटा वाली पंक्तियों या कॉलम्स को हटा दें।
df.dropna(inplace=True)- इम्प्यूटेशन: सांख्यिकीय माप (मीन, मीडियन) से मिसिंग वैल्यूज़ भरना या KNN इम्प्यूटेशन जैसी उन्नत विधियों का उपयोग करना।
df['column'].fillna(df['column'].mean(), inplace=True)- इंडिकेटर वैरिएबल: यह बताने के लिए एक इंडिकेटर वैरिएबल जोड़ें कि कौन-सी वैल्यूज़ मिसिंग थीं।
df['column_missing'] = df['column'].isnull().astype(int)- मॉडल-आधारित इम्प्यूटेशन: मिसिंग वैल्यूज़ का अनुमान लगाने के लिए प्रेडिक्टिव मॉडलिंग का उपयोग करें।
from sklearn.impute import KNNImputer
imputer = KNNImputer(n_neighbors=5)
df = pd.DataFrame(imputer.fit_transform(df), columns=df.columns)18. Python में API रेट लिमिट्स को डेटा फ़ेच करते समय आप कैसे संभालते हैं?
API रेट लिमिट्स को संभालने के लिए कुछ रणनीतियाँ हैं, जैसे:
- बैकऑफ और रिट्राई: रेट लिमिट्स तक पहुँचने पर एक्सपोनेन्शियल बैकऑफ लागू करना।
- पैजिनेशन: API की पैजिनेशन विकल्पों का उपयोग करके डेटा को छोटे हिस्सों में फ़ेच करना।
- कैशिंग: अनावश्यक API कॉल्स से बचने के लिए रिस्पॉन्सेस को स्टोर करना।
Python की time लाइब्रेरी और requests मॉड्यूल का उपयोग करते हुए उदाहरण:
import time
import requests
def fetch_data_with_rate_limit(url):
for attempt in range(5): # Retry up to 5 times
response = requests.get(url)
if response.status_code == 429: # Too many requests
time.sleep(2 ** attempt) # Exponential backoff
else:
return response.json()
raise Exception("Rate limit exceeded")Python निस्संदेह डेटा इंजीनियरिंग में सबसे महत्वपूर्ण भाषाओं में से एक है। आप हमारे Data Engineer in Python ट्रैक को लेकर अपने कौशल निखार सकते हैं, जो आधुनिक डेटा इंजीनियरिंग कॉन्सेप्ट्स, प्रोग्रामिंग भाषाओं, टूल्स, और फ्रेमवर्क्स से युक्त एक व्यापक पाठ्यक्रम कवर करता है।
SQL डेटा इंजीनियर इंटरव्यू प्रश्न
SQL कोडिंग चरण डेटा इंजीनियरिंग हायरिंग प्रक्रिया का एक महत्वपूर्ण हिस्सा है। विभिन्न सरल और जटिल स्क्रिप्ट्स का अभ्यास आपकी तैयारी में मदद कर सकता है। इंटरव्यूअर आपसे डेटा एनालिटिक्स, कॉमन टेबल एक्सप्रेशंस, रैंकिंग, सबटोटल्स जोड़ना, और टेम्पररी फ़ंक्शंस लिखने के लिए कह सकते हैं।
19. SQL में कॉमन टेबल एक्सप्रेशंस (CTEs) क्या होते हैं?
CTEs जटिल जॉइन्स को सरल बनाने और सबक्वेरीज़ चलाने के लिए उपयोग होते हैं। वे SQL क्वेरीज़ को अधिक पठनीय और मेंटेन करने योग्य बनाते हैं। यहाँ एक CTE का उदाहरण है जो सभी ऐसे छात्रों को दिखाता है जिनका मेजर Science है और ग्रेड A है:
SELECT *
FROM class
WHERE id IN (
SELECT DISTINCT id
FROM students
WHERE grade = "A"
AND major = "Science"
);CTE का उपयोग करने पर, क्वेरी इस प्रकार हो जाती है:
WITH temp AS (
SELECT id
FROM students
WHERE grade = "A"
AND major = "Science"
)
SELECT *
FROM class
WHERE id IN (SELECT id FROM temp);CTEs का उपयोग अधिक जटिल समस्याओं के लिए किया जा सकता है और कई CTEs को एक साथ जोड़ा जा सकता है।
20. आप SQL में डेटा को कैसे रैंक करते हैं?
डेटा इंजीनियर अक्सर बिक्री और लाभ जैसे पैरामीटर्स के आधार पर मानों को रैंक करते हैं। RANK() फ़ंक्शन का उपयोग किसी विशिष्ट कॉलम के आधार पर डेटा को रैंक करने के लिए किया जाता है:
SELECT
id,
sales,
RANK() OVER (ORDER BY sales DESC) AS rank
FROM bill;वैकल्पिक रूप से, आप DENSE_RANK() का उपयोग कर सकते हैं, जो समान मान होने पर बाद की रैंक्स को नहीं छोड़ता।
21. क्या आप एक सरल टेम्पररी फ़ंक्शन बना सकते हैं और उसे SQL क्वेरी में उपयोग कर सकते हैं?
Python की तरह, आप SQL में भी फ़ंक्शंस बना सकते हैं ताकि आपकी क्वेरीज़ अधिक सुंदर हों और दोहराए जाने वाले case स्टेटमेंट्स से बचा जा सके। यहाँ एक टेम्पररी फ़ंक्शन get_gender का उदाहरण है:
CREATE TEMPORARY FUNCTION get_gender(type VARCHAR) RETURNS VARCHAR AS (
CASE
WHEN type = "M" THEN "male"
WHEN type = "F" THEN "female"
ELSE "n/a"
END
);
SELECT
name,
get_gender(type) AS gender
FROM class;यह तरीका आपके SQL कोड को साफ़ और अधिक मेंटेन करने योग्य बनाता है।
22. आप SQL में सबटोटल्स कैसे जोड़ते हैं?
सबटोटल्स जोड़ने के लिए GROUP BY और ROLLUP() फ़ंक्शंस का उपयोग किया जा सकता है। उदाहरण:
SELECT
department,
product,
SUM(sales) AS total_sales
FROM sales_data
GROUP BY ROLLUP(department, product);यह क्वेरी प्रत्येक विभाग के लिए सबटोटल और अंत में एक ग्रैंड टोटल देगी।
23. आप SQL में मिसिंग डेटा को कैसे संभालते हैं?
डेटा अखंडता बनाए रखने के लिए मिसिंग डेटा को संभालना आवश्यक है। सामान्य तरीकों में शामिल हैं:
COALESCE()का उपयोग: यह फ़ंक्शन सूची में पहला non-null मान लौटाता है।
SELECT id, COALESCE(salary, 0) AS salary FROM employees;CASEस्टेटमेंट्स का उपयोग: कंडीशनली मिसिंग वैल्यूज़ को संभालने के लिए।
SELECT id,
CASE
WHEN salary IS NULL THEN 0
ELSE salary
END AS salary
FROM employees;24. आप SQL में डेटा एग्रीगेशन कैसे करते हैं?
डेटा एग्रीगेशन में SUM(), AVG(), COUNT(), MIN(), और MAX() जैसे एग्रीगेट फ़ंक्शंस का उपयोग शामिल है। उदाहरण:
SELECT department,
SUM(salary) AS total_salary,
AVG(salary) AS average_salary,
COUNT(*) AS employee_count
FROM employees
GROUP BY department;25. बेहतर प्रदर्शन के लिए आप SQL क्वेरीज़ को कैसे ऑप्टिमाइज़ करते हैं?
SQL क्वेरीज़ को ऑप्टिमाइज़ करने के लिए आप यह कर सकते हैं:
- अक्सर क्वेरी किए जाने वाले कॉलम्स पर इंडेक्स का उपयोग करें ताकि लुकअप तेज़ हों।
- केवल आवश्यक कॉलम्स निर्दिष्ट करके
SELECT *से बचें। - जॉइन्स का समझदारी से उपयोग करें और अनावश्यक जॉइन्स से बचें।
- उचित होने पर सबक्वेरीज़ को CTEs से बदलकर ऑप्टिमाइज़ करें।
- क्वेरी एक्ज़ीक्यूशन प्लान का विश्लेषण करें ताकि बॉटलनेक्स की पहचान हो सके। उदाहरण:
EXPLAIN ANALYZE
SELECT customer_id, COUNT(order_id)
FROM orders
GROUP BY customer_id;SQL कोडिंग अभ्यासों को हल करना अभ्यास करने और भूले हुए कॉन्सेप्ट्स को दोहराने का सबसे अच्छा तरीका है। आप DataCamp का Data Analysis in SQL टेस्ट देकर अपने SQL कौशल का आकलन कर सकते हैं (इस असेसमेंट तक पहुँचने के लिए आपको एक अकाउंट की आवश्यकता होगी)।
प्रोजेक्ट-संबंधित डेटा इंजीनियर इंटरव्यू प्रश्न
सामान्य राउंड्स के बाद, आप आम तौर पर एक तकनीकी चरण में जाते हैं जिसमें कोडिंग चुनौतियाँ, समस्या-समाधान, व्हाइटबोर्ड पर डेटाबेस सिस्टम डिजाइन, टेक-होम एग्ज़ाम, और विश्लेषणात्मक प्रश्न शामिल होते हैं।
यह चरण काफी तीव्र हो सकता है, इसलिए कुछ सामान्य डेटा इंजीनियरिंग इंटरव्यू प्रश्नों और उत्तरों को जानना आपको इंटरव्यू में उत्कृष्टता हासिल करने में मदद कर सकता है।
26. किसी ऐसे प्रोजेक्ट के बारे में बताइए जिस पर आपने शुरुआत से अंत तक काम किया हो।
यदि आपने पहले छात्र या प्रोफ़ेशनल के रूप में डेटा इंजीनियरिंग प्रोजेक्ट पर काम किया है, तो यह उत्तर स्वाभाविक होना चाहिए। फिर भी, पहले से तैयारी करना हमेशा सहायक होता है। अपना उत्तर इस तरह संरचित करें:
- परिचय और व्यावसायिक समस्या:
- प्रोजेक्ट का संदर्भ समझाकर शुरू करें। उस व्यावसायिक समस्या का वर्णन करें जिसे आप हल कर रहे थे और परियोजना के लक्ष्य।
- उदाहरण: "इस प्रोजेक्ट में, हमने एनालिटिक्स टीम के लिए क्वेरी प्रदर्शन और डेटा सटीकता में सुधार करने हेतु TLC Trip Record डेटा प्रोसेसिंग के लिए डेटा पाइपलाइन को ऑप्टिमाइज़ करने का लक्ष्य रखा।"
- डेटा इनजेशन:
- बताएं कि आपने कच्चे डेटा तक कैसे पहुंच बनाई और उसे कैसे इनजेस्ट किया।
- उदाहरण: "हमने GCP, Airflow, और PostgreSQL का उपयोग करके कच्चे TLC Trip Record डेटा को इनजेस्ट किया ताकि अनेक स्रोतों से विश्वसनीय डेटा इनटेक सुनिश्चित हो।"
- डेटा प्रोसेसिंग और ट्रांसफॉर्मेशन:
- डेटा को साफ़ करने, ट्रांसफॉर्म करने, और संरचित करने के लिए उठाए गए चरणों को समझाएँ।
- उदाहरण: "हमने बैच प्रोसेसिंग के लिए Apache Spark और रियल-टाइम स्ट्रीमिंग के लिए Apache Kafka का उपयोग किया। डेटा को साफ़ किया गया, सत्यापित किया गया, और विश्लेषण के लिए उपयुक्त संरचित फॉर्मेट में बदला गया।"
- डेटा स्टोरेज और वेयरहाउजिंग:
- उपयोग किए गए डेटा स्टोरेज समाधानों और उन्हें चुनने के कारणों पर चर्चा करें।
- उदाहरण: "प्रोसेस्ड डेटा को Google BigQuery में स्टोर किया गया, जिसने एक स्केलेबल और कुशल डेटा वेयरहाउजिंग समाधान प्रदान किया। डेटा वर्कफ़्लोज़ को मैनेज करने के लिए Airflow का उपयोग किया गया।"
- एनालिटिकल इंजीनियरिंग:
- विश्लेषणात्मक उद्देश्यों के लिए उपयोग किए गए टूल्स और तरीकों को हाइलाइट करें।
- उदाहरण: "हमने एनालिटिकल इंजीनियरिंग के लिए dbt (data build tool), BigQuery, PostgreSQL, Google Data Studio, और Metabase का उपयोग किया। इन टूल्स ने मजबूत डेटा मॉडल बनाने और सूचनाप्रद रिपोर्ट्स व डैशबोर्ड्स तैयार करने में मदद की।"
- डिप्लॉयमेंट और क्लाउड वातावरण:
- डिप्लॉयमेंट स्ट्रेटेजीज़ और उपयोग किए गए क्लाउड इन्फ्रास्ट्रक्चर का उल्लेख करें।
- उदाहरण: "पूरा प्रोजेक्ट GCP, Terraform, और Docker का उपयोग करके डिप्लॉय किया गया, जिससे एक स्केलेबल और विश्वसनीय क्लाउड वातावरण सुनिश्चित हुआ।"
- चुनौतियाँ और समाधान:
- जिन चुनौतियों का सामना किया और आपने उन्हें कैसे हल किया, उस पर चर्चा करें।
- उदाहरण: "मुख्य चुनौतियों में से एक रियल-टाइम में उच्च वॉल्यूम डेटा को संभालना था। हमने अपने Kafka स्ट्रीमिंग जॉब्स को ऑप्टिमाइज़ करके और कुशल Spark ट्रांसफॉर्मेशंस लागू करके इसे संबोधित किया।"
- परिणाम और प्रभाव:
- अंत में परियोजना के परिणामों और प्रभाव का वर्णन करें।
- उदाहरण: "प्रोजेक्ट ने एनालिटिक्स टीम के लिए क्वेरी प्रदर्शन और डेटा सटीकता में उल्लेखनीय सुधार किया, जिससे तेज़ निर्णय-निर्माण और बेहतर अंतर्दृष्टियाँ संभव हुईं।"
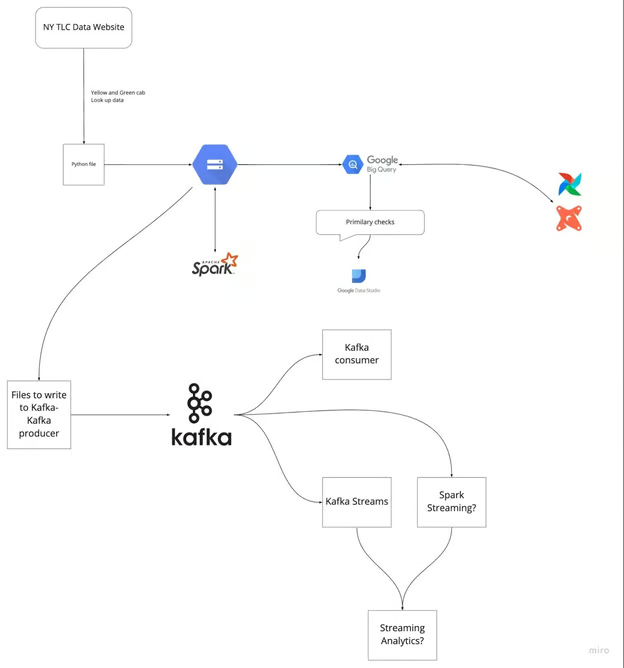
चित्र DataTalksClub/data-engineering-zoomcamp से
इंटरव्यू के दौरान हिचकिचाहट से बचने के लिए आपने जिन अंतिम पाँच प्रोजेक्ट्स पर काम किया है, उनकी समीक्षा पहले से करना सहायक होगा। समस्या विवरण और आपके द्वारा लागू किए गए समाधानों को समझें। प्रत्येक चरण को स्पष्ट और संक्षेप में समझाने का अभ्यास करें।
डेटा इंजीनियर मैनेजर इंटरव्यू प्रश्न
इंजीनियरिंग मैनेजर पदों के लिए, प्रश्न आमतौर पर निर्णय-निर्माण, व्यावसायिक समझ, डेटासेट्स का क्यूरेशन और रखरखाव, अनुपालन, और सुरक्षा नीतियों से संबंधित होते हैं।
27. डेटा वेयरहाउस और ऑपरेशनल डेटाबेस में क्या अंतर है?
डेटा वेयरहाउस डेटा एनालिटिक्स कार्यों और निर्णय-निर्माण के लिए ऐतिहासिक डेटा को सर्व करता है। यह Online Analytical Processing (OLAP) जैसे उच्च-वॉल्यूम विश्लेषणात्मक प्रोसेसिंग का समर्थन करता है। डेटा वेयरहाउसेज़ जटिल क्वेरीज़ को संभालने के लिए डिजाइन किए जाते हैं जो कई पंक्तियों तक पहुँचती हैं और रीड-हैवी ऑपरेशंस के लिए ऑप्टिमाइज़्ड होते हैं। वे कुछ समवर्ती उपयोगकर्ताओं का समर्थन करते हैं और बड़े वॉल्यूम का डेटा तेज़ी से और कुशलता से पुनर्प्राप्त करने के लिए बनाए गए हैं।
ऑपरेशनल डेटाबेस मैनेजमेंट सिस्टम्स (OLTP) रियल-टाइम में डायनेमिक डेटासेट्स का प्रबंधन करते हैं। वे हज़ारों समवर्ती क्लाइंट्स के लिए उच्च-वॉल्यूम ट्रांज़ैक्शन प्रोसेसिंग का समर्थन करते हैं, जिससे वे रोज़मर्रा के संचालन के लिए उपयुक्त होते हैं। डेटा आमतौर पर व्यावसायिक लेनदेन और संचालन के बारे में वर्तमान, अद्यतन जानकारी से बना होता है। OLTP सिस्टम्स राइट-हैवी ऑपरेशंस और तेज़ क्वेरी प्रोसेसिंग के लिए ऑप्टिमाइज़्ड होते हैं।
28. आपको क्यों लगता है कि डेटा सिस्टम्स का उपयोग करने वाली हर फर्म को एक डिजास्टर रिकवरी प्लान की आवश्यकता होती है?
डिजास्टर मैनेजमेंट डेटा इंजीनियरिंग मैनेजर की ज़िम्मेदारी है। डिजास्टर रिकवरी प्लान सुनिश्चित करता है कि साइबर-अटैक, हार्डवेयर फेल्योर, प्राकृतिक आपदा, या अन्य विनाशकारी घटनाओं की स्थिति में डेटा सिस्टम्स को पुनर्स्थापित किया जा सके और वे काम करना जारी रखें। प्रासंगिक पहलू शामिल हैं:
- रियल-टाइम बैकअप: फ़ाइलों और डाटाबेस का नियमित रूप से सुरक्षित, ऑफसाइट स्टोरेज लोकेशंस पर बैकअप लेना।
- डेटा रिडंडेंसी: उपलब्धता सुनिश्चित करने के लिए विभिन्न भौगोलिक स्थानों पर डेटा प्रतिकृति लागू करना।
- सुरक्षा प्रोटोकॉल: डेटा उल्लंघनों को रोकने के लिए इनकमिंग और आउटगोइंग ट्रैफ़िक दोनों की निगरानी, ट्रेसिंग, और प्रतिबंधित करने के प्रोटोकॉल स्थापित करना।
- रिकवरी प्रक्रियाएँ: डाउनटाइम को न्यूनतम करने के लिए डेटा और सिस्टम्स को तेज़ी और कुशलता से पुनर्स्थापित करने की विस्तृत प्रक्रियाएँ।
- टेस्टिंग और ड्रिल्स: इसकी प्रभावशीलता सुनिश्चित करने और आवश्यक समायोजन करने के लिए सिमुलेशंस और ड्रिल्स के माध्यम से नियमित रूप से डिजास्टर रिकवरी प्लान का परीक्षण।
29. डेटा इंजीनियरिंग टीम का नेतृत्व करते समय आप निर्णय-निर्माण कैसे करते हैं?
डेटा इंजीनियरिंग मैनेजर के रूप में, निर्णय-निर्माण में तकनीकी विचारों और व्यावसायिक उद्देश्यों के बीच संतुलन शामिल होता है। कुछ तरीके शामिल हैं:
- डेटा-आधारित निर्णय: निर्णयों को सूचित करने के लिए डेटा एनालिटिक्स का उपयोग करना, जिससे वे अंतर्ज्ञान की बजाय वस्तुनिष्ठ अंतर्दृष्टियों पर आधारित हों।
- हितधारक सहयोग: हितधारकों के साथ मिलकर काम करना ताकि व्यावसायिक आवश्यकताओं को समझा जा सके और डेटा इंजीनियरिंग प्रयासों को कंपनी के लक्ष्यों के साथ संरेखित किया जा सके।
- जोखिम मूल्यांकन: संभावित जोखिमों और उनके प्रोजेक्ट्स पर प्रभाव का आकलन करना और शमन रणनीतियाँ विकसित करना।
- एजाइल पद्धतियाँ: बदलती आवश्यकताओं के अनुरूप होने और क्रमिक रूप से मूल्य प्रदान करने के लिए एजाइल प्रैक्टिसेस लागू करना।
- मेंटरशिप और विकास: टीम के सदस्यों के विकास का समर्थन करना—मेंटरशिप और प्रशिक्षण अवसर प्रदान करके—और एक सहयोगी वातावरण को बढ़ावा देना।
30. आप अपने डेटा इंजीनियरिंग प्रोजेक्ट्स में डेटा सुरक्षा विनियमों के अनुपालन को कैसे संभालते हैं?
डेटा सुरक्षा विनियमों के अनुपालन में कई प्रथाएँ शामिल होती हैं, उदाहरण के लिए:
- विनियमों की समझ: GDPR, CCPA, और HIPAA जैसे डेटा सुरक्षा विनियमों पर अद्यतन रहना।
- डेटा गवर्नेंस फ़्रेमवर्क: डेटा गोपनीयता, सुरक्षा, और एक्सेस कंट्रोल के लिए नीतियाँ शामिल करने वाला एक मजबूत डेटा गवर्नेंस फ्रेमवर्क लागू करना।
- डेटा एन्क्रिप्शन: संवेदनशील डेटा को at rest और in transit दोनों स्थितियों में एन्क्रिप्ट करना ताकि अनधिकृत एक्सेस रोका जा सके।
- एक्सेस कंट्रोल्स: सख्त एक्सेस कंट्रोल्स लागू करना ताकि केवल अधिकृत कर्मियों को ही संवेदनशील डेटा तक पहुँच हो।
- ऑडिट्स और मॉनिटरिंग: किसी भी अनुपालन मुद्दे का शीघ्र पता लगाने और समाधान करने के लिए डेटा एक्सेस और उपयोग का नियमित ऑडिट और मॉनिटरिंग करना।
31. क्या आप किसी चुनौतीपूर्ण डेटा इंजीनियरिंग प्रोजेक्ट का वर्णन कर सकते हैं जिसे आपने मैनेज किया?
किसी चुनौतीपूर्ण प्रोजेक्ट पर चर्चा करते समय, आप निम्न पहलुओं पर ध्यान केंद्रित कर सकते हैं:
- प्रोजेक्ट स्कोप और उद्देश्य: प्रोजेक्ट के लक्ष्यों और जिस व्यावसायिक समस्या को हल करने का उद्देश्य था, उसे स्पष्ट रूप से परिभाषित करें।
- सामना की गई चुनौतियाँ: तकनीकी सीमाओं, संसाधन बाधाओं, या हितधारक संरेखण मुद्दों जैसी विशिष्ट चुनौतियों का वर्णन करें।
- रणनीतियाँ और समाधान: इन चुनौतियों को पार करने के लिए आपके तरीकों—तकनीकी समाधान, टीम प्रबंधन प्रथाएँ, और हितधारक एंगेजमेंट—को समझाएँ।
- परिणाम और प्रभाव: सफल परिणामों और व्यवसाय पर प्रभाव को हाइलाइट करें, जैसे बेहतर डेटा गुणवत्ता, उन्नत सिस्टम प्रदर्शन, या बढ़ी हुई परिचालन दक्षता।
32. आप नई डेटा तकनीकों का मूल्यांकन और कार्यान्वयन कैसे करते हैं?
नई डेटा तकनीकों का मूल्यांकन और कार्यान्वयन शामिल करता है:
- मार्केट रिसर्च: डेटा इंजीनियरिंग तकनीकों में नवीनतम प्रगति और रुझानों से अवगत रहना।
- प्रूफ़ ऑफ कॉन्सेप्ट (PoC): अपनी विशिष्ट परिस्थिति में नई तकनीकों की व्यवहार्यता और लाभों का परीक्षण करने के लिए PoC प्रोजेक्ट्स करना।
- कॉस्ट-बेनेफिट एनालिसिस: नई तकनीकों को अपनाने की लागत, लाभ, और संभावित ROI का आकलन करना।
- हितधारक समर्थन: निष्कर्षों और सिफारिशों को हितधारकों के सामने प्रस्तुत करना ताकि समर्थन और अनुमोदन प्राप्त हो सके।
- इम्प्लीमेंटेशन प्लान: टाइमलाइन्स, संसाधन आवंटन, और जोखिम प्रबंधन रणनीतियों सहित एक विस्तृत इम्प्लीमेंटेशन प्लान विकसित करना।
- ट्रेनिंग और सपोर्ट: टीम को प्रशिक्षण और समर्थन प्रदान करना ताकि नई तकनीकों में सुचारू रूपांतरण सुनिश्चित हो सके।
33. तेज़-रफ़्तार वाले वातावरण में आप कार्यों और प्रोजेक्ट्स को कैसे प्राथमिकता देते हैं?
कार्यों को प्राथमिकता देने का एक प्रभावी तरीका उन्हें उनके व्यावसायिक उद्देश्यों पर प्रभाव और तात्कालिकता के आधार पर क्रमबद्ध करना है। आप Eisenhower Matrix जैसे फ़्रेमवर्क का उपयोग कर सकते हैं जो कार्यों को चार चतुर्थांशों में वर्गीकृत करता है: तात्कालिक और महत्वपूर्ण, महत्वपूर्ण परन्तु गैर-तात्कालिक, तात्कालिक परन्तु गैर-महत्वपूर्ण, और न दोनों। इसके अलावा, हितधारकों के साथ संवाद कर प्राथमिकताओं को संरेखित करें और सुनिश्चित करें कि टीम उच्च-मूल्य की गतिविधियों पर केंद्रित रहे।
FAANG डेटा इंजीनियर इंटरव्यू प्रश्न
इस खंड में, हम Facebook, Amazon, और Google के मैनेजर्स द्वारा डेटा इंजीनियरिंग पदों के लिए सबसे अधिक पूछे जाने वाले डेटा इंजीनियरिंग इंटरव्यू प्रश्नों की पड़ताल करते हैं।
Facebook डेटा इंजीनियर इंटरव्यू प्रश्न
34. हम Kafka में क्लस्टर्स का उपयोग क्यों करते हैं, और इसके क्या लाभ हैं?
एक Kafka क्लस्टर में कई ब्रोकर्स होते हैं जो डेटा को कई इंस्टेंसेज़ में वितरित करते हैं। यह आर्किटेक्चर बिना डाउनटाइम के स्केलेबिलिटी और फॉल्ट टॉलरेंस प्रदान करता है। यदि प्राथमिक क्लस्टर बंद हो जाता है, तो अन्य Kafka क्लस्टर्स वही सेवाएँ प्रदान कर सकते हैं, जिससे उच्च उपलब्धता सुनिश्चित होती है।
Kafka क्लस्टर आर्किटेक्चर में Topics, Brokers, ZooKeeper, Producers, और Consumers शामिल होते हैं। यह बड़े डेटा अनुप्रयोगों के लिए डेटा स्ट्रीम्स को कुशलतापूर्वक संभालता है, जिससे मजबूत डेटा-चालित एप्लिकेशंस बनाना संभव होता है।
35. Apache Airflow किन समस्याओं का समाधान करता है?
Apache Airflow आपको विश्लेषणात्मक वर्कफ़्लोज़, डेटा वेयरहाउस प्रबंधन, और डेटा ट्रांसफॉर्मेशन एवं मॉडलिंग के लिए पाइपलाइनों का प्रबंधन और शेड्यूल करने की अनुमति देता है। यह प्रदान करता है:
- पाइपलाइन प्रबंधन: वर्कफ़्लोज़ को परिभाषित, शेड्यूल, और मॉनिटर करने का प्लेटफ़ॉर्म।
- केंद्रीकृत लॉगिंग: एक ही जगह पर एक्ज़ीक्यूशन लॉग्स की निगरानी।
- एरर हैंडलिंग: Slack और Discord जैसे कम्युनिकेशन प्लेटफ़ॉर्म्स पर फेल्योर अलर्ट भेजने के लिए कॉलबैक्स।
- यूज़र इंटरफ़ेस: वर्कफ़्लोज़ को मैनेज और विज़ुअलाइज़ करने के लिए उपयोगकर्ता-अनुकूल UI।
- इंटीग्रेशन: विभिन्न टूल्स और सिस्टम्स के साथ मजबूत इंटीग्रेशंस।
- ओपन सोर्स: यह मुफ़्त है और समुदाय द्वारा व्यापक रूप से समर्थित है।
Amazon डेटा इंजीनियर इंटरव्यू प्रश्न
36. आपको एक IP एड्रेस स्ट्रिंग के रूप में इनपुट दिया गया है। आप कैसे पता लगाएंगे कि यह वैध IP एड्रेस है या नहीं?
IP एड्रेस की वैधता निर्धारित करने के लिए, आप स्ट्रिंग को “.” पर स्प्लिट कर सकते हैं और प्रत्येक सेगमेंट को मान्य करने के लिए कई चेक्स बना सकते हैं। यहाँ एक Python फ़ंक्शन है जो यह करता है:
def is_valid(ip):
ip = ip.split(".")
for i in ip:
if len(i) > 3 or int(i) < 0 or int(i) > 255:
return False
if len(i) > 1 and int(i) == 0:
return False
if len(i) > 1 and int(i) != 0 and i[0] == '0':
return False
return True
A = "255.255.11.135"
B = "255.050.11.5345"
print(is_valid(A)) # True
print(is_valid(B)) # False37. Hadoop में विभिन्न मोड्स कौन-से हैं?
Hadoop मुख्यतः तीन मोड्स में काम करता है:
- स्टैंडअलोन मोड: यह मोड डिबगिंग उद्देश्यों के लिए उपयोग होता है। यह HDFS का उपयोग नहीं करता और इनपुट-आउटपुट के लिए लोकल फ़ाइल सिस्टम पर निर्भर रहता है।
- स्यूडो-डिस्ट्रिब्यूटेड मोड: यह एक सिंगल-नोड क्लस्टर है जिसमें NameNode और DataNode एक ही मशीन पर रहते हैं। यह मुख्यतः टेस्टिंग और डेवलपमेंट के लिए उपयोग होता है।
- फुली डिस्ट्रिब्यूटेड मोड: यह प्रोडक्शन-रेडी मोड है जिसमें डेटा कई नोड्स में वितरित होता है, और मास्टर (NameNode) और स्लेव (DataNode) डेमन्स के लिए अलग नोड्स होते हैं।
Google डेटा इंजीनियर इंटरव्यू प्रश्न
38. आप SQL क्वेरी में डुप्लिकेट डेटा पॉइंट्स को कैसे संभालेंगे?
SQL में डुप्लिकेट्स को संभालने के लिए आप DISTINCT कीवर्ड का उपयोग कर सकते हैं या ROWID के साथ MAX या MIN फ़ंक्शन का उपयोग करके डुप्लिकेट पंक्तियाँ हटा सकते हैं। उदाहरण:
DISTINCT का उपयोग करते हुए:
SELECT DISTINCT Name, ADDRESS
FROM CUSTOMERS
ORDER BY Name;ROWID का उपयोग करके डुप्लिकेट्स हटाना:
DELETE FROM Employee
WHERE ROWID NOT IN (
SELECT MAX(ROWID)
FROM Employee
GROUP BY Name, ADDRESS
);39. 1 से n की रेंज में n-1 पूर्णांकों की एक सूची दी गई है। सूची में कोई डुप्लिकेट नहीं है। इन पूर्णांकों में से एक सूची से गायब है। क्या आप गायब पूर्णांक खोजने के लिए कुशल कोड लिख सकते हैं?
इस सामान्य कोडिंग चुनौती को गणितीय दृष्टिकोण से हल किया जा सकता है:
def search_missing_number(list_num):
n = len(list_num)
# Check if the first or last number is missing
if list_num[0] != 1:
return 1
if list_num[-1] != n + 1:
return n + 1
# Calculate the sum of the first n+1 natural numbers
total = (n + 1) * (n + 2) // 2
# Calculate the sum of all elements in the list
sum_of_L = sum(list_num)
# Return the difference, which is the missing number
return total - sum_of_L
# Validation
num_list = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 13]
print("The missing number is", search_missing_number(num_list)) # The missing number is 12डेटा इंजीनियर इंटरव्यू की तैयारी कैसे करें
इंटरव्यू में उपस्थित होने से पहले, आपको डेटा इंजीनियरिंग में उपयोग होने वाले सभी कॉन्सेप्ट्स और मानक शब्दों की समीक्षा करनी चाहिए। यहाँ कुछ सबसे महत्वपूर्ण क्षेत्रों पर ध्यान केंद्रित करें:
- SQL में महारत हासिल करें: आपको डाटाबेस बनाना, संशोधित करना, और प्रबंधित करना अभ्यास करना चाहिए। इसके अलावा, आपको डेटा एनालिटिक्स, मॉडलिंग, और ट्रांसफॉर्मेशन में निपुण होना चाहिए।
- कोडिंग चुनौतियाँ हल करें: Python, Scala, या C++ कोडिंग चुनौतियाँ हल करें। अधिकांश कंपनियाँ टेक-होम एग्जाम्स और लाइव कोडिंग चुनौतियों के माध्यम से प्रोग्रामिंग कौशल का आकलन करती हैं।
- ETL पाइपलाइन डिज़ाइन करें: डेटा, ETL, या डिलीवरी पाइपलाइंस बनाना अभ्यास करें। आपको डेटा पाइपलाइंस का परीक्षण, सत्यापन, स्केलिंग, और रखरखाव करना समझना चाहिए।
- एनालिटिक्स इंजीनियरिंग: डेटा को लोड करना, ट्रांसफॉर्म करना, और एनालिटिक्स करना अभ्यास करें। डेटा गुणवत्ता और सिस्टम प्रदर्शन के लिए डैशबोर्ड बनाना सीखें।
- संभावित प्रश्नों की समीक्षा करें: सैंपल मॉक प्रश्नों की समीक्षा करके इंटरव्यू की तैयारी करें। एक साधारण Google सर्च आपको सैकड़ों प्रश्नों तक पहुंच प्रदान करेगा।
- आधुनिक डेटा इंजीनियरिंग टूल्स सीखें: भले ही आपके पास आधुनिक डेटा इंजीनियरिंग टूल्स का अनुभव न हो, आपको यह पता होना चाहिए कि वे कैसे काम करते हैं और अन्य टूल्स के साथ कैसे इंटीग्रेट होते हैं। कंपनियाँ हमेशा कम लागत पर बेहतर प्रदर्शन के लिए बेहतर टूल्स की तलाश में रहती हैं।
- बैच प्रोसेसिंग और स्ट्रीमिंग सीखें: Apache Spark बैच प्रोसेसिंग के लिए उपयोग होता है, और Apache Kafka डेटा स्ट्रीमिंग के लिए। ये टूल्स उच्च मांग में हैं और शीर्ष कंपनियों में नौकरी पाने में मदद करेंगे।
- पर्यावरण: कभी-कभी, इंटरव्यूअर क्लाउड कंप्यूटिंग (GCP, AWS, Azure), Docker, स्क्रिप्टिंग, Terraform, और Kubernetes के बारे में पूछेगा। आप इन टूल्स का उपयोग क्लाउड या ऑन-प्रिमाइसेज़ कंप्यूट और स्टोरेज संसाधन सेट करने के लिए कर सकते हैं। इन तकनीकों को समझना और उन्हें पोर्टफोलियो प्रोजेक्ट्स में एकीकृत करना एक अच्छी प्रैक्टिस है।
डेटा इंजीनियरिंग इंटरव्यू की तैयारी चुनौतीपूर्ण हो सकती है, लेकिन सही संसाधनों और अभ्यास के साथ, आप उत्कृष्ट प्रदर्शन कर सकते हैं और अपनी मनचाही नौकरी पा सकते हैं। अपने कौशल और ज्ञान को और बेहतर करने के लिए, इन मूल्यवान संसाधनों पर नज़र डालें:
- Understanding Data Engineering: डेटा इंजीनियरिंग के कॉन्सेप्ट्स और सिद्धांतों की व्यापक समझ प्राप्त करें।
- Data Engineer in Python: आवश्यक टूल्स और फ्रेमवर्क्स को कवर करने वाले इस करियर ट्रैक के माध्यम से Python के साथ डेटा इंजीनियरिंग में महारत हासिल करें।
- Database Design: कुशल और स्केलेबल डाटाबेस बनाने के लिए डाटाबेस डिज़ाइन की मूल बातें सीखें।
इन कोर्सेज़ का लाभ उठाकर अपनी नींव को मजबूत करें और अपने डेटा इंजीनियरिंग करियर में आगे बने रहें। आपके इंटरव्यू के लिए शुभकामनाएँ!
FAQs
मैं डेटा इंजीनियर इंटरव्यू से क्या अपेक्षा कर सकता/सकती हूँ?
आप HR फोन स्क्रीन, तकनीकी फोन स्क्रीन, टेक-होम एग्ज़ाम, कोडिंग चैलेंज, ऑन-साइट इंटरव्यू, व्हाइटबोर्ड पर डाटाबेस और सिस्टम डिज़ाइन, SQL इंटरव्यू, और अंत में सांस्कृतिक अनुरूपता जाँचने के लिए “एग्ज़िक्यूटिव” इंटरव्यू की अपेक्षा कर सकते हैं।
कुछ कंपनियों में इंटरव्यू के तीन चरण होते हैं, जबकि अन्य में नौ तक भी हो सकते हैं। संगठन अक्सर हर स्तर पर उम्मीदवारों का परीक्षण करने के लिए उच्च प्रवेश बाधा रखते हैं।
क्या डेटा इंजीनियरों की मांग है?
हाँ, हर कंपनी जो डेटा जनरेट करती है, उसे पाइपलाइंस बनाने, प्रबंधन करने, और विभिन्न विभागों तक डेटा डिलीवर करने के लिए डेटा इंजीनियरों की आवश्यकता होती है। 2025 तक, हम प्रतिदिन 463 एग्ज़ाबाइट्स डेटा पैदा करेंगे, और हमें डेटा को एक्सट्रैक्ट, ट्रांसफॉर्म, और पाइपलाइंस एवं सिस्टम्स को मैनेज करने के लिए और अधिक इंजीनियरों की आवश्यकता होगी - weforum.org.
क्या डेटा इंजीनियर कोड लिखते हैं?
हाँ, IT क्षेत्र से जुड़े हर व्यक्ति को कोड लिखना सीखना चाहिए, यहाँ तक कि मैनेजरियल स्तर पर भी। डेटा इंजीनियरों के लिए Python, SQL, Docker, Yaml, और Bash आवश्यक कोडिंग भाषाएँ हैं। इनका उपयोग इन्फ्रास्ट्रक्चर-एज़-कोड, पाइपलाइंस, डाटाबेस प्रबंधन, स्ट्रीमिंग, वेब स्क्रैपिंग, डेटा प्रोसेसिंग, मॉडलिंग, और एनालिटिक्स में होता है।
डेटा एनालिस्ट और डेटा इंजीनियर में क्या अंतर है?
डेटा इंजीनियर डेटा एकत्र करता है, ट्रांसफॉर्म करता है, और डेटा विश्लेषकों के लिए डेटा तैयार करता है ताकि वे मूल्यवान व्यावसायिक अंतर्दृष्टियाँ निकाल सकें। डेटा इंजीनियर पूरे डाटाबेस सिस्टम्स का प्रबंधन करते हैं और सुनिश्चित करते हैं कि वे विश्लेषणात्मक रिपोर्ट्स, डैशबोर्ड्स, ग्राहक अनुसंधान, और पूर्वानुमान जैसे डेटा विश्लेषण कार्यों के लिए उच्च-गुणवत्ता वाला डेटा प्रदान करें।
एक डेटा इंजीनियर वास्तव में क्या करता है?
कई स्रोतों से डेटा अधिग्रहण करना, डेटा पाइपलाइंस बनाना, सत्यापित करना और उनका रखरखाव करना, एल्गोरिदम का उपयोग करके डेटा को ट्रांसफॉर्म करना, एनालिटिकल इंजीनियरिंग करना, डेटा गवर्नेंस और सुरक्षा का अनुपालन सुनिश्चित करना, और पूरे डाटाबेस सिस्टम्स का रखरखाव करना। वे कंपनी के विभिन्न विभागों को उच्च-गुणवत्ता वाली डेटा स्ट्रीम्स प्रदान करने के लिए ज़िम्मेदार होते हैं। डेटा इंजीनियरिंग के बारे में अधिक जानने के लिए आप What is Data Engineering? ब्लॉग पढ़ सकते हैं।
डेटा इंजीनियर बनने के लिए किन कौशलों की आवश्यकता है?
आपको कोडिंग, डेटा वेयरहाउजिंग, ETL (Extract Transform Load), SQL क्वेरीज़, डेटा एनालिटिक्स और मॉडलिंग, क्रिटिकल थिंकिंग, और कम्युनिकेशन स्किल्स आनी चाहिए। डेटा इंजीनियरिंग अनुभव और फील्ड में जटिल चुनौतियों को पार करके सीखी जाती है। हमारा Data Engineering Certification आपके कौशल बनाने और डेटा इंजीनियर की भूमिका हासिल करने के लिए एक आदर्श पहल है।

एक प्रमाणित डेटा साइंटिस्ट के रूप में, मैं अत्याधुनिक तकनीक का उपयोग करके नवाचारी मशीन लर्निंग अनुप्रयोग बनाने के लिए उत्साहित रहता/रहती हूँ। स्पीच रिकॉग्निशन, डेटा विश्लेषण और रिपोर्टिंग, MLOps, संवादात्मक AI और NLP में मजबूत पृष्ठभूमि के साथ, मैंने ऐसे बुद्धिमान सिस्टम विकसित करने में अपनी विशेषज्ञता निखारी है जो वास्तविक प्रभाव डाल सकें। तकनीकी दक्षता के अलावा, मैं जटिल अवधारणाओं को स्पष्ट और संक्षिप्त भाषा में प्रस्तुत करने में भी निपुण हूँ। परिणामस्वरूप, मैं डेटा साइंस पर एक मांग में रहने वाला/वाली ब्लॉगर बन गया/गई हूँ, और डेटा प्रोफेशनलों के बढ़ते समुदाय के साथ अपने अनुभव और विचार साझा करता/करती हूँ। वर्तमान में, मैं कंटेंट निर्माण और संपादन पर केंद्रित हूँ, बड़े भाषा मॉडलों के साथ काम करते हुए ऐसा प्रभावशाली और आकर्षक कंटेंट विकसित कर रहा/रही हूँ जो व्यवसायों और व्यक्तियों दोनों को अपने डेटा का अधिकतम लाभ उठाने में मदद कर सके।
डेटा इंजीनियरिंग टेक उद्योग में सबसे महत्वपूर्ण भूमिकाओं में से एक बन गई है, जो दुनिया भर की कंपनियों के लिए डेटा इन्फ्रास्ट्रक्चर की रीढ़ को संचालित करती है। जैसे-जैसे कंपनियां डेटा-आधारित निर्णय लेने पर अधिक निर्भर होती जा रही हैं, कुशल डेटा इंजीनियरों की मांग लगातार बढ़ रही है।
यदि आप डेटा इंजीनियरिंग इंटरव्यू की तैयारी कर रहे हैं, तो आपको सामान्य और तकनीकी प्रश्नों में निपुण होना चाहिए जो आपके अनुभव, समस्या-समाधान क्षमता, और तकनीकी कौशल का आकलन करते हैं।
इस ब्लॉग पोस्ट में, हम आपको डेटा इंजीनियरिंग इंटरव्यू के विभिन्न चरणों—प्रारंभिक HR स्क्रीनिंग से लेकर गहन तकनीकी मूल्यांकन तक—की तैयारी में मदद करने के लिए एक व्यापक गाइड प्रदान करते हैं।