
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.5K
ओपन-वेट मॉडल रिलीज़ पर कुछ समय से चीनी लैब्स का दबदबा रहा है, जहाँ GLM, Kimi, Qwen और DeepSeek परिवार एजेंटिक कोडिंग मूल्यांकनों में शीर्ष अंक ला रहे हैं।
Reflection AI का Beam, 5 अक्टूबर 2026 को घोषित, एक स्पष्ट प्रस्ताव लेकर आता है: लैब जिसे "Western open-weight frontier" कहती है उसे आगे बढ़ाना, और कच्ची क्षमता की बजाय इन्फरेंस दक्षता पर प्रतिस्पर्धा करना।
इस लेख में, मैं बताऊँगा कि Reflection AI का Beam क्या है, रोज़मर्रा के काम के लिए कौन-सी विशेषताएँ मायने रखती हैं, यह Kimi K3, DeepSeek V4.1 Flash, और GLM 5.x लाइन से बेंचमार्क पर कैसे तुलना करता है, और आप आज इससे क्या कर सकते हैं और क्या नहीं। मैं हमारे एक अन्य नए मॉडल Kolibri 1 के गाइड, और Kimi K3 तथा DeepSeek V4.1 Flash बनाम Gemini 3.8 Flash के गाइड भी देखने की सिफारिश करता/करती हूँ।
Beam Reflection AI का 501-बिलियन-पैरामीटर स्पार्स mixture-of-experts मॉडल है, जिसे कोडिंग, तर्क, और एजेंटिक वर्कलोड्स के लिए बनाया गया है। किसी भी दिए गए टोकन पर इनमें से केवल 23 बिलियन पैरामीटर सक्रिय होते हैं।
यह लैब की पहली ओपन-वेट रिलीज़ है और नियोजित श्रृंखला का पहला मॉडल है।
अंदर से, Beam में 52 लेयर्स हैं, यह अपना ज्ञान कई छोटे विशेषज्ञ "experts" में बाँटता है (प्रति टोकन केवल कुछ ही चलते हैं), और पास के पाठ पर देखने वाला अटेन्शन पूरे इनपुट पर देखने वाले अटेन्शन के साथ मिलाता है।
स्पार्सिटी ही पूरा तर्क है।
Qwen 3.8-Max जैसा 2T-प्लस क्लास मॉडल प्रति टोकन कहीं अधिक पैरामीटर सक्रिय करता है, इसलिए हर जनरेटेड टोकन ज्यादा कंप्यूट लागत वाला होता है।
Reflection की शर्त यह है कि 23B सक्रिय फ़ुटप्रिंट, जिसे reinforcement learning (RL) से कड़ा धक्का दिया गया हो, कोडिंग और एजेंटिक कामों पर इतना पास पहुँचा देता है कि लागत का फर्क सार्थक बन जाए।
ट्रेनिंग स्केल वह जगह है जहाँ Reflection ने खर्च किया। 23.8 ट्रिलियन टोकन्स पर प्री-ट्रेनिंग 6,144 NVIDIA GB300 GPUs पर 4 सप्ताह से कम में हुई, रन के अंत की ओर क्लस्टर 92.3% समय उपयोगी काम कर रहा था और रास्ते में 9 रीस्टार्ट्स पुराने चेकपॉइंट्स से हुए।
इसके बाद RL फेज़ अलग से 10,500 GB300s पर 4 सप्ताह चला। इसने लगभग 10 लाख क्यूरेटेड कोडिंग, एजेंटिक, और STEM टास्क्स में 100 मिलियन से अधिक रोलआउट्स (किसी कार्य का पूर्ण प्रयास) उत्पन्न किए, जिन्हें चलाने और ग्रेड करने के लिए लगभग 1.3 बिलियन सैंडबॉक्स्ड एनवायरनमेंट्स का उपयोग हुआ।
Reflection यह भी बताता है कि RL कंप्यूट बढ़ने पर क्षमता में सुधार जारी रहा, रन के अंत तक कोई पठार नहीं दिखा। यह वह दावा है जिसे मैं बाहरी परीक्षण में सबसे अधिक देखना चाहूँगा/चाहूँगी, क्योंकि यही लैब के इस कथन की नींव है कि वह पहले से श्रृंखला के अगले मॉडल को ट्रेन कर रहा/रही है।
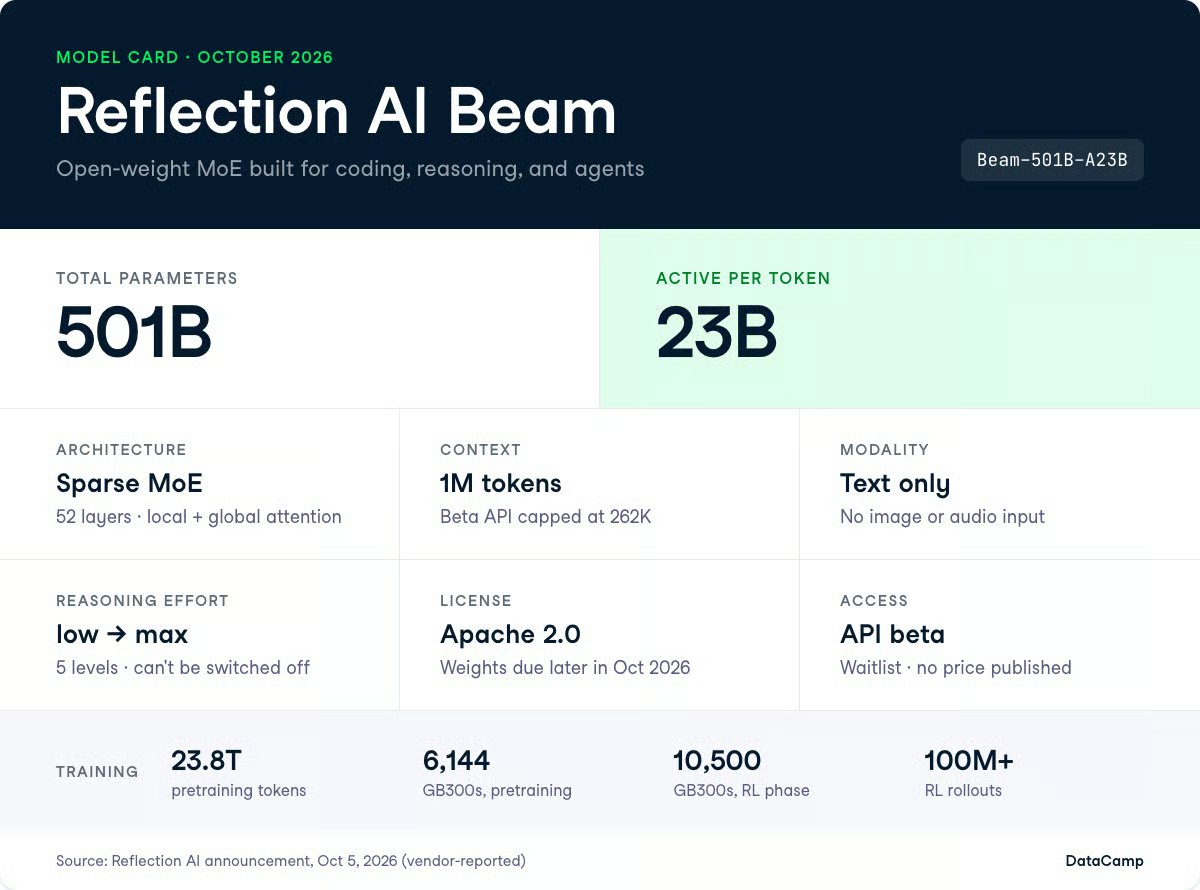
Beam केवल टेक्स्ट-आधारित है, इसलिए न तो इमेज इनपुट है और न ऑडियो।
यह जो देता है, वह कोडिंग एजेंट्स चलाने वाले लोगों को सीधी लक्षित कंट्रोल्स और क्षमताओं का सेट है।
Beam एक reasoning effort पैरामीटर उजागर करता है, ताकि आप चुन सकें कि किसी कार्य को कितने thinking tokens मिलें। API low, medium (डिफॉल्ट), high, xhigh, और max स्वीकार करता है, लेकिन reasoning को पूरी तरह बंद नहीं किया जा सकता।
कम सेटिंग्स छोटी प्रतिक्रियाओं को प्राथमिकता देती हैं; ऊँची सेटिंग्स कठिन समस्याओं पर लंबा तर्क करने की अनुमति देती हैं।
यह डायल सीधे तौर पर Beam के ट्रेन होने के तरीके का परिणाम है।
RL के दौरान, Reflection ने एक समायोज्य length penalty का उपयोग किया जो सही समाधान पर इनाम देता था और अतिरिक्त टोकन्स को हतोत्साहित करता था। रिपोर्ट है कि ट्रेनिंग के शुरुआती चरण में, परफॉर्मेंस बेहतर हुई जबकि प्रतिक्रियाएँ वास्तव में छोटी हो गईं।
बाद में, जैसे-जैसे एजेंटिक क्षमता बढ़ी, प्रतिक्रियाएँ फिर लंबी हुईं, और वे अतिरिक्त टोकन्स अपने आप को सही ठहराते रहे।
मिडट्रेनिंग Beam के प्रभावी संदर्भ को 10 लाख टोकन्स तक बढ़ाती है, जिसे संरचित कोड रिपॉजिटरीज़, लंबी-अवधि के कार्यों, और लम्बे दस्तावेज़ों पर प्रशिक्षित किया गया।
दो सावधानियाँ हैं। RL रोलआउट्स अधिकतम 256K टोकन्स के संदर्भ के साथ चले, इसलिए Beam का एजेंटिक व्यवहार उस लंबाई के एक-चौथाई पर सीखा गया, और बीटा API फिलहाल रिक्वेस्ट्स को 262,144 टोकन्स (इनपुट प्लस आउटपुट) पर सीमित करता है, जहाँ आउटपुट 131,072 टोकन्स तक सीमित है।
कागज़ पर लंबा संदर्भ और व्यवहार में लंबा संदर्भ अलग बातें हैं। LongBench v2 पर Beam 65.5 स्कोर करता है, जबकि Qwen 3.8-Max 66.3 और GLM 5.2 64.0 पर हैं, और AA-LCR पर 79.3, जहाँ Kimi K3 88.7 तक पहुँचता है। इससे Beam लंबे इनपुट्स के लिए उपयोगी है, पर वर्ग में सर्वश्रेष्ठ नहीं।
घोषणा में सबसे दिलचस्प परिणाम का ताल्लुक किसी लीडरबोर्ड से नहीं है।
तर्क, सॉफ्टवेयर इंजीनियरिंग, और टर्मिनल कार्यों को कवर करने वाले ट्रेनिंग फेज़ के दौरान, जहाँ RL मिक्स में ब्राउज़िंग कार्य थे ही नहीं, Beam के ब्राउज़िंग स्कोर वैसे भी बेहतर हो गए।
वेब एक्सेस मिलने पर, मॉडल ने खुद ही समझ लिया कि वह दूसरे भाषा मॉडलों से क्वेरी कर सकता है और उन दस्तावेज़ों को पढ़ने के लिए ऑप्टिकल कैरेक्टर रिकग्निशन (OCR) APIs कॉल कर सकता है जिन्हें वह देख नहीं सकता था।
Reflection के डेमो इसे और आगे बढ़ाते हैं: सार्वजनिक MTA डेटा से बना लाइव NYC सबवे मैप, केवल टेक्स्ट के ज़रिए बनाया गया 3D p5.js फ्री-फॉल गेम, और Gemma 4 का फाइन-ट्यूनिंग नोटबुक जो OpenCode के अंदर Unsloth डॉक्यूमेंटेशन से असेंबल किया गया, जिससे Gemma की held-out टेस्ट एक्युरेसी 66.5% बढ़ी।
घोषणा का एक जनरलाइज़ेशन टेस्ट अलग से उल्लेखनीय है क्योंकि इसे ट्रेनिंग डेटा में देखा जाना मुश्किल है।
Reflection ने लॉन्च से कुछ दिन पहले X पर वायरल हुए एक ग्रिड पज़ल को दोहराया, Beam से 180x90 की फिक्स्ड वर्ल्ड ग्रिड के 16,200 पॉइंट्स में से प्रत्येक को भूमि या जल के रूप में वर्गीकृत करने को कहा। Beam ने उनमें से 95.5% सही किए, Opus 5 के 92.5% और Fable 5 के 97.8% के बीच।
Beam को असिंक्रोनस RL से प्रशिक्षित किया गया, यानी मॉडल रोलआउट्स जनरेट करता रहता है जबकि ट्रेनिंग अपडेट समानांतर में होते हैं, एक-दूसरे का इंतज़ार नहीं करते। इसलिए एक लंबा रोलआउट कई अलग-अलग मॉडल वर्ज़नों द्वारा उत्पादित टोकन्स समाहित कर सकता है।
Reflection बताता है कि तब भी लर्निंग स्थिर रही जब किसी बैच का सबसे पुराना सैंपल मौजूदा वर्ज़न से 107 अपडेट पीछे के मॉडल वर्ज़न से आया था, यानी लगभग एक दिन पुराना।
यदि आप RL सिस्टम बनाते हैं तो इन्फ्रास्ट्रक्चर के ये आँकड़े देखने लायक हैं:
Reflection कहता है कि वह अक्टूबर 2026 के अंत में Apache 2.0 के तहत Beam के वेट्स प्रकाशित करेगा, साथ ही टेक्निकल रिपोर्ट, मॉडल कार्ड, डॉक्यूमेंटेशन, और मॉडल को चलाने, मूल्यांकन करने, और फाइन-ट्यून करने के टूलिंग भी।
यह अपने बनाए आंतरिक सेफ्टी इवैल्युएशन्स को भी ओपन-सोर्स करने की योजना बनाता है, जो स्वयं वेट रिलीज़ से भी दुर्लभ है।
Apache 2.0 जितना उदार हो सकता है उतना है: व्यावसायिक उपयोग, पुनर्वितरण, और संशोधन—बिना किसी यूज़र या राजस्व सीमा के।
यह इसलिए मायने रखता है क्योंकि Kimi K3 और DeepSeek V4.1 Flash ने यह अपेक्षाएँ तय कर दी हैं कि एक ओपन मॉडल आपको क्या करने दे, और कोई प्रतिबंधात्मक लाइसेंस Beam को चर्चा से बाहर कर देता।
Beam अधिकांश मूल्यांकनों पर मोटे तौर पर वहीं आकर बैठता है जहाँ GLM 5.2 है, Inkling और Nemotron 3 Ultra से काफी आगे, और सबसे कठिन एजेंटिक कोडिंग कार्यों पर Kimi K3, GLM 5.3, और DeepSeek V4.1 Flash से स्पष्ट रूप से पीछे।
Reflection इसके बारे में साफ है, Beam की बढ़त को दक्षता के रूप में प्रस्तुत करता है, न कि अधिकतम क्षमता के रूप में।
नीचे दिए गए सभी आँकड़े वेंडर-रिपोर्टेड हैं, प्रतिद्वंद्वियों के स्कोर Reflection ने Artificial Analysis और DataCurve से लिए हैं।
Beam का हेडलाइन कोडिंग नंबर SWE-bench Verified पर 80.9 है, जबकि Inkling 77.6 और Nemotron 3 Ultra 70.7 पर हैं।
SWE-bench Verified वास्तविक GitHub इश्यूज़ का मानव-प्रमाणित सेट है जहाँ मॉडल को प्रोजेक्ट के अपने टेस्ट पास करने वाला फिक्स लिखना होता है, और यह अब भी वह पहला बेंचमार्क है जिसे अधिकांश प्रैक्टिशनर देखते हैं।
बाकी जगह तस्वीर कम आकर्षक है।
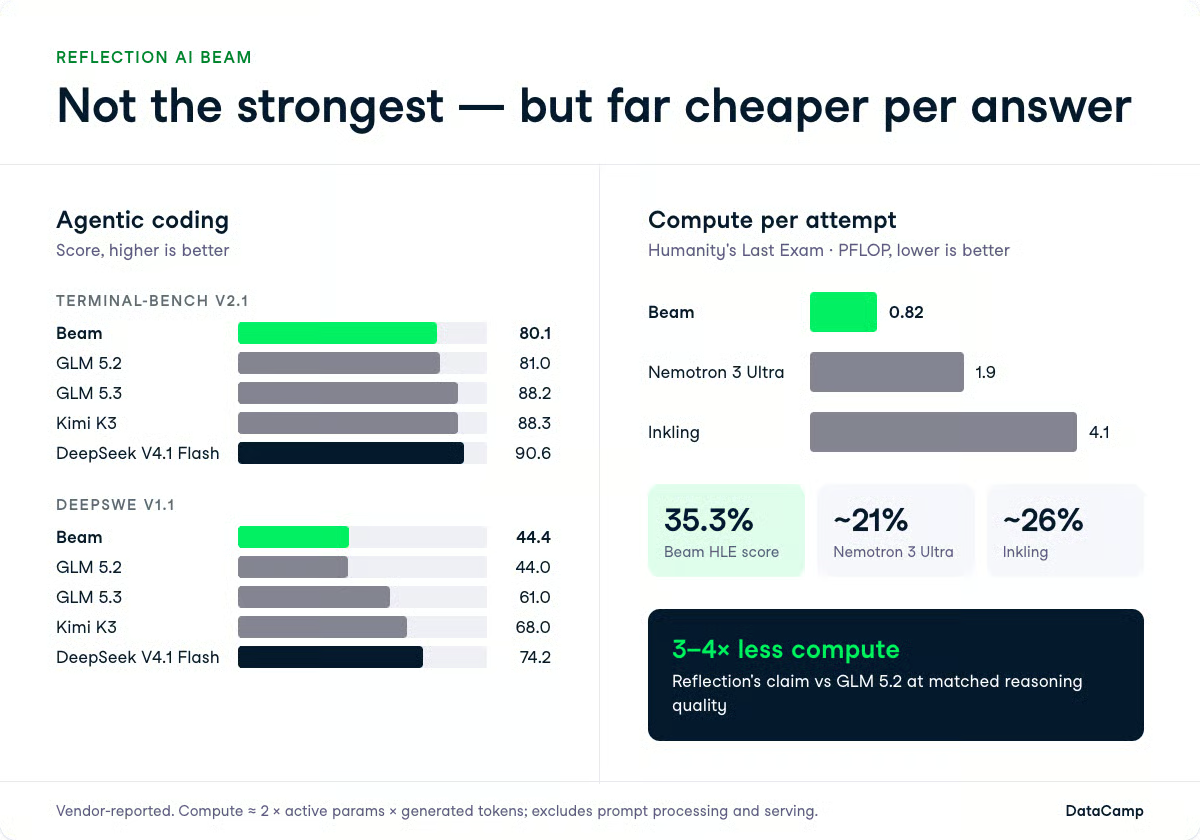
जिन मॉडलों के बीच आप वास्तव में चुनेंगे, उनके मुकाबले Beam हर उस एजेंटिक कोडिंग बेंचमार्क पर पीछे है जहाँ तुलना स्कोर उपलब्ध है।
| Benchmark | Beam | GLM 5.2 | GLM 5.3 | Kimi K3 | DeepSeek V4.1 Flash |
|---|---|---|---|---|---|
| Terminal-Bench v2.1 | 80.1 | 81.0 | 88.2 | 88.3 | 90.6 |
| DeepSWE v1.1 | 44.4 | 44.0 | 61.0 | 68.0 | 74.2 |
| SWE-bench Pro v2-Hard | 77.2 | NR | 84.3 | 88.2 | NR |
| SWE Atlas Codebase QnA | 34.6 | NR | 61.0 | 68.0 | NR |
NR = not reported.
DeepSWE और SWE Atlas के अंतर बड़े हैं।
DeepSWE v1.1 एकल फिक्स की बजाय बहु-चरणीय एजेंटिक सॉफ्टवेयर इंजीनियरिंग को परखता है, और DeepSeek V4.1 Flash से 29.8-पॉइंट का घाटा कोई मामूली बात नहीं है।
SWE-bench Pro v1 पर, Beam का 65.5 GLM 5.2 के 62.1 को मात देता है और Qwen 3.8-Max के 67.7 से बस नीचे बैठता है।
Humanity's Last Exam (HLE) पर बिना टूल्स के, Beam 36.2 स्कोर करता है, जबकि GLM 5.2 40.5, GLM 5.3 42.3, Qwen 3.8-Max 43.6, और Kimi K3 46.9 पर हैं।
HLE विशेषज्ञ-लिखित प्रश्नों का सेट है जिसे इस तरह डिज़ाइन किया गया है कि सर्च और याददाश्त ज्यादा मदद न करें, और यह आम तौर पर इस समूह के बड़े मॉडलों को पुरस्कृत करता है।
बाकी तर्क सूट कसा हुआ है:
यहाँ लगभग हर मॉडल AIME पर शीर्ष के पास स्कोर करता है, इसलिए अब यह उन्हें अलग नहीं करता, और GPQA Diamond पर Kimi K3 से 3-पॉइंट का अंतर प्रोडक्शन डिप्लॉयमेंट तय नहीं करता।
CritPt, जो शोध-स्तरीय भौतिकी समस्याओं का बेंचमार्क है, वहीं फर्क चुभता है, जहाँ Kimi K3 Beam से लगभग 50% अधिक स्कोर करता है।
Beam के टूल-कॉलिंग परिणाम सबसे असमान सेट हैं।
यह AutomationBench (पब्लिक सेट) पर 37.0 स्कोर करता है, GLM 5.2 के 26.2 से आगे लेकिन Kimi K3 के 46.7 और DeepSeek V4.1 Flash के 54.8 से पीछे। MCP Atlas पर, यह 78.7 स्कोर करता है, GLM 5.2 के 77.8 और Qwen 3.8-Max के 84.5 के मुकाबले।
τ³-bench बैंकिंग पर, Beam 38.0 तक पहुँचता है जबकि GLM 5.2 और Kimi K3 दोनों 37.1 पर हैं, और Qwen 3.8-Max 55.2 पर काफी आगे है। सर्च सबसे कमजोर क्षेत्र है: BrowseComp पर 77.4 और DeepSearchQA पर संदर्भ प्रबंधन के साथ 80.1, जबकि Kimi K3 क्रमशः 91.2 और 95.0 पर है। यदि आपका एजेंट खुले वेब पर निर्भर है, तो यह वही अंतर है जिस पर ध्यान देना चाहिए।
इन्फरेंस दक्षता वही संख्या है जिस पर Reflection वास्तव में आपका ध्यान चाहता है।
Reflection के HLE दक्षता चार्ट पर, Beam प्रति प्रयास अनुमानित 0.82 PFLOP (क्वाड्रिलियन फ्लोटिंग-पॉइंट ऑपरेशंस) कंप्यूट पर 35.3% तक पहुँचता है, जबकि Inkling को लगभग 26% तक पहुँचने के लिए करीब 4.1 PFLOP और Nemotron 3 Ultra को लगभग 21% के लिए करीब 1.9 PFLOP चाहिए।
Reflection का व्यापक दावा है कि Beam उन्नत तर्क में GLM 5.2 की बराबरी करता है, जबकि 3 से 4 गुना कम इन्फरेंस कंप्यूट उपयोग करता है, और 2T-प्लस Qwen 3.8-Max परिवार के मुकाबले अंतर और बड़ा है।
विधि ध्यान से पढ़ें: कंप्यूट का अनुमान 2 × सक्रिय पैरामीटर्स × प्रति प्रयास जनरेटेड टोकन्स की औसत संख्या के रूप में लगता है। यह प्रॉम्प्ट की प्रोसेसिंग की लागत, लंबे संदर्भों की अतिरिक्त अटेन्शन लागत, और सर्विंग ओवरहेड को छोड़ देता है।
यह तर्कसंगत कंप्यूट तुलना है, न कि मापा हुआ डिप्लॉयमेंट खर्च, और क्योंकि यह केवल सक्रिय पैरामीटर्स गिनता है, स्वाभाविक रूप से Beam जैसे स्पार्स मॉडलों के पक्ष में जाता है।
Reflection ने उसी प्री-ट्रेन किए गए चेकपॉइंट से एक अलग सेफ्टी और अलाइनमेंट मॉडल प्रशिक्षित किया, फिर उसे मुख्य RL-प्रशिक्षित मॉडल के साथ multi-teacher on-policy distillation (MOPD) का उपयोग करके संयोजित किया, जहाँ एक सिंगल स्टूडेंट मॉडल एक साथ दोनों "टीचर" मॉडलों से सीखता है।
अलाइनमेंट सिद्धांत तीन स्तरों में व्यवस्थित हैं:
सेफ्टी ट्रेनिंग में deliberative alignment का उपयोग हुआ, जो मॉडल को उत्तर देने से पहले अपनी सेफ्टी पॉलिसी पर तर्क करना सिखाता है। एक प्रतिकूल (adversarial) लूप हर राउंड के चेकपॉइंट पर हमले जनरेट करता और सफल हमलों को अगली राउंड की सुपरवाइज़्ड फाइन-ट्यूनिंग डेटा में वापस फीड करता।
Reflection यह भी बताता है कि वह कठिन-से-ग्रेड व्यवहारों पर RL कितना सुधार लाएगा, इसका r = 0.79 का सहसंबंध के साथ अनुमान लगा सकता था, जबकि एक सरल Best-of-N बेसलाइन का 0.46 था। सेफ्टी इवैल्युएशन के परिणाम अब प्रकाशित नहीं हैं, तकनीकी रिपोर्ट में वादा किए गए हैं।
Beam के लिए कोई प्रकाशित कीमत नहीं है। 6 अक्टूबर 2026 तक Reflection के डेवलपर डॉक्यूमेंटेशन में प्रति-टोकन रेट कार्ड नहीं था, जिससे होस्टेड Kimi K3 या DeepSeek V4.1 Flash एंडपॉइंट्स के मुकाबले किसी भी लागत तुलना को अभी असंभव बनाता है।
एक्सेस धीरे-धीरे खोले जा रहे API बीटा के ज़रिए है, वेटलिस्ट से।
डॉक्यूमेंटेड बेस URL है https://api.reflection.ai/openai/v1, और यह सीमित अर्थ में OpenAI-कम्पैटिबल है: Chat Completions और मॉडल लिस्टिंग सपोर्टेड हैं, जबकि Responses, Embeddings, Files, और Batch नहीं। बीटा सीमाएँ और व्यवहार स्पष्ट रूप से बदल सकते हैं।
वितरण अभी पतला है। 6 अक्टूबर 2026 को जाँचने पर, Beam न तो Ollama पर था, न OpenRouter कैटलॉग में, न OpenCode द्वारा उपयोग किए गए models.dev कैटलॉग में, और Hugging Face पर कोई वेट्स सूचीबद्ध नहीं थे।
Reflection कहता है कि वह वेट रिलीज़ के साथ वितरण भागीदारों और ओपन-सोर्स हार्नेस इंटीग्रेशन्स के साथ लॉन्च करेगा।
Beam के वेट्स अभी बाहर नहीं आए हैं।
Reflection ने अक्टूबर 2026 के अंत में Apache 2.0 रिलीज़ के लिए प्रतिबद्धता जताई है, जिसमें वेट्स, टेक्निकल रिपोर्ट, मॉडल कार्ड, और मॉडल को चलाने, मूल्यांकन करने, और फाइन-ट्यून करने के टूलिंग शामिल होंगे। तब तक, आप इसे स्वयं होस्ट नहीं कर सकते, न क्वांटाइज़ कर सकते, न यह माप सकते हैं कि इसे वास्तव में कितनी GPU मेमोरी चाहिए, और न ही कोई प्रकाशित स्कोर पुनरुत्पादित कर सकते हैं।
आज आप जो कर सकते हैं, वह है बीटा वेटलिस्ट में शामिल होना और होस्टेड API को कॉल करना।
डेवलपर डॉक्यूमेंटेशन में मॉडल ID है Beam-501B-A23B, और क्योंकि एंडपॉइंट Chat Completions बोलता है, आधिकारिक OpenAI Python क्लाइंट बेस URL बदलते ही काम करता है।
from openai import OpenAI

client = OpenAI(
    base_url="https://api.reflection.ai/openai/v1",
    api_key="YOUR_REFLECTION_KEY",
)

response = client.chat.completions.create(
    model="Beam-501B-A23B",
    reasoning_effort="medium",  # low, medium, high, xhigh, or max
    messages=[{"role": "user", "content": "Port this module to the v2 payments API."}],
)
print(response.choices[0].message.content)
यदि आप इसी पैटर्न का अभ्यास किसी ऐसे मॉडल के साथ करना चाहते हैं जिसे आप अभी एक्सेस कर सकते हैं, हमारा GPT-6 Sol API ट्यूटोरियल वही क्लाइंट कोड उपयोग करता है, जिसमें टूल परमिशन और किसी एजेंटिक माइग्रेशन टास्क के लिए कॉस्ट ट्रैकिंग शामिल है।
Beam एक विश्वसनीय ओपन-वेट एंट्री है, और दक्षता का फ्रेमिंग ईमानदार है: Kimi K3 और DeepSeek V4.1 Flash उन एजेंटिक कोडिंग बेंचमार्क्स पर इसे पछाड़ते हैं जो सबसे अधिक मायने रखते हैं, इसलिए Beam के पक्ष में तर्क क्षमता नहीं, बल्कि प्रति सॉल्व्ड टास्क लागत होना चाहिए।
मैं अभी इसके इर्द-गिर्द योजना नहीं बनाऊँगा/बनाऊँगी।
प्रकाशित वेट्स, कीमत, या एक भी स्वतंत्र पुनरुत्पादन के बिना, यहाँ हर दावा उसी लैब से आता है जिसने मॉडल ट्रेन किया है, और कंप्यूट तुलना प्रॉम्प्ट प्रोसेसिंग और सर्विंग लागतों को छोड़ देती है। तब वापस जाँचे जब Apache 2.0 वेट्स आएँ और Artificial Analysis अपने स्वयं के नंबर प्रकाशित करे।
इस बीच यदि आप ओपन-वेट स्टैक के साथ हाथ गंदे करना चाहते हैं, तो हमारा AI Fundamentals स्किल ट्रैक नींव मजबूत करने की अच्छी जगह है।
शीर्ष DataCamp पाठ्यक्रम
कोर्स
कोर्स
कोर्स