मैंने हाल ही में एक AI कंपनी के साथ एक अनुबंध पूरा किया। अन्य बातों के साथ, वे शोधकर्ताओं को LLMs का पोस्ट-ट्रेनिंग करने में मदद करते हैं। एक PhD गणितज्ञ के रूप में, मैंने ऐसे गणितीय प्रॉम्प्ट बनाए जो फ्रंटियर AI मॉडलों को चकरा दें। चालबाजी वाले प्रॉम्प्ट मान्य नहीं थे; प्रॉम्प्ट में तर्क संबंधी त्रुटियाँ उजागर होना आवश्यक था।
उस काम के दौरान, मैंने बार-बार "Humanity’s Last Exam" के संदर्भ सुने। मुझे पता चला कि यह कई अकादमिक क्षेत्रों में तर्क की जाँच के लिए बनाया गया एक AI बेंचमार्क है। जिज्ञासा ने मुझे HLE क्या है और यह हमें AI तर्क की वर्तमान सीमाओं के बारे में क्या बताता है, इसे और गहराई से समझने के लिए प्रेरित किया।
यदि आप AI और बेंचमार्किंग में नए हैं, तो मैं AI Fundamentals स्किल ट्रैक लेने की सलाह देता/देती हूँ।
“Humanity’s Last Exam" क्या है?
जैसे-जैसे LLMs उन्नत हुए हैं, शोधकर्ता प्रदर्शन की तुलना करने और प्रगति को ट्रैक करने के लिए मूल्यांकन प्रश्नों के संग्रह, जिन्हें बेंचमार्क कहा जाता है, पर निर्भर करते हैं। Humanity's Last Exam (HLE) एक बेंचमार्क है जो LLM की तर्क क्षमता मापने के लिए बनाया गया है, न कि केवल पैटर्न मैच करने की क्षमता। इसका उद्देश्य विभिन्न अकादमिक क्षेत्रों में विशेषज्ञ-स्तरीय समस्याओं को मॉडल कितनी अच्छी तरह संभालता है, इसका मूल्यांकन करना है।
हमें “लास्ट एग्ज़ाम” की ज़रूरत क्यों है?
इतने सारे मौजूदा बेंचमार्क के बावजूद, एक और क्यों? जो बेंचमार्क कभी LLMs के लिए चुनौतीपूर्ण थे, जैसे MMLU, अब संतृप्त हो चुके हैं, और मॉडल अक्सर 90 प्रतिशत से ऊपर स्कोर कर रहे हैं। इस बिंदु पर, ये बेंचमार्क मॉडलों के बीच सार्थक अंतर मापना बंद कर देते हैं।
HLE अगली पीढ़ी का बेंचमार्क है जो कठिनाई स्तर बढ़ाता है, ऐसे विशेषज्ञ-निर्मित प्रश्नों को इकट्ठा करके जो केवल सतही पैटर्न-मिलान को याद करने के बजाय बहु-चरणीय तर्क की मांग करते हैं।
HLE कैसे विकसित किया गया?
2024 के अंत में, Centre for AI Safety, जो AI सुरक्षा पर आधारित एक गैर-लाभकारी संस्था है, ने डेटा कंपनी Scale AI के साथ मिलकर एक अधिक कठिन AI बेंचमार्क विकसित किया। इस परियोजना का नेतृत्व Dan Hendrycks ने किया।
टीम ने कई अकादमिक विषयों से स्नातकोत्तर-स्तरीय प्रश्नों को क्राउडसोर्स किया और महत्वपूर्ण पुरस्कार दिए: शीर्ष 50 योगदानकर्ताओं को प्रत्येक को $5000 मिले, और अगले 500 को $500।
परिणामस्वरूप गणित, कंप्यूटर विज्ञान, साहित्य, संगीत विश्लेषण और इतिहास जैसे अनेक विषयों में विशेषज्ञ-स्तरीय प्रश्नों का एक बड़ा पूल बना।
Humanity's Last Exam में क्या शामिल है?
HLE पेपर बेंचमार्क को "...विस्तृत अकादमिक कौशल के लिए अंतिम क्लोज़्ड-एंडेड बेंचमार्क" के रूप में वर्णित करता है। इसके प्रश्न बहु-चरणीय तर्क की मांग करते हैं, जो मॉडलों को अनुमान लगाने या उत्तर याद करने से रोकते हैं।
HLE में 2,500 सार्वजनिक प्रश्न और लगभग 500 अतिरिक्त प्रश्न एक निजी होल्डआउट सेट में शामिल हैं।
प्रत्येक प्रश्न मौलिक होना चाहिए, उसका एक ही सही उत्तर होना चाहिए, और साधारण वेब खोज या डेटाबेस लुकअप से हल नहीं होना चाहिए। लगभग 76% प्रश्न सटीक-मिलान (exact-match) उत्तर प्रारूप का उपयोग करते हैं और शेष 24% बहुविकल्पीय हैं। लगभग 14% प्रश्न मल्टीमॉडल हैं, जिनमें पाठ और छवियाँ दोनों शामिल हैं।
HLE टीम के पास प्रश्नों के लिए एक कड़ा जाँच-परख (वेटिंग) प्रक्रिया थी।
- स्वीकृति के लिए, प्रश्नों को एक फ्रंटियर LLM को चकमा देना आवश्यक था। लगभग सत्तर हजार प्रश्न इस मानदंड पर खरे उतरे।
- विशेषज्ञ सहकर्मी समीक्षकों ने इन्हें परिष्कृत कर तेरह हजार प्रश्नों तक छाँटा।
- आयोजकों और विशेषज्ञ समीक्षकों ने इनमें से छह हजार प्रश्नों को मैन्युअल रूप से स्वीकृत किया।
- शोधकर्ताओं ने इस प्रश्न-पूल को 2,500 प्रश्नों के एक सार्वजनिक सेट और लगभग 500 प्रश्नों के एक होल्डआउट सेट में बाँट दिया।
Humanity’s Last Exam की आलोचनाएँ
प्रारंभिक परिणामों से पता चला कि फ्रंटियर मॉडल प्रश्नों पर शुरुआत में खराब स्कोर कर रहे थे, फिर भी उच्च आत्मविश्वास व्यक्त कर रहे थे। यह अंतर भ्रमात्मक (hallucination) प्रवृत्तियों की ओर संकेत करता है।
स्वतंत्र समूहों ने भी चिंताएँ उठाईं। Future House, एक गैर-लाभकारी अनुसंधान प्रयोगशाला, ने एक ब्लॉग प्रकाशित किया, "Humanity’s Last Exam के रसायन/जीवविज्ञान उत्तरों में से लगभग 30% संभवतः गलत हैं।"
उनका विश्लेषण समीक्षा प्रोटोकॉल पर केंद्रित था। प्रश्न लेखकों ने सही उत्तर प्रस्तुत किए, लेकिन समीक्षकों को उत्तर-सहीपन की समीक्षा पर केवल पाँच मिनट खर्च करने के लिए कहा गया था। उनका तर्क है कि यह प्रक्रिया अत्यधिक जटिल, बनावटी, या अस्पष्ट उत्तरों को भी पारित होने देती है जो अक्सर वैज्ञानिक साहित्य से टकराते हैं।
HLE के मेंटेनरों ने विवादित उप-समुच्चय की तीन-विशेषज्ञ समीक्षा का आदेश देकर पोस्ट का जवाब दिया। 16 सितंबर, 2025 तक, वे HLE के लिए एक रोलिंग समीक्षा प्रक्रिया की घोषणा करने की योजना बना रहे थे।
AI बेंचमार्क्स का परिदृश्य
HLE उन बेंचमार्क्स के व्यापक पारिस्थितिकी तंत्र के भीतर स्थित है जो LLM क्षमता के विभिन्न पहलुओं का परीक्षण करते हैं।
ज्ञान और तर्क
ये बेंचमार्क अकादमिक ज्ञान और तर्क का मूल्यांकन करते हैं।
- Massive Multitask Language Understanding (MMLU)। MMLU सत्तावन विभिन्न विषयों में ज़ीरो-शॉट प्रदर्शन का परीक्षण करता है।
- MMLU-Pro/MMLU Pro+। प्रश्न-जटिलता में वृद्धि और उच्च-स्तरीय तर्क पर ध्यान।
- Google Proof Q&A (GPQA) 448 बहुविकल्पीय प्रश्नों वाला एक Google-प्रूफ, स्नातकोत्तर-स्तरीय STEM बेंचमार्क।
- Humanity's Last Exam (HLE)। HLE विशेषज्ञ-स्तरीय क्यूरेट किए गए समस्याओं का उपयोग करता है जो स्मृति-आधारित उत्तर के बजाय तर्क पर ज़ोर देती हैं।
मल्टीमॉडल समझ
ये बेंचमार्क ऐसे तर्क को मापते हैं जिसमें पाठ और छवियाँ दोनों शामिल होती हैं।
- The Massive Multi-discipline Multimodal Understanding and Reasoning (MMMU)। परीक्षाओं, क्विज़ और पाठ्यपुस्तकों से लिए गए लगभग 1,500 मल्टीमॉडल, बहु-विषयक प्रश्न।
- The MMMU-Pro बेंचमार्क उन प्रश्नों को हटाता है जिन्हें केवल पाठ-आधारित मॉडल हल कर सकते हैं, अधिक मज़बूत उत्तर विकल्प जोड़ता है, और एक विज़न-ओनली सेटिंग पेश करता है जिसमें पूरा प्रॉम्प्ट छवि के भीतर एम्बेड किया जाता है।
सॉफ्टवेयर इंजीनियरिंग और टूल उपयोग
अन्य कुछ बेंचमार्क विशेष रूप से सॉफ्टवेयर इंजीनियरिंग और टूल उपयोग पर केंद्रित हैं।
- SWE-bench। बारह Python रिपॉज़िटरीज़ के वास्तविक GitHub इश्यूज़ से निर्मित। मॉडल कोडबेस पढ़ता है, इश्यू के विवरण की व्याख्या करता है, और एक पैच प्रस्तावित करता है।
- SWE-bench Verified। SWE-bench का एक उन्नत संस्करण जो अत्यधिक विशिष्ट परीक्षणों को ठीक करता है, अस्पष्ट इश्यू विवरणों को स्पष्ट करता है, और एनवायरनमेंट सेटअप को स्थिर करता है।
- SWE-bench-Live। 93 रिपोज़ में 1319 कार्यों के साथ एक स्केलेबल, निरंतर अद्यतन संस्करण।
समग्र, बहु-मीट्रिक मूल्यांकन रूपरेखाएँ
Stanford के Center for Research on Foundation Models (CRFM) ने Holistic Evaluation of Language Models (HELM) को जिम्मेदार AI मूल्यांकन का समर्थन करने के लिए विकसित किया।
HELM मॉडलों का मानकीकृत परिदृश्यों के एक बैटरी पर मूल्यांकन करता है, जैसे प्रश्नोत्तर, सार-संक्षेप, सुरक्षा-महत्त्वपूर्ण प्रश्न, और सामाजिक/नैतिक सामग्री। इन परिदृश्यों को कई आयामों पर स्कोर किया जाता है—सिर्फ़ शुद्धता ही नहीं, बल्कि कैलिब्रेशन, मजबूती, और टॉक्सिसिटी भी।
HELM संबंधित रूपरेखाओं के एक परिवार में विकसित हो गया है।
- HEML Capabilities। LMs के मूल्यांकन के लिए एक सामान्य-उद्देश्य लीडरबोर्ड।
- Audio। ऑडियो और स्पीच-संबंधित कार्यों के लिए मूल्यांकन।
- HELM Lite। त्वरित तुलना के लिए एक छोटा, तेज़ सबसेट।
- HELM Finance। वित्तीय कार्यों के अनुरूप HELM।
- MedHELM। स्वास्थ्यसेवा-संबंधी तर्क और सुरक्षा के लिए मूल्यांकन।
सुरक्षा और खतरनाक-क्षमता मूल्यांकन
सुरक्षा रूपरेखाएँ बौद्धिक क्षमता के बजाय जोखिम को मापती हैं।
- Model Evaluation & Threat Research (METR) एक गैर-लाभकारी अनुसंधान संगठन है जो संभावित रूप से खतरनाक क्षमताओं का मूल्यांकन करता है, जैसे साइबर हमले, शटडाउन से बचने के प्रयास, या AI R&D को स्वचालित करने की क्षमता। इसका मिशन विनाशकारी जोखिमों का समय रहते पता लगाना है।
- Google DeepMind का Frontier Safety Framework। महत्वपूर्ण क्षमता स्तरों (CCLs) को परिभाषित करता है, यह मॉनिटर करता है कि फ्रंटियर मॉडल उनके करीब पहुँच रहे हैं या नहीं, और ऐसा होने पर शमन योजनाएँ लागू करता है।
वर्तमान AI मॉडल AI बेंचमार्क्स पर कहाँ स्कोर करते हैं?
कई सार्वजनिक लीडरबोर्ड विभिन्न मीट्रिक्स पर LLM के प्रदर्शन को ट्रैक करते हैं।
लीडरबोर्ड्स
दिसंबर 2025 में लिखे जाने के समय के कुछ स्कोर नीचे दिए गए हैं।
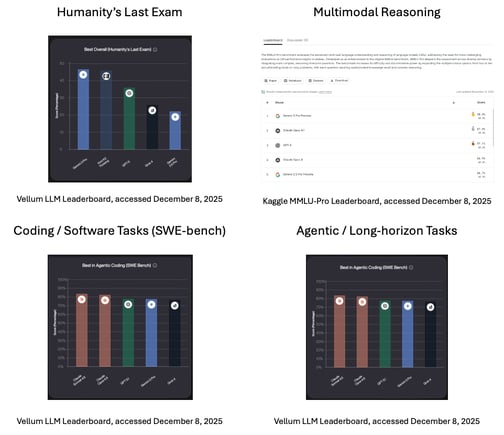
- Humanity's Last Exam। Vellum लीडरबोर्ड के अनुसार, वर्तमान अग्रणी (इस लेखन के समय) Gemini 3 Pro है, जो Google का प्रमुख जनरेटिव मल्टीमॉडल AI मॉडल है।
- मल्टीमॉडल तर्क। Kaggle MMLU-Pro लीडरबोर्ड के अनुसार, बहु-मोडेलिटी को एक एकल सिस्टम में समेकित करने के लिए डिज़ाइन किया गया Gemini 3 Pro मल्टीमॉडल तर्क में अग्रणी है।
- कोडिंग / सॉफ्टवेयर कार्य (SWE-bench)। Anthropic का Claude Sonnet 4.5, जो सावधानीपूर्वक तर्क को प्राथमिकता देता है, Vellum लीडरबोर्ड के अनुसार कोडिंग और वास्तविक-विश्व सॉफ्टवेयर कार्यों में शीर्ष स्थान पर है।
- एजेंटिक / लॉन्ग-होराइजन कार्य। Vellum लीडरबोर्ड के अनुसार, Claude Sonnet 4.5 एजेंटिक और दीर्घ-अवधि के कार्यों में भी अग्रणी है।
सुरक्षा/खतरनाक क्षमताएँ
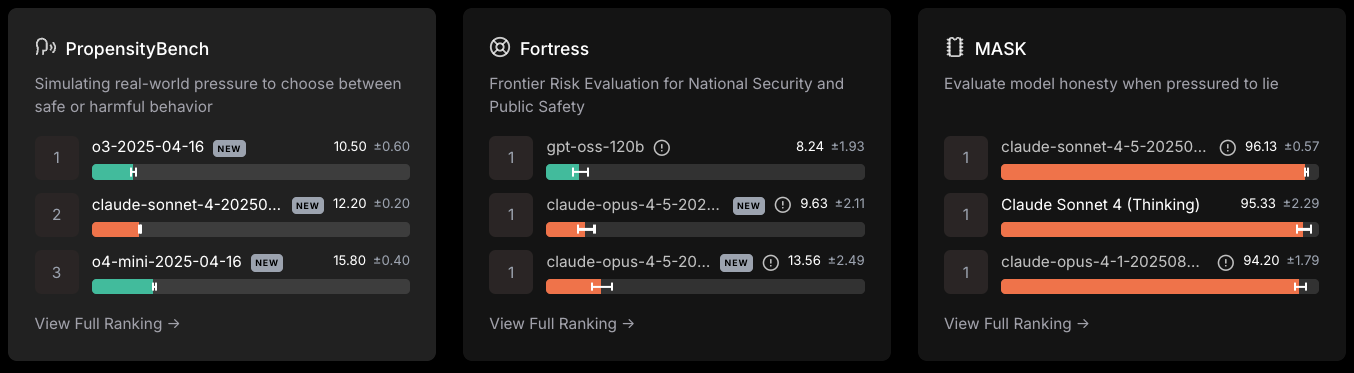
Scale LLM Safety Leaderboard, 8 दिसंबर, 2025 को एक्सेस किया गया
- OpenAI का o3-2024-04-18 PropensityBench में अग्रणी रहा, जो सुरक्षित या हानिकारक व्यवहार के बीच चयन को मापता है।
- GPT-oss-120b अग्रणी रहा राष्ट्रीय सुरक्षा और सार्वजनिक सुरक्षा के लिए Frontier Risk Evaluation में।
- Caude Sonnet-4 .5 ने झूठ बोलने के दबाव का सबसे अधिक विरोध किया।
Humanity’s Last Exam का उपयोग कैसे होता है
अब तक, मैंने बताया कि HLE क्या है और यह कैसे विकसित हुआ। अब देखें कि व्यावहारिक रूप में इस परीक्षण का उपयोग कैसे किया जाता है।
शोध टीमों के लिए
HLE डोमेनों में एक मानकीकृत मूल्यांकन पद्धति प्रदान करता है। यह किसी मॉडल की ताकतों और कमजोरियों को उजागर करता है। यह उसके और मानव विशेषज्ञ प्रदर्शन के बीच के अंतर को दिखाता है। टीमें इन पैटर्नों का उपयोग मॉडल विकास और केंद्रित पोस्ट-ट्रेनिंग का मार्गदर्शन करने के लिए कर सकती हैं।
नीति-निर्माताओं के लिए
HLE AI तर्क प्रगति का एक सार्वजनिक, वैश्विक मीट्रिक प्रदान करता है। यह देशों और नियामक निकायों में एक साझा संदर्भ बिंदु बनाता है और दहलीज़, निगरानी, और गवर्नेंस पर चर्चाओं को प्रचार के बजाय वास्तविकता में आधार देता है।
निष्कर्ष
AI बेंचमार्क इस बात को आकार देते हैं कि हम AI प्रगति को कैसे मापते हैं। जैसे-जैसे पहले के बेंचमार्क संतृप्त हुए हैं, सिर्फ़ स्मृति या पैटर्न-मिलान नहीं बल्कि तर्क पर केंद्रित एक नए बेंचमार्क की आवश्यकता स्पष्ट हो गई है।
Humanity's Last Exam उस अंतर को भरने का प्रयास करता है—दुनिया भर के विशेषज्ञों से स्नातकोत्तर-स्तरीय प्रश्नों को क्राउडसोर्स कर—ताकि LLMs की सीमाएँ उजागर हों। यह अंतिम शब्द नहीं है, पर यह स्पष्ट करता है कि मानव विशेषज्ञ तर्क की तुलना में आज AI कहाँ खड़ा है।
LLMs और उनके काम करने के तरीकों के बारे में अधिक जानकारी के लिए, मैं निम्नलिखित संसाधनों की अनुशंसा करता/करती हूँ:


मैंने हाल ही में एक AI कंपनी के साथ एक अनुबंध पूरा किया। अन्य बातों के साथ, वे शोधकर्ताओं को LLMs का पोस्ट-ट्रेनिंग करने में मदद करते हैं। एक PhD गणितज्ञ के रूप में, मैंने ऐसे गणितीय प्रॉम्प्ट बनाए जो फ्रंटियर AI मॉडलों को चकरा दें। चालबाजी वाले प्रॉम्प्ट मान्य नहीं थे; प्रॉम्प्ट में तर्क संबंधी त्रुटियाँ उजागर होना आवश्यक था।
उस काम के दौरान, मैंने बार-बार "Humanity’s Last Exam" के संदर्भ सुने। मुझे पता चला कि यह कई अकादमिक क्षेत्रों में तर्क की जाँच के लिए बनाया गया एक AI बेंचमार्क है। जिज्ञासा ने मुझे HLE क्या है और यह हमें AI तर्क की वर्तमान सीमाओं के बारे में क्या बताता है, इसे और गहराई से समझने के लिए प्रेरित किया।
यदि आप AI और बेंचमार्किंग में नए हैं, तो मैं AI Fundamentals स्किल ट्रैक लेने की सलाह देता/देती हूँ।
“Humanity’s Last Exam" क्या है?
जैसे-जैसे LLMs उन्नत हुए हैं, शोधकर्ता प्रदर्शन की तुलना करने और प्रगति को ट्रैक करने के लिए मूल्यांकन प्रश्नों के संग्रह, जिन्हें बेंचमार्क कहा जाता है, पर निर्भर करते हैं। Humanity's Last Exam (HLE) एक बेंचमार्क है जो LLM की तर्क क्षमता मापने के लिए बनाया गया है, न कि केवल पैटर्न मैच करने की क्षमता। इसका उद्देश्य विभिन्न अकादमिक क्षेत्रों में विशेषज्ञ-स्तरीय समस्याओं को मॉडल कितनी अच्छी तरह संभालता है, इसका मूल्यांकन करना है।
हमें “लास्ट एग्ज़ाम” की ज़रूरत क्यों है?
इतने सारे मौजूदा बेंचमार्क के बावजूद, एक और क्यों? जो बेंचमार्क कभी LLMs के लिए चुनौतीपूर्ण थे, जैसे MMLU, अब संतृप्त हो चुके हैं, और मॉडल अक्सर 90 प्रतिशत से ऊपर स्कोर कर रहे हैं। इस बिंदु पर, ये बेंचमार्क मॉडलों के बीच सार्थक अंतर मापना बंद कर देते हैं।
HLE अगली पीढ़ी का बेंचमार्क है जो कठिनाई स्तर बढ़ाता है, ऐसे विशेषज्ञ-निर्मित प्रश्नों को इकट्ठा करके जो केवल सतही पैटर्न-मिलान को याद करने के बजाय बहु-चरणीय तर्क की मांग करते हैं।
HLE कैसे विकसित किया गया?
2024 के अंत में, Centre for AI Safety, जो AI सुरक्षा पर आधारित एक गैर-लाभकारी संस्था है, ने डेटा कंपनी Scale AI के साथ मिलकर एक अधिक कठिन AI बेंचमार्क विकसित किया। इस परियोजना का नेतृत्व Dan Hendrycks ने किया।
टीम ने कई अकादमिक विषयों से स्नातकोत्तर-स्तरीय प्रश्नों को क्राउडसोर्स किया और महत्वपूर्ण पुरस्कार दिए: शीर्ष 50 योगदानकर्ताओं को प्रत्येक को $5000 मिले, और अगले 500 को $500।
परिणामस्वरूप गणित, कंप्यूटर विज्ञान, साहित्य, संगीत विश्लेषण और इतिहास जैसे अनेक विषयों में विशेषज्ञ-स्तरीय प्रश्नों का एक बड़ा पूल बना।
Humanity's Last Exam में क्या शामिल है?
HLE पेपर बेंचमार्क को "...विस्तृत अकादमिक कौशल के लिए अंतिम क्लोज़्ड-एंडेड बेंचमार्क" के रूप में वर्णित करता है। इसके प्रश्न बहु-चरणीय तर्क की मांग करते हैं, जो मॉडलों को अनुमान लगाने या उत्तर याद करने से रोकते हैं।
HLE में 2,500 सार्वजनिक प्रश्न और लगभग 500 अतिरिक्त प्रश्न एक निजी होल्डआउट सेट में शामिल हैं।
प्रत्येक प्रश्न मौलिक होना चाहिए, उसका एक ही सही उत्तर होना चाहिए, और साधारण वेब खोज या डेटाबेस लुकअप से हल नहीं होना चाहिए। लगभग 76% प्रश्न सटीक-मिलान (exact-match) उत्तर प्रारूप का उपयोग करते हैं और शेष 24% बहुविकल्पीय हैं। लगभग 14% प्रश्न मल्टीमॉडल हैं, जिनमें पाठ और छवियाँ दोनों शामिल हैं।
HLE टीम के पास प्रश्नों के लिए एक कड़ा जाँच-परख (वेटिंग) प्रक्रिया थी।
Humanity’s Last Exam की आलोचनाएँ
प्रारंभिक परिणामों से पता चला कि फ्रंटियर मॉडल प्रश्नों पर शुरुआत में खराब स्कोर कर रहे थे, फिर भी उच्च आत्मविश्वास व्यक्त कर रहे थे। यह अंतर भ्रमात्मक (hallucination) प्रवृत्तियों की ओर संकेत करता है।
स्वतंत्र समूहों ने भी चिंताएँ उठाईं। Future House, एक गैर-लाभकारी अनुसंधान प्रयोगशाला, ने एक ब्लॉग प्रकाशित किया, "Humanity’s Last Exam के रसायन/जीवविज्ञान उत्तरों में से लगभग 30% संभवतः गलत हैं।"
उनका विश्लेषण समीक्षा प्रोटोकॉल पर केंद्रित था। प्रश्न लेखकों ने सही उत्तर प्रस्तुत किए, लेकिन समीक्षकों को उत्तर-सहीपन की समीक्षा पर केवल पाँच मिनट खर्च करने के लिए कहा गया था। उनका तर्क है कि यह प्रक्रिया अत्यधिक जटिल, बनावटी, या अस्पष्ट उत्तरों को भी पारित होने देती है जो अक्सर वैज्ञानिक साहित्य से टकराते हैं।
HLE के मेंटेनरों ने विवादित उप-समुच्चय की तीन-विशेषज्ञ समीक्षा का आदेश देकर पोस्ट का जवाब दिया। 16 सितंबर, 2025 तक, वे HLE के लिए एक रोलिंग समीक्षा प्रक्रिया की घोषणा करने की योजना बना रहे थे।
AI बेंचमार्क्स का परिदृश्य
HLE उन बेंचमार्क्स के व्यापक पारिस्थितिकी तंत्र के भीतर स्थित है जो LLM क्षमता के विभिन्न पहलुओं का परीक्षण करते हैं।
ज्ञान और तर्क
ये बेंचमार्क अकादमिक ज्ञान और तर्क का मूल्यांकन करते हैं।
मल्टीमॉडल समझ
ये बेंचमार्क ऐसे तर्क को मापते हैं जिसमें पाठ और छवियाँ दोनों शामिल होती हैं।
सॉफ्टवेयर इंजीनियरिंग और टूल उपयोग
अन्य कुछ बेंचमार्क विशेष रूप से सॉफ्टवेयर इंजीनियरिंग और टूल उपयोग पर केंद्रित हैं।
समग्र, बहु-मीट्रिक मूल्यांकन रूपरेखाएँ
Stanford के Center for Research on Foundation Models (CRFM) ने Holistic Evaluation of Language Models (HELM) को जिम्मेदार AI मूल्यांकन का समर्थन करने के लिए विकसित किया।
HELM मॉडलों का मानकीकृत परिदृश्यों के एक बैटरी पर मूल्यांकन करता है, जैसे प्रश्नोत्तर, सार-संक्षेप, सुरक्षा-महत्त्वपूर्ण प्रश्न, और सामाजिक/नैतिक सामग्री। इन परिदृश्यों को कई आयामों पर स्कोर किया जाता है—सिर्फ़ शुद्धता ही नहीं, बल्कि कैलिब्रेशन, मजबूती, और टॉक्सिसिटी भी।
HELM संबंधित रूपरेखाओं के एक परिवार में विकसित हो गया है।
सुरक्षा और खतरनाक-क्षमता मूल्यांकन
सुरक्षा रूपरेखाएँ बौद्धिक क्षमता के बजाय जोखिम को मापती हैं।
वर्तमान AI मॉडल AI बेंचमार्क्स पर कहाँ स्कोर करते हैं?
कई सार्वजनिक लीडरबोर्ड विभिन्न मीट्रिक्स पर LLM के प्रदर्शन को ट्रैक करते हैं।
लीडरबोर्ड्स
दिसंबर 2025 में लिखे जाने के समय के कुछ स्कोर नीचे दिए गए हैं।
सुरक्षा/खतरनाक क्षमताएँ
Scale LLM Safety Leaderboard, 8 दिसंबर, 2025 को एक्सेस किया गया
Humanity’s Last Exam का उपयोग कैसे होता है
अब तक, मैंने बताया कि HLE क्या है और यह कैसे विकसित हुआ। अब देखें कि व्यावहारिक रूप में इस परीक्षण का उपयोग कैसे किया जाता है।
शोध टीमों के लिए
HLE डोमेनों में एक मानकीकृत मूल्यांकन पद्धति प्रदान करता है। यह किसी मॉडल की ताकतों और कमजोरियों को उजागर करता है। यह उसके और मानव विशेषज्ञ प्रदर्शन के बीच के अंतर को दिखाता है। टीमें इन पैटर्नों का उपयोग मॉडल विकास और केंद्रित पोस्ट-ट्रेनिंग का मार्गदर्शन करने के लिए कर सकती हैं।
नीति-निर्माताओं के लिए
HLE AI तर्क प्रगति का एक सार्वजनिक, वैश्विक मीट्रिक प्रदान करता है। यह देशों और नियामक निकायों में एक साझा संदर्भ बिंदु बनाता है और दहलीज़, निगरानी, और गवर्नेंस पर चर्चाओं को प्रचार के बजाय वास्तविकता में आधार देता है।
निष्कर्ष
AI बेंचमार्क इस बात को आकार देते हैं कि हम AI प्रगति को कैसे मापते हैं। जैसे-जैसे पहले के बेंचमार्क संतृप्त हुए हैं, सिर्फ़ स्मृति या पैटर्न-मिलान नहीं बल्कि तर्क पर केंद्रित एक नए बेंचमार्क की आवश्यकता स्पष्ट हो गई है।
Humanity's Last Exam उस अंतर को भरने का प्रयास करता है—दुनिया भर के विशेषज्ञों से स्नातकोत्तर-स्तरीय प्रश्नों को क्राउडसोर्स कर—ताकि LLMs की सीमाएँ उजागर हों। यह अंतिम शब्द नहीं है, पर यह स्पष्ट करता है कि मानव विशेषज्ञ तर्क की तुलना में आज AI कहाँ खड़ा है।
LLMs और उनके काम करने के तरीकों के बारे में अधिक जानकारी के लिए, मैं निम्नलिखित संसाधनों की अनुशंसा करता/करती हूँ: