
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.7K
अपडेट: 2 सितंबर, 2026: Alibaba ने Qwen3.8-Max-0902 जारी किया है, जो Qwen3.8-Max का एक अपग्रेडेड स्नैपशॉट है और कोडिंग व एजेंट परफ़ॉर्मेंस पर केंद्रित है। नीचे दिया गया सेक्शन नए बेंचमार्क्स को दर्शाने के लिए जोड़ा गया है।
2 सितंबर, 2026 को Alibaba ने Qwen3.8-Max-0902 जारी किया, जो Qwen3.8-Max का पोस्ट-ट्रेनिंग अपग्रेड है। आर्किटेक्चर अपरिवर्तित है: 2.4 ट्रिलियन पैरामीटर्स, 1M टोकन कॉन्टेक्स्ट, और वही प्राइसिंग ($2/1M इनपुट, $6/1M आउटपुट)। फ़ोकस पूरी तरह कोडिंग और लॉन्ग-होराइज़न एजेंट कार्य पर है।
उल्लेखनीय नतीजा Code Arena WebDev है, जहाँ Qwen3.8-Max-0902 कुल मिलाकर 1,691 अंकों के साथ पहले स्थान पर है—Claude Opus 5 Max (1,687) से 3 अंक, Kimi K3 Max (1,674) से 17, और पिछले Qwen3.8-Max (1,669) से 22 अंक आगे। यह मिश्रित $5 प्रति मिलियन टोकन की लागत पर Pareto फ़्रंटियर पर भी शीर्ष स्थान पर है।
सभी 8 कोडिंग बेंचमार्क्स में सुधार हुआ। सबसे बड़े लाभ TerminalBench 3.0 (11.3 से 29.0) और ProgramBench Almost Solved (10.5 से 28.0) पर हैं—दोनों में दोगुने से अधिक। नीचे दी गई तालिका कोडिंग, एजेंट, और मल्टीमोडल श्रेणियों में पूरी तस्वीर दिखाती है।
| बेंचमार्क | Qwen3.8-Max-0902 | Qwen3.8-Max | Claude Opus 5 |
|---|---|---|---|
| कोडिंग | |||
| TerminalBench 3.0 | 29.0 | 11.3 | 42.7 |
| DeepSWE 1.1 | 69.3 | 56.6 | 73.6 |
| NL2Repo-Bench | 64.9 | 55.9 | 72.3 |
| ProgramBench (Almost Solved) | 28.0 | 10.5 | 41.5 |
| SWE-Marathon | 44.8 | 39.1 | 50.0 |
| MLS-Bench-Lite | 50.1 | 41.0 | 49.8 |
| SWE-Atlas QnA | 66.3 | 60.3 | 63.2 |
| QwenSWEBench V2 | 70.0 | 55.1 | 68.0 |
| एजेंट | |||
| CoWorkBench | 76.1 | 74.8 | 79.6 |
| JobBench | 64.0 | 53.4 | 67.8 |
| Toolathlon Verified | 73.3 | 72.5 | 77.6 |
| WorkArena (Elo) | 1468 | 1348 | 1437 |
| मल्टीमोडल | |||
| MMMU-Pro | 82.7 | 82.3 | 82.6 |
| ERQA | 78.3 | 77.8 | 67.3 |
बोल्ड यह दर्शाता है कि उस बेंचमार्क पर Qwen3.8-Max-0902, Claude Opus 5 से आगे है। सभी नतीजे Alibaba की प्रकाशित तुलना तालिका से हैं।
Claude Opus 5 की तुलना में, 0902 अपडेट तीन कोडिंग बेंचमार्क्स (MLS-Bench-Lite, SWE-Atlas QnA, QwenSWEBench V2) पर आगे है और WorkArena व दोनों प्रकाशित मल्टीमोडल इवाल्स पर जीतता है। Claude अब भी TerminalBench 3.0, DeepSWE 1.1, और एजेंट कोऑर्डिनेशन बेंचमार्क्स पर आगे है। प्राइसिंग अपरिवर्तित है, इसलिए यदि आप पहले से Qwen3.8-Max का उपयोग कर रहे थे, तो यह एक मुफ़्त अपग्रेड है जो कोडिंग में अर्थपूर्ण बढ़त देता है। Qwen ने 18 सितंबर को Qwen3.8-Omni-Flash भी जारी किया।
मूल लेख
Alibaba की Qwen टीम ने 3 अगस्त, 2026 को Qwen3.8-Max जारी किया, और यह फ़्रंटियर मार्केट के सबसे प्रतिस्पर्धी हिस्से—स्वायत्त सॉफ़्टवेयर इंजीनियरिंग और लॉन्ग-होराइज़न एंटरप्राइज़ कार्य—में सीधे उतरता है। यह पहली बार है जब Qwen एक Max-क्लास मॉडल को ओपन-सोर्स करने की योजना बना रहा है, जिसके वेट्स अगले हफ्ते एक छोटे Qwen3.8-27B के साथ जारी होने वाले हैं।
Qwen3.8-Max एक 2.4-ट्रिलियन-पैरामीटर mixture-of-experts (MoE) मॉडल है, जिसमें 95B सक्रिय पैरामीटर, 1M-टोकन कॉन्टेक्स्ट विंडो, और मूल पाठ, इमेज, व वीडियो इनपुट है। मुख्य दावा है कि यह OSWorld-Verified पर 86.1 स्कोर करता है, GPT-5.6 Sol Max (83.2), Claude Fable 5 (85.0), और Gemini 3.1 Pro (76.2) से आगे। यह 93.0 के साथ सबसे अधिक रिपोर्टेड PaperBench स्कोर भी दर्ज करता है और प्रति मिलियन इनपुट/आउटपुट टोकन $2/$6 की कीमत पर उपलब्ध है।
इस लेख में, मैं Qwen3.8-Max की नई बातें कवर करूंगा—इसके कोडिंग और एजेंटिक फ़ीचर्स, बेंचमार्क्स की पड़ताल, और आपके लिए हैंड्स-ऑन टेस्ट सेटअप। संबंधित कवरेज के लिए हमारे Grok 4.5 के गाइड्स, GPT-5.6 Terra बनाम Claude Sonnet 5, और Claude API के पूर्ण गाइड देखें। आप नए Qwen3.8-Flash के बारे में भी पढ़ सकते हैं।
Qwen3.8-Max, Qwen परिवार का सबसे सक्षम मॉडल है—एक स्पार्स MoE आर्किटेक्चर—जिसमें कुल 2.4 ट्रिलियन पैरामीटर्स हैं और प्रति फ़ॉरवर्ड पास लगभग 95B सक्रिय।
यह Qwen 3.5 की आर्किटेक्चरल नींव पर बना है और खास तौर पर चार ट्रैक्स को लक्षित करता है:
Qwen3.7-Max से सबसे बड़ा संरचनात्मक बदलाव स्केल और ओपन-वेट प्रतिबद्धता है। Qwen ने पहले कभी Max-क्लास मॉडल के वेट्स जारी नहीं किए हैं, और कंपनी का कहना है कि Qwen3.8-Max और Qwen3.8-27B दोनों अगले हफ्ते Hugging Face और ModelScope पर आएंगे।
Alibaba ने अभी तक लाइसेंस का खुलासा नहीं किया है, इसलिए यह स्पष्ट नहीं है कि यह Apache 2.0 जैसी परमिटिव लाइसेंस के तहत आएगा या अधिक प्रतिबंधात्मक कस्टम लाइसेंस के तहत।
बेंचमार्क फ़्रंट पर सबसे महत्वपूर्ण खबर एजेंटिक कंप्यूटर उपयोग की है।
OSWorld-Verified पर, जो यह मापता है कि कोई एजेंट वास्तविक डेस्कटॉप वातावरण को कितना अच्छी तरह संचालित करता है, Qwen3.8-Max उन सभी मालिकाना मॉडलों से आगे है जिनसे Qwen ने इसकी तुलना की।
एक ऐसे मॉडल के लिए जो सेल्फ-होस्टेबल होगा, यह सामान्य ओपन-वेट रिलीज़ से अलग प्रस्ताव है, जो अक्सर फ़्रंटियर से एक पीढ़ी पीछे रहते हैं।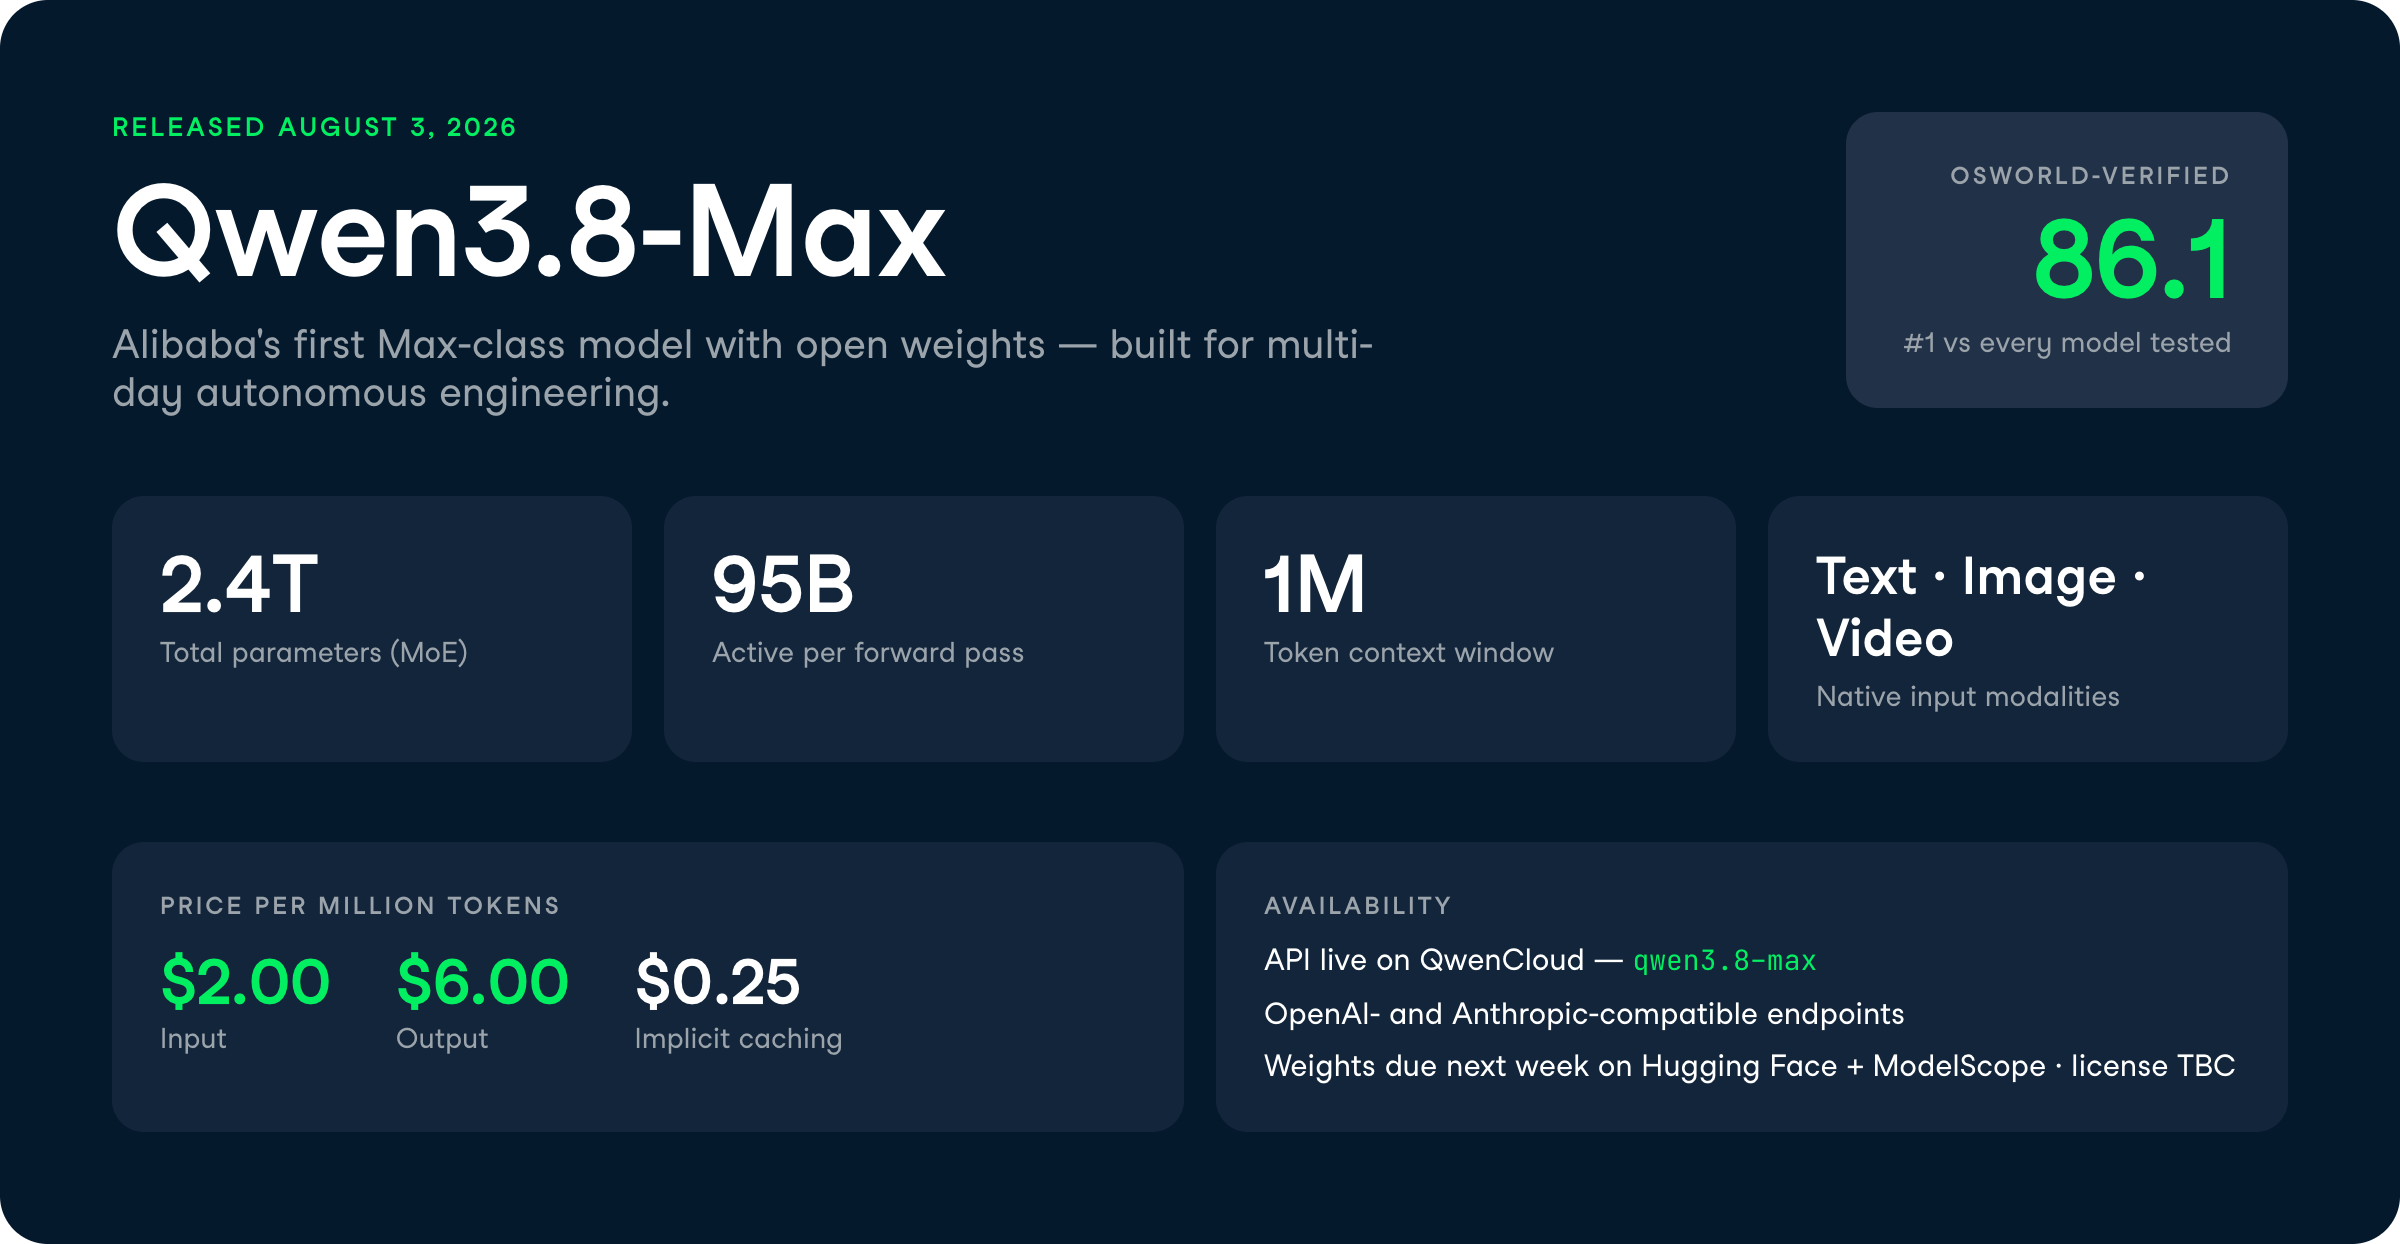
Qwen3.8-Max की पूरी थीम लंबी अवधि में स्वायत्तता है।
Qwen हर क्षमता को इसी विचार के इर्द-गिर्द फ़्रेम करता है: मॉडल किसी तय योजना का पालन नहीं करता; यह लगातार फ़ीडबैक लूप्स के ज़रिये दिनों तक स्वयं-सुधार करता है।
मेरे लिए जो फ़ीचर्स सबसे अलग दिखे, वे यहाँ हैं।
Qwen3.8-Max बिना मानव हस्तक्षेप के, दिनों तक लगातार काम करते हुए, एक खाली फ़ोल्डर से एक तैयार डिलिवरेबल तक कोडिंग प्रोजेक्ट ले जा सकता है।
कंपनी के फ़्लैगशिप डेमो ने लगभग 16 दिनों तक पूर्णतः स्वायत्त रूप से चलकर, एक स्वयं-विकसित होने वाला CLI हार्नेस बनाया, जिसमें 265 कमिट्स, 127 PRs, और 151 इश्यूज़ शामिल हुए।
तंत्र एक फ़ीडबैक लूप है: आवश्यकताएँ GitHub इश्यूज़ के रूप में आती हैं, एजेंट्स उन्हें क्लेम कर निष्पादित करते हैं, फिर मर्ज से पहले बिल्ड, यूनिट टेस्ट, एंड-टू-एंड टेस्ट, और CI चेक्स ट्रिगर होते हैं।
व्यवहार में, यह उन मॉडलों की ओर इशारा करता है जो एक-शॉट कोड प्रश्नों का उत्तर देने के बजाय बिना निगरानी के इंजीनियरिंग पाइपलाइनों को चलाने के लिए डिज़ाइन किए गए हैं।
स्पष्ट चेतावनी यह है कि ये वेंडर-चलित शोकेस हैं।
कंट्रोल्ड एन्वायरनमेंट में 16-दिन का स्वायत्त रन, इसे आपके प्रोडक्शन मोनोरेपो पर पॉइंट कर देने और दूर चले जाने के बराबर नहीं है।
Qwen3.8-Max एक शोध पेपर पढ़ सकता है, उसकी एक्सपेरिमेंट्स को शून्य से कोड में पुन: उत्पन्न कर सकता है, और फिर मूल विधि को हराने की कोशिश कर सकता है।
Qwen के उदाहरण में, मॉडल ने लगभग 5 दिन (~125 घंटे) काम किया, लगभग 7,600 पंक्तियों का कोड लिखा, 1,100 से अधिक एक्शंस लिए, और बिना किसी स्टार्टर कोड के 33 राउंड GPU ट्रेनिंग चलाई।
इसने पहले पेपर के छह मुख्य निष्कर्षों को पुन: उत्पन्न किया, फिर 4 राउंड और 18 आइडियाज़ में हाइपोथेसिस, कोड, GPU रन, और विश्लेषण का स्वयं-सुधार लूप चलाया।
इसने जो अंतिम विधि ईजाद की, उसने AIME24—एक प्रतियोगिता-स्तरीय गणित बेंचमार्क—पर पेपर के अपने एप्रोच को 2.71 अंकों से हरा दिया।
यह वैसा वर्कफ़्लो है जो सामान्यतः किसी रिसर्च टीम का एक हफ्ता सेटअप में ही खा जाता है, इससे पहले कि एक्सपेरिमेंट्स शुरू हों।
Dynamic Workflows, Qwen3.8-Max को किसी कार्य की प्रोग्रामेटिक योजना बनाने और बड़ी संख्या में सब-एजेंट्स को पैरलल में डिस्पैच करने देते हैं।
एक क्वांट-रिसर्च डेमो में, मॉडल ने 6 छोटे फ़ैक्टर विवरणों को प्रत्येक के 50 रिसर्च डायरेक्शंस में विघटित किया, लगभग 330 सब-एजेंट्स डिस्पैच किए, और ~6,000 बैकटेस्ट पूरे किए, साथ ही रन के दौरान वर्कफ़्लो को अनुकूलित किया।
इसे किसी फ़िक्स्ड स्क्रिप्ट से अलग बनाता है कि मॉडल ने साक्ष्यों पर कार्रवाई की।
जब इसे ओवरफ़िटिंग के संकेत दिखे, तो इसने राउंड-दर-राउंड अतिरिक्त फ़ैक्टर्स को छांटा; जब छोटे क्रॉस-सेक्शंस पर तीन-मॉडल एन्सेम्बलिंग, फ़िक्स्ड-डायरेक्शन सिंथेसिस से कम मज़बूत दिखी, तो इसने अपने आप फ़्रेमवर्क बदल दिया।
चयनित फ़ैक्टर्स ने 0.64 से 1.48 तक अतिरिक्त Sharpe रेशियो हासिल किए—जो किसी धारणा के बजाय ठोस, जाँचे जा सकने वाले नतीजे हैं।
Qwen3.8-Max पूरे निष्पादन के दौरान विज़न का उपयोग करता है, केवल इनपुट पढ़ने के लिए नहीं।
किसी टास्क के दौरान, यह अपने मध्यवर्ती आउटपुट का निरीक्षण करता है, जैसे गलत-संरेखित इंटरफ़ेस या उल्टी दिशा में देखती वस्तु जैसी समस्याएँ पहचानता है, और उन्हें ठीक करने के लिए योजना में संशोधन करता है।
इनपुट पक्ष पर, यह 200 से अधिक पन्नों के PDFs—टेक्स्ट, चार्ट्स, और लेआउट सहित—को संभालता है, और लोगों, घटनाओं, और टाइमस्टैम्प्स का वीडियो मेमोरी ग्राफ बनाकर 100 घंटे से लंबी वीडियोज़ प्रोसेस कर सकता है।
Qwen ने Qwen-MM-Plugins भी जारी किए, जो एक हार्नेस एक्सटेंशन लाइब्रेरी है, जो मौजूदा एजेंट फ़्रेमवर्क्स में इमेज और वीडियो प्रोसेसिंग, मल्टीमोडल मेमोरी, और विज़ुअल टूल उपयोग जोड़ती है।
जो लोग डॉक्यूमेंट-हेवी या वीडियो-हेवी एजेंट्स बना रहे हैं, उनके लिए मेमोरी ग्राफ देखने लायक हिस्सा है।
Qwen3.8-Max एक reasoning_effort पैरामीटर उपलब्ध कराता है ताकि आप लागत और गहराई के बीच संतुलन बना सकें। तीन स्तर आपको नियंत्रित करने देते हैं कि उत्तर देने से पहले मॉडल कितना सोचे:
xhigh (डिफ़ॉल्ट): उन जटिल कार्यों के लिए, जिन्हें गहन विश्लेषण चाहिएmedium: सटीकता और गति का संतुलनlow: गति और लागत के लिए अनुकूलित कुशल रीज़निंगध्यान देने योग्य: r/LocalLLaMA के एक कमेंटर ने नोट किया कि Qwen मॉडल अक्सर ज़रूरत से ज़्यादा सोचते हैं, और DeepSeek V4 Flash कम समय रीज़निंग में बिताता है, भले ही कभी-कभी आउटपुट गुणवत्ता कम हो। यदि आपका वर्कलोड लेटेंसी-सेंसिटिव है, तो डिफ़ॉल्ट को सही मान लेने से पहले low पर स्विच करें।
Qwen का बेंचमार्क सूट स्थिर परीक्षाओं की बजाय लॉन्ग-होराइज़न एक्ज़िक्यूशन पर भारी झुका है, जो मॉडल की पोज़िशनिंग के अनुरूप है।
प्रकाशित तालिकाओं में, Qwen3.8-Max एजेंटिक कंप्यूटर उपयोग, रिसर्च पुनरुत्पादन, और कोडिंग में आगे या बहुत प्रतिस्पर्धी रहता है, जबकि कुछ सॉफ़्टवेयर-इंजीनियरिंग इवाल्स पर GPT-5.6 Sol Max और Fable 5 से पीछे रहता है।
यह हर श्रेणी पर हावी होने के बजाय सबसे व्यापक संतुलित प्रोफ़ाइल्स में से एक पेश करता है।
| बेंचमार्क (श्रेणी) | Qwen 3.8 Max | Qwen 3.7 Max | Opus 4.8 | Fable 5 | Gemini 3.1-Pro | GPT5.6 Sol (max) |
|---|---|---|---|---|---|---|
| SWE-Pro (सॉफ़्टवेयर इंजीनियरिंग) | 67.7 | 60.6 | 69.2 | 80.0 | - | 64.6 |
| TerminalBench-2.1 (टर्मिनल एजेंट) | 86.6 | 74.5 | 84.6 | 84.6 | - | 88.8 |
| PaperBench (रिसर्च पुनरुत्पादन) | 93.0 | 64.8 | 80.3 | 88.8 | - | 90.5 |
| FrontierSWE (सॉफ़्टवेयर इंजीनियरिंग) | 73.5 | 40.7 | 70.0 | 88.8 | - | - |
| QwenReactBench (React फ़्रंटएंड) | 1724 | 1538 | 1694 | 1770 | - | 1564 |
| CoWorkBench (प्रोफ़ेशनल कोवर्क टास्क्स) | 74.8 | 64.6 | 72.3 | 75.9 | - | 71.5 |
| JobBench (एजेंट्स द्वारा मानव वर्कफ़्लोज़ सशक्त) | 53.4 | 31.3 | 48.4 | 57.4 | - | 45.4 |
| Agents' Last Exam (लॉन्ग-होराइज़न वैल्यूएबल टास्क्स) | 52.4 | 31.1 | 45.1 | - | - | 53.6 |
| BabyVision (विज़ुअल रीज़निंग)* | 82.0 / 91.3 | 64.7 / 70.4 | 28.4 / 81.2 | 42.5 / 90.5 | 55.9 / 68.3 | 65.5 / 88.9 |
| CharXiv (RQ) (चार्ट रीज़निंग)* | 88.4 / 93.5 | 85.8 / 85.9 | 78.5 / 89.9 | 87.9 / 93.5 | 84.4 / 89.9 | 85.1 / 89.1 |
| ERQA (एंबॉडीड रीज़निंग) | 77.8 | 69.8 | 57.2 | 70.0 | 68.0 | 70.0 |
| PerceptionBench (विज़ुअल परसेप्शन) | 63.5 | 51.1 | 47.2 | 57.2 | 56.2 | 59.7 |
| LVBench (लॉन्ग वीडियो अंडरस्टैंडिंग) | 81.8 | 76.2 | 67.3 | 75.1 | - | 78.8 |
| Vision2Web (विज़ुअल वेब डेवलपमेंट) | 69.0 | 42.1 | 62.4 | 70.5 | - | 62.1 |
| MobileWorld (एजेंटिक मोबाइल उपयोग) | 77.8 | 51.2 | 67.5 | 85.5 | 58.1 | 76.9 |
| OSWorld-Verified (एजेंटिक कंप्यूटर उपयोग) | 86.1 | 73.3 | 83.4 | 85.0 | 76.2 | 83.2 |
महत्वपूर्ण नोट्स:
* डुअल स्कोर्स: जिन बेंचमार्क्स में दोहरे मीट्रिक्स (BabyVision और CharXiv) हैं, वहाँ मान w/o python / w/ python प्रारूप में दिए गए हैं, संबंधित बार्स पर दिखाए गए अंदरूनी और शीर्ष संख्याओं के आधार पर।
* लापता डेटा (-): हाइफ़न यह दर्शाते हैं कि उस विशेष मॉडल का या तो परीक्षण नहीं किया गया या स्कोर चार्ट्स से बाहर रखा गया।
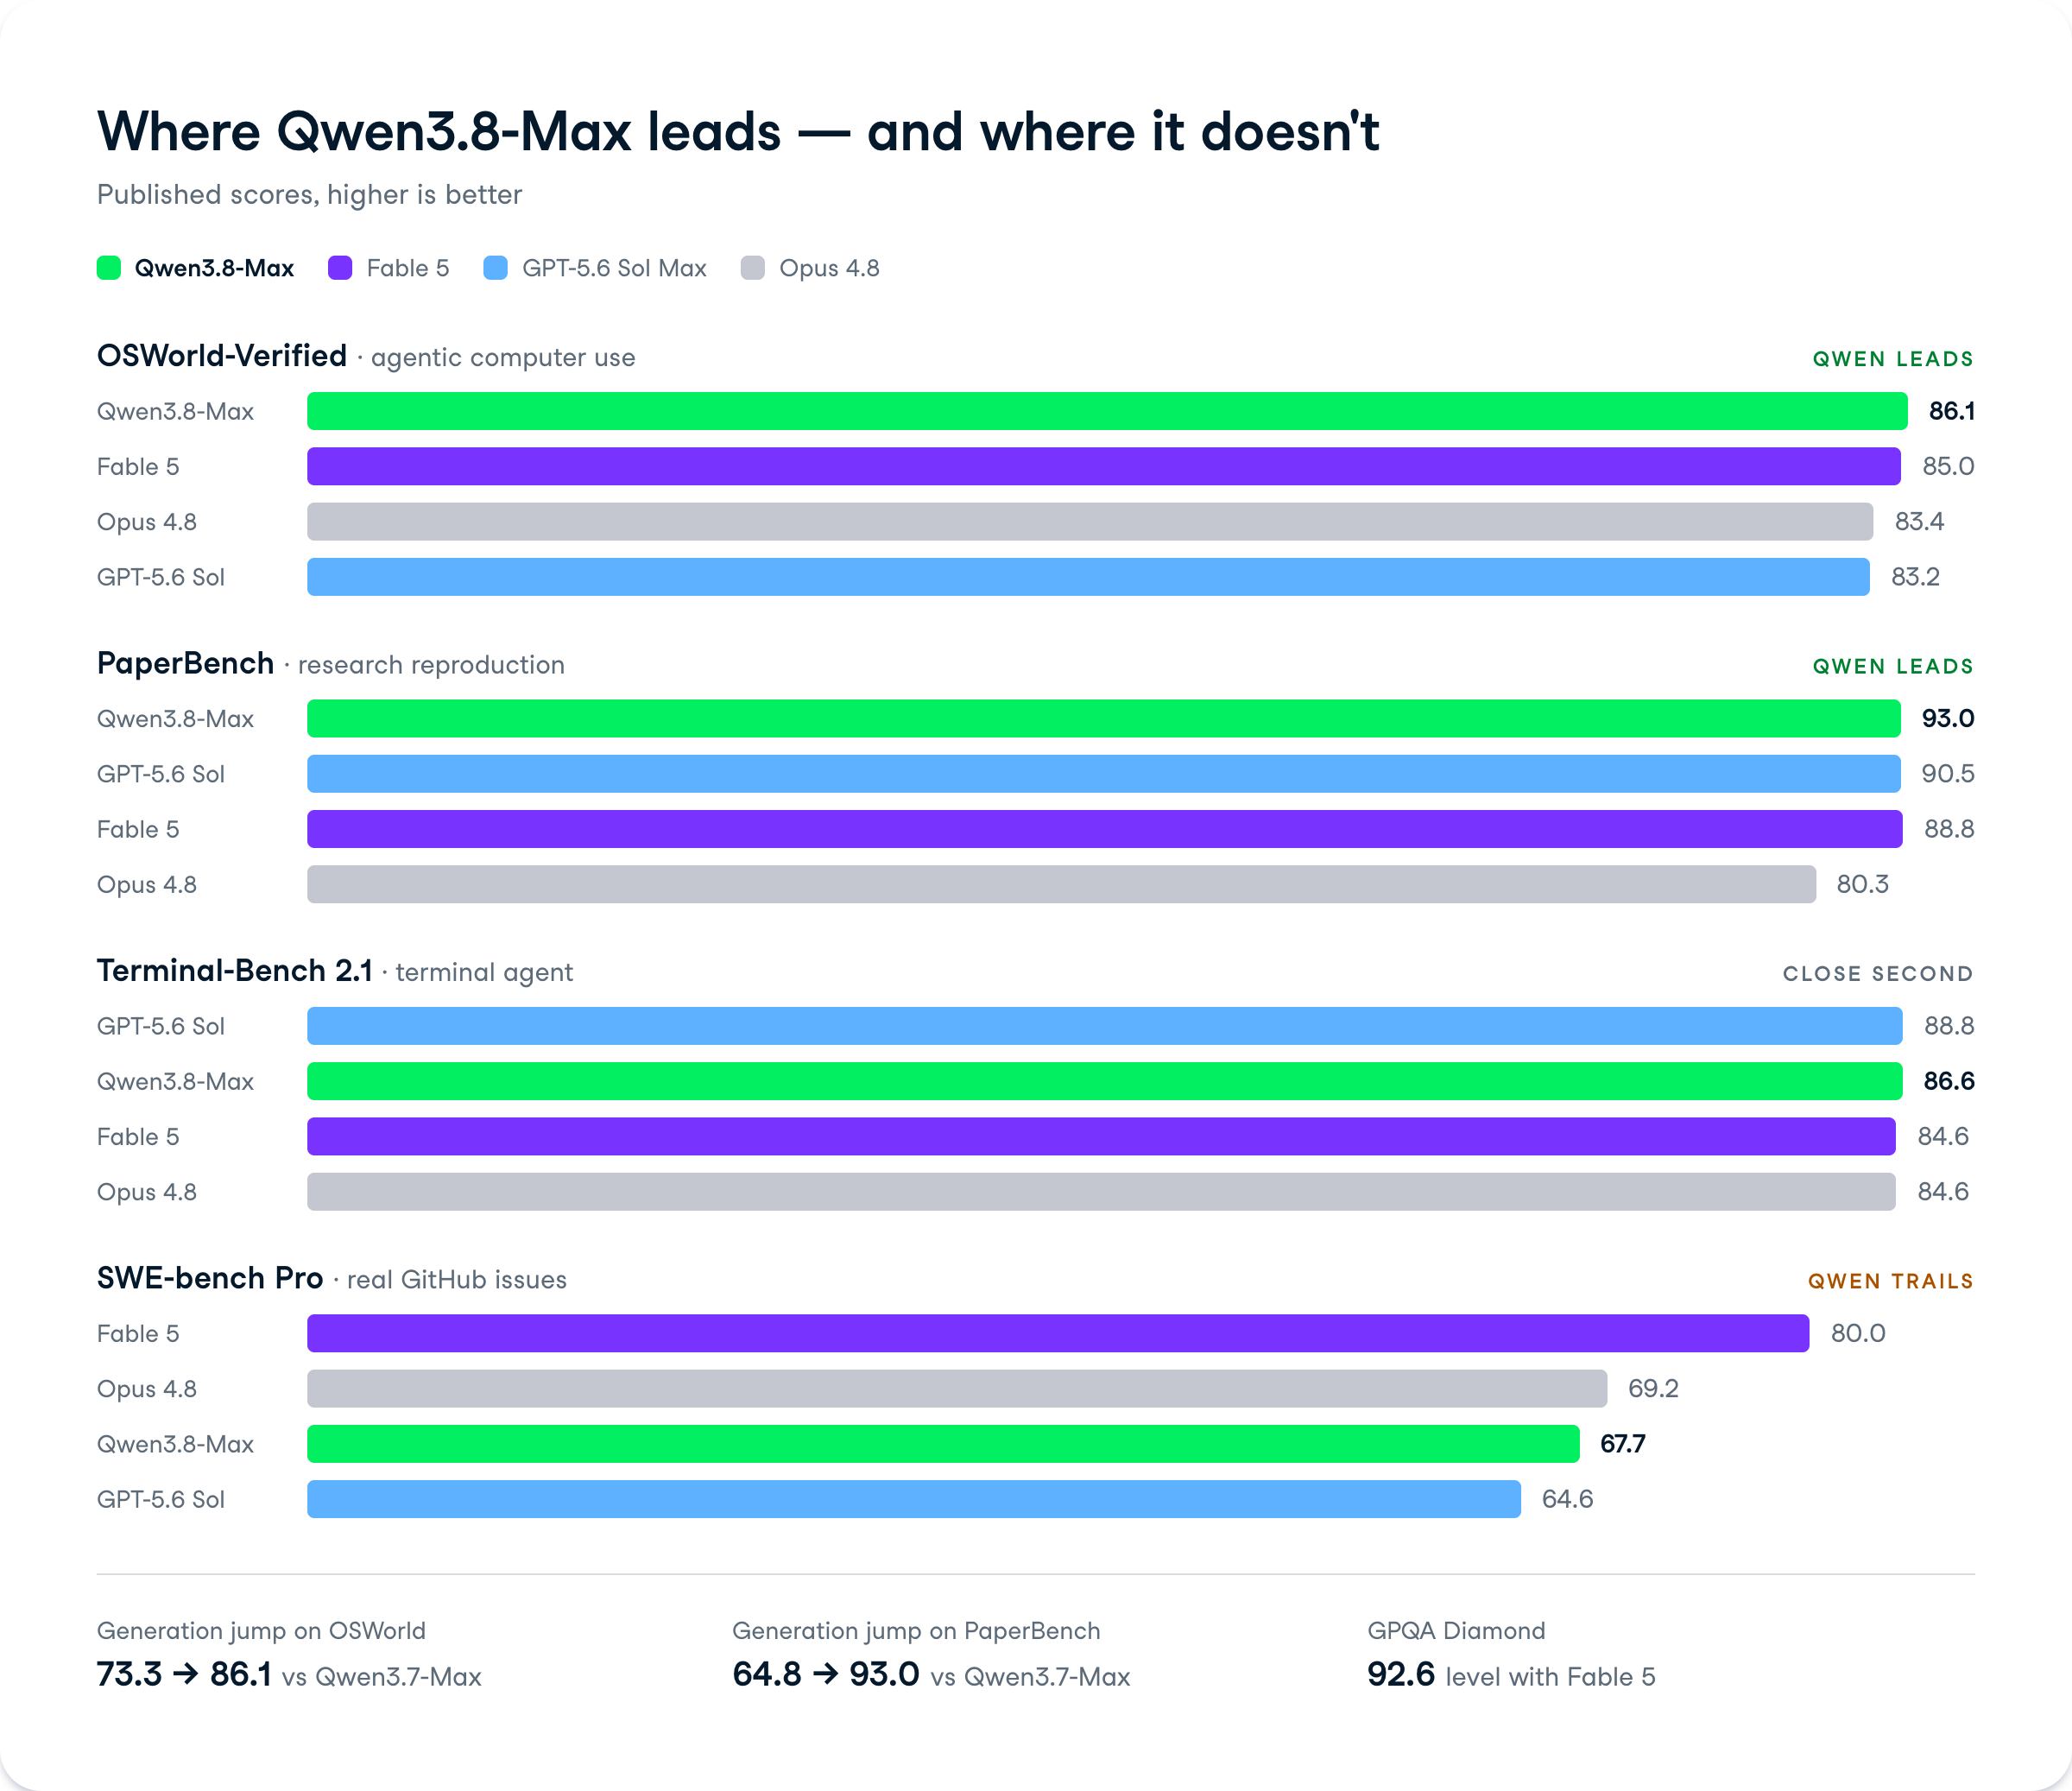
OSWorld-Verified पर Qwen3.8-Max 86.1 स्कोर करता है, Fable 5 (85.0), GPT-5.6 Sol Max (83.2), और Gemini 3.1 Pro (76.2) से आगे।
यह बेंचमार्क मापता है कि कंप्यूटर-उपयोग एजेंट वास्तविक डेस्कटॉप वातावरण को कितनी विश्वसनीयता से संचालित करता है—इंटरफ़ेस पर क्लिक करते हुए और मल्टी-स्टेप कार्यों को पूरा करते हुए।
जो कोई भी ऐसे एजेंट बना रहा है जो APIs कॉल करने के बजाय वास्तविक एप्लिकेशंस चलाते हैं, उसके लिए यही संख्या सबसे महत्वपूर्ण है। Qwen3.7-Max ने यहाँ केवल 73.3 स्कोर किया था, इसलिए परिवार के भीतर यह छलांग महत्वपूर्ण है।
PaperBench पर, Qwen3.8-Max 93.0 पोस्ट करता है, जो सबसे ऊँचा रिपोर्टेड स्कोर है—GPT-5.6 Sol के 90.5 और Fable 5 के 88.8 से आगे।
PaperBench यह मापता है कि कोई मॉडल किसी शोध पेपर के एक्सपेरिमेंट्स को कोड में कितनी अच्छी तरह पुन: उत्पन्न कर सकता है—जो सीधे 5-दिन के रिसर्च पुनरुत्पादन शोकेस से मेल खाता है।
यह Qwen3.7-Max के 64.8 पर बड़े अंतर की बढ़त है। यदि आपका काम पेपर्स को कार्यशील पाइपलाइनों में बदलना है, तो यह एक मजबूत संकेत है।
Terminal-Bench 2.1 पर Qwen3.8-Max 86.6 स्कोर करता है, GPT-5.6 Sol के 88.8 और Opus 4.8 व Fable 5 के 84.6 के बीच।
यह बेंचमार्क समय-सीमा के भीतर टर्मिनल में कार्य करते हुए किसी एजेंट की इंजीनियरिंग टास्क पूरी करने की क्षमता को परखता है।
यह Qwen3.7-Max के 74.5 पर वास्तविक सुधार है, और कमांड-लाइन एजेंटिक कार्य पर शीर्ष मालिकाना स्कोर्स के क़रीब एक ओपन-वेट मॉडल को लाता है।
यहाँ Qwen3.8-Max पिछड़ता है। यह SWE-bench Pro पर 67.7 स्कोर करता है—Fable 5 के 80.0 और Opus 4.8 के 69.2 से पीछे, हालांकि GPT-5.6 Sol के 64.6 से आगे।
SWE-bench Pro प्रोफ़ेशनल कोडबेस में वास्तविक GitHub इश्यूज़ को सुलझाने की क्षमता को मापता है।
यह ईमानदार कमज़ोरी है। जब हमने Grok 4.5 की समीक्षा की, तब भी Fable 5 SWE-Bench Pro पर 80.4 के साथ आगे था, इसलिए Anthropic का मॉडल इस विशेष इवाल पर अब भी हराने लायक बना हुआ है।
GPQA Diamond—एक ग्रेजुएट-स्तरीय विज्ञान रीज़निंग बेंचमार्क—पर Qwen3.8-Max 92.6 स्कोर करता है, जो Fable 5 (92.6) के बराबर और GPT-5.6 Sol (94.1) से थोड़ा पीछे है। यह IFBench (निर्देश पालन) पर 82.8, HealthBench पर 60.2, और PRBench-Finance पर 58.3 के साथ अग्रणी भी है।
पैटर्न पूरे बोर्ड पर कायम है: एजेंटिक और एप्लाइड कार्यों पर मज़बूत, रीज़निंग पर प्रतिस्पर्धी, और कभी-कभी सबसे कठिन रीज़निंग परीक्षा Humanity's Last Exam पर पीछे—जहाँ यह 43.6 स्कोर करता है, Fable 5 के 53.3 के मुक़ाबले।
Qwen3.8-Max, QwenCloud पर अभी उपलब्ध है, API मॉडल ID qwen3.8-max के साथ। API, OpenAI-कम्पैटिबल चैट कम्प्लीशन्स और रिस्पॉन्सेस एंडपॉइंट्स के साथ-साथ Anthropic-कम्पैटिबल इंटरफ़ेस को सपोर्ट करता है, ताकि आप Claude Code या Codex को न्यूनतम कॉन्फ़िग परिवर्तन के साथ इस पर पॉइंट कर सकें।
प्राइसिंग मिड-टियर में बैठती है और जिन शीर्ष अमेरिकी मालिकाना मॉडलों के साथ इसका बेंचमार्क हुआ है, उनसे कम है:
यह $8 का संयुक्त कुल, Claude Opus 5 के $30 का एक-तिहाई से भी कम और GPT-5.6 Sol Standard के $35 का एक-चौथाई से कम है। यह Grok 4.5 से मेल खाता है, जो $2/$6 पर ही प्राइस्ड है, जैसा कि हमने अपने Grok 4.5 कवरेज में नोट किया। Qwen3.8-Max और Qwen3.8-27B दोनों के ओपन वेट्स अगले हफ्ते Hugging Face और ModelScope पर आने वाले हैं, हालांकि लाइसेंस शर्तें अभी सार्वजनिक नहीं हैं।
Qwen3.8-Max यह बताने का Alibaba का तरीका है कि ओपन वेट्स कहाँ प्रतिस्पर्धा कर सकते हैं। Fable 5 और GPT-5.6 Sol Max के ख़िलाफ़ OSWorld-Verified और PaperBench में शीर्ष पर पहुँचना, और $2/$6 की कीमत पर सेल्फ-होस्टेबल मॉडल देना—यह पूरी मालिकाना श्रेणी पर प्रति एजेंटिक टास्क लागत के लिहाज़ से दबाव बनाता है।
चेतावनियाँ वास्तविक हैं। 16-दिन का स्वायत्त कोडिंग रन और 5-दिन का रिसर्च पुनरुत्पादन वेंडर शोकेस हैं, स्वतंत्र पुनरुत्पादन नहीं, और अगले हफ्ते आने वाले वेट्स का लाइसेंस अब भी अज्ञात है। r/LocalLLaMA पर अधिक रोचक बहस छोटे Qwen3.8-27B को लेकर थी—कई कमेंटर्स एक सिंगल कंज्यूमर GPU पर इंटेलिजेंस समेटने को लेकर ज़्यादा उत्साहित दिखे, बजाय 2.4T दैत्य के, जिसे केवल कुछ सेटअप्स ही चला सकते हैं।
मेरा मत: यदि आप ऐसे एजेंट बना रहे हैं जो वास्तविक इंटरफ़ेसेज़ ऑपरेट करते हैं या रिसर्च पाइपलाइंस पुन: उत्पन्न करते हैं, तो Qwen3.8-Max गंभीर परीक्षण के लायक है—खासतौर पर जब वेट्स आएँ और आप सेल्फ-होस्ट कर सकें। यदि आपका काम शुद्ध प्रोफ़ेशनल सॉफ़्टवेयर इंजीनियरिंग है, कठिन GitHub इश्यूज़ पर, तो Fable 5 अब भी SWE-bench Pro में आगे है—इसलिए कमिट करने से पहले दोनों चलाएँ।
यदि आप ऐसे मॉडलों के साथ उनकी APIs के ज़रिये काम करने में सहज होना चाहते हैं, तो मैं हमारी AI Fundamentals स्किल ट्रैक की सिफारिश करता हूँ, ताकि पहले बुनियादें मजबूत हों।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
लर्निंग पाथ