कोर्स
Google Gemini और NotebookLM के साथ प्रैक्टिकल AI
2 घंटा
9.8K
Gemma 4 Google DeepMind का ओपन-वेट्स मॉडल परिवार है, जिसे लोकल डिप्लॉयमेंट और शोध—दोनों के लिए डिज़ाइन किया गया है। यह Gemma वंश पर आधारित है, जिसमें बेहतर निर्देश-अनुसरण, लंबी कॉन्टेक्स्ट विंडो, और नेटिव मल्टीमॉडल इनपुट हैंडलिंग शामिल है, और यह Gemini 3 के समान रिसर्च इन्फ्रास्ट्रक्चर से बना है।
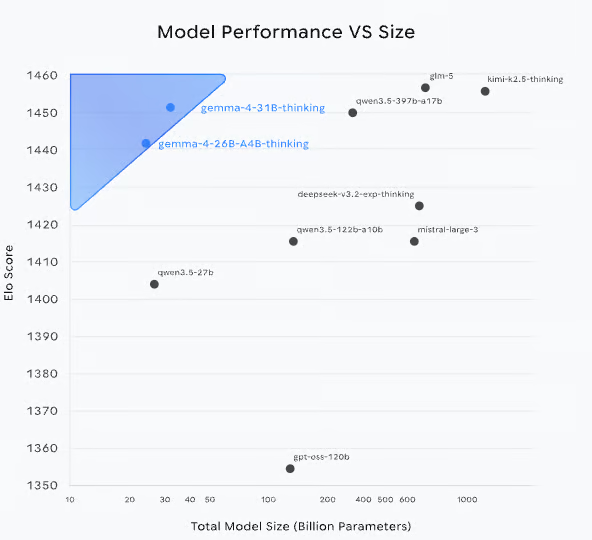
चित्र: मॉडल परफॉर्मेंस बनाम आकार (स्रोत: Gemma 4 ब्लॉग)
Gemma-4-26B(MOE) और Gemma-4-31B जैसे मॉडल बहुत बड़े मॉडलों के तुल्य Elo स्कोर प्राप्त करते हैं, जो प्रति-पैरामीटर मजबूत प्रदर्शन का संकेत है। 31B मॉडल वर्तमान में Arena AI टेक्स्ट लीडरबोर्ड पर दुनिया का तीसरा ओपन मॉडल रैंक करता है, और 26B मॉडल छठे स्थान पर है। यह Gemma 4 को क्षमता से समझौता किए बिना लोकल और संसाधन-सीमित डिप्लॉयमेंट के लिए विशेष रूप से उपयुक्त बनाता है।
Gemma 4 चार बहुमुखी आकारों में जारी किया गया है: Effective 2B (E2B), Effective 4B (E4B), 26B Mixture of Experts (MoE), और 31B Dense मॉडल। डिप्लॉयमेंट लक्ष्य के आधार पर परिवार दो स्तरों में बाँटा गया है:
|
मॉडल |
आर्किटेक्चर |
कुल पैरामीटर्स |
सक्रिय/प्रभावी पैरामीटर्स |
कॉन्टेक्स्ट लंबाई |
मोडैलिटीज़ |
|
Gemma-4-31B |
डेंस ट्रांसफॉर्मर |
31B |
31B |
256K टोकन |
टेक्स्ट, विज़न, वीडियो |
|
Gemma-4-26B-A4B |
MoE (128 एक्सपर्ट्स) |
26B |
3.8B सक्रिय |
256K टोकन |
टेक्स्ट, विज़न, वीडियो |
|
Gemma-4-E4B |
डेंस ट्रांसफॉर्मर |
7.9B (एंबेडिंग सहित) |
4.5B प्रभावी |
128K टोकन |
टेक्स्ट, ऑडियो, विज़न, वीडियो |
|
Gemma-4-E2B |
डेंस ट्रांसफॉर्मर |
5.1B (एंबेडिंग सहित) |
2.3B प्रभावी |
128K टोकन |
टेक्स्ट, ऑडियो, विज़न, वीडियो |
आइए प्रत्येक वैरिएंट को विस्तार से समझें:
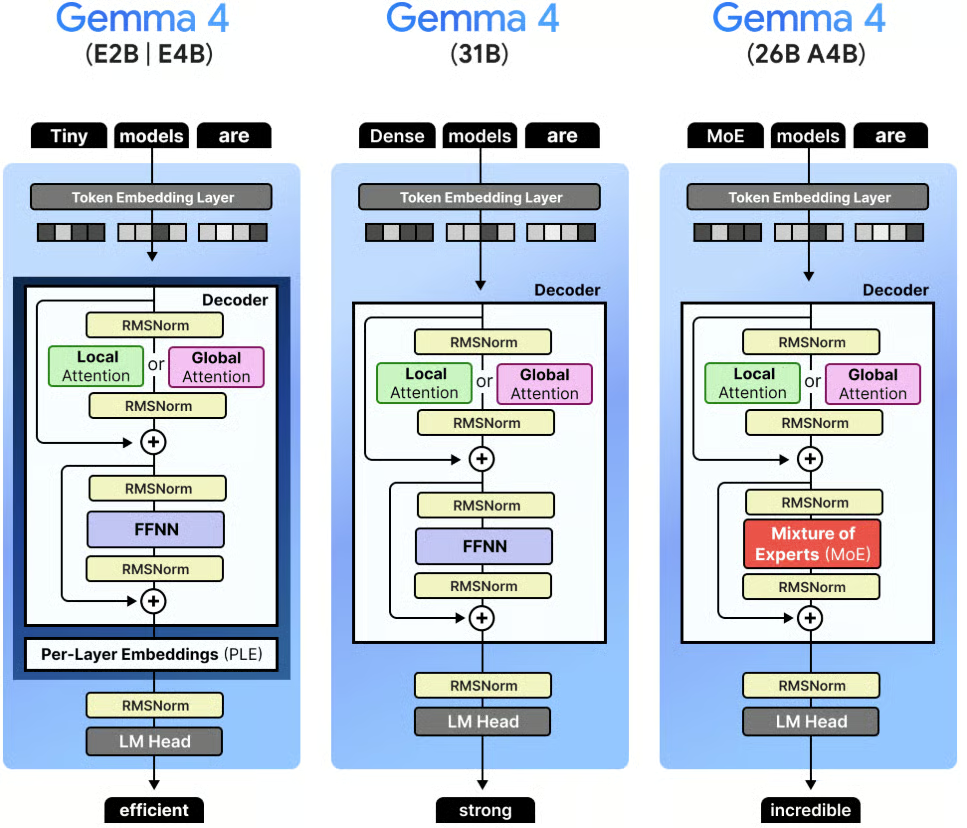
चित्र: Gemma 4 का दृश्य मार्गदर्शक (स्रोत)
सभी चार मॉडल Apache 2.0 लाइसेंस के अंतर्गत उपलब्ध हैं और Ollama, vLLM, llama.cpp, या Unsloth के माध्यम से लोकल रूप से डिप्लॉय किए जा सकते हैं।
कोडिंग कार्यों के लिए, Gemma 4 इन बातों में उत्कृष्ट है:
इस ट्यूटोरियल में, हम Ollama के माध्यम से gemma4:e4b (9.6GB) वैरिएंट का उपयोग करते हैं, जो एक क्वांटाइज़्ड संस्करण है और कंज्यूमर हार्डवेयर पर लोकल इन्फ्रेंस के लिए उपयुक्त है।
Ollama मॉडल डाउनलोडिंग, क्वांटाइज़ेशन, सर्विंग संभालता है और एक OpenAI-संगत HTTP API प्रदान करता है। इस ट्यूटोरियल में, Ollama इन्फ्रेंस बैकएंड के रूप में काम करता है, और हमारा ऐप localhost:11434 पर उससे संचार करता है।
मॉडल पुल और रन करने के लिए:
curl -fsSL https://ollama.com/install.sh | sh
ollama pull gemma4:e4b
ollama serve
ऊपर दिए गए कमांड आधिकारिक इंस्टॉल स्क्रिप्ट का उपयोग करके लोकल रूप से Ollama इंस्टॉल करते हैं। फिर हम ऑन-डिवाइस इन्फ्रेंस के लिए gemma 4:e4b मॉडल वैरिएंट डाउनलोड करते हैं। अंत में, ollama serve Ollama सर्वर शुरू करता है, जिससे हमारा ऐप मॉडल को रिक्वेस्ट भेज सके।
सर्वर चलने के बाद, Gradio ऐप उससे स्वतः कनेक्ट हो जाता है।
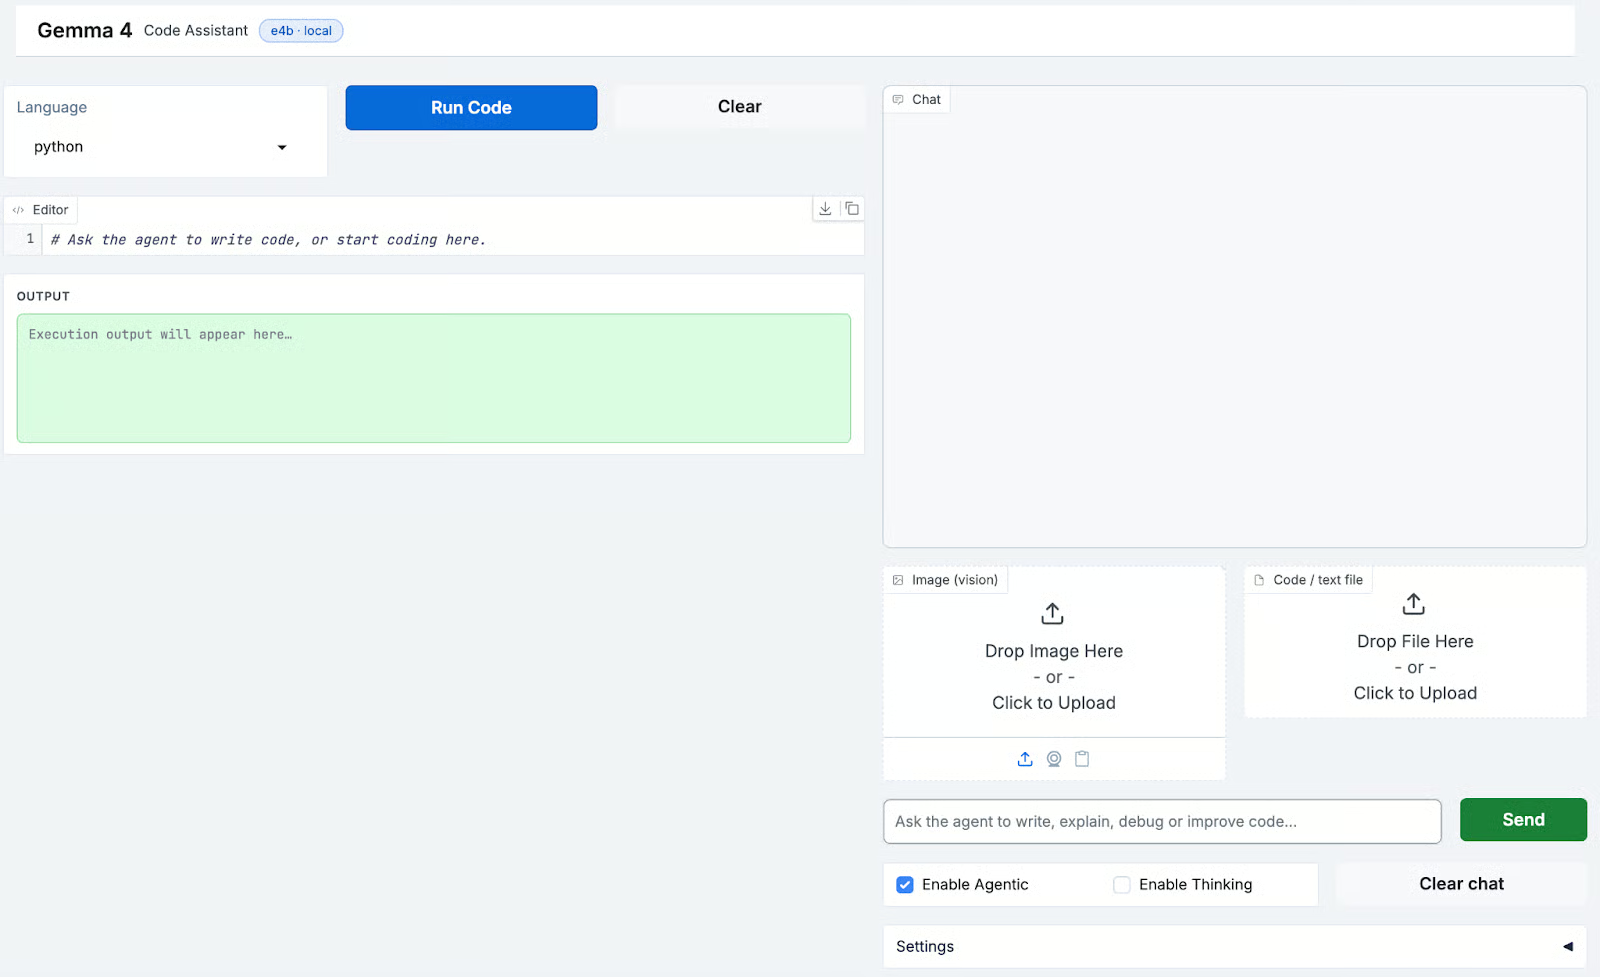
इस खंड में, हम चरण-दर-चरण कोड असिस्टेंट बनाएँगे। उच्च स्तर पर, ऐप यह करता है:
चैट पैनल में प्राकृतिक-भाषा संदेश स्वीकार करता है, वैकल्पिक इमेज या फ़ाइल अटैचमेंट्स के साथ
मॉडल के लिए वर्तमान एडिटर कोड को संदर्भ के रूप में इंजेक्ट करता है
Ollama के /api/chat एन्डपॉइंट के माध्यम से Gemma 4 को एक स्ट्रीमिंग रिक्वेस्ट भेजता है
एजेंटिक लूप में वैकल्पिक रूप से टूल्स (कोड एक्ज़ीक्यूशन, गणित मूल्यांकन) कॉल करता है
प्रतिक्रिया से निकाले गए कोड ब्लॉक्स को लाइव एडिटर में पुश करता है
आइए इसे चरण-दर-चरण बनाते हैं।
ऐप को UI, इमेज हैंडलिंग, और HTTP कम्युनिकेशन के लिए कुछ लाइब्रेरीज़ की आवश्यकता होती है। चूँकि मॉडल Ollama के माध्यम से लोकल चलता है, कोई क्लाउड SDK निर्भरताएँ नहीं हैं।
pip install gradio requests pillowइस प्रोजेक्ट में, हम उपयोग करेंगे:
gradio स्प्लिट-पैन एडिटर और चैट UI के लिए
requests Ollama HTTP API से संचार करने के लिए
pillow UI में इमेज हैंडलिंग सपोर्ट के लिए
यह वातावरण को हल्का रखता है और किसी भी मशीन पर काम करता है जो Ollama चला रही है—macOS (Apple Silicon), Linux, और WSL के माध्यम से Windows सहित।
किसी भी लॉजिक से पहले, हम इम्पोर्ट्स, मॉडल का नाम, Ollama बेस URL, समर्थित भाषाएँ, और एक डिफ़ॉल्ट सिस्टम प्रॉम्प्ट परिभाषित करते हैं। ये कॉन्स्टेंट्स पूरे ऐप के व्यवहार को नियंत्रित करते हैं।
import base64
import json
import math
import os
import re
import subprocess
import tempfile
from pathlib import Path
import gradio as gr
import requests

OLLAMA_BASE = "http://localhost:11434"
MODEL       = "gemma4:e4b"
LANGUAGES = [
    "python", "javascript", "typescript", "bash", "sql",
    "rust", "go", "java", "c", "cpp", "html", "css",
    "json", "yaml", "markdown", "plaintext",
]
TEXT_EXTS = {
    ".py", ".js", ".ts", ".jsx", ".tsx", ".html", ".css",
    ".json", ".yaml", ".yml", ".toml", ".md", ".txt",
    ".csv", ".sql", ".sh", ".bash", ".rs", ".go",
    ".java", ".c", ".cpp", ".h", ".hpp", ".rb", ".php",
}
IMAGE_EXTS = {".jpg", ".jpeg", ".png", ".webp", ".gif", ".bmp"}
DEFAULT_SYSTEM = """\
You are an expert coding assistant. When you write code:
- Always wrap it in a markdown code block with the language tag
- Write complete, working code — not fragments
- Briefly explain what the code does
You have a code-runner tool. Use it to validate logic when helpful.\
"""
TEXT_EXTS और IMAGE_EXTS सेट दो अलग-अलग अटैचमेंट व्यवहारों को नियंत्रित करते हैं। टेक्स्ट/कोड फ़ाइलें पढ़कर प्रॉम्प्ट में संदर्भ के रूप में इंजेक्ट की जाती हैं, जबकि इमेज फ़ाइलों को base64-एन्कोड करके Gemma 4 की विज़न क्षमताओं के लिए images फ़ील्ड में भेजा जाता है।
DEFAULT_SYSTEM प्रॉम्प्ट मॉडल की कोड जनरेशन शैली को आकार देता है, खासतौर पर भाषा टैग्स के साथ संपूर्ण कोड ब्लॉक्स माँगते हुए, क्योंकि ऐप इन्हें पार्स करके एडिटर में कोड पुश करता है।
असिस्टेंट एजेंटिक मोड में काम कर सकता है, जहाँ वह इन्फ्रेंस के दौरान टूल्स कॉल करता है। हम दो टूल्स को उस मानक फ़ंक्शन-कॉलिंग स्कीमा में परिभाषित करते हैं जिसे Ollama सपोर्ट करता है:
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "run_code",
            "description": (
                "Execute Python code in a sandboxed subprocess and return "
                "stdout + stderr. Use this to validate, test, or demonstrate code."
            ),
            "parameters": {
                "type": "object",
                "properties": {
                    "code": {
                        "type": "string",
                        "description": "Python code to run (max ~50 lines, 5 s timeout).",
                    }
                },
                "required": ["code"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "calculate",
            "description": "Evaluate a mathematical expression precisely.",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {
                        "type": "string",
                        "description": "Python-compatible math expression, e.g. 'math.sqrt(2) * 100'",
                    }
                },
                "required": ["expression"],
            },
        },
    },
]
उपरोक्त कोड स्निपेट run_code टूल परिभाषित करता है, जो 5-सेकंड टाइमआउट के साथ एक अस्थायी फ़ाइल में सबप्रोसेस के जरिए Python चलाता है और stdout तथा stderr दोनों कैप्चर करता है। यह मॉडल को लॉजिक वेलिडेट करने, उदाहरण चलाने, या स्थिर टेक्स्ट से आगे बढ़कर लाइव आउटपुट देने में सक्षम बनाता है।
वहीं, calculate टूल प्रतिबंधित नेमस्पेस में केवल math मॉड्यूल और सुरक्षित बिल्ट-इन्स का उपयोग करके गणितीय अभिव्यक्तियों का मूल्यांकन करता है। जब मॉडल को सटीक संख्यात्मक परिणाम चाहिए होते हैं और पूर्ण Python प्रोसेस स्पिन-अप नहीं करना होता, तब यह सहायक होता है।
निष्पादन लेयर टूल नामों को उनकी इम्प्लीमेंटेशंस से मैप करती है। एजेंटिक लूप के दौरान जब भी मॉडल tool_calls ब्लॉक लौटाता है, तब इसे कॉल किया जाता है।
def _run_python(code: str) -> str:
    with tempfile.NamedTemporaryFile(mode="w", suffix=".py", delete=False) as f:
        f.write(code)
        tmp = f.name
    try:
        r = subprocess.run(
            ["python3", tmp],
            capture_output=True, text=True, timeout=5,
        )
        out = (r.stdout + r.stderr).strip()
        return out[:3000] if out else "(no output)"
    except subprocess.TimeoutExpired:
        return "⏱ Timed out (>5 s)"
    except Exception as e:
        return f"Error: {e}"
    finally:
        os.unlink(tmp)

def _calculate(expr: str) -> str:
    ns = {k: getattr(math, k) for k in dir(math) if not k.startswith("_")}
    ns.update({"abs": abs, "round": round})
    try:
        return str(eval(expr, {"__builtins__": {}}, ns))  # noqa: S307
    except Exception as e:
        return f"Error: {e}"

def execute_tool(name: str, args: dict) -> str:
    if name == "run_code":
        return _run_python(args.get("code", ""))
    if name == "calculate":
        return _calculate(args.get("expression", ""))
    return f"Unknown tool: {name}"
टूल निष्पादन स्टैक में कुछ सुरक्षा-संबंधी डिज़ाइन विकल्प उल्लेखनीय हैं:
_run_python() फ़ंक्शन अस्थायी फ़ाइल में लिखता है और उसे साफ कर देता है, जिससे त्रुटि पर भी फाइलें नहीं छूटतीं
आउटपुट 3,000 अक्षरों तक सीमित है ताकि बड़े प्रिंट डंप्स से संदर्भ न भर जाए
_calculate() फ़ंक्शन eval() का उपयोग __builtins__ को खाली डिक्शनरी पर सेट करके करता है, जिससे स्पष्ट रूप से अलाउलिस्टेड math फ़ंक्शंस के बाहर किसी भी Python बिल्ट-इन तक पहुँच रोकी जाती है
टाइमआउट सख्त 5-सेकंड की विंडो है—अधिकांश वेलिडेशन कार्यों के लिए पर्याप्त और रनअवे प्रोसेसेज़ को रोकने के लिए छोटा
कोर चैट लॉजिक बनाने से पहले, हमें कुछ यूटिलिटी फ़ंक्शंस चाहिए जो फ़ाइल पाथ, इमेज एन्कोडिंग, और कोड एक्सट्रैक्शन संभालें। ये हेल्पर फ़ंक्शंस स्ट्रीमिंग पाइपलाइन में लगातार कॉल होते हैं।
def encode_image(path: str) -> str | None:
    if not path:
        return None
    try:
        with open(path, "rb") as f:
            return base64.b64encode(f.read()).decode()
    except Exception:
        return None

def file_as_context(path: str) -> str | None:
    if not path:
        return None
    p = Path(path)
    if p.suffix.lower() not in TEXT_EXTS:
        return None
    try:
        content = p.read_text(encoding="utf-8", errors="replace")[:8000]
        lang = p.suffix.lstrip(".")
        return f"\n\n**Attached file — {p.name}:**\n```{lang}\n{content}\n```"
    except Exception:
        return None

def resolve_gradio_path(val) -> str | None:
    if val is None:
        return None
    if isinstance(val, Path):
        s = str(val)
        return s if s.strip() else None
    if isinstance(val, str):
        s = val.strip()
        return s if s else None
    if isinstance(val, dict):
        p = val.get("path")
        if isinstance(p, str) and p.strip():
            return p.strip()
        nested = val.get("file")
        if isinstance(nested, dict):
            np = nested.get("path")
            if isinstance(np, str) and np.strip():
                return np.strip()
        return None
    name = getattr(val, "name", None)
    if isinstance(name, str) and name.strip():
        return name.strip()
    return None

def is_image_path(path: str | None) -> bool:
    return bool(path) and Path(path).suffix.lower() in IMAGE_EXTS

def extract_last_code_block(text: str) -> tuple[str | None, str]:
    blocks = re.findall(r"```(\w*)\n(.*?)```", text, re.DOTALL)
    if blocks:
        lang, code = blocks[-1]
        return code.strip(), lang.strip() or "python"
    return None, "python"

def ollama_ok() -> bool:
    try:
        requests.get(f"{OLLAMA_BASE}/", timeout=2)
        return True
    except Exception:
        return False

def _gradio_content_to_text(content) -> str:
    if content is None:
        return ""
    if isinstance(content, str):
        return content
    if isinstance(content, list):
        parts: list[str] = []
        for block in content:
            if isinstance(block, dict):
                if block.get("type") == "text":
                    parts.append(str(block.get("text", "")))
                elif "text" in block:
                    parts.append(str(block["text"]))
            elif isinstance(block, str):
                parts.append(block)
        return "".join(parts)
    return str(content)

def _append_chat_turn(
    history: list | None, user_text: str, assistant_text: str
) -> list:
    base = list(history) if history else []
    return base + [
        {"role": "user", "content": user_text},
        {"role": "assistant", "content": assistant_text},
    ]

def run_code_btn(code: str) -> str:
    if not code.strip():
        return "Nothing to run."
    result = _run_python(code)
    return result
ये यूटिलिटीज़ मल्टीमॉडल इनपुट और स्ट्रक्चर्ड आउटपुट्स के सुचारू हैंडलिंग को सक्षम करती हैं:
encode_image() फ़ंक्शन: यह फ़ंक्शन इमेज फ़ाइल को base64 स्ट्रिंग में बदलता है ताकि उसे Ollama के images फ़ील्ड में पास किया जा सके। इससे Gemma टेक्स्ट के साथ इमेज पर भी मल्टीमॉडल रीजनिंग कर पाता है।
file_as_context() फ़ंक्शन: यह टेक्स्ट/कोड फ़ाइलें पढ़कर उन्हें सीधे प्रॉम्प्ट में फ़ॉर्मैटेड मार्कडाउन ब्लॉक के रूप में इंजेक्ट करता है। इससे एक अलग रिट्रीवल सिस्टम की ज़रूरत नहीं पड़ती क्योंकि सब कुछ इनलाइन संदर्भ के रूप में पास होता है।
resolve_gradio_path() फ़ंक्शन: यह फ़ंक्शन Gradio द्वारा लौटाए गए अलग-अलग फ़ाइल फ़ॉर्मैट्स को एक उपयोगी फ़ाइल पाथ में सामान्यीकृत करता है। इससे फ़ाइल हैंडलिंग में एज-केस बग्स रोके जाते हैं।
is_image_path() फ़ंक्शन: यह यह जाँचने का त्वरित तरीका है कि कोई दी गई फ़ाइल इमेज है या नहीं। इससे इमेज इनपुट्स को सही ढंग से रूट करने में मदद मिलती है।
extract_last_code_block() फ़ंक्शन: इसके बाद, हम मॉडल की प्रतिक्रिया से अंतिम कोड ब्लॉक निकालते हैं।
ollama_ok() फ़ंक्शन: रिक्वेस्ट करने से पहले हम जाँचते हैं कि लोकल Ollama सर्वर चल रहा है या नहीं।
_gradio_content_to_text() और _append_chat_turn() फ़ंक्शंस: हम Gradio के स्ट्रक्चर्ड मैसेज फ़ॉर्मैट को फ्लैट टेक्स्ट में बदलते हैं ताकि प्रोसेसिंग सुसंगत रहे और चैट हिस्ट्री बनाए रखें।
run_code_btn() फ़ंक्शन: अंततः, जब उपयोगकर्ता UI में Run code बटन दबाता है, तो हम इस फ़ंक्शन से जेनरेट किया गया कोड चलाते हैं।
अब जबकि हमारे हेल्पर यूटिलिटीज़ तैयार हैं, हम कोर chat() फ़ंक्शन लागू कर सकते हैं।
यह फ़ंक्शन पूरी इंटरैक्शन लूप को संचालित करता है—इनपुट तैयार करने से लेकर प्रतिक्रियाएँ स्ट्रीम करने और टूल निष्पादन संभालने तक।
उच्च स्तर पर, chat() फ़ंक्शन:
def chat(
    message, history, image_path, file_path,
    editor_code, language, system_prompt,
    agentic, thinking, temperature,
):
फ़ंक्शन निम्नलिखित चरणानुक्रम का पालन करता है:
हम पिछली चैटबॉट टर्न्स को Ollama के संदेश फ़ॉर्मैट में बदलते हैं। मॉडल के व्यवहार को निर्देशित करने के लिए सिस्टम प्रॉम्प्ट पहले जोड़ा जाता है, जिससे प्रतिक्रिया बनाने से पहले मॉडल के पास पूरा वार्तालाप संदर्भ होता है।
for h in history or []:
        if not isinstance(h, dict):
            continue
        role = h.get("role")
        if role not in ("user", "assistant"):
            continue
        messages.append(
            {"role": role, "content": _gradio_content_to_text(h.get("content"))}
        )
content = messageअब हम अतिरिक्त संदर्भ इंजेक्ट करके वर्तमान यूज़र संदेश बनाते हैं। यदि उपयोगकर्ता कोड पर काम कर रहा है, तो हम एडिटर की सामग्री जोड़ते हैं:
if editor_code.strip() and editor_code.strip() != STARTER_CODE.strip():
    content += (
        f"\n\n**Current code in editor ({language}):**\n"
        f"```{language}\n{editor_code}\n```"
    )
इसी तरह, अपलोड की गई फ़ाइलें इनलाइन संदर्भ के रूप में जोड़ी जाती हैं और इमेजेज़ को base64-एन्कोड करके images फ़ील्ड के माध्यम से पास किया जाता है। इससे मॉडल टेक्स्ट, कोड, और इमेज—इन सब पर साथ में तर्क कर सकता है।
पेलोड में मॉडल का नाम, संदेश इतिहास, स्ट्रीमिंग फ़्लैग, और विकल्प शामिल होते हैं:
payload = {
    "model": MODEL,
    "messages": messages,
    "stream": True,
    "options": options,
}

if agentic:
    payload["tools"] = TOOLS
यदि थिंकिंग मोड सक्षम है, तो options["think"] = True सेट किया जाता है, जो समर्थित मॉडलों में विस्तारित चेन-ऑफ-थॉट रीजनिंग सक्रिय करता है।
यदि एजेंटिक मोड सक्षम है, तो मॉडल टेक्स्ट के बजाय टूल कॉल्स लौटा सकता है। हर टूल के निष्पादन के बाद उसके परिणाम वार्तालाप में जोड़ दिए जाते हैं। फिर, जनरेशन जारी रखने के लिए एक फॉलो-अप रिक्वेस्ट भेजा जाता है।
if agentic and msg.get("tool_calls"):
    for tc in msg["tool_calls"]:
        fn_name = tc["function"]["name"]
        fn_args = tc["function"]["arguments"]
        result = execute_tool(fn_name, fn_args)
        if fn_name == "run_code" and fn_args.get("code"):
            new_code = fn_args["code"]
        messages.append(msg)
        messages.append({"role": "tool", "content": result})
    resp2 = requests.post(f"{OLLAMA_BASE}/api/chat", ...)
यह एक सिंगल-टर्न एजेंटिक लूप बनाता है, जहाँ मॉडल टूल कॉल करता है, परिणाम देखता है, और फिर अंतिम प्रतिक्रिया जनरेट करना जारी रखता है। टूल कॉल लॉग्स उपयोगकर्ता के लिए चैट में पहले जोड़े जाते हैं।
अंततः, स्ट्रीमिंग पूर्ण होने के बाद, हम प्रतिक्रिया से अंतिम कोड ब्लॉक निकालते हैं:
extracted, _ = extract_last_code_block(full_response)

if extracted:
    new_code = extracted
कुल मिलाकर, मॉडल कोड जनरेट करता है, एडिटर अपने-आप अपडेट होता है और किसी मैन्युअल कॉपी-पेस्ट की ज़रूरत नहीं रहती।
कोर लॉजिक तैयार होने के साथ, अब हम Gradio का उपयोग करके यूज़र इंटरफ़ेस डिज़ाइन करते हैं। लक्ष्य ऐसा लेआउट बनाना है जो कोडिंग वर्कफ़्लो और AI-समर्थित इंटरैक्शन दोनों को साथ-साथ सपोर्ट करे।
हम gr.Blocks का उपयोग करके दो-स्तंभ लेआउट परिभाषित करते हैं:
with gr.Blocks(title="Gemma 4 · Code Assistant") as demo:
    with gr.Row(equal_height=False):
        # LEFT: Code Editor
        with gr.Column(scale=11):
            with gr.Row():
                lang_sel = gr.Dropdown(choices=LANGUAGES, value="python", label="Language")
                run_btn  = gr.Button("Run Code", elem_classes=["run-btn"])
                clear_ed = gr.Button("Clear")
            code_editor = gr.Code(
                value=STARTER_CODE,
                language="python",
                label="Editor",
                lines=24,
                interactive=True,
            )
            run_output = gr.Textbox(
                label="Output",
                lines=6,
                interactive=False,
                elem_id="run-output",
            )
        # RIGHT: Chat
        with gr.Column(scale=9):
            chatbot = gr.Chatbot(value=[], elem_id="chatbot", height=430)
            with gr.Row():
                image_upload = gr.Image(label="Image (vision)", type="filepath")
                file_upload  = gr.File(label="Code / text file")
            with gr.Row():
                msg_input = gr.Textbox(placeholder="Ask the agent...", scale=6)
                send_btn  = gr.Button("Send", variant="primary")
            with gr.Row():
                agentic_cb  = gr.Checkbox(label="Enable Agentic", value=True)
                thinking_cb = gr.Checkbox(label="Enable Thinking", value=False)
                clear_chat  = gr.Button("Clear chat")
            with gr.Accordion("Settings", open=False):
                sys_prompt  = gr.Textbox(value=DEFAULT_SYSTEM, label="System prompt")
                temperature = gr.Slider(minimum=0.0, maximum=2.0, value=0.7)
आइए समझें कि UI ऊपर बताए गए सभी घटकों के साथ मिलकर कैसे काम करता है:
Send और Submit इवेंट्स समान इनपुट्स और आउटपुट्स साझा करते हैं, इसलिए बटन क्लिक और टेक्स्ट बॉक्स में Enter दबाने—दोनों से समान व्यवहार ट्रिगर होता है:
_inputs = [
    msg_input, chatbot, image_upload, file_upload,
    code_editor, lang_sel,
    sys_prompt, agentic_cb, thinking_cb, temperature,
]
_outputs = [chatbot, code_editor, msg_input]
send_btn.click(fn=respond, inputs=_inputs, outputs=_outputs)
msg_input.submit(fn=respond, inputs=_inputs, outputs=_outputs)
respond() रैपर यहाँ Gradio फ़ाइल पाथ ऑब्जेक्ट्स को साधारण फ़ाइल पाथ स्ट्रिंग्स में बदल देता है, उन्हें स्ट्रीमिंग जनरेटर में पास करने से पहले। फिर यह हर चंक पर (history, code, "") यील्ड करता है ताकि खाली स्ट्रिंग पहले यील्ड पर मैसेज इनपुट को क्लियर कर दे।
उपयोगिता और दृश्य स्थिरता सुधारने के लिए, हम Gradio की डिफ़ॉल्ट स्टाइलिंग के ऊपर कस्टम थीम और CSS लेयर जोड़ते हैं। इससे ऐप को एक परिष्कृत, GitHub-प्रेरित लुक मिलता है, जिसमें लाइट और डार्क—दोनों मोड्स का सपोर्ट है। यह पूरी तरह वैकल्पिक है।
हम gr.themes.Base का उपयोग करके एक बेस थीम परिभाषित करने से शुरू करते हैं:
THEME = gr.themes.Base(
    primary_hue   = "blue",
    secondary_hue = "slate",
    neutral_hue   = "slate",
    font      = [gr.themes.GoogleFont("Inter"), "system-ui", "sans-serif"],
    font_mono = [gr.themes.GoogleFont("JetBrains Mono"), "monospace"],
)
यह एक सुसंगत रंग-पैलेट और स्वच्छ UI टाइपोग्राफी (Inter) सेट करता है, डेवलपर-फ्रेंडली मोनोस्पेस फ़ॉन्ट (JetBrains Mono) के साथ। अगला, हम ऐप की उपस्थिति नियंत्रित करने के लिए प्रमुख CSS वेरिएबल्स ओवरराइड करते हैं:
gradio-app {
    --body-background-fill:   #f0f3f7;
    --block-background-fill:  #ffffff;
    --body-text-color:        #1f2328;
    --button-primary-background-fill: #1a7f37;
}

body.dark gradio-app {
    --body-background-fill:   #0d1117;
    --block-background-fill:  #1c2128;
    --body-text-color:        #e6edf3;
    --button-primary-background-fill: #238636;
}
यहाँ पहला ब्लॉक लाइट थीम परिभाषित करता है, जबकि दूसरा ब्लॉक डार्क मोड के लिए मानों को ओवरराइड करता है। यद्यपि यह चरण वैकल्पिक है, कस्टम थीमिंग और CSS जोड़ने से कुल मिलाकर उपयोगकर्ता अनुभव काफी बेहतर होता है।
अब UI पूरी तरह स्ट्रक्चर्ड और स्टाइल्ड है, हम अंतिम चरण—एप्लिकेशन लॉन्च करने—के लिए तैयार हैं।
अंत में, ऐप इस तरह लॉन्च किया जाता है:
if __name__ == "__main__":
    print(f"Model  : {MODEL}")
    print(f"Ollama : {OLLAMA_BASE}")
    if not ollama_ok():
        print("Ollama not detected — run ollama serve before chatting")
    demo.launch(
        server_name="0.0.0.0",
        server_port=7860,
        share=False,
        theme=THEME,
        css=CSS,
    )
यहाँ, server_name="0.0.0.0" ऐप को आपके लोकल नेटवर्क पर सुलभ बनाता है और share=False सेट करने से सब कुछ लोकल ही रहता है। ollama_ok() जाँच localhost:11434 पर एक त्वरित GET रिक्वेस्ट करती है और स्टार्टअप पर चेतावनी देती है यदि Ollama नहीं चल रहा, ताकि त्रुटि उपयोगकर्ता की पहली मैसेज सबमिशन पर ही सामने न आए।
अंत में, ऐप चलने के बाद http://localhost:7860 पर जाएँ।
उपयोगकर्ता के नज़रिये से पूरा एक्ज़ीक्यूशन फ्लो इस प्रकार है:
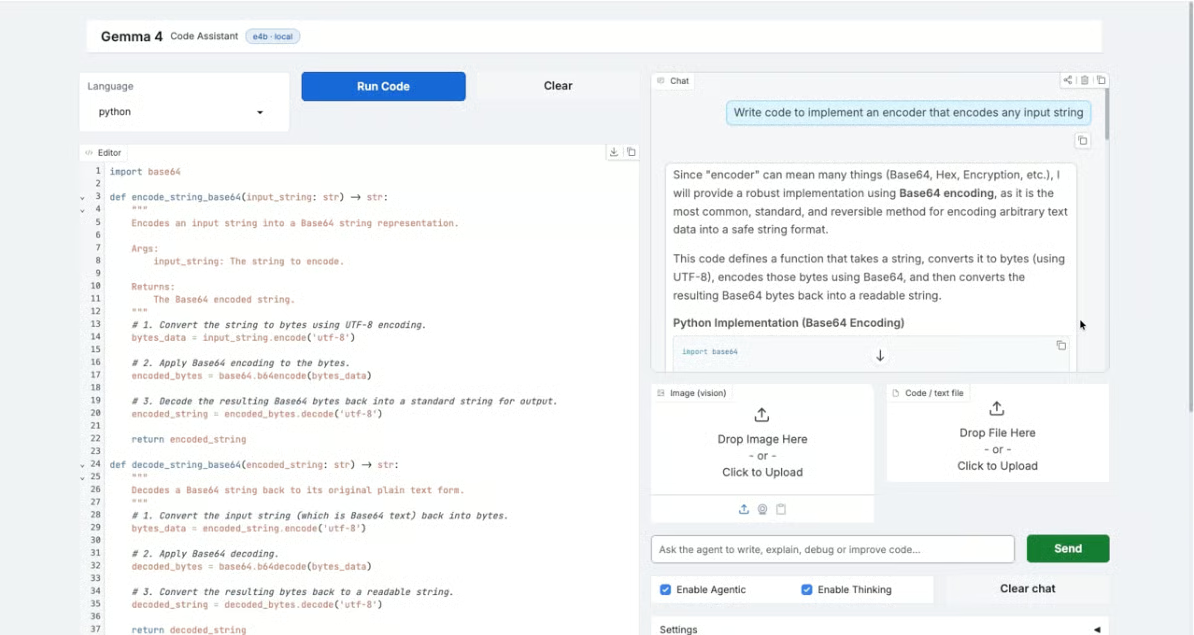
उपयोगकर्ता चैट पैनल में संदेश टाइप करता है, वैकल्पिक रूप से इमेज या कोड फ़ाइल अपलोड करता है और एजेंटिक/थिंकिंग मोड टॉगल करता है
सबमिट पर, respond() फ़ंक्शन पूरा Ollama रिक्वेस्ट बनाता है, जिसमें एडिटर का मौजूदा कोड और कोई भी अटैचमेंट संदर्भ के रूप में शामिल होते हैं
रिक्वेस्ट टोकन-बाय-टोकन स्ट्रीम होती है और आंशिक प्रतिक्रियाएँ लाइव रेंडरिंग के लिए Gradio चैटबॉट को यील्ड की जाती हैं
यदि एजेंटिक मोड चालू है और मॉडल टूल कॉल करने का निर्णय लेता है, तो टूल लोकल रूप से चलता है, परिणाम वार्तालाप में जोड़े जाते हैं, और एक फॉलो-अप रिक्वेस्ट अंतिम उत्तर स्ट्रीम करता है
स्ट्रीमिंग पूर्ण होने के बाद, प्रतिक्रिया में अंतिम fenced कोड ब्लॉक निकाला जाता है और अपने-आप एडिटर में पुश किया जाता है
इस ट्यूटोरियल में, हमने Gemma 4, Ollama, और Gradio का उपयोग करके एक पूरी तरह लोकल AI कोडिंग असिस्टेंट बनाया। ऐप मल्टीमॉडल इनपुट, वास्तविक टूल उपयोग, स्ट्रीमिंग प्रतिक्रियाएँ, और लाइव कोड एडिटर सपोर्ट करता है—वह भी बिना किसी बाहरी API के, आपकी अपनी मशीन पर।
एडिटर के कोड को हर प्रॉम्प्ट में सीधे इंजेक्ट करने का "होल-कॉन्टेक्स्ट" तरीका, एक सिंगल-फ़ाइल वर्कफ़्लो के लिए RAG की तुलना में सरल है और उस समय विशेष रूप से अच्छा काम करता है जब आप जिस कोड को सक्रिय रूप से एडिट कर रहे हैं, उसे समझाना, रिफैक्टर करना, या बढ़ाना हो।
यहाँ से, आप प्रोजेक्ट को कई दिशाओं में आगे बढ़ा सकते हैं:
DataCamp के साथ सीखें
कोर्स
कोर्स
कोर्स