
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.5K
काफी समय हो गया है जब किसी नई कंपनी ने LLM दौड़ में एंट्री की हो। लेकिन 3 अक्टूबर को Aleph Alpha ने अपना नया मॉडल Kolibri 1 को Apache 2.0 लाइसेंस के तहत Hugging Face पर जारी किया और यूरोप से स्वायत्त AI को गंभीरता से लेने की अपील की।
प्रस्ताव यह है कि यूरोपीय सरकारें और कंपनियाँ किसी अमेरिकी प्रदाता के API पर निर्भर रहने के बजाय सक्षम मॉडल को अपने हार्डवेयर पर, यहाँ तक कि पूरी तरह ऑफलाइन, चला सकती हैं।
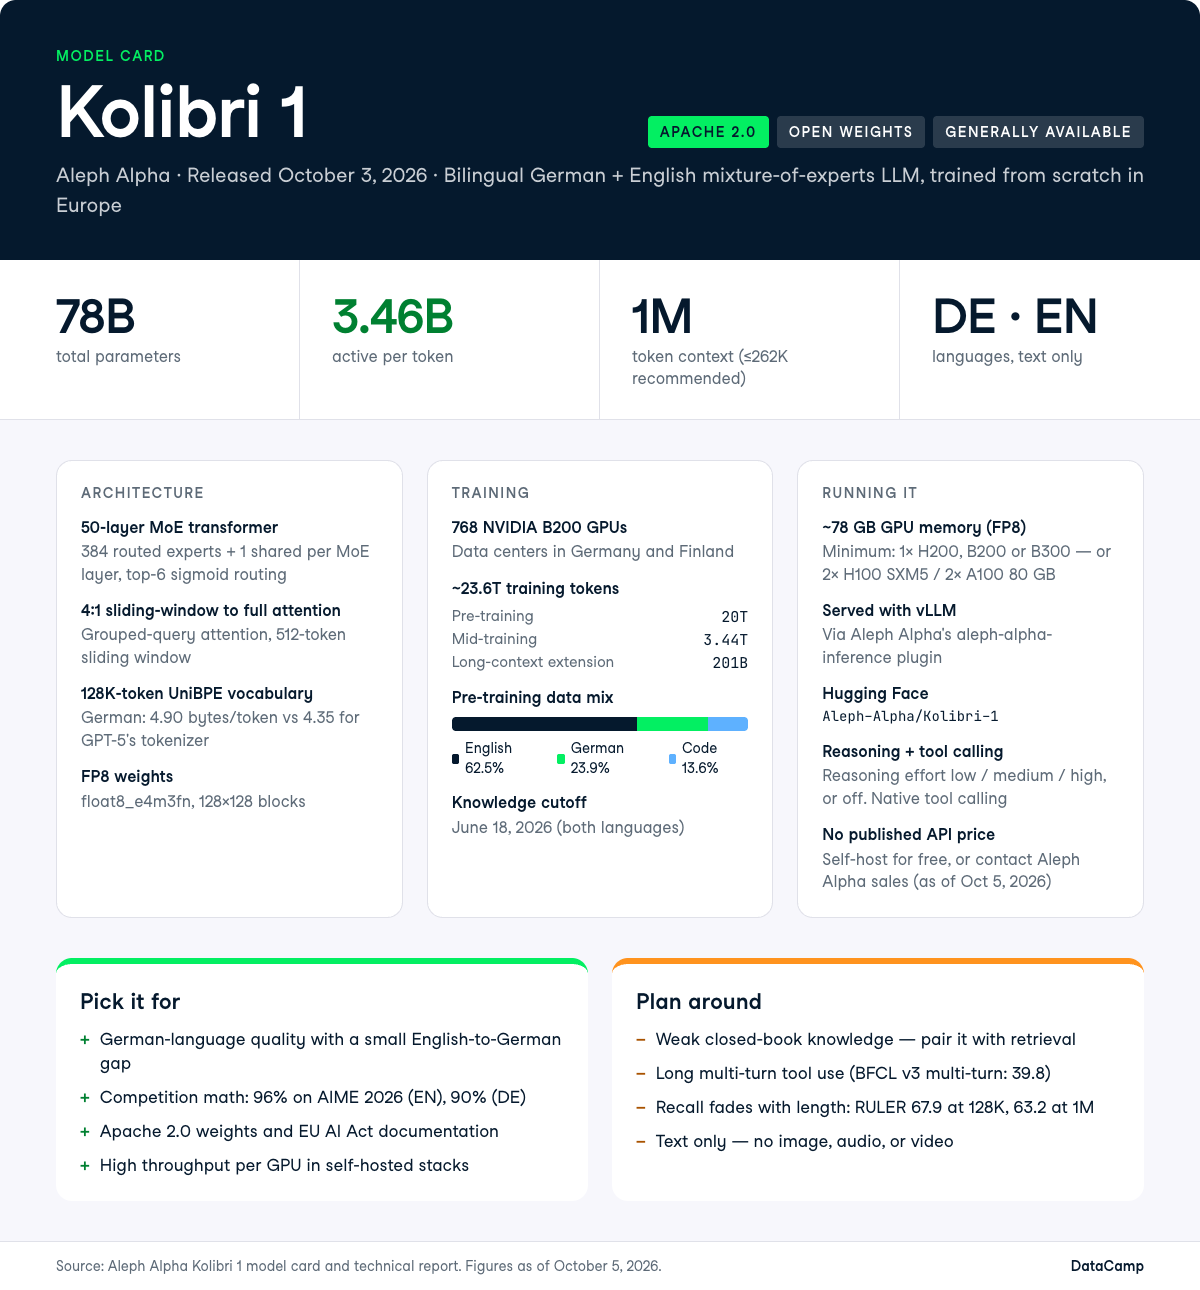
Kolibri 1 एक mixture-of-experts (MoE) मॉडल है जिसमें कुल 78B पैरामीटर्स हैं और प्रति टोकन 3.46B सक्रिय हैं, जिसे Aleph Alpha Research ने जर्मनी और फ़िनलैंड के डेटा सेंटर्स में 768 NVIDIA B200 GPUs पर शून्य से प्रशिक्षित किया है।
यह केवल जर्मन और अंग्रेज़ी को संभालता है, 1,048,576-टोकन का कॉन्टेक्स्ट विंडो सपोर्ट करता है (Aleph Alpha सेवा दक्षता के लिए 262,144 टोकन या उससे कम पर रहने की सिफारिश करता है), और प्रीव्यू के बजाय सामान्य उपलब्धता के रूप में शिप होता है। प्री-ट्रेनिंग में 20 ट्रिलियन टोकन शामिल थे, उसके बाद मिड-ट्रेनिंग में 3.44T और लोंग-कॉन्टेक्स्ट विस्तार के लिए 201B।
इस लेख में, मैं Kolibri 1 की नई बातें कवर करूँगा—मुख्य फीचर्स, बेंचमार्क्स की पड़ताल, और इसे सच में चलाने की लागत पर।
Kolibri 1, Aleph Alpha का विशेषीकृत द्विभाषी बड़ा भाषा मॉडल (LLM) है, 3 अक्टूबर, 2026 को Apache 2.0 के तहत जारी। यह एकल सामान्य रूप से उपलब्ध मॉडल है, इसके कोई छोटे या बड़े वेरिएंट नहीं हैं।
अंदर से, यह 50-लेयर का mixture-of-experts ट्रांसफ़ॉर्मर है।
हर लेयर में 384 छोटे विशेषज्ञ सब-नेटवर्क (एक्सपर्ट्स) हैं, और एक राउटर हर टोकन को केवल 6 के पास भेजता है, साथ ही 1 साझा एक्सपर्ट जो हमेशा चलता है। इसी तरह 78.1B कुल पैरामीटर्स प्रति टोकन 3.46B सक्रिय (लगभग 4.4%) तक सिमटते हैं, यानी मॉडल अधिकतम क्षमता के बजाय सस्ते सर्विंग के लिए बनाया गया है।
दो और डिज़ाइन विकल्प इसे तेज़ और मेमोरी पर हल्का रखते हैं:
Aleph Alpha जिस प्रमुख नतीजे को आगे रख रहा है, वह कच्ची क्षमता के बजाय दक्षता है।
Kolibri 1 अपने जर्मन बेंचमार्क सूट पर औसतन 71% स्कोर करता है, जबकि प्रति GPU लगभग 47,000 बाइट/सेकंड की दर से टेक्स्ट डिकोड करता है; Nemotron Super A12B के लिए यह 68% और लगभग 24,000 बाइट/सेकंड है।
मॉडल का नॉलेज कटऑफ़ 18 जून, 2026 है, दोनों भाषाओं के लिए, और यह केवल टेक्स्ट-आधारित है—छवि, ऑडियो, या वीडियो का इनपुट/आउटपुट नहीं।
यदि आप देखना चाहते हैं कि जर्मन क्षमता वास्तव में कहाँ से आती है, तो प्रकाशित डेटा मिक्स, एक ओपन-वेट रिलीज़ के लिए असामान्य रूप से पारदर्शी है।
| डोमेन | प्री-ट्रेनिंग | मिड-ट्रेनिंग | लोंग-कॉन्टेक्स्ट विस्तार |
|---|---|---|---|
| अंग्रेज़ी वेब और दस्तावेज़ | 43.4% | 1.3% | 15.8% |
| जर्मन वेब और दस्तावेज़ | 23.4% | 2.1% | 2.6% |
| कोड | 13.6% | 16.3% | 13.2% |
| एजेंटिक कोड और टूल उपयोग | ~0% | 15.4% | 5.6% |
| OCR किए गए PDF | 0% | 0% | 33.3% |
तालिका में केवल वेब, कोड, एजेंटिक और PDF वाली पंक्तियाँ दिखाई गई हैं। मॉडल कार्ड में अंग्रेज़ी और जर्मन इंस्ट्रक्शन और रीजनिंग डेटा, STEM दस्तावेज़, QA, और विशिष्ट कानूनी तथा सार्वजनिक-क्षेत्र के डेटा भी सूचीबद्ध हैं। अंग्रेज़ी और जर्मन की सभी पंक्तियों को मिलाकर, मॉडल कार्ड प्री-ट्रेनिंग मिक्स को लगभग 62.5% अंग्रेज़ी, 23.9% जर्मन, और 13.6% कोड के रूप में संक्षेपित करता है।
Kolibri 1 को अलग करने वाली ज़्यादातर बातें दो फैसलों पर टिकती हैं: जर्मन पक्ष को अनुवाद के बजाय सही तरह से ट्रेन करना, और सक्रिय पैरामीटर्स की संख्या इतनी कम रखना कि एक अकेला H200 इसे सर्व कर सके।
Kolibri 1 जर्मन और अंग्रेज़ी के बीच का अंतर अपेक्षा से अधिक कम कर देता है, जो इस आकार के ओपन-वेट मॉडल के लिए असामान्य है।
इसका समग्र बेंचमार्क औसत अंग्रेज़ी में 75.5 और जर्मन में 70.8 है।
Aleph Alpha ने 128,000-टोकन की शब्दावली एक नए टोकनाइज़र एल्गोरिद्म UniBPE से प्रशिक्षित की, जो बाइट-पेयर एनकोडिंग की greedy बॉटम-अप मर्जेस रखता है, लेकिन यह तय करने के लिए Unigram उद्देश्य का उपयोग करता है कि कौन-सा मर्ज शब्दावली में जाए।
बताया गया लाभ यह है कि जर्मन में 4.90 बाइट/टोकन का संपीड़न मिलता है, जबकि GPT-5 के टोकनाइज़र के लिए यह 4.35 है; अंग्रेज़ी 4.58 बाइट/टोकन पर रहती है (GPT-5 के टोकनाइज़र में 4.67)।
यह गुणवत्ता जितना ही लागत के लिए भी मायने रखता है।
बेहतर संपीड़न का मतलब है कि उसी जर्मन दस्तावेज़ के लिए कम टोकन, इसलिए 50-पृष्ठ का Bescheid (जर्मनी का एक आधिकारिक प्रशासनिक नोटिस) प्रोसेस करने में कम लागत आती है और कॉन्टेक्स्ट में अधिक जगह बचती है।
प्री-ट्रेनिंग मिक्स में जर्मन 23.4% था, जबकि अंग्रेज़ी वेब और दस्तावेज़ 43.4% थे, इसलिए क्षमता मुख्य प्रशिक्षण रन के बाद जोड़े गए फाइन-ट्यून के बजाय डेटा में निवेश से आई है।
मॉडल 1,048,576 टोकन का दावा करता है। यह 201B-टोकन के लोंग-कॉन्टेक्स्ट प्रशिक्षण चरण के बाद 262,144 टोकन को नैटिव रूप से संभालता है और 1M तक extrapolate करके पहुँचता है, यानी इसे उस लंबाई पर कभी ट्रेन नहीं किया गया।
Aleph Alpha खुद सेवा दक्षता के लिए 262,144 टोकन या उससे कम पर रहने की सलाह देता है। RULER, जो जाँचता है कि कोई मॉडल बहुत लंबे इनपुट्स में दबी विशिष्ट जानकारी ढूँढ और उपयोग कर सकता है या नहीं, बेस मॉडल के लिए गिरावट दिखाता है: 128K पर 67.9 और 1M पर 63.2, जबकि उद्धृत Qwen3.5 35B-A3B बेस का 128K पर 89.9 है।
न्याय के लिए कहें तो, 1M पर Kolibri का स्कोर Nemotron 3 Nano (58.5) और Qwen3.5 (57.5) से बेहतर है, इसलिए यह निचले शुरुआती बिंदु से भी उनसे कम फीका पड़ता है।
मैं 1M आंकड़े को एक ऐसी छत मानूँगा जिसे आप तकनीकी रूप से छू सकते हैं, न कि एक कार्यशील बजट।
यदि आपकी retrieval-augmented generation (RAG) पाइपलाइन स्कैन किए गए PDFs को टेक्स्ट (OCR) में बदलकर 400K टोकन प्रॉम्प्ट में ठूँसती है और उम्मीद करती है कि मॉडल एक विशिष्ट विवरण भरोसेमंद रूप से ढूँढ लेगा, तो कमिट करने से पहले परीक्षण करें। विशेष रूप से, लोंग-कॉन्टेक्स्ट विस्तार मिक्स का 33.3% OCR किए गए PDFs थे, इसलिए स्कैन-डॉक्यूमेंट वर्कलोड्स स्पष्ट लक्ष्य उपयोग-केस हैं।
Reasoning मोड का अर्थ है कि मॉडल उत्तर देने से पहले समस्या को चरण-दर-चरण सुलझाता है, जिससे सटीकता बढ़ती है लेकिन अधिक टोकन खर्च होते हैं।
Kolibri 1 में, यह एक स्विच है जिसे आप नियंत्रित करते हैं—यह कोई अलग मॉडल टियर नहीं है—और टूल कॉलिंग (मॉडल का किसी बाहरी फ़ंक्शन या API, जैसे डेटाबेस लुकअप, को कॉल करने का निर्णय) नैटिव है।
Aleph Alpha बहु-चरण reasoning, RAG, एजेंटिक टूल कॉलिंग, कोडिंग, और द्विभाषी असिस्टेंट कार्य को अपेक्षित उपयोग के रूप में सूचीबद्ध करता है, और मिड-ट्रेनिंग मिक्स में एजेंटिक कोड और टूल उपयोग को 15.4% दिया, जो प्री-ट्रेनिंग के दौरान लगभग शून्य से बढ़ा।
एक अनौपचारिक उपयोगकर्ता रिपोर्ट में, मॉडल को एकल RTX Pro 6000 वर्कस्टेशन GPU पर FP8 में चलाते हुए, लगभग 170 टोकन प्रति सेकंड मापा गया और यह प्रवृत्ति दिखी कि यह विचार-विमर्श में बहुत टोकन खर्च करता है।
यदि आप लेटेंसी-संवेदी पाथ में डिफ़ॉल्ट रूप से reasoning चालू छोड़ते हैं, तो उसके लिए बजट रखें।
Kolibri 1 शून्य से प्रशिक्षित है, इसलिए यह किसी दूसरी कंपनी के मॉडल का फाइन-ट्यून या कॉपी नहीं है।
यह लाइसेंसिंग और यह जानने—कि इसमें क्या-क्या गया—दोनों के लिए अहम है।
Apache 2.0 वेट्स के साथ मिलकर, इसका मतलब है कि आप Kolibri 1 को एयर-गैप्ड (पूरी तरह इंटरनेट से कटा हुआ) चला सकते हैं, फाइन-ट्यून कर सकते हैं, और बिना किसी से पूछे इसे किसी वाणिज्यिक उत्पाद में शिप कर सकते हैं।
EU AI Act और उसका General-Purpose AI (GPAI) Code of Practice, सामान्य-उद्देश्य मॉडलों के लिए EU के नियम तय करते हैं, जिसमें प्रशिक्षण डेटा का दस्तावेज़ीकरण शामिल है।
Aleph Alpha Code of Practice का हस्ताक्षरी है और एक विस्तृत मॉडल कार्ड प्रकाशित करता है जिसमें प्रशिक्षण-डेटा के स्रोत, डीकॉन्टैमिनेशन कदम (ट्रेनिंग डेटा से बेंचमार्क प्रश्न हटाना), और राइटशोल्डर्स के लिए संपर्क बिंदु शामिल है—यही वह दस्तावेज़ीकरण है जिसकी EU AI Act अनुपालन समीक्षा में माँग होगी।
जर्मनी और व्यापक EU के सार्वजनिक-क्षेत्र के खरीदारों के लिए, वह कागज़ात अक्सर किसी बेंचमार्क अंतर से अधिक निर्णायक होता है।
और यह वह हिस्सा है जिसे कोई अमेरिकी लैब जल्दी नहीं कॉपी कर सकती।
Aleph Alpha का मॉडल कार्ड सीमाओं को खुलकर बताता है, और खरीद के फैसले से पहले उन्हें पढ़ना चाहिए:
किसी भी उच्च-दांव परिनियोजन के लिए, Aleph Alpha बताता है कि अतिरिक्त गार्डरेल्स और Regulation (EU) 2024/1689 का अनुपालन आवश्यक है।
Kolibri 1 का बेंचमार्क प्रोफ़ाइल एक उपयोगी तरह से असंतुलित है: यह प्रतियोगी गणित और जर्मन रीजनिंग पर अपने बताए तुलना-समूह में आगे है, और क्लोज़्ड-बुक नॉलेज, MMLU-Pro, और अधिकांश टूल-उपयोग सूट्स में Qwen3.6 35B-A3B से हारता है।
Aleph Alpha Qwen3.6 35B-A3B, Mistral Small 4 119B-A6B, और Nemotron 3 Super 120B-A12B के साथ तुलना करता है।
मॉडल कार्ड Qwen3.8 27B को भी सूचीबद्ध करता है, जो एक डेंस मॉडल है (MoE के विपरीत, जो हर टोकन के लिए अपने सभी पैरामीटर्स का उपयोग करता है) और जो कुल मिलाकर बेहतर स्कोर करता है (समग्र जर्मन 79.9, Kolibri के 70.8 के मुकाबले) और इसके सक्रिय पैरामीटर्स लगभग आठ गुना हैं।
मैंने इसे नीचे की तालिकाओं से बाहर रखा है, लेकिन दक्षता दावों को पढ़ते समय इसे ध्यान में रखें।
उन मॉडल नामों में, "A" के बाद की संख्या प्रति टोकन सक्रिय पैरामीटर्स है, तो 35B-A3B का मतलब 35B कुल और 3B सक्रिय। नीचे तालिकाओं में दिए बेंचमार्क्स यह मापते हैं:
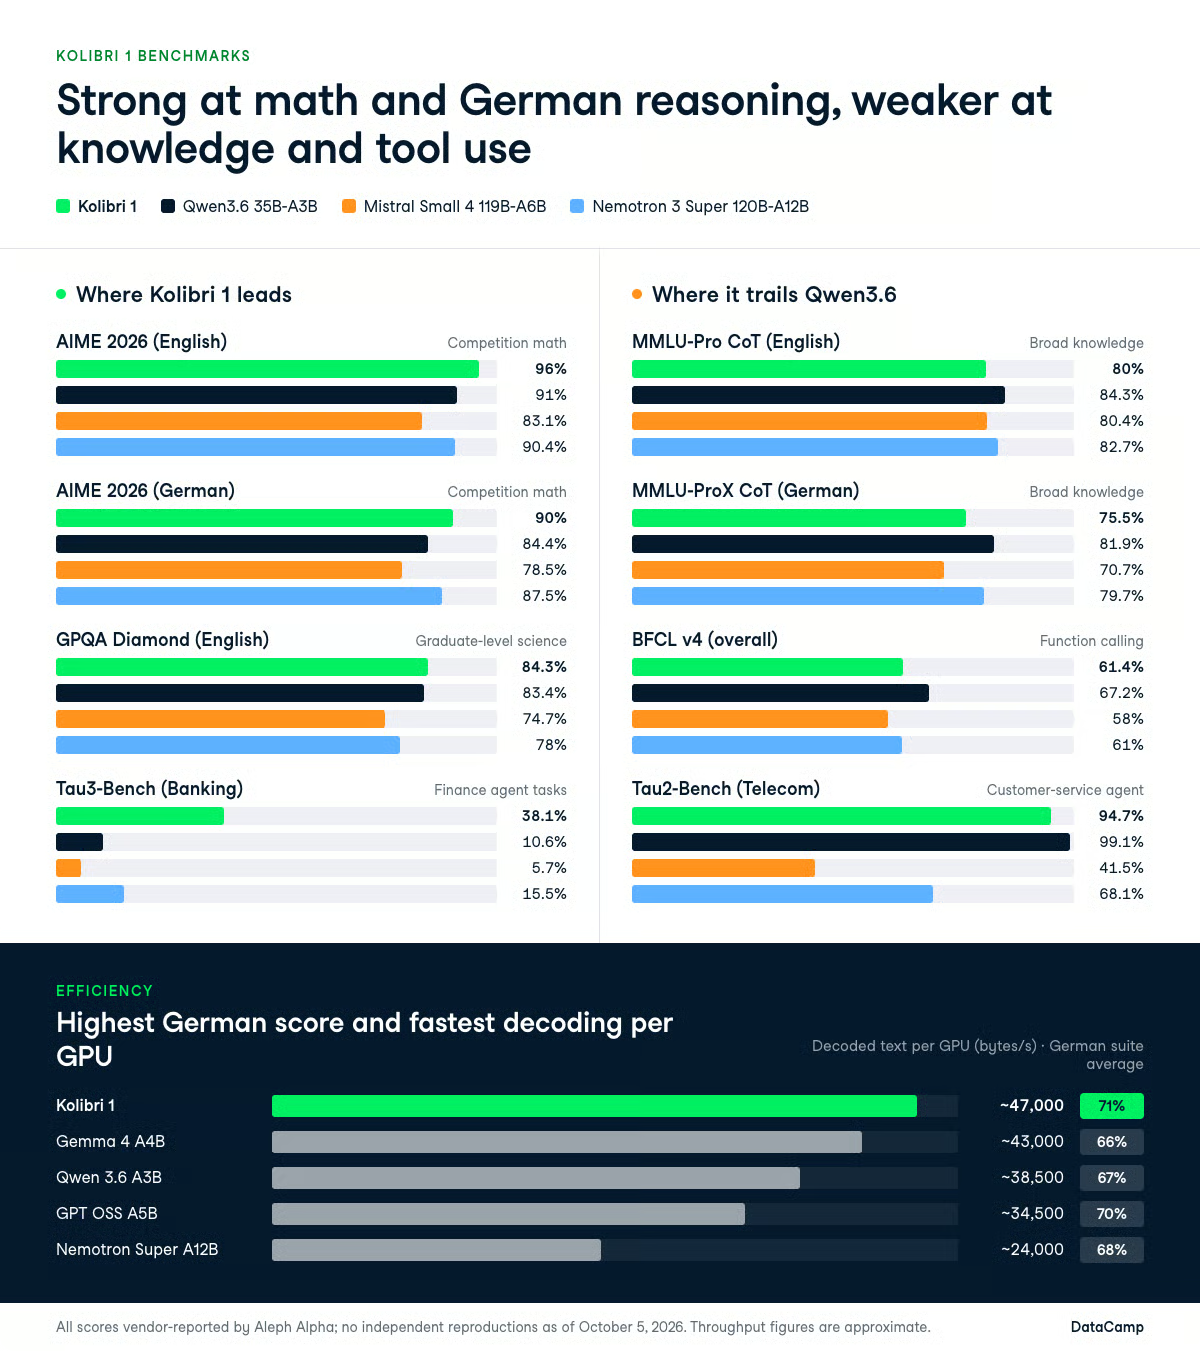
गणित वह क्षेत्र है जहाँ Kolibri 1 साफ बढ़त में है।
यह AIME 2026 (EN) पर 96% स्कोर करता है, जबकि Qwen3.6 35B-A3B के लिए 91%, Nemotron 3 Super के लिए 90.4%, और Mistral Small 4 के लिए 83.1% है, और AIME 2025 (EN) पर 96.9% जबकि Qwen3.6 का 84.6% है।
GPQA Diamond (EN) पर यह 84.3% लेता है बनाम 83.4%, और Humanity's Last Exam (EN) पर 21.5% बनाम 21.1%, दोनों इतने करीब हैं कि बराबरी मानी जा सकती है।
उसी तालिका में कमजोर कड़ी ज्ञान है।
AA-Omniscience Index (public set) ऐसे पैमाने पर स्कोर किया जाता है जहाँ नकारात्मक संख्याएँ आम हैं और ऊँचा बेहतर है। Kolibri 1 -32.8 तक पहुँचता है, जबकि Qwen3.6 के लिए -12.5 और Mistral Small 4 के लिए -24.0 है, हालांकि यह Nemotron 3 Super के -36.5 से थोड़ा आगे है। एक अलग AA-Omniscience सटीकता आँकड़ा 14.8% आता है, जो चारों मॉडलों में सबसे कम है।
उसी बेंचमार्क पर इसका नॉन-हैलुसिनेशन रेट अधिक अनुकूल 44.0% है, जो Nemotron (13.9%) और Mistral (34.7%) से आगे है लेकिन Qwen3.6 (56.7%) से पीछे, जो Aleph Alpha के abstention प्रशिक्षण से मेल खाता है।
3.46B सक्रिय-पैरामीटर मॉडल में तथ्यों को याद रखने की सीमित गुंजाइश होती है, इसलिए क्लोज़्ड-बुक रिकॉल पर भरोसा करने के बजाय इसे रिट्रीवल के साथ जोड़ें।
| बेंचमार्क (EN) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 96% | 91% | 83.1% | 90.4% |
| AIME 2025 | 96.9% | 84.6% | 79.8% | 91.7% |
| GPQA Diamond | 84.3% | 83.4% | 74.7% | 78% |
| Humanity's Last Exam | 21.5% | 21.1% | 9.7% | 20.6% |
| MMLU-Pro CoT | 80% | 84.3% | 80.4% | 82.7% |
| AA-Omniscience Index (उच्च बेहतर है) | -32.8 | -12.5 | -24.0 | -36.5 |
Kolibri 1 जर्मन गणित और विज्ञान बेंचमार्क में आगे है और जर्मन ज्ञान वाले में पीछे, जो इसके अंग्रेजी प्रोफाइल जैसी ही आकृति है।
यह AIME 2026 (DE) पर 90% स्कोर करता है जबकि Qwen3.6 के लिए 84.4%, और GPQA Diamond (DE) पर 81.3% जबकि 80.6%। MMLU-ProX CoT (DE) पर यह 75.5% पर आ जाता है जबकि Qwen3.6 81.9% और Nemotron 3 Super 79.7% तक पहुँचते हैं, और Humanity's Last Exam (DE) पर यह 15.9% करता है जबकि Nemotron का 22.3% है।
मुझे वास्तव में दिलचस्प इसकी अंग्रेजी-से-जर्मन की छोटी खाई लगती है।
Kolibri AIME 2026 को अंग्रेजी से जर्मन में ले जाते हुए 6 अंक खोता है और GPQA Diamond पर 3 अंक, जो उस मॉडल से अपेक्षित गिरावट से संकरी है जो जर्मन को केवल अनुवाद लक्ष्य की तरह मानता हो।
| बेंचमार्क (DE) | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| AIME 2026 | 90% | 84.4% | 78.5% | 87.5% |
| AIME 2025 | 87.5% | 82.9% | 72.3% | 85.6% |
| GPQA Diamond | 81.3% | 80.6% | 72.9% | 76.6% |
| MMLU-ProX CoT | 75.5% | 81.9% | 70.7% | 79.7% |
| Humanity's Last Exam | 15.9% | 20.5% | 10.5% | 22.3% |
यह रिलीज़ का सबसे नरम हिस्सा है।
BFCL v4 कुल मिलाकर, Kolibri 1 61.4% स्कोर करता है जबकि Qwen3.6 के लिए 67.2%, और Tau2-Bench (Telecom) पर यह 94.7% तक पहुँचता है जबकि Qwen3.6 का 99.1% है। यह Tau2-Bench (Airline) पर Qwen3.6 को मामूली रूप से पीछे छोड़ता है, 76.7% बनाम 70.7%।
अलग से रिपोर्ट किया गया BFCL v3 मल्टी-टर्न आँकड़ा 39.8 पॉइंट (Qwen3.6 के लिए 53.5) वही कमजोरी दिखाता है: एकल टूल कॉल ठीक हैं, बार-बार टूल राउंड-ट्रिप के साथ लंबी बातचीत नहीं।
अपवाद इसका उल्टा है।
Tau3-Bench (Banking) पर, Kolibri 1 38.1% स्कोर करता है जबकि Qwen3.6 10.6%, Nemotron 3 Super 15.5%, और Mistral Small 4 केवल 5.7% लेते हैं। यह इस तुलना सेट में अगले सर्वश्रेष्ठ मॉडल पर लगभग 2.5x का मार्जिन है (Qwen3.6 पर 3.6x) एक फाइनेंस-फ्लेवर वाले एजेंट बेंचमार्क पर, और यह इस रिलीज़ का वह एकल परिणाम है जिसे मैं सबसे अधिक स्वतंत्र रूप से पुनरुत्पादित देखना चाहूँगा।
| बेंचमार्क | Kolibri 1 | Qwen3.6 35B-A3B | Mistral Small 4 119B-A6B | Nemotron 3 Super 120B-A12B |
|---|---|---|---|---|
| Tau2-Bench (Telecom) | 94.7% | 99.1% | 41.5% | 68.1% |
| Tau2-Bench (Retail) | 69.9% | 71.6% | 62.9% | 67.5% |
| Tau2-Bench (Airline) | 76.7% | 70.7% | 40% | 72.7% |
| Tau3-Bench (Banking) | 38.1% | 10.6% | 5.7% | 15.5% |
| BFCL v4 (कुल) | 61.4% | 67.2% | 58% | 61% |
रिपोर्ट किए गए कोडिंग परिणाम हैं: LiveCodeBench v6 पर 85.9, SWE-bench Verified पर 66.4, और Terminal-Bench 2.1 पर 27.7।
कच्ची कोड जनरेशन मजबूत दिखती है, एजेंटिक सॉफ्टवेयर इंजीनियरिंग सामान्य दर्जे की, और Terminal-Bench का नंबर बताता है कि लंबा, बहु-चरणीय टर्मिनल कार्य इस मॉडल के लिए नहीं है।
एक संदूषण चेतावनी है जिसे उद्धृत करने से पहले आपको पढ़ना चाहिए।
तकनीकी रिपोर्ट नोट करती है कि अंग्रेजी के 48% और जर्मन के 47% HumanEval मूल्यांकन डेटा प्रशिक्षण-संबंधित सामग्री में दिखाई दिए, जो HumanEval-शैली के स्कोर को बढ़ा देते हैं।
तुलना तालिकाओं में कई सूट स्वामित्व वाले या विक्रेता-निर्मित हैं, जिससे पूरे सेट का ऑडिट करना कठिन हो जाता है, और लेखन के समय मौजूदा Claude, GPT, या Gemini फ्लैगशिप्स के विरुद्ध कोई सत्यापित, समान-से-समान तुलना मौजूद नहीं थी।
दक्षता का दावा विक्रेता-रिपोर्टिंग चेतावनी के बाद भी सबसे बेहतर टिकता है, क्योंकि यह स्कोर के बजाय आर्किटेक्चर का गुण है।
यहाँ थ्रूपुट का अर्थ है प्रति GPU प्रति सेकंड मॉडल कितना पाठ जनरेट कर सकता है। Aleph Alpha इसे टोकन के बजाय बाइट्स में मापता है, ताकि अलग-अलग टोकनाइज़र वाले मॉडलों की निष्पक्ष तुलना हो सके।
Kolibri 1 Aleph Alpha के जर्मन बेंचमार्क सूट पर औसतन 71% पर बैठता है, जबकि प्रति GPU लगभग 47,000 बाइट/सेकंड डिकोड करता है। GPT OSS A5B लगभग 34,500 बाइट/सेकंड पर 70% तक पहुँचता है, Qwen 3.6 A3B लगभग 38,500 पर 67%, Gemma 4 A4B लगभग 43,000 पर 66%, और Nemotron Super A12B लगभग 24,000 पर 68%।
Nemotron मॉडल की तुलना में प्रति GPU लगभग 2x डिकोडेड टेक्स्ट परोसना, और वह भी उच्चतर जर्मन औसत पर, स्व-होस्टेड स्टैक में Kolibri चुनने का व्यावहारिक तर्क है।
यदि आप प्रति टोकन के बजाय अपने स्वयं के GPUs के लिए भुगतान कर रहे हैं, तो प्रति GPU थ्रूपुट वही संख्या है जो बिल में दिखाई देती है।
Kolibri 1 के लिए कोई प्रकाशित टोकन कीमत नहीं है।
Aleph Alpha ने होस्टेड API प्राइस सूची जारी नहीं की है, और 5 अक्टूबर, 2026 तक आधिकारिक API प्रलेखन में कोई पुष्टि किया गया Kolibri API मॉडल ID दिखाई नहीं दिया।
एंटरप्राइज़ परिनियोजन Aleph Alpha की सेल्स टीम के माध्यम से चलता है, और रिपॉजिटरी आइडेंटिफ़ायर Aleph-Alpha/Kolibri-1 को API मॉडल ID नहीं माना जाना चाहिए।
वेट्स स्वयं Apache 2.0 के तहत निःशुल्क हैं, इसलिए आपकी लागत GPU समय है।
FP8 मेमोरी फ़ुटप्रिंट लगभग 78 GB है, जिसमें न्यूनतम आवश्यकताएँ 2x A100 80 GB, 2x H100 SXM5, 1x H200, 1x B200, या 1x B300 बताई गई हैं, और अनुशंसित कॉन्फ़िगरेशन 2x H100 SXM5, 2x H200, 1x B200, या 1x B300 है। मॉडल सामान्य रूप से उपलब्ध है, प्रीव्यू नहीं, और कोई वेटलिस्ट या क्षेत्रीय लॉक नहीं है।
आप किसके मुकाबले ट्रेड-ऑफ़ कर रहे हैं, इसका अंदाज़ा लगाने के लिए, हमारी GPT-6.1 Sol कवरेज उस मॉडल को प्रति मिलियन टोकन $2 इनपुट / $10 आउटपुट पर रखती है। किसी तृतीय-पक्ष मूल्य-सारांश में पुराने GPT-5.6 Sol को $5 / $30 और GPT-5.6 Luna को 30 जुलाई के OpenAI मूल्य-ह्रास के बाद $0.20 / $1.20 पर सूचीबद्ध किया गया है।
स्व-होस्टिंग प्रति-इकाई अर्थशास्त्र में तभी जीतती है जब आपका वॉल्यूम B200 की फिक्स्ड लागत से ऊपर निकल जाए।
Kolibri 1 Apache 2.0 के तहत ओपन-वेट है, जो बिना किसी उपयोगकर्ता या राजस्व सीमा के वाणिज्यिक उपयोग, संशोधन और पुनर्वितरण की अनुमति देता है।
वेट्स Hugging Face पर Aleph-Alpha/Kolibri-1 में float8_e4m3fn के रूप में उपलब्ध हैं। मॉडल कार्ड में केवल vLLM के ज़रिए सर्विंग का दस्तावेज़ है, Aleph Alpha के aleph-alpha-inference प्लगइन का उपयोग करते हुए। कम्युनिटी GGUF और MLX बिल्ड कुछ दिनों में आ गए, लेकिन Aleph Alpha ने उन्हें वैध नहीं ठहराया है, और मुझे कोई आधिकारिक Ollama एंट्री नहीं मिली।
सर्व्ड परिनियोजन के लिए, 1x H200 या 1x B200 एक ही कार्ड पर ~78 GB FP8 वेट्स रखता है। H100s पर --tensor-parallel-size 2 का उपयोग करें।
जब तक आपने विशेष रूप से लंबे कॉन्टेक्स्ट का परीक्षण नहीं किया है, --max-model-len को 262,144 पर या उससे नीचे रखें। उससे आगे जाने के लिए एक अतिरिक्त --hf-overrides फ़्लैग चाहिए, जिसका विवरण मॉडल कार्ड में है।
प्लगइन इंस्टॉल करें और सर्वर शुरू करें:
pip install 'aleph-alpha-inference>=1'

# Add --tensor-parallel-size 2 on 2x H100
vllm serve Aleph-Alpha/Kolibri-1 \
  --kv-cache-dtype fp8 \
  --max-model-len 262144 \
  --reasoning-parser kolibri1 \
  --tool-call-parser kolibri1 \
  --enable-auto-tool-choice
फिर OpenAI-संगत API के माध्यम से, वे सैंपलिंग पैरामीटर्स इस्तेमाल करते हुए क्वेरी करें जो Aleph Alpha सुझाता है (temperature 1.0, top_p 0.97, top_k 128):
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

response = client.chat.completions.create(
    model="Aleph-Alpha/Kolibri-1",
    messages=[{
        "role": "user",
        "content": "Fasse die wichtigsten Fristen aus diesem Bescheid in drei Punkten zusammen.",
    }],
    temperature=1.0,
    top_p=0.97,
    max_tokens=512,
    extra_body={
        "top_k": 128,
        "chat_template_kwargs": {"reasoning_effort": "medium"},
    },
)
print(response.choices[0].message.content)
Reasoning effort low, medium, और high स्वीकार करता है, और यदि विलंबता गहराई से अधिक मायने रखती है तो आप सोच-विचार को पूरी तरह बंद कर सकते हैं।
आउटपुट सैंपलिंग पैरामीटर्स के साथ बदलेंगे, और मॉडल कार्ड नोट करता है कि सैंपलिंग डिसेबल करने पर भी वे हल्के-से विचलित हो सकते हैं।
स्व-होस्टेड इन्फ़रेंस और एजेंट लूप्स पर गहराई से सेटअप कार्य के लिए, हमारा माइग्रेशन एजेंट बनाने पर API ट्यूटोरियल वे टूल-परमिशन और स्टीयरिंग पैटर्न कवर करता है जो सीधे ट्रांसफर होते हैं।
Kolibri 1 को धारणा के स्तर पर 'sovereign AI' कहा गया है, जिसका अर्थ है कि कोई देश या संगठन अपनी अवसंरचना पर और अपने अधिकार क्षेत्र में अपने AI को चला, ऑडिट और नियंत्रित कर सकता है, किसी विदेशी प्रदाता के API, कीमत या सेवा शर्तों पर निर्भर हुए बिना। Kolibri 1 के लिए, यह दावा Apache 2.0 वेट्स पर टिका है जिन्हें आप एयर-गैप्ड (इंटरनेट से अलग) चला सकते हैं, यूरोपीय प्रशिक्षण अवसंरचना, और EU AI Act दस्तावेज़ीकरण पर।
हालाँकि, इस लॉन्च के पीछे कॉर्पोरेट संदर्भ की दो बातें हैं।
Aleph Alpha ने कनाडाई कंपनी Cohere के साथ एक बाध्यकारी विलय समझौते पर हस्ताक्षर किए हैं ताकि वे जिसे पहला ट्रांसअटलांटिक सॉवरेन AI समाधान बताते हैं, उसे बनाया जा सके।
संयुक्त कंपनी Cohere नाम के तहत संचालित होगी, टोरंटो और बर्लिन में दोहरे मुख्यालयों के साथ, और हाइडेलबर्ग अनुसंधान केंद्र के रूप में जारी रहेगा। यह सौदा अभी नियामकीय स्वीकृति चाहता है।
सॉवरेन्टी की पेशकश इस पर निर्भर करती है कि मॉडल का मालिक जो भी हो, वह इसे सपोर्ट करता रहे, और एक बार विलय पूरा होने पर Aleph Alpha ब्रांड Cohere में समा जाने वाला है, इसलिए दोनों बातों पर बेंचमार्क्स के साथ-साथ नज़र रखना उपयोगी है।
Aleph Alpha यह दांव लगा रहा है कि सॉवरेन्टी, Apache 2.0 लाइसेंसिंग, और EU AI Act अनुपालन का प्रलेखन, यूरोपीय सार्वजनिक-क्षेत्र खरीदारों के लिए MMLU-Pro पर कुछ अंकों से अधिक मायने रखता है।
यह दांव तर्कसंगत लगता है, और Cohere के साथ कंपनी का विलय संकेत देता है कि वह केवल स्केल के दम पर नहीं जीत सकती।
मेरा मानना है कि यह कहना उचित होगा कि Kolibri 1 अपने सक्रिय-पैरामीटर आकार में जर्मन-भाषा का अब तक का सबसे अच्छा ओपन-वेट मॉडल है जिसे हमने इस स्तर पर दस्तावेजीकृत देखा है, लेकिन यदि मुझे लंबे मल्टी-टर्न एजेंट रन या क्लोज़्ड-बुक तथ्यात्मक रिकॉल चाहिए, तो मैं यही मॉडल नहीं चुनूँगा।
तुलनीय छोटे-सक्रिय MoE मॉडलों में, Qwen3.6 35B-A3B अभी भी वह मुक़ाबला जीतता है। यदि आप एक डेंस 27B मॉडल वहन कर सकते हैं, तो Qwen3.8 27B इसे पूरी तरह जीतता है।
यदि आप ऐसे मॉडलों को चलाने और मूल्यांकन करने में गति पकड़ना चाहते हैं, तो हमारी AI Fundamentals स्किल ट्रैक से शुरुआत करें।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स