
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.5K
पूर्व OpenAI CTO मीरा मुराटी द्वारा स्थापित लैब Thinking Machines ने अपना पहला मॉडल जारी किया है: Inkling। OpenAI, Anthropic, और Google के फ्लैगशिप मॉडलों के विपरीत, Inkling पूर्ण वेट्स के साथ डाउनलोड हेतु उपलब्ध है, जिससे डेवलपर्स इसे केवल मीटर्ड API के माध्यम से कॉल करने के बजाय सीधे संशोधित कर सकते हैं।
Inkling एक Mixture-of-Experts (MoE) ट्रांसफॉर्मर है, जिसमें कुल 975B पैरामीटर हैं और प्रति टोकन 41B सक्रिय, 1M-टोकन का कॉन्टेक्स्ट विंडो, और 45 ट्रिलियन टोकनों (टेक्स्ट, इमेज, ऑडियो, और वीडियो) पर प्री-ट्रेनिंग शामिल है।
Thinking Machines साफ तौर पर कहता है कि यह सबसे शक्तिशाली उपलब्ध मॉडल नहीं है: कंपनी स्पष्ट रूप से बताती है कि Inkling "आज उपलब्ध समग्र रूप से सबसे मजबूत मॉडल नहीं है, चाहे ओपन हो या क्लोज्ड।" इसकी पेशकश है संतुलित प्रदर्शन के साथ एक ऐसा डिज़ाइन जो Tinker, कंपनी के फाइन-ट्यूनिंग प्लेटफ़ॉर्म, के जरिए कस्टमाइज़ करने के लिए बना है।
इस लेख में, मैं Inkling की नई बातें कवर करूंगा—इसके फीचर्स, बेंचमार्क्स, और वे हैंड्स-ऑन टेस्ट जिन्हें आप खुद चला सकते हैं। साथ ही हमारा Inkling को लोकली चलाने का गाइड भी देखने की सलाह देता हूँ।
Inkling एक ओपन-वेट्स MoE ट्रांसफॉर्मर है जिसमें कुल 975B पैरामीटर हैं और प्रति टोकन 41B सक्रिय, जिसे फाइन-ट्यूनिंग के लिए एक व्यापक बेस मॉडल के रूप में पोजिशन किया गया है—लीडरबोर्ड-टॉप चैटबॉट के रूप में नहीं। यह एक नियोजित परिवार का पहला रिलीज़ है, 15 जुलाई, 2026 को इसके छोटे भाई Inkling-Small के प्रीव्यू के साथ जारी किया गया।
डिज़ाइन लक्ष्य है व्यापकता। Thinking Machines ने Inkling को एजेंटिक, रीजनिंग, कोडिंग, इंस्ट्रक्शन-फॉलोइंग, फैक्चुअलिटी, विज़न, और ऑडियो टास्क्स पर प्रशिक्षित किया, किसी एक डोमेन के लिए ऑप्टिमाइज़ करने के बजाय।
यह इसलिए महत्वपूर्ण है क्योंकि कंपनी का दांव है कि संगठन अपने डेटा पर मॉडल को फाइन-ट्यून करेंगे, और एक व्यापक बेस संकीर्ण की तुलना में अधिक वर्कफ़्लोज़ में अनुकूलित होता है।
हेडलाइन क्षमता दावा पीक बेंचमार्क से अधिक दक्षता का है। Terminal Bench 2.1 पर, Thinking Machines रिपोर्ट करता है कि Inkling, NVIDIA के Nemotron 3 Ultra जितना ही कोडिंग प्रदर्शन पाने के लिए लगभग एक-तिहाई टोकन खर्च करता है।
ऐसे मॉडल के लिए जिसे आप लंबे वर्कफ़्लोज़ में लाखों बार चला सकते हैं, वह टोकन कॉस्ट कर्व एकल मैक्स-एफर्ट स्कोर से अधिक मायने रखता है।
Inkling का MoE डिज़ाइन काफी हद तक DeepSeek-V3 का अनुसरण करता है—256 routed experts, 2 shared experts, और प्रति टोकन 6 routed experts सक्रिय, जिसमें एक सिग्मॉइड राउटर और auxiliary-loss-free लोड बैलेंसिंग का उपयोग किया गया है।
Thinking Machines ने 5:1 अनुपात पर स्लाइडिंग-विंडो और ग्लोबल अटेंशन को इंटरलीव किया और RoPE के बजाय relative positional embeddings का उपयोग किया, जिससे लंबे सीक्वेंस पर बेहतर एक्सट्रैपोलेशन रिपोर्ट हुआ।
प्री-ट्रेनिंग 45 ट्रिलियन मल्टीमोडल टोकनों पर एक हाइब्रिड ऑप्टिमाइज़र के साथ चलाई गई: बड़े मैट्रिक्स वेट्स के लिए Muon और अन्य पैरामीटर्स के लिए Adam।
पोस्ट-ट्रेनिंग, ओपन-वेट्स मॉडलों के सिंथेटिक डेटा पर थोड़ी SFT से शुरू होकर, उसके बाद दो सतत रन में 30M से अधिक रोलआउट तक स्केल किए गए बड़े पैमाने के असिंक्रोनस RL के साथ की गई।
Inkling के फर्क कच्ची क्षमता से कम और इस बात में अधिक हैं कि इसे कस्टमाइज़ और नियंत्रित करने के लिए कैसे बनाया गया है। यहाँ वे फीचर्स हैं जो अलग दिखते हैं।
Inkling आपको "thinking effort" स्तर सेट करने देता है ताकि गहनता को टोकन लागत और लेटेंसी के मुकाबले ट्रेड किया जा सके।
आप कठिन समस्या पर अधिकतम प्रदर्शन के लिए effort को 0.99 तक बढ़ा सकते हैं, या हाई-वॉल्यूम टास्क के लिए, जहाँ गति और लागत प्रमुख हैं, इसे कम रख सकते हैं।
यह प्रशिक्षित व्यवहार है, कोई रैपर नहीं।
बड़े पैमाने के रिइनफोर्समेंट लर्निंग के दौरान, Thinking Machines ने सिस्टम मैसेज बदलकर और प्रति-टोकन लागत समायोजित करके प्रति सैंपल effort स्तर को भिन्न किया, ताकि मॉडल अलग-अलग रोलआउट्स पर अलग टोकन बजट खर्च करना सीख सके।
effort सेटिंग को किसी कोडिंग या एजेंट हार्नेस के भीतर से पास किया जा सकता है।
प्रोडक्शन वर्कलोड चलाने वाले प्रैक्टिशनर्स के लिए, यह वह फीचर है जिस पर मैं सबसे अधिक ध्यान देता। इंटरएक्टिव टूल्स के लिए लेटेंसी अक्सर बाध्यकारी सीमा होती है, और बिना मॉडल बदले प्रति रिक्वेस्ट इसे नियंत्रित कर पाना वाकई उपयोगी है।
Inkling टेक्स्ट, इमेज और ऑडियो पर नैटिव रूप से तर्क करता है, और मल्टीमोडल घटक सामान्य-डोमेन डेटा पर स्क्रैच से प्रशिक्षित किए गए हैं।
यह स्पीच ट्रांसक्राइब कर सकता है, बोले गए निर्देशों का पालन कर सकता है, रिकॉर्डिंग्स पर प्रश्नों का उत्तर दे सकता है, इमेज का वर्णन कर सकता है, और चार्ट्स व डायग्राम्स पर तर्क कर सकता है।
आर्किटेक्चर एन्कोडर-फ्री है।
ऑडियो को dMel स्पेक्ट्रोग्राम्स के रूप में फीड किया जाता है, इमेज को 40x40 पिक्सेल पैच के रूप में चार-लेयर hMLP से एन्कोड किया जाता है, और दोनों को एक हल्की एम्बेडिंग लेयर के माध्यम से टेक्स्ट टोकनों के साथ संयुक्त रूप से प्रोसेस करने के लिए पास किया जाता है।
विज़न साइड पर, Inkling तर्क करते समय ज़ूम और क्रॉप करने के लिए एक Python टूल कॉल कर सकता है, जिससे एक ही पास में विज़ुअल और कोड-आधारित तर्क संयोजित होते हैं।
एक ध्यान देने योग्य कैविएट: इनपुट मल्टीमोडल है, लेकिन वर्तमान टूलिंग में आउटपुट केवल टेक्स्ट है। अगर आपके उपयोग-केस में मॉडल को सीधे इमेज या ऑडियो जनरेट करना जरूरी है, तो Inkling ऐसा नहीं करेगा।
Inkling को सही मात्रा में आत्मविश्वास व्यक्त करने के लिए प्रशिक्षित किया गया है—जिसमें तब "मुझे नहीं पता" कहना शामिल है जब उसके गलत होने की संभावना हो—जिसे Thinking Machines मॉडल के "epistemics" के अंतर्गत रखता है।
कंपनी ने वास्तविक दुनिया के सुलझे हुए प्रश्नों के बड़े कॉर्पस पर proper scoring rules के खिलाफ रिइनफोर्समेंट लर्निंग का उपयोग करके कैलिब्रेशन के लिए प्रशिक्षण किया।
पोस्ट-ट्रेनिंग में दो स्वचालित ग्रेडर्स का उपयोग हुआ: एक रूब्रिक ग्रेडर जो यह जांचता है कि अच्छे उत्तर में क्या होना चाहिए की चेकलिस्ट के विरुद्ध प्रतिक्रिया कैसी है, और एक क्लेम्स ग्रेडर जो एजेंटिक वेब सर्च के जरिए प्रत्येक तथ्यात्मक दावे को सत्यापित करता है।
क्लेम्स ग्रेडर उन दावों को दंडित करता है जो सत्यापन में खरे नहीं उतरते, जिससे केवल रिकॉल को रिवार्ड करने के बजाय भ्रम (हैलुसिनेशन) कम होते हैं।
यह इसलिए मायने रखता है क्योंकि हर उत्तर में अत्यधिक आत्मविश्वास रखने वाला मॉडल आपको सब कुछ दोबारा जांचने पर मजबूर करता है। ForecastBench Brier Index (बिना सर्च) पर Inkling 61.1 स्कोर करता है, जो Grok 4.3 के बराबर है और GPT-5.5 (59.1) तथा Gemini 3.1 Pro (54.6) से थोड़ा आगे है।
Thinking Machines द्वारा तुलना किए गए ओपन-वेट्स मॉडलों में Inkling का FORTRESS adversarial सेफ़्टी स्कोर सबसे मजबूत है—78.0%। FORTRESS हथियारों और हिंसा से संबंधित अनुरोधों की अस्वीकृति को, साथ ही समान दिखने वाले हानिरहित क्वेरीज़ के साथ, टेस्ट करता है, इसलिए उच्च स्कोर का अर्थ है हानिकारक अनुरोधों को अस्वीकार करना, बिना सुरक्षित अनुरोधों को अति-अस्वीकार किए।
तुलना के लिए, Nemotron 3 Ultra ने 77.6% स्कोर किया, Kimi K2.5 ने 54.1%, GLM 5.2 ने 65.6%, और DeepSeek V4 Pro ने उसी adversarial सेट पर 36.0%।
Inkling StrongREJECT पर भी 98.6% प्राप्त करता है, जो स्पष्ट रूप से हानिकारक अनुरोधों की अस्वीकृति का परीक्षण है—अन्य ओपन और क्लोज्ड मॉडलों के अनुरूप।
खुला प्रश्न यह है कि फाइन-ट्यूनिंग के बाद क्या होता है।
Thinking Machines कहता है कि वह अभी भी अध्ययन कर रहा है कि जब ग्राहक Tinker पर फाइन-ट्यून करते हैं तो सुरक्षा व्यवहार कैसे बदलता है—जो किसी भी डाउनलोडेबल मॉडल के लिए वास्तविक चिंता है।
ओपन-वेट्स मॉडलों में Inkling मिड-पैक में आता है: अधिकांश रीजनिंग और कोडिंग टेस्ट पर Nemotron 3 Ultra और Kimi K2.5 से आगे, लेकिन सबसे कठिन में GLM 5.2 और Kimi K2.6 से पीछे। GPT-5.6 Sol, Gemini 3.1 Pro, और Claude Fable 5 जैसे क्लोज्ड फ्रंटियर मॉडलों के मुकाबले यह लगातार पीछे रहता है। नीचे दिए गए सभी स्कोर effort 0.99 पर रिपोर्ट किए गए हैं।
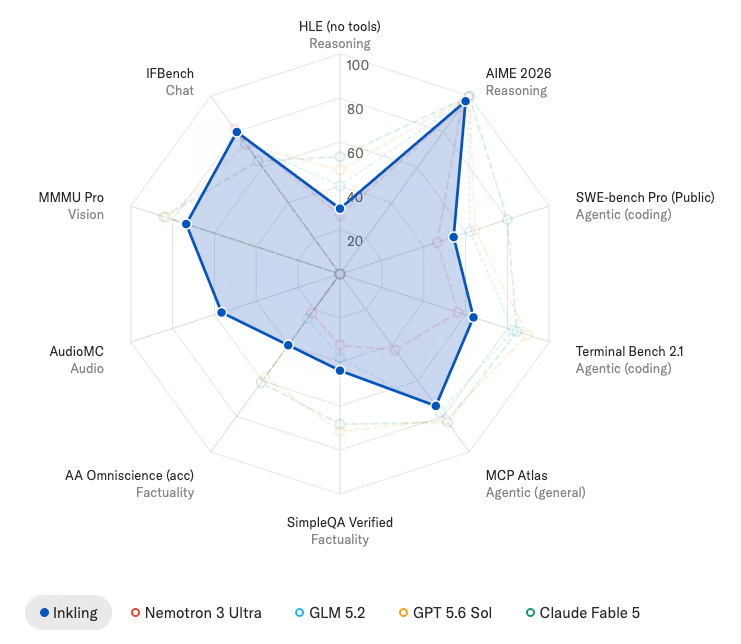
Terminal Bench 2.1 टर्मिनल वातावरण में एजेंटिक कोडिंग का परीक्षण करता है।
Inkling अपने सर्वश्रेष्ठ हार्नेस पर 63.8% स्कोर करता है—Nemotron 3 Ultra (56.4%) और Kimi K2.5 (51.3%) से आगे, लेकिन GLM 5.2 (82.7%) और GPT-5.6 Sol (89.5%) से काफी पीछे।
यहीं टोकन-दक्षता का दावा आता है: Inkling लगभग एक-तिहाई टोकन का उपयोग करके Nemotron 3 Ultra के बराबर कोडिंग प्रदर्शन तक पहुँचता है।
Humanity's Last Exam (HLE) एक कठिन, व्यापक रीजनिंग बेंचमार्क है।
Inkling टेक्स्ट-ओनली पर 29.7% और टूल्स के साथ 46.0% स्कोर करता है—Nemotron 3 Ultra (26.6% / 37.4%) से आगे, लेकिन GLM 5.2 (40.1% / 54.7%) और क्लोज्ड मॉडलों से पीछे, जहाँ GPT-5.6 Sol टेक्स्ट-ओनली पर 47.2% है।
GPQA Diamond ग्रेजुएट-स्तरीय विज्ञान प्रश्नों का परीक्षण करता है।
Inkling, SimpleQA Verified पर 43.9% स्कोर करता है—Nemotron 3 Ultra (32.4%) और Kimi K2.5 (36.9%) से आगे, लेकिन Gemini 3.1 Pro (77.3%) और GPT-5.6 Sol (71.6%) से काफी पीछे। कच्चा तथ्यात्मक रिकॉल इसकी ताकत नहीं है।
जहाँ Inkling अलग दिखता है वह है AA Omniscience, जो यह जानने के लिए पुरस्कृत करता है कि आपको क्या नहीं पता।
Inkling 2.1 का पॉज़िटिव स्कोर करता है, जबकि कई ओपन मॉडल्स नेगेटिव में जाते हैं: Kimi K2.5 -8.0, DeepSeek V4 Pro -10.0, और Nemotron 3 Ultra -1.0। यह अंतर कैलिब्रेशन प्रशिक्षण के फायदे को दर्शाता है।
MMMU Pro (Standard 10), एक विज़न रीजनिंग बेंचमार्क, पर Inkling 73.5% स्कोर करता है—Kimi K2.6 (79.0%) और Gemini 3.1 Pro (82.0%) से पीछे।
Charxiv RQ (चार्ट रीजनिंग) पर यह 78.1% तक पहुंचता है, जो Python टूल की अनुमति मिलने पर 82.0% हो जाता है।
ऑडियो के लिए, Inkling VoiceBench पर 91.4%, MMAU पर 77.2%, और Audio MC पर 56.6% स्कोर करता है—इसे सबसे मजबूत ओपन-वेट्स ऑडियो मॉडलों में स्थान देता है।
Gemini 3.1 Pro अब भी तीनों पर आगे है—क्रमशः 94.3%, 82.5%, और 66.8%।
Inkling आज Tinker पर फाइन-ट्यूनिंग के लिए उपलब्ध है, 64K और 256K टोकन के कॉन्टेक्स्ट विकल्पों के साथ। पूर्ण वेट्स Hugging Face पर उपलब्ध हैं—मूल चेकपॉइंट और NVIDIA Blackwell इन्फरेंस के लिए NVFP4 चेकपॉइंट दोनों रूपों में।
Thinking Machines सीमित समय के लिए 50% की छूट दे रहा है; पूर्ण मूल्य इसकी डॉक्यूमेंटेशन में हैं।
इस छूट के साथ, प्रति 1 मिलियन टोकन की कीमतें इस प्रकार हैं:
(नोट: जबकि Tinker 17 जुलाई को अधिकांश मॉडलों के लिए कीमतें बढ़ा रहा है, Inkling की दरें इस वृद्धि से सुरक्षित हैं। फाइन-ट्यूनिंग के लिए $0.10 प्रति GB/माह के मानक प्लेटफ़ॉर्म स्टोरेज शुल्क अभी भी लागू होते हैं।)
तैनाती समर्थन व्यापक है। फाइन-ट्यून किए गए चेकपॉइंट TogetherAI, Fireworks, Modal, Databricks, और Baseten पर APIs के माध्यम से चलते हैं, और SGLang, vLLM, तथा llama.cpp में ओपन-सोर्स इन्फरेंस सपोर्ट भी है, साथ ही Inkling Playground में एक समेकित वेब सर्च वाला चैट इंटरफेस, जो सीमित समय के लिए निःशुल्क है।
Inkling के साथ, Thinking Machines ने Inkling-Small का प्रीव्यू भी दिया—276B-पैरामीटर MoE जिसमें 12B सक्रिय हैं, जबकि पूर्ण मॉडल में 41B। छोटे मॉडल के प्री-ट्रेनिंग डेटा और रेसिपी में सुधार के कारण यह कई बेंचमार्क्स पर अपने बड़े समकक्ष की बराबरी करता है या उससे आगे निकलता है।
Inkling-Small, तथ्यात्मक रिकॉल और कठिन एजेंटिक कोडिंग के बदले कम लागत और कम लेटेंसी देता है, जो ग्रेडिंग, सिंथेटिक डेटा जेनरेशन, और हाई-वॉल्यूम कोडिंग जैसे वर्कलोड्स के लिए उपयुक्त है। परीक्षण पूर्ण होते ही पूर्ण वेट्स शिप किए जाएंगे।
Inkling एक लीडरबोर्ड जीत से अधिक रणनीति पर किया गया बयान है। Thinking Machines का दांव है कि जो संगठन मॉडल को फाइन-ट्यून कर अपना बनाना चाहते हैं, वे क्लोज्ड फ्रंटियर मॉडल को मीटर्ड कॉल करने से अधिक मूल्य पाएंगे—और Inkling उसी के लिए पेश किया गया बेस है।
मुझे यह ईमानदारी ताज़गीभरी लगती है। कंपनी साफ-साफ कहती है कि Inkling सबसे मजबूत मॉडल नहीं है—जो लॉन्च के लिए असामान्य है—और बेंचमार्क्स भी इसकी पुष्टि करते हैं: यह सबसे कठिन कोडिंग और रीजनिंग टेस्ट में GLM 5.2 और Kimi K2.6 से पीछे है, और GPT-5.6 Sol तथा Gemini 3.1 Pro जैसे क्लोज्ड मॉडलों से काफी पीछे। बदले में यह व्यापकता, नैटिव मल्टीमोडल इनपुट, कैलिब्रेटेड उत्तर, नियंत्रित करने योग्य thinking effort, और तुलना किए गए ओपन-वेट्स मॉडलों में सर्वश्रेष्ठ FORTRESS adversarial सेफ़्टी स्कोर प्रदान करता है।
यदि आप किसी एकल बेंचमार्क पर टॉप स्कोर चाहते हैं, तो Inkling आपकी पसंद नहीं है। यदि आप अपने डेटा पर फाइन-ट्यून करने के लिए ओपन-वेट्स बेस चाहते हैं—मजबूत कैलिब्रेशन और सेफ़्टी के साथ—तो यह एक तर्कसंगत विकल्प है, हालांकि हाई-वॉल्यूम डिप्लॉयमेंट्स के लिए प्रति-टोकन प्राइसिंग और डिफ़ॉल्ट verbosity पर नज़र रखना उचित है।
यदि आप वे फाइन-ट्यूनिंग स्किल्स बनाना चाहते हैं जो Inkling जैसे मॉडल को उपयोगी बनाती हैं, तो मैं हमारे AI Fundamentals स्किल ट्रैक से शुरू करने की सलाह देता हूँ।
सर्वोत्तम DataCamp कोर्स
कोर्स
कोर्स
कोर्स