
कोर्स
डेवलपर्स के लिए AI-असिस्टेड कोडिंग
1 घंटा 30 मिनट
10.7K
Z.ai ने GLM-5.3-Flash जारी किया है, जो उसके फ्लैगशिप GLM-5.3 का किफायती संस्करण है, और इसे सार्वजनिक रूप से "Ox Alpha" के रूप में उजागर करने से पहले एक अनाम प्रीव्यू कोडनेम के तहत लाया गया था। Qwen3.8-Flash-Next भी उसी दिन लॉन्च हुआ, जिससे बजट-टियर LLM सेगमेंट तेजी से गुलजार हो गया।
यदि आप ओपन-वेट चीनी लैब्स और वेस्टर्न फ्रंटियर के बीच दौड़ देख रहे हैं, तो यह मॉडल ध्यान देने योग्य है।
मुख्य दावा सरल है: कम लागत पर near-frontier कोडिंग और एजेंटिक प्रदर्शन।
GLM-5.3-Flash Terminal-Bench 2.1 पर 84.3 स्कोर करता है, जो इसे Claude Opus 4.8 (85.0) और GPT-5.6 Terra (87.4) के क़रीब लाता है।
यह 320B-A18B कॉन्फ़िगरेशन (320B कुल पैरामीटर्स, प्रति टोकन 18B सक्रिय) वाले mixture-of-experts डिज़ाइन का उपयोग करता है, 1M टोकन कॉन्टेक्स्ट विंडो सपोर्ट करता है, और मूल रूप से मल्टीमोडल है।
इस लेख में, मैं GLM-5.3-Flash की नई चीज़ों को कवर करूंगा—फ़ीचर्स पर नजर डालते हुए और बेंचमार्क्स को देखते हुए। मॉडल को एक्शन में देखने के लिए हमारा GLM-5.3-Flash ट्यूटोरियल ज़रूर देखें, जिसमें हम CrewAI के साथ इसका उपयोग करके एक मल्टी-एजेंटिक फ़ाइनेंशियल एनालिस्ट टीम बनाते हैं।
यदि आप इसकी तुलना उसी दिन शिप हुए दूसरे बजट-टियर मॉडल से करना चाहते हैं, तो हमारा Qwen3.8-Flash-Next गाइड देखें, और एक समान MoE मॉडल जिसे हमने लोकली चलाया, उसके लिए हमारा DeepSeek-V4-Flash-0731 चलाने वाला ट्यूटोरियल देखें।
GLM-5.3-Flash, GLM-5.3 फैमिली में Z.ai का किफायती मॉडल है, जो क्षमता में फुल-फैट GLM-5.3 फ्लैगशिप से नीचे है, लेकिन कीमत में उससे कहीं नीचे।
Artificial Analysis इसे 57 के इंटेलिजेंस इंडेक्स पर रेट करता है, जबकि GLM-5.3 के लिए यह 60 है।
ट्रेड-ऑफ स्पीड और लागत है: Flash लगभग GLM-5.2 की कीमत के दसवें हिस्से पर सर्व करता है, या GLM-5.3 की ब्लेंडेड कीमत के लगभग नौवें हिस्से पर, और प्रति टोकन धीमा चलता है।
मॉडल पहले एक अनाम प्रीव्यू के रूप में शिप हुआ, फिर नामकरण हुआ, और समुदाय ने जल्दी ही इसे "Ox Alpha" कोडनेम दे दिया।
पब्लिक चेकपॉइंट Hugging Face पर zai-org/GLM-5.3-Flash के रूप में उपलब्ध है, जिसमें लंबा कॉन्टेक्स्ट (~1M टोकन) सपोर्ट है, और टूल-कॉलिंग व मल्टीमोडल क्षमता आसपास के इकोसिस्टम के ज़रिए एक्सपोज़ होती है।
यहां सबसे अहम बेंचमार्क Terminal-Bench 2.1 है, जहां GLM-5.3-Flash 84.3 तक पहुंचता है। यह DeepSeek-V4-Flash-0731 के 82.7 से ऊपर है, और Claude Opus 4.8 से केवल 0.7 अंक पीछे। लगभग $0.10 प्रति 1M टोकन की ब्लेंडेड, उपयोग-वेटेड कीमत वाले मॉडल के लिए, यही इस रिलीज़ की कहानी है।
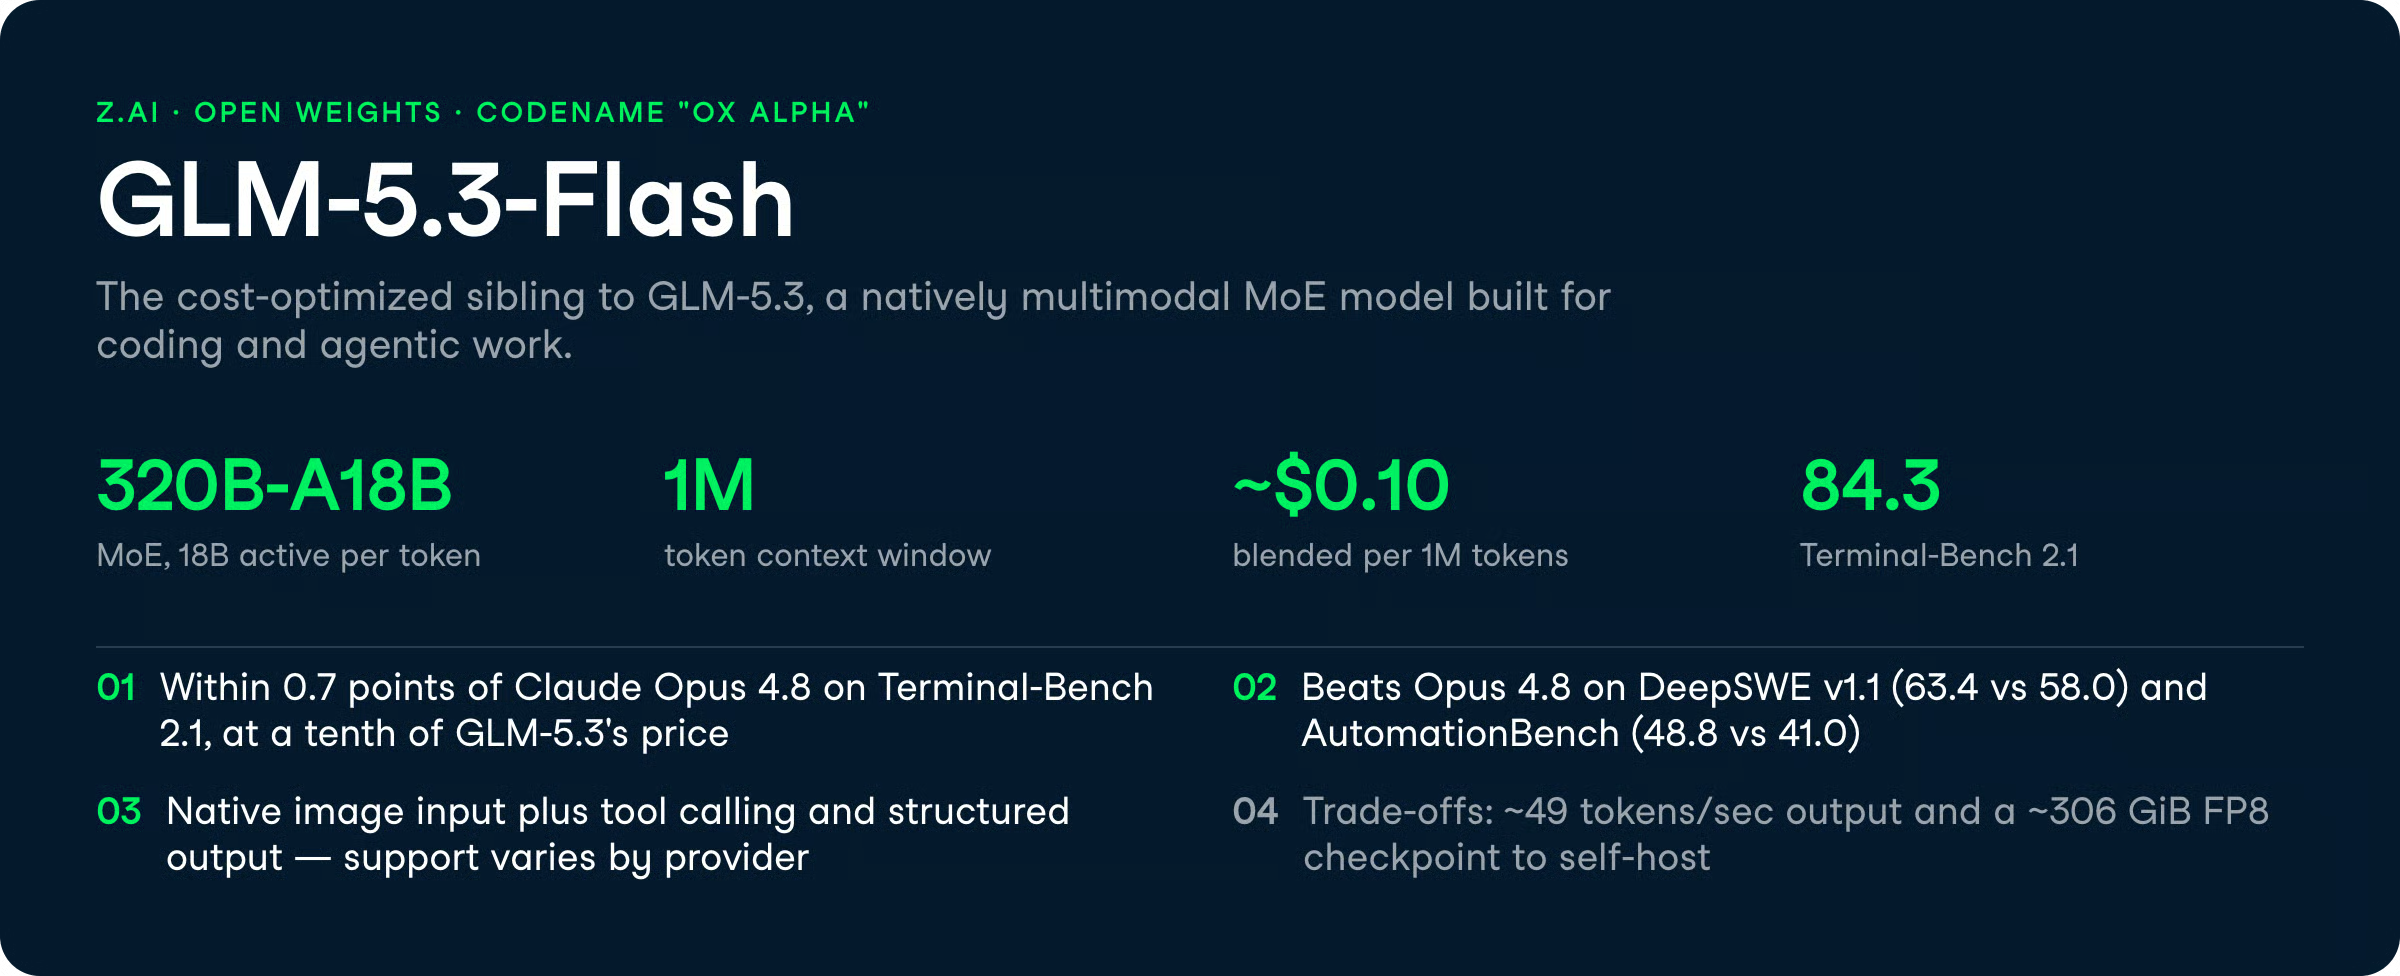
GLM-5.3-Flash उन डेवलपर्स के लिए बना है जो एजेंटिक और कोडिंग परफ़ॉर्मेंस चाहते हैं, लेकिन फ्लैगशिप कीमत नहीं।
व्यावहारिक काम के लिए जो क्षमताएं मायने रखती हैं, वे यहां हैं।
आप ऐसे प्राइस पॉइंट पर कोडिंग एजेंट्स और ऑटोमेशन वर्कफ़्लोज़ चला सकते हैं, जो हाई-वॉल्यूम उपयोग को यथार्थवादी बनाता है।
GLM-5.3-Flash Terminal-Bench 2.1 पर 84.3 और DeepSWE v1.1 पर 63.4 स्कोर करता है, जो GLM-5.2 के उसी DeepSWE इवैल पर 46.2 से तेज़ उछाल है।
प्रैक्टिशनर्स के लिए आकर्षण यह है कि ऐसे कोडिंग टास्क चलाए जा सकते हैं जो Opus-क्लास मॉडलों पर महंगे पड़ते।
कुछ तुलनाएं Flash को कोडिंग और ऑटोमेशन एजेंट्स के लिए "मज़बूत" बताती हैं, और GLM-5.2 पर DeepSWE का उछाल यह संकेत देता है कि सुधार बेंचमार्क-विशिष्ट नहीं बल्कि वास्तविक हैं।
आप पूरे कोडबेस, लंबे दस्तावेज़, या मल्टी-फ़ाइल एजेंट ट्रेसेज़ को एक ही रिक्वेस्ट में दे सकते हैं।
GLM-5.3-Flash 1M टोकन के कॉन्टेक्स्ट विंडो को सपोर्ट करता है, जो GLM-5.3 और GPT-5.6 Terra तथा Claude Sonnet 5 के 1M विंडो से मेल खाता है।
हालांकि, कुछ समुदाय रिपोर्ट्स ~700K टोकन से आगे अत्यधिक लंबाइयों पर attention "ड्रिफ्ट" का जिक्र करती हैं—यह सीमा बड़े कॉन्टेक्स्ट विंडो वाले अधिकतर समकक्षों में दिखती है।
सैकड़ों हज़ार टोकनों में अच्छा रिकॉल रिपोर्ट होता है, पर विंडो के अंतिम सिरे पर परफ़ेक्ट रिट्रीवल मानकर न चलें।
आप GLM-5.3-Flash को फंक्शन कॉल्स और लागू किए गए JSON स्कीमाज़ के साथ एजेंट फ़्रेमवर्क्स में वायर कर सकते हैं। मॉडल Toolathlon पर 78.4 और AutomationBench पर 48.8 स्कोर करता है—दूसरा, GLM-5.2 के 26.2 से बड़ा उछाल है।
एक बात ध्यान रखें: सपोर्ट प्रोवाइडर के अनुसार बदलता है।
कुछ गेटवे संरचित आउटपुट को असमर्थित मार्क करते हैं, और होस्टेड प्रोवाइडर्स के बीच सिस्टम प्रॉम्प्ट हैंडलिंग अलग हो सकती है—इसलिए आपको टूल स्कीमा और JSON मोड एंडपॉइंट के अनुसार एडजस्ट करने की ज़रूरत पड़ सकती है।
आप टेक्स्ट के साथ इमेज भी पास कर सकते हैं—चार्ट पढ़ने, दस्तावेज़ विश्लेषण, और विज़ुअल रीज़निंग के लिए।
GLM-5.3-Flash CharXiv-R पर 89.4%, MMVU पर 80.5, और Chartography पर 78.0 स्कोर करता है—ये ठोस चार्ट और विज़ुअल-डॉक्यूमेंट हैंडलिंग की ओर इशारा करते हैं।
मल्टीमोडल सपोर्ट मूल है, जोड़ा हुआ नहीं—हालांकि, टूल कॉलिंग की तरह इसकी सतह किस प्रोवाइडर का उपयोग करते हैं, उस पर निर्भर करती है। एक साधारण Hugging Face चेकआउट होस्टेड API जितना सब कुछ एक्सपोज़ न करे।
GLM-5.3-Flash, Artificial Analysis Intelligence Index v4.1.1 पर 57 स्कोर करता है, प्रति टास्क $0.045 (छूट के बाद) की लागत पर। Z.ai का कहना है कि पहले इस स्तर की इंटेलिजेंस की कीमत लगभग दस गुना थी।
नीचे दिया गया छह-बेंचमार्क मूल्यांकन Flash की तुलना GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra, और Gemini 3.7 Flash से करता है।
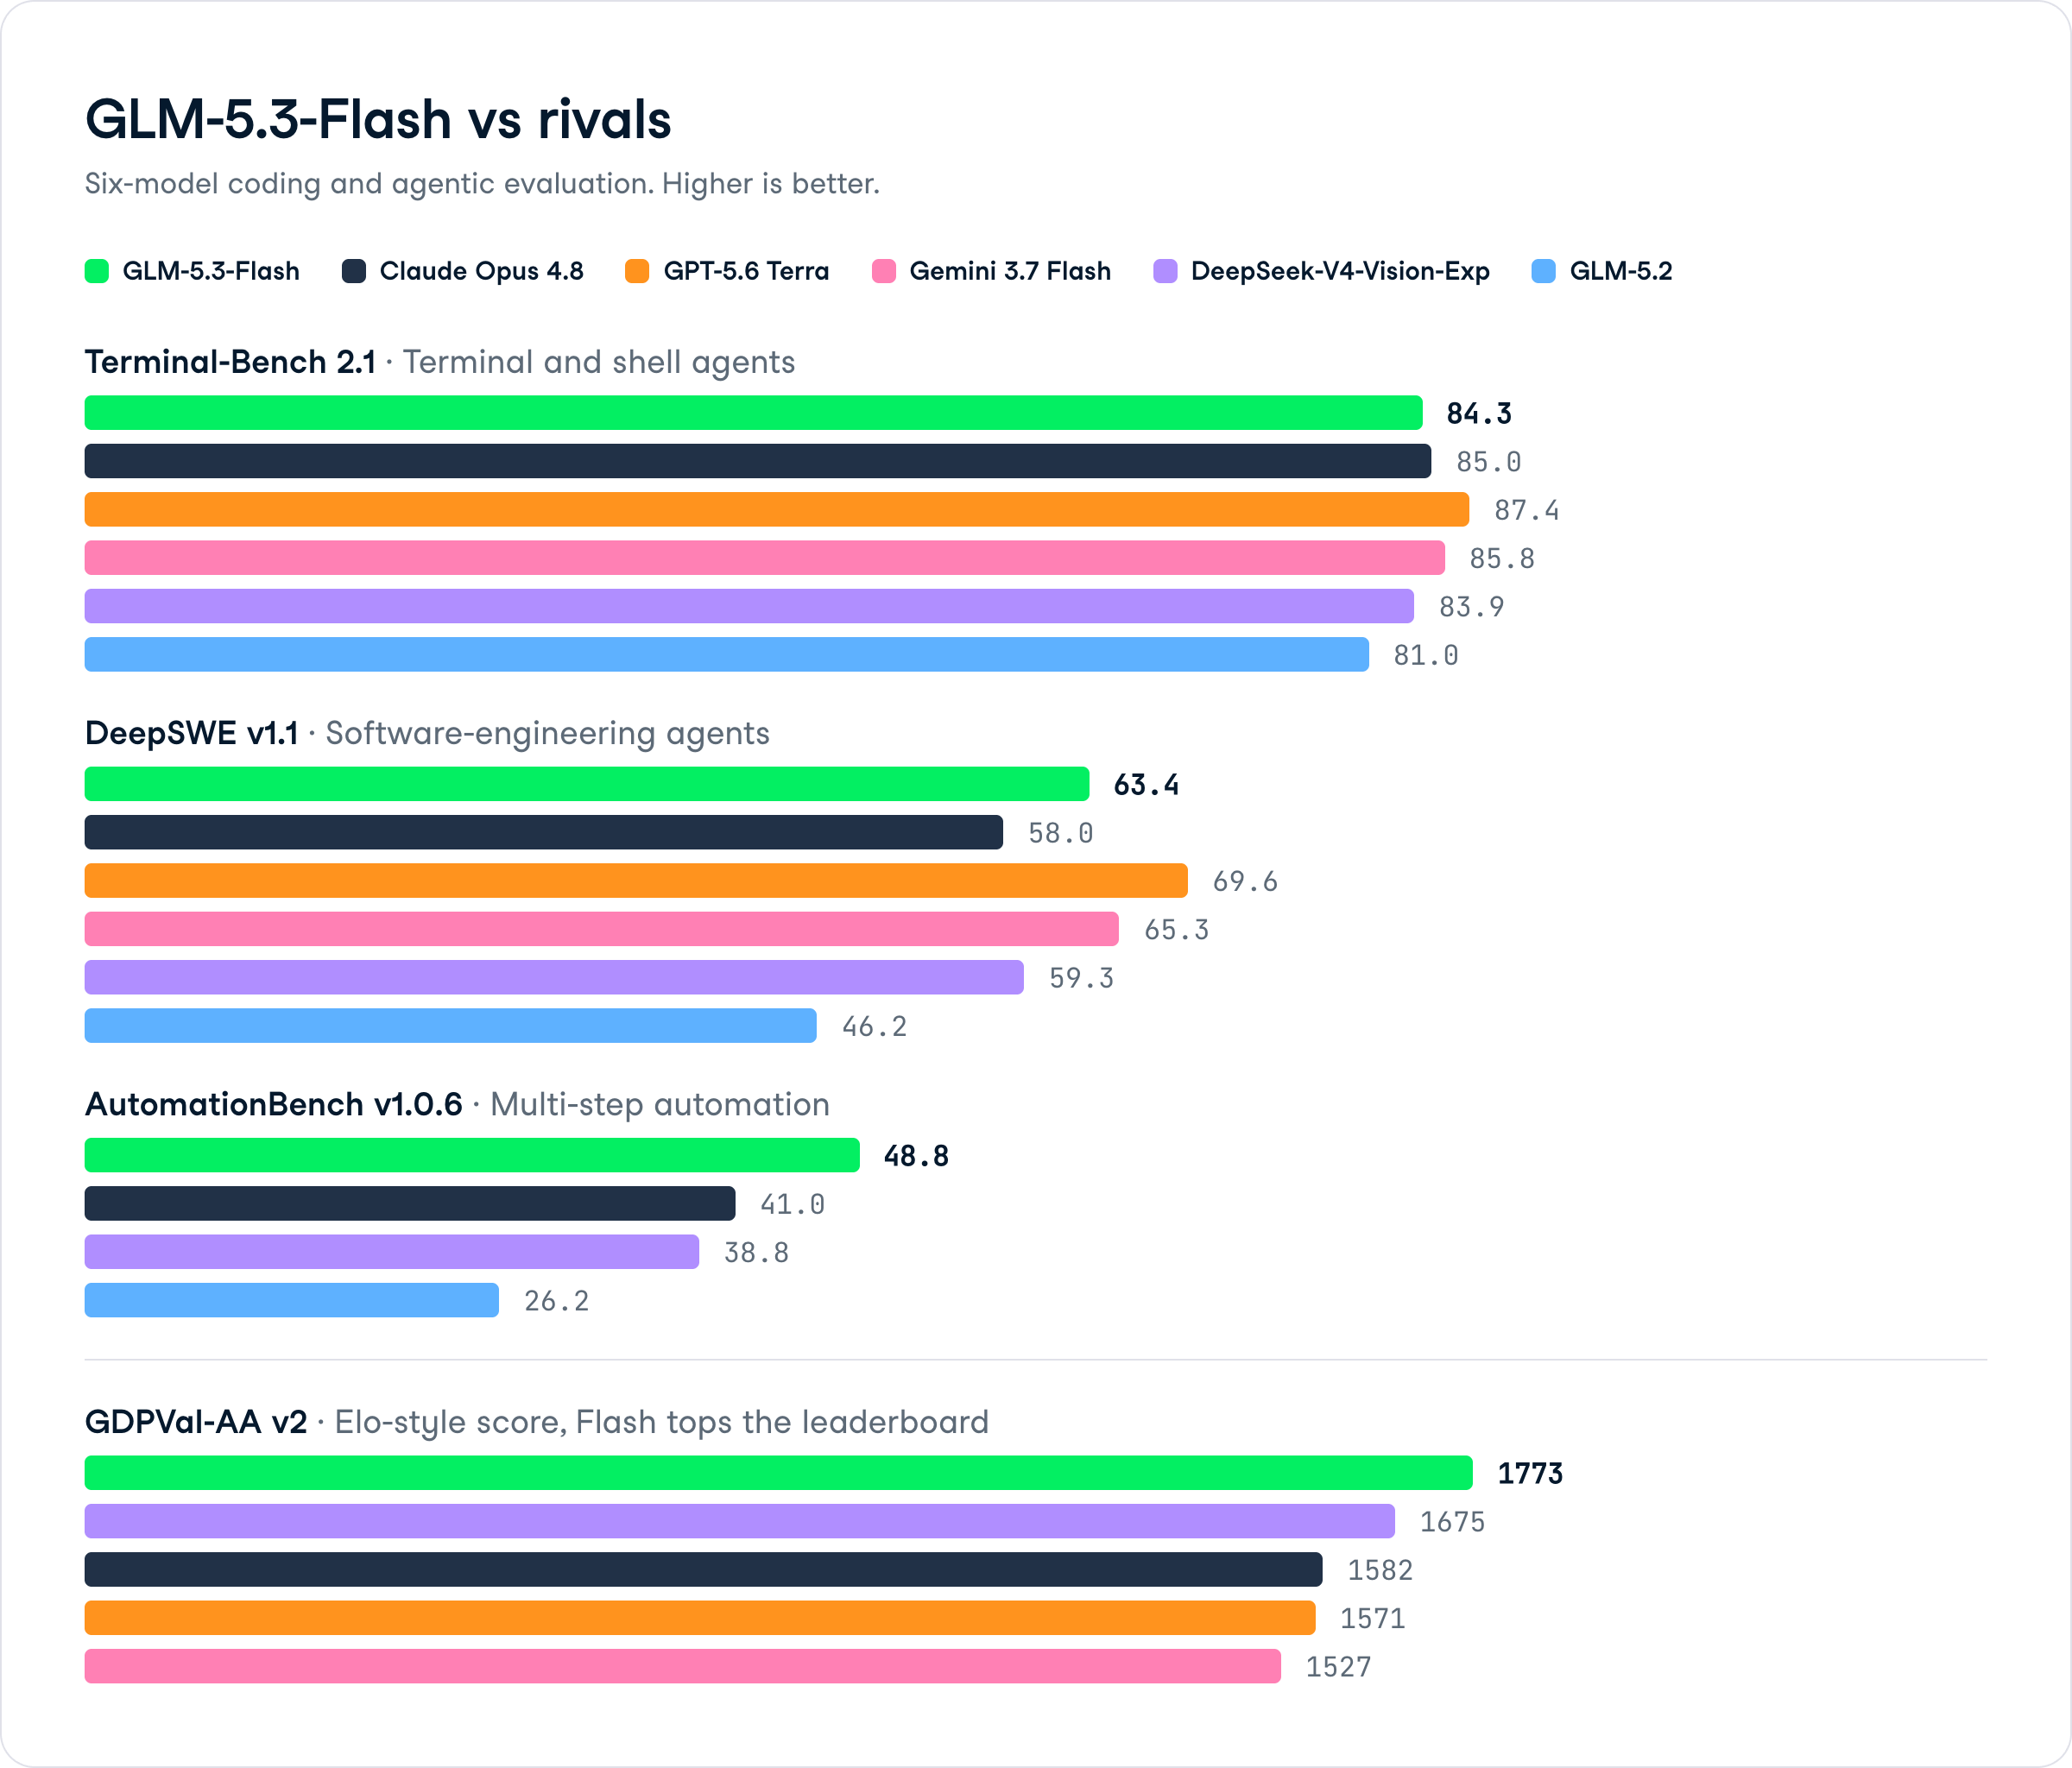
इस सॉफ्टवेयर-इंजीनियरिंग एजेंट बेंचमार्क पर, GLM-5.3-Flash 63.4 स्कोर करता है, Claude Opus 4.8 (58.0) और DeepSeek-V4-Vision-Exp (59.3) से आगे, और GLM-5.2 के 46.2 से ऊपर।
यह GPT-5.6 Terra (69.6) और Gemini 3.7 Flash (65.3) से पीछे है, लेकिन Flash लागत पर Claude को मात देना यहां व्यावहारिक हेडलाइन है।
GLM-5.3-Flash मल्टी-स्टेप ऑटोमेशन वर्कफ़्लोज़ पर 48.8 स्कोर करता है—सेट के किसी भी बेंचमार्क पर Claude Opus 4.8 (41.0) और DeepSeek-V4-Vision-Exp (38.8) पर सबसे बड़ी बढ़त।
GLM-5.2 ने 26.2 स्कोर किया था, इसलिए यह पीढ़ी-दर-पीढ़ी सबसे तेज़ सुधार भी है।
जनरल डेवलपमेंट और प्रोग्रामिंग इवैल्यूएशन पर, Flash 1773 के साथ लीडरबोर्ड में शीर्ष पर है, DeepSeek-V4-Vision-Exp (1675), Claude Opus 4.8 (1582), GPT-5.6 Terra (1571), और Gemini 3.7 Flash (1527) से आगे।
टर्मिनल और शेल एजेंट टास्क्स पर Flash 84.3 स्कोर करता है, Claude Opus 4.8 (85.0) और Gemini 3.7 Flash (85.8) से थोड़ा नीचे, और GPT-5.6 Terra (87.4) से पीछे। यह GLM-5.2 (81.0) और DeepSeek-V4-Vision-Exp (83.9) को पछाड़ता है। प्रतिस्पर्धी है, प्रभुत्वशाली नहीं।
GLM-5.3-Flash Z.ai के API और कई थर्ड-पार्टी गेटवे—जैसे Baseten, Deep Infra, Venice AI, और Requesty—के माध्यम से उपलब्ध है।
पब्लिक चेकपॉइंट zai-org/GLM-5.3-Flash सेल्फ-होस्टिंग के लिए Hugging Face पर है।
Z.ai की आधिकारिक बेस लिस्ट प्राइसिंग और सीमित अवधि का प्रमोशन इस प्रकार है:
Apidog लगभग $0.10 प्रति 1M टोकन की ब्लेंडेड, उपयोग-वेटेड कीमत रिपोर्ट करता है, जबकि GLM-5.3 के लिए यह लगभग $0.90 है।
थर्ड-पार्टी गेटवे अलग कीमत लगाते हैं: EmpirioLabs पर $0.07 इनपुट / $0.25 आउटपुट, Venice AI पर $0.09 / $0.31, और Requesty पर $0.14 / $0.45, जिसमें 9 सितम्बर 2026 तक 55% छूट का प्रमो नोटेड है।
कैच है थ्रूपुट और हार्डवेयर।
Flash ~49 टोकन/सेकंड पर सर्व करता है, जबकि GLM-5.3 ~86 पर, और Artificial Analysis इसे स्पीड पर 2/4 रेट करता है।
सेल्फ-होस्टिंग भी हल्की नहीं: FP8 चेकपॉइंट केवल वेट्स में ~306 GiB है—KV-कैश और रनटाइम से पहले—इसलिए एक कार्ड की बजाय कई हाई-मेमोरी GPUs (मान लें >4×80 GiB क्लास) की ज़रूरत होगी।
दोनों में चुनाव लागत बनाम इंटेलिजेंस इंडेक्स और थ्रूपुट पर टिकता है। नीचे की तालिका समझौते का सार देती है।
| गुण | GLM-5.3-Flash | GLM-5.3 |
|---|---|---|
| इंटेलिजेंस इंडेक्स (Artificial Analysis) | 57 | 60 |
| ब्लेंडेड कीमत / 1M टोकन | ~$0.10 | ~$0.90 |
| आउटपुट स्पीड | ~49 टोकन/सेकंड | ~86 टोकन/सेकंड |
| पहले टोकन तक समय | ~1.52 s | ~1.57 s |
| Terminal-Bench 2.1 | 84.3 | नोट्स में N/A |
| कॉन्टेक्स्ट विंडो | 1M | 1M |
जब आपकी बाधा cost-per-token हो और आपका काम कोडिंग या एजेंटिक हो, तो Flash चुनें। जब आपको अतिरिक्त इंटेलिजेंस इंडेक्स और लगभग दोगुना थ्रूपुट चाहिए, तो GLM-5.3 लें।
दोनों मॉडल 26 अगस्त 2026 को लॉन्च हुए, एक ही बजट-एजेंटिक टियर को लक्ष्य बनाकर। उनके बीच सीधे साझा बेंचमार्क (DeepSWE v1.1: 63.4 बनाम 58.7) पर GLM-5.3-Flash थोड़ा आगे है, पर दोनों मॉडल काफ़ी अलग ढंग से बने हैं—इसलिए चुनाव आपके वर्कलोड पर अधिक निर्भर करेगा, किसी एक स्कोर पर नहीं।
| GLM-5.3-Flash | Qwen3.8-Flash-Next | |
|---|---|---|
| आर्किटेक्चर | 320B कुल / 18B सक्रिय | 125B कुल / 6B सक्रिय |
| मूल कॉन्टेक्स्ट | 1M टोकन | 262K (YaRN के साथ 1M) |
| DeepSWE v1.1 | 63.4 | 58.7 |
| इनपुट कीमत | ~$0.075/1M (प्रमो) | $0.16/1M |
| मल्टीमोडल | हाँ (मूल) | हाँ (मूल) |
GLM-5.3-Flash प्रति टोकन तीन गुना अधिक पैरामीटर्स सक्रिय करता है, जो संभवतः DeepSWE बढ़त और Terminal-Bench 2.1 (84.3) के परिणाम की व्याख्या करता है।
Qwen3.8-Flash-Next SWE-bench Pro (62.5) और ऑफिस व एजेंट बेंचमार्क्स जैसे CoWorkBench (73.9) और JobBench (55.7) पर मज़बूत रिपोर्टेड स्कोर के साथ पलटवार करता है, जहाँ GLM तुलनीय आंकड़े प्रकाशित नहीं करता।
कीमत पर, प्रमोशनल विंडो के दौरान GLM सस्ता है। पैरामीटर एफिशिएंसी पर, Qwen छोटा सक्रिय फुटप्रिंट रखते हुए अधिक करता है। सेल्फ-होस्टिंग पर, Qwen का छोटा चेकपॉइंट लोकली चलाना कहीं आसान है।
यदि आपकी प्राथमिकता कोडिंग एजेंट्स और रॉ एजेंटिक थ्रूपुट है, तो GLM-5.3-Flash के पास उन जगहों पर मज़बूत नंबर हैं जहाँ सीधी तुलना संभव है। यदि आपके वर्कफ़्लो ऑफिस-हेवी, मल्टीमोडल हैं, या छोटे सेल्फ-होस्टेड चेकपॉइंट से लाभान्वित होते हैं, तो Qwen3.8-Flash-Next पहले टेस्ट करने योग्य है।
पूरे विवरण के लिए हमारा Qwen3.8-Flash-Next पर पूरा गाइड देखें।
GLM-5.3-Flash बजट-एजेंटिक सेगमेंट पर Z.ai की स्पष्ट बाज़ी है: कोडिंग इवैल्स पर Opus 4.8 और GPT-5.6 Terra के एक-आध अंक के भीतर पहुंचना, फिर कीमत में एक ऑर्डर ऑफ मैग्निट्यूड सस्ता होना।
लगभग $0.10 ब्लेंडेड प्रति 1M टोकन पर Terminal-Bench 2.1 का 84.3 ही इसकी पिच है—और हाई-वॉल्यूम कोडिंग व ऑटोमेशन के लिए यह मज़बूत है।
सीमाएं स्पीड और इन्फ्रास्ट्रक्चर के साथ आती हैं।
~49 टोकन/सेकंड पर यह लेटेंसी-सेंसिटिव स्ट्रीमिंग के लिए सही मॉडल नहीं है, और ~306 GiB का FP8 चेकपॉइंट कैज़ुअल लोकल डिप्लॉयमेंट को बाहर कर देता है। r/opencodeCLI पर शुरुआती प्रीव्यू यूज़र्स ने लोड के दौरान क्यू टाइम्स और धीमी शुरुआत रिपोर्ट की थी, हालांकि GA के बाद इसमें संभवतः सुधार हुआ है।
मेरा मानना है कि जब आपकी बाधा cost-per-token हो और आपका काम कोडिंग या एजेंटिक हो, तो कमिट करने से पहले GLM-5.3-Flash को GPT-5.6 Terra और Claude Opus 4.8 के खिलाफ टेस्ट करना चाहिए।
यदि आपको इंटेलिजेंस इंडेक्स के अतिरिक्त 3 अंक और तेज़ थ्रूपुट चाहिए, तो पूरा GLM-5.3 उसी कारण से मौजूद है। यह Qwen3.8-Flash-Next के साथ उसी दिन लैंड करता है, इसलिए अभी बजट टियर में विकल्पों की तुलना करना सार्थक है।
ऐसे मॉडलों के साथ काम करने में सहज होने के लिए, मैं हमारे AI Fundamentals स्किल ट्रैक से बुनियाद बनाने, फिर हमारे लोकली MoE Flash मॉडल चलाने वाले ट्यूटोरियल से हैंड्स-ऑन करने की सलाह देता हूँ।
शीर्ष DataCamp कोर्स
कोर्स
कोर्स
कोर्स