Last chance! 50% off DataCamp Premium
Sale ends in
LLM डिस्टिलेशन एक तकनीक है जो बड़े भाषा मॉडल के प्रदर्शन को उसके आकार और कम्प्यूटेशनल आवश्यकताओं को घटाते हुए पुनरुत्पादित करने का प्रयास करती है।
कल्पना कीजिए एक अनुभवी प्रोफेसर अपना अनुभव एक नए विद्यार्थी के साथ साझा कर रहे हैं। प्रोफेसर, जो टीचर मॉडल का प्रतिनिधित्व करते हैं, जटिल अवधारणाएँ और अंतर्दृष्टियाँ बताते हैं, जबकि स्टूडेंट मॉडल इन शिक्षाओं की नकल अधिक सरल और कुशल तरीके से करना सीखता है।
यह प्रक्रिया न केवल शिक्षक की मूल क्षमताओं को बनाए रखती है बल्कि स्टूडेंट को तेज़ और अधिक बहुमुखी अनुप्रयोगों के लिए अनुकूलित भी करती है।
बड़े भाषा मॉडलों का बढ़ता आकार और कम्प्यूटेशनल आवश्यकताएँ इनके व्यापक अपनाव और डिप्लॉयमेंट में बाधा बनती हैं। हाई-परफॉर्मेंस हार्डवेयर और बढ़ती ऊर्जा खपत अक्सर इन मॉडलों की पहुँच सीमित कर देती हैं, खासकर सीमित संसाधनों वाले परिवेश जैसे मोबाइल डिवाइस या एज कंप्यूटिंग प्लेटफ़ॉर्म में।
LLM डिस्टिलेशन इन चुनौतियों का समाधान छोटे और तेज़ मॉडलों का निर्माण करके करता है, जिससे उन्हें विभिन्न डिवाइस और प्लेटफ़ॉर्म पर एकीकृत करना आदर्श बन जाता है।
यह नवाचार उन्नत AI की पहुँच का लोकतंत्रीकरण ही नहीं करता, बल्कि रीयल-टाइम अनुप्रयोगों को भी समर्थन देता है जहाँ गति और दक्षता अत्यंत महत्वपूर्ण हैं। अधिक सुलभ और स्केलेबल AI समाधान सक्षम करके, LLM डिस्टिलेशन AI तकनीकों के व्यावहारिक कार्यान्वयन को आगे बढ़ाने में मदद करता है।
LLM डिस्टिलेशन प्रक्रिया में कई तकनीकें शामिल होती हैं जो सुनिश्चित करती हैं कि स्टूडेंट मॉडल अधिक कुशलता से कार्य करते हुए भी प्रमुख जानकारी बनाए रखे। यहाँ हम उन प्रमुख तंत्रों का अन्वेषण करते हैं जो इस नॉलेज ट्रांसफ़र को प्रभावी बनाते हैं।
LLM डिस्टिलेशन के केंद्र में टीचर-स्टूडेंट पैराडाइम होता है, जो नॉलेज ट्रांसफ़र प्रक्रिया को आगे बढ़ाने वाली बुनियादी अवधारणा है। इस सेटअप में, एक बड़ा, अधिक उन्नत मॉडल एक छोटे, हल्के मॉडल को अपना ज्ञान देता है।
टीचर मॉडल, जो अक्सर व्यापक प्रशिक्षण और कम्प्यूटेशनल संसाधनों वाला अत्याधुनिक भाषा मॉडल होता है, जानकारी का समृद्ध स्रोत होता है। दूसरी ओर, स्टूडेंट टीचर के व्यवहार की नकल करके और उसके ज्ञान को आत्मसात करके सीखने के लिए डिज़ाइन किया गया होता है।
स्टूडेंट मॉडल का प्राथमिक कार्य टीचर के आउटपुट्स को दोहराना है, जबकि आकार में बहुत छोटा और कम्प्यूटेशनल मांगों में कम रहना है। इस प्रक्रिया में स्टूडेंट विभिन्न इनपुट्स पर टीचर की भविष्यवाणियाँ, समायोजन और प्रतिक्रियाओं को देखकर सीखता है।
ऐसा करने से स्टूडेंट तुलनीय स्तर का प्रदर्शन और समझ हासिल कर सकता है, जिससे वह सीमित संसाधन वाले परिवेश में डिप्लॉयमेंट के लिए उपयुक्त बनता है।
टीचर से स्टूडेंट तक ज्ञान स्थानांतरित करने के लिए विभिन्न डिस्टिलेशन तकनीकों का उपयोग किया जाता है। ये तरीके सुनिश्चित करते हैं कि स्टूडेंट मॉडल न केवल कुशलता से सीखे बल्कि टीचर मॉडल के आवश्यक ज्ञान और क्षमताओं को भी बनाए रखे। यहाँ LLM डिस्टिलेशन में उपयोग की जाने वाली कुछ प्रमुख तकनीकें दी गई हैं।
LLM डिस्टिलेशन की सबसे उल्लेखनीय तकनीकों में से एक नॉलेज डिस्टिलेशन (KD) है। KD में, स्टूडेंट मॉडल को टीचर मॉडल के आउटपुट प्रॉबेबिलिटीज, जिन्हें सॉफ्ट टार्गेट्स कहा जाता है, के साथ-साथ ग्राउंड ट्रुथ लेबल्स, जिन्हें हार्ड टार्गेट्स कहा जाता है, का उपयोग करके प्रशिक्षित किया जाता है।
सॉफ्ट टार्गेट्स टीचर की भविष्यवाणियों का एक सूक्ष्म दृष्टिकोण प्रदान करते हैं, जो केवल एक सही उत्तर के बजाय संभावित आउटपुट्स पर प्रायिकता वितरण देते हैं। यह अतिरिक्त जानकारी स्टूडेंट मॉडल को टीचर की प्रतिक्रियाओं में निहित सूक्ष्म पैटर्न और जटिल ज्ञान को पकड़ने में मदद करती है।
सॉफ्ट टार्गेट्स का उपयोग करके, स्टूडेंट मॉडल टीचर की निर्णय लेने की प्रक्रिया को बेहतर ढंग से समझ सकता है, जिससे अधिक सटीक और विश्वसनीय प्रदर्शन मिलता है। यह दृष्टिकोण न केवल टीचर के महत्वपूर्ण ज्ञान को संरक्षित करता है बल्कि स्टूडेंट के लिए प्रशिक्षण प्रक्रिया को अधिक सुचारु और प्रभावी भी बनाता है।
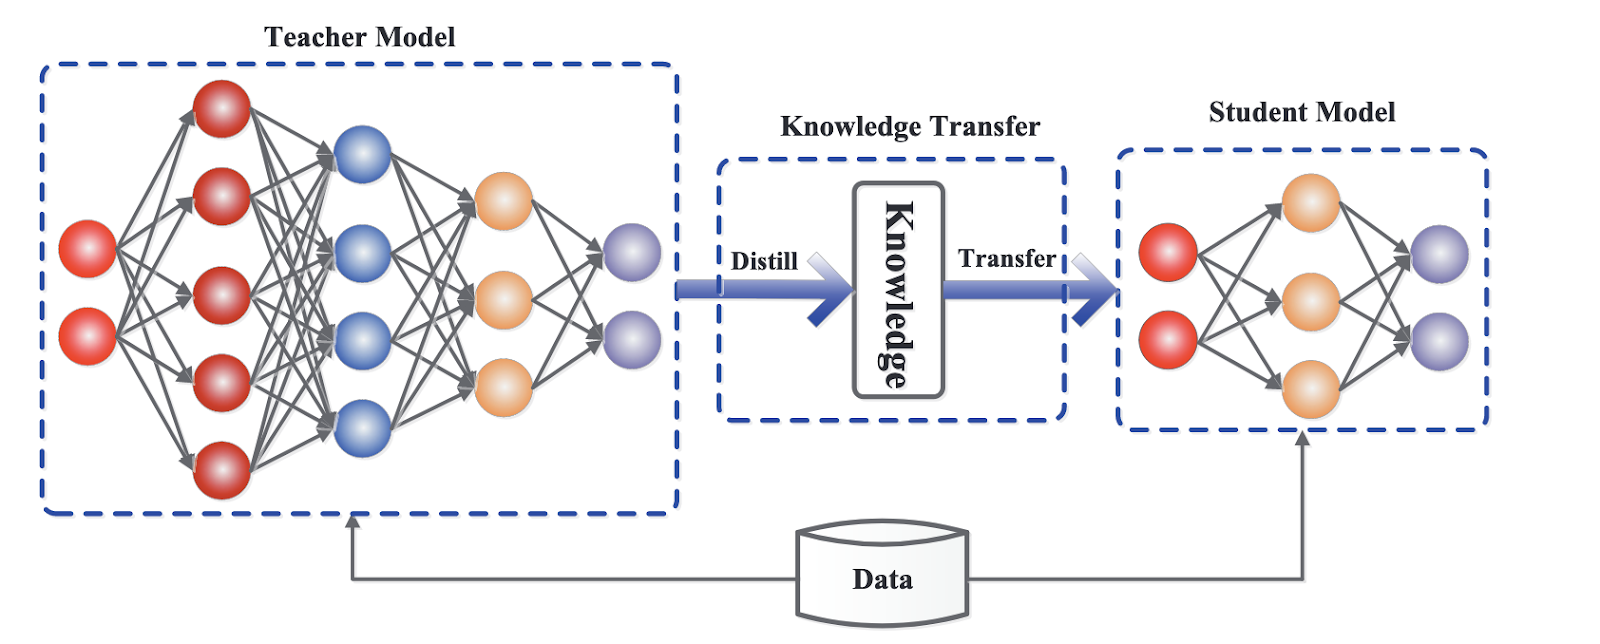
नॉलेज डिस्टिलेशन के लिए सामान्य फ्रेमवर्क। स्रोत
KD के अलावा, कई अन्य तकनीकें LLM डिस्टिलेशन प्रक्रिया को बेहतर बना सकती हैं:
LLM डिस्टिलेशन ऐसे कई महत्वपूर्ण लाभ प्रदान करता है जो भाषा मॉडलों की उपयोगिता और दक्षता को बढ़ाते हैं, उन्हें विविध अनुप्रयोगों के लिए अधिक व्यावहारिक बनाते हैं।
यहाँ हम कुछ प्रमुख फ़ायदों का अन्वेषण करते हैं।
LLM डिस्टिलेशन का एक प्रमुख लाभ उल्लेखनीय रूप से छोटे मॉडलों का निर्माण है। बड़े टीचर मॉडल से छोटे स्टूडेंट मॉडल में ज्ञान स्थानांतरित करके, परिणामी स्टूडेंट अपने आकार का एक अंश होते हुए भी टीचर की अधिकांश क्षमताएँ बनाए रखता है।
मॉडल आकार में यह कमी निम्नलिखित की ओर ले जाती है:
डिस्टिल्ड मॉडलों का छोटा आकार सीधे बेहतर इनफ़रेंस स्पीड में अनुवादित होता है। यह विशेष रूप से उन अनुप्रयोगों के लिए महत्वपूर्ण है जिन्हें रीयल-टाइम प्रोसेसिंग और त्वरित प्रतिक्रियाओं की आवश्यकता होती है।
यह लाभ इस प्रकार दिखता है:
LLM डिस्टिलेशन का एक और उल्लेखनीय लाभ कम्प्यूटेशनल लागत में कमी है। छोटे मॉडल चलाने के लिए कम कम्प्यूटेशनल शक्ति की आवश्यकता होती है, जो कई क्षेत्रों में लागत बचत की ओर ले जाती है:
डिस्टिल्ड LLM अधिक बहुमुखी और सुलभ होते हैं, जिससे उन्हें विभिन्न प्लेटफ़ॉर्म पर डिप्लॉय करना संभव हो जाता है। इस विस्तारित पहुँच के कई निहितार्थ हैं:
LLM डिस्टिलेशन के लाभ केवल मॉडल दक्षता और लागत बचत तक सीमित नहीं हैं। डिस्टिल्ड भाषा मॉडल नेचुरल लैंग्वेज प्रोसेसिंग (NLP) के व्यापक कार्यों और उद्योग-विशिष्ट उपयोग मामलों में लागू किए जा सकते हैं, जिससे विभिन्न क्षेत्रों में AI समाधान सुलभ होते हैं।
डिस्टिल्ड LLM कई नेचुरल लैंग्वेज प्रोसेसिंग कार्यों में उत्कृष्ट प्रदर्शन करते हैं। उनका घटा हुआ आकार और बढ़ा हुआ प्रदर्शन उन्हें रीयल-टाइम प्रोसेसिंग और कम कम्प्यूटेशनल शक्ति की आवश्यकता वाले कार्यों के लिए आदर्श बनाता है।
डिस्टिल्ड LLM छोटे, तेज़ चैटबॉट्स के विकास को सक्षम बनाते हैं जो ग्राहक सेवा और सहायता कार्यों को सहजता से संभाल सकते हैं। ये चैटबॉट्स रीयल-टाइम में उपयोगकर्ता प्रश्नों को समझकर उत्तर दे सकते हैं, बिना व्यापक कंप्यूटिंग की आवश्यकता के निर्बाध अनुभव प्रदान करते हैं।
डिस्टिल्ड LLM द्वारा संचालित समरीकरण टूल्स समाचार लेखों, दस्तावेज़ों या सोशल मीडिया फ़ीड्स को संक्षिप्त सारांशों में समेट सकते हैं। यह उपयोगकर्ताओं को लंबे टेक्स्ट पढ़े बिना मुख्य बिंदु जल्दी समझने में मदद करता है।
डिस्टिल्ड मॉडल विभिन्न डिवाइस पर अनुवाद सेवाओं को तेज़ और अधिक सुलभ बनाते हैं। उन्हें मोबाइल फ़ोन, टैबलेट और यहाँ तक कि ऑफ़लाइन ऐप्लिकेशन्स पर भी डिप्लॉय किया जा सकता है, कम लेटेंसी और कम्प्यूटेशनल ओवरहेड के साथ रीयल-टाइम अनुवाद प्रदान करते हुए।
डिस्टिल्ड LLM न केवल सामान्य NLP कार्यों के लिए मूल्यवान हैं बल्कि उन विशिष्ट क्षेत्रों में भी उत्कृष्ट हैं जिनमें तेज़ प्रोसेसिंग और सटीक परिणामों की आवश्यकता होती है।
डिस्टिल्ड LLM केवल सामान्य NLP कार्यों तक सीमित नहीं हैं। वे प्रक्रियाओं और उपयोगकर्ता अनुभवों में सुधार करके और नवाचार को आगे बढ़ाकर कई उद्योगों को प्रभावित कर सकते हैं।
हेल्थकेयर उद्योग में, डिस्टिल्ड LLM रोगी रिकॉर्ड्स और डायग्नोस्टिक डेटा को अधिक कुशलता से प्रोसेस कर सकते हैं, जिससे तेज़ और अधिक सटीक निदान संभव होता है। ये मॉडल मेडिकल डिवाइसों में डिप्लॉय किए जा सकते हैं, डॉक्टरों और स्वास्थ्य पेशेवरों को रीयल-टाइम डेटा विश्लेषण और निर्णय लेने में सहायता प्रदान करते हुए।
वित्तीय क्षेत्र को डिस्टिल्ड मॉडलों से उन्नत फ्रॉड डिटेक्शन सिस्टम्स और कस्टमर इंटरैक्शन मॉडलों के माध्यम से लाभ मिलता है। लेनदेन पैटर्न और ग्राहक प्रश्नों को तेज़ी से समझकर, डिस्टिल्ड LLM धोखाधड़ी गतिविधियों को रोकने और व्यक्तिगत वित्तीय सलाह व सहायता प्रदान करने में मदद करते हैं।
शिक्षा में, डिस्टिल्ड LLM अनुकूली लर्निंग सिस्टम्स और व्यक्तिगत ट्यूशन प्लेटफ़ॉर्म के निर्माण को सुगम बनाते हैं। ये सिस्टम छात्र प्रदर्शन का विश्लेषण कर अनुकूलित शैक्षणिक सामग्री प्रदान कर सकते हैं, जिससे सीखने के परिणाम बेहतर होते हैं और शिक्षा अधिक सुलभ व प्रभावकारी बनती है।
LLM डिस्टिलेशन को लागू करने में कई चरण शामिल होते हैं और प्रक्रिया को सरल बनाने के लिए विशेष फ्रेमवर्क्स व लाइब्रेरीज़ का उपयोग किया जाता है। यहाँ हम एक बड़े भाषा मॉडल को डिस्टिल करने के लिए आवश्यक टूल्स और चरणों का अन्वेषण करते हैं।
डिस्टिलेशन प्रक्रिया को सुव्यवस्थित करने के लिए कुछ फ्रेमवर्क्स और लाइब्रेरीज़ उपलब्ध हैं, जिनमें से प्रत्येक LLM डिस्टिलेशन को समर्थन देने के लिए विशिष्ट सुविधाएँ प्रदान करता है।
Hugging Face transformers लाइब्रेरी LLM डिस्टिलेशन को लागू करने के लिए एक लोकप्रिय टूल है। इसमें Distiller क्लास शामिल है जो टीचर मॉडल से स्टूडेंट मॉडल तक ज्ञान के स्थानांतरण की प्रक्रिया को सरल बनाती है।
Distiller क्लास का उपयोग करके, प्रैक्टिशनर्स प्री-ट्रेंड मॉडलों का लाभ उठा सकते हैं, उन्हें विशिष्ट डेटासेट्स पर फाइन-ट्यून कर सकते हैं, और इष्टतम परिणाम पाने के लिए डिस्टिलेशन तकनीकों को अपना सकते हैं।
Hugging Face Transformers के अलावा, कई अन्य लाइब्रेरीज़ LLM डिस्टिलेशन का समर्थन करती हैं:
Distiller डीप लर्निंग मॉडलों को कम्प्रेस करने के लिए डिज़ाइन किया गया है, जिसमें डिस्टिलेशन तकनीकों के लिए समर्थन शामिल है। यह डिस्टिलेशन प्रक्रिया को प्रबंधित करने और मॉडल दक्षता में सुधार करने के लिए कई यूटिलिटीज़ प्रदान करता है।LLM डिस्टिलेशन को लागू करने के लिए सावधानीपूर्वक योजना और निष्पादन आवश्यक है। प्रक्रिया में शामिल मुख्य चरण इस प्रकार हैं।
डिस्टिलेशन प्रक्रिया का पहला चरण स्टूडेंट मॉडल को प्रशिक्षित करने के लिए उपयुक्त डेटासेट तैयार करना है। डेटासेट उन कार्यों का प्रतिनिधि होना चाहिए जो मॉडल करेगा, ताकि स्टूडेंट मॉडल अच्छी तरह जनरलाइज़ करना सीखे।
डेटा ऑग्मेंटेशन तकनीकें भी डेटासेट को समृद्ध कर सकती हैं, स्टूडेंट मॉडल को सीखने के लिए उदाहरणों की व्यापक रेंज प्रदान करते हुए।
सफल डिस्टिलेशन के लिए उपयुक्त टीचर मॉडल का चयन आवश्यक है। टीचर मॉडल ऐसा प्री-ट्रेंड मॉडल होना चाहिए जो लक्षित कार्यों पर उच्च स्तर की शुद्धता के साथ अच्छा प्रदर्शन करता हो। टीचर मॉडल की गुणवत्ता और विशेषताएँ सीधे स्टूडेंट मॉडल के प्रदर्शन को प्रभावित करती हैं।
डिस्टिलेशन प्रक्रिया में निम्नलिखित चरण शामिल हैं:
डिस्टिल्ड मॉडल के प्रदर्शन का मूल्यांकन करना आवश्यक है ताकि यह सुनिश्चित हो सके कि वह वांछित मानदंडों को पूरा करता है। सामान्य मूल्यांकन मेट्रिक्स में शामिल हैं:
मैं LLM मूल्यांकन को इस लेख में और विस्तार से कवर करता/करती हूँ: LLM Evaluation: Metrics, Methodologies, Best Practices.
हालाँकि LLM डिस्टिलेशन कई लाभ प्रदान करता है, सफल इम्प्लीमेंटेशन सुनिश्चित करने के लिए इसमें कुछ चुनौतियों का समाधान करना भी आवश्यक है।
LLM डिस्टिलेशन में प्रमुख बाधाओं में से एक ज्ञान ह्रास की संभावना है। डिस्टिलेशन के दौरान, टीचर मॉडल की कुछ सूक्ष्म जानकारी और फ़ीचर्स स्टूडेंट मॉडल द्वारा पूरी तरह कैप्चर नहीं हो पाते, जिससे प्रदर्शन में कमी आ सकती है। यह समस्या विशेष रूप से उन कार्यों में अधिक स्पष्ट हो सकती है जिनमें गहरी समझ या विशिष्ट ज्ञान की आवश्यकता होती है।
ज्ञान ह्रास को कम करने के लिए हम कुछ रणनीतियाँ अपना सकते हैं:
डिस्टिलेशन की सफलता के लिए सावधानीपूर्वक हाइपरपैरामीटर ट्यूनिंग महत्वपूर्ण है। तापमान और लर्निंग रेट जैसे प्रमुख हाइपरपैरामीटर्स टीचर से सीखने की स्टूडेंट मॉडल की क्षमता को काफी हद तक प्रभावित करते हैं:
डिस्टिल्ड मॉडल की प्रभावशीलता का मूल्यांकन करना अपरिहार्य कदम है ताकि यह गारंटी हो सके कि वह वांछित प्रदर्शन मानदंडों को पूरा करता है, विशेषकर अपने पूर्ववर्तियों और विकल्पों की तुलना में। इसमें स्टूडेंट के प्रदर्शन की तुलना टीचर और अन्य बेसलाइन्स से करना शामिल है, ताकि समझा जा सके कि डिस्टिलेशन प्रक्रिया ने मॉडल की कार्यक्षमता को कितनी अच्छी तरह संरक्षित या उन्नत किया है।
डिस्टिल्ड मॉडल की प्रभावशीलता को मापने के लिए निम्न मेट्रिक्स पर ध्यान केंद्रित करना महत्वपूर्ण है:
सर्वोत्तम अभ्यासों का पालन करने से LLM डिस्टिलेशन की प्रभावशीलता बढ़ सकती है। ये दिशानिर्देश प्रयोग, सतत मूल्यांकन और रणनीतिक इम्प्लीमेंटेशन पर ज़ोर देते हैं।
LLM डिस्टिलेशन का क्षेत्र तेज़ी से विकसित हो रहा है। यह अनुभाग नवीनतम रुझानों, वर्तमान शोध चुनौतियों और उभरती तकनीकों का अन्वेषण करता है।
हाल के शोध LLM डिस्टिलेशन की दक्षता और प्रभावशीलता बढ़ाने के लिए नई तकनीकों और आर्किटेक्चर्स के विकास पर केंद्रित रहे हैं। कुछ उल्लेखनीय प्रगतियाँ शामिल हैं:
काफी प्रगति के बावजूद, LLM डिस्टिलेशन के क्षेत्र में कई चुनौतियाँ और खुले शोध प्रश्न बने हुए हैं:
इन चुनौतियों का समाधान करने और क्षेत्र को आगे बढ़ाने के लिए लगातार उभरती तकनीकें और नवाचार विकसित किए जा रहे हैं। कुछ आशाजनक दृष्टिकोण हैं:
LLM डिस्टिलेशन बड़े भाषा मॉडलों को अधिक व्यावहारिक और कुशल बनाने की एक केंद्रीय तकनीक है। जटिल टीचर मॉडल से आवश्यक ज्ञान को छोटे स्टूडेंट मॉडल में स्थानांतरित करके, डिस्टिलेशन आकार और कम्प्यूटेशनल मांगों को घटाते हुए प्रदर्शन को संरक्षित रखता है।
यह प्रक्रिया विभिन्न उद्योगों में तेज़ और अधिक सुलभ AI अनुप्रयोगों को सक्षम बनाती है—रीयल-टाइम NLP कार्यों से लेकर हेल्थकेयर और वित्त जैसे विशिष्ट उपयोग मामलों तक। LLM डिस्टिलेशन को लागू करने में सावधानीपूर्वक योजना और सही टूल्स की आवश्यकता होती है, लेकिन लागत में कमी और व्यापक डिप्लॉयमेंट जैसे लाभ महत्वपूर्ण हैं।
जैसे-जैसे अनुसंधान आगे बढ़ता है, LLM डिस्टिलेशन AI का लोकतंत्रीकरण करने में बढ़ती महत्वपूर्ण भूमिका निभाएगा, जिससे शक्तिशाली मॉडल विविध संदर्भों में अधिक सुलभ और उपयोगी बन सकेंगे।
इन कोर्सेज़ के साथ LLMs के बारे में जानें!
कोर्स
कोर्स
कोर्स