course
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
109.7K
ट्रांसफ़ॉर्मर्स को पहले अनुक्रम रूपांतरण या न्यूरल मशीन अनुवाद की समस्या हल करने के लिए विकसित किया गया था—अर्थात् वे ऐसे किसी भी कार्य के लिए बनाए गए हैं जिसमें इनपुट अनुक्रम को आउटपुट अनुक्रम में बदला जाता है। इसी कारण इन्हें “Transformers” कहा जाता है।
पर शुरुआत से शुरू करें।
ट्रांसफ़ॉर्मर मॉडल एक न्यूरल नेटवर्क है जो क्रमिक डेटा का संदर्भ सीखता है और उससे नया डेटा जनरेट करता है।
सरल शब्दों में:
ट्रांसफ़ॉर्मर कृत्रिम बुद्धिमत्ता का ऐसा मॉडल है जो बड़े पैमाने पर पाठ डेटा में पैटर्न का विश्लेषण करके मानव-जैसा पाठ समझना और उत्पन्न करना सीखता है।
ट्रांसफ़ॉर्मर्स वर्तमान समय के अत्याधुनिक NLP मॉडल हैं और एन्कोडर–डीकोडर आर्किटेक्चर का विकसित रूप माने जाते हैं। किंतु जहाँ एन्कोडर–डीकोडर आर्किटेक्चर क्रमिक जानकारी निकालने के लिए मुख्यतः Recurrent Neural Networks (RNNs) पर निर्भर करता है, वहीं ट्रांसफ़ॉर्मर्स में यह रिकरेंस बिल्कुल नहीं होती।
तो फिर वे यह कैसे करते हैं?
ये विशेष रूप से अलग-अलग तत्वों के संबंधों का विश्लेषण करके संदर्भ और अर्थ समझने के लिए डिज़ाइन किए गए हैं, और इसके लिए लगभग पूरी तरह attention नामक गणितीय तकनीक पर निर्भर रहते हैं।
चित्र: लेखक द्वारा।
2017 में Google के एक शोध पत्र से उत्पन्न, ट्रांसफ़ॉर्मर मॉडल मशीन लर्निंग क्षेत्र के सबसे हालिया और प्रभावशाली विकासों में से हैं। पहला ट्रांसफ़ॉर्मर मॉडल "Attention is All You Need" नामक प्रभावशाली पेपर में समझाया गया था।
यह अग्रणी अवधारणा केवल सैद्धांतिक प्रगति नहीं रही, बल्कि TensorFlow के Tensor2Tensor पैकेज में व्यावहारिक रूप से लागू भी हुई। आगे, Harvard NLP समूह ने पेपर की एनोटेटेड गाइड और उसके साथ PyTorch इम्प्लीमेंटेशन उपलब्ध कराया। आप हमारे अलग ट्यूटोरियल में स्क्रैच से ट्रांसफ़ॉर्मर इम्प्लीमेंट करना सीख सकते हैं।
उनके परिचय ने इस क्षेत्र में तीव्र उछाल लाया, जिसे अक्सर Transformer AI कहा जाता है। इस क्रांतिकारी मॉडल ने BERT सहित बड़े भाषा मॉडलों में आगे की प्रगति की नींव रखी। 2018 तक, इन्हें NLP में मील का पत्थर माना जाने लगा था।
2020 में OpenAI के शोधकर्ताओं ने GPT-3 की घोषणा की। कुछ ही हफ्तों में GPT-3 की बहुमुखी प्रतिभा दिखी—लोगों ने इससे कविताएँ, प्रोग्राम, गाने, वेबसाइट्स और बहुत कुछ बनाना शुरू कर दिया, जिसने वैश्विक उपयोगकर्ताओं की कल्पना को मोहित कर दिया। इस बदलाव को देखते हुए, स्टैनफोर्ड के विद्वानों ने 2021 में एक पेपर प्रकाशित कर इन्हें "फ़ाउंडेशन मॉडल्स" कहा, और AI को नया आकार देने में उनकी अहम भूमिका रेखांकित की।
जहाँ स्वामित्व वाले मॉडल्स ने शुरुआती दौर में सार्वजनिक ध्यान खींचा, वहीं समानांतर ओपन-सोर्स क्रांति ने ट्रांसफ़ॉर्मर तकनीक का लोकतंत्रीकरण तेज़ी से कर दिया। Hugging Face जैसे प्लेटफ़ॉर्म मॉडल साझा करने के अहम केंद्र बने, पर परिदृश्य में बुनियादी बदलाव 2023 में Meta के Llama परिवार के रिलीज़ के साथ आया। इसने "ओपन-वेट्स" आंदोलन को जन्म दिया, यह साबित करते हुए कि अत्याधुनिक AI बनाने के लिए डेवलपर्स को बंद कॉर्पोरेट इकोसिस्टम पर निर्भर रहने की ज़रूरत नहीं।
2024 और 2025 भर में, ओपन-सोर्स विकास बेतहाशा तेज़ हुआ। Meta के विशाल Llama 3.1 और बाद के Llama 4 सीरीज़ के साथ, Mistral जैसी स्टार्टअप्स के अत्यधिक कुशल आर्किटेक्चर और DeepSeek के शक्तिशाली रीज़निंग मॉडल्स ने दिखा दिया कि खुले तौर पर उपलब्ध मॉडल्स स्वामित्व वाले दिग्गजों की बराबरी कर सकते हैं, और कभी-कभी उनसे आगे भी निकल सकते हैं।
इसी दौरान, क्लोज़्ड-सोर्स मॉडल भी जटिल क्षमताओं के साथ विकसित होते रहे। 2023 का GPT-4, जिसने मल्टीमोडल क्षमताएँ जोड़ीं, और 2024 में GPT-4o, जिसने पाठ, दृष्टि, और ऑडियो प्रोसेसिंग को एक ही मॉडल में एकीकृत किया।
2024 के अंत में, OpenAI की o1 सीरीज़ और DeepSeek के ओपन R1 जैसे मॉडलों के साथ एक और अहम मोड़ आया—जिन्होंने उत्तर देने से पहले जटिल तर्क और गणित पर सोचने के लिए आंतरिक 'चेन-ऑफ़-थॉट' पेश किया।
2025 के अंत तक और 2026 में, GPT-5 परिवार के लॉन्च के साथ परिदृश्य पूरी तरह वार्तालापी सहायकों से स्वायत्त प्रणालियों की ओर शिफ्ट हो गया—जिसने एंटरप्राइज़ इन्फ्रास्ट्रक्चर में उन्नत मल्टी-स्टेप प्लानिंग, दीर्घकालिक मेमोरी, और सुदृढ़ एजेंटिक वर्कफ़्लोज़ ला दिए।
ट्रांसफ़ॉर्मर मॉडल के परिचय के समय, Recurrent Neural Networks (RNNs) क्रमिक डेटा—जिसकी इनपुट में एक विशिष्ट क्रमबद्धता होती है—से निपटने का पसंदीदा तरीका थे।
RNNs फीड-फ़ॉरवर्ड न्यूरल नेटवर्क के समान काम करते हैं, लेकिन इनपुट को क्रम से, एक समय में एक तत्व, प्रोसेस करते हैं।
ट्रांसफ़ॉर्मर्स को RNNs में पाए जाने वाले एन्कोडर–डीकोडर आर्किटेक्चर से प्रेरणा मिली। हालांकि, रिकरेंस का उपयोग करने के बजाय, ट्रांसफ़ॉर्मर मॉडल पूरी तरह Attention मैकेनिज़्म पर आधारित है।
RNN के प्रदर्शन में सुधार करने के अलावा, ट्रांसफ़ॉर्मर्स ने कई अन्य कार्यों—जैसे टेक्स्ट सारांशण, इमेज कैप्शनिंग, और स्पीच रिकग्निशन—को हल करने के लिए नई आर्किटेक्चर दी।
तो, RNNs की मुख्य समस्याएँ क्या हैं? NLP कार्यों के लिए वे दो मुख्य कारणों से अप्रभावी साबित होते हैं:
LSTM जैसे RNNs से NLP में ट्रांसफ़ॉर्मर्स की ओर बदलाव इन्हीं दो समस्याओं और Attention मैकेनिज़्म में सुधारों से लाभ उठाकर उन्हें दूर करने की ट्रांसफ़ॉर्मर्स की क्षमता से प्रेरित है:
इस प्रकार, ट्रांसफ़ॉर्मर्स RNNs का स्वाभाविक उन्नत रूप बन गए।
अब आगे देखते हैं कि ट्रांसफ़ॉर्मर्स काम कैसे करते हैं।
मूल रूप से अनुक्रम रूपांतरण या न्यूरल मशीन अनुवाद के लिए बनाए गए, ट्रांसफ़ॉर्मर्स इनपुट अनुक्रमों को आउटपुट अनुक्रमों में बदलने में उत्कृष्ट हैं। यह पहला ऐसा ट्रांसडक्शन मॉडल है जो इनपुट और आउटपुट के अभ्यावेदन की गणना के लिए पूरी तरह सेल्फ-अटेंशन पर निर्भर करता है—बिना क्रम-संरेखित RNNs या कन्वोल्यूशन के। ट्रांसफ़ॉर्मर्स आर्किटेक्चर की मूल विशेषता यह है कि वे एन्कोडर–डीकोडर मॉडल को बनाए रखते हैं।
यदि हम भाषा अनुवाद के लिए ट्रांसफ़ॉर्मर को एक साधारण ब्लैक बॉक्स मानें, तो यह एक भाषा—उदाहरण के लिए अंग्रेज़ी—में वाक्य को इनपुट के रूप में लेगा और आउटपुट में उसका अनुवाद देगा।
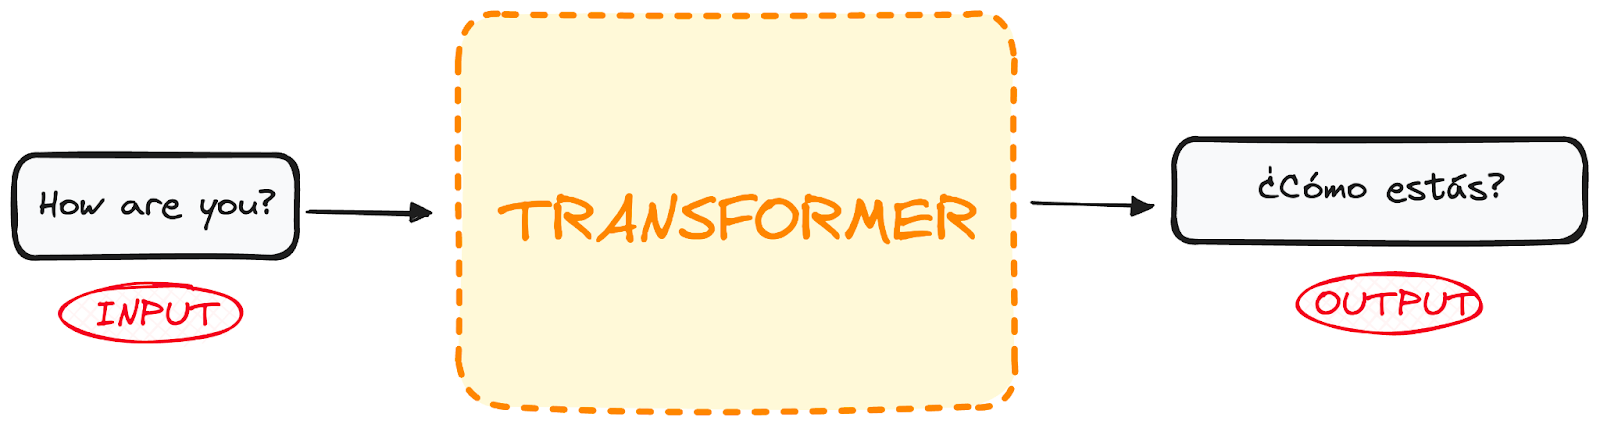
चित्र: लेखक द्वारा।
थोड़ा और भीतर देखें, तो यह ब्लैक बॉक्स दो मुख्य भागों से बना है:
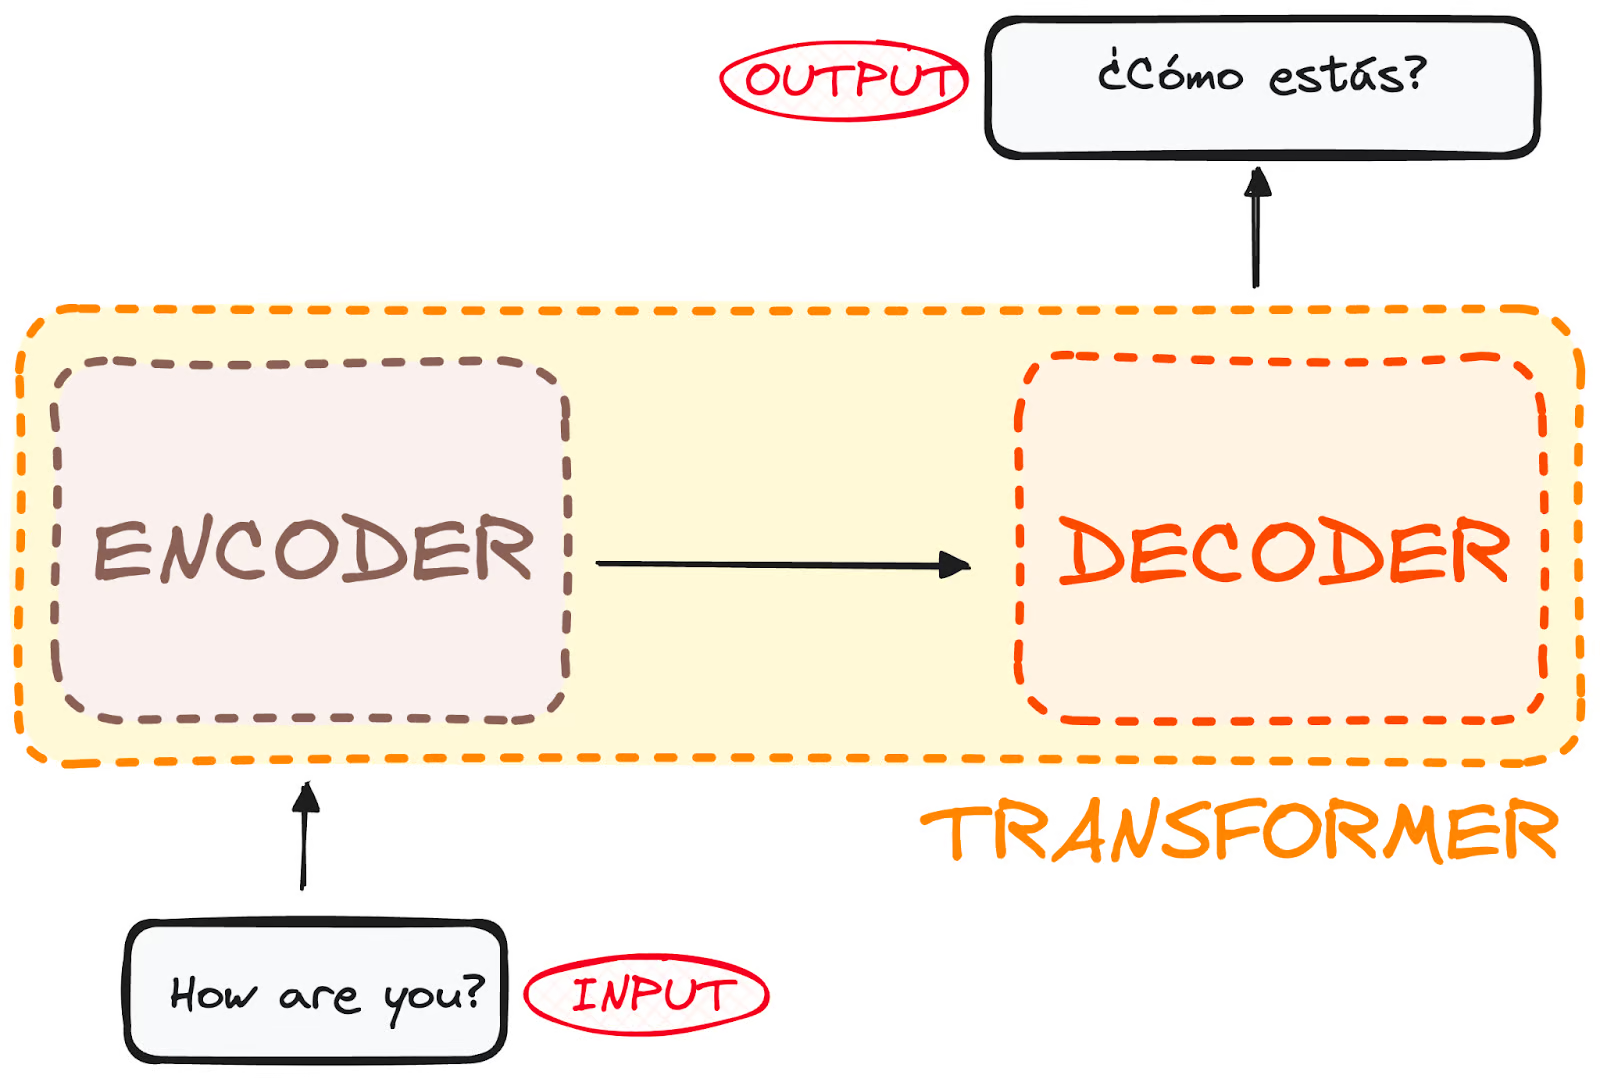
चित्र: लेखक द्वारा। एन्कोडर–डीकोडर की समग्र संरचना।
हालाँकि, एन्कोडर और डीकोडर वास्तव में बहु-स्तरीय स्टैक होते हैं (दोनों में समान संख्या)। सभी एन्कोडर्स की संरचना समान होती है—इनपुट हर एन्कोडर में जाता है और आगे वाले को पास होता है। सभी डीकोडर्स की संरचना भी समान होती है—वे अंतिम एन्कोडर और पिछले डीकोडर से इनपुट लेते हैं।
मूल आर्किटेक्चर में 6 एन्कोडर और 6 डीकोडर थे, पर परतों की संख्या आवश्यकता अनुसार बढ़ाई जा सकती है। तो मान लें कि प्रत्येक के N लेयर्स हैं।
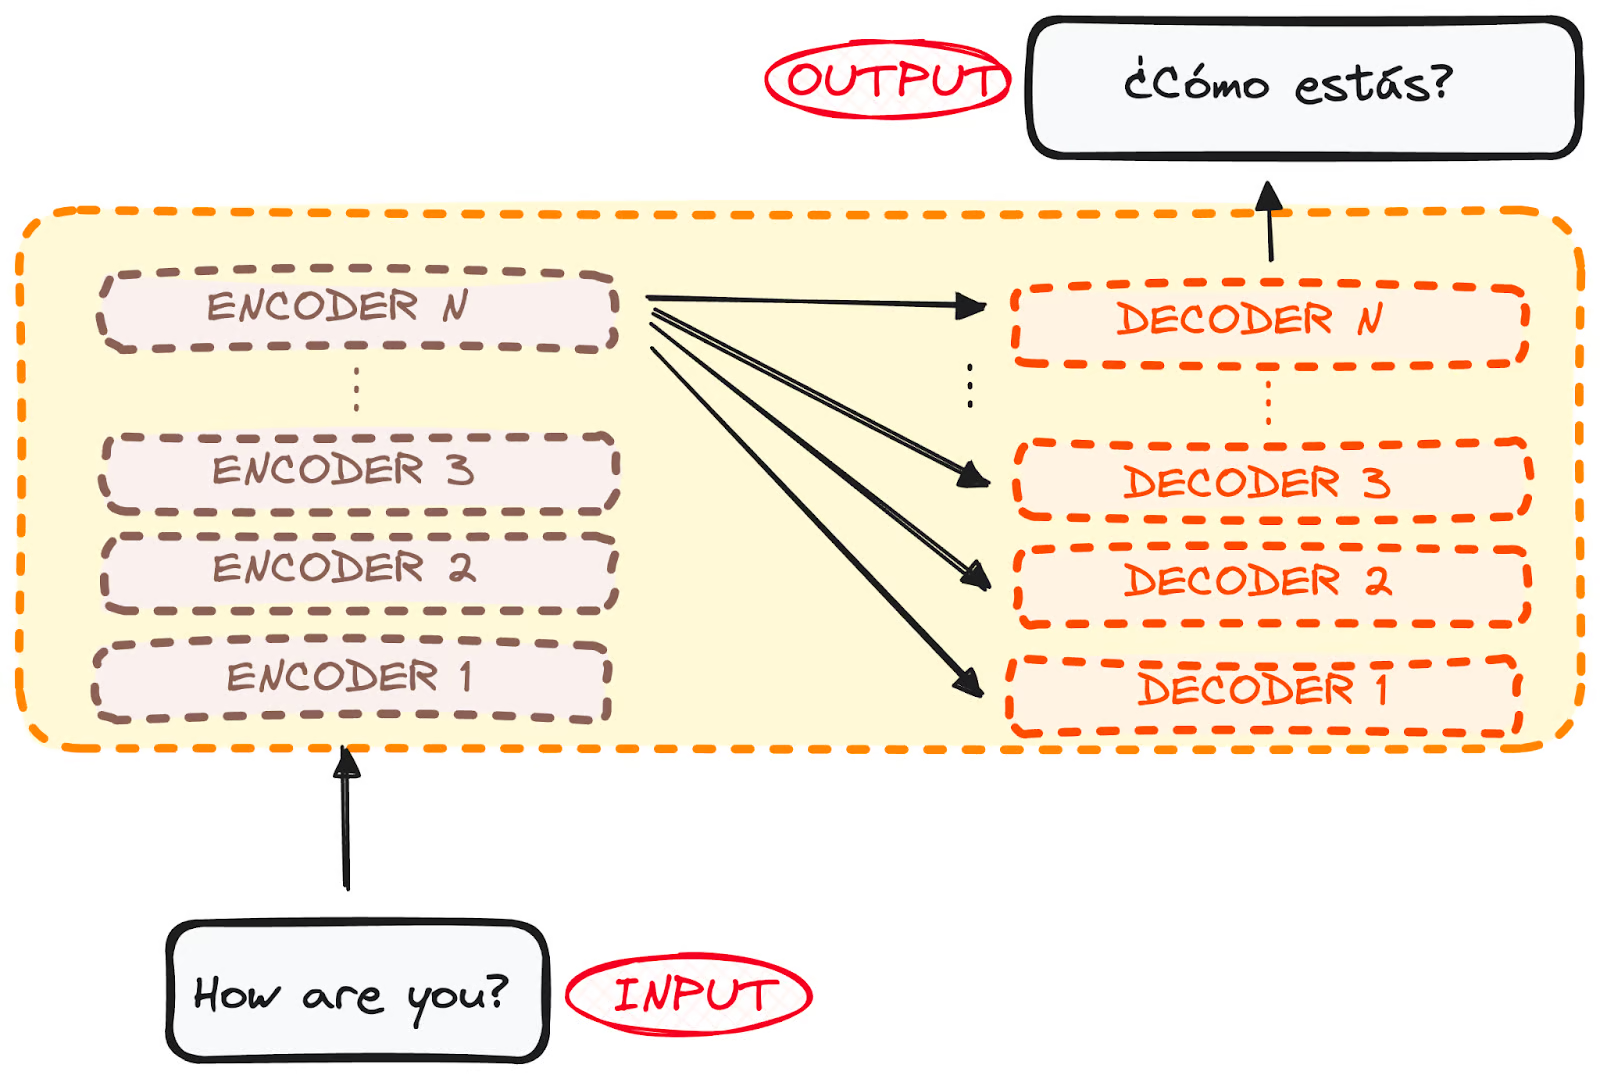
चित्र: लेखक द्वारा। एन्कोडर–डीकोडर की बहु-स्तरीय वैश्विक संरचना।
अब जब हमें समग्र ट्रांसफ़ॉर्मर आर्किटेक्चर का एक सामान्य विचार है, तो बेहतर समझ के लिए एन्कोडर्स और डीकोडर्स दोनों पर अलग-अलग ध्यान दें:
एन्कोडर, ट्रांसफ़ॉर्मर आर्किटेक्चर का मूल घटक है। इसका प्राथमिक कार्य इनपुट टोकन्स को संदर्भित अभ्यावेदन में बदलना है। पहले के मॉडलों के विपरीत जो टोकन्स को स्वतंत्र रूप से प्रोसेस करते थे, ट्रांसफ़ॉर्मर एन्कोडर पूरे अनुक्रम के संदर्भ में प्रत्येक टोकन का संदर्भ पकड़ता है।
इसकी संरचनात्मक रचना निम्न प्रकार है:
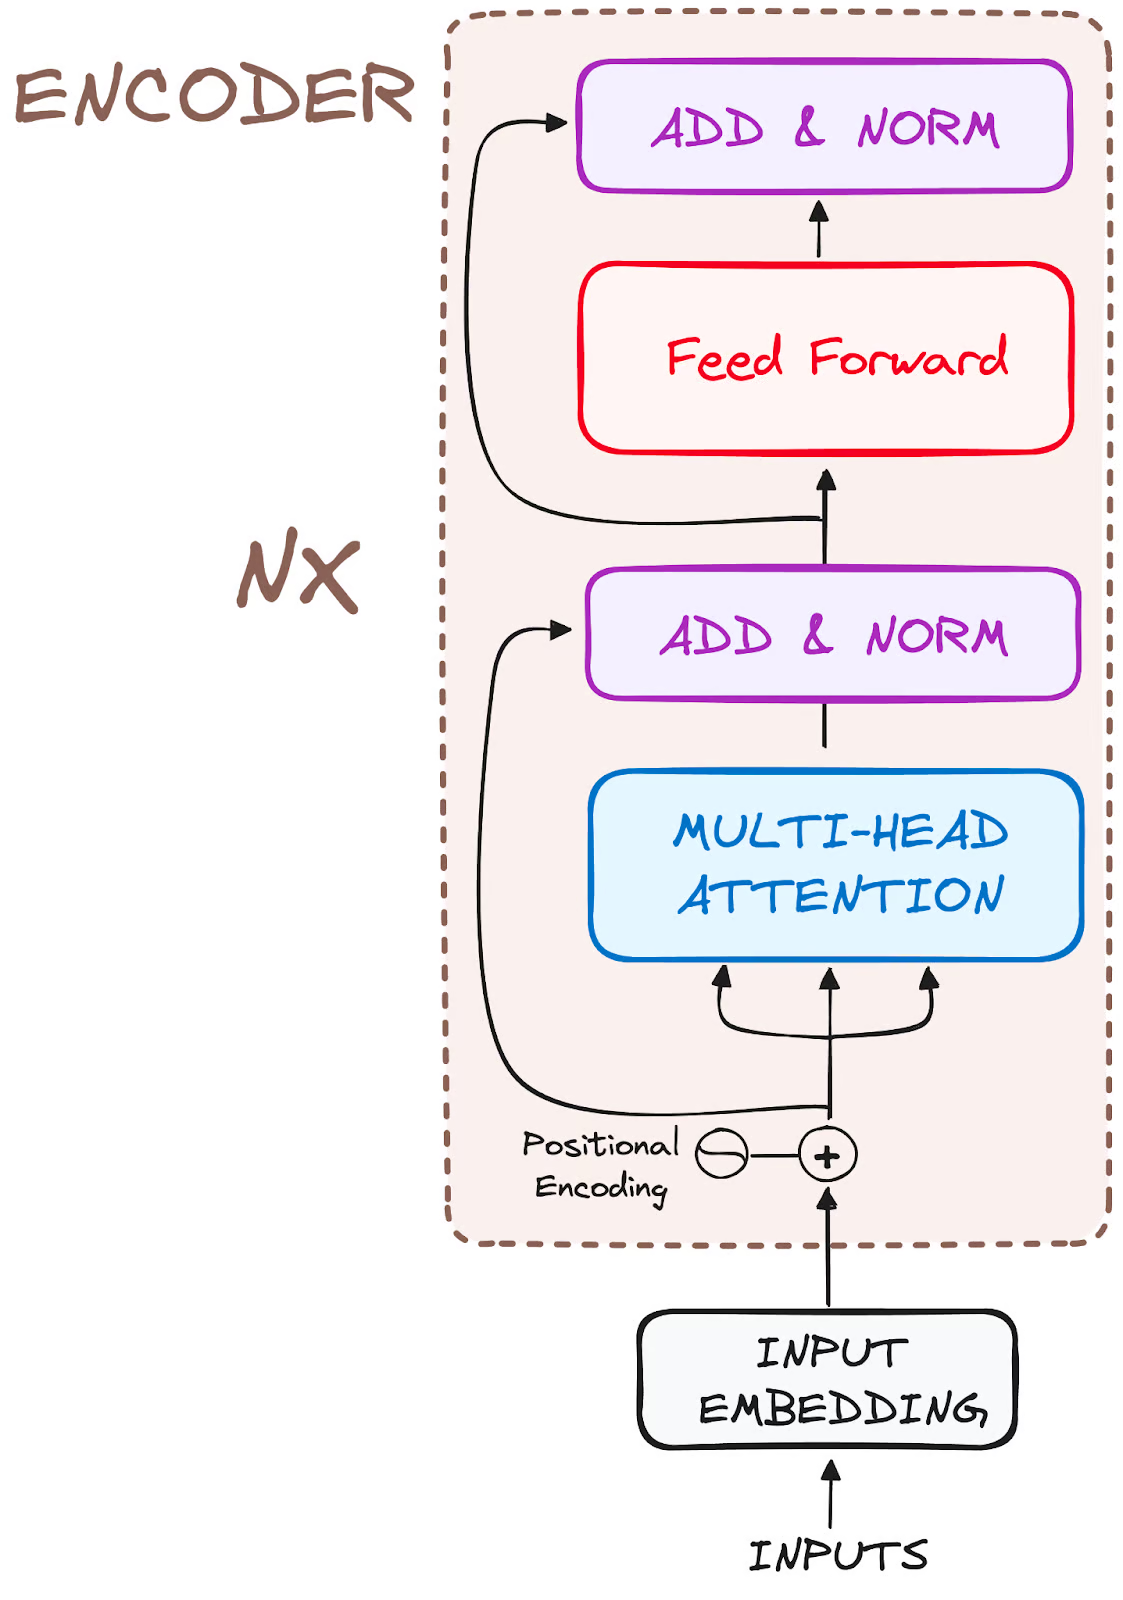
चित्र: लेखक द्वारा। एन्कोडर्स की समग्र संरचना।
आइए इसके वर्कफ़्लो को मूलभूत चरणों में बाँटें:
एम्बेडिंग केवल सबसे नीचे वाले एन्कोडर में होती है। एन्कोडर इनपुट टोकन्स—शब्द या उप-शब्द—को एम्बेडिंग लेयर्स की मदद से वेक्टर में बदलकर शुरू करता है। ये एम्बेडिंग्स टोकन्स के अर्थगत पहलू पकड़ती हैं और उन्हें संख्यात्मक वेक्टर में बदलती हैं।
सभी एन्कोडर्स को वेक्टरों की एक सूची मिलती है, प्रत्येक का आकार 512 (नियत आकार)। सबसे निचले एन्कोडर में यह शब्द एम्बेडिंग्स होते हैं, जबकि अन्य एन्कोडर्स में यह सीधे नीचे वाले एन्कोडर का आउटपुट होता है।
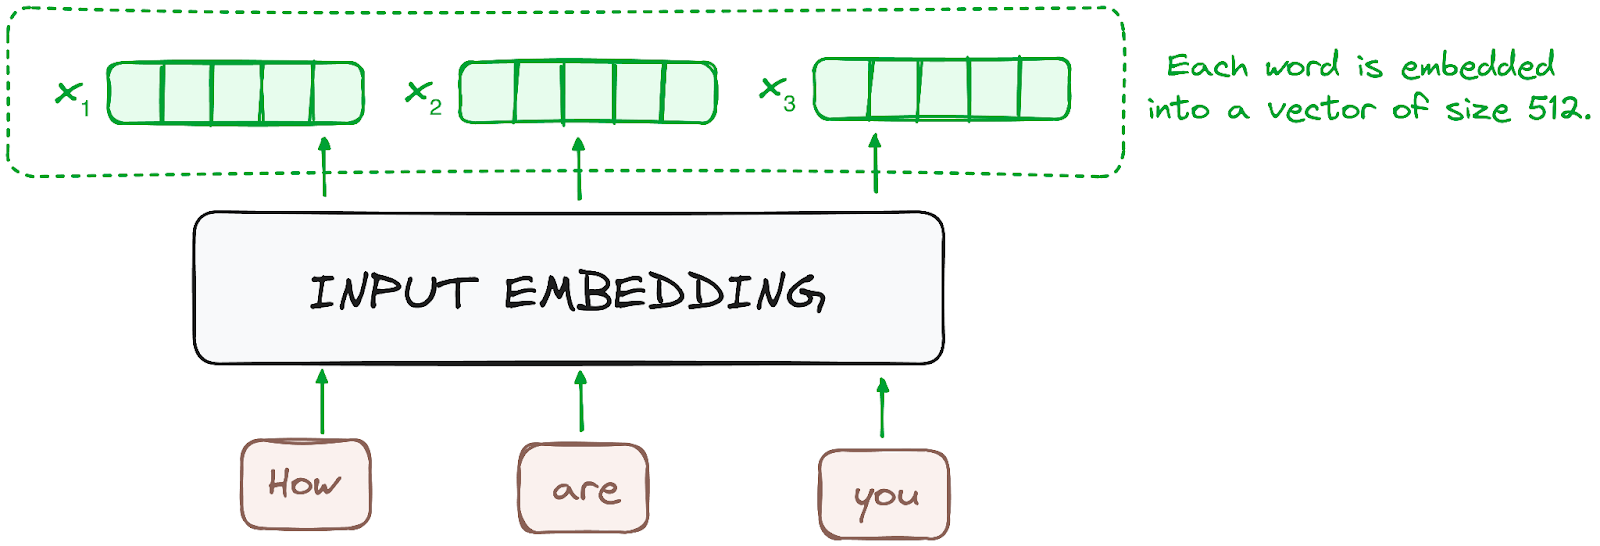
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: इनपुट एम्बेडिंग।
क्योंकि ट्रांसफ़ॉर्मर्स में RNNs जैसी रिकरेंस प्रणाली नहीं होती, वे इनपुट एम्बेडिंग्स में पोज़िशनल इनकोडिंग जोड़ते हैं, जिससे अनुक्रम में हर टोकन की स्थिति की जानकारी मिलती है। इससे वे वाक्य में प्रत्येक शब्द की स्थिति समझ पाते हैं।
इसके लिए, शोधकर्ताओं ने विभिन्न साइन और कोसाइन फ़ंक्शंस के संयोजन से पोज़िशनल वेक्टर बनाने का सुझाव दिया, जिससे किसी भी लंबाई के वाक्य के लिए इस पोज़िशनल एन्कोडर का उपयोग संभव हो।
इस पद्धति में, प्रत्येक आयाम को तरंग की विशिष्ट आवृत्तियों और ऑफ़सेट्स द्वारा दर्शाया जाता है, जिनके मान -1 से 1 के बीच होते हैं, और इस प्रकार प्रत्येक स्थिति को प्रभावी ढंग से व्यक्त करते हैं।
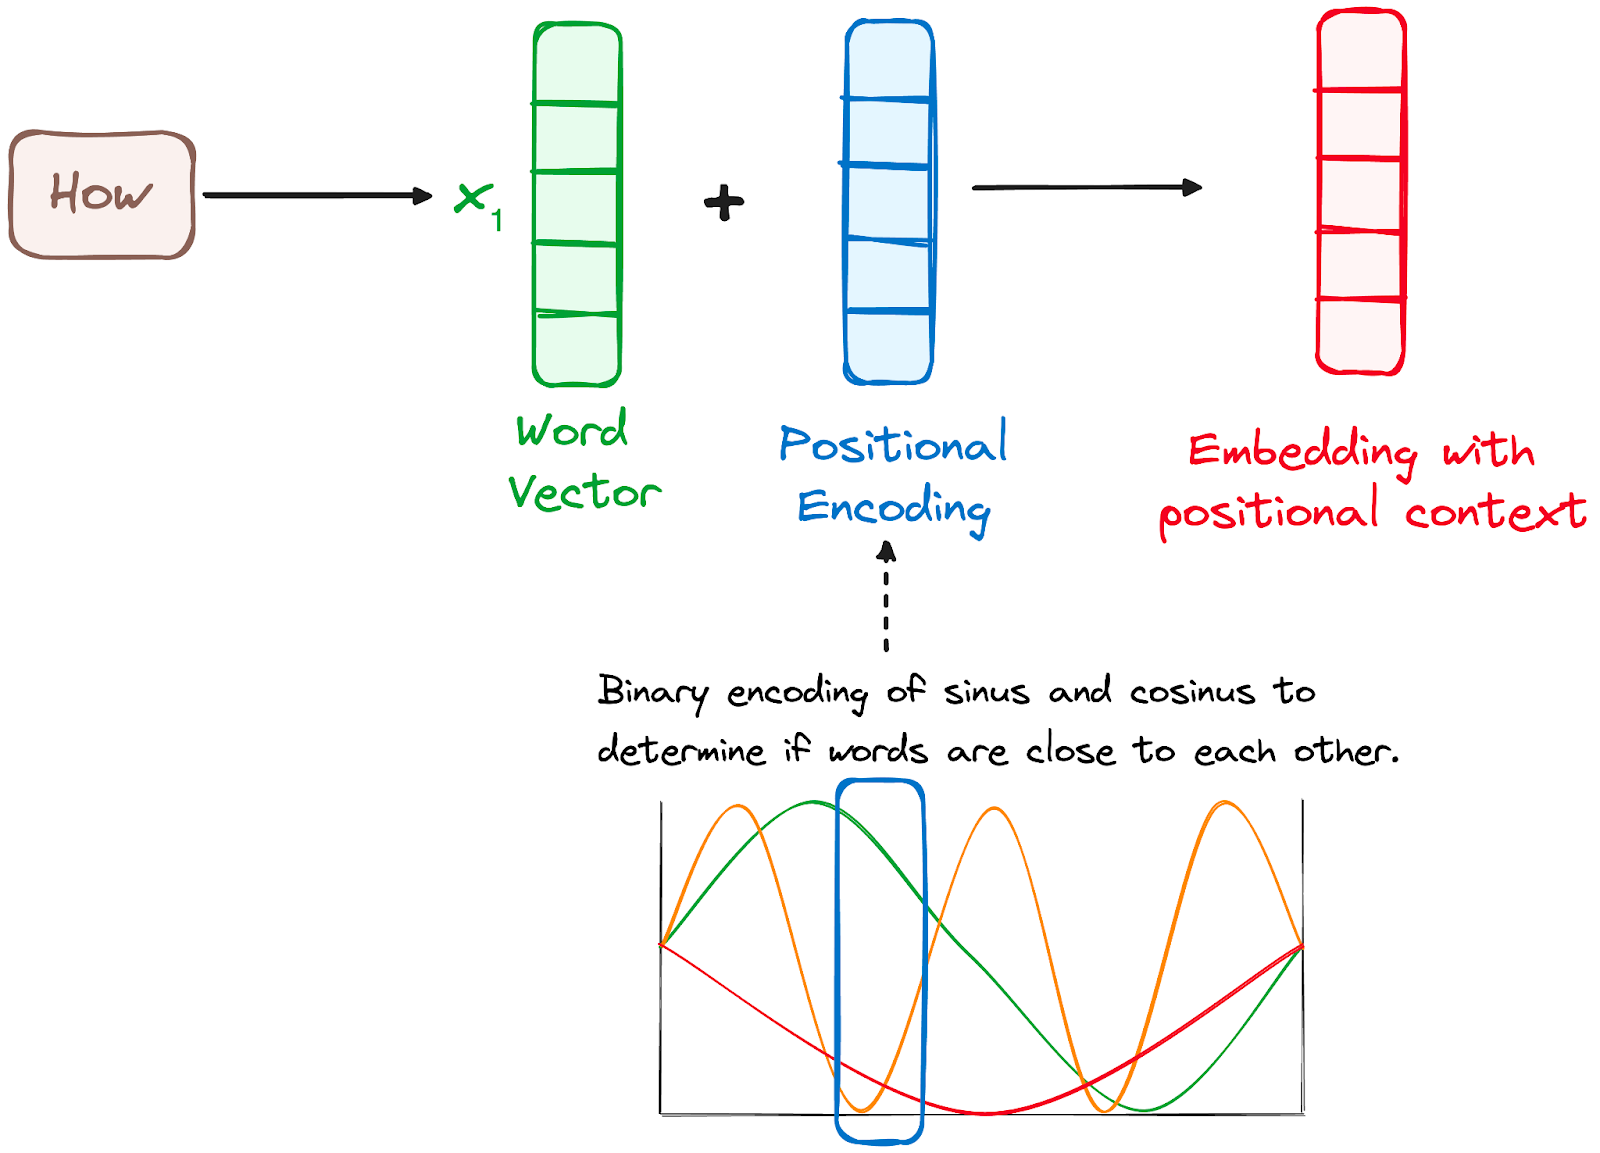
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: पोज़िशनल इनकोडिंग।
ट्रांसफ़ॉर्मर एन्कोडर समान लेयर्स के एक स्टैक से बना है (मूल मॉडल में 6)।
एन्कोडर लेयर सभी इनपुट अनुक्रमों को एक सतत, सार-स्तरीय अभ्यावेदन में बदलती है जो पूरे अनुक्रम से सीखी जानकारी को समेटता है। यह लेयर दो उप-मॉड्यूल्स से मिलकर बनी होती है:
इसके अतिरिक्त, प्रत्येक सबलेयर के चारों ओर रेज़िडुअल कनेक्शंस शामिल होते हैं, जिनके बाद लेयर नॉर्मलाइज़ेशन लगाया जाता है।
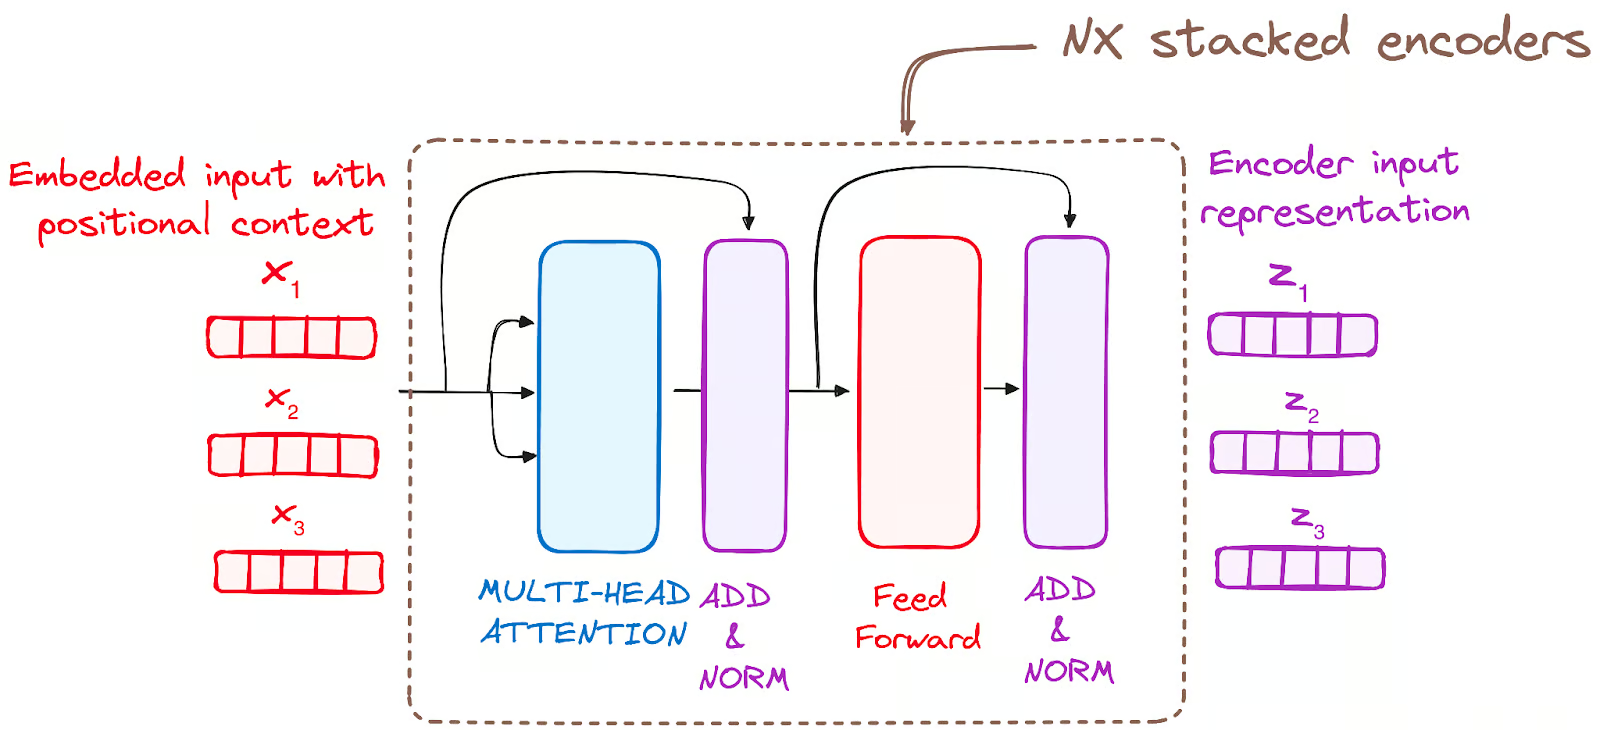
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: एन्कोडर लेयर्स का स्टैक
एन्कोडर में मल्टी-हेडेड अटेंशन, सेल्फ-अटेंशन नामक विशेष अटेंशन मैकेनिज़्म का उपयोग करता है। यह पद्धति मॉडल को इनपुट के प्रत्येक शब्द को अन्य शब्दों से जोड़ने में सक्षम बनाती है। उदाहरण के लिए, किसी वाक्य में मॉडल “are” शब्द को “you” से जोड़ना सीख सकता है।
यह मैकेनिज़्म एन्कोडर को प्रत्येक टोकन प्रोसेस करते समय इनपुट अनुक्रम के अलग-अलग हिस्सों पर ध्यान केंद्रित करने देता है। यह अटेंशन स्कोर की गणना इन पर आधारित करता है:
यह पहला सेल्फ-अटेंशन मॉड्यूल मॉडल को पूरे अनुक्रम से संदर्भगत जानकारी पकड़ने देता है। एकल अटेंशन फ़ंक्शन करने के बजाय, क्वेरीज़, कीज़ और वैल्यूज़ को रैखिक रूप से h बार प्रोजेक्ट किया जाता है। इन प्रोजेक्टेड संस्करणों पर अटेंशन समानांतर में किया जाता है, जिससे h-आयामी आउटपुट मान मिलते हैं।
विस्तृत आर्किटेक्चर इस प्रकार है:
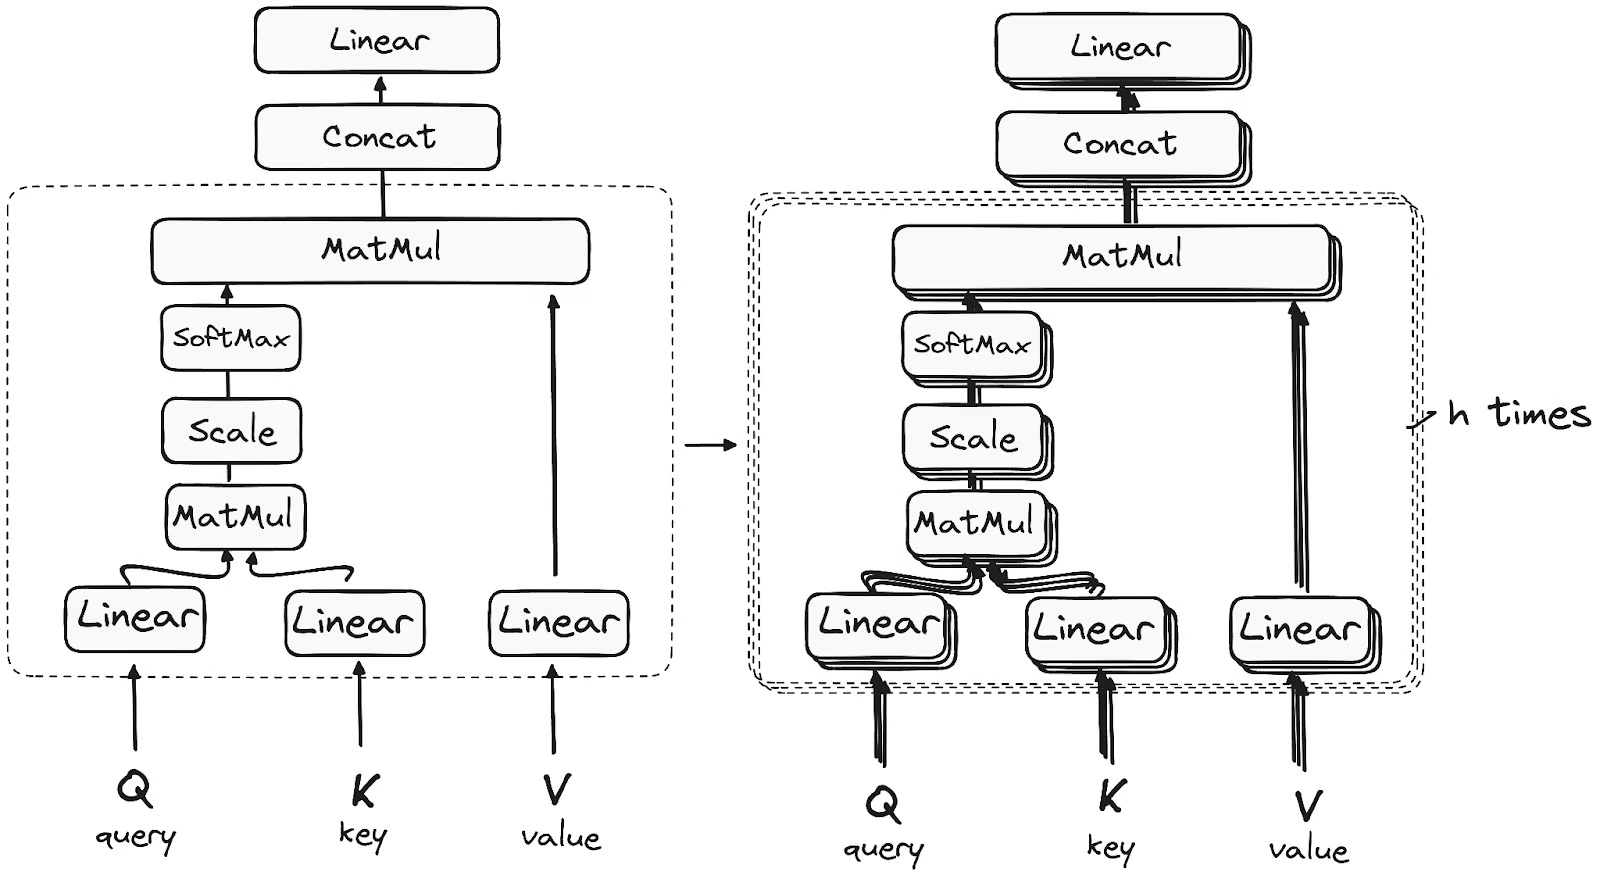
जब क्वेरी, की, और वैल्यू वेक्टर एक रैखिक लेयर से गुज़रते हैं, तो क्वेरीज़ और कीज़ के बीच डॉट प्रोडक्ट मैट्रिक्स गुणा किया जाता है, जिससे एक स्कोर मैट्रिक्स बनता है।
स्कोर मैट्रिक्स यह निर्धारित करता है कि प्रत्येक शब्द को अन्य शब्दों पर कितना ज़ोर देना चाहिए। इसलिए, हर शब्द को उसी समय-चरण में अन्य शब्दों के सापेक्ष एक स्कोर सौंपा जाता है। उच्च स्कोर का अर्थ है अधिक ध्यान।
यह प्रक्रिया प्रभावी रूप से क्वेरीज़ को उनकी संबंधित कीज़ से मैप करती है।
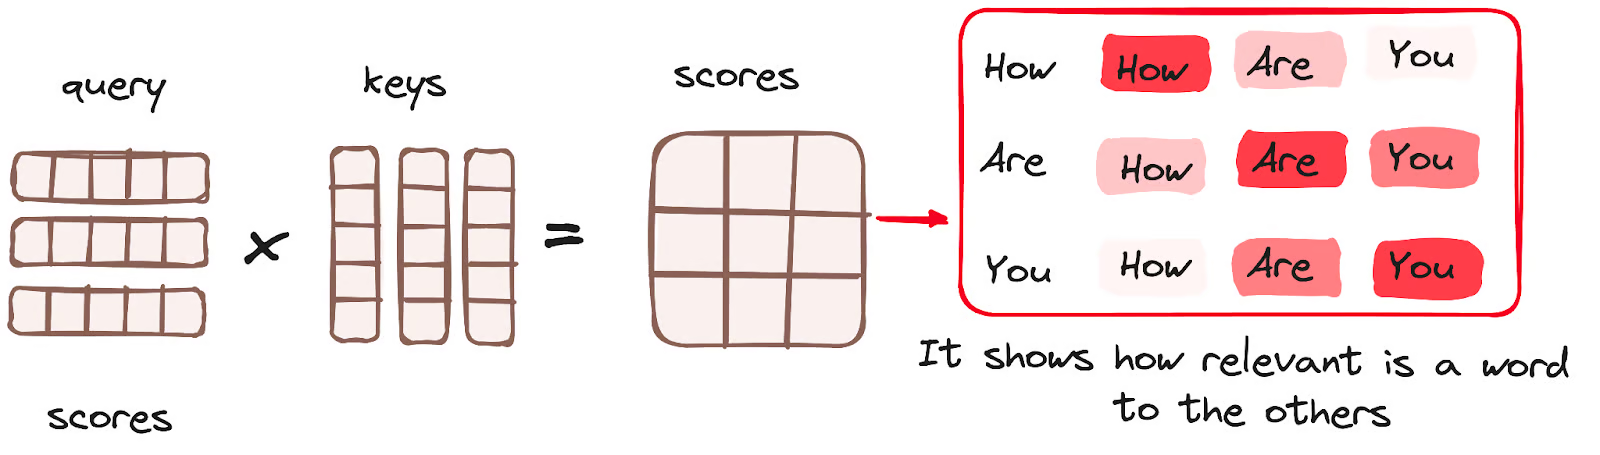
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: अटेंशन मैकेनिज़्म - मैट्रिक्स मल्टिप्लिकेशन।
इसके बाद स्कोर्स को क्वेरी और की वेक्टर के आयाम के वर्गमूल से भाग देकर घटाया जाता है। यह चरण स्थिर ग्रेडिएंट्स सुनिश्चित करने के लिए लागू होता है, क्योंकि मानों का गुणन अत्यधिक बड़े प्रभाव ला सकता है।
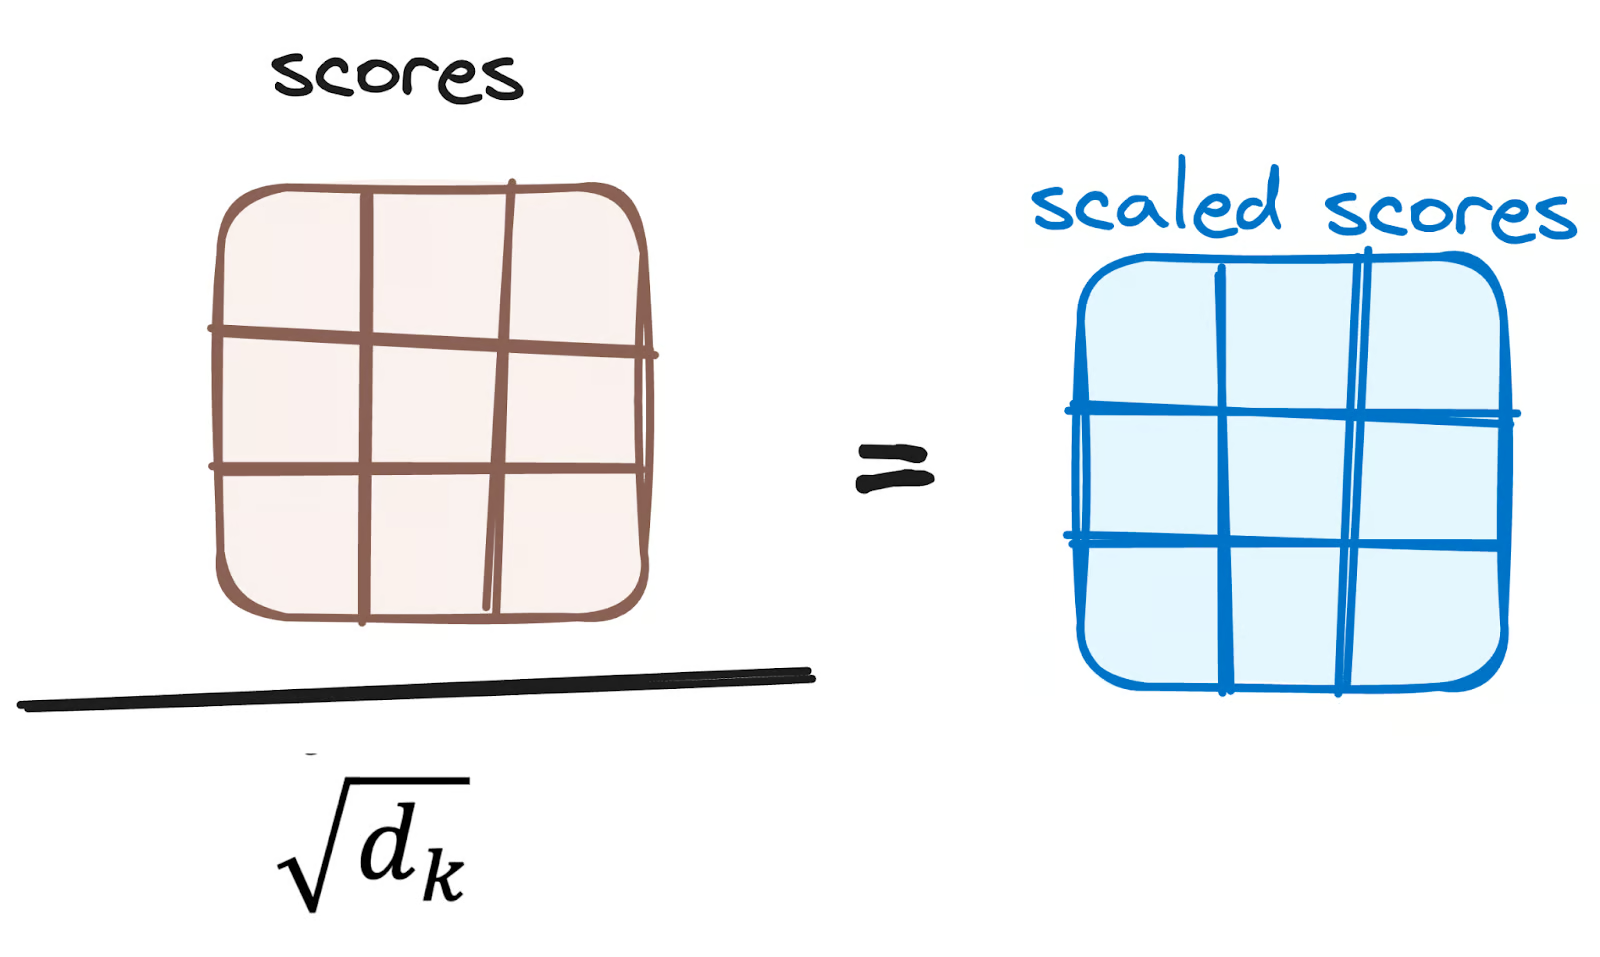
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: अटेंशन स्कोर्स घटाना।
इसके बाद समायोजित स्कोर्स पर softmax फ़ंक्शन लगाया जाता है ताकि अटेंशन वेट्स मिलें। इससे 0 से 1 के बीच प्रायिकता मान प्राप्त होते हैं। Softmax उच्च स्कोर्स को प्रमुखता देता है और निम्न स्कोर्स को घटाता है, जिससे मॉडल यह बेहतर तय कर पाता है कि किन शब्दों पर अधिक ध्यान देना है।
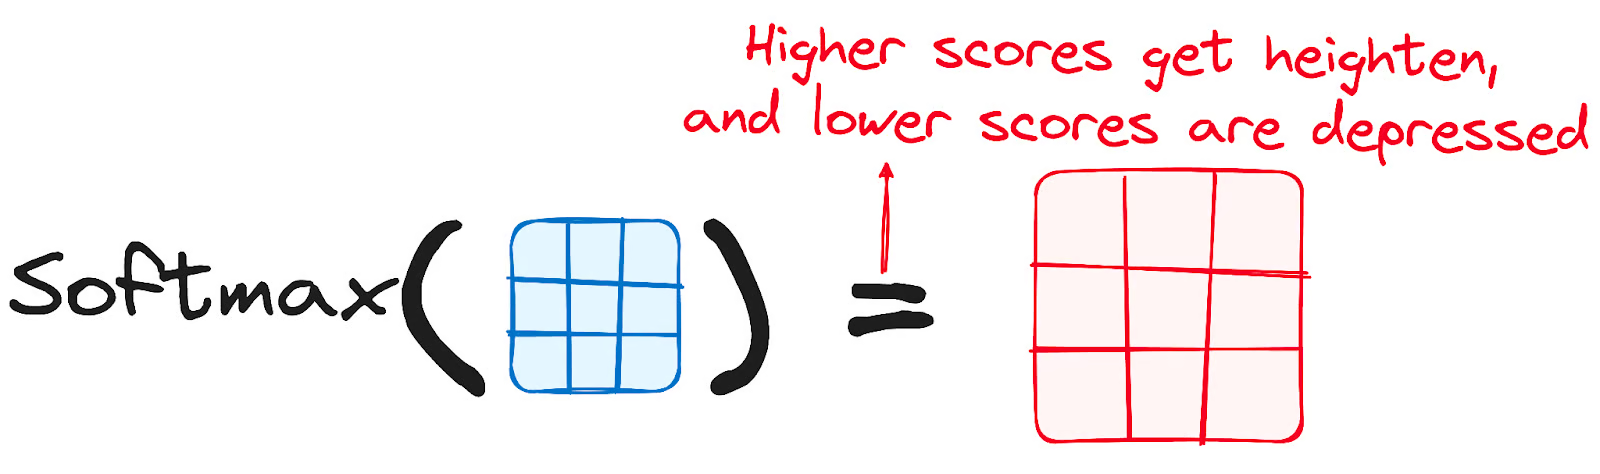
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: Softmax समायोजित स्कोर्स।
अटेंशन मैकेनिज़्म के अगले चरण में softmax से प्राप्त वेट्स को वैल्यू वेक्टर से गुणा किया जाता है, जिससे एक आउटपुट वेक्टर बनता है।
इस प्रक्रिया में केवल वे शब्द संरक्षित रहते हैं जिनके softmax स्कोर उच्च हैं। अंत में, इस आउटपुट वेक्टर को आगे की प्रोसेसिंग के लिए एक रैखिक लेयर में भेजा जाता है।
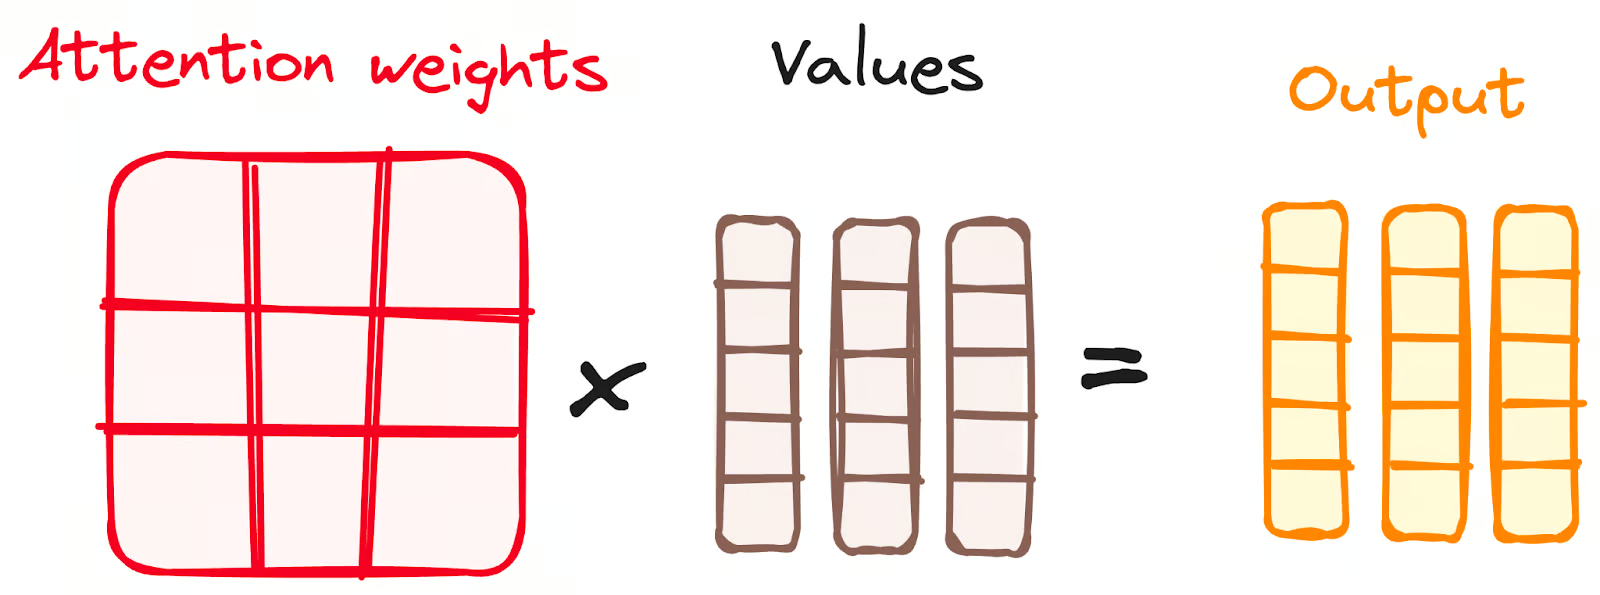
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: Softmax परिणामों को वैल्यू वेक्टर से संयोजित करना।
और हमें अंततः अटेंशन मैकेनिज़्म का आउटपुट मिल जाता है!
तो, इसे मल्टी-हेड अटेंशन क्यों कहते हैं?
याद रखें कि प्रक्रिया शुरू होने से पहले, हम अपनी क्वेरीज़, कीज़ और वैल्यूज़ को h बार विभाजित करते हैं। यह प्रक्रिया, जिसे सेल्फ-अटेंशन कहा जाता है, इन छोटे-छोटे चरणों या 'हेड्स' में अलग-अलग होती है। प्रत्येक हेड स्वतंत्र रूप से काम करता है और एक आउटपुट वेक्टर देता है।
यह समुच्चय अंतिम रैखिक लेयर से गुजरता है, मानो कोई फ़िल्टर जो उनके सामूहिक प्रदर्शन को परिष्कृत करता हो। ख़ूबसूरती यह है कि हर हेड अलग ढंग से सीखता है, जिससे एन्कोडर मॉडल का समझ व्यापक और बहुआयामी बनता है।
अटेंशन मैकेनिज़्म की गहराई से समझ के लिए हमारा ट्रांसफ़ॉर्मर्स में मल्टी-हेड अटेंशन ट्यूटोरियल देखें।
एन्कोडर लेयर में हर सबलेयर के बाद नॉर्मलाइज़ेशन स्टेप होता है। साथ ही, प्रत्येक सबलेयर के आउटपुट को उसके इनपुट में जोड़ दिया जाता है (रेज़िडुअल कनेक्शन), ताकि वेनिशिंग ग्रेडिएंट समस्या कम हो और गहरे मॉडल संभव हों। यही प्रक्रिया फ़ीड-फ़ॉरवर्ड न्यूरल नेटवर्क के बाद भी दोहराई जाती है।
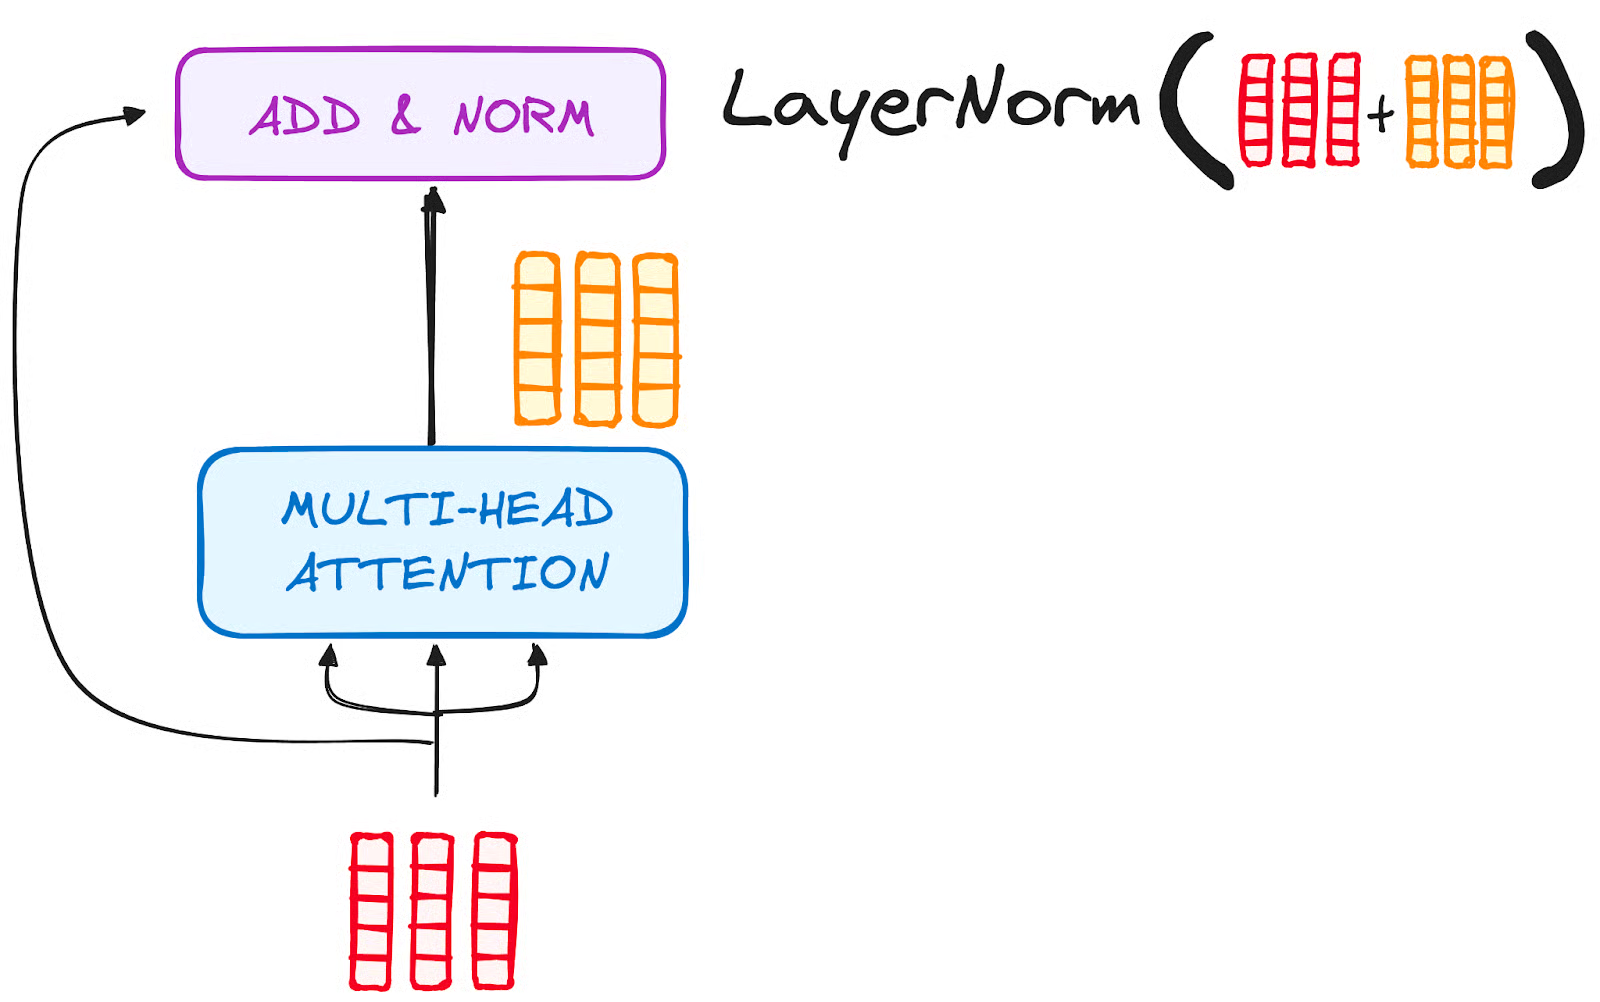
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: मल्टी-हेड अटेंशन के बाद नॉर्मलाइज़ेशन और रेज़िडुअल कनेक्शन।
नॉर्मलाइज़्ड रेज़िडुअल आउटपुट अपनी यात्रा में आगे एक पॉइंटवाइज़ फ़ीड-फ़ॉरवर्ड नेटवर्क से होकर गुजरता है—यह अतिरिक्त परिष्कार का अहम चरण है।
इसे दो रैखिक लेयर्स के युगल की तरह समझें, जिनके बीच ReLU एक्टिवेशन पुल का काम करता है। प्रोसेसिंग पूरी होने पर, आउटपुट फिर परिचित रास्ता पकड़ता है: यह लौटकर पॉइंटवाइज़ फ़ीड-फ़ॉरवर्ड नेटवर्क के इनपुट से मिल जाता है।
इसके बाद एक और नॉर्मलाइज़ेशन किया जाता है, ताकि सब कुछ ठीक-ठाक समायोजित होकर अगले चरणों के लिए तैयार हो।
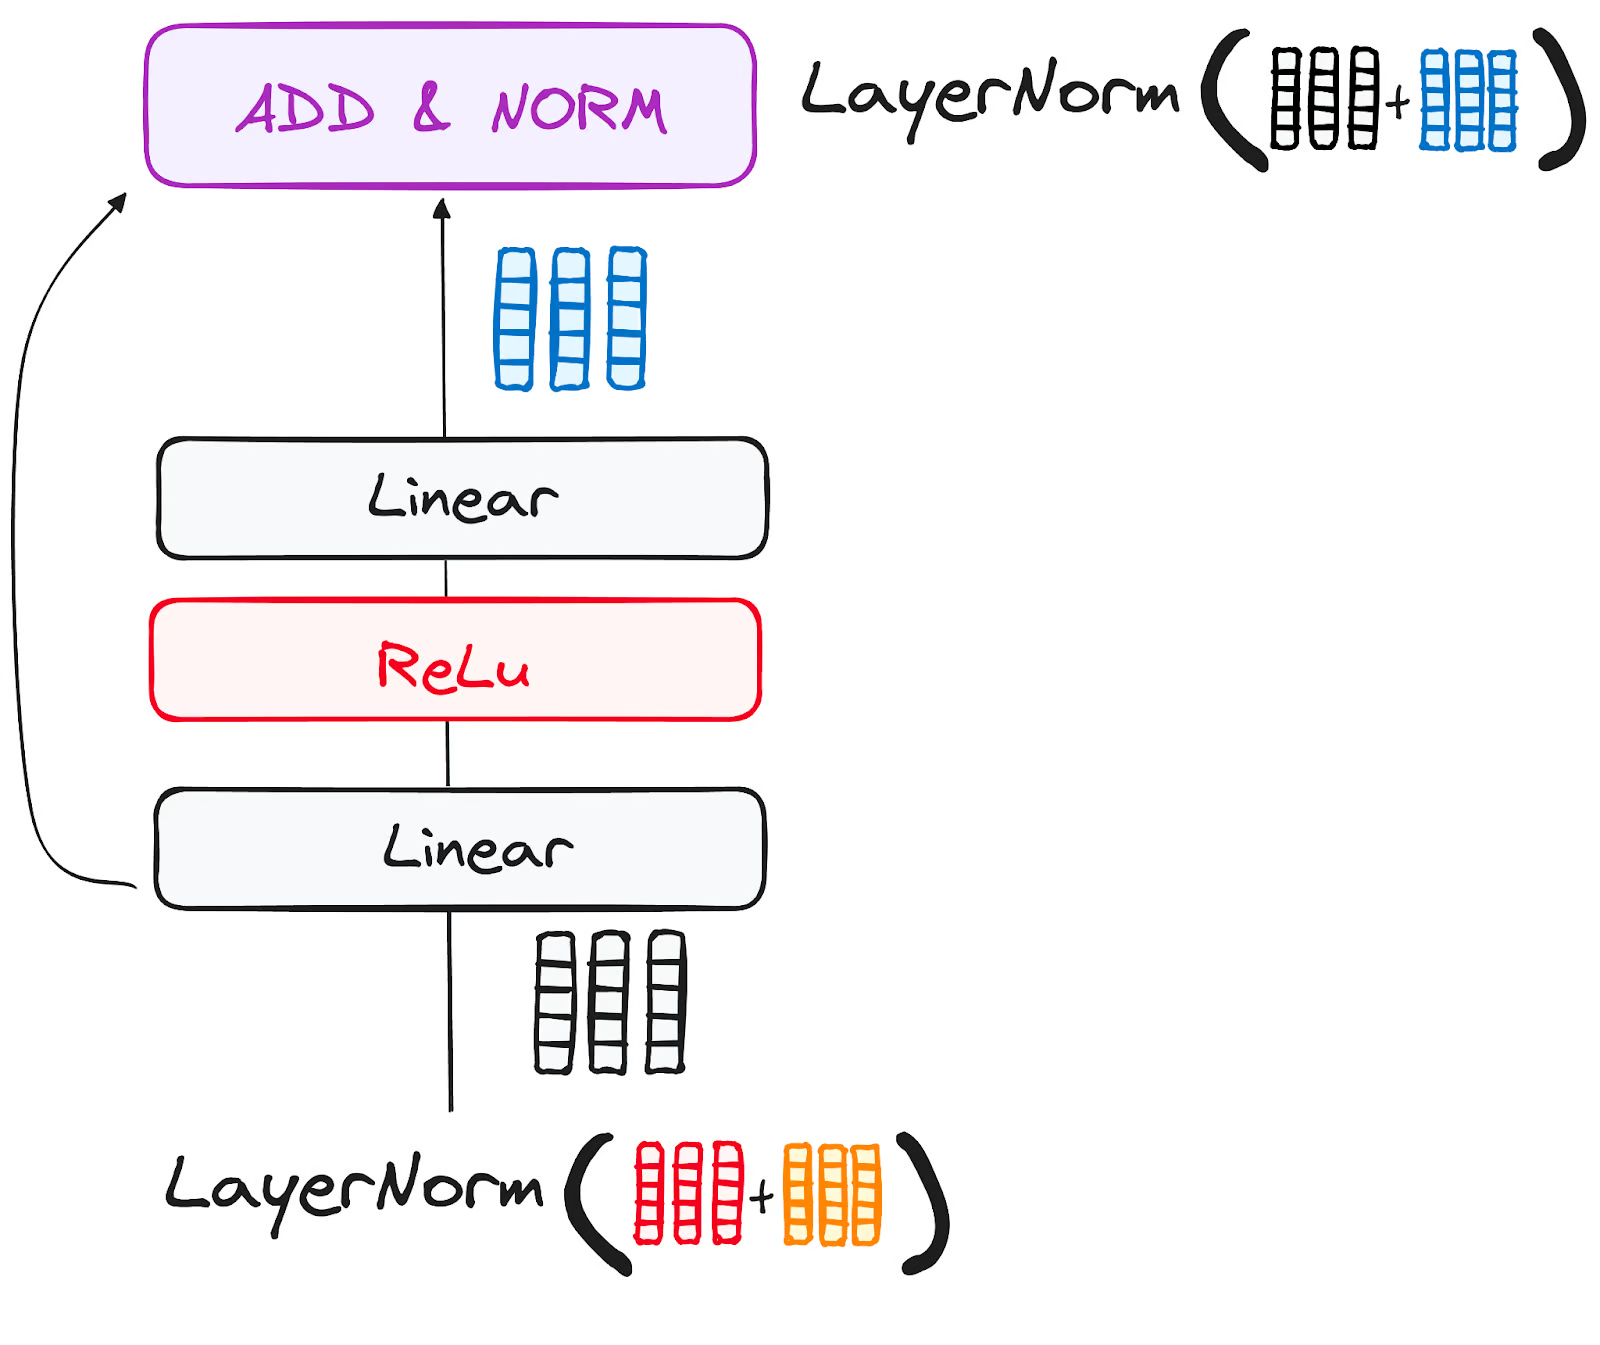
चित्र: लेखक द्वारा। एन्कोडर का वर्कफ़्लो: फ़ीड-फ़ॉरवर्ड न्यूरल नेटवर्क सब-लेयर।
अंतिम एन्कोडर लेयर का आउटपुट वेक्टरों का एक सेट होता है, जो इनपुट अनुक्रम का समृद्ध संदर्भगत प्रतिनिधित्व करता है। यही आउटपुट ट्रांसफ़ॉर्मर मॉडल में डीकोडर का इनपुट बनता है।
यह सावधानीपूर्वक एनकोडिंग डीकोडर के लिए राह बनाती है, ताकि डिकोड करते समय वह इनपुट के सही शब्दों पर ध्यान दे।
इसे एक मीनार बनाने जैसा समझें, जहाँ आप N एन्कोडर लेयर जोड़ सकते हैं। स्टैक की हर लेयर को अलग-अलग प्रकार के अटेंशन पहलुओं का अन्वेषण करने का मौका मिलता है—मानो ज्ञान की परतें। इससे समझ विविध होती है और ट्रांसफ़ॉर्मर नेटवर्क की भविष्यवाणी क्षमता उल्लेखनीय रूप से बढ़ सकती है।
डीकोडर का काम पाठ अनुक्रम गढ़ना है। एन्कोडर के समान, डीकोडर में भी समान सब-लेयर्स का सेट होता है। इसमें दो मल्टी-हेडेड अटेंशन लेयर्स, एक पॉइंटवाइज़ फ़ीड-फ़ॉरवर्ड लेयर, और प्रत्येक सब-लेयर के बाद रेज़िडुअल कनेक्शंस एवं लेयर नॉर्मलाइज़ेशन शामिल होते हैं।
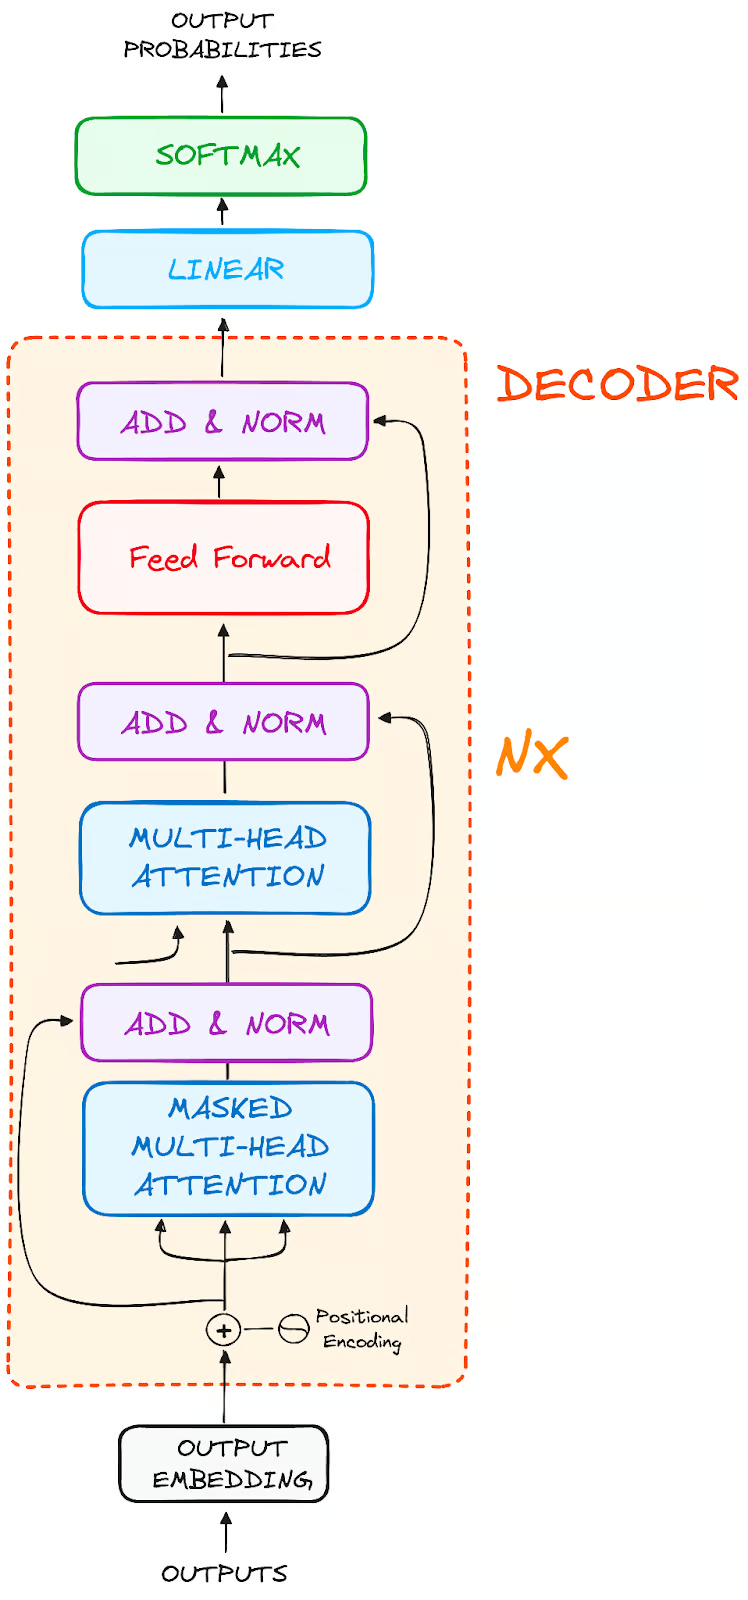
चित्र: लेखक द्वारा। एन्कोडर्स की समग्र संरचना।
ये घटक एन्कोडर की लेयर्स की तरह ही कार्य करते हैं, पर एक ट्विस्ट के साथ: डीकोडर की प्रत्येक मल्टी-हेडेड अटेंशन लेयर का अपना अलग उद्देश्य होता है।
डीकोडर की प्रक्रिया के अंत में एक रैखिक लेयर होती है, जो क्लासिफ़ायर का काम करती है, और उसके ऊपर softmax फ़ंक्शन होता है जो विभिन्न शब्दों की प्रायिकताएँ गणना करता है।
ट्रांसफ़ॉर्मर डीकोडर की संरचना इस आउटपुट को कदम-दर-कदम एन्कोडेड जानकारी को डिकोड करके उत्पन्न करने के लिए विशेष रूप से डिज़ाइन की गई है।
ध्यान देने योग्य है कि डीकोडर ऑटोरेग्रेसिव ढंग से काम करता है—यह start टोकन से प्रक्रिया शुरू करता है। यह चालाकी से पहले से जनित आउटपुट्स की सूची को अपने इनपुट के रूप में उपयोग करता है, साथ ही एन्कोडर के आउटपुट्स को, जिनमें प्रारंभिक इनपुट से अटेंशन संबंधी समृद्ध जानकारी होती है।
यह क्रमिक डिकोडिंग तब तक चलता है जब तक डीकोडर ऐसा टोकन उत्पन्न नहीं कर देता जो आउटपुट निर्माण के अंत का संकेत दे।
डीकोडर की शुरुआती रेखा पर, प्रक्रिया एन्कोडर जैसी ही होती है। यहाँ इनपुट पहले एम्बेडिंग लेयर से होकर गुजरता है
एम्बेडिंग के बाद, फिर से एन्कोडर की तरह, इनपुट पोज़िशनल इनकोडिंग लेयर से होकर गुजरता है। यह अनुक्रम पोज़िशनल एम्बेडिंग्स बनाने के लिए होता है।
ये पोज़िशनल एम्बेडिंग्स फिर डीकोडर की पहली मल्टी-हेड अटेंशन लेयर में भेजी जाती हैं, जहाँ डीकोडर के इनपुट हेतु अटेंशन स्कोर्स सावधानी से गणना किए जाते हैं।
डीकोडर समान लेयर्स के स्टैक से बना होता है (मूल ट्रांसफ़ॉर्मर मॉडल में 6)। प्रत्येक लेयर में तीन प्रमुख उप-घटक होते हैं:
यह एन्कोडर के सेल्फ-अटेंशन जैसा ही है, पर एक महत्वपूर्ण भिन्नता के साथ: यह पोज़िशन्स को अपने बाद आने वाली पोज़िशन्स पर ध्यान देने से रोकता है—अर्थात अनुक्रम का प्रत्येक शब्द भविष्य के टोकन्स से प्रभावित नहीं होता।
उदाहरण के लिए, जब “are” शब्द के लिए अटेंशन स्कोर्स की गणना हो रही हो, तो यह ज़रूरी है कि “are” को “you”—जो अनुक्रम में बाद का शब्द है—की झलक न मिले।
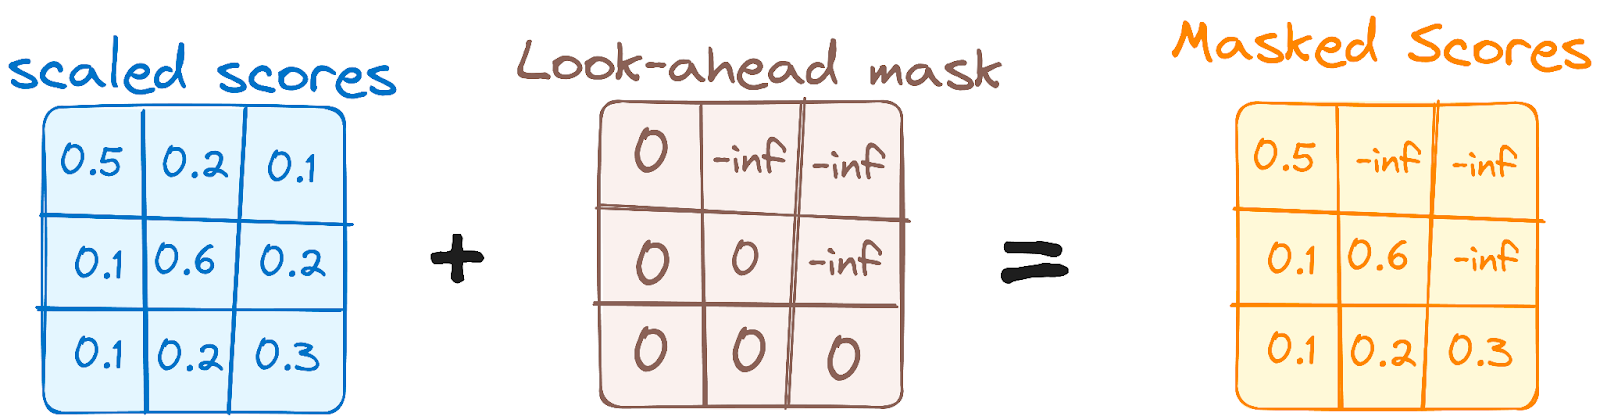
चित्र: लेखक द्वारा। डीकोडर का वर्कफ़्लो: पहली मल्टी-हेड अटेंशन मास्क।
यह मास्किंग सुनिश्चित करती है कि किसी विशेष पोज़िशन के लिए भविष्यवाणी केवल उससे पहले की ज्ञात पोज़िशन्स के आउटपुट पर निर्भर हो।
डीकोडर की दूसरी मल्टी-हेडेड अटेंशन लेयर में एन्कोडर और डीकोडर के घटकों के बीच अनोखा समन्वय दिखता है। यहाँ एन्कोडर के आउटपुट क्वेरीज़ और कीज़ की भूमिका निभाते हैं, जबकि डीकोडर की पहली मल्टी-हेडेड अटेंशन लेयर के आउटपुट वैल्यूज़ के रूप में काम करते हैं।
यह सेटअप एन्कोडर के इनपुट को डीकोडर के साथ प्रभावी रूप से संरेखित करता है, जिससे डीकोडर एन्कोडर के इनपुट के सबसे प्रासंगिक हिस्सों की पहचान और उन पर ज़ोर दे पाता है।
इसके बाद, इस दूसरी मल्टी-हेडेड अटेंशन लेयर के आउटपुट को पॉइंटवाइज़ फ़ीड-फ़ॉरवर्ड लेयर से परिष्कृत किया जाता है, जिससे प्रोसेसिंग और बेहतर होती है।
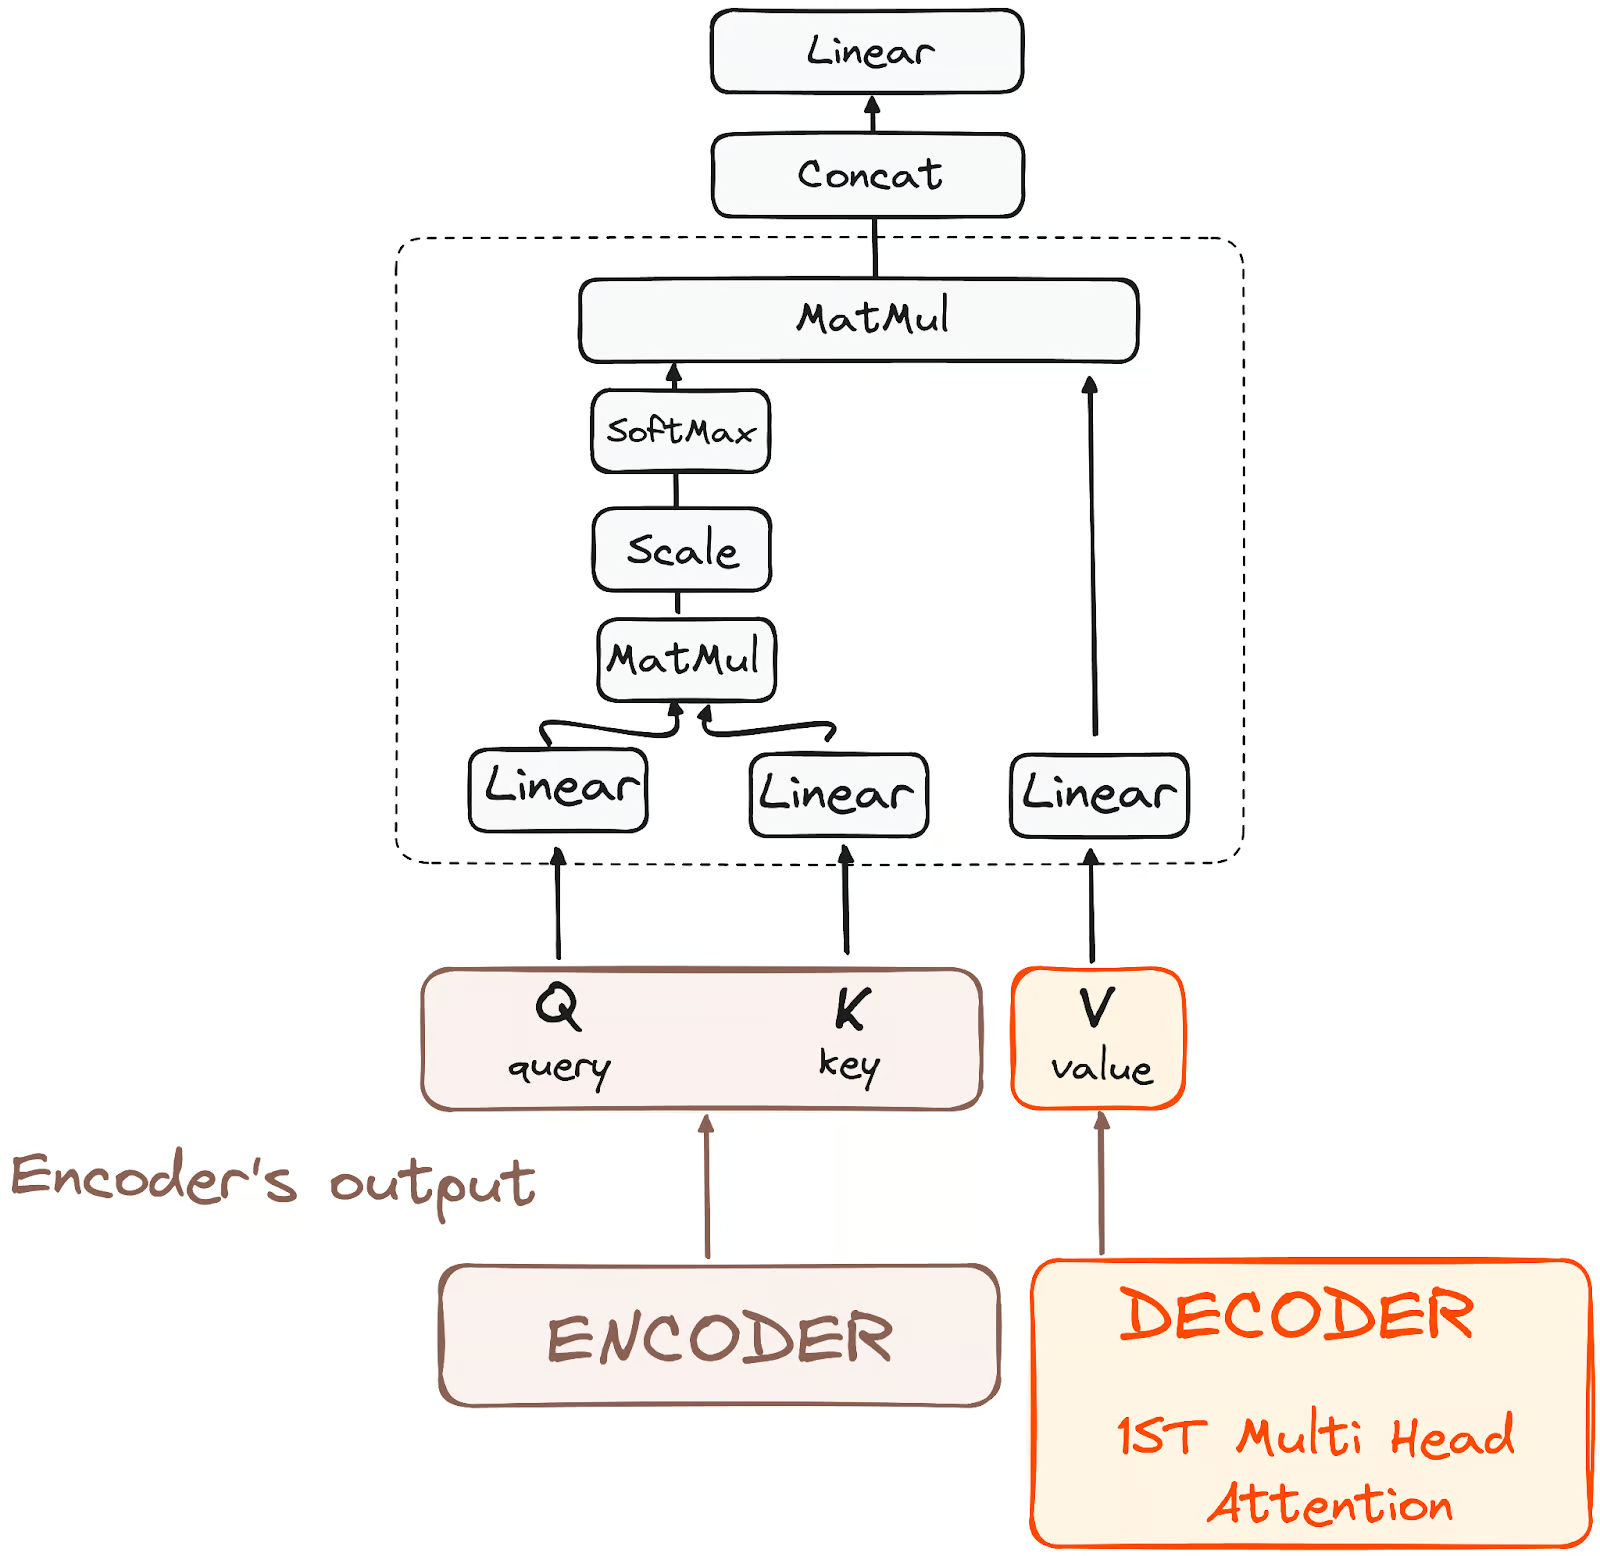
चित्र: लेखक द्वारा। डीकोडर का वर्कफ़्लो: एन्कोडर–डीकोडर अटेंशन।
इस सब-लेयर में, क्वेरीज़ पिछले डीकोडर लेयर से आती हैं, और कीज़ व वैल्यूज़ एन्कोडर के आउटपुट से। इससे डीकोडर की हर पोज़िशन इनपुट अनुक्रम की सभी पोज़िशन्स पर ध्यान दे सकती है—एन्कोडर की जानकारी को डीकोडर की जानकारी के साथ प्रभावी रूप से एकीकृत करते हुए।
एन्कोडर की तरह, प्रत्येक डीकोडर लेयर में एक फ़ुली-कनेक्टेड फ़ीड-फ़ॉरवर्ड नेटवर्क होता है, जिसे प्रत्येक पोज़िशन पर अलग-अलग और एक समान रूप से लागू किया जाता है।
ट्रांसफ़ॉर्मर मॉडल में डेटा की यात्रा अंततः एक अंतिम रैखिक लेयर से होकर पूरी होती है, जो क्लासिफ़ायर का कार्य करती है।
इस क्लासिफ़ायर का आकार संबंधित क्लासों की कुल संख्या के बराबर होता है (शब्दावली में शब्दों की संख्या)। उदाहरण के लिए, यदि 1000 भिन्न शब्द हैं, तो क्लासिफ़ायर का आउटपुट 1000 तत्त्वों की एक ऐरे होगा।
इसके बाद इस आउटपुट को softmax लेयर में भेजा जाता है, जो इसे 0 और 1 के बीच प्रायिकता स्कोर्स में बदल देता है। सबसे उच्च प्रायिकता स्कोर निर्णायक होता है—उसका इंडेक्स सीधे उस शब्द की ओर संकेत करता है जिसे मॉडल अनुक्रम में अगले शब्द के रूप में भविष्यवाणी करता है।
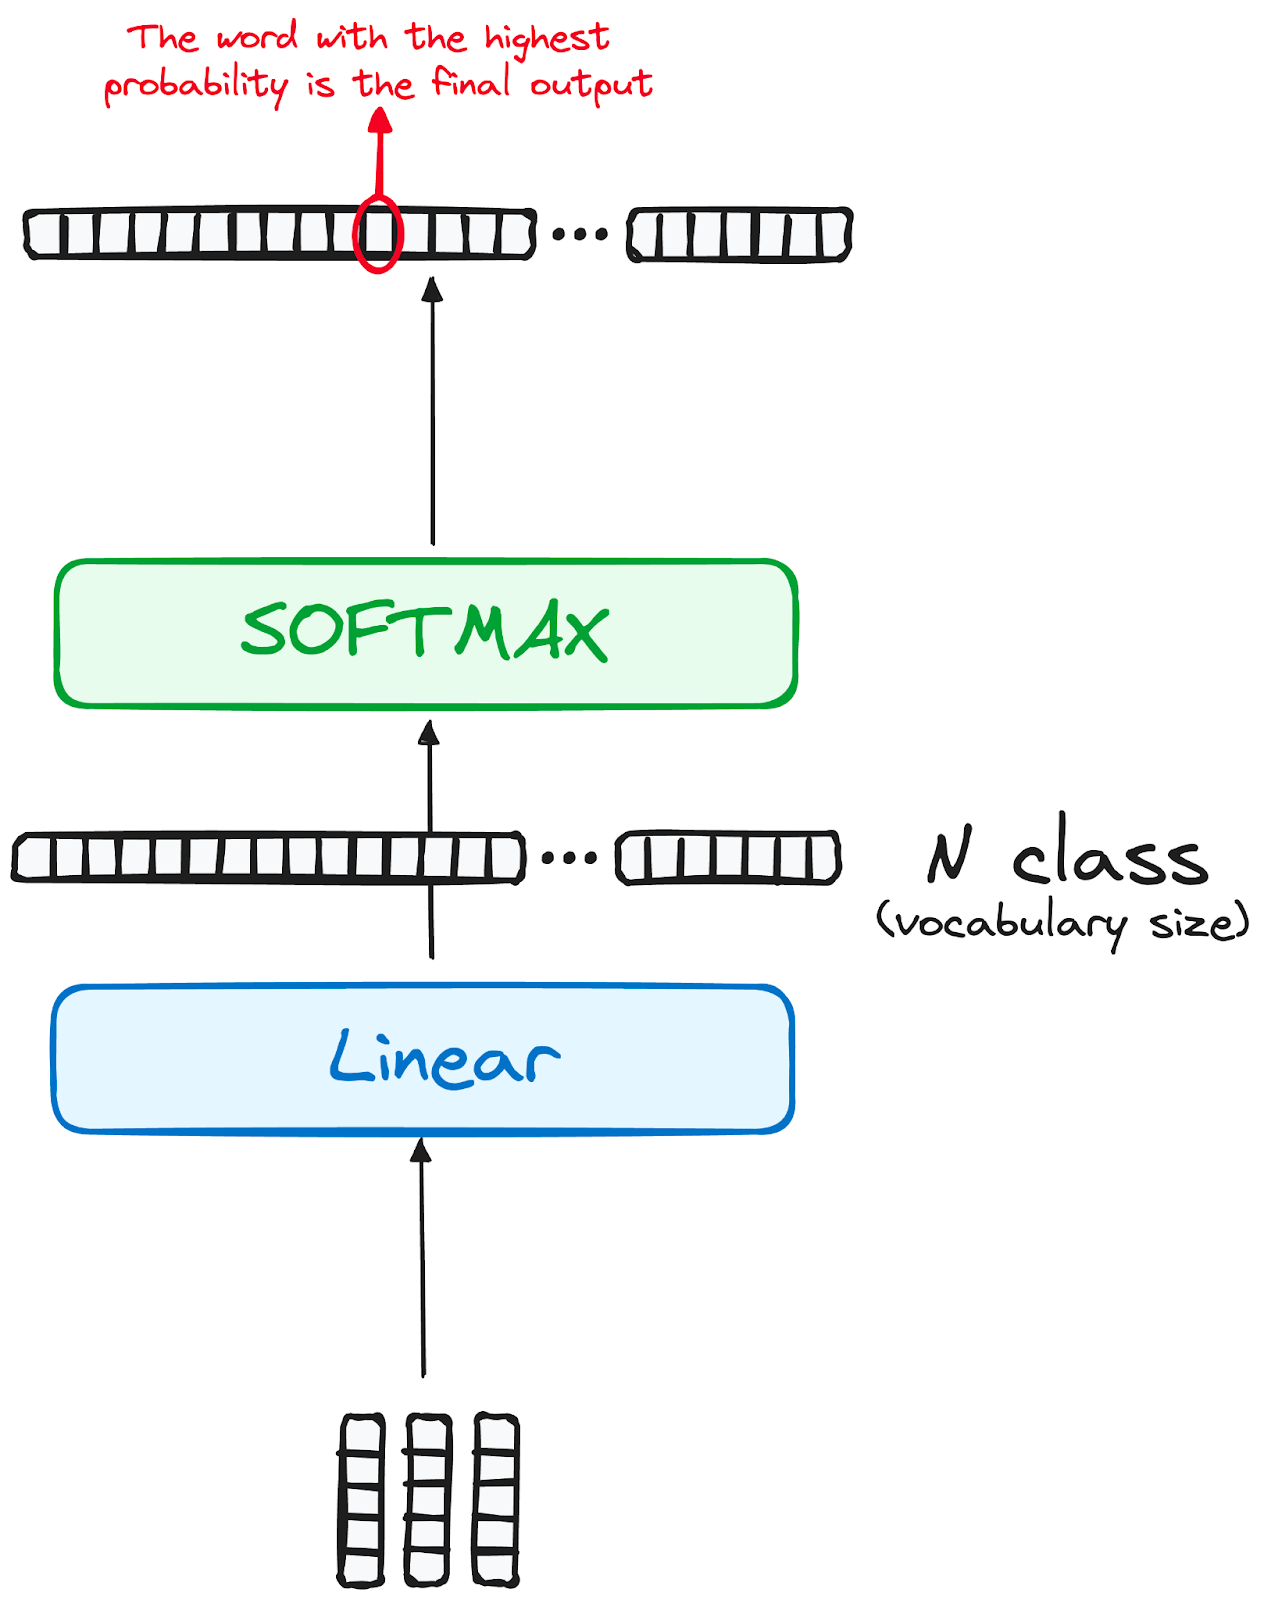
चित्र: लेखक द्वारा। डीकोडर का वर्कफ़्लो: ट्रांसफ़ॉर्मर का अंतिम आउटपुट।
प्रत्येक सब-लेयर (मास्क्ड सेल्फ-अटेंशन, एन्कोडर–डीकोडर अटेंशन, फ़ीड-फ़ॉरवर्ड नेटवर्क) के बाद नॉर्मलाइज़ेशन स्टेप होता है, और हर एक के चारों ओर रेज़िडुअल कनेक्शन शामिल होता है।
अंतिम लेयर का आउटपुट एक भविष्यवाणी किए गए अनुक्रम में बदल दिया जाता है—आम तौर पर रैखिक लेयर और उसके बाद softmax के ज़रिए, जो शब्दावली पर प्रायिकताएँ जनरेट करता है।
डीकोडर अपने परिचालन प्रवाह में नव-जनित आउटपुट को अपने बढ़ते इनपुट्स में शामिल करता है, और फिर डिकोडिंग जारी रखता है। यह चक्र तब तक दोहरता है जब तक मॉडल कोई विशिष्ट टोकन भविष्यवाणी नहीं कर देता, जो पूर्णता का संकेत देता है।
सबसे उच्च प्रायिकता के साथ भविष्यवाणी किया गया टोकन अंतिम क्लास के रूप में सौंपा जाता है, जिसे अक्सर end टोकन द्वारा दर्शाया जाता है।
फिर याद रखें कि डीकोडर एक ही लेयर तक सीमित नहीं है। इसे N लेयर्स के साथ संरचित किया जा सकता है—हर लेयर एन्कोडर और अपने पिछले लेयर्स से प्राप्त इनपुट पर आधारित होती है। यह परतदार संरचना मॉडल को अपना फ़ोकस विविध करने और अपनी अटेंशन हेड्स में अलग-अलग पैटर्न निकालने देती है।
ऐसी बहु-स्तरीय पद्धति मॉडल की भविष्यवाणी क्षमता को उल्लेखनीय रूप से बढ़ा सकती है, क्योंकि यह अलग-अलग अटेंशन संयोजनों की अधिक सूक्ष्म समझ विकसित करती है।
अंतिम आर्किटेक्चर (मूल पेपर से) इस प्रकार दिखता है:
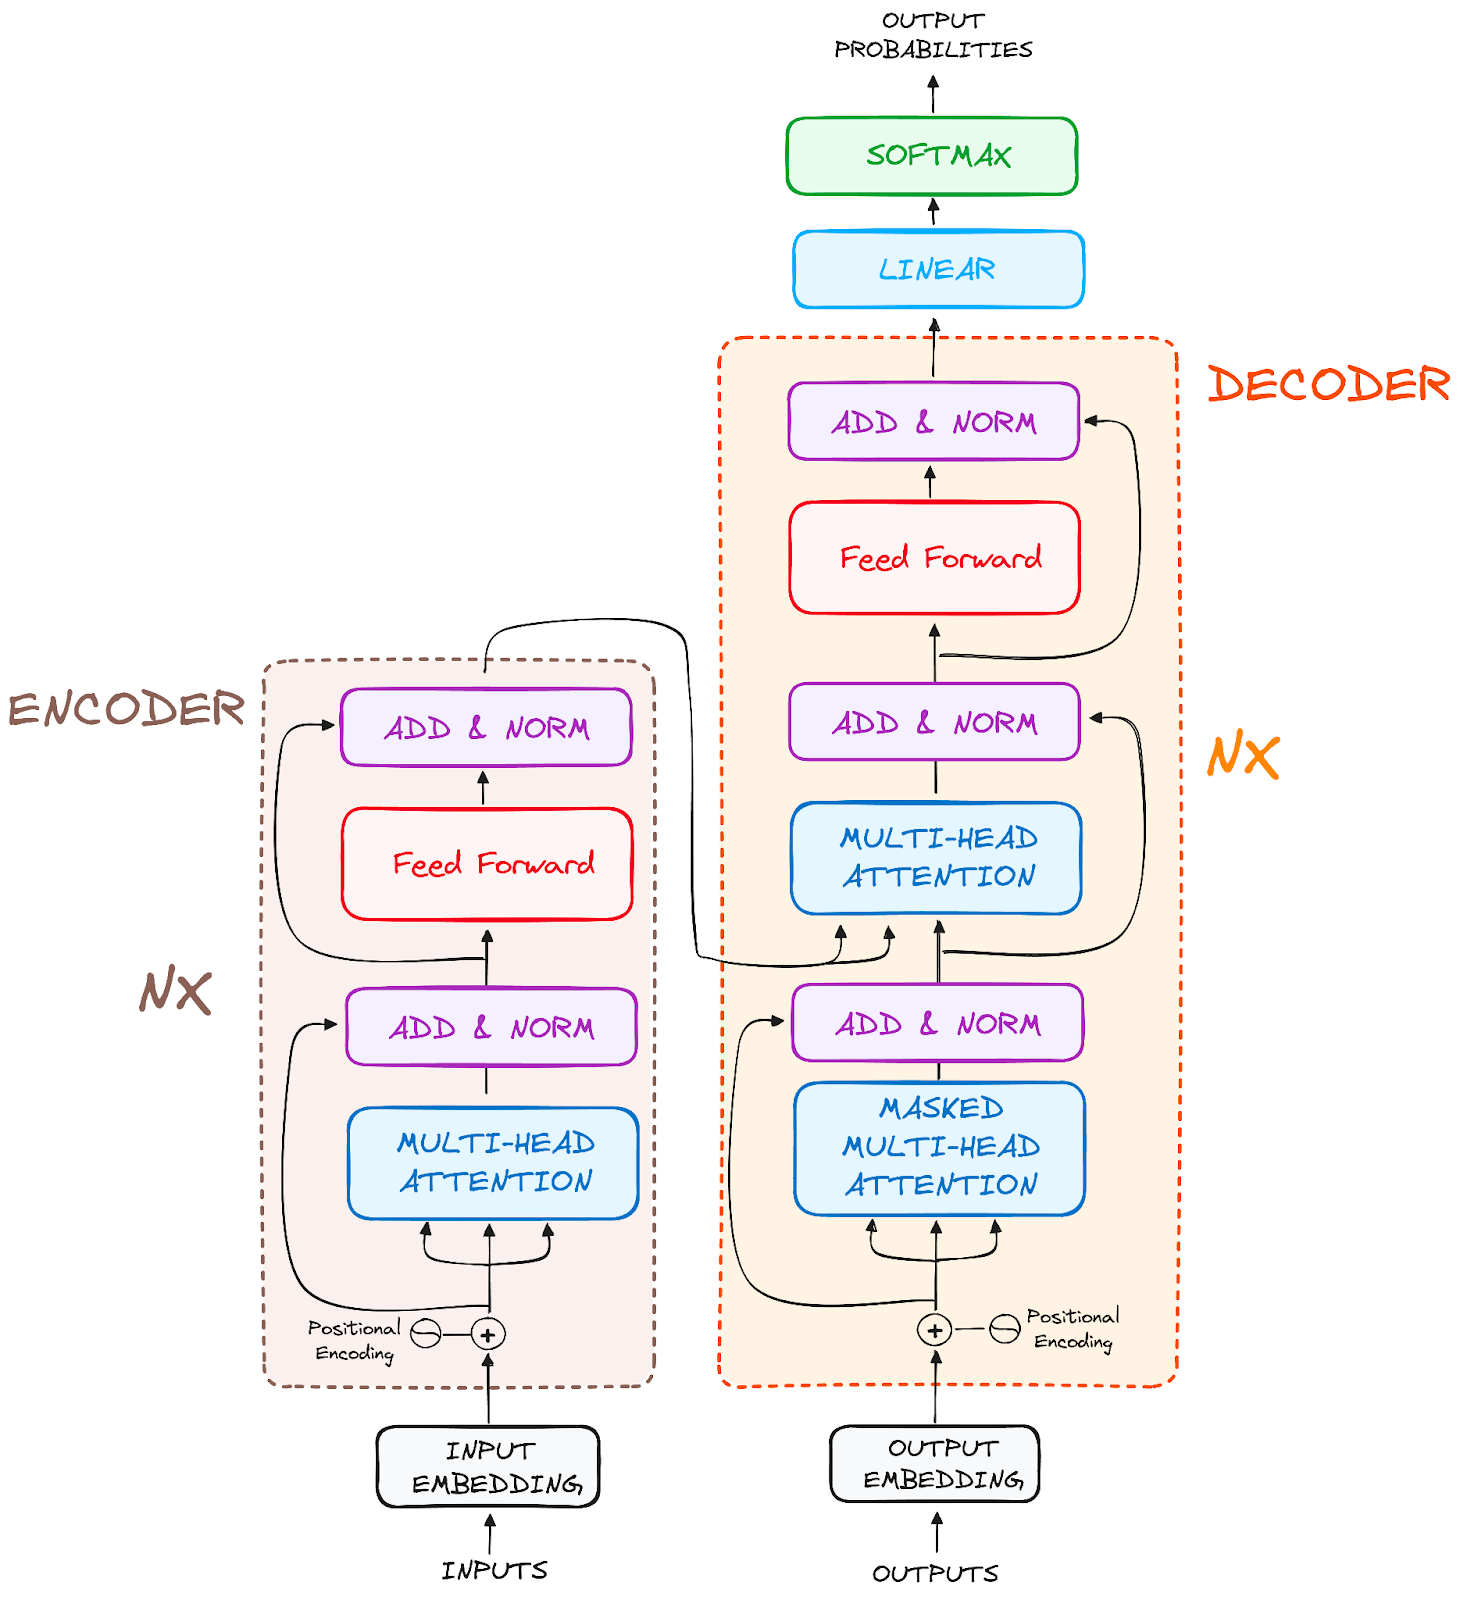
चित्र: लेखक द्वारा। ट्रांसफ़ॉर्मर्स की मूल संरचना।
इस आर्किटेक्चर को बेहतर समझने के लिए, मैं सलाह दूँगा कि आप इस PyTorch के साथ ट्रांसफ़ॉर्मर बनाने के ट्यूटोरियल का अनुसरण करते हुए स्क्रैच से ट्रांसफ़ॉर्मर लागू करने की कोशिश करें।
Google द्वारा 2018 में जारी BERT—एक ओपन-सोर्स नैचुरल लैंग्वेज प्रोसेसिंग फ़्रेमवर्क—ने अपनी अनूठी द्विदिश ट्रेनिंग से NLP में क्रांति ला दी, जिससे मॉडल अगले शब्द के बारे में अधिक संदर्भ-सूचित भविष्यवाणियाँ कर पाता है।
किसी शब्द के चारों ओर के संदर्भ को दोनों दिशाओं से समझकर, BERT ने प्रश्नोत्तर और संदिग्ध/अस्पष्ट भाषा समझ जैसे कार्यों में पिछले मॉडलों को पीछे छोड़ दिया। इसका मूल ट्रांसफ़ॉर्मर्स पर आधारित है, जो प्रत्येक आउटपुट और इनपुट तत्व को गतिशील रूप से जोड़ता है।
विकिपीडिया पर प्री-ट्रेंड BERT ने कई NLP कार्यों में उत्कृष्ट प्रदर्शन किया, जिससे Google ने इसे अपने सर्च इंजन में अधिक स्वाभाविक क्वेरीज़ के लिए एकीकृत किया। इस नवाचार ने उन्नत भाषा मॉडलों के विकास की दौड़ शुरू कर दी और जटिल भाषा समझने की क्षमता में क्षेत्र को आगे बढ़ाया।
BERT के बारे में अधिक जानने के लिए हमारा अलग लेख देखें जो BERT मॉडल का परिचय देता है।
LaMDA (Language Model for Dialogue Applications) Google द्वारा विकसित ट्रांसफ़ॉर्मर-आधारित मॉडल है, जिसे विशेष रूप से संवादात्मक कार्यों के लिए डिज़ाइन किया गया और 2021 के Google I/O कीनोट में लॉन्च किया गया। इसे अधिक स्वाभाविक और संदर्भानुकूल प्रतिक्रियाएँ उत्पन्न करने के लिए बनाया गया है, जिससे विभिन्न अनुप्रयोगों में उपयोगकर्ता संवाद बेहतर होते हैं।
LaMDA का डिज़ाइन इसे विषयों और उपयोगकर्ता इरादों की विस्तृत शृंखला को समझने और जवाब देने में सक्षम बनाता है, जिससे यह चैटबोट्स, वर्चुअल असिस्टेंट्स और अन्य इंटरैक्टिव AI प्रणालियों के लिए उपयुक्त है, जहाँ गतिशील बातचीत महत्वपूर्ण होती है।
संवादी समझ और प्रत्युत्तर पर यह फोकस LaMDA को नैचुरल लैंग्वेज प्रोसेसिंग और AI-चालित संचार के क्षेत्र में एक महत्वपूर्ण प्रगति के रूप में चिह्नित करता है।
यदि आप LaMDA मॉडलों को और समझना चाहते हैं, तो हमारा LaMDA पर लेख आपकी समझ बेहतर करेगा।
OpenAI द्वारा विकसित GPT और ChatGPT उन्नत जनरेटिव मॉडल हैं, जो सुसंगत और संदर्भानुकूल पाठ उत्पन्न करने की क्षमता के लिए जाने जाते हैं। GPT-1 पहला मॉडल था, जो जून 2018 में लॉन्च हुआ, और GPT-3—सबसे प्रभावशाली मॉडलों में से एक—दो साल बाद 2020 में आया।
ये मॉडल कंटेंट निर्माण, बातचीत, भाषा अनुवाद आदि सहित कई कार्यों में दक्ष हैं। GPT की आर्किटेक्चर इसे ऐसा पाठ उत्पन्न करने देती है जो मानव लेखन से काफ़ी मेल खाता है—रचनात्मक लेखन, कस्टमर सपोर्ट, और कोडिंग असिस्टेंस जैसे अनुप्रयोगों में उपयोगी। ChatGPT, जो संवादात्मक संदर्भों के लिए अनुकूलित वेरिएंट है, मानव-जैसी वार्ता जनरेट करने में उत्कृष्ट है—जिससे चैटबॉट्स और वर्चुअल असिस्टेंट्स में इसका उपयोग बढ़ता है।
Anthropic द्वारा विकसित Claude, सुरक्षा और सहायतापूर्णता पर केंद्रित ट्रांसफ़ॉर्मर-आधारित AI असिस्टेंट्स का परिवार है। Claude Constitutional AI (CAI) का उपयोग करता है—एक प्रशिक्षण दृष्टिकोण जिसमें मॉडल को सिद्धांतों के एक सेट द्वारा निर्देशित किया जाता है ताकि वह सहायक, हानिरहित और ईमानदार प्रतिक्रियाएँ दे।
Claude 3 (2024 में जारी) ने तीन मॉडल टियर—Haiku, Sonnet, और Opus—पेश किए, जो गति और क्षमता के बीच अलग-अलग संतुलन देते हैं। ये मॉडल सूक्ष्म तर्क, जटिल निर्देशों का पालन, और लंबी बातचीत (200K टोकन्स तक) में संदर्भ बनाए रखने में उत्कृष्ट हैं।
2025 और 2026 में, Anthropic ने Claude 4 मॉडल जारी किए; हाल के Opus 4.6 और Sonnet 4.6 कई LLM बेंचमार्क्स में शीर्ष पर रहे।
फ़ाउंडेशन मॉडलों—विशेषकर ट्रांसफ़ॉर्मर्स—का परिदृश्य तेज़ी से विस्तार कर रहा है। एक अध्ययन ने 50 से अधिक महत्वपूर्ण ट्रांसफ़ॉर्मर मॉडलों की पहचान की, जबकि स्टैनफोर्ड समूह ने उनमें से 30 का मूल्यांकन किया—क्षेत्र की तीव्र प्रगति को स्वीकारते हुए। NVIDIA के Inception प्रोग्राम का हिस्सा NLP Cloud नामक एक नवोन्मेषी स्टार्टअप एयरलाइंस और फ़ार्मेसी जैसे क्षेत्रों के लिए व्यावसायिक रूप से लगभग 25 बड़े भाषा मॉडलों का उपयोग करता है।
इन मॉडलों को ओपन-सोर्स करने की प्रवृत्ति बढ़ रही है—Hugging Face का मॉडल हब जैसे प्लेटफ़ॉर्म इसमें अग्रणी हैं। साथ ही, अनेक ट्रांसफ़ॉर्मर-आधारित मॉडल विकसित किए गए हैं, जो अलग-अलग NLP कार्यों में विशेषज्ञता दिखाते हैं—मॉडल की बहुमुखी प्रतिभा और दक्षता का प्रदर्शन करते हुए।
आप अलग लेख में सभी फ़ाउंडेशन मॉडल्स के बारे में अधिक जान सकते हैं—जो बताते हैं कि वे क्या हैं और सबसे अधिक उपयोग में कौन-से हैं।
मूल 2017 की आर्किटेक्चर के बाद से, ट्रांसफ़ॉर्मर्स ने सीमाएँ दूर करने और नए डोमेन्स में विस्तार के लिए काफ़ी विकास किया है।
विज़न ट्रांसफ़ॉर्मर्स छवियों को पैचेज़ में बाँटकर प्रत्येक पैच को टोकन मानते हुए सेल्फ-अटेंशन को छवियों पर लागू करते हैं। यह पद्धति इमेज क्लासिफ़िकेशन, ऑब्जेक्ट डिटेक्शन, और इमेज जनरेशन के लिए अत्यंत प्रभावी साबित हुई है—और बड़े डेटासेट्स पर अक्सर पारंपरिक CNNs से बेहतर प्रदर्शन करती है।
आधुनिक मॉडल जैसे GPT-5, Gemini 3, और Llama 4 एक ही आर्किटेक्चर में अनेक इनपुट प्रकार (टेक्स्ट, छवियाँ, ऑडियो, वीडियो) प्रोसेस करते हैं। ये मल्टीमोडल ट्रांसफ़ॉर्मर्स एकीकृत एम्बेडिंग स्पेसेज़ और क्रॉस-अटेंशन मैकेनिज़्म का उपयोग कर अलग-अलग मोडैलिटीज़ पर एक साथ तर्क करते हैं।
सेल्फ-अटेंशन की वर्गात्मक जटिलता संदर्भ लंबाई को सीमित करती है। कई नवाचार इसका समाधान प्रस्तुत करते हैं:
NLP में ट्रांसफ़ॉर्मर मॉडलों का बेंचमार्किंग और प्रदर्शन मूल्यांकन उनकी प्रभावशीलता और दक्षता का सुव्यवस्थित आकलन है।
कार्य की प्रकृति के आधार पर, इसे करने के अलग-अलग तरीके और संसाधन हैं:
मशीन अनुवाद कार्यों में, आप WMT (Workshop on Machine Translation) जैसे मानक डेटासेट्स का लाभ उठा सकते हैं—जहाँ MT प्रणालियाँ विविध भाषा युग्मों से जूझती हैं, जिनमें हर एक की अपनी चुनौतियाँ होती हैं।
BLEU, METEOR, TER, और chrF जैसे मेट्रिक्स मार्गदर्शक औज़ार के रूप में काम करते हैं, जो हमें शुद्धता और प्रवाह की ओर ले जाते हैं।
साथ ही, समाचार, साहित्य और तकनीकी पाठ जैसे विविध डोमेन्स में परीक्षण यह सुनिश्चित करता है कि MT प्रणाली अनुकूलनीय और बहुमुखी है—डिजिटल दुनिया में एक सच्चा बहुभाषी।
QA मॉडलों का मूल्यांकन करने के लिए, हम SQuAD (Stanford Question Answering Dataset), Natural Questions, या TriviaQA जैसी प्रश्न-उत्तर संग्रहों का उपयोग करते हैं।
प्रत्येक अपना अलग खेल है—अपनी-अपनी नियमावली के साथ। उदाहरण के लिए, SQuAD दिए गए पाठ में उत्तर ढूँढने के बारे में है, जबकि अन्य कहीं से भी प्रश्न पूछे जाने वाले क्विज़ जैसे होते हैं।
प्रदर्शन आँकने के लिए हम Precision, Recall, F1, और कभी-कभी exact match स्कोर जैसे मेट्रिक्स का उपयोग करते हैं।
Natural Language Inference (NLI) में, हम SNLI (Stanford Natural Language Inference), MultiNLI, और ANLI जैसे विशेष डेटासेट्स का उपयोग करते हैं।
ये भाषा विविधताओं और पेचीदा मामलों की बड़ी लाइब्रेरियाँ हैं—जो यह जाँचने में मदद करती हैं कि हमारे कंप्यूटर्स अलग-अलग वाक्यों को कितनी अच्छी तरह समझते हैं। हम मुख्यतः यह देखते हैं कि कंप्यूटर कथनों के अनुकूल, विरोधी, या असंबद्ध होने को कितनी सटीकता से पहचानते हैं।
यह देखना भी महत्वपूर्ण है कि कंप्यूटर कठिन भाषाई बातों को कैसे समझता है—जैसे सर्वनाम किसकी ओर इशारा करता है, या 'नहीं', 'सभी', और 'कुछ' जैसे शब्दों का अर्थ।
न्यूरल नेटवर्क्स की दुनिया में, दो प्रमुख संरचनाओं की आमतौर पर ट्रांसफ़ॉर्मर्स से तुलना होती है—प्रत्येक विशिष्ट डेटा प्रोसेसिंग के लिए अलग लाभ और चुनौतियाँ देती है। RNNs, जो इस लेख में कई बार आ चुके हैं, और Convolutional लेयर्स।
रिकरेंट लेयर्स—Recurrent Neural Networks (RNNs) की आधारशिला—क्रमिक डेटा संभालने में निपुण हैं। इस आर्किटेक्चर की ताकत क्रमिक ऑपरेशंस करने में है—जो भाषा प्रोसेसिंग या टाइम-सीरीज़ विश्लेषण जैसे कार्यों के लिए ज़रूरी हैं। रिकरेंट लेयर में पिछले स्टेप का आउटपुट अगले स्टेप के इनपुट के रूप में वापस फ़ीड होता है। यह लूपिंग तंत्र नेटवर्क को पूर्व जानकारी याद रखने देता है, जो अनुक्रम के संदर्भ को समझने में अहम है।
हालाँकि, जैसा हमने चर्चा की, इस क्रमिक प्रोसेसिंग के दो मुख्य प्रभाव हैं:
ट्रांसफ़ॉर्मर मॉडल रिकरेंट लेयर्स वाली आर्किटेक्चर्स से काफ़ी अलग हैं क्योंकि इनमें रिकरेंस नहीं होती। जैसा हमने देखा, ट्रांसफ़ॉर्मर की अटेंशन लेयर दोनों समस्याओं को संबोधित करती है—जिससे वे NLP अनुप्रयोगों के लिए RNNs का स्वाभाविक विकास बनते हैं।
दूसरी ओर, कन्वोल्यूशनल लेयर्स—Convolutional Neural Networks (CNNs) की आधारशिला—स्थानिक डेटा, जैसे छवियों, को प्रोसेस करने में दक्षता के लिए जानी जाती हैं।
ये लेयर्स कर्नेल्स (फ़िल्टर्स) का उपयोग करती हैं, जो इनपुट डेटा पर स्कैन करके फ़ीचर्स निकालते हैं। कर्नेल की चौड़ाई समायोजित की जा सकती है—ताकि कार्य के अनुसार नेटवर्क छोटे या बड़े फ़ीचर्स पर फ़ोकस कर सके।
हालाँकि कन्वोल्यूशनल लेयर्स डेटा में स्थानिक पदानुक्रम और पैटर्न पकड़ने में उत्कृष्ट हैं, वे लंबी अवधि की निर्भरताओं के साथ चुनौतियाँ झेलती हैं। इनमें क्रमिक जानकारी अंतर्निहित रूप से सम्मिलित नहीं होती—जिससे वे ऐसे कार्यों के लिए कम उपयुक्त हैं जिनमें अनुक्रम का क्रम या संदर्भ समझना आवश्यक है।
इसीलिए CNNs और ट्रांसफ़ॉर्मर्स अलग-अलग प्रकार के डेटा और कार्यों के लिए अनुकूलित हैं। स्पैटियल जानकारी प्रोसेस करने में दक्षता के कारण कंप्यूटर विज़न में CNNs हावी हैं, जबकि ट्रांसफ़ॉर्मर्स—लंबी दूरी की निर्भरताएँ समझने की क्षमता के कारण—जटिल क्रमिक कार्यों, विशेषकर NLP, के लिए पसंदीदा हैं।
सफलताओं के बावजूद, ट्रांसफ़ॉर्मर्स में कुछ उल्लेखनीय सीमाएँ हैं:
इन सीमाओं को दूर करने हेतु Flash Attention, mixture-of-experts, और retrieval-augmented generation (RAG) जैसे आर्किटेक्चरल नवाचारों पर शोध जारी है।
समापन में, ट्रांसफ़ॉर्मर्स कृत्रिम बुद्धिमत्ता और नैचुरल लैंग्वेज प्रोसेसिंग (NLP) में एक विराट उपलब्धि बनकर उभरे हैं।
अपने विशिष्ट सेल्फ-अटेंशन मैकेनिज़्म के ज़रिए क्रमिक डेटा को प्रभावी ढंग से संभालकर, इन मॉडलों ने पारंपरिक RNNs को पीछे छोड़ दिया है। लंबी अनुक्रमों को अधिक दक्षता से संभालने और डेटा प्रोसेसिंग को समानांतर करने की उनकी क्षमता प्रशिक्षण को उल्लेखनीय रूप से तेज़ करती है।
Google के BERT और OpenAI की GPT श्रृंखला जैसे अग्रणी मॉडल ट्रांसफ़ॉर्मर्स के परिवर्तनकारी प्रभाव का उदाहरण हैं—सर्च इंजनों को बेहतर बनाना और मानव-जैसा पाठ जनरेट करना।
नतीजतन, वे आधुनिक मशीन लर्निंग में अपरिहार्य बन गए हैं—AI की सीमाएँ आगे बढ़ाते हुए और तकनीकी प्रगति में नए क्षितिज खोलते हुए।
यदि आप ट्रांसफ़ॉर्मर्स और उनके व्यावहारिक उपयोग में उतरना चाहते हैं, तो हमारा Transformers और Hugging Face पर लेख एक उत्तम शुरुआत है! आप हमारे विस्तृत गाइड के साथ यह भी सीख सकते हैं कि PyTorch से ट्रांसफ़ॉर्मर कैसे बनाएँ।
ट्रांसफ़ॉर्मर्स और LLMs के बारे में और सीखें!
course
course
course