प्रभावी डेटा स्टोरेज किसी भी सेक्टर के व्यवसाय की परिचालन सफलता का एक महत्वपूर्ण घटक है। जितना अधिक डेटा एकत्रित होता है, उतनी ही स्केलेबल, भरोसेमंद और किफायती स्टोरेज समाधानों की ज़रूरत बढ़ जाती है।
सही डेटा स्टोरेज चुनना चुनौतीपूर्ण हो सकता है, क्योंकि क्लाउड और ऑन-प्रिमाइसेस—दोनों में—कई विकल्प मौजूद हैं, जिनके अपने-अपने लाभ और सीमाएँ हैं।
यह लेख सभी संभावित विकल्पों को कवर करने का लक्ष्य नहीं रखता, बल्कि स्केलेबल, भरोसेमंद और किफायती सेवाओं पर केंद्रित है: Amazon Simple Storage Service (Amazon S3) और Amazon Elastic File System (EFS)।
हम पहले बताएंगे कि व्यवसायों को स्टोरेज सेवाएँ क्यों अपनानी चाहिए और फिर स्टोरेज सेवाओं की बुनियादी बातों को कवर करेंगे। इसके बाद हम परिचालन प्रक्रिया में स्टोरेज सेवाओं को एकीकृत करने के लिए मार्गदर्शन देंगे। आख़िरी भाग उन्नत अवधारणाओं की गहराई से चर्चा है, विशेष रूप से प्रदर्शन और लागत अनुकूलन पर फोकस के साथ।
यदि आप Amazon Web Services (AWS) पर एक व्यापक प्रारंभिक संसाधन खोज रहे हैं, तो यह Introduction to AWS कोर्स देखें।
फाइल स्टोरेज के लिए AWS क्यों?
इतने सारे स्टोरेज विकल्पों के बीच, यह बताना महत्वपूर्ण है कि कोई व्यवसाय फाइल स्टोरेज के लिए AWS क्यों चुने—यही इस खंड का उद्देश्य है।
यह AWS स्टोरेज सेवाओं और पारंपरिक सेवाओं के बीच तुलनात्मक विश्लेषण से शुरू होता है, साथ ही वास्तविक-world अनुप्रयोगों के संक्षिप्त उदाहरणों के साथ। उम्मीद है, यह विभिन्न परिदृश्यों में AWS S3 और EFS की प्रासंगिकता को मज़बूती देगा।
स्टोरेज विकल्पों की तुलना
पारंपरिक स्टोरेज सेवाएँ और AWS स्टोरेज सेवाएँ अलग-अलग फीचर और लाभ प्रदान करती हैं। नीचे दी गई तालिका में हम तुलनात्मक विश्लेषण करते हैं:
फ़ीचर्स
पारंपरिक स्टोरेज
AWS S3 और EFS
लागत
हार्डवेयर पर पूंजीगत व्यय और मेंटेनेंस की लगातार लागत—समय के साथ अनिश्चित हो सकती है।
पे-एज़-यू-गो प्राइसिंग मॉडल अग्रिम लागत घटाता है और उपयोग-आधारित लागत प्रबंधन को बेहतर बनाता है।
कंप्लायंस
आंतरिक नियंत्रण और ऑडिट के माध्यम से प्राप्त—मानकों को बनाए रखने के लिए अतिरिक्त संसाधनों की आवश्यकता हो सकती है।
AWS HIPAA और GDPR जैसे अनेक उद्योग मानकों के अनुरूप है, जिससे उपयोगकर्ता कंप्लायंस सरल हो जाता है।
डेटा उपलब्धता
मुख्यतः विशिष्ट स्थानों या नेटवर्क से ही सुलभ। रिमोट एक्सेस कम सुरक्षित और जटिल हो सकता है।
इंटरनेट पर वैश्विक रूप से सुलभ, उच्च उपलब्धता और डेटा रिडंडेंसी के साथ।
डेटा टिकाऊपन
भौतिक क्षति, चोरी, या प्राकृतिक आपदाओं के प्रति संवेदनशील।
कई अवेलेबिलिटी ज़ोन में स्वतः डेटा प्रतिलिपि बनाकर 99.99999999999% (11 नाइन्स) टिकाऊपन प्रदान करते हैं।
मैनेजमेंट और मेंटेनेंस
हार्डवेयर मेंटेनेंस, सॉफ्टवेयर अपडेट और ट्रबलशूटिंग के लिए समर्पित टीम की आवश्यकता।
AWS द्वारा प्रबंधित। इससे उपयोगकर्ताओं पर प्रशासनिक बोझ कम होता है।
परफॉर्मेंस
विशिष्ट हार्डवेयर और नेटवर्क अवसंरचना पर निर्भर। साथ ही, अपग्रेड महंगे हो सकते हैं।
कस्टमाइज़ेबल परफॉर्मेंस विकल्प प्रदान करते हैं। S3 स्टोरेज क्लासेज़ और एक्सीलरेशन फ़ीचर्स देता है, जबकि EFS बर्स्टिंग वर्कलोड्स और थ्रूपुट मॉडल्स का समर्थन करता है।
स्केलेबिलिटी
भौतिक अवसंरचना से सीमित और स्केल करने के लिए मैनुअल हस्तक्षेप की आवश्यकता।
उच्च रूप से स्केलेबल, बिना अग्रिम प्रोविज़निंग के स्टोरेज समायोजन आसान बनाता है।
सुरक्षा
स्थानीय सुरक्षा उपायों पर निर्भर। डेटा सुरक्षा और कंप्लायंस सुनिश्चित करने के लिए पर्याप्त प्रयास चाहिए।
व्यापक सुरक्षा नियंत्रण प्रदान करते हैं, जिनमें डेटा एन्क्रिप्शन (एट रेस्ट और इन ट्रांजिट), एक्सेस मैनेजमेंट, और कंप्लायंस सर्टिफिकेशंस शामिल हैं।
S3 और EFS दोनों के उद्योगों में व्यापक अनुप्रयोग हैं। नीचे दोनों सेवाओं के वास्तविक-world उपयोग मामलों के कुछ उदाहरण दिए गए हैं, जो विभिन्न परिदृश्यों में उनकी प्रासंगिकता और उपयोगिता को दर्शाते हैं।
Amazon S3 उपयोग के मामले
पहले Amazon Simple Storage Service (S3) के उपयोग मामलों पर विचार करें:
वेबसाइट होस्टिंग: S3 स्टैटिक वेबसाइट्स जैसे ब्लॉग, मार्केटिंग वेबसाइट्स और पोर्टफोलियो होस्ट करता है। इसकी वैश्विक पहुंच और उच्च टिकाऊपन सुनिश्चित करते हैं कि वेबसाइट सामग्री दुनिया भर में तेज़ी और विश्वसनीयता से डिलीवर हो।
बैकअप और डिजास्टर रिकवरी: उच्च टिकाऊपन और उपलब्धता के कारण S3 का उपयोग बैकअप, डेटा आर्काइविंग और डिजास्टर रिकवरी के लिए किया जा सकता है।
एनालिटिक्स के लिए डेटा लेक: कंपनियाँ बड़ी मात्रा में स्ट्रक्चर्ड और अनस्ट्रक्चर्ड डेटा को S3 में एकत्रित कर बिग डेटा एनालिटिक्स के लिए उपयोग कर सकती हैं।
कंटेंट डिस्ट्रीब्यूशन और डिलीवरी: मीडिया कंपनियाँ S3 का उपयोग बड़े वीडियो, ऑडियो और इमेज फाइलों को स्टोर और डिस्ट्रीब्यूट करने के लिए करती हैं, आगे के विश्लेषण के उद्देश्य से। CloudFront और Content Delivery Network सेवाओं के साथ उपयोग करने पर, S3 कम लेटेंसी के साथ कंटेंट कुशलतापूर्वक डिलीवर कर सकता है।
EFS उपयोग के मामले
अब Amazon Elastic File System (EFS) के उपयोग मामलों पर विचार करें:
EC2 इंस्टेंसेज़ के लिए साझा फाइल स्टोरेज: EFS EC2 इंस्टेंसेज़ के लिए उच्च उपलब्ध और स्केलेबल फाइल स्टोरेज का काम करता है। कई इंस्टेंसेज़ पर चलने वाले एप्लिकेशंस EFS के माध्यम से डेटा शेयर कर सकते हैं, जिससे यह उन वर्कलोड्स के लिए आदर्श बनता है जिन्हें फाइल सिस्टम फीचर्स जैसे हाइरार्किकल स्टोरेज, डायरेक्टरी नेविगेशन और फाइल लॉकिंग की आवश्यकता होती है।
कॉन्टेनर स्टोरेज: EFS को कंटेनराइज़्ड एप्लिकेशंस के साथ उपयोग किया जा सकता है, जिनमें Amazon ECS और AWS पर Kubernetes द्वारा ऑर्केस्ट्रेटेड एप्लिकेशंस शामिल हैं। यह कंटेनर्स के लिए परसिस्टेंट स्टोरेज लेयर प्रदान करता है, जिससे डेटा एक सिंगल कंटेनर इंस्टेंस के जीवनकाल से परे भी बना रहता है।
बिग डेटा और एनालिटिक्स: EFS साझा फाइल स्टोरेज की आवश्यकता वाले बिग डेटा एनालिटिक्स एप्लिकेशंस के लिए उपयुक्त है। यह बड़े डेटासेट्स के प्रोसेसिंग के लिए आवश्यक थ्रूपुट, IOPS और लो-लेटेंसी प्रदान करके जटिल एनालिटिक वर्कलोड्स का समर्थन कर सकता है।
AWS स्टोरेज की बुनियादी बातें
S3 और EFS स्टोरेज सेवाओं के बारे में इन जानकारियों के साथ, यह जानना आवश्यक है कि कब किस सेवा का उपयोग करें—और यही इस खंड का उद्देश्य है। हम पहले ब्लॉक, फाइल और ऑब्जेक्ट स्टोरेज का परिचय देंगे और फिर S3 और EFS के तुलनात्मक पक्ष में उतरेंगे।
ब्लॉक, फाइल, और ऑब्जेक्ट स्टोरेज का परिचय
ब्लॉक स्टोरेज, फाइल स्टोरेज और ऑब्जेक्ट स्टोरेज डेटा स्टोरेज सिस्टम्स के तीन बुनियादी प्रकार हैं। प्रत्येक क्लाउड कंप्यूटिंग और डेटा प्रबंधन में अलग-अलग उद्देश्यों की पूर्ति करता है।
ब्लॉक स्टोरेज
ब्लॉक स्टोरेज डेटा को ब्लॉक्स में विभाजित करता है, प्रत्येक का एक यूनिक आइडेंटिफायर होता है, जिससे लचीला और कुशल डेटा प्रबंधन संभव होता है। Amazon Elastic Block Store (EBS) और Instance Store Volumes AWS इकोसिस्टम में ब्लॉक स्टोरेज के उदाहरण हैं।
Instance Store अस्थायी स्टोरेज प्रदान करता है जो सीधे होस्ट कंप्यूटर से जुड़ा होता है—अस्थायी डेटा के लिए उपयुक्त। इसके विपरीत, EBS परसिस्टेंट ब्लॉक-लेवल स्टोरेज देता है, जो डेटाबेस, एप्लिकेशंस और फाइल सिस्टम्स के लिए उपयुक्त है जिन्हें टिकाऊपन और स्नैपशॉट्स के माध्यम से इन्क्रीमेंटल बैकअप्स की आवश्यकता होती है।
फाइल स्टोरेज
फाइल स्टोरेज डेटा को फाइल्स और फोल्डर्स की हाइरार्किकल संरचना में व्यवस्थित करता है, जैसा कि किसी पारंपरिक कंप्यूटर फाइल सिस्टम में होता है। यह सहज तरीका विभिन्न एप्लिकेशंस और सेवाओं में डेटा एक्सेस और प्रबंधन को सरल बनाता है।
Amazon Elastic File System (EFS) क्लाउड में फाइल स्टोरेज का एक उदाहरण है। यह साझा फाइल सिस्टम प्रदान करता है जो स्वतः स्केल करता है और कई इंस्टेंसेज़ से एक साथ एक्सेस का समर्थन करता है।
EFS विशेष रूप से उन एप्लिकेशंस के लिए लाभदायक है जिन्हें फाइल्स तक साझा एक्सेस की आवश्यकता होती है या ऐसा कंटेंट सर्व करना होता है जिसे कई उपयोगकर्ता या सिस्टम एक्सेस और संपादित कर सकें।
ऑब्जेक्ट स्टोरेज
ऑब्जेक्ट स्टोरेज, जैसे Amazon S3, विशाल मात्रा में अनस्ट्रक्चर्ड डेटा स्टोर करने के लिए डिज़ाइन किया गया है। ब्लॉक और फाइल स्टोरेज के विपरीत, ऑब्जेक्ट स्टोरेज डेटा को बकेट्स के भीतर ऑब्जेक्ट्स के रूप में मैनेज करता है।
हर ऑब्जेक्ट में डेटा, मेटाडेटा, और एक यूनिक आइडेंटिफायर शामिल होता है, जो किसी भी स्केल पर कुशल डेटा रिट्रीवल और मैनेजमेंट सक्षम करता है। S3 बहुउपयोगी है—स्टैटिक वेबसाइट होस्टिंग से लेकर डेटा आर्काइविंग तक—अपनी विभिन्न स्टोरेज क्लासेज़ के माध्यम से, जिनमें Standard, Standard-Infrequent Access (IA), Glacier Flexible Retrieval, और Glacier Deep Archive शामिल हैं।
S3 बनाम EFS
Amazon S3 और Amazon Elastic File System (EFS) के बीच चयन आपकी एप्लिकेशन या वर्कलोड की विशिष्ट आवश्यकताओं पर निर्भर करता है। आइए दोनों के बीच के अंतर देखें:
फ़ीचर
Amazon S3
Amazon EFS
डेटा प्रकार
इमेज, वीडियो, लॉग्स और बैकअप जैसी अनस्ट्रक्चर्ड डेटा।
ऐसी साझा फाइलें जिन तक कई EC2 इंस्टेंसेज़ को एक साथ पहुँच चाहिए।
स्टोरेज स्केल
विशाल मात्रा के डेटा के लिए डिज़ाइन—एग्ज़ाबाइट्स तक स्केलेबल।
आपकी स्टोरेज ज़रूरतों के साथ स्वतः स्केल करता है—कोई मैनुअल हस्तक्षेप नहीं।
एक्सेस पैटर्न
विभिन्न एक्सेस पैटर्न वाले डेटा के लिए आदर्श—फ्रीक्वेंट से लेकर आर्काइवल तक।
ऐसे डेटा के लिए उपयुक्त जिसे कई एप्लिकेशंस द्वारा एकसमान और एक साथ एक्सेस चाहिए।
इंटीग्रेशन
डेटा प्रोसेसिंग, एनालिटिक्स और कंटेंट डिलीवरी के लिए AWS सेवाओं के साथ एकीकृत।
पारंपरिक फाइल सिस्टम इंटरफ़ेस की आवश्यकता वाले एप्लिकेशंस को सपोर्ट करता है।
स्टोरेज क्लासेज़
एकाधिक स्टोरेज क्लासेज़।
लागू नहीं।
लागत संबंधी विचार
स्टोरेज लागत क्लास के अनुसार बदलती है—कम एक्सेस वाले विकल्प लागत घटाते हैं।
उपयोग की गई स्टोरेज क्षमता के आधार पर लागत—कोई अग्रिम लागत नहीं और स्वचालित स्केलिंग।
स्केलेबिलिटी और लचीलापन
स्टोरेज क्षमता और परफॉर्मेंस—दोनों के लिए अत्यधिक स्केलेबल।
प्रोविज़निंग की ज़रूरत बिना स्केल करने में लचीलापन—पीक लोड्स को आसानी से संभालता है।
Amazon S3 के साथ शुरुआत
अब जबकि हमें फाइल स्टोरेज की अवधारणा का बेहतर समझ है, कुछ तकनीकी इम्प्लीमेंटेशन के साथ हाथ गंदे करने का समय है।
यह खंड Amazon S3 के साथ डेटा मैनेजमेंट की प्रक्रिया कवर करता है। खास तौर पर, हम स्टोरेज के लिए बकेट बनाना, डेटा को फोल्डरों में व्यवस्थित करना, फाइल अपलोड करना, ज़रूरत पड़ने पर सार्वजनिक एक्सेस के लिए परमिशंस समायोजित करना, प्रबंधन हेतु मेटाडेटा लागू करना, और अंत में अतिरिक्त लागत से बचने के लिए बकेट और उसकी सामग्री हटाना सीखेंगे।
इस खंड को सफलतापूर्वक पूरा करने की मुख्य पूर्व-आवश्यकता AWS अकाउंट होना है, जिसे AWS की वेबसाइट से बनाया जा सकता है।
बकेट बनाएँ
इस खंड का शुरुआती बिंदु Amazon Web Services मैनेजमेंट कंसोल है, जैसा नीचे दिखाया गया है:
यह कंसोल सभी AWS संसाधनों का प्रबंधन करने में मदद करता है—EC2 जैसे कंप्यूट इंस्टेंसेज़ से लेकर SQS जैसे मैसेज क्यूइंग सर्विसेज़ तक—सिक्योरिटी मैनेजमेंट सहित।
कंसोल पर आने के बाद, पहला कदम S3 इंस्टेंस बनाना है। यह निम्नलिखित चरणों द्वारा किया जा सकता है (आप नीचे दी गई इमेज में नंबर फॉलो कर सकते हैं):
अब हम कुछ और चरणों के साथ आगे बढ़ते हैं:
आइए उन चरणों पर कुछ नोट्स जोड़ें जिन्हें हमने कवर किया है:
चरण 4: हमने बकेट को US East (Ohio) us-east-2 रीजन में बनाया।
चरण 5: बकेट नाम वैश्विक रूप से यूनिक होते हैं, इसलिए ऐसा नाम चुनना महत्वपूर्ण है जो पहले से उपयोग में न हो। इस तरह, कोई और, स्थान की परवाह किए बिना, उसी नाम से बकेट नहीं बना सकता।
चरण 6: ACLs enabled विकल्प हमें यह सेट करने देता है कि बकेट की फाइलों तक कौन पहुँच सकता है और वे क्या कर सकते हैं—विस्तृत परमिशंस। यह व्यक्तिगत फाइल स्तर पर एक्सेस प्रबंधन के लिए लाभदायक है। ACLs disabled विकल्प व्यक्तिगत फाइलों पर परमिशंस सेट करने की सुविधा नहीं देता।
चरण 8: Bucket owner preferred विकल्प सुनिश्चित करता है कि बकेट में अपलोड की गई सभी फाइलों के मालिक हम ही हों—चाहे उन्हें किसी ने भी अपलोड किया हो। इससे परमिशंस और एक्सेस प्रबंधन आसान हो जाता है।
आइए तीन और चरण लेकर बकेट बनाएँ:
बकेट में डेटा अपलोड करें
बकेट बनाने के बाद, हम नीचे विवरण देख सकते हैं। बकेट एक कंटेनर है जो संसाधन रख सकता है। संसाधन अपलोड करना फोल्डर बनाने से शुरू होता है। आइए ये दो चरण लें:
अब फोल्डर बनाएँ:
ध्यान दें कि फोल्डर बन गया है!
अब फोल्डर में डेटा अपलोड करने का समय है। आइए एक इमेज अपलोड करके देखें:
हमने इमेज सफलतापूर्वक अपलोड कर दी!
एक्सेस कंट्रोल कॉन्फ़िगर करें
डिफ़ॉल्ट रूप से, बकेट में अपलोड की गई सभी फाइलें निजी होती हैं और क्रिएटर के स्वामित्व में—केवल मालिक उन्हें देख, संपादित या डाउनलोड कर सकता है। हालांकि, हमें कभी-कभी बकेट को इस तरह कॉन्फ़िगर करने की ज़रूरत पड़ सकती है कि कोई भी फाइल तक पहुँच सके—जब सभी को किसी वेबसाइट पर फ़ोटो देखने की आवश्यकता हो, तब यह उपयोगी है।
हम यह कॉन्फ़िगरेशन इमेज के लिए सार्वजनिक एक्सेस की अनुमति देकर कर सकते हैं। इससे हमें पब्लिक एक्सेस के साथ ऑब्जेक्ट URL तक पहुँच मिलनी चाहिए, लेकिन दुर्भाग्यवश हमें Access Denied संदेश मिलता है।
इसे ठीक करने के लिए, हमें बकेट स्तर पर Permissions टैब में जाना होगा और Bucket Policy को एडिट करना होगा:
अब स्टेटमेंट को एडिट करें:
अब जब हमने ये बदलाव कर दिए हैं, तो इमेज आखिरकार दिख रही है!
एक्सेस कंट्रोल कॉन्फ़िगरेशन के बाद AWS लोगो
Amazon EFS का परिचय
यह खंड EFS फाइल सिस्टम बनाने पर चर्चा करता है, जिसमें परफॉर्मेंस और सिक्योरिटी सेटिंग्स पर ज़ोर है।
सिक्योरिटी ग्रुप बनाएँ
हम पहले बाएँ बैनर पर Security टैब के अंतर्गत “Security Groups” विकल्प चुनकर एक सिक्योरिटी ग्रुप बनाते हैं।
फिर, हम:
Create security group चुनते हैं।
एक सार्थक नाम उपयोग करते हैं—हमारे मामले में MyDataCampEFSGroup।
सिक्योरिटी ग्रुप का संक्षिप्त विवरण लिखते हैं।
VPC को डिफ़ॉल्ट मान पर ही छोड़ते हैं।
हम कोई इनबाउंड रूल नहीं जोड़ते:
Outbound rule 1 का प्रकार All traffic होना चाहिए:
अब जब हमारा कॉन्फ़िगरेशन पूरा हो गया है, तो हम Create security group बटन पर क्लिक कर सकते हैं।
नया बनाया गया सिक्योरिटी ग्रुप Security Groups सेक्शन में दिखता है।
अपना पहला EFS फाइल सिस्टम सेट करें
अगले चरण में हम एक EFS फाइल सिस्टम बनाते हैं। हम EFS को खोजकर चुनने से शुरू करते हैं:
अब हम Create file system पर क्लिक करते हैं।
हम सार्थक नाम उपयोग करते हैं, VPC सेक्शन को जैसा है वैसा छोड़ते हैं, और फिर Customize पर क्लिक करते हैं।
नेटवर्क कॉन्फ़िगरेशन पेज तक पहुँचने के लिए, हम Next पर क्लिक करते हैं।
अब हम प्रत्येक अवेलेबिलिटी ज़ोन के सिक्योरिटी ग्रुप्स सेक्शन में MyDataCampEFSGroup भरते हैं।
पूरा होने पर, हम फिर से Next पर क्लिक करते हैं।
अंतिम चरण हमें पूरी कॉन्फ़िगरेशन की समीक्षा करने देता है। सब कुछ संतोषजनक होने पर, हम Create पर क्लिक करते हैं।
सब कुछ सफलतापूर्वक निष्पादित होने पर, हमें File systems टैब में नया बनाया गया EFS फाइल सिस्टम दिखना चाहिए।
EC2 इंस्टेंस बनाएँ
अगला कदम EC2 इंस्टेंस बनाना है, जो EFS को आवश्यक कंप्यूटिंग वातावरण प्रदान करता है और एक साथ वही डेटा एक्सेस करता है।
आइए चरण-दर-चरण आगे बढ़ें! हम कंसोल में EC2 इंस्टेंस का चयन करके शुरू करते हैं। फिर Launch instance पर क्लिक करते हैं। हम Amazon Linux 2 चुनेंगे, जो फ्री टियर के लिए पात्र आता है।
अब हम इंस्टेंस से सुरक्षित रूप से कनेक्ट करने के लिए की पेयर बनाते हैं। जो हम इस खंड में बनाते हैं उसकी एक्सटेंशन .pem है और नाम efs_ec2_key_pair है। यह फाइल डाउनलोड होकर स्थानीय रूप से आगे उपयोग के लिए सहेजी जाती है।
डिफ़ॉल्ट स्टोरेज क्षमता 8GiB है, जो हमारे परिदृश्य के लिए पर्याप्त है, और इंस्टेंसेज़ की संख्या 3 कर दी जाती है। अंतिम चरण Launch instance बटन पर क्लिक करके इंस्टेंस लॉन्च करना है, और अंतिम परिणाम में नए बनाए गए इंस्टेंसेज़ दिखते हैं।
आगे बढ़ने से पहले, सुनिश्चित करें कि इंस्टेंसेज़ से कनेक्ट करना संभव है। हम निम्नलिखित SSH (Secure Shell) कमांड का उपयोग करेंगे:
ssh-i[path_to_the_key] ec2-user@[Public IPv4 address]संचालित द्वारा
आइए इस कमांड को चरण-दर-चरण समझें:
ssh: यह कमांड SSH कनेक्शन आरंभ करता है।
-i [path_to_the_key]: यह विकल्प हमारी प्राइवेट SSH की फाइल का पथ बताता है, जो रिमोट सर्वर पर ऑथेंटिकेशन के लिए आवश्यक है।
ec2-user: यह EC2 Linux इंस्टेंसेज़ के लिए डिफ़ॉल्ट यूज़रनेम है। यदि कॉन्फ़िगर किया गया हो तो हम अलग यूज़रनेम भी उपयोग कर सकते हैं।
@: यह प्रतीक यूज़रनेम को सर्वर के पते से अलग करता है।
[Public IPv4 address]: यह हमारे EC2 इंस्टेंस का पब्लिक IP पता है। हम यह पता AWS मैनेजमेंट कंसोल में पा सकते हैं।
आइए SSH के माध्यम से प्रत्येक इंस्टेंस से कनेक्शन के परिणाम देखें।
पहले इंस्टेंस के लिए SSH कनेक्शन परिणाम।
दूसरे इंस्टेंस के लिए SSH कनेक्शन परिणाम।
तीसरे इंस्टेंस के लिए SSH कनेक्शन परिणाम।
EFS कॉन्फ़िगर करें
यह अंतिम चरण ऊपर बनाए गए EC2 इंस्टेंसेज़ को माउंट करने की अनुमति देता है। हम यह EFS की जनरल इंटरफ़ेस से कर सकते हैं।
सरलता के लिए, माउंटिंग प्रक्रिया केवल एक इंस्टेंस के लिए दिखाई गई है, लेकिन वही तरीका शेष इंस्टेंसेज़ पर भी लागू होता है।
हम प्रत्येक इंस्टेंस के लिए EFS माउंट हेल्पर इंस्टॉल करके शुरू करते हैं, निम्न कमांड का उपयोग करके:
फोल्डर सफलतापूर्वक बनाने के बाद, अगला चरण उसे माउंट करना है। फाइल सिस्टम ID वही है जो हमने EFS सेक्शन में बनाया है, और हम इसे sudo mount -t efs [file system ID]:/ /efs कमांड में उपयोग करते हैं:
sudomount-t efs fs-088faeea6372efa83:/ /efsसंचालित द्वारा
यह टाइमआउट इसलिए होता है क्योंकि हमने जो EFS सिस्टम बनाया है उससे जुड़ा सिक्योरिटी ग्रुप हमारी EC2 इंस्टेंसेज़ से कोई इनबाउंड ट्रैफिक की अनुमति नहीं देता। हम इसे इनबाउंड कनेक्शंस स्वीकार करने के लिए सिक्योरिटी ग्रुप सक्षम करके ठीक कर सकते हैं:
अब हम एक नया इनबाउंड रूल बनाते हैं:
एक अधिक सुरक्षित विकल्प EC2 इंस्टेंसेज़ के लिए एक अलग सिक्योरिटी ग्रुप बनाना है, और केवल उसी सिक्योरिटी ग्रुप से कनेक्शन की अनुमति देना। वह कॉन्फ़िगरेशन इस लेख के दायरे से बाहर है।
यह प्रक्रिया प्रत्येक EC2 इंस्टेंस पर सफलतापूर्वक पूरी करने के बाद, EFS सिस्टम कहीं से भी (हमारे EC2 इंस्टेंसेज़ सहित) कनेक्शंस स्वीकार कर सकता है। इस बार हमें कोई टाइमआउट नहीं मिलता:
यह सुनिश्चित करने के लिए कि माउंटिंग प्रक्रिया सफल रही, हमें सक्षम होना चाहिए कि:
एक EC2 इंस्टेंस से साझा efs फोल्डर के भीतर एक फोल्डर बनाएँ
उस फोल्डर तक किसी दूसरे EC2 इंस्टेंस से पहुँचें।
नीचे का चित्रण दिखाता है कि कैसे my_DataCamp_data फोल्डर पहले EC2 इंस्टेंस से बनाया गया, साथ ही एक README.txt फाइल। वही README फाइल शेष EC2 इंस्टेंसेज़ में दिखती है।
EFS फाइल शेयरिंग।
EFS सिस्टम कॉन्फ़िगरेशन की ताकत के कारण, एक इंस्टेंस द्वारा बनाई गई फाइल शेष इंस्टेंसेज़ द्वारा सुलभ होती है।
प्रभावी स्टोरेज रणनीतियाँ डेटा को कुशलतापूर्वक प्रबंधित करने के लिए आवश्यक हैं। इन रणनीतियों के दो प्रमुख पहलू हैं—परफॉर्मेंस ऑप्टिमाइज़ेशन और कॉस्ट ऑप्टिमाइज़ेशन।
ये रणनीतियाँ विशेष रूप से Amazon की Simple Storage Service (S3) और Elastic File System (EFS) पर लागू होती हैं।
S3 और EFS में परफॉर्मेंस ऑप्टिमाइज़ेशन में उपयुक्त स्टोरेज क्लासेज़ और थ्रूपुट मोड्स का चयन शामिल है, ताकि गति और दक्षता बढ़ाई जा सके।
कॉस्ट ऑप्टिमाइज़ेशन में डेटा एक्सेस की आवृत्ति के आधार पर अलग-अलग स्टोरेज टियर्स का उपयोग करना और लागत प्रबंधन के लिए AWS मॉनिटरिंग टूल्स का उपयोग करना शामिल है। ये रणनीतियाँ क्लाउड स्टोरेज में कुशल डेटा प्रबंधन और लागत में कमी में मदद करती हैं।
निष्कर्ष
यहाँ तक पहुँचने के लिए बधाई! हमें उम्मीद है कि यह गहन अध्ययन आपको AWS स्टोरेज का उपयोग शुरू करने के लिए सक्षम बनाता है।
AWS सेवाओं में महारत हासिल करने का एक प्रभावी तरीका है उन्हें वास्तविक-world परिदृश्यों पर लागू करना—केवल अलग-अलग नहीं बल्कि कई सेवाओं के संयोजन से भी। यदि इस तरह का अभ्यास आपको रोचक लगता है, तो यह कोर्स देखें: Streaming Data with AWS Kinesis and Lambda।
बहु-प्रतिभाशाली डेटा साइंटिस्ट जो अपना ज्ञान साझा करने और समुदाय को वापस देने में आनंद लेते हैं, ज़ूमाना YouTube पर कंटेंट क्रिएटर हैं और Medium पर शीर्ष तकनीकी लेखक हैं। उन्हें बोलने, कोडिंग करने और पढ़ाने में खुशी मिलती है। ज़ूमाना के पास दो मास्टर डिग्री हैं—पहली पेरिस, फ्रांस से कंप्यूटर साइंस में, मशीन लर्निंग पर केंद्रित, और दूसरी अमेरिका के टेक्सास टेक यूनिवर्सिटी से डेटा साइंस में। उनका करियर फ्रांस में Groupe OPEN में सॉफ्टवेयर डेवलपर के रूप में शुरू हुआ, जिसके बाद वे IBM में मशीन लर्निंग कंसल्टेंट बने, जहाँ उन्होंने बीमा कंपनियों के लिए एंड-टू-एंड एआई समाधान विकसित किए। ज़ूमाना ने Axionable, पेरिस और मॉन्ट्रियल स्थित पहली Sustainable AI स्टार्टअप, से जुड़कर डेटा साइंटिस्ट के रूप में काम किया और फ्रांस, मॉन्ट्रियल, सिंगापुर और स्विट्ज़रलैंड के क्लाइंट्स के लिए मुख्यतः NLP उपयोग मामलों पर आधारित एआई प्रोडक्ट्स लागू किए। इसके अतिरिक्त, अपने समय का 5% उन्होंने अनुसंधान और विकास को समर्पित किया। वर्तमान में, वे IFC - The World Bank Group में सीनियर डेटा साइंटिस्ट के रूप में कार्यरत हैं।


प्रभावी डेटा स्टोरेज किसी भी सेक्टर के व्यवसाय की परिचालन सफलता का एक महत्वपूर्ण घटक है। जितना अधिक डेटा एकत्रित होता है, उतनी ही स्केलेबल, भरोसेमंद और किफायती स्टोरेज समाधानों की ज़रूरत बढ़ जाती है।
सही डेटा स्टोरेज चुनना चुनौतीपूर्ण हो सकता है, क्योंकि क्लाउड और ऑन-प्रिमाइसेस—दोनों में—कई विकल्प मौजूद हैं, जिनके अपने-अपने लाभ और सीमाएँ हैं।
यह लेख सभी संभावित विकल्पों को कवर करने का लक्ष्य नहीं रखता, बल्कि स्केलेबल, भरोसेमंद और किफायती सेवाओं पर केंद्रित है: Amazon Simple Storage Service (Amazon S3) और Amazon Elastic File System (EFS)।
हम पहले बताएंगे कि व्यवसायों को स्टोरेज सेवाएँ क्यों अपनानी चाहिए और फिर स्टोरेज सेवाओं की बुनियादी बातों को कवर करेंगे। इसके बाद हम परिचालन प्रक्रिया में स्टोरेज सेवाओं को एकीकृत करने के लिए मार्गदर्शन देंगे। आख़िरी भाग उन्नत अवधारणाओं की गहराई से चर्चा है, विशेष रूप से प्रदर्शन और लागत अनुकूलन पर फोकस के साथ।
यदि आप Amazon Web Services (AWS) पर एक व्यापक प्रारंभिक संसाधन खोज रहे हैं, तो यह Introduction to AWS कोर्स देखें।
फाइल स्टोरेज के लिए AWS क्यों?
इतने सारे स्टोरेज विकल्पों के बीच, यह बताना महत्वपूर्ण है कि कोई व्यवसाय फाइल स्टोरेज के लिए AWS क्यों चुने—यही इस खंड का उद्देश्य है।
यह AWS स्टोरेज सेवाओं और पारंपरिक सेवाओं के बीच तुलनात्मक विश्लेषण से शुरू होता है, साथ ही वास्तविक-world अनुप्रयोगों के संक्षिप्त उदाहरणों के साथ। उम्मीद है, यह विभिन्न परिदृश्यों में AWS S3 और EFS की प्रासंगिकता को मज़बूती देगा।
स्टोरेज विकल्पों की तुलना
पारंपरिक स्टोरेज सेवाएँ और AWS स्टोरेज सेवाएँ अलग-अलग फीचर और लाभ प्रदान करती हैं। नीचे दी गई तालिका में हम तुलनात्मक विश्लेषण करते हैं:
फ़ीचर्स
पारंपरिक स्टोरेज
AWS S3 और EFS
लागत
हार्डवेयर पर पूंजीगत व्यय और मेंटेनेंस की लगातार लागत—समय के साथ अनिश्चित हो सकती है।
पे-एज़-यू-गो प्राइसिंग मॉडल अग्रिम लागत घटाता है और उपयोग-आधारित लागत प्रबंधन को बेहतर बनाता है।
कंप्लायंस
आंतरिक नियंत्रण और ऑडिट के माध्यम से प्राप्त—मानकों को बनाए रखने के लिए अतिरिक्त संसाधनों की आवश्यकता हो सकती है।
AWS HIPAA और GDPR जैसे अनेक उद्योग मानकों के अनुरूप है, जिससे उपयोगकर्ता कंप्लायंस सरल हो जाता है।
डेटा उपलब्धता
मुख्यतः विशिष्ट स्थानों या नेटवर्क से ही सुलभ। रिमोट एक्सेस कम सुरक्षित और जटिल हो सकता है।
इंटरनेट पर वैश्विक रूप से सुलभ, उच्च उपलब्धता और डेटा रिडंडेंसी के साथ।
डेटा टिकाऊपन
भौतिक क्षति, चोरी, या प्राकृतिक आपदाओं के प्रति संवेदनशील।
कई अवेलेबिलिटी ज़ोन में स्वतः डेटा प्रतिलिपि बनाकर 99.99999999999% (11 नाइन्स) टिकाऊपन प्रदान करते हैं।
मैनेजमेंट और मेंटेनेंस
हार्डवेयर मेंटेनेंस, सॉफ्टवेयर अपडेट और ट्रबलशूटिंग के लिए समर्पित टीम की आवश्यकता।
AWS द्वारा प्रबंधित। इससे उपयोगकर्ताओं पर प्रशासनिक बोझ कम होता है।
परफॉर्मेंस
विशिष्ट हार्डवेयर और नेटवर्क अवसंरचना पर निर्भर। साथ ही, अपग्रेड महंगे हो सकते हैं।
कस्टमाइज़ेबल परफॉर्मेंस विकल्प प्रदान करते हैं। S3 स्टोरेज क्लासेज़ और एक्सीलरेशन फ़ीचर्स देता है, जबकि EFS बर्स्टिंग वर्कलोड्स और थ्रूपुट मॉडल्स का समर्थन करता है।
स्केलेबिलिटी
भौतिक अवसंरचना से सीमित और स्केल करने के लिए मैनुअल हस्तक्षेप की आवश्यकता।
उच्च रूप से स्केलेबल, बिना अग्रिम प्रोविज़निंग के स्टोरेज समायोजन आसान बनाता है।
सुरक्षा
स्थानीय सुरक्षा उपायों पर निर्भर। डेटा सुरक्षा और कंप्लायंस सुनिश्चित करने के लिए पर्याप्त प्रयास चाहिए।
व्यापक सुरक्षा नियंत्रण प्रदान करते हैं, जिनमें डेटा एन्क्रिप्शन (एट रेस्ट और इन ट्रांजिट), एक्सेस मैनेजमेंट, और कंप्लायंस सर्टिफिकेशंस शामिल हैं।
S3 और EFS दोनों के उद्योगों में व्यापक अनुप्रयोग हैं। नीचे दोनों सेवाओं के वास्तविक-world उपयोग मामलों के कुछ उदाहरण दिए गए हैं, जो विभिन्न परिदृश्यों में उनकी प्रासंगिकता और उपयोगिता को दर्शाते हैं।
Amazon S3 उपयोग के मामले
पहले Amazon Simple Storage Service (S3) के उपयोग मामलों पर विचार करें:
EFS उपयोग के मामले
अब Amazon Elastic File System (EFS) के उपयोग मामलों पर विचार करें:
AWS स्टोरेज की बुनियादी बातें
S3 और EFS स्टोरेज सेवाओं के बारे में इन जानकारियों के साथ, यह जानना आवश्यक है कि कब किस सेवा का उपयोग करें—और यही इस खंड का उद्देश्य है। हम पहले ब्लॉक, फाइल और ऑब्जेक्ट स्टोरेज का परिचय देंगे और फिर S3 और EFS के तुलनात्मक पक्ष में उतरेंगे।
ब्लॉक, फाइल, और ऑब्जेक्ट स्टोरेज का परिचय
ब्लॉक स्टोरेज, फाइल स्टोरेज और ऑब्जेक्ट स्टोरेज डेटा स्टोरेज सिस्टम्स के तीन बुनियादी प्रकार हैं। प्रत्येक क्लाउड कंप्यूटिंग और डेटा प्रबंधन में अलग-अलग उद्देश्यों की पूर्ति करता है।
ब्लॉक स्टोरेज
ब्लॉक स्टोरेज डेटा को ब्लॉक्स में विभाजित करता है, प्रत्येक का एक यूनिक आइडेंटिफायर होता है, जिससे लचीला और कुशल डेटा प्रबंधन संभव होता है। Amazon Elastic Block Store (EBS) और Instance Store Volumes AWS इकोसिस्टम में ब्लॉक स्टोरेज के उदाहरण हैं।
Instance Store अस्थायी स्टोरेज प्रदान करता है जो सीधे होस्ट कंप्यूटर से जुड़ा होता है—अस्थायी डेटा के लिए उपयुक्त। इसके विपरीत, EBS परसिस्टेंट ब्लॉक-लेवल स्टोरेज देता है, जो डेटाबेस, एप्लिकेशंस और फाइल सिस्टम्स के लिए उपयुक्त है जिन्हें टिकाऊपन और स्नैपशॉट्स के माध्यम से इन्क्रीमेंटल बैकअप्स की आवश्यकता होती है।
फाइल स्टोरेज
फाइल स्टोरेज डेटा को फाइल्स और फोल्डर्स की हाइरार्किकल संरचना में व्यवस्थित करता है, जैसा कि किसी पारंपरिक कंप्यूटर फाइल सिस्टम में होता है। यह सहज तरीका विभिन्न एप्लिकेशंस और सेवाओं में डेटा एक्सेस और प्रबंधन को सरल बनाता है।
Amazon Elastic File System (EFS) क्लाउड में फाइल स्टोरेज का एक उदाहरण है। यह साझा फाइल सिस्टम प्रदान करता है जो स्वतः स्केल करता है और कई इंस्टेंसेज़ से एक साथ एक्सेस का समर्थन करता है।
EFS विशेष रूप से उन एप्लिकेशंस के लिए लाभदायक है जिन्हें फाइल्स तक साझा एक्सेस की आवश्यकता होती है या ऐसा कंटेंट सर्व करना होता है जिसे कई उपयोगकर्ता या सिस्टम एक्सेस और संपादित कर सकें।
ऑब्जेक्ट स्टोरेज
ऑब्जेक्ट स्टोरेज, जैसे Amazon S3, विशाल मात्रा में अनस्ट्रक्चर्ड डेटा स्टोर करने के लिए डिज़ाइन किया गया है। ब्लॉक और फाइल स्टोरेज के विपरीत, ऑब्जेक्ट स्टोरेज डेटा को बकेट्स के भीतर ऑब्जेक्ट्स के रूप में मैनेज करता है।
हर ऑब्जेक्ट में डेटा, मेटाडेटा, और एक यूनिक आइडेंटिफायर शामिल होता है, जो किसी भी स्केल पर कुशल डेटा रिट्रीवल और मैनेजमेंट सक्षम करता है। S3 बहुउपयोगी है—स्टैटिक वेबसाइट होस्टिंग से लेकर डेटा आर्काइविंग तक—अपनी विभिन्न स्टोरेज क्लासेज़ के माध्यम से, जिनमें Standard, Standard-Infrequent Access (IA), Glacier Flexible Retrieval, और Glacier Deep Archive शामिल हैं।
S3 बनाम EFS
Amazon S3 और Amazon Elastic File System (EFS) के बीच चयन आपकी एप्लिकेशन या वर्कलोड की विशिष्ट आवश्यकताओं पर निर्भर करता है। आइए दोनों के बीच के अंतर देखें:
फ़ीचर
Amazon S3
Amazon EFS
डेटा प्रकार
इमेज, वीडियो, लॉग्स और बैकअप जैसी अनस्ट्रक्चर्ड डेटा।
ऐसी साझा फाइलें जिन तक कई EC2 इंस्टेंसेज़ को एक साथ पहुँच चाहिए।
स्टोरेज स्केल
विशाल मात्रा के डेटा के लिए डिज़ाइन—एग्ज़ाबाइट्स तक स्केलेबल।
आपकी स्टोरेज ज़रूरतों के साथ स्वतः स्केल करता है—कोई मैनुअल हस्तक्षेप नहीं।
एक्सेस पैटर्न
विभिन्न एक्सेस पैटर्न वाले डेटा के लिए आदर्श—फ्रीक्वेंट से लेकर आर्काइवल तक।
ऐसे डेटा के लिए उपयुक्त जिसे कई एप्लिकेशंस द्वारा एकसमान और एक साथ एक्सेस चाहिए।
इंटीग्रेशन
डेटा प्रोसेसिंग, एनालिटिक्स और कंटेंट डिलीवरी के लिए AWS सेवाओं के साथ एकीकृत।
पारंपरिक फाइल सिस्टम इंटरफ़ेस की आवश्यकता वाले एप्लिकेशंस को सपोर्ट करता है।
स्टोरेज क्लासेज़
एकाधिक स्टोरेज क्लासेज़।
लागू नहीं।
लागत संबंधी विचार
स्टोरेज लागत क्लास के अनुसार बदलती है—कम एक्सेस वाले विकल्प लागत घटाते हैं।
उपयोग की गई स्टोरेज क्षमता के आधार पर लागत—कोई अग्रिम लागत नहीं और स्वचालित स्केलिंग।
स्केलेबिलिटी और लचीलापन
स्टोरेज क्षमता और परफॉर्मेंस—दोनों के लिए अत्यधिक स्केलेबल।
प्रोविज़निंग की ज़रूरत बिना स्केल करने में लचीलापन—पीक लोड्स को आसानी से संभालता है।
Amazon S3 के साथ शुरुआत
अब जबकि हमें फाइल स्टोरेज की अवधारणा का बेहतर समझ है, कुछ तकनीकी इम्प्लीमेंटेशन के साथ हाथ गंदे करने का समय है।
यह खंड Amazon S3 के साथ डेटा मैनेजमेंट की प्रक्रिया कवर करता है। खास तौर पर, हम स्टोरेज के लिए बकेट बनाना, डेटा को फोल्डरों में व्यवस्थित करना, फाइल अपलोड करना, ज़रूरत पड़ने पर सार्वजनिक एक्सेस के लिए परमिशंस समायोजित करना, प्रबंधन हेतु मेटाडेटा लागू करना, और अंत में अतिरिक्त लागत से बचने के लिए बकेट और उसकी सामग्री हटाना सीखेंगे।
इस खंड को सफलतापूर्वक पूरा करने की मुख्य पूर्व-आवश्यकता AWS अकाउंट होना है, जिसे AWS की वेबसाइट से बनाया जा सकता है।
बकेट बनाएँ
इस खंड का शुरुआती बिंदु Amazon Web Services मैनेजमेंट कंसोल है, जैसा नीचे दिखाया गया है:
यह कंसोल सभी AWS संसाधनों का प्रबंधन करने में मदद करता है—EC2 जैसे कंप्यूट इंस्टेंसेज़ से लेकर SQS जैसे मैसेज क्यूइंग सर्विसेज़ तक—सिक्योरिटी मैनेजमेंट सहित।
कंसोल पर आने के बाद, पहला कदम S3 इंस्टेंस बनाना है। यह निम्नलिखित चरणों द्वारा किया जा सकता है (आप नीचे दी गई इमेज में नंबर फॉलो कर सकते हैं):
अब हम कुछ और चरणों के साथ आगे बढ़ते हैं:
आइए उन चरणों पर कुछ नोट्स जोड़ें जिन्हें हमने कवर किया है:
आइए तीन और चरण लेकर बकेट बनाएँ:
बकेट में डेटा अपलोड करें
बकेट बनाने के बाद, हम नीचे विवरण देख सकते हैं। बकेट एक कंटेनर है जो संसाधन रख सकता है। संसाधन अपलोड करना फोल्डर बनाने से शुरू होता है। आइए ये दो चरण लें:
अब फोल्डर बनाएँ:
ध्यान दें कि फोल्डर बन गया है!
अब फोल्डर में डेटा अपलोड करने का समय है। आइए एक इमेज अपलोड करके देखें:
हमने इमेज सफलतापूर्वक अपलोड कर दी!
एक्सेस कंट्रोल कॉन्फ़िगर करें
डिफ़ॉल्ट रूप से, बकेट में अपलोड की गई सभी फाइलें निजी होती हैं और क्रिएटर के स्वामित्व में—केवल मालिक उन्हें देख, संपादित या डाउनलोड कर सकता है। हालांकि, हमें कभी-कभी बकेट को इस तरह कॉन्फ़िगर करने की ज़रूरत पड़ सकती है कि कोई भी फाइल तक पहुँच सके—जब सभी को किसी वेबसाइट पर फ़ोटो देखने की आवश्यकता हो, तब यह उपयोगी है।
हम यह कॉन्फ़िगरेशन इमेज के लिए सार्वजनिक एक्सेस की अनुमति देकर कर सकते हैं। इससे हमें पब्लिक एक्सेस के साथ ऑब्जेक्ट URL तक पहुँच मिलनी चाहिए, लेकिन दुर्भाग्यवश हमें Access Denied संदेश मिलता है।
इसे ठीक करने के लिए, हमें बकेट स्तर पर Permissions टैब में जाना होगा और Bucket Policy को एडिट करना होगा: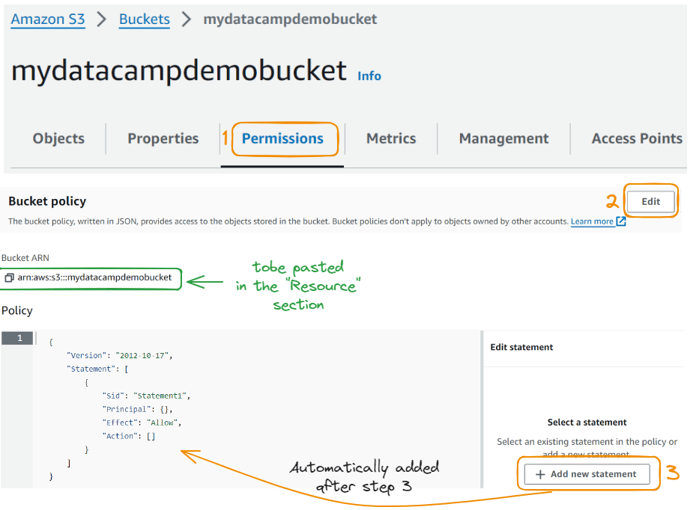
अब स्टेटमेंट को एडिट करें:
एक्सेस कंट्रोल कॉन्फ़िगरेशन के बाद AWS लोगो
Amazon EFS का परिचय
यह खंड EFS फाइल सिस्टम बनाने पर चर्चा करता है, जिसमें परफॉर्मेंस और सिक्योरिटी सेटिंग्स पर ज़ोर है।
सिक्योरिटी ग्रुप बनाएँ
हम पहले बाएँ बैनर पर Security टैब के अंतर्गत “Security Groups” विकल्प चुनकर एक सिक्योरिटी ग्रुप बनाते हैं।
फिर, हम:
हम कोई इनबाउंड रूल नहीं जोड़ते:
Outbound rule 1 का प्रकार All traffic होना चाहिए:
अब जब हमारा कॉन्फ़िगरेशन पूरा हो गया है, तो हम Create security group बटन पर क्लिक कर सकते हैं।
नया बनाया गया सिक्योरिटी ग्रुप Security Groups सेक्शन में दिखता है।
अपना पहला EFS फाइल सिस्टम सेट करें
अगले चरण में हम एक EFS फाइल सिस्टम बनाते हैं। हम EFS को खोजकर चुनने से शुरू करते हैं:
अब हम Create file system पर क्लिक करते हैं।
हम सार्थक नाम उपयोग करते हैं, VPC सेक्शन को जैसा है वैसा छोड़ते हैं, और फिर Customize पर क्लिक करते हैं।
नेटवर्क कॉन्फ़िगरेशन पेज तक पहुँचने के लिए, हम Next पर क्लिक करते हैं।
अब हम प्रत्येक अवेलेबिलिटी ज़ोन के सिक्योरिटी ग्रुप्स सेक्शन में MyDataCampEFSGroup भरते हैं।
पूरा होने पर, हम फिर से Next पर क्लिक करते हैं।
अंतिम चरण हमें पूरी कॉन्फ़िगरेशन की समीक्षा करने देता है। सब कुछ संतोषजनक होने पर, हम Create पर क्लिक करते हैं।
सब कुछ सफलतापूर्वक निष्पादित होने पर, हमें File systems टैब में नया बनाया गया EFS फाइल सिस्टम दिखना चाहिए।
EC2 इंस्टेंस बनाएँ
अगला कदम EC2 इंस्टेंस बनाना है, जो EFS को आवश्यक कंप्यूटिंग वातावरण प्रदान करता है और एक साथ वही डेटा एक्सेस करता है।
आइए चरण-दर-चरण आगे बढ़ें! हम कंसोल में EC2 इंस्टेंस का चयन करके शुरू करते हैं। फिर Launch instance पर क्लिक करते हैं। हम Amazon Linux 2 चुनेंगे, जो फ्री टियर के लिए पात्र आता है।
अब हम इंस्टेंस से सुरक्षित रूप से कनेक्ट करने के लिए की पेयर बनाते हैं। जो हम इस खंड में बनाते हैं उसकी एक्सटेंशन .pem है और नाम efs_ec2_key_pair है। यह फाइल डाउनलोड होकर स्थानीय रूप से आगे उपयोग के लिए सहेजी जाती है।
डिफ़ॉल्ट स्टोरेज क्षमता 8GiB है, जो हमारे परिदृश्य के लिए पर्याप्त है, और इंस्टेंसेज़ की संख्या 3 कर दी जाती है। अंतिम चरण Launch instance बटन पर क्लिक करके इंस्टेंस लॉन्च करना है, और अंतिम परिणाम में नए बनाए गए इंस्टेंसेज़ दिखते हैं।
आगे बढ़ने से पहले, सुनिश्चित करें कि इंस्टेंसेज़ से कनेक्ट करना संभव है। हम निम्नलिखित SSH (Secure Shell) कमांड का उपयोग करेंगे:
आइए इस कमांड को चरण-दर-चरण समझें:
ssh: यह कमांड SSH कनेक्शन आरंभ करता है।-i [path_to_the_key]: यह विकल्प हमारी प्राइवेट SSH की फाइल का पथ बताता है, जो रिमोट सर्वर पर ऑथेंटिकेशन के लिए आवश्यक है।ec2-user: यह EC2 Linux इंस्टेंसेज़ के लिए डिफ़ॉल्ट यूज़रनेम है। यदि कॉन्फ़िगर किया गया हो तो हम अलग यूज़रनेम भी उपयोग कर सकते हैं।@: यह प्रतीक यूज़रनेम को सर्वर के पते से अलग करता है।[Public IPv4 address]: यह हमारे EC2 इंस्टेंस का पब्लिक IP पता है। हम यह पता AWS मैनेजमेंट कंसोल में पा सकते हैं।आइए SSH के माध्यम से प्रत्येक इंस्टेंस से कनेक्शन के परिणाम देखें।
दूसरे इंस्टेंस के लिए SSH कनेक्शन परिणाम।
तीसरे इंस्टेंस के लिए SSH कनेक्शन परिणाम।
EFS कॉन्फ़िगर करें
यह अंतिम चरण ऊपर बनाए गए EC2 इंस्टेंसेज़ को माउंट करने की अनुमति देता है। हम यह EFS की जनरल इंटरफ़ेस से कर सकते हैं।
सरलता के लिए, माउंटिंग प्रक्रिया केवल एक इंस्टेंस के लिए दिखाई गई है, लेकिन वही तरीका शेष इंस्टेंसेज़ पर भी लागू होता है।
हम प्रत्येक इंस्टेंस के लिए EFS माउंट हेल्पर इंस्टॉल करके शुरू करते हैं, निम्न कमांड का उपयोग करके:
Amazon EFS यूटिलिटीज़ की स्थापना—ट्रेस लॉग।
इसके बाद हम
sudoका उपयोग करके रूट पर अपनी इंस्टेंसेज़ में efs फोल्डर बनाते हैं, यह सुनिश्चित करते हुए कि सभी इंस्टेंसेज़ में एक ही फोल्डर उपयोग हो।फोल्डर सफलतापूर्वक बनाने के बाद, अगला चरण उसे माउंट करना है। फाइल सिस्टम ID वही है जो हमने EFS सेक्शन में बनाया है, और हम इसे
sudo mount -t efs [file system ID]:/ /efsकमांड में उपयोग करते हैं:यह टाइमआउट इसलिए होता है क्योंकि हमने जो EFS सिस्टम बनाया है उससे जुड़ा सिक्योरिटी ग्रुप हमारी EC2 इंस्टेंसेज़ से कोई इनबाउंड ट्रैफिक की अनुमति नहीं देता। हम इसे इनबाउंड कनेक्शंस स्वीकार करने के लिए सिक्योरिटी ग्रुप सक्षम करके ठीक कर सकते हैं:
अब हम एक नया इनबाउंड रूल बनाते हैं:
एक अधिक सुरक्षित विकल्प EC2 इंस्टेंसेज़ के लिए एक अलग सिक्योरिटी ग्रुप बनाना है, और केवल उसी सिक्योरिटी ग्रुप से कनेक्शन की अनुमति देना। वह कॉन्फ़िगरेशन इस लेख के दायरे से बाहर है।
यह प्रक्रिया प्रत्येक EC2 इंस्टेंस पर सफलतापूर्वक पूरी करने के बाद, EFS सिस्टम कहीं से भी (हमारे EC2 इंस्टेंसेज़ सहित) कनेक्शंस स्वीकार कर सकता है। इस बार हमें कोई टाइमआउट नहीं मिलता:
यह सुनिश्चित करने के लिए कि माउंटिंग प्रक्रिया सफल रही, हमें सक्षम होना चाहिए कि:
नीचे का चित्रण दिखाता है कि कैसे my_DataCamp_data फोल्डर पहले EC2 इंस्टेंस से बनाया गया, साथ ही एक README.txt फाइल। वही README फाइल शेष EC2 इंस्टेंसेज़ में दिखती है।
EFS फाइल शेयरिंग।
EFS सिस्टम कॉन्फ़िगरेशन की ताकत के कारण, एक इंस्टेंस द्वारा बनाई गई फाइल शेष इंस्टेंसेज़ द्वारा सुलभ होती है।
AWS इकोसिस्टम का व्यापक अवलोकन करने के लिए, यह कोर्स देखें: AWS Cloud Technology and Services।
उन्नत स्टोरेज रणनीतियाँ
प्रभावी स्टोरेज रणनीतियाँ डेटा को कुशलतापूर्वक प्रबंधित करने के लिए आवश्यक हैं। इन रणनीतियों के दो प्रमुख पहलू हैं—परफॉर्मेंस ऑप्टिमाइज़ेशन और कॉस्ट ऑप्टिमाइज़ेशन।
ये रणनीतियाँ विशेष रूप से Amazon की Simple Storage Service (S3) और Elastic File System (EFS) पर लागू होती हैं।
S3 और EFS में परफॉर्मेंस ऑप्टिमाइज़ेशन में उपयुक्त स्टोरेज क्लासेज़ और थ्रूपुट मोड्स का चयन शामिल है, ताकि गति और दक्षता बढ़ाई जा सके।
कॉस्ट ऑप्टिमाइज़ेशन में डेटा एक्सेस की आवृत्ति के आधार पर अलग-अलग स्टोरेज टियर्स का उपयोग करना और लागत प्रबंधन के लिए AWS मॉनिटरिंग टूल्स का उपयोग करना शामिल है। ये रणनीतियाँ क्लाउड स्टोरेज में कुशल डेटा प्रबंधन और लागत में कमी में मदद करती हैं।
निष्कर्ष
यहाँ तक पहुँचने के लिए बधाई! हमें उम्मीद है कि यह गहन अध्ययन आपको AWS स्टोरेज का उपयोग शुरू करने के लिए सक्षम बनाता है।
AWS सेवाओं में महारत हासिल करने का एक प्रभावी तरीका है उन्हें वास्तविक-world परिदृश्यों पर लागू करना—केवल अलग-अलग नहीं बल्कि कई सेवाओं के संयोजन से भी। यदि इस तरह का अभ्यास आपको रोचक लगता है, तो यह कोर्स देखें: Streaming Data with AWS Kinesis and Lambda।
यदि आप AWS क्षेत्र में नौकरी की तलाश कर रहे हैं, तो संबंधित 2024 की AWS प्रमाणपत्र ज़रूर देखें। साथ ही, शीर्ष AWS इंटरव्यू प्रश्न और उत्तर पढ़ लेना भी काफ़ी सहायक हो सकता है।