AI berkembang begitu cepat hingga mengikuti tantangan keamanannya terasa seperti mencoba memperbaiki pesawat saat masih mengudara. Seiring sistem menjadi lebih cerdas dan semakin tertanam dalam proses bisnis sehari-hari, kerentanannya terhadap jenis ancaman baru juga meningkat.
Saya telah melihat ini dari dekat dalam pekerjaan saya. Berkali-kali saya menemukan celah keamanan dalam proses bisnis yang dapat memungkinkan seseorang mengakses informasi sensitif yang seharusnya tidak mereka lihat, terutama ketika solusi AI diterapkan secara tergesa-gesa tanpa langkah keamanan yang memadai.
Itulah inti artikel ini: memahami risiko, tantangan, dan praktik terbaik untuk menjaga AI tetap aman. AI tumbuh begitu cepat, dan jika kita tidak selangkah lebih maju dari kerentanan, kita berisiko kehilangan kepercayaan dan manfaat yang dibawanya.
Jika Anda ingin mempelajari topik ini lebih detail, saya sarankan mengecek kursus AI Security and Risk Management.
Tantangan Baru Keamanan AI
AI berjalan dengan data. Semakin banyak data yang diandalkan AI Anda, semakin besar pula sasarannya. Peretas tahu ini. Bayangkan rumah sakit menggunakan AI untuk memprediksi risiko kesehatan pasien. Kedengarannya bagus, sampai seseorang meretas sistem. Tiba-tiba, catatan pasien yang sifatnya privat tersebar di dark web, atau lebih buruk lagi, data medis diubah sehingga dapat menyebabkan keputusan berbahaya. Mengenkripsi data sensitif dan memiliki cadangan adalah kunci, tetapi banyak perusahaan begitu fokus pada inovasi hingga mengabaikan hal-hal dasar ini.
Dan peretas tidak hanya mencuri data. Mereka juga bisa mengacaukan model AI itu sendiri. Misalnya, mobil swakemudi yang dikelabui sehingga mengira rambu berhenti adalah rambu batas kecepatan. Jenis serangan ini disebut serangan peracunan data, di mana peretas memasukkan data buruk ke dalam sistem untuk merusak proses pengambilan keputusan. Kita akan membahas ini lebih detail di bagian berikutnya.
Serangan penyuntikan prompt juga merupakan jenis serangan lain. Ini adalah manipulasi halus yang menipu AI agar mengatakan—atau melakukan—sesuatu yang seharusnya tidak dilakukan. Kami memiliki artikel yang sangat bagus tentang penyuntikan prompt, jadi kami tidak akan membahasnya terlalu rinci di artikel ini, tetapi ini jelas layak dibaca.
Ironisnya, peretas juga menggunakan AI untuk meretas. Di sinilah keamanan siber menjadi perlombaan melawan waktu—peretas berinovasi, dan tim keamanan harus merespons secepatnya. Alat seperti deteksi anomali dapat membantu, tetapi tidak sepenuhnya andal.
Pernah mendengar pepatah, "Kekuatan rantai hanya sekuat mata rantai terlemahnya"? Ini sangat berlaku untuk AI. Perusahaan sering mengintegrasikan alat AI siap pakai ke dalam sistem mereka. Namun apa yang terjadi jika salah satu alat itu dikompromikan? Bayangkan chatbot populer yang digunakan ratusan bisnis diretas. Itu berarti ratusan perusahaan—bersama seluruh data pelanggan mereka—berada dalam risiko. Efek domino digital.
Terakhir, ada kesenjangan keahlian. Adopsi AI meningkat, tetapi keamanan siber untuk AI masih tertinggal.
Ancaman Keamanan AI
Sistem AI menghadapi ancaman keamanan serius yang dapat mengganggu kinerja dan keandalannya. Mari melihat ancaman utamanya.
Serangan adversarial
Serangan adversarial menipu sistem AI dengan membuat perubahan kecil dan licik pada masukan yang diproses AI. Perubahan ini begitu halus sehingga manusia biasanya tidak dapat mengenalinya, tetapi bisa sepenuhnya membingungkan AI hingga mengambil keputusan yang salah.
Contohnya:
- Mengubah detail kecil dalam gambar, seperti memodifikasi hanya beberapa piksel, sehingga AI salah mengidentifikasinya.
- Menambahkan noise tipis pada berkas audio, yang terdengar sama bagi kita namun menyebabkan AI salah menafsirkan.
- Mengutak-atik perumusan kalimat untuk membingungkan pemahaman AI.
Serangan ini tidak mengharuskan penyerang mengetahui cara kerja internal AI, yang membuatnya sangat sulit dideteksi dan dihentikan.
Sekarang mari melihat beberapa contoh dunia nyata.
- Algoritma DeepFool: DeepFool adalah metode yang dirancang untuk membuat perubahan sangat kecil dan hampir tak terlihat pada input, seperti gambar, guna menipu AI agar salah mengklasifikasikannya. Metode ini bekerja dengan menyesuaikan input secara bertahap sampai AI membuat kesalahan. Perubahannya begitu kecil hingga manusia tidak akan menyadarinya.
- Serangan audio terarah: Dalam makalah ini, penyerang membuat audio yang terdengar hampir identik dengan aslinya tetapi menyebabkan sistem pengenalan ucapan mendengar kata-kata yang sama sekali berbeda. Metode ini digunakan untuk memperdaya sistem DeepSpeech milik Mozilla dengan tingkat keberhasilan 100%.
- Manipulasi autopilot Tesla: Keen Labs memperdaya sistem autopilot Tesla dengan menempatkan tiga stiker yang tidak mencolok di jalan, menyebabkan sistem salah menafsirkan marka jalur dan berpotensi berbelok ke jalur yang salah. Baca selengkapnya di sini.
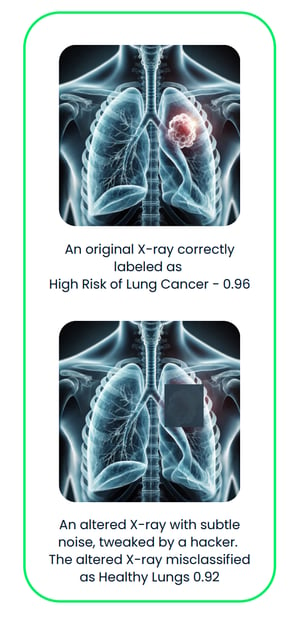
Diagram ini mengilustrasikan serangan adversarial pada sistem AI pencitraan medis. Rontgen asli, yang diklasifikasikan dengan benar sebagai "Risiko Tinggi Kanker Paru", diubah secara halus dengan noise adversarial, sehingga salah diklasifikasikan menjadi "Paru-paru Sehat".
Bacaan yang bagus adalah Adversarial Machine Learning, bidang yang mempelajari serangan yang mengeksploitasi kerentanan model pembelajaran mesin dan mengembangkan pertahanan untuk melindungi dari ancaman ini.
Serangan peracunan
Serangan peracunan menargetkan fase pelatihan sistem AI, saat model belajar mengambil keputusan. Penyerang menyelundupkan data yang rusak atau menyesatkan ke dalam himpunan pelatihan agar dapat memanipulasi AI berperilaku salah atau cenderung menghasilkan keluaran bias. Serangan ini efektif karena mengutak-atik fondasi proses pembelajaran AI, sering kali tanpa meninggalkan tanda-tanda jelas bahwa ada yang salah.
Ini dapat melibatkan:
- Mengubah label pada contoh pelatihan tertentu, misalnya memberi label gambar anjing sebagai kucing.
- Menambahkan titik data palsu yang dirancang untuk memengaruhi keputusan AI dengan cara tertentu.
Perubahan halus ini dapat menyebabkan AI gagal dalam kondisi tertentu atau bertindak dengan cara yang menguntungkan penyerang. Karena serangan terjadi selama pelatihan, sulit terdeteksi setelah model diterapkan.
Mari melihat beberapa contoh dunia nyata:
- Serangan backdoor: Sebuah studi berjudul “Bypassing Backdoor Detection Algorithms in Deep Learning” menunjukkan bagaimana penyerang dapat menyembunyikan "pintu belakang" berbahaya di dalam model AI. Pintu belakang ini hanya terpicu dalam kondisi tertentu, seperti menampilkan pola tertentu pada gambar. Studi tersebut menunjukkan bahwa penyerang dapat menggunakan teknik canggih untuk membuat data beracun terlihat identik dengan data bersih, sehingga lolos dari deteksi.
- Peracunan dataset skala web: Dalam makalah “Poisoning Web-Scale Training Datasets is Practical,” para peneliti menjelaskan bagaimana dataset besar yang dikumpulkan dari internet dapat diracuni:
- Split-view data poisoning: Merusak data setelah dikumpulkan tetapi sebelum digunakan untuk pelatihan.
- Frontrunning data poisoning: Memanipulasi data tepat sebelum ditambahkan ke dataset.
- Chatbot Tay milik Microsoft: Pada 2016, Microsoft meluncurkan chatbot bernama Tay di Twitter. Pengguna dengan cepat memanipulasi Tay dengan membombardirnya dengan konten ofensif, sehingga memposting cuitan rasis dan tidak pantas. Microsoft harus mematikan Tay tak lama setelah diluncurkan. Baca selengkapnya di sini.
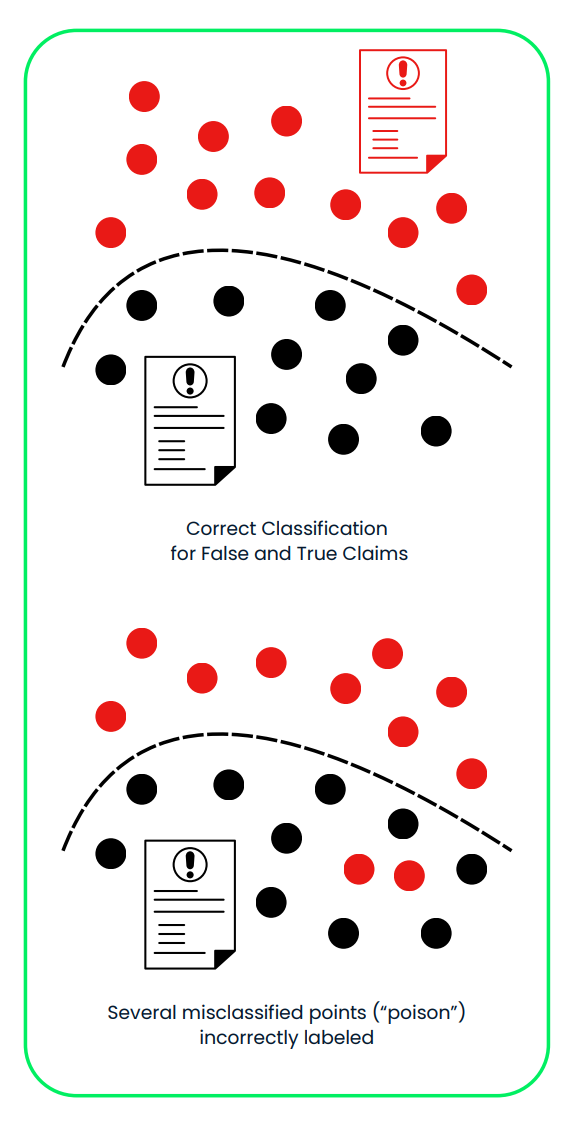
Diagram ini menunjukkan serangan peracunan pada sistem AI yang digunakan untuk mengklasifikasikan klaim asuransi palsu dan benar. Pada panel pertama, sistem memisahkan klaim palsu (merah) dan benar (hitam) dengan benar menggunakan dataset pelatihan bersih. Pada panel kedua, data yang salah label secara berbahaya (“racun”) menggeser batas keputusan, sehingga klaim palsu salah diklasifikasikan sebagai benar, yang merusak keandalan dan keamanan sistem.
Serangan ekstraksi model
Dalam serangan ekstraksi model, penyerang mencari tahu cara kerja model AI dengan merekayasa baliknya. Mereka menggunakan masukan dan keluaran yang dikumpulkan untuk menyalin rancangan dan perilaku sistem.
Setelah mereka membangun replika model, mereka dapat:
- Menggunakannya untuk membuat prediksi, yang mungkin melibatkan data sensitif atau pribadi.
- Mencuri informasi rahasia dari model asli.
- Memodifikasi dan melatih ulang model agar sesuai dengan kebutuhan mereka, sering kali untuk tujuan berbahaya.
Misalnya, jika model curian dilatih pada data pelanggan pribadi, penyerang dapat memprediksi detail pribadi pelanggan tersebut atau membuat versi model yang disesuaikan untuk penggunaan mereka sendiri.
Mari melihat beberapa contoh dunia nyata:
- Alat bernama DeepSniffer menunjukkan bagaimana serangan seperti ini dapat bekerja. DeepSniffer tidak perlu mengetahui apa pun tentang model asli sebelumnya. Ia mengumpulkan petunjuk dari cara model memproses data, seperti melacak operasi memori saat runtime. Petunjuk ini digabungkan untuk menyimpulkan struktur model, bahkan jika sistem mencoba mengoptimalkan atau menyembunyikan prosesnya.
- Mindgard menunjukkan bagaimana komponen penting dari model bahasa kotak hitam, seperti ChatGPT 3.5 Turbo milik OpenAI, dapat diekstraksi melalui proses berbiaya rendah. Hanya dengan $50 biaya API, tim berhasil membuat model yang lebih kecil—sekitar 100 kali lebih kecil dari aslinya—yang melampaui ChatGPT pada tugas tertentu. Model hasil ekstraksi ini kemudian digunakan untuk meningkatkan serangan lain, yang kemudian diterapkan kembali terhadap ChatGPT. Serangan yang ditingkatkan ini mencapai tingkat keberhasilan lebih tinggi, naik menjadi 11%.
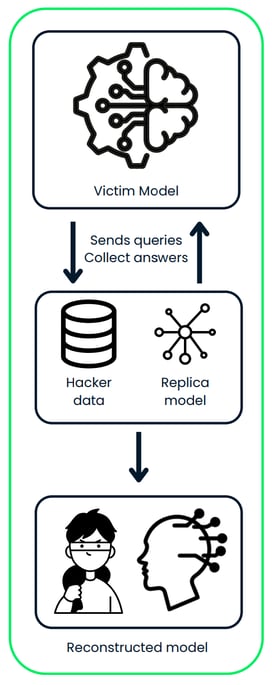
Diagram ini mengilustrasikan serangan ekstraksi model, di mana penyerang berinteraksi dengan model AI korban dengan mengirim kueri dan mengumpulkan prediksinya. Data yang dikumpulkan digunakan untuk melatih model replika, sehingga pada akhirnya membangun versi curian dari sistem asli.
Pertahanan Keamanan AI
Kita telah menyebutkan di bagian sebelumnya bahwa seiring AI menjadi lebih umum, penting untuk menerapkan langkah keamanan yang kuat untuk melindungi dari serangan. Mari membahas beberapa cara efektif untuk membuat AI lebih aman.
Pelatihan adversarial
Metode ini melibatkan pengajaran model untuk mengenali dan menangani masukan yang licik dan dimanipulasi (disebut contoh adversarial). Saat Anda melatih model dengan contoh-contoh ini, model menjadi lebih baik dalam menahan jenis serangan tertentu.
- Cara kerjanya: Buat contoh data yang dimanipulasi dan sertakan dalam pelatihan AI.
- Mengapa membantu: Membuat sistem AI lebih tangguh terhadap serangan yang mencoba menipunya.
- Kekurangan: Dapat sedikit menurunkan akurasi AI pada data normal (bersih).
- Contoh dunia nyata:
- Cloud Vision API milik Google menggunakan pelatihan adversarial untuk meningkatkan ketahanan model pengenalan gambarnya terhadap masukan yang dimanipulasi
- Model-model OpenAI memasukkan contoh adversarial dalam proses pelatihannya untuk meningkatkan ketangguhan terhadap serangan berbasis teks.
Distilasi defensif
Distilasi LLM melibatkan pelatihan model sekunder untuk meniru perilaku model asli dengan tujuan membuatnya lebih sulit dimanipulasi penyerang.
- Cara kerjanya: Latih model pertama, lalu gunakan keluarannya untuk melatih model lain dengan cara yang menghaluskan proses pengambilan keputusannya.
- Mengapa membantu: Membuat penyerang lebih sulit mengeksploitasi kelemahan.
- Kekurangan: Pendekatan ini dapat memerlukan daya komputasi besar, terutama untuk model yang besar.
- Contoh dunia nyata:
- Peneliti di University of California, Berkeley, menerapkan distilasi defensif untuk meningkatkan ketangguhan jaringan saraf dalam pada kendaraan otonom.
- Platform IBM Watson AI menggunakan teknik distilasi defensif untuk melindungi model pemrosesan bahasa alaminya dari serangan adversarial.
Memastikan data yang masuk ke sistem AI bersih dan aman adalah kunci untuk melindunginya dari masukan berbahaya.
- Cara kerjanya: Periksa bahwa input memiliki format yang benar, berada dalam rentang yang diharapkan, dan tidak mengandung elemen berbahaya.
- Mengapa membantu: Mencegah serangan seperti peracunan data dan menjaga sistem AI berjalan lancar.
- Praktik terbaik: Validasi data di beberapa tahap—di sisi pengguna, sisi server, dan di dalam sistem AI itu sendiri.
- Contoh dunia nyata:
- Layanan Azure AI milik Microsoft menerapkan validasi input ketat untuk mencegah serangan injeksi SQL pada model pembelajaran mesin mereka.
- Sistem pengenalan wajah Rekognition milik Amazon menggunakan sanitasi input untuk menyaring masukan gambar yang berpotensi berbahaya.
Metode ansambel
Menggunakan beberapa model AI berbeda secara bersama (ansambel) dapat membuat sistem lebih aman. Bahkan jika satu model diserang, model lainnya dapat menjadi cadangan.
- Cara kerjanya: Gabungkan prediksi dari beberapa model untuk membuat keputusan.
- Mengapa membantu: Lebih sulit bagi penyerang untuk mengompromikan semua model sekaligus.
- Kekurangan: Membutuhkan lebih banyak sumber daya komputasi untuk mengelola beberapa model.
- Contoh dunia nyata:
- Sistem rekomendasi Netflix menggunakan ansambel beberapa model AI untuk meningkatkan akurasi dan ketahanan terhadap upaya manipulasi.
- Metode ansambel tidak eksklusif untuk keamanan AI; metode ini digunakan secara umum untuk membangun model prediktif yang lebih tangguh dan akurat.
Explainable AI (XAI)
Membuat sistem AI dapat dijelaskan membantu orang memahami cara kerjanya dan mendeteksi kerentanan atau perilaku tidak biasa. Anda dapat mengeksplorasi topik ini lebih detail dalam kursus Explainable AI in Python.
- Cara kerjanya: Gunakan alat seperti LIME, SHAP, atau mekanisme atensi untuk menjelaskan keputusan AI.
- Mengapa membantu: Meningkatkan kepercayaan pada sistem AI dan memudahkan mendeteksi serta memperbaiki masalah seperti bias.
- Tantangan: Model yang lebih sederhana dan dapat dijelaskan mungkin tidak sekuat model yang kompleks.
- Contoh dunia nyata:
- Program Explainable AI (XAI) DARPA bertujuan mengembangkan sistem AI yang lebih transparan untuk aplikasi militer.
- Toolkit AI Explainability 360 milik IBM menyediakan sumber daya open-source untuk menerapkan teknik AI yang dapat dijelaskan di berbagai industri.
Audit keamanan berkala
Memeriksa sistem AI secara rutin untuk mencari kelemahan dapat membantu menangkap masalah sejak dini dan memastikan sistem tetap aman dari waktu ke waktu.
- Apa saja yang dilakukan: Lakukan penilaian kerentanan, uji penetrasi, dan tinjauan kode.
- Seberapa sering: Lakukan audit secara berkala dan setelah ada perubahan signifikan pada sistem.
- Mengapa membantu: Mengidentifikasi potensi celah keamanan dan memastikan kepatuhan terhadap regulasi.
- Contoh dunia nyata:
- Facebook melakukan audit keamanan rutin terhadap sistem moderasi konten bertenaga AI untuk mengidentifikasi dan menangani potensi kerentanan.
- Undang-Undang AI Uni Eropa mengusulkan audit keamanan wajib untuk sistem AI berisiko tinggi yang digunakan di sektor-sektor kritis.
Menggunakan strategi-strategi ini dapat membuat sistem AI lebih aman dan lebih terlindungi dari serangan. Namun begini—keamanan AI bukanlah urusan "pasang lalu lupakan". Ini adalah proses berkelanjutan.
Saat ancaman baru bermunculan—dan percayalah, itu selalu terjadi—bisnis perlu sigap. Artinya, terus memantau kerentanan, memperbarui sistem, dan meningkatkan pertahanan.
|
Metode
|
Cara Kerja
|
Mengapa Membantu
|
Kekurangan
|
|
Pelatihan Adversarial
|
Buat contoh data yang dimanipulasi dan sertakan dalam pelatihan AI.
|
Meningkatkan ketangguhan terhadap serangan adversarial yang mencoba menipu sistem.
|
Dapat sedikit menurunkan akurasi AI pada data normal (bersih).
|
|
Distilasi Defensif
|
Latih model sekunder untuk meniru perilaku model asli, menghaluskan proses pengambilan keputusan.
|
Menyulitkan penyerang mengeksploitasi kelemahan pada model.
|
Memerlukan daya komputasi besar, terutama untuk model yang besar.
|
|
Validasi & Sanitasi Input
|
Validasi bahwa input berformat benar, berada dalam rentang yang diharapkan, dan tidak mengandung elemen berbahaya.
|
Mencegah peracunan data dan memastikan sistem AI berjalan lancar.
|
Memerlukan implementasi cermat di beberapa tahap.
|
|
Metode Ansambel
|
Gabungkan prediksi dari beberapa model untuk membuat keputusan.
|
Lebih sulit bagi penyerang untuk mengompromikan semua model secara bersamaan.
|
Memerlukan lebih banyak sumber daya komputasi untuk mengelola dan memelihara beberapa model.
|
|
Explainable AI (XAI)
|
Gunakan alat seperti LIME, SHAP, atau mekanisme atensi untuk menjelaskan keputusan AI.
|
Meningkatkan kepercayaan dan memudahkan mengidentifikasi serta memperbaiki masalah seperti bias atau perilaku tidak biasa.
|
Model yang lebih sederhana dan dapat dijelaskan mungkin tidak berkinerja sebaik model yang kompleks.
|
|
Audit Keamanan Berkala
|
Lakukan penilaian kerentanan, uji penetrasi, dan tinjauan kode untuk mengidentifikasi kelemahan.
|
Mengidentifikasi potensi celah keamanan dan memastikan kepatuhan terhadap regulasi.
|
Dapat menyerap sumber daya besar tergantung kompleksitas sistem.
|
Tren Baru dalam Keamanan AI
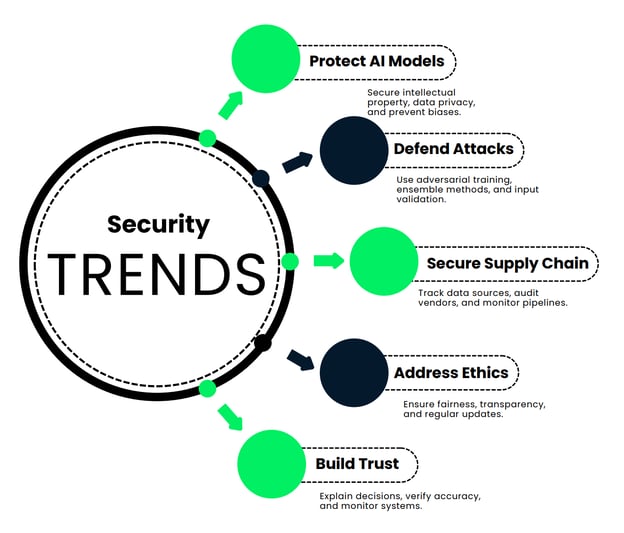
Di bagian ini, kita melihat tren baru yang menjaga sistem AI tetap aman, akurat, dan tepercaya.
Melindungi model AI dan integritas data
Pertama, mari bahas mengapa melindungi model AI dan data begitu penting.
- Melindungi kekayaan intelektual: Pikirkan waktu, biaya, dan upaya intelektual untuk membuat model AI. Ini bukan sekadar algoritme; ini adalah investasi besar. Menjaganya tetap aman mencegah pesaing mencuri kerja keras tersebut.
- Menjaga keunggulan kompetitif: Jika seseorang mendapatkan akses tidak sah ke model AI Anda, mereka bisa menyalinnya dan meraih hasil yang sama—tanpa mengeluarkan biaya pengembangan.
- Privasi data dan kepatuhan: AI sering memproses data sensitif—informasi keuangan, catatan medis, dan lainnya. Jika data ini terekspos, Anda akan menghadapi denda besar dan penurunan kepercayaan publik. Pelajari lebih lanjut dalam Introduction to Data Privacy ini.
- Mencegah peracunan data: Peretas dapat mengacaukan data pelatihan, mengajarkan AI mengambil keputusan salah—misalnya membiarkan penipuan lolos atau menandai tindakan yang tidak bersalah sebagai ancaman.
- Memitigasi serangan inversi model: Bayangkan jika penyerang dapat menyimpulkan detail pelanggan privat hanya dengan mempelajari keluaran AI Anda. Itu jelas berbahaya!
- Menghindari hasil bias atau tidak etis: Model yang dikompromikan dapat menghasilkan keputusan tidak adil atau bahkan berbahaya, yang dapat merusak reputasi Anda.
- Melindungi infrastruktur kritis: Karena AI digunakan di layanan kesehatan, keuangan, hingga keamanan nasional, perlindungannya bukan hanya urusan bisnis—ini juga isu keselamatan publik.
Jadi, bagaimana cara Anda benar-benar menjaga AI tetap aman? Berikut beberapa strategi kunci:
- Gunakan enkripsi dan anonimisasi data untuk melindungi informasi sensitif.
- Terapkan kebijakan retensi data yang ketat untuk mengendalikan lamanya informasi disimpan.
- Lakukan audit keamanan dan pemantauan rutin untuk menangkap kerentanan sejak dini.
- Rancang sistem dengan prinsip privacy by design, membangun keamanan di setiap langkah.
- Gunakan teknik lanjutan seperti federated learning untuk melindungi model dan datanya tanpa perlu memindahkan informasi sensitif.
Mari hidupkan ini dengan skenario nyata. Bayangkan sebuah bank internasional besar yang mengembangkan model AI untuk mendeteksi transaksi penipuan. Sistem ini menangani jutaan transaksi setiap hari, menemukan pola mencurigakan dan menandai penipuan.
Bank menghabiskan $50 juta dan tiga tahun untuk membangun sistem ini. Jika dicuri, pesaing dapat menggunakannya tanpa berinvestasi sepeser pun, merenggut keunggulan bank.
Model ini memproses data keuangan sensitif dari jutaan pelanggan. Pelanggaran dapat mengekspos informasi ini, menyebabkan denda besar berdasarkan undang-undang seperti GDPR.
Jika peretas menyuntikkan data palsu selama pelatihan, mereka dapat mengajari AI untuk melewatkan pola penipuan tertentu, membuat bank rentan.
Penyerang canggih bahkan dapat mengekstrak detail pelanggan privat dari keluaran model.
Bagaimana bank melindunginya?
- Mereka menggunakan enkripsi end-to-end untuk mengamankan data.
- Akses ke model memerlukan otentikasi multi-faktor dan dibatasi melalui kontrol berbasis peran.
- Mereka menjalankan audit dan uji penetrasi rutin untuk menemukan kelemahan.
- Data pelanggan yang digunakan untuk pelatihan dianonimkan sepenuhnya.
- Bank memantau kinerja model secara terus-menerus untuk menangkap hal-hal yang tidak biasa.
Hasilnya adalah sistem AI yang lebih aman dan andal yang menjaga data pelanggan tetap terlindungi dan memenuhi janji untuk mendeteksi penipuan secara efektif. Ini menguntungkan baik bagi bank maupun pelanggannya.
Bertahan dari serangan pengelakan dan peracunan
Bayangkan Anda menjalankan fasilitas berkeamanan tinggi yang mengandalkan pengenalan wajah untuk menjaga semuanya aman. Namun, kita telah mempelajari bahwa sistem AI rentan terhadap serangan, seperti masukan adversarial atau data pelatihan yang diracuni. Peretas dapat memanipulasi sistem agar mereka bisa masuk.
Mari uraikan empat pertahanan kunci yang dapat menghentikan penyerang di jalurnya:
- Pelatihan adversarial: Ini seperti mengajarkan jurus bela diri pada model Anda. Anda menyertakan contoh masukan yang dimanipulasi—gambar dengan penyesuaian halus yang dirancang untuk menipu AI—dan melatihnya untuk mengenalinya. Bayangkan sistem pengenalan wajah yang tidak hanya mengenali wajah Anda, tetapi juga perubahan piksel yang coba diselundupkan penyerang. AI Anda menjadi lebih cerdas menghadapi serangan ini, belajar dari contoh agar tidak mudah dikelabui di dunia nyata.
- Metode ansambel: Kita telah membahas ini sebelumnya. Alih-alih mengandalkan satu sistem, Anda menggunakan satu skuad model. Setiap model memproses input secara independen, dan hasilnya digabungkan dengan mekanisme voting. Penyerang tidak bisa hanya menipu satu model—mereka harus memperdaya seluruh skuad. Tidak mudah.
- Pemeriksaan data rutin: Tidak ada yang suka bersih-bersih, tetapi ini perawatan penting bagi AI Anda. Audit mingguan memastikan data pelatihan bebas dari duplikasi, label salah, atau masukan berbahaya yang tersembunyi. Dan menjaga dataset tetap segar dengan gambar terverifikasi membantu sistem Anda tetap tajam.
- Validasi input: Sebelum gambar mendekati AI Anda, gambar melewati pos pemeriksaan keamanan. Inilah yang terjadi:
- Format dan ukurannya diperiksa.
- Metadata dianalisis untuk tanda-tanda pengubahan.
- Pola adversarial yang dikenal ditandai.
- Deteksi anomali bekerja untuk menemukan hal yang tidak biasa.
Sistem ini bukan hanya cerdas; juga waspada. Setiap input harus membuktikan keabsahannya sebelum melanjutkan.
Mengamankan rantai pasok AI
Mengamankan AI berarti mengelola integritas data, melindungi model kepemilikan, dan memastikan semuanya selaras dengan pengaturan keamanan siber yang ada. Ditambah kebutuhan untuk menghadapi ancaman yang berkembang, kepatuhan regulasi, etika, dan kerentanan rantai pasok. Berikut beberapa strategi untuk mengamankan siklus hidup AI:
- Lacak sumber Anda: Setiap potongan data dan setiap model dalam sistem AI Anda harus memiliki asal-usul yang jelas. Dokumentasikan dari mana asalnya, apakah dari rumah sakit tepercaya, institusi riset, atau pemasok spesialis. Mengapa? Karena mengetahui sumber adalah langkah pertama untuk mengetahui bahwa Anda dapat mempercayainya.
- Audit pemasok Anda: Penyedia pihak ketiga itu krusial, tetapi juga titik lemah potensial. Lakukan audit rutin untuk memastikan mereka memenuhi standar keamanan Anda, apakah itu kepatuhan HIPAA, protokol anonimisasi data, atau sertifikasi ISO.
- Gunakan alat pelacakan data: Data Anda tidak statis. Seiring waktu, ia berkembang, dan terkadang evolusi itu mencakup kesalahan atau perubahan berbahaya. Alat pemantauan data otomatis dapat melacak perubahan dan menandai pergeseran tak terduga, menjaga dataset tetap bersih dan akurat.
- Pantau pipeline data: Data mengalir dari sumber ke model melalui pipeline yang kompleks, dan gangguan di sepanjang jalan dapat menimbulkan masalah. Dasbor waktu nyata dapat membantu Anda menangkap kejanggalan, seperti penurunan mendadak volume data atau perubahan fitur yang tidak diharapkan.
Berikut contoh dunia nyata. Misalkan perusahaan layanan kesehatan mengembangkan alat diagnostik bertenaga AI. Rantai pasok mereka mencakup:
- Data pasien dari rumah sakit mitra.
- Dataset pencitraan medis dari institusi riset papan atas.
- Model pra-latih dari pemasok AI spesialis.
Bagaimana mereka mengamankan pipeline ini?
- Pelacakan sumber: Setiap dataset dan model didokumentasikan dengan cermat untuk memastikan keterlacakan.
- Audit pemasok: Mereka melakukan pemeriksaan triwulanan untuk kepatuhan HIPAA dan memastikan anonimisasi data. Pemasok menjalani penilaian keamanan tahunan untuk mempertahankan sertifikasi.
- Alat garis keturunan data: Mereka menggunakan alat seperti Anomalo untuk mendeteksi pergeseran tak terduga pada demografi pasien atau data pencitraan.
- Pemantauan pipeline: Dasbor waktu nyata di Looker memantau aliran data, langsung menandai kejanggalan apa pun.
Dengan cara ini, mereka memiliki rantai pasok AI yang aman sehingga alat diagnostik mereka akurat, andal, dan sesuai standar industri.
Mengatasi risiko etika
AI itu kuat, tetapi kekuatan itu bisa berbahaya di tangan yang salah. Jika sistem AI diretas atau dirancang dengan buruk, hal itu dapat menghasilkan keputusan bias, hasil yang tidak etis, atau bahkan disalahgunakan. Ini masalah besar, terutama ketika AI membuat keputusan yang memengaruhi kehidupan nyata—seperti rekrutmen, pinjaman, atau layanan kesehatan.
Jadi, bagaimana kita membuat sistem AI lebih etis dan tangguh? Mari kita bagi menjadi empat langkah kunci:
- Kembangkan aturan dan kerangka kerja yang jelas: Mulailah dengan fondasi yang kuat. Ini berarti menyusun kebijakan yang mendefinisikan seperti apa keadilan dan etika bagi sistem Anda.
- Latih tim AI tentang etika: Anda tidak dapat berharap AI bertindak etis jika orang yang membangunnya tidak dibekali untuk berpikir kritis tentang isu-isu ini. Pelatihan etika membantu tim mengenali dan mengatasi bias tak sadar, memahami keadilan, dan mempertimbangkan dampak sosial dari pekerjaan mereka.
- Buat keputusan AI transparan: Transparansi berarti merancang sistem yang dapat menjelaskan keputusannya—faktor apa yang dipertimbangkan, bagaimana kandidat dibandingkan, dan di mana potensi kekhawatiran. Transparansi membangun kepercayaan dan akuntabilitas.
- Perbarui sistem AI secara berkala: AI bukan urusan sekali pasang. Audit rutin membantu mengidentifikasi dan mengurangi bias, memastikan keadilan, dan menjaga sistem tetap mematuhi standar industri serta persyaratan hukum terbaru. Keadilan tidak statis; ini proses berkelanjutan.
Berikut contoh dunia nyata. Mari bahas perusahaan teknologi besar yang menggunakan sistem rekrutmen bertenaga AI. Bagaimana mereka menjaganya tetap etis?
- Kembangkan aturan yang jelas: Mereka membuat Kebijakan Etika AI yang menguraikan prinsip rekrutmen tanpa bias, mencakup segala hal dari pengumpulan data hingga pengambilan keputusan. Dewan Etika AI mengawasi kebijakan ini untuk memastikan akuntabilitas.
- Latih tim: Pelatihan etika menjadi wajib bagi semua karyawan yang bekerja pada sistem. Mereka mengikuti kursus tentang bias tak sadar dan keadilan dalam pembelajaran mesin serta berpartisipasi dalam lokakarya yang membahas dilema dunia nyata.
- Transparansi: Sistem rekrutmen menyertakan alat keterjelasan. Untuk setiap rekomendasi, sistem memberikan uraian faktor yang memengaruhi keputusan—seperti kualifikasi kunci atau bagaimana kandidat dibandingkan dengan yang lain. Ini memudahkan manajer HR meninjau keputusan.
- Pembaruan rutin: Audit triwulanan menganalisis keputusan rekrutmen untuk mendeteksi bias dan menerapkan teknik seperti adversarial debiasing untuk terus meningkatkan keadilan. Mereka juga memperbarui sistem dengan undang-undang kesempatan kerja setara terbaru dan praktik terbaik industri.
Ini adalah sistem rekrutmen yang etis, adil, dan transparan—bahkan jika menghadapi potensi kompromi.
Tantangan dalam keterjelasan dan kepercayaan
Sistem AI sering dipandang sebagai “kotak hitam,” artinya proses pengambilan keputusannya tidak mudah dipahami. Ini dapat menyulitkan untuk menemukan masalah atau membangun kepercayaan. Jika Anda seorang dokter yang mengandalkan alat AI atau pasien yang terdampak keputusannya, Anda menginginkan jawaban, bukan tanda tanya. Solusinya adalah keterjelasan. Berikut empat strategi untuk membuat sistem AI lebih transparan dan mudah dipercaya:
- Gunakan alat Explainable AI (XAI): Alat ini membantu mengungkap bagaimana AI mencapai kesimpulannya. Misalnya, teknik seperti LIME atau SHAP dapat menunjukkan faktor mana yang memengaruhi keputusan tertentu, sehingga penalaran sistem menjadi lebih mudah diakses.
- Lacak dan dokumentasikan perubahan data: Saat Anda mendokumentasikan setiap perubahan—data mana yang ditambahkan, dihapus, atau dimodifikasi—Anda dapat menelusuri bagaimana pembaruan ini memengaruhi kinerja model.
- Verifikasi akurasi secara berkala: Anda tidak bisa begitu saja menerima AI apa adanya. Bandingkan keluarannya dengan data asli dan, jika memungkinkan, mintalah pendapat pakar manusia. Audit rutin memastikan sistem tetap tajam dan tidak bias. Percayai, tetapi verifikasi.
- Uji dan pantau secara berkelanjutan: AI bukan alat “pasang lalu lupakan”. Pengujian sering dengan beragam input membantu menangkap kesalahan sejak dini, dan pemantauan waktu nyata memastikan sistem berkinerja konsisten di berbagai skenario.
Mari lihat bagaimana sebuah rumah sakit membangun kepercayaan pada alat diagnostik dermatologi bertenaga AI—sistem yang menggunakan pengenalan gambar untuk mengidentifikasi potensi kondisi kulit.
- Alat XAI: Rumah sakit menggunakan LIME, alat yang menyoroti bagian gambar kulit yang paling berpengaruh dalam diagnosis AI sehingga dokter dapat memahami dan mempercayai penalaran AI.
- Melacak perubahan data: Alat garis keturunan data mencatat semua pembaruan pada dataset pelatihan, seperti gambar yang baru ditambahkan atau dihapus. Ini memungkinkan rumah sakit melacak bagaimana perubahan tersebut memengaruhi akurasi AI dari waktu ke waktu.
- Memverifikasi akurasi: Setiap bulan, dokter kulit meninjau sampel acak diagnosis AI, membandingkannya dengan data pasien asli dan pendapat ahli mereka sendiri. Tujuannya untuk memastikan sistem mempertahankan standar akurasi dan keadilan yang tinggi.
- Pengujian dan pemantauan rutin: Tim TI melakukan pengujian mingguan dengan beragam gambar, memeriksa kinerja AI pada berbagai jenis kulit dan kondisi. Mereka juga memantau pola tidak biasa secara waktu nyata, sehingga masalah dapat diperbaiki sebelum membesar.
Alat AI ini tidak hanya cerdas tetapi juga dapat dijelaskan dan tepercaya. Dokter memahami keputusannya, pasien merasa yakin dengan perawatan mereka, dan rumah sakit memastikan teknologinya bekerja dengan adil dan akurat.
Kesimpulan
Seiring AI menjadi bagian yang lebih besar dalam hidup kita, menjaganya tetap aman menjadi semakin krusial. Mengapa? Karena kekuatan yang sama yang mendorong kapabilitas AI juga menjadikannya target serangan. Ancaman seperti serangan adversarial, peracunan data, dan pencurian model dapat sangat mengganggu cara kerja AI.
Jadi, bagaimana kita mempertahankan AI? Kita telah mempelajari bahwa tidak ada solusi satu untuk semua. Teknik seperti pelatihan adversarial, audit rutin, dan pengamanan berlapis dapat mengurangi risiko dan membuat sistem Anda lebih tangguh.
Lalu ada AI generatif. Model bahasa besar menawarkan peluang luar biasa, tetapi juga memperkenalkan kerentanan baru. Dari menghasilkan konten menyesatkan hingga dimanipulasi untuk memberikan keluaran berbahaya, alat ini memerlukan pengawasan yang cermat. Dalam artikel How to Build Guardrails for Large Language Models, langkah-langkah keamanan untuk memastikan LLM berperilaku sebagaimana mestinya dibahas.
Etika dan transparansi tidak bisa ditawar. Sistem AI perlu adil, dapat dijelaskan, dan tepercaya. Bias dan penyalahgunaan dapat mengikis kepercayaan—dan kepercayaan adalah segalanya di dunia yang digerakkan teknologi saat ini. Orang tidak akan menggunakan apa yang tidak mereka percayai.
Akhirnya, tetap selangkah di depan adalah kunci. Ancaman AI terus berkembang. Bisnis perlu secara rutin memperbarui strategi keamanan mereka, mengikuti risiko baru agar tetap terlindungi.Kuncinya adalah proaktif, waspada, dan berkomitmen pada etika serta transparansi, sehingga bisnis dapat membangun kepercayaan dan memaksimalkan manfaat AI.


 Dario Radečić · 15 min

 David Woods · 13 min

 Javier Canales Luna · 14 min


AI berkembang begitu cepat hingga mengikuti tantangan keamanannya terasa seperti mencoba memperbaiki pesawat saat masih mengudara. Seiring sistem menjadi lebih cerdas dan semakin tertanam dalam proses bisnis sehari-hari, kerentanannya terhadap jenis ancaman baru juga meningkat.
Saya telah melihat ini dari dekat dalam pekerjaan saya. Berkali-kali saya menemukan celah keamanan dalam proses bisnis yang dapat memungkinkan seseorang mengakses informasi sensitif yang seharusnya tidak mereka lihat, terutama ketika solusi AI diterapkan secara tergesa-gesa tanpa langkah keamanan yang memadai.
Itulah inti artikel ini: memahami risiko, tantangan, dan praktik terbaik untuk menjaga AI tetap aman. AI tumbuh begitu cepat, dan jika kita tidak selangkah lebih maju dari kerentanan, kita berisiko kehilangan kepercayaan dan manfaat yang dibawanya.
Jika Anda ingin mempelajari topik ini lebih detail, saya sarankan mengecek kursus AI Security and Risk Management.
Tantangan Baru Keamanan AI
AI berjalan dengan data. Semakin banyak data yang diandalkan AI Anda, semakin besar pula sasarannya. Peretas tahu ini. Bayangkan rumah sakit menggunakan AI untuk memprediksi risiko kesehatan pasien. Kedengarannya bagus, sampai seseorang meretas sistem. Tiba-tiba, catatan pasien yang sifatnya privat tersebar di dark web, atau lebih buruk lagi, data medis diubah sehingga dapat menyebabkan keputusan berbahaya. Mengenkripsi data sensitif dan memiliki cadangan adalah kunci, tetapi banyak perusahaan begitu fokus pada inovasi hingga mengabaikan hal-hal dasar ini.
Dan peretas tidak hanya mencuri data. Mereka juga bisa mengacaukan model AI itu sendiri. Misalnya, mobil swakemudi yang dikelabui sehingga mengira rambu berhenti adalah rambu batas kecepatan. Jenis serangan ini disebut serangan peracunan data, di mana peretas memasukkan data buruk ke dalam sistem untuk merusak proses pengambilan keputusan. Kita akan membahas ini lebih detail di bagian berikutnya.
Serangan penyuntikan prompt juga merupakan jenis serangan lain. Ini adalah manipulasi halus yang menipu AI agar mengatakan—atau melakukan—sesuatu yang seharusnya tidak dilakukan. Kami memiliki artikel yang sangat bagus tentang penyuntikan prompt, jadi kami tidak akan membahasnya terlalu rinci di artikel ini, tetapi ini jelas layak dibaca.
Ironisnya, peretas juga menggunakan AI untuk meretas. Di sinilah keamanan siber menjadi perlombaan melawan waktu—peretas berinovasi, dan tim keamanan harus merespons secepatnya. Alat seperti deteksi anomali dapat membantu, tetapi tidak sepenuhnya andal.
Pernah mendengar pepatah, "Kekuatan rantai hanya sekuat mata rantai terlemahnya"? Ini sangat berlaku untuk AI. Perusahaan sering mengintegrasikan alat AI siap pakai ke dalam sistem mereka. Namun apa yang terjadi jika salah satu alat itu dikompromikan? Bayangkan chatbot populer yang digunakan ratusan bisnis diretas. Itu berarti ratusan perusahaan—bersama seluruh data pelanggan mereka—berada dalam risiko. Efek domino digital.
Terakhir, ada kesenjangan keahlian. Adopsi AI meningkat, tetapi keamanan siber untuk AI masih tertinggal.
Ancaman Keamanan AI
Sistem AI menghadapi ancaman keamanan serius yang dapat mengganggu kinerja dan keandalannya. Mari melihat ancaman utamanya.
Serangan adversarial
Serangan adversarial menipu sistem AI dengan membuat perubahan kecil dan licik pada masukan yang diproses AI. Perubahan ini begitu halus sehingga manusia biasanya tidak dapat mengenalinya, tetapi bisa sepenuhnya membingungkan AI hingga mengambil keputusan yang salah.
Contohnya:
Serangan ini tidak mengharuskan penyerang mengetahui cara kerja internal AI, yang membuatnya sangat sulit dideteksi dan dihentikan.
Sekarang mari melihat beberapa contoh dunia nyata.
Diagram ini mengilustrasikan serangan adversarial pada sistem AI pencitraan medis. Rontgen asli, yang diklasifikasikan dengan benar sebagai "Risiko Tinggi Kanker Paru", diubah secara halus dengan noise adversarial, sehingga salah diklasifikasikan menjadi "Paru-paru Sehat".
Bacaan yang bagus adalah Adversarial Machine Learning, bidang yang mempelajari serangan yang mengeksploitasi kerentanan model pembelajaran mesin dan mengembangkan pertahanan untuk melindungi dari ancaman ini.
Serangan peracunan
Serangan peracunan menargetkan fase pelatihan sistem AI, saat model belajar mengambil keputusan. Penyerang menyelundupkan data yang rusak atau menyesatkan ke dalam himpunan pelatihan agar dapat memanipulasi AI berperilaku salah atau cenderung menghasilkan keluaran bias. Serangan ini efektif karena mengutak-atik fondasi proses pembelajaran AI, sering kali tanpa meninggalkan tanda-tanda jelas bahwa ada yang salah.
Ini dapat melibatkan:
Perubahan halus ini dapat menyebabkan AI gagal dalam kondisi tertentu atau bertindak dengan cara yang menguntungkan penyerang. Karena serangan terjadi selama pelatihan, sulit terdeteksi setelah model diterapkan.
Mari melihat beberapa contoh dunia nyata:
Diagram ini menunjukkan serangan peracunan pada sistem AI yang digunakan untuk mengklasifikasikan klaim asuransi palsu dan benar. Pada panel pertama, sistem memisahkan klaim palsu (merah) dan benar (hitam) dengan benar menggunakan dataset pelatihan bersih. Pada panel kedua, data yang salah label secara berbahaya (“racun”) menggeser batas keputusan, sehingga klaim palsu salah diklasifikasikan sebagai benar, yang merusak keandalan dan keamanan sistem.
Serangan ekstraksi model
Dalam serangan ekstraksi model, penyerang mencari tahu cara kerja model AI dengan merekayasa baliknya. Mereka menggunakan masukan dan keluaran yang dikumpulkan untuk menyalin rancangan dan perilaku sistem.
Setelah mereka membangun replika model, mereka dapat:
Misalnya, jika model curian dilatih pada data pelanggan pribadi, penyerang dapat memprediksi detail pribadi pelanggan tersebut atau membuat versi model yang disesuaikan untuk penggunaan mereka sendiri.
Mari melihat beberapa contoh dunia nyata:
Diagram ini mengilustrasikan serangan ekstraksi model, di mana penyerang berinteraksi dengan model AI korban dengan mengirim kueri dan mengumpulkan prediksinya. Data yang dikumpulkan digunakan untuk melatih model replika, sehingga pada akhirnya membangun versi curian dari sistem asli.
Pertahanan Keamanan AI
Kita telah menyebutkan di bagian sebelumnya bahwa seiring AI menjadi lebih umum, penting untuk menerapkan langkah keamanan yang kuat untuk melindungi dari serangan. Mari membahas beberapa cara efektif untuk membuat AI lebih aman.
Pelatihan adversarial
Metode ini melibatkan pengajaran model untuk mengenali dan menangani masukan yang licik dan dimanipulasi (disebut contoh adversarial). Saat Anda melatih model dengan contoh-contoh ini, model menjadi lebih baik dalam menahan jenis serangan tertentu.
Distilasi defensif
Distilasi LLM melibatkan pelatihan model sekunder untuk meniru perilaku model asli dengan tujuan membuatnya lebih sulit dimanipulasi penyerang.
Validasi dan sanitasi input
Memastikan data yang masuk ke sistem AI bersih dan aman adalah kunci untuk melindunginya dari masukan berbahaya.
Metode ansambel
Menggunakan beberapa model AI berbeda secara bersama (ansambel) dapat membuat sistem lebih aman. Bahkan jika satu model diserang, model lainnya dapat menjadi cadangan.
Explainable AI (XAI)
Membuat sistem AI dapat dijelaskan membantu orang memahami cara kerjanya dan mendeteksi kerentanan atau perilaku tidak biasa. Anda dapat mengeksplorasi topik ini lebih detail dalam kursus Explainable AI in Python.
Audit keamanan berkala
Memeriksa sistem AI secara rutin untuk mencari kelemahan dapat membantu menangkap masalah sejak dini dan memastikan sistem tetap aman dari waktu ke waktu.
Menggunakan strategi-strategi ini dapat membuat sistem AI lebih aman dan lebih terlindungi dari serangan. Namun begini—keamanan AI bukanlah urusan "pasang lalu lupakan". Ini adalah proses berkelanjutan.
Saat ancaman baru bermunculan—dan percayalah, itu selalu terjadi—bisnis perlu sigap. Artinya, terus memantau kerentanan, memperbarui sistem, dan meningkatkan pertahanan.
Metode
Cara Kerja
Mengapa Membantu
Kekurangan
Pelatihan Adversarial
Buat contoh data yang dimanipulasi dan sertakan dalam pelatihan AI.
Meningkatkan ketangguhan terhadap serangan adversarial yang mencoba menipu sistem.
Dapat sedikit menurunkan akurasi AI pada data normal (bersih).
Distilasi Defensif
Latih model sekunder untuk meniru perilaku model asli, menghaluskan proses pengambilan keputusan.
Menyulitkan penyerang mengeksploitasi kelemahan pada model.
Memerlukan daya komputasi besar, terutama untuk model yang besar.
Validasi & Sanitasi Input
Validasi bahwa input berformat benar, berada dalam rentang yang diharapkan, dan tidak mengandung elemen berbahaya.
Mencegah peracunan data dan memastikan sistem AI berjalan lancar.
Memerlukan implementasi cermat di beberapa tahap.
Metode Ansambel
Gabungkan prediksi dari beberapa model untuk membuat keputusan.
Lebih sulit bagi penyerang untuk mengompromikan semua model secara bersamaan.
Memerlukan lebih banyak sumber daya komputasi untuk mengelola dan memelihara beberapa model.
Explainable AI (XAI)
Gunakan alat seperti LIME, SHAP, atau mekanisme atensi untuk menjelaskan keputusan AI.
Meningkatkan kepercayaan dan memudahkan mengidentifikasi serta memperbaiki masalah seperti bias atau perilaku tidak biasa.
Model yang lebih sederhana dan dapat dijelaskan mungkin tidak berkinerja sebaik model yang kompleks.
Audit Keamanan Berkala
Lakukan penilaian kerentanan, uji penetrasi, dan tinjauan kode untuk mengidentifikasi kelemahan.
Mengidentifikasi potensi celah keamanan dan memastikan kepatuhan terhadap regulasi.
Dapat menyerap sumber daya besar tergantung kompleksitas sistem.
Tren Baru dalam Keamanan AI
Di bagian ini, kita melihat tren baru yang menjaga sistem AI tetap aman, akurat, dan tepercaya.
Melindungi model AI dan integritas data
Pertama, mari bahas mengapa melindungi model AI dan data begitu penting.
Jadi, bagaimana cara Anda benar-benar menjaga AI tetap aman? Berikut beberapa strategi kunci:
Mari hidupkan ini dengan skenario nyata. Bayangkan sebuah bank internasional besar yang mengembangkan model AI untuk mendeteksi transaksi penipuan. Sistem ini menangani jutaan transaksi setiap hari, menemukan pola mencurigakan dan menandai penipuan.
Bank menghabiskan $50 juta dan tiga tahun untuk membangun sistem ini. Jika dicuri, pesaing dapat menggunakannya tanpa berinvestasi sepeser pun, merenggut keunggulan bank.
Model ini memproses data keuangan sensitif dari jutaan pelanggan. Pelanggaran dapat mengekspos informasi ini, menyebabkan denda besar berdasarkan undang-undang seperti GDPR.
Jika peretas menyuntikkan data palsu selama pelatihan, mereka dapat mengajari AI untuk melewatkan pola penipuan tertentu, membuat bank rentan.
Penyerang canggih bahkan dapat mengekstrak detail pelanggan privat dari keluaran model.
Bagaimana bank melindunginya?
Hasilnya adalah sistem AI yang lebih aman dan andal yang menjaga data pelanggan tetap terlindungi dan memenuhi janji untuk mendeteksi penipuan secara efektif. Ini menguntungkan baik bagi bank maupun pelanggannya.
Bertahan dari serangan pengelakan dan peracunan
Bayangkan Anda menjalankan fasilitas berkeamanan tinggi yang mengandalkan pengenalan wajah untuk menjaga semuanya aman. Namun, kita telah mempelajari bahwa sistem AI rentan terhadap serangan, seperti masukan adversarial atau data pelatihan yang diracuni. Peretas dapat memanipulasi sistem agar mereka bisa masuk.
Mari uraikan empat pertahanan kunci yang dapat menghentikan penyerang di jalurnya:
Sistem ini bukan hanya cerdas; juga waspada. Setiap input harus membuktikan keabsahannya sebelum melanjutkan.
Mengamankan rantai pasok AI
Mengamankan AI berarti mengelola integritas data, melindungi model kepemilikan, dan memastikan semuanya selaras dengan pengaturan keamanan siber yang ada. Ditambah kebutuhan untuk menghadapi ancaman yang berkembang, kepatuhan regulasi, etika, dan kerentanan rantai pasok. Berikut beberapa strategi untuk mengamankan siklus hidup AI:
Berikut contoh dunia nyata. Misalkan perusahaan layanan kesehatan mengembangkan alat diagnostik bertenaga AI. Rantai pasok mereka mencakup:
Bagaimana mereka mengamankan pipeline ini?
Dengan cara ini, mereka memiliki rantai pasok AI yang aman sehingga alat diagnostik mereka akurat, andal, dan sesuai standar industri.
Mengatasi risiko etika
AI itu kuat, tetapi kekuatan itu bisa berbahaya di tangan yang salah. Jika sistem AI diretas atau dirancang dengan buruk, hal itu dapat menghasilkan keputusan bias, hasil yang tidak etis, atau bahkan disalahgunakan. Ini masalah besar, terutama ketika AI membuat keputusan yang memengaruhi kehidupan nyata—seperti rekrutmen, pinjaman, atau layanan kesehatan.
Jadi, bagaimana kita membuat sistem AI lebih etis dan tangguh? Mari kita bagi menjadi empat langkah kunci:
Berikut contoh dunia nyata. Mari bahas perusahaan teknologi besar yang menggunakan sistem rekrutmen bertenaga AI. Bagaimana mereka menjaganya tetap etis?
Ini adalah sistem rekrutmen yang etis, adil, dan transparan—bahkan jika menghadapi potensi kompromi.
Tantangan dalam keterjelasan dan kepercayaan
Sistem AI sering dipandang sebagai “kotak hitam,” artinya proses pengambilan keputusannya tidak mudah dipahami. Ini dapat menyulitkan untuk menemukan masalah atau membangun kepercayaan. Jika Anda seorang dokter yang mengandalkan alat AI atau pasien yang terdampak keputusannya, Anda menginginkan jawaban, bukan tanda tanya. Solusinya adalah keterjelasan. Berikut empat strategi untuk membuat sistem AI lebih transparan dan mudah dipercaya:
Mari lihat bagaimana sebuah rumah sakit membangun kepercayaan pada alat diagnostik dermatologi bertenaga AI—sistem yang menggunakan pengenalan gambar untuk mengidentifikasi potensi kondisi kulit.
Alat AI ini tidak hanya cerdas tetapi juga dapat dijelaskan dan tepercaya. Dokter memahami keputusannya, pasien merasa yakin dengan perawatan mereka, dan rumah sakit memastikan teknologinya bekerja dengan adil dan akurat.
Kesimpulan
Seiring AI menjadi bagian yang lebih besar dalam hidup kita, menjaganya tetap aman menjadi semakin krusial. Mengapa? Karena kekuatan yang sama yang mendorong kapabilitas AI juga menjadikannya target serangan. Ancaman seperti serangan adversarial, peracunan data, dan pencurian model dapat sangat mengganggu cara kerja AI.
Jadi, bagaimana kita mempertahankan AI? Kita telah mempelajari bahwa tidak ada solusi satu untuk semua. Teknik seperti pelatihan adversarial, audit rutin, dan pengamanan berlapis dapat mengurangi risiko dan membuat sistem Anda lebih tangguh.
Lalu ada AI generatif. Model bahasa besar menawarkan peluang luar biasa, tetapi juga memperkenalkan kerentanan baru. Dari menghasilkan konten menyesatkan hingga dimanipulasi untuk memberikan keluaran berbahaya, alat ini memerlukan pengawasan yang cermat. Dalam artikel How to Build Guardrails for Large Language Models, langkah-langkah keamanan untuk memastikan LLM berperilaku sebagaimana mestinya dibahas.
Etika dan transparansi tidak bisa ditawar. Sistem AI perlu adil, dapat dijelaskan, dan tepercaya. Bias dan penyalahgunaan dapat mengikis kepercayaan—dan kepercayaan adalah segalanya di dunia yang digerakkan teknologi saat ini. Orang tidak akan menggunakan apa yang tidak mereka percayai.
Akhirnya, tetap selangkah di depan adalah kunci. Ancaman AI terus berkembang. Bisnis perlu secara rutin memperbarui strategi keamanan mereka, mengikuti risiko baru agar tetap terlindungi.Kuncinya adalah proaktif, waspada, dan berkomitmen pada etika serta transparansi, sehingga bisnis dapat membangun kepercayaan dan memaksimalkan manfaat AI.