Yapay zeka o kadar hızlı gelişiyor ki, güvenlik sorunlarına ayak uydurmak, uçuştayken uçağı tamir etmeye çalışmak gibi hissettiriyor. Sistemler daha akıllı hale geldikçe ve günlük iş süreçlerine daha derinlemesine entegre oldukça, yeni tür tehditlere karşı daha savunmasız oluyorlar.
Bunu işimde yakından gördüm. Özellikle yapay zeka çözümlerinin uygun güvenlik önlemleri olmadan aceleyle uygulandığı durumlarda, birinin erişmemesi gereken hassas bilgilere erişmesine olanak tanıyabilecek iş süreçlerindeki güvenlik açıklarını defalarca keşfettim.
Bu makale de bununla ilgili: Yapay zekayı güvende tutmak için riskleri, zorlukları ve en iyi uygulamaları anlamak. Yapay zeka çok hızlı büyüyor ve açıkların önünde gitmezsek, onun getirdiği güveni ve faydaları kaybetme riskiyle karşı karşıya kalırız.
Bu konuyu daha detaylı öğrenmek isterseniz AI Security and Risk Management kursuna göz atmanızı öneririm.
Yeni Yapay Zeka Güvenlik Zorlukları
Yapay zeka verilerle çalışır. Yapay zekanız ne kadar çok veriye dayanıyorsa, hedef de o kadar büyüktür. Hackerlar bunun farkında. Bir hastanenin hastaların sağlık risklerini tahmin etmek için yapay zekayı kullandığını hayal edin. Kulağa harika geliyor, ta ki biri sistemi hackleyene kadar. Bir anda özel hasta kayıtları dark web'de ortaya çıkabilir ya da daha kötüsü, tıbbi veriler değiştirilerek zararlı kararlara yol açabilir. Hassas verilerin şifrelenmesi ve yedeklerin olması kritik önemdedir, ancak birçok şirket inovasyona o kadar odaklanıyor ki bu temel unsurları gözden kaçırıyor.
Üstelik hackerlar sadece veri çalmıyor. Doğrudan yapay zeka modelleriyle de oynayabiliyorlar. Örneğin, otonom bir aracın bir dur işaretini hız sınırı tabelası sanacak şekilde kandırılması. Bu tür bir saldırı, hackerların sisteme kötü veri vererek karar alma süreçlerini bozduğu veri zehirleme saldırısı olarak adlandırılır. Bunu bir sonraki bölümde daha detaylı inceleyeceğiz.
İstem enjeksiyonu saldırıları da başka bir saldırı türüdür. Bunlar, bir yapay zekayı söylememesi—ya da yapmaması—gereken bir şeye yönlendiren ince manipülasyonlardır. Prompt injection hakkında harika bir makalemiz var; bu yazıda çok detaya girmeyeceğiz ama kesinlikle okunmaya değer.
İronik bir şekilde, hackerlar hacklemek için de yapay zekadan yararlanıyor. İşte burada siber güvenlik zamana karşı bir yarışa dönüşüyor—hackerlar yenilik yapıyor, güvenlik ekipleri de aynı hızda karşılık vermek zorunda kalıyor. Anomali tespiti gibi araçlar yardımcı olabilir, ancak kusursuz değiller.
“Bir zincir en zayıf halkası kadar güçlüdür” sözünü hiç duydunuz mu? Yapay zeka için de tamamen geçerli. Şirketler genellikle hazır yapay zeka araçlarını sistemlerine entegre eder. Peki bu araçlardan biri ele geçirilirse ne olur? Yüzlerce işletme tarafından kullanılan popüler bir sohbet botunun hacklendiğini düşünün. Bu, yüzlerce şirketin—ve tüm müşteri verilerinin—riske girmesi demektir. Dijital bir domino etkisi.
Son olarak, uzmanlık açığı var. Yapay zeka benimsenmesi artıyor, ancak yapay zeka için siber güvenlik hâlâ geriden geliyor.
Yapay Zeka Güvenliği Tehditleri
Yapay zeka sistemleri, performanslarını ve güvenilirliklerini tehlikeye atabilecek ciddi güvenlik tehditleriyle karşı karşıya. Başlıca tehditlere bakalım.
Hasmane (adversarial) saldırılar
Hasmane saldırılar, yapay zekayı kandırmak için yapay zekanın işlediği girdilerde küçük ve sinsi değişiklikler yapar. Bu değişiklikler o kadar incedir ki insanlar genellikle fark etmez, fakat yapay zekayı tamamen yanıltarak yanlış karar vermesine yol açabilir.
Örneğin:
- Bir görüntüde yalnızca birkaç pikseli değiştirerek yapay zekanın onu yanlış sınıflandırmasına neden olmak.
- Bir ses dosyasına hafif gürültü ekleyerek bize aynı gelmesini sağlamak ama yapay zekanın onu yanlış yorumlamasına yol açmak.
- Bir cümlenin ifadesini, yapay zekanın anlayışını karıştıracak şekilde küçük oynamalarla değiştirmek.
Bu saldırılar, saldırganın yapay zekanın iç işleyişini bilmesini gerektirmez; bu da onları tespit etmeyi ve durdurmayı çok zor hale getirir.
Şimdi gerçek dünya örneklerine bakalım.
- DeepFool algoritması: DeepFool, bir görüntü gibi girdilerde neredeyse görünmez değişiklikler yaparak yapay zekayı yanlış sınıflandırmaya düşürmek için tasarlanmış bir yöntemdir. Girdiyi, yapay zekanın hataya düşeceği ana kadar kademeli olarak değiştirir. Bu değişiklikler o kadar küçüktür ki insanlar fark etmez.
- Hedefli ses saldırıları: Bu makalede, orijinaline neredeyse özdeş duyulan ancak konuşma tanıma sisteminin tamamen farklı kelimeler duymasına neden olan seslerin nasıl üretildiği gösterildi. Bu yöntem, Mozilla'nın DeepSpeech sistemini %100 başarı oranıyla kandırmak için kullanıldı.
- Tesla otopilot manipülasyonu: Keen Labs, yola stratejik olarak üç fark edilmeyecek etiket yerleştirerek Tesla'nın otopilot sistemini şerit işaretlerini yanlış yorumlamaya ve potansiyel olarak yanlış şeride yönelmeye zorladı. Daha fazlasını burada okuyun.
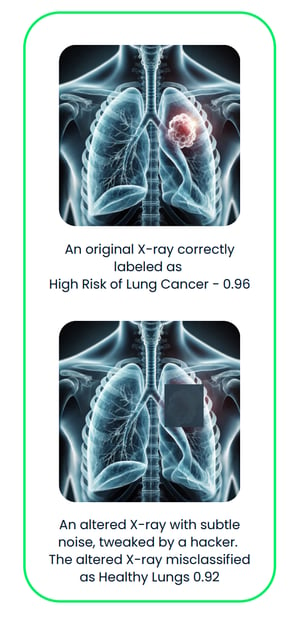
Bu diyagram, tıbbi görüntüleme yapan bir yapay zeka sistemine yönelik hasmane bir saldırıyı göstermektedir. Orijinal röntgen, "Akciğer Kanseri Yüksek Risk" olarak doğru sınıflandırılmışken, hasmane gürültü ile ince şekilde değiştirilmiş ve "Sağlıklı Akciğerler" olarak yanlış sınıflandırılmıştır.
Okumaya değer bir konu da Hasmane Makine Öğrenimidur; bu alan, makine öğrenmesi modellerindeki zafiyetleri sömüren saldırıları inceler ve bu tehditlere karşı savunmalar geliştirir.
Zehirleme (poisoning) saldırıları
Zehirleme saldırıları, modelin nasıl karar vereceğini öğrendiği eğitim aşamasını hedef alır. Saldırganlar, yapay zekayı hatalı davranmaya ya da taraflı sonuçları tercih etmeye yönlendirmek için eğitim setine bozulmuş veya yanıltıcı veriler sızdırır. Bu saldırılar, yapay zekanın öğrenme sürecinin temeliyle oynadıkları ve genellikle bir şeylerin ters gittiğine dair bariz izler bırakmadıkları için etkilidir.
Bu şunları içerebilir:
- Bazı eğitim örneklerinin etiketlerini değiştirmek; örneğin bir köpek resmini kedi olarak etiketlemek.
- Yapay zekanın kararlarını belirli şekillerde etkilemek üzere tasarlanmış sahte veri noktaları eklemek.
Bu ince değişiklikler, yapay zekanın belirli koşullarda başarısız olmasına ya da saldırgana fayda sağlayacak şekillerde davranmasına neden olabilir. Saldırı eğitim sırasında gerçekleştiği için, model dağıtıma alındıktan sonra tespit etmek zordur.
Bazı gerçek dünya örneklerine bakalım:
- Arka kapı (backdoor) saldırıları: “Bypassing Backdoor Detection Algorithms in Deep Learning” başlıklı çalışma, saldırganların yapay zeka modellerine kötü niyetli “arka kapılar” gizleyebileceğini gösterdi. Bu arka kapılar, yalnızca görüntüde belirli bir desenin gösterilmesi gibi özel koşullarda tetiklenir. Çalışma, saldırganların zehirlenmiş verileri temiz verilerle özdeş görünecek şekilde gelişmiş tekniklerle gizleyerek tespitten kaçınabildiğini ortaya koydu.
- Web ölçekli veri seti zehirleme: “Poisoning Web-Scale Training Datasets is Practical” makalesinde, internetten toplanan büyük veri setlerinin şu yollarla zehirlenebileceği açıklandı:
- Bölünmüş görünüm (split-view) veri zehirleme: Veri toplandıktan sonra ancak eğitimde kullanılmadan önce bozulması.
- Önden koşma (frontrunning) veri zehirleme: Verinin veri setine eklenmesinden hemen önce manipüle edilmesi.
- Microsoft'un Tay sohbet botu: 2016'da Microsoft, Twitter'da Tay adlı bir sohbet botu yayınladı. Kullanıcılar, saldırgan içeriklerle bombardımana tutarak Tay'i hızla manipüle etti ve ırkçı ve uygunsuz tweetler atmasına neden oldu. Microsoft, kısa süre sonra Tay'i kapatmak zorunda kaldı. Daha fazlasını burada okuyun.
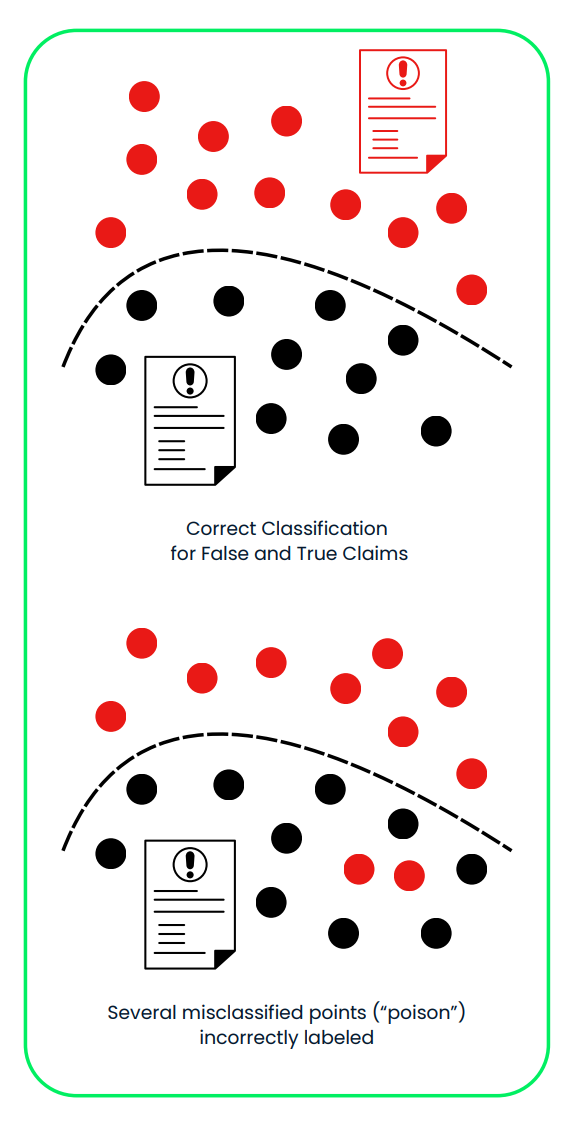
Bu diyagram, sahte ve gerçek sigorta taleplerini sınıflandıran bir yapay zeka sistemine yönelik zehirleme saldırısını göstermektedir. İlk panelde, sistem temiz bir eğitim veri seti kullanarak sahte (kırmızı) ve gerçek (siyah) talepleri doğru şekilde ayırır. İkinci panelde, kötü niyetle yanlış etiketlenmiş veriler (“zehir”), karar sınırını kaydırarak sahte taleplerin gerçek olarak yanlış sınıflandırılmasına yol açar; bu da sistemin güvenilirliğini ve güvenliğini zedeler.
Model çıkarımı saldırısında, bir saldırgan bir yapay zeka modelinin nasıl çalıştığını tersine mühendislikle çözer. Topladığı giriş ve çıkışları kullanarak sistemin tasarımını ve davranışını kopyalar.
Bir kopya model oluşturduktan sonra şunları yapabilir:
- Onu tahmin yapmak için kullanabilir; bu tahminler hassas veya özel verileri içerebilir.
- Orijinal modelden gizli bilgileri çalabilir.
- Modeli kendi amaçlarına uyacak şekilde değiştirip yeniden eğitebilir; bu amaçlar sıklıkla zararlı olabilir.
Örneğin, çalınan model özel müşteri verileriyle eğitildiyse, saldırgan bu müşteriler hakkında kişisel ayrıntıları tahmin edebilir veya kendi kullanımına uygun özelleştirilmiş bir sürüm oluşturabilir.
Bazı gerçek dünya örneklerine bakalım:
- DeepSniffer adlı bir araç bu tür bir saldırının nasıl çalışabileceğini gösteriyor. DeepSniffer, orijinal model hakkında önceden hiçbir şey bilmeyi gerektirmez. Bunun yerine, modelin çalışma zamanındaki bellek işlemlerini izlemek gibi, modelin veriyi nasıl işlediğine dair ipuçları toplar. Bu ipuçlarını bir araya getirerek, sistem süreçlerini optimize etmeye veya gizlemeye çalışsa bile modelin yapısını çıkarabilir.
- Mindgard, OpenAI'nın ChatGPT 3.5 Turbo'sı gibi kara kutu bir dil modelinin kritik bileşenlerinin düşük maliyetli bir süreçle nasıl çıkarılabildiğini gösterdi. Sadece 50 $ API harcamasıyla ekip, özgününden yaklaşık 100 kat daha küçük bir model oluşturdu ve bu model belirli bir görevde ChatGPT'yi geride bıraktı. Ardından bu çıkarılan model, ChatGPT'nin kendisine karşı konuşlandırılan başka bir saldırıyı geliştirmek için kullanıldı. İyileştirilmiş saldırı başarı oranını %11'e yükseltti.
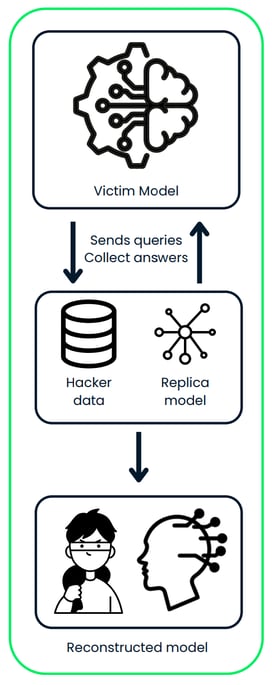
Bu diyagram, bir saldırganın sorgular gönderip tahminlerini toplayarak kurban yapay zeka modeliyle etkileşime geçtiği model çıkarımı saldırısını göstermektedir. Saldırgan, topladığı verileri bir kopya modeli eğitmek için kullanır ve sonunda orijinal sistemin çalınmış bir sürümünü yeniden oluşturur.
Yapay Zeka Güvenliği Savunmaları
Önceki bölümlerde belirttiğimiz gibi, yapay zeka yaygınlaştıkça saldırılara karşı koruma sağlamak için güçlü güvenlik önlemleri almak önemli hale geliyor. Yapay zekayı daha güvenli kılmanın etkili yollarından bahsedelim.
Hasmane eğitim
Bu yöntem, modellere hileli, manipüle edilmiş girdileri (hasmane örnekler) tanımayı ve bunlarla başa çıkmayı öğretir. Modelinizi bu örneklerle eğittiğinizde, belirli saldırı türlerine karşı daha dirençli hale gelir.
- Nasıl çalışır: Manipüle edilmiş veri örnekleri oluşturup yapay zekanın eğitimine dahil edin.
- Neden faydalı: Yapay zeka sistemlerini kandırmaya yönelik saldırılara karşı daha sağlam hale getirir.
- Dezavantaj: Yapay zekanın normal (temiz) verilerdeki doğruluğunu biraz düşürebilir.
- Gerçek dünya örnekleri:
- Google'ın Cloud Vision API'si, görüntü tanıma modellerinin manipüle edilmiş girdilere karşı dayanıklılığını artırmak için hasmane eğitim kullanır
- OpenAI'ın modelleri, metin tabanlı saldırılara karşı dayanıklılığı artırmak için eğitim sürecine hasmane örnekler dahil eder.
Savunmacı damıtma (defensive distillation)
LLM distillation, saldırganların manipüle etmesini zorlaştırma amacıyla ikincil bir modelin, orijinal modelin davranışını taklit edecek şekilde eğitilmesini içerir.
- Nasıl çalışır: Önce birinci modeli eğitin, ardından karar verme sürecini yumuşatacak şekilde çıktısını kullanarak başka bir modeli eğitin.
- Neden faydalı: Saldırganların zayıflıkları sömürmesini zorlaştırır.
- Dezavantaj: Özellikle büyük modellerde çok fazla bilgi işlem gücü gerektirebilir.
- Gerçek dünya örnekleri:
- California, Berkeley Üniversitesi'ndeki araştırmacılar, otonom araçlarda kullanılan derin sinir ağlarının dayanıklılığını artırmak için savunmacı damıtmayı uyguladı.
- IBM'in Watson AI platformu, doğal dil işleme modellerini hasmane saldırılardan korumak için savunmacı damıtma tekniklerinden yararlanır.
Girdi doğrulama ve temizleme
Bir yapay zeka sistemine giren verilerin temiz ve güvenli olmasını sağlamak, onu kötü niyetli girdilere karşı korumanın anahtarıdır.
- Nasıl çalışır: Girdilerin doğru formatta olduğunu, beklenen aralıklara düştüğünü ve zararlı unsurlar içermediğini kontrol edin.
- Neden faydalı: Veri zehirleme gibi saldırıları önler ve yapay zeka sisteminin sorunsuz çalışmasını sağlar.
- En iyi uygulama: Verileri birden çok aşamada doğrulayın—kullanıcı tarafında, sunucu tarafında ve yapay zeka sisteminin içinde.
- Gerçek dünya örnekleri:
- Microsoft'un Azure AI hizmetleri, makine öğrenmesi modellerine yönelik SQL enjeksiyonu saldırılarını önlemek için katı girdi doğrulaması uygular.
- Amazon'un Rekognition yüz tanıma sistemi, potansiyel olarak zararlı görüntü girdilerini filtrelemek için girdi temizleme kullanır.
Topluluk (ensemble) yöntemleri
Birden fazla yapay zeka modelini birlikte kullanmak (ensemble), sistemleri daha güvenli hale getirebilir. Bir model saldırıya uğrasa bile diğerleri yedek sağlayabilir.
- Nasıl çalışır: Karar vermek için birden fazla modelin tahminlerini birleştirir.
- Neden faydalı: Saldırganların tüm modelleri aynı anda tehlikeye atması daha zordur.
- Dezavantaj: Birden çok modeli yönetmek için daha fazla hesaplama kaynağı gerektirir.
- Gerçek dünya örnekleri:
- Netflix'in öneri sistemi, doğruluğu artırmak ve manipülasyon girişimlerine karşı dayanıklılığı güçlendirmek için birden çok yapay zeka modelinden oluşan bir topluluk kullanır.
- Topluluk yöntemleri yalnızca yapay zekada güvenlikle sınırlı değildir; genel olarak daha sağlam ve doğru kestirimci modeller oluşturmak için de kullanılır.
Açıklanabilir Yapay Zeka (XAI)
Yapay zeka sistemlerini açıklanabilir kılmak, nasıl çalıştıklarını anlamaya ve zafiyetleri ya da olağan dışı davranışları tespit etmeye yardımcı olur. Bu konuyu daha detaylı incelemek için Explainable AI in Python kursuna göz atabilirsiniz.
- Nasıl çalışır: LIME, SHAP veya dikkat mekanizmaları gibi araçları kullanarak yapay zekanın kararlarını açıklayın.
- Neden faydalı: Yapay zeka sistemlerine olan güveni artırır ve önyargılar gibi sorunları tespit edip düzeltmeyi kolaylaştırır.
- Zorluk: Daha basit, açıklanabilir modeller karmaşık olanlar kadar güçlü olmayabilir.
- Gerçek dünya örneği:
- DARPA'nın Explainable AI (XAI) programı, askeri uygulamalar için daha şeffaf yapay zeka sistemleri geliştirmeyi amaçlar.
- IBM'in AI Explainability 360 araç seti, farklı sektörlerde açıklanabilir yapay zeka tekniklerini uygulamak için açık kaynaklı kaynaklar sunar.
Düzenli güvenlik denetimleri
Yapay zeka sistemlerini düzenli olarak zayıflıklara karşı kontrol etmek, sorunları erken yakalamaya ve zaman içinde güvenli kalmalarını sağlamaya yardımcı olur.
- Neleri kapsar: Zafiyet değerlendirmeleri, sızma testleri ve kod incelemeleri gerçekleştirin.
- Ne sıklıkta: Denetimleri düzenli olarak ve sistemde önemli değişikliklerden sonra yapın.
- Neden faydalı: Potansiyel güvenlik açıklarını belirler ve mevzuata uyumu sağlar.
- Gerçek dünya örnekleri:
- Facebook, potansiyel zafiyetleri belirlemek ve ele almak için yapay zeka destekli içerik denetim sistemlerine düzenli güvenlik denetimleri uygular.
- Avrupa Birliği Yapay Zeka Yasası, kritik sektörlerde kullanılan yüksek riskli yapay zeka sistemleri için zorunlu güvenlik denetimleri önerir.
Bu stratejileri kullanmak, yapay zeka sistemlerini daha güvenli ve saldırılara karşı daha korunaklı hale getirebilir. Ancak şu bir gerçek—yapay zeka güvenliği “kur ve unut” türünden değildir. Süreklilik gerektirir.
Yeni tehditler ortaya çıktıkça—bana güvenin, her zaman çıkarlar—işletmeler tetikte olmalı. Bu da açıkları sürekli izlemek, sistemleri güncellemek ve savunmaları iyileştirmek anlamına gelir.
|
Yöntem
|
Nasıl Çalışır
|
Neden Faydalı
|
Dezavantajlar
|
|
Hasmane Eğitim
|
Manipüle edilmiş veri örnekleri oluşturup yapay zekanın eğitimine dahil edin.
|
Sistemi kandırmaya çalışan hasmane saldırılara karşı dayanıklılığı artırır.
|
Yapay zekanın normal (temiz) verilerdeki doğruluğunu biraz düşürebilir.
|
|
Savunmacı Damıtma
|
Orijinal modelin davranışını taklit eden ikincil bir model eğitilip karar süreci yumuşatılır.
|
Saldırganların modeldeki zayıflıkları sömürmesini zorlaştırır.
|
Özellikle büyük modellerde çok fazla bilgi işlem gücü gerektirir.
|
|
Girdi Doğrulama ve Temizleme
|
Girdilerin doğru formatta olduğunu, beklenen aralıklara düştüğünü ve zararlı unsurlar içermediğini doğrulayın.
|
Veri zehirlemeyi önler ve yapay zeka sisteminin sorunsuz çalışmasını sağlar.
|
Birden çok aşamada dikkatli uygulama gerektirir.
|
|
Topluluk Yöntemleri
|
Karar vermek için birden fazla modelin tahminlerini birleştirin.
|
Saldırganların tüm modelleri aynı anda tehlikeye atması daha zordur.
|
Birden çok modeli yönetmek ve sürdürmek daha fazla kaynak gerektirir.
|
|
Açıklanabilir Yapay Zeka (XAI)
|
LIME, SHAP veya dikkat mekanizmaları gibi araçları kullanarak yapay zekanın kararlarını açıklayın.
|
Güveni artırır ve önyargılar veya olağandışı davranışlar gibi sorunları tespit edip düzeltmeyi kolaylaştırır.
|
Daha basit, açıklanabilir modeller karmaşık olanlar kadar iyi performans göstermeyebilir.
|
|
Düzenli Güvenlik Denetimleri
|
Zayıflıkları belirlemek için zafiyet değerlendirmeleri, sızma testleri ve kod incelemeleri yapın.
|
Potansiyel güvenlik açıklarını belirler ve mevzuata uyumu sağlar.
|
Sistemin karmaşıklığına bağlı olarak kaynak yoğun olabilir.
|
Yapay Zeka Güvenliğinde Yeni Trendler
Bu bölümde, yapay zeka sistemlerini güvenli, doğru ve güvenilir tutan yeni trendlere bakıyoruz.
Yapay zeka modellerini ve veri bütünlüğünü korumak
Öncelikle, yapay zeka modellerini ve verileri korumanın neden bu kadar önemli olduğundan bahsedelim.
- Fikri mülkiyeti korumak: Bir yapay zeka modeli oluşturmak için harcanan zaman, para ve emek gücünü düşünün. Bunlar sadece algoritmalar değil; büyük yatırımlar. Onları güvence altına almak, rakiplerin bu emeği çalmasını önler.
- Rekabet avantajını sürdürmek: Birisi yapay zeka modelinize yetkisiz erişim sağlarsa, onu kopyalayıp geliştirmeye tek kuruş harcamadan aynı sonuçları elde edebilir.
- Veri gizliliği ve uyum: Yapay zeka sıklıkla hassas verileri işler—finansal bilgiler, tıbbi kayıtlar, aklınıza ne gelirse. Bu veriler ifşa olursa, ağır para cezaları ve kamuoyunda ciddi itibar kaybı söz konusu olur. Daha fazla bilgi için Introduction to Data Privacy.
- Veri zehirlemesini önlemek: Hackerlar eğitim verilerinizle oynayarak yapay zekanıza yanlış kararlar almayı “öğretebilir”—örneğin dolandırıcılığı gözden kaçırmak veya masum eylemleri tehdit olarak işaretlemek gibi.
- Model tersine çevirme (inversion) saldırılarını azaltmak: Saldırganların yalnızca yapay zekanızın çıktılarından özel müşteri ayrıntılarını çıkarabildiğini hayal edin. Pek iyi olmazdı!
- Taraflı veya etik dışı sonuçlardan kaçınmak: Tehlikeye atılmış bir model, itibarınıza zarar verebilecek adaletsiz hatta zararlı kararlara yol açabilir.
- Kritik altyapıyı korumak: Yapay zeka sağlık, finans ve hatta ulusal güvenlikte kullanıldıkça, onun korunması sadece bir iş meselesi değil—kamusal güvenlik meselesidir.
Peki yapay zekanızı nasıl gerçekten güvende tutabilirsiniz? İşte bazı temel stratejiler:
- Hassas bilgileri korumak için veri şifreleme ve anonimleştirme kullanın.
- Bilgilerin ne kadar süre saklanacağını kontrol etmek için katı veri saklama politikaları uygulayın.
- Açıkları erken yakalamak için düzenli güvenlik denetimleri ve izleme yapın.
- Sistemleri her adımda güvenliği gözeterek, tasarımdan itibaren gizlilik ilkeleriyle tasarlayın.
- Modeli ve verilerini hassas bilgileri taşımadan korumak için federated learning gibi gelişmiş teknikler kullanın.
Bunu gerçek bir senaryoyla somutlaştıralım. Sahtekarlık işlemlerini tespit etmek için bir yapay zeka modeli geliştiren büyük bir uluslararası bankayı hayal edin. Bu sistem, şüpheli kalıpları tespit edip dolandırıcılığı işaretlemek için günde milyonlarca işlemi işler.
Banka bu sistemi geliştirmek için 50 milyon dolar ve üç yıl harcadı. Çalınırsa, rakipler tek kuruş yatırım yapmadan onu kullanabilir; bu da bankanın üstünlüğüne mal olur.
Bu model milyonlarca müşterinin hassas finansal verilerini işler. Bir ihlal, bu bilgilerin ifşa olmasına ve GDPR gibi yasalara göre büyük cezalara yol açabilir.
Hackerlar eğitim sırasında sahte veri enjekte ederse, yapay zekaya belirli dolandırıcılık kalıplarını kaçırmayı “öğretebilir” ve bankayı savunmasız bırakabilir.
Gelişmiş saldırganlar, modelin çıktılarından özel müşteri ayrıntılarını bile çekebilir.
Banka bunu nasıl korur?
- Verileri güvence altına almak için uçtan uca şifreleme kullanırlar.
- Modele erişim çok faktörlü kimlik doğrulama gerektirir ve role dayalı kontroller ile sınırlandırılır.
- Zayıflıkları bulmak için düzenli denetimler ve sızma testleri yürütürler.
- Eğitimde kullanılan müşteri verileri tamamen anonimleştirilir.
- Olağandışı bir şeyi yakalamak için modelin performansı sürekli izlenir.
Sonuç, müşteri verilerini güvende tutan ve dolandırıcılığı etkin şekilde tespit etme vaadini yerine getiren daha güvenli ve güvenilir bir yapay zeka sistemidir. Hem banka hem de müşterileri için kazan-kazan.
Kaçınma (evasion) ve zehirleme saldırılarına karşı savunma
Her şeyi güvende tutmak için yüz tanıma kullanan yüksek güvenlikli bir tesis işlettiğinizi hayal edin. Ancak, yapay zeka sistemlerinin hasmane girdiler veya zehirlenmiş eğitim verileri gibi saldırılara karşı savunmasız olduğunu öğrendik. Hackerlar sistemi kendilerini içeri almak için manipüle edebilir.
Saldırganları durdurabilecek dört temel savunmayı parçalarına ayıralım:
- Hasmane eğitim: Bu, modelinize bazı öz savunma hareketleri öğretmeye benzer. Yapay zekayı kandırmak için tasarlanmış ince ayarlı girdileri—pikselleri kusursuzca oynanmış görüntüler gibi—içeren örnekler ekleyip bunları tanımayı öğretirsiniz. Yüz tanıma sistemi, yalnızca yüzünüzü değil, saldırganların gizlice eklemeye çalıştığı o pürüzsüz değişiklikleri de fark eder. Yapay zekanız, gerçek hayatta aldatılmamak için bu örneklerden öğrenerek bu saldırılara karşı daha akıllı hale gelir.
- Topluluk yöntemleri: Bunu daha önce konuştuk. Tek bir sisteme güvenmek yerine bir model ekibi kullanırsınız. Her model girdiyi bağımsız işler ve sonuçları oylama mekanizmasıyla birleştirilir. Saldırganlar yalnızca bir modeli kandıramaz—tüm ekibi aldatmaları gerekir. Buna da kolay gelsin.
- Düzenli veri kontrolleri: Kimse temizlikten hoşlanmaz ama bu, yapay zekanız için şarttır. Haftalık denetimler, eğitim verilerinizin yinelenen, yanlış etiketlenmiş ya da sinsi kötü amaçlı girdilerden arınmış olmasını sağlar. Doğrulanmış görüntülerle veri setini güncel tutmak da sisteminizi dinç tutar.
- Girdi doğrulama: Bir görüntü yapay zekanıza yaklaşmadan önce bir güvenlik kontrol noktasından geçer. Şunlar olur:
- Format ve boyut kontrol edilir.
- Metadata, kurcalama işaretleri açısından analiz edilir.
- Bilinen hasmane kalıplar işaretlenir.
- Anomali tespiti olağandışı olanı yakalamak için devrededir.
Sistem yalnızca akıllı değil; temkinli. Her girdi, ilerlemeden önce meşru olduğunu kanıtlamak zorunda.
Yapay zeka tedarik zincirlerinin güvence altına alınması
Yapay zekayı güvenceye almak, veri bütünlüğünü yönetmek, mülkiyete tabi modelleri korumak ve her şeyin mevcut siber güvenlik yapınızla uyumlu çalışmasını sağlamaktır. Buna evrilen tehditler, mevzuata uyum, etik ve tedarik zinciri zafiyetlerini ele alma ihtiyacı da eklenir. Yapay zeka yaşam döngüsünü güvence altına almak için bazı stratejiler:
- Kaynaklarınızı izleyin: Yapay zeka sisteminizdeki her veri parçasının ve her modelin net bir köken hikayesi olmalıdır. Nereden geldiğini belgeleyin; ister güvenilir bir hastane, ister bir araştırma kurumu, ister uzman bir tedarikçi olsun. Neden? Çünkü kaynağı bilmek, ona güvenebilmenin ilk adımıdır.
- Tedarikçilerinizi denetleyin: Üçüncü taraf sağlayıcılar kritiktir, ancak aynı zamanda potansiyel zayıf halkalardır. HIPAA uyumu, veri anonimleştirme protokolleri veya ISO sertifikaları gibi güvenlik standartlarınızı karşıladıklarından emin olmak için düzenli denetimler yapın.
- Veri izleme araçları kullanın: Veriniz statik değildir. Zamanla evrilir ve bazen bu evrim hataları veya kötü niyetli değişiklikleri içerir. Otomatik veri izleme gibi araçlar, değişiklikleri takip edebilir ve beklenmeyen kaymaları işaretleyerek veri setlerinizi temiz ve doğru tutar.
- Veri hatlarını izleyin: Veri, kaynaktan modele karmaşık boru hatlarıyla akar ve yoldaki herhangi bir aksama sorun yaratabilir. Gerçek zamanlı panolar, veri hacminde ani düşüşler veya beklenmedik özellik değişimleri gibi düzensizlikleri yakalamanıza yardımcı olabilir.
Gerçek bir örnek: Yapay zeka destekli bir tanı aracı geliştiren bir sağlık şirketini ele alalım. Tedarik zincirleri şunları içerir:
- Paydaş hastanelerden hasta verileri.
- Üst düzey bir araştırma kurumundan tıbbi görüntüleme veri setleri.
- Uzman bir yapay zeka tedarikçisinden önceden eğitilmiş modeller.
Bu hattı nasıl güvenceye alırlar?
- Kaynak takibi: Her veri seti ve model, izlenebilirliği sağlamak için titizlikle belgelenir.
- Tedarikçi denetimleri: HIPAA uyumu için üç ayda bir kontroller yaparlar ve veri anonimleştirmeyi sağlarlar. Tedarikçilere sertifikaları sürdürmek için yıllık güvenlik değerlendirmeleri uygulanır.
- Veri soy ağacı (lineage) araçları: Hasta demografisi veya görüntüleme verilerindeki beklenmedik kaymaları tespit etmek için Anomalo gibi araçlar kullanırlar.
- Boru hattı izleme: Looker'daki gerçek zamanlı panolar veri akışını takip eder ve herhangi bir düzensizliği anında işaretler.
Bu şekilde, tanı aracının doğru, güvenilir ve endüstri standartlarına uygun olmasını sağlayan güvenli bir yapay zeka tedarik zincirine sahip olurlar.
Etik risklerin ele alınması
Yapay zeka güçlüdür, ancak yanlış ellerde bu güç tehlikeli olabilir. Bir yapay zeka sistemi hacklenir veya kötü tasarlanırsa, taraflı kararlara, etik dışı sonuçlara veya hatta kötüye kullanıma yol açabilir. Bu büyük bir meseledir; özellikle de yapay zeka işe alım, kredi veya sağlık gibi gerçek hayatları etkileyen kararlar alırken.
Peki, yapay zeka sistemlerini nasıl daha etik ve dayanıklı hale getiririz? Bunu dört temel adıma bölelim:
- Açık kurallar ve çerçeveler geliştirin: Sağlam bir temel oluşturarak başlayın. Bu, sisteminiz için adaletin ve etiğin nasıl göründüğünü tanımlayan politikalar hazırlamak anlamına gelir.
- Yapay zeka ekiplerini etik konusunda eğitin: Yapay zekadan etik davranmasını bekleyemezsiniz; onu geliştiren insanlar bu konularda eleştirel düşünmeye hazır değilse. Etik eğitimi, ekiplerin bilinçdışı önyargıları tanıyıp ele almasına, adaleti anlamasına ve çalışmalarının toplumsal etkisiyle yüzleşmesine yardımcı olur.
- Yapay zeka kararlarını şeffaf kılın: Şeffaflık, hangi faktörlerin dikkate alındığı, adayların nasıl karşılaştırıldığı ve potansiyel endişelerin nerede bulunduğu gibi kararları açıklayabilen sistemler tasarlamak demektir. Şeffaflık güven ve hesap verebilirlik sağlar.
- Yapay zeka sistemlerini düzenli olarak güncelleyin: Yapay zeka “kur ve unut” değildir. Düzenli denetimler, önyargıları tespit edip azaltmaya, adaleti sağlamaya ve sistemi en güncel endüstri standartları ve yasal gerekliliklerle uyumlu tutmaya yardımcı olur. Adalet statik değildir; sürekli bir süreçtir.
Gerçek bir örnek: Yapay zeka destekli bir işe alım sistemi kullanan büyük bir teknoloji şirketinden bahsedelim. Bunu etik tutmak için ne yaparlar?
- Açık kurallar geliştirmek: Veri toplamadan karar vermeye kadar her şeyi kapsayan tarafsız işe alım ilkelerini belirleyen bir Yapay Zeka Etik Politikası oluştururlar. Bir Yapay Zeka Etik Kurulu, hesap verebilirliği sağlamak için bu politikaları denetler.
- Ekipleri eğitmek: Sistemde çalışan tüm çalışanlar için etik eğitimi zorunlu hale getirilir. Bilinçdışı önyargı ve makine öğrenmesinde adalet üzerine dersler alır ve gerçek dünya ikilemleriyle başa çıkan atölyelere katılırlar.
- Şeffaflık: İşe alım sistemi, açıklanabilirlik araçları içerir. Her tavsiye için, kararı etkileyen faktörlerin dökümünü sunar—örneğin temel nitelikler veya bir adayın diğerleriyle nasıl karşılaştırıldığı. Bu, İK yöneticilerinin kararları gözden geçirmesini kolaylaştırır.
- Düzenli güncellemeler: Üç ayda bir yapılan denetimler, işe alım kararlarını önyargı açısından analiz eder ve adaleti sürekli iyileştirmek için hasmane önyargı giderme gibi teknikleri uygular. Ayrıca sistem, en güncel eşit istihdam yasaları ve sektörün en iyi uygulamalarıyla güncellenir.
Bu, potansiyel tehlikelere rağmen etik, adil ve şeffaf bir işe alım sistemidir.
Açıklanabilirlik ve güven zorlukları
Yapay zeka sistemleri sıklıkla “kara kutu” olarak görülür; yani karar alma süreçlerini anlamak kolay değildir. Bu da sorunları tespit etmeyi veya güven inşa etmeyi zorlaştırabilir. Bir doktora olarak bir yapay zeka aracına güveniyorsanız ya da kararından etkilenen bir hastaysanız, soru işareti değil, yanıt istersiniz. Çözüm açıklanabilirliktir. Yapay zeka sistemlerini daha şeffaf ve güvenilir kılmak için dört strateji:
- Açıklanabilir yapay zeka (XAI) araçları kullanın: Bu araçlar, yapay zekanın sonuçlarına nasıl ulaştığını anlaşılır kılar. Örneğin LIME veya SHAP gibi teknikler, belirli bir kararı hangi faktörlerin etkilediğini gösterebilir ve böylece sistemin mantığını daha erişilebilir kılar.
- Veri değişikliklerini takip edip belgeleyin: Her değişikliği—hangi verinin eklendiği, çıkarıldığı veya değiştirildiği gibi—belgelediğinizde, bu güncellemelerin model performansını nasıl etkilediğini izleyebilirsiniz.
- Doğruluğu düzenli olarak doğrulayın: Yapay zekayı olduğu gibi kabul etmeyin. Çıktılarını orijinal verilerle karşılaştırın ve mümkün olduğunda uzman görüşü alın. Düzenli denetimler, sistemin keskin ve tarafsız kalmasını sağlar. Güvenin ama doğrulayın.
- Sürekli test edin ve izleyin: Yapay zeka “kur ve unut” bir araç değildir. Çeşitli girdilerle sık test etmek hataları erken yakalamaya yardımcı olur ve gerçek zamanlı izleme, sistemin farklı senaryolarda tutarlı performans göstermesini sağlar.
Bir hastanenin, olası cilt rahatsızlıklarını belirlemek için görüntü tanımadan yararlanan bir dermatoloji tanı aracına nasıl güven oluşturduğuna bakalım.
- XAI araçları: Hastane, LIME kullanır; bu araç, cilt görüntüsünün hangi bölümlerinin yapay zekanın teşhisinde en etkili olduğunu vurgular; böylece hekimler yapay zekanın mantığını anlayıp güvenebilir.
- Veri değişikliklerini takip etmek: Bir data lineage aracı, eğitim veri setine yapılan tüm güncellemeleri—yeni eklenen veya çıkarılan görüntüler gibi—kayda geçirir. Bu, hastanenin bu değişikliklerin zaman içindeki doğruluğa etkisini izleyebilmesini sağlar.
- Doğruluğun doğrulanması: Ayda bir, dermatologlar rastgele seçilen yapay zeka teşhislerini, orijinal hasta verileri ve kendi uzman görüşleriyle karşılaştırarak inceler. Amaç, sistemin yüksek doğruluk ve adalet standartlarını korumasını sağlamaktır.
- Düzenli test ve izleme: BT ekibi, farklı cilt tipleri ve durumlarını kapsayan çeşitli görüntülerle haftalık testler yapar ve gerçek zamanlı olarak olağan dışı kalıpları izler; böylece sorunlar büyümeden önce giderilir.
Bu yapay zeka aracı yalnızca akıllı değil; aynı zamanda açıklanabilir ve güvenilir. Hekimler kararlarını anlar, hastalar aldıkları bakıma güven duyar ve hastane teknolojinin adil ve doğru çalışmasını sağlar.
Sonuç
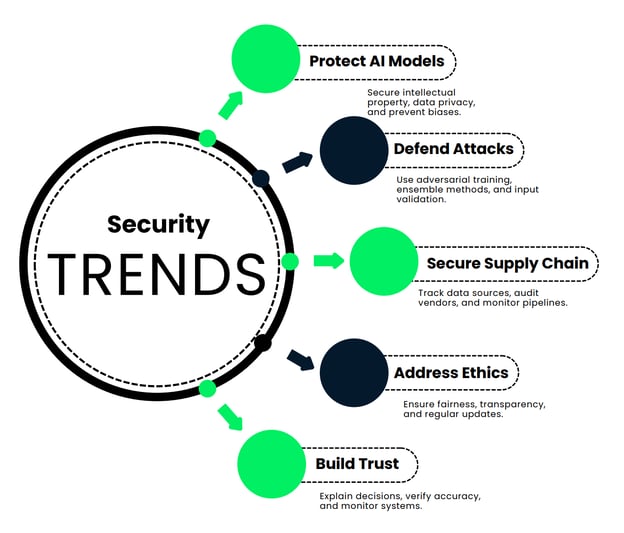
Yapay zeka hayatımızın daha büyük bir parçası haline geldikçe, onu güvende tutmak her zamankinden daha kritik. Neden? Çünkü yapay zekanın yeteneklerini besleyen aynı güç, onu saldırılar için bir hedef de yapıyor. Hasmane saldırılar, veri zehirleme ve model hırsızlığı gibi tehditler, yapay zekanın işleyişini ciddi biçimde bozabilir.
Peki yapay zekayı nasıl savunuruz? Bunun tek boyutlu bir çözümü olmadığını gördük. Hasmane eğitim, düzenli denetimler ve katmanlı korumalar gibi teknikler, riskleri azaltabilir ve sistemlerinizi daha dayanıklı hale getirebilir.
Bir de üretken yapay zeka var. Büyük dil modelleri inanılmaz fırsatlar sunar, ancak yeni zafiyetler de getirir. Yanıltıcı içerik üretmekten zararlı çıktılar vermeye zorlanmaya kadar, bu araçlar dikkatli gözetim gerektirir. How to Build Guardrails for Large Language Models makalesinde, LLM'lerin olması gerektiği gibi davranmasını sağlamak için güvenlik önlemleri ele alınıyor.
Etik ve şeffaflık vazgeçilmezdir. Yapay zeka sistemlerinin adil, açıklanabilir ve güvenilir olması gerekir. Önyargılar ve kötüye kullanım güveni aşındırır—ve günümüz teknoloji odaklı dünyasında güven her şeydir. İnsanlar güvenmedikleri şeyi kullanmaz.
Son olarak, önden gitmek şart. Yapay zeka tehditleri sürekli evriliyor. İşletmelerin, korunmak için güvenlik stratejilerini düzenli olarak güncelleyip yeni risklere ayak uydurması gerekir.Asıl olan proaktif, tetikte ve etik ile şeffaflığa bağlı olmaktır; bu sayede işletmeler güven inşa eder ve yapay zekanın faydalarından en iyi şekilde yararlanır.



 Abid Ali Awan · 14 min

 Dario Radečić · 15 min

 Kurtis Pykes · 8 min


Yapay zeka o kadar hızlı gelişiyor ki, güvenlik sorunlarına ayak uydurmak, uçuştayken uçağı tamir etmeye çalışmak gibi hissettiriyor. Sistemler daha akıllı hale geldikçe ve günlük iş süreçlerine daha derinlemesine entegre oldukça, yeni tür tehditlere karşı daha savunmasız oluyorlar.
Bunu işimde yakından gördüm. Özellikle yapay zeka çözümlerinin uygun güvenlik önlemleri olmadan aceleyle uygulandığı durumlarda, birinin erişmemesi gereken hassas bilgilere erişmesine olanak tanıyabilecek iş süreçlerindeki güvenlik açıklarını defalarca keşfettim.
Bu makale de bununla ilgili: Yapay zekayı güvende tutmak için riskleri, zorlukları ve en iyi uygulamaları anlamak. Yapay zeka çok hızlı büyüyor ve açıkların önünde gitmezsek, onun getirdiği güveni ve faydaları kaybetme riskiyle karşı karşıya kalırız.
Bu konuyu daha detaylı öğrenmek isterseniz AI Security and Risk Management kursuna göz atmanızı öneririm.
Yeni Yapay Zeka Güvenlik Zorlukları
Yapay zeka verilerle çalışır. Yapay zekanız ne kadar çok veriye dayanıyorsa, hedef de o kadar büyüktür. Hackerlar bunun farkında. Bir hastanenin hastaların sağlık risklerini tahmin etmek için yapay zekayı kullandığını hayal edin. Kulağa harika geliyor, ta ki biri sistemi hackleyene kadar. Bir anda özel hasta kayıtları dark web'de ortaya çıkabilir ya da daha kötüsü, tıbbi veriler değiştirilerek zararlı kararlara yol açabilir. Hassas verilerin şifrelenmesi ve yedeklerin olması kritik önemdedir, ancak birçok şirket inovasyona o kadar odaklanıyor ki bu temel unsurları gözden kaçırıyor.
Üstelik hackerlar sadece veri çalmıyor. Doğrudan yapay zeka modelleriyle de oynayabiliyorlar. Örneğin, otonom bir aracın bir dur işaretini hız sınırı tabelası sanacak şekilde kandırılması. Bu tür bir saldırı, hackerların sisteme kötü veri vererek karar alma süreçlerini bozduğu veri zehirleme saldırısı olarak adlandırılır. Bunu bir sonraki bölümde daha detaylı inceleyeceğiz.
İstem enjeksiyonu saldırıları da başka bir saldırı türüdür. Bunlar, bir yapay zekayı söylememesi—ya da yapmaması—gereken bir şeye yönlendiren ince manipülasyonlardır. Prompt injection hakkında harika bir makalemiz var; bu yazıda çok detaya girmeyeceğiz ama kesinlikle okunmaya değer.
İronik bir şekilde, hackerlar hacklemek için de yapay zekadan yararlanıyor. İşte burada siber güvenlik zamana karşı bir yarışa dönüşüyor—hackerlar yenilik yapıyor, güvenlik ekipleri de aynı hızda karşılık vermek zorunda kalıyor. Anomali tespiti gibi araçlar yardımcı olabilir, ancak kusursuz değiller.
“Bir zincir en zayıf halkası kadar güçlüdür” sözünü hiç duydunuz mu? Yapay zeka için de tamamen geçerli. Şirketler genellikle hazır yapay zeka araçlarını sistemlerine entegre eder. Peki bu araçlardan biri ele geçirilirse ne olur? Yüzlerce işletme tarafından kullanılan popüler bir sohbet botunun hacklendiğini düşünün. Bu, yüzlerce şirketin—ve tüm müşteri verilerinin—riske girmesi demektir. Dijital bir domino etkisi.
Son olarak, uzmanlık açığı var. Yapay zeka benimsenmesi artıyor, ancak yapay zeka için siber güvenlik hâlâ geriden geliyor.
Yapay Zeka Güvenliği Tehditleri
Yapay zeka sistemleri, performanslarını ve güvenilirliklerini tehlikeye atabilecek ciddi güvenlik tehditleriyle karşı karşıya. Başlıca tehditlere bakalım.
Hasmane (adversarial) saldırılar
Hasmane saldırılar, yapay zekayı kandırmak için yapay zekanın işlediği girdilerde küçük ve sinsi değişiklikler yapar. Bu değişiklikler o kadar incedir ki insanlar genellikle fark etmez, fakat yapay zekayı tamamen yanıltarak yanlış karar vermesine yol açabilir.
Örneğin:
Bu saldırılar, saldırganın yapay zekanın iç işleyişini bilmesini gerektirmez; bu da onları tespit etmeyi ve durdurmayı çok zor hale getirir.
Şimdi gerçek dünya örneklerine bakalım.
Bu diyagram, tıbbi görüntüleme yapan bir yapay zeka sistemine yönelik hasmane bir saldırıyı göstermektedir. Orijinal röntgen, "Akciğer Kanseri Yüksek Risk" olarak doğru sınıflandırılmışken, hasmane gürültü ile ince şekilde değiştirilmiş ve "Sağlıklı Akciğerler" olarak yanlış sınıflandırılmıştır.
Okumaya değer bir konu da Hasmane Makine Öğrenimidur; bu alan, makine öğrenmesi modellerindeki zafiyetleri sömüren saldırıları inceler ve bu tehditlere karşı savunmalar geliştirir.
Zehirleme (poisoning) saldırıları
Zehirleme saldırıları, modelin nasıl karar vereceğini öğrendiği eğitim aşamasını hedef alır. Saldırganlar, yapay zekayı hatalı davranmaya ya da taraflı sonuçları tercih etmeye yönlendirmek için eğitim setine bozulmuş veya yanıltıcı veriler sızdırır. Bu saldırılar, yapay zekanın öğrenme sürecinin temeliyle oynadıkları ve genellikle bir şeylerin ters gittiğine dair bariz izler bırakmadıkları için etkilidir.
Bu şunları içerebilir:
Bu ince değişiklikler, yapay zekanın belirli koşullarda başarısız olmasına ya da saldırgana fayda sağlayacak şekillerde davranmasına neden olabilir. Saldırı eğitim sırasında gerçekleştiği için, model dağıtıma alındıktan sonra tespit etmek zordur.
Bazı gerçek dünya örneklerine bakalım:
Bu diyagram, sahte ve gerçek sigorta taleplerini sınıflandıran bir yapay zeka sistemine yönelik zehirleme saldırısını göstermektedir. İlk panelde, sistem temiz bir eğitim veri seti kullanarak sahte (kırmızı) ve gerçek (siyah) talepleri doğru şekilde ayırır. İkinci panelde, kötü niyetle yanlış etiketlenmiş veriler (“zehir”), karar sınırını kaydırarak sahte taleplerin gerçek olarak yanlış sınıflandırılmasına yol açar; bu da sistemin güvenilirliğini ve güvenliğini zedeler.
Model çıkarımı (extraction) saldırıları
Model çıkarımı saldırısında, bir saldırgan bir yapay zeka modelinin nasıl çalıştığını tersine mühendislikle çözer. Topladığı giriş ve çıkışları kullanarak sistemin tasarımını ve davranışını kopyalar.
Bir kopya model oluşturduktan sonra şunları yapabilir:
Örneğin, çalınan model özel müşteri verileriyle eğitildiyse, saldırgan bu müşteriler hakkında kişisel ayrıntıları tahmin edebilir veya kendi kullanımına uygun özelleştirilmiş bir sürüm oluşturabilir.
Bazı gerçek dünya örneklerine bakalım:
Bu diyagram, bir saldırganın sorgular gönderip tahminlerini toplayarak kurban yapay zeka modeliyle etkileşime geçtiği model çıkarımı saldırısını göstermektedir. Saldırgan, topladığı verileri bir kopya modeli eğitmek için kullanır ve sonunda orijinal sistemin çalınmış bir sürümünü yeniden oluşturur.
Yapay Zeka Güvenliği Savunmaları
Önceki bölümlerde belirttiğimiz gibi, yapay zeka yaygınlaştıkça saldırılara karşı koruma sağlamak için güçlü güvenlik önlemleri almak önemli hale geliyor. Yapay zekayı daha güvenli kılmanın etkili yollarından bahsedelim.
Hasmane eğitim
Bu yöntem, modellere hileli, manipüle edilmiş girdileri (hasmane örnekler) tanımayı ve bunlarla başa çıkmayı öğretir. Modelinizi bu örneklerle eğittiğinizde, belirli saldırı türlerine karşı daha dirençli hale gelir.
Savunmacı damıtma (defensive distillation)
LLM distillation, saldırganların manipüle etmesini zorlaştırma amacıyla ikincil bir modelin, orijinal modelin davranışını taklit edecek şekilde eğitilmesini içerir.
Girdi doğrulama ve temizleme
Bir yapay zeka sistemine giren verilerin temiz ve güvenli olmasını sağlamak, onu kötü niyetli girdilere karşı korumanın anahtarıdır.
Topluluk (ensemble) yöntemleri
Birden fazla yapay zeka modelini birlikte kullanmak (ensemble), sistemleri daha güvenli hale getirebilir. Bir model saldırıya uğrasa bile diğerleri yedek sağlayabilir.
Açıklanabilir Yapay Zeka (XAI)
Yapay zeka sistemlerini açıklanabilir kılmak, nasıl çalıştıklarını anlamaya ve zafiyetleri ya da olağan dışı davranışları tespit etmeye yardımcı olur. Bu konuyu daha detaylı incelemek için Explainable AI in Python kursuna göz atabilirsiniz.
Düzenli güvenlik denetimleri
Yapay zeka sistemlerini düzenli olarak zayıflıklara karşı kontrol etmek, sorunları erken yakalamaya ve zaman içinde güvenli kalmalarını sağlamaya yardımcı olur.
Bu stratejileri kullanmak, yapay zeka sistemlerini daha güvenli ve saldırılara karşı daha korunaklı hale getirebilir. Ancak şu bir gerçek—yapay zeka güvenliği “kur ve unut” türünden değildir. Süreklilik gerektirir.
Yeni tehditler ortaya çıktıkça—bana güvenin, her zaman çıkarlar—işletmeler tetikte olmalı. Bu da açıkları sürekli izlemek, sistemleri güncellemek ve savunmaları iyileştirmek anlamına gelir.
Yöntem
Nasıl Çalışır
Neden Faydalı
Dezavantajlar
Hasmane Eğitim
Manipüle edilmiş veri örnekleri oluşturup yapay zekanın eğitimine dahil edin.
Sistemi kandırmaya çalışan hasmane saldırılara karşı dayanıklılığı artırır.
Yapay zekanın normal (temiz) verilerdeki doğruluğunu biraz düşürebilir.
Savunmacı Damıtma
Orijinal modelin davranışını taklit eden ikincil bir model eğitilip karar süreci yumuşatılır.
Saldırganların modeldeki zayıflıkları sömürmesini zorlaştırır.
Özellikle büyük modellerde çok fazla bilgi işlem gücü gerektirir.
Girdi Doğrulama ve Temizleme
Girdilerin doğru formatta olduğunu, beklenen aralıklara düştüğünü ve zararlı unsurlar içermediğini doğrulayın.
Veri zehirlemeyi önler ve yapay zeka sisteminin sorunsuz çalışmasını sağlar.
Birden çok aşamada dikkatli uygulama gerektirir.
Topluluk Yöntemleri
Karar vermek için birden fazla modelin tahminlerini birleştirin.
Saldırganların tüm modelleri aynı anda tehlikeye atması daha zordur.
Birden çok modeli yönetmek ve sürdürmek daha fazla kaynak gerektirir.
Açıklanabilir Yapay Zeka (XAI)
LIME, SHAP veya dikkat mekanizmaları gibi araçları kullanarak yapay zekanın kararlarını açıklayın.
Güveni artırır ve önyargılar veya olağandışı davranışlar gibi sorunları tespit edip düzeltmeyi kolaylaştırır.
Daha basit, açıklanabilir modeller karmaşık olanlar kadar iyi performans göstermeyebilir.
Düzenli Güvenlik Denetimleri
Zayıflıkları belirlemek için zafiyet değerlendirmeleri, sızma testleri ve kod incelemeleri yapın.
Potansiyel güvenlik açıklarını belirler ve mevzuata uyumu sağlar.
Sistemin karmaşıklığına bağlı olarak kaynak yoğun olabilir.
Yapay Zeka Güvenliğinde Yeni Trendler
Bu bölümde, yapay zeka sistemlerini güvenli, doğru ve güvenilir tutan yeni trendlere bakıyoruz.
Yapay zeka modellerini ve veri bütünlüğünü korumak
Öncelikle, yapay zeka modellerini ve verileri korumanın neden bu kadar önemli olduğundan bahsedelim.
Peki yapay zekanızı nasıl gerçekten güvende tutabilirsiniz? İşte bazı temel stratejiler:
Bunu gerçek bir senaryoyla somutlaştıralım. Sahtekarlık işlemlerini tespit etmek için bir yapay zeka modeli geliştiren büyük bir uluslararası bankayı hayal edin. Bu sistem, şüpheli kalıpları tespit edip dolandırıcılığı işaretlemek için günde milyonlarca işlemi işler.
Banka bu sistemi geliştirmek için 50 milyon dolar ve üç yıl harcadı. Çalınırsa, rakipler tek kuruş yatırım yapmadan onu kullanabilir; bu da bankanın üstünlüğüne mal olur.
Bu model milyonlarca müşterinin hassas finansal verilerini işler. Bir ihlal, bu bilgilerin ifşa olmasına ve GDPR gibi yasalara göre büyük cezalara yol açabilir.
Hackerlar eğitim sırasında sahte veri enjekte ederse, yapay zekaya belirli dolandırıcılık kalıplarını kaçırmayı “öğretebilir” ve bankayı savunmasız bırakabilir.
Gelişmiş saldırganlar, modelin çıktılarından özel müşteri ayrıntılarını bile çekebilir.
Banka bunu nasıl korur?
Sonuç, müşteri verilerini güvende tutan ve dolandırıcılığı etkin şekilde tespit etme vaadini yerine getiren daha güvenli ve güvenilir bir yapay zeka sistemidir. Hem banka hem de müşterileri için kazan-kazan.
Kaçınma (evasion) ve zehirleme saldırılarına karşı savunma
Her şeyi güvende tutmak için yüz tanıma kullanan yüksek güvenlikli bir tesis işlettiğinizi hayal edin. Ancak, yapay zeka sistemlerinin hasmane girdiler veya zehirlenmiş eğitim verileri gibi saldırılara karşı savunmasız olduğunu öğrendik. Hackerlar sistemi kendilerini içeri almak için manipüle edebilir.
Saldırganları durdurabilecek dört temel savunmayı parçalarına ayıralım:
Sistem yalnızca akıllı değil; temkinli. Her girdi, ilerlemeden önce meşru olduğunu kanıtlamak zorunda.
Yapay zeka tedarik zincirlerinin güvence altına alınması
Yapay zekayı güvenceye almak, veri bütünlüğünü yönetmek, mülkiyete tabi modelleri korumak ve her şeyin mevcut siber güvenlik yapınızla uyumlu çalışmasını sağlamaktır. Buna evrilen tehditler, mevzuata uyum, etik ve tedarik zinciri zafiyetlerini ele alma ihtiyacı da eklenir. Yapay zeka yaşam döngüsünü güvence altına almak için bazı stratejiler:
Gerçek bir örnek: Yapay zeka destekli bir tanı aracı geliştiren bir sağlık şirketini ele alalım. Tedarik zincirleri şunları içerir:
Bu hattı nasıl güvenceye alırlar?
Bu şekilde, tanı aracının doğru, güvenilir ve endüstri standartlarına uygun olmasını sağlayan güvenli bir yapay zeka tedarik zincirine sahip olurlar.
Etik risklerin ele alınması
Yapay zeka güçlüdür, ancak yanlış ellerde bu güç tehlikeli olabilir. Bir yapay zeka sistemi hacklenir veya kötü tasarlanırsa, taraflı kararlara, etik dışı sonuçlara veya hatta kötüye kullanıma yol açabilir. Bu büyük bir meseledir; özellikle de yapay zeka işe alım, kredi veya sağlık gibi gerçek hayatları etkileyen kararlar alırken.
Peki, yapay zeka sistemlerini nasıl daha etik ve dayanıklı hale getiririz? Bunu dört temel adıma bölelim:
Gerçek bir örnek: Yapay zeka destekli bir işe alım sistemi kullanan büyük bir teknoloji şirketinden bahsedelim. Bunu etik tutmak için ne yaparlar?
Bu, potansiyel tehlikelere rağmen etik, adil ve şeffaf bir işe alım sistemidir.
Açıklanabilirlik ve güven zorlukları
Yapay zeka sistemleri sıklıkla “kara kutu” olarak görülür; yani karar alma süreçlerini anlamak kolay değildir. Bu da sorunları tespit etmeyi veya güven inşa etmeyi zorlaştırabilir. Bir doktora olarak bir yapay zeka aracına güveniyorsanız ya da kararından etkilenen bir hastaysanız, soru işareti değil, yanıt istersiniz. Çözüm açıklanabilirliktir. Yapay zeka sistemlerini daha şeffaf ve güvenilir kılmak için dört strateji:
Bir hastanenin, olası cilt rahatsızlıklarını belirlemek için görüntü tanımadan yararlanan bir dermatoloji tanı aracına nasıl güven oluşturduğuna bakalım.
Bu yapay zeka aracı yalnızca akıllı değil; aynı zamanda açıklanabilir ve güvenilir. Hekimler kararlarını anlar, hastalar aldıkları bakıma güven duyar ve hastane teknolojinin adil ve doğru çalışmasını sağlar.
Sonuç
Yapay zeka hayatımızın daha büyük bir parçası haline geldikçe, onu güvende tutmak her zamankinden daha kritik. Neden? Çünkü yapay zekanın yeteneklerini besleyen aynı güç, onu saldırılar için bir hedef de yapıyor. Hasmane saldırılar, veri zehirleme ve model hırsızlığı gibi tehditler, yapay zekanın işleyişini ciddi biçimde bozabilir.
Peki yapay zekayı nasıl savunuruz? Bunun tek boyutlu bir çözümü olmadığını gördük. Hasmane eğitim, düzenli denetimler ve katmanlı korumalar gibi teknikler, riskleri azaltabilir ve sistemlerinizi daha dayanıklı hale getirebilir.
Bir de üretken yapay zeka var. Büyük dil modelleri inanılmaz fırsatlar sunar, ancak yeni zafiyetler de getirir. Yanıltıcı içerik üretmekten zararlı çıktılar vermeye zorlanmaya kadar, bu araçlar dikkatli gözetim gerektirir. How to Build Guardrails for Large Language Models makalesinde, LLM'lerin olması gerektiği gibi davranmasını sağlamak için güvenlik önlemleri ele alınıyor.
Etik ve şeffaflık vazgeçilmezdir. Yapay zeka sistemlerinin adil, açıklanabilir ve güvenilir olması gerekir. Önyargılar ve kötüye kullanım güveni aşındırır—ve günümüz teknoloji odaklı dünyasında güven her şeydir. İnsanlar güvenmedikleri şeyi kullanmaz.
Son olarak, önden gitmek şart. Yapay zeka tehditleri sürekli evriliyor. İşletmelerin, korunmak için güvenlik stratejilerini düzenli olarak güncelleyip yeni risklere ayak uydurması gerekir.Asıl olan proaktif, tetikte ve etik ile şeffaflığa bağlı olmaktır; bu sayede işletmeler güven inşa eder ve yapay zekanın faydalarından en iyi şekilde yararlanır.