AI đang phát triển nhanh đến mức theo kịp những thách thức về bảo mật của nó giống như đang cố sửa một chiếc máy bay khi nó đang bay. Khi hệ thống trở nên thông minh hơn và được tích hợp sâu vào các quy trình kinh doanh hằng ngày, chúng cũng dễ bị tổn thương hơn trước những kiểu đe doạ mới.
Tôi đã chứng kiến điều này rất rõ trong công việc của mình. Nhiều lần tôi phát hiện ra lỗ hổng bảo mật trong quy trình kinh doanh có thể cho phép ai đó truy cập thông tin nhạy cảm mà họ không được phép, đặc biệt khi các giải pháp AI được triển khai vội vàng mà không có biện pháp bảo vệ phù hợp.
Đó là lý do có bài viết này: hiểu rủi ro, thách thức và thực hành tốt nhất để giữ an toàn cho AI. AI đang tăng trưởng quá nhanh, và nếu không đi trước các lỗ hổng, chúng ta có nguy cơ đánh mất niềm tin và lợi ích mà nó mang lại.
Nếu bạn muốn tìm hiểu sâu hơn về chủ đề này, tôi khuyến nghị xem khóa học AI Security and Risk Management.
Những thách thức bảo mật AI mới
AI vận hành dựa trên dữ liệu. Và càng phụ thuộc vào dữ liệu, mục tiêu càng lớn. Hacker biết điều đó. Hãy hình dung một bệnh viện dùng AI dự đoán rủi ro sức khỏe bệnh nhân. Nghe thật tuyệt, cho đến khi ai đó xâm nhập hệ thống. Đột nhiên, hồ sơ bệnh nhân riêng tư bị rao bán trên dark web, hoặc tệ hơn, dữ liệu y tế bị chỉnh sửa, có thể dẫn đến quyết định gây hại. Mã hóa dữ liệu nhạy cảm và có bản sao lưu là chìa khóa, nhưng nhiều công ty mải mê đổi mới đến mức bỏ qua những điều cơ bản này.
Và hacker không chỉ đánh cắp dữ liệu. Họ còn có thể can thiệp trực tiếp vào mô hình AI. Ví dụ, một xe tự lái bị đánh lừa nghĩ biển báo dừng là biển giới hạn tốc độ. Kiểu tấn công này gọi là tấn công đầu độc dữ liệu (data poisoning), trong đó hacker bơm dữ liệu xấu vào hệ thống để làm sai lệch quyết định. Chúng ta sẽ xem chi tiết hơn ở phần tiếp theo.
Tấn công tiêm lệnh (prompt injection) cũng là một kiểu tấn công khác. Đây là các thao tác tinh vi nhằm đánh lừa AI nói—hoặc làm—điều nó không nên. Chúng tôi có một bài viết tuyệt vời về prompt injection, nên chúng tôi sẽ không đi quá sâu ở đây, nhưng chắc chắn rất đáng đọc.
Trớ trêu thay, hacker cũng dùng AI để hack. Đây là lúc an ninh mạng trở thành cuộc chạy đua với thời gian—hacker đổi mới, và đội ngũ bảo mật phải phản ứng nhanh không kém. Các công cụ như phát hiện bất thường có thể giúp, nhưng không hề hoàn hảo.
Bạn từng nghe câu “Mạnh vì gạo, bạo vì tiền” hay “Mắt xích yếu làm hỏng cả dây xích” chứ? Điều này hoàn toàn đúng với AI. Các công ty thường tích hợp công cụ AI dựng sẵn vào hệ thống của họ. Nhưng nếu một trong các công cụ đó bị xâm phạm thì sao? Hãy tưởng tượng một chatbot phổ biến được hàng trăm doanh nghiệp sử dụng bị hack. Nghĩa là hàng trăm công ty—cùng toàn bộ dữ liệu khách hàng của họ—đều gặp rủi ro. Hiệu ứng đô-mi-nô kỹ thuật số.
Cuối cùng là khoảng cách về chuyên môn. Việc ứng dụng AI đang tăng, nhưng bảo mật cho AI vẫn đang chạy theo sau.
Các mối đe dọa bảo mật AI
Hệ thống AI đối mặt với những mối đe dọa nghiêm trọng có thể ảnh hưởng đến hiệu quả và độ tin cậy. Hãy điểm qua các mối đe dọa chính.
Tấn công đối kháng (Adversarial attacks)
Tấn công đối kháng đánh lừa hệ thống AI bằng cách thực hiện những thay đổi nhỏ, kín đáo vào đầu vào mà AI xử lý. Những thay đổi này tinh vi đến mức con người thường không nhận ra, nhưng có thể khiến AI hoàn toàn nhầm lẫn và đưa ra quyết định sai.
Ví dụ:
- Thay đổi một vài chi tiết rất nhỏ trong ảnh, như chỉnh chỉ vài điểm ảnh, để AI nhận diện sai.
- Thêm nhiễu rất nhẹ vào tệp âm thanh, nghe với chúng ta thì như nhau nhưng khiến AI hiểu sai.
- Chỉnh cách diễn đạt của một câu để làm rối hiểu biết của AI.
Những tấn công này không đòi hỏi kẻ tấn công phải biết AI hoạt động nội bộ ra sao, đó là một lý do nữa khiến chúng rất khó phát hiện và ngăn chặn.
Giờ hãy xem vài ví dụ thực tế.
- Thuật toán DeepFool: DeepFool là phương pháp tạo ra những thay đổi rất nhỏ, gần như vô hình trên đầu vào, như một bức ảnh, để đánh lừa AI phân loại sai. Nó hoạt động bằng cách chỉnh dần đầu vào cho đến khi AI mắc lỗi. Những thay đổi nhỏ đến mức con người không nhận ra.
- Tấn công âm thanh có mục tiêu: Trong bài báo này, kẻ tấn công tạo âm thanh gần như giống hệt bản gốc nhưng khiến hệ thống nhận dạng giọng nói nghe thành những từ hoàn toàn khác. Phương pháp này được dùng để đánh lừa hệ thống DeepSpeech của Mozilla với tỷ lệ thành công 100%.
- Can thiệp hệ thống lái tự động của Tesla: Keen Labs đã đánh lừa hệ thống autopilot của Tesla bằng cách đặt có chủ đích ba miếng dán khó nhận ra trên đường, khiến hệ thống hiểu sai vạch làn và có thể lái sang làn không đúng. Đọc thêm tại đây.
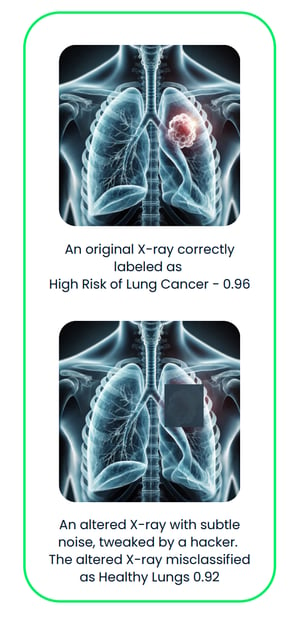
Sơ đồ này minh họa một cuộc tấn công đối kháng vào hệ thống AI chẩn đoán hình ảnh y khoa. Ảnh X-quang gốc được phân loại đúng là "Nguy cơ cao ung thư phổi" bị chỉnh nhẹ với nhiễu đối kháng, dẫn đến phân loại sai thành "Phổi khỏe mạnh".
Một bài đọc rất hay là Học máy đối kháng (Adversarial Machine Learning), một lĩnh vực nghiên cứu các cuộc tấn công khai thác lỗ hổng trong mô hình học máy và phát triển biện pháp phòng vệ để bảo vệ trước các mối đe dọa này.
Tấn công đầu độc (Poisoning attacks)
Tấn công đầu độc nhắm vào giai đoạn huấn luyện của hệ thống AI, nơi mô hình học cách ra quyết định. Kẻ tấn công lén đưa dữ liệu hỏng hoặc gây hiểu nhầm vào tập huấn luyện để thao túng AI hành xử sai hoặc thiên lệch. Những tấn công này hiệu quả vì chúng can thiệp vào nền tảng quá trình học của AI, thường không để lại dấu hiệu rõ ràng.
Điều này có thể bao gồm:
- Thay đổi nhãn của một số ví dụ huấn luyện, như gắn nhãn ảnh chó thành mèo chẳng hạn.
- Thêm các điểm dữ liệu giả được thiết kế để ảnh hưởng đến quyết định của AI theo những cách cụ thể.
Những thay đổi tinh vi này có thể khiến AI thất bại trong một số điều kiện hoặc hành xử theo cách có lợi cho kẻ tấn công. Vì cuộc tấn công diễn ra trong quá trình huấn luyện, rất khó phát hiện khi mô hình đã triển khai.
Hãy xem vài ví dụ thực tế:
- Tấn công cửa hậu (Backdoor): Một nghiên cứu có tiêu đề “Bypassing Backdoor Detection Algorithms in Deep Learning” cho thấy cách kẻ tấn công có thể ẩn “cửa hậu” độc hại trong mô hình AI. Những cửa hậu này chỉ kích hoạt trong điều kiện cụ thể, như xuất hiện một mẫu nhất định trong ảnh. Nghiên cứu chứng minh kẻ tấn công có thể dùng kỹ thuật nâng cao để làm dữ liệu đầu độc trông y như dữ liệu sạch, qua mặt phát hiện.
- Đầu độc tập dữ liệu quy mô web: Trong bài “Poisoning Web-Scale Training Datasets is Practical,” các nhà nghiên cứu mô tả cách tập dữ liệu lớn thu thập từ internet có thể bị đầu độc:
- Đầu độc dữ liệu “split-view”: Làm hỏng dữ liệu sau khi thu thập nhưng trước khi dùng để huấn luyện.
- Đầu độc dữ liệu “frontrunning”: Can thiệp dữ liệu ngay trước khi nó được thêm vào tập dữ liệu.
- Chatbot Tay của Microsoft: Năm 2016, Microsoft triển khai chatbot tên Tay trên Twitter. Người dùng nhanh chóng thao túng Tay bằng cách dồn dập nội dung phản cảm, khiến nó đăng những dòng tweet phân biệt chủng tộc và không phù hợp. Microsoft buộc phải đóng Tay ngay sau khi ra mắt. Đọc thêm tại đây.
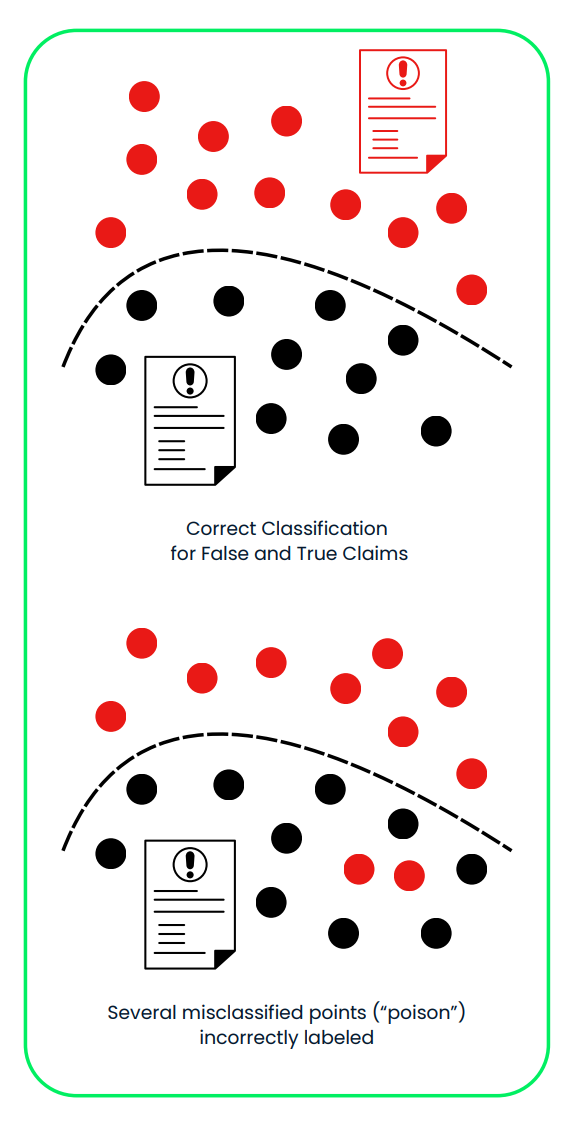
Sơ đồ này minh họa một cuộc tấn công đầu độc vào hệ thống AI dùng để phân loại hồ sơ bảo hiểm sai thật. Ở bảng đầu, hệ thống tách đúng hồ sơ sai (đỏ) và đúng (đen) bằng tập huấn luyện sạch. Ở bảng sau, dữ liệu bị gắn nhãn sai ác ý (“poison”) làm dịch chuyển ranh quyết định, dẫn đến phân loại sai hồ sơ gian lận thành đúng, làm suy giảm độ tin cậy và bảo mật của hệ thống.
Tấn công trích xuất mô hình
Trong tấn công trích xuất mô hình, kẻ tấn công tìm hiểu cách một mô hình AI hoạt động bằng cách đảo ngược nó. Họ dùng các đầu vào và đầu ra thu thập được để sao chép thiết kế và hành vi của hệ thống.
Khi đã dựng bản sao của mô hình, họ có thể:
- Dùng nó để dự đoán, có thể liên quan đến dữ liệu nhạy cảm hoặc riêng tư.
- Đánh cắp thông tin mật từ mô hình gốc.
- Chỉnh sửa và huấn luyện lại mô hình phục vụ mục đích riêng, thường là mục đích xấu.
Ví dụ, nếu mô hình bị đánh cắp được huấn luyện trên dữ liệu khách hàng riêng tư, kẻ tấn công có thể dự đoán thông tin cá nhân về những khách hàng đó hoặc tạo phiên bản mô hình tuỳ biến cho mục đích riêng.
Hãy xem một số ví dụ thực tế:
- Một công cụ tên DeepSniffer cho thấy kiểu tấn công này hoạt động thế nào. DeepSniffer không cần biết trước bất cứ điều gì về mô hình gốc. Nó thu thập manh mối từ cách mô hình xử lý dữ liệu, như theo dõi thao tác bộ nhớ khi chạy. Nó ghép các manh mối lại để suy ra cấu trúc mô hình, ngay cả khi hệ thống cố tối ưu hoặc che giấu quy trình.
- Mindgard đã chứng minh các thành phần quan trọng của mô hình ngôn ngữ hộp đen, như ChatGPT 3.5 Turbo của OpenAI, có thể bị trích xuất thông qua quy trình chi phí thấp. Chỉ với 50 đô chi phí API, nhóm đã tạo ra một mô hình nhỏ hơn—khoảng nhỏ hơn 100 lần so với bản gốc—nhưng lại vượt trội ChatGPT ở một tác vụ cụ thể. Mô hình trích xuất này sau đó được dùng để tăng cường một cuộc tấn công khác, rồi triển khai ngược lại chính ChatGPT. Cuộc tấn công cải tiến đạt tỷ lệ thành công cao hơn, tăng lên 11%.
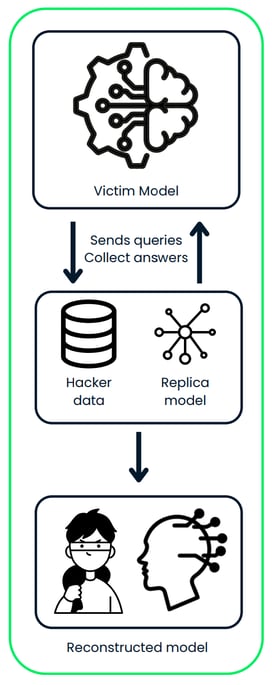
Sơ đồ này minh họa một cuộc tấn công trích xuất mô hình, trong đó kẻ tấn công tương tác với mô hình AI nạn nhân bằng cách gửi truy vấn và thu thập dự đoán. Dữ liệu thu được được dùng để huấn luyện mô hình bản sao, cuối cùng tái tạo một phiên bản bị đánh cắp của hệ thống gốc.
Phòng thủ bảo mật AI
Như đã đề cập ở các phần trước, khi AI trở nên phổ biến hơn, việc áp dụng các biện pháp bảo mật mạnh mẽ để chống lại tấn công là rất quan trọng. Hãy nói về một số cách hiệu quả để làm AI an toàn hơn.
Huấn luyện đối kháng
Phương pháp này liên quan đến việc dạy mô hình nhận biết và xử lý các đầu vào bị thao túng (gọi là ví dụ đối kháng). Khi bạn huấn luyện mô hình với các ví dụ này, nó sẽ chống chịu tốt hơn trước một số kiểu tấn công.
- Cách hoạt động: Tạo các ví dụ dữ liệu bị thao túng và đưa vào quá trình huấn luyện AI.
- Lý do hữu ích: Giúp hệ thống AI vững vàng hơn trước các tấn công cố đánh lừa nó.
- Hạn chế: Có thể hơi giảm độ chính xác của AI trên dữ liệu bình thường (sạch).
- Ví dụ thực tế:
- Cloud Vision API của Google dùng huấn luyện đối kháng để cải thiện khả năng chống chịu của mô hình nhận dạng ảnh trước các đầu vào bị thao túng
- Các mô hình của OpenAI đưa ví dụ đối kháng vào quy trình huấn luyện để tăng cường khả năng chống lại các tấn công dựa trên văn bản.
Chưng cất phòng thủ (Defensive distillation)
Chưng cất LLM liên quan đến việc huấn luyện một mô hình thứ cấp để bắt chước hành vi của mô hình gốc với mục tiêu khiến kẻ tấn công khó thao túng hơn.
- Cách hoạt động: Huấn luyện mô hình đầu tiên, sau đó dùng đầu ra của nó để huấn luyện mô hình khác theo cách làm mượt quá trình ra quyết định.
- Lý do hữu ích: Khiến kẻ tấn công khó khai thác điểm yếu hơn.
- Hạn chế: Cách tiếp cận này có thể đòi hỏi năng lực tính toán lớn, đặc biệt với mô hình lớn.
- Ví dụ thực tế:
- Các nhà nghiên cứu tại Đại học California, Berkeley, áp dụng chưng cất phòng thủ để cải thiện độ vững chắc của mạng nơ-ron sâu dùng trong xe tự hành.
- Nền tảng Watson AI của IBM áp dụng kỹ thuật chưng cất phòng thủ để bảo vệ các mô hình xử lý ngôn ngữ tự nhiên trước tấn công đối kháng.
Kiểm tra và làm sạch đầu vào
Đảm bảo dữ liệu đưa vào hệ thống AI sạch và an toàn là then chốt để bảo vệ khỏi các đầu vào độc hại.
- Cách hoạt động: Kiểm tra đầu vào có đúng định dạng, nằm trong phạm vi mong đợi và không chứa thành phần gây hại.
- Lý do hữu ích: Ngăn tấn công đầu độc dữ liệu và giữ hệ thống AI vận hành trơn tru.
- Thực hành tốt: Xác thực dữ liệu ở nhiều lớp—phía người dùng, phía máy chủ và ngay trong hệ thống AI.
- Ví dụ thực tế:
- Dịch vụ Azure AI của Microsoft triển khai xác thực đầu vào nghiêm ngặt để ngăn tấn công SQL injection vào các mô hình học máy của họ.
- Hệ thống nhận diện khuôn mặt Rekognition của Amazon dùng làm sạch đầu vào để lọc bỏ ảnh có khả năng độc hại.
Phương pháp tổ hợp (Ensemble)
Sử dụng nhiều mô hình AI khác nhau cùng lúc (tổ hợp) có thể làm hệ thống an toàn hơn. Dù một mô hình bị tấn công, các mô hình khác vẫn có thể “đỡ lưng”.
- Cách hoạt động: Kết hợp dự đoán của nhiều mô hình để ra quyết định.
- Lý do hữu ích: Khó để kẻ tấn công xâm phạm đồng thời tất cả mô hình.
- Hạn chế: Cần nhiều tài nguyên tính toán để quản lý nhiều mô hình.
- Ví dụ thực tế:
- Hệ thống gợi ý của Netflix dùng tổ hợp nhiều mô hình AI để tăng độ chính xác và khả năng chống lại các nỗ lực thao túng.
- Phương pháp tổ hợp không chỉ dùng cho bảo mật AI, mà còn được dùng rộng rãi để tạo mô hình dự đoán vững và chính xác hơn.
AI có thể giải thích (XAI)
Làm cho hệ thống AI có thể giải thích giúp con người hiểu cách chúng hoạt động và phát hiện lỗ hổng hoặc hành vi bất thường. Bạn có thể khám phá chi tiết hơn trong khóa học Explainable AI in Python.
- Cách hoạt động: Dùng các công cụ như LIME, SHAP hoặc cơ chế attention để giải thích quyết định AI.
- Lý do hữu ích: Tăng niềm tin vào hệ thống AI và giúp dễ phát hiện, sửa các vấn đề như thiên lệch.
- Thách thức: Mô hình đơn giản, dễ giải thích có thể không mạnh như mô hình phức tạp.
- Ví dụ thực tế:
- Chương trình XAI của DARPA nhằm phát triển các hệ thống AI minh bạch hơn cho ứng dụng quân sự.
- Bộ công cụ AI Explainability 360 của IBM cung cấp tài nguyên mã nguồn mở để triển khai kỹ thuật XAI trên nhiều ngành.
Kiểm toán bảo mật định kỳ
Thường xuyên kiểm tra hệ thống AI để tìm điểm yếu giúp phát hiện sớm vấn đề và đảm bảo hệ thống an toàn theo thời gian.
- Bao gồm những gì: Đánh giá lỗ hổng, kiểm thử xâm nhập và rà soát mã nguồn.
- Tần suất: Thực hiện thường xuyên và sau mỗi thay đổi lớn đối với hệ thống.
- Lý do hữu ích: Xác định các khoảng trống bảo mật tiềm ẩn và đảm bảo tuân thủ quy định.
- Ví dụ thực tế:
- Facebook tiến hành kiểm toán bảo mật định kỳ với hệ thống kiểm duyệt nội dung dùng AI để xác định và xử lý lỗ hổng tiềm ẩn.
- Đạo luật AI của Liên minh Châu Âu đề xuất kiểm toán bảo mật bắt buộc cho các hệ thống AI rủi ro cao dùng trong lĩnh vực trọng yếu.
Áp dụng các chiến lược này có thể giúp hệ thống AI an toàn hơn và được bảo vệ tốt hơn trước tấn công. Nhưng có một điều—bảo mật AI không phải kiểu “thiết lập rồi để đó”. Đó là một quá trình liên tục.
Khi các mối đe dọa mới xuất hiện—và tin tôi đi, chúng luôn xuất hiện—doanh nghiệp cần luôn cảnh giác. Điều đó có nghĩa là liên tục giám sát lỗ hổng, cập nhật hệ thống và cải thiện phòng thủ.
|
Phương pháp
|
Cách hoạt động
|
Lý do hữu ích
|
Hạn chế
|
|
Huấn luyện đối kháng
|
Tạo ví dụ dữ liệu bị thao túng và đưa vào quá trình huấn luyện AI.
|
Cải thiện khả năng chống chịu trước các tấn công đối kháng cố đánh lừa hệ thống.
|
Có thể hơi giảm độ chính xác của AI trên dữ liệu bình thường (sạch).
|
|
Chưng cất phòng thủ
|
Huấn luyện một mô hình thứ cấp bắt chước mô hình gốc, làm mượt quá trình ra quyết định.
|
Khiến kẻ tấn công khó khai thác điểm yếu trong mô hình hơn.
|
Yêu cầu nhiều năng lực tính toán, đặc biệt với mô hình lớn.
|
|
Xác thực & Làm sạch đầu vào
|
Xác thực đầu vào đúng định dạng, trong phạm vi mong đợi và không chứa thành phần gây hại.
|
Ngăn đầu độc dữ liệu và đảm bảo hệ thống AI vận hành trơn tru.
|
Cần triển khai cẩn thận ở nhiều giai đoạn.
|
|
Phương pháp tổ hợp
|
Kết hợp dự đoán từ nhiều mô hình để ra quyết định.
|
Khó để kẻ tấn công xâm phạm tất cả mô hình cùng lúc.
|
Cần nhiều tài nguyên tính toán để quản lý và duy trì nhiều mô hình.
|
|
AI có thể giải thích (XAI)
|
Dùng các công cụ như LIME, SHAP hoặc cơ chế attention để giải thích quyết định AI.
|
Tăng niềm tin và giúp dễ xác định, khắc phục các vấn đề như thiên lệch hoặc hành vi bất thường.
|
Mô hình đơn giản, dễ giải thích có thể không hiệu quả bằng mô hình phức tạp.
|
|
Kiểm toán bảo mật định kỳ
|
Thực hiện đánh giá lỗ hổng, kiểm thử xâm nhập và rà soát mã để xác định điểm yếu.
|
Xác định khoảng trống bảo mật tiềm ẩn và đảm bảo tuân thủ quy định.
|
Có thể tốn nhiều tài nguyên tùy độ phức tạp của hệ thống.
|
Xu hướng mới trong bảo mật AI
Trong phần này, chúng ta xem các xu hướng mới giúp hệ thống AI an toàn, chính xác và đáng tin cậy.
Bảo vệ mô hình AI và tính toàn vẹn dữ liệu
Trước hết, hãy nói về lý do việc bảo vệ mô hình AI và dữ liệu lại quan trọng đến vậy.
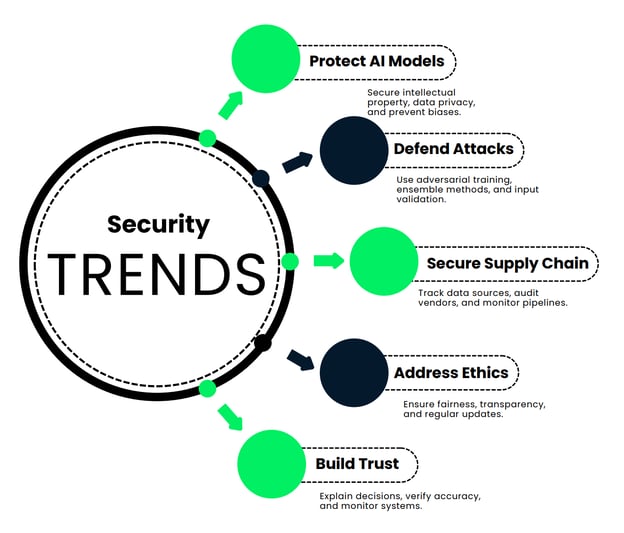
- Bảo vệ tài sản trí tuệ: Hãy nghĩ đến thời gian, tiền bạc và chất xám để tạo ra một mô hình AI. Đây không chỉ là thuật toán; đó là khoản đầu tư khổng lồ. Giữ an toàn giúp ngăn đối thủ đánh cắp công sức ấy.
- Duy trì lợi thế cạnh tranh: Nếu ai đó truy cập trái phép mô hình của bạn, họ có thể sao chép và đạt cùng kết quả—mà không tốn đồng nào để phát triển.
- Quyền riêng tư dữ liệu và tuân thủ: AI thường xử lý dữ liệu nhạy cảm—thông tin tài chính, hồ sơ y tế, v.v. Nếu dữ liệu này bị lộ, bạn sẽ đối mặt với khoản phạt lớn và tổn hại nghiêm trọng niềm tin công chúng. Tìm hiểu thêm trong Introduction to Data Privacy.
- Ngăn chặn đầu độc dữ liệu: Hacker có thể can thiệp dữ liệu huấn luyện, dạy AI ra quyết định sai—như để lọt gian lận hoặc gắn nhầm hành vi vô hại là mối đe doạ.
- Giảm thiểu tấn công đảo ngược mô hình (model inversion): Hãy tưởng tượng kẻ tấn công có thể suy ra chi tiết riêng tư của khách hàng chỉ bằng cách phân tích đầu ra của AI. Điều đó sẽ rất tệ!
- Tránh kết quả thiên lệch hoặc phi đạo đức: Mô hình bị xâm phạm có thể dẫn đến quyết định không công bằng hoặc thậm chí gây hại, làm tổn hại danh tiếng.
- Bảo vệ hạ tầng trọng yếu: Khi AI được dùng trong y tế, tài chính, thậm chí an ninh quốc gia, bảo vệ nó không chỉ là chuyện kinh doanh—đó là vấn đề an toàn công cộng.
Vậy, làm thế nào để thực sự giữ an toàn cho AI? Dưới đây là vài chiến lược chính:
- Dùng mã hóa dữ liệu và ẩn danh hóa để bảo vệ thông tin nhạy cảm.
- Triển khai chính sách lưu giữ dữ liệu nghiêm ngặt để kiểm soát thời gian lưu trữ thông tin.
- Thực hiện kiểm toán và giám sát bảo mật thường xuyên để phát hiện sớm lỗ hổng.
- Thiết kế hệ thống theo nguyên tắc privacy by design, tích hợp bảo mật vào mọi bước.
- Dùng các kỹ thuật tiên tiến như học liên kết (federated learning) để bảo vệ mô hình và dữ liệu của nó mà không phải di chuyển thông tin nhạy cảm.
Hãy làm sống động điều này bằng một kịch bản thực tế. Hình dung một ngân hàng quốc tế lớn phát triển mô hình AI phát hiện giao dịch gian lận. Hệ thống xử lý hàng triệu giao dịch mỗi ngày, phát hiện mẫu đáng ngờ và gắn cờ gian lận.
Ngân hàng chi 50 triệu đô và ba năm để xây dựng hệ thống này. Nếu bị đánh cắp, đối thủ có thể dùng mà không đầu tư xu nào, khiến ngân hàng mất lợi thế.
Mô hình này xử lý dữ liệu tài chính nhạy cảm của hàng triệu khách hàng. Một vụ lộ có thể khiến thông tin bị phơi bày, dẫn đến khoản phạt lớn theo các luật như GDPR.
Nếu hacker bơm dữ liệu giả vào lúc huấn luyện, họ có thể dạy AI bỏ sót một số mẫu gian lận, khiến ngân hàng dễ bị tổn thương.
Những kẻ tinh vi thậm chí có thể rút ra chi tiết riêng tư của khách hàng từ đầu ra mô hình.
Ngân hàng bảo vệ thế nào?
- Họ dùng mã hóa đầu-cuối để bảo vệ dữ liệu.
- Truy cập mô hình yêu cầu xác thực đa yếu tố và được giới hạn qua kiểm soát theo vai trò.
- Họ tiến hành kiểm toán và kiểm thử xâm nhập định kỳ để tìm điểm yếu.
- Dữ liệu khách hàng dùng để huấn luyện được ẩn danh hoàn toàn.
- Ngân hàng liên tục theo dõi hiệu năng mô hình để phát hiện bất thường.
Kết quả là một hệ thống AI an toàn, đáng tin cậy hơn, giữ dữ liệu khách hàng an toàn và thực hiện đúng cam kết phát hiện gian lận hiệu quả. Đó là lợi ích kép cho cả ngân hàng lẫn khách hàng.
Phòng vệ trước tấn công né tránh và đầu độc
Hãy tưởng tượng bạn vận hành một cơ sở an ninh cao dựa vào nhận diện khuôn mặt để giữ mọi thứ an toàn. Tuy nhiên, chúng ta đã biết hệ thống AI dễ bị tấn công, như đầu vào đối kháng hoặc dữ liệu huấn luyện bị đầu độc. Hacker có thể thao túng hệ thống để lọt qua.
Hãy chia nhỏ bốn phòng tuyến chủ chốt có thể chặn đứng kẻ tấn công:
- Huấn luyện đối kháng: Giống như dạy mô hình vài “đòn tự vệ”. Bạn đưa vào các ví dụ đầu vào bị thao túng—những ảnh chỉnh rất tinh để đánh lừa AI—và huấn luyện nó nhận biết. Hình dung một hệ thống nhận diện khuôn mặt không chỉ nhận ra khuôn mặt bạn, mà còn cả những chỉnh sửa hoàn hảo từng điểm ảnh mà kẻ tấn công cố gắng lén lút. AI của bạn trở nên khôn ngoan hơn trước các đòn này, học từ ví dụ để không bị lừa ngoài đời thực.
- Phương pháp tổ hợp: Chúng ta đã nói ở trên. Thay vì dựa vào một hệ thống, bạn dùng một “đội hình” mô hình. Mỗi mô hình xử lý đầu vào độc lập, và kết quả được kết hợp theo cơ chế bỏ phiếu. Kẻ tấn công không thể chỉ lừa một mô hình—họ phải qua mặt cả đội. Chúc may mắn với chuyện đó.
- Kiểm tra dữ liệu thường xuyên: Không ai thích dọn dẹp, nhưng đây là bảo dưỡng thiết yếu cho AI của bạn. Kiểm toán hàng tuần đảm bảo tập huấn luyện không có bản trùng, nhãn sai hoặc đầu vào ác ý lén lút. Và việc liên tục làm mới tập dữ liệu bằng ảnh đã xác minh giúp hệ thống luôn sắc bén.
- Xác thực đầu vào: Trước khi một bức ảnh đến gần AI, nó đi qua trạm kiểm soát an ninh. Cụ thể:
- Kiểm tra định dạng và kích thước.
- Phân tích siêu dữ liệu để tìm dấu hiệu can thiệp.
- Gắn cờ các mẫu đối kháng đã biết.
- Phát hiện bất thường để nhận diện điều khác lạ.
Hệ thống không chỉ thông minh; nó còn thận trọng. Mỗi đầu vào phải “chứng minh” là hợp lệ trước khi đi tiếp.
Bảo mật chuỗi cung ứng AI
Bảo mật AI là quản trị tính toàn vẹn dữ liệu, bảo vệ mô hình sở hữu và đảm bảo mọi thứ ăn khớp với thiết lập an ninh mạng hiện có. Thêm vào đó là nhu cầu đối phó mối đe dọa tiến hóa, tuân thủ quy định, đạo đức và lỗ hổng trong chuỗi cung ứng. Dưới đây là một số chiến lược để bảo mật vòng đời AI:
- Theo dõi nguồn gốc: Mọi mẩu dữ liệu và mọi mô hình trong hệ thống AI của bạn nên có “lý lịch trích ngang” rõ ràng. Ghi lại nơi xuất phát, dù là bệnh viện đáng tin, viện nghiên cứu hay nhà cung cấp. Tại sao? Vì biết nguồn là bước đầu để biết có thể tin cậy.
- Kiểm toán nhà cung cấp: Bên thứ ba rất quan trọng, nhưng cũng là điểm yếu tiềm tàng. Thực hiện kiểm toán định kỳ để đảm bảo họ đáp ứng tiêu chuẩn bảo mật của bạn, như tuân thủ HIPAA, quy trình ẩn danh dữ liệu hoặc chứng nhận ISO.
- Dùng công cụ theo dõi dữ liệu: Dữ liệu không tĩnh. Theo thời gian, nó thay đổi, và đôi khi bao gồm lỗi hoặc thay đổi ác ý. Công cụ giám sát dữ liệu tự động có thể theo dõi thay đổi và gắn cờ biến động bất thường, giúp tập dữ liệu sạch và chính xác.
- Giám sát pipeline dữ liệu: Dữ liệu đi từ nguồn đến mô hình qua pipeline phức tạp, và bất kỳ trục trặc nào dọc đường đều có thể gây rắc rối. Bảng điều khiển thời gian thực giúp bạn bắt kịp bất thường, như sụt giảm đột ngột khối lượng dữ liệu hoặc thay đổi đặc trưng bất ngờ.
Ví dụ thực tế: một công ty chăm sóc sức khỏe phát triển công cụ chẩn đoán dùng AI. Chuỗi cung ứng của họ gồm:
- Dữ liệu bệnh nhân từ các bệnh viện đối tác.
- Tập dữ liệu hình ảnh y khoa từ một viện nghiên cứu hàng đầu.
- Mô hình tiền huấn luyện từ nhà cung cấp AI chuyên biệt.
Họ bảo mật pipeline này thế nào?
- Theo dõi nguồn gốc: Mọi tập dữ liệu và mô hình đều được ghi chép tỉ mỉ để đảm bảo khả năng truy vết.
- Kiểm toán nhà cung cấp: Họ tiến hành kiểm tra hàng quý về tuân thủ HIPAA và đảm bảo ẩn danh dữ liệu. Nhà cung cấp được đánh giá bảo mật hằng năm để duy trì chứng chỉ.
- Công cụ dòng dõi dữ liệu (data lineage): Họ dùng công cụ như Anomalo để phát hiện biến động bất thường về nhân khẩu học bệnh nhân hoặc dữ liệu hình ảnh.
- Giám sát pipeline: Bảng điều khiển thời gian thực trong Looker theo dõi luồng dữ liệu, gắn cờ ngay mọi bất thường.
Bằng cách này, họ có một chuỗi cung ứng AI an toàn, đảm bảo công cụ chẩn đoán chính xác, đáng tin cậy và tuân thủ tiêu chuẩn ngành.
Giải quyết rủi ro đạo đức
AI rất mạnh mẽ, nhưng sức mạnh đó có thể nguy hiểm nếu rơi vào tay kẻ xấu. Nếu hệ thống AI bị hack hoặc thiết kế kém, nó có thể dẫn đến quyết định thiên lệch, kết quả phi đạo đức, thậm chí bị lạm dụng. Điều này nghiêm trọng, đặc biệt khi AI đưa ra quyết định ảnh hưởng đến đời thực—như tuyển dụng, cho vay hay chăm sóc sức khỏe.
Vậy làm sao để hệ thống AI đạo đức hơn và bền vững hơn? Hãy chia thành bốn bước chính:
- Xây dựng quy tắc và khung làm việc rõ ràng: Bắt đầu bằng nền tảng vững. Soạn chính sách xác định thế nào là công bằng và đạo đức với hệ thống của bạn.
- Đào tạo nhóm AI về đạo đức: Không thể kỳ vọng AI hành xử có đạo đức nếu người xây dựng không được trang bị tư duy phản biện về vấn đề này. Đào tạo đạo đức giúp nhóm nhận diện và xử lý thiên kiến vô thức, hiểu công bằng và tác động xã hội của công việc họ làm.
- Làm minh bạch quyết định của AI: Minh bạch nghĩa là thiết kế hệ thống có thể giải thích quyết định—các yếu tố được cân nhắc, cách so sánh ứng viên và những điểm cần lưu ý. Minh bạch xây dựng niềm tin và trách nhiệm giải trình.
- Cập nhật hệ thống AI thường xuyên: AI không phải “làm xong để đó”. Kiểm toán định kỳ giúp nhận diện và giảm thiên lệch, đảm bảo công bằng và tuân thủ tiêu chuẩn ngành, yêu cầu pháp lý mới nhất. Công bằng không tĩnh; đó là quá trình liên tục.
Ví dụ thực tế: một công ty công nghệ lớn dùng hệ thống tuyển dụng hỗ trợ AI. Họ giữ cho nó có đạo đức thế nào?
- Xây dựng quy tắc rõ ràng: Họ tạo Chính sách Đạo đức AI nêu nguyên tắc tuyển dụng không thiên lệch, bao trùm từ thu thập dữ liệu đến ra quyết định. Một Hội đồng Đạo đức AI giám sát chính sách để đảm bảo trách nhiệm giải trình.
- Đào tạo đội ngũ: Đào tạo đạo đức là bắt buộc cho mọi nhân viên tham gia hệ thống. Họ học về thiên kiến vô thức và công bằng trong học máy, tham gia hội thảo giải quyết tình huống thực tế.
- Minh bạch: Hệ thống tuyển dụng tích hợp công cụ giải thích. Với mỗi khuyến nghị, nó cung cấp phân tích các yếu tố ảnh hưởng—như năng lực chính hoặc cách một ứng viên so với người khác. Điều này giúp bộ phận nhân sự dễ rà soát quyết định.
- Cập nhật thường xuyên: Kiểm toán hàng quý phân tích quyết định tuyển dụng để phát hiện thiên lệch và áp dụng kỹ thuật như adversarial debiasing để liên tục cải thiện công bằng. Họ cũng cập nhật hệ thống theo luật bình đẳng việc làm mới nhất và thông lệ tốt nhất của ngành.
Đây là một hệ thống tuyển dụng có đạo đức, công bằng và minh bạch—kể cả khi đối mặt với khả năng bị xâm phạm.
Thách thức về khả năng giải thích và niềm tin
Hệ thống AI thường bị xem như “hộp đen”, nghĩa là quá trình ra quyết định không dễ hiểu. Điều này khiến khó phát hiện vấn đề hoặc xây dựng niềm tin. Nếu bạn là bác sĩ dựa vào công cụ AI hoặc bệnh nhân chịu tác động bởi quyết định của nó, bạn muốn câu trả lời, không phải dấu hỏi. Giải pháp là khả năng giải thích. Dưới đây là bốn chiến lược giúp hệ thống AI minh bạch và dễ tạo niềm tin hơn:
- Dùng công cụ XAI: Những công cụ này giúp “giải ảo” cách AI đi đến kết luận. Ví dụ, LIME hoặc SHAP có thể cho thấy yếu tố nào ảnh hưởng đến một quyết định cụ thể, khiến lập luận của hệ thống dễ tiếp cận hơn.
- Theo dõi và ghi lại thay đổi dữ liệu: Khi bạn ghi lại mọi thay đổi—như dữ liệu nào được thêm, xóa hoặc sửa—bạn có thể truy vết tác động của những cập nhật này đến hiệu năng mô hình.
- Xác minh độ chính xác thường xuyên: Không thể tin AI “như đúng rồi”. So sánh đầu ra với dữ liệu gốc và, khi có thể, nhờ chuyên gia con người thẩm định. Kiểm toán định kỳ đảm bảo hệ thống luôn sắc bén và không thiên lệch. Tin nhưng phải kiểm chứng.
- Kiểm thử và giám sát liên tục: AI không phải công cụ “thiết lập rồi quên”. Kiểm thử thường xuyên với đầu vào đa dạng giúp phát hiện lỗi sớm, và giám sát thời gian thực đảm bảo hệ thống hoạt động ổn định trong nhiều kịch bản.
Hãy xem cách một bệnh viện xây dựng niềm tin với công cụ chẩn đoán da liễu dùng AI—một hệ thống dùng nhận dạng hình ảnh để phát hiện tình trạng da tiềm ẩn.
- Công cụ XAI: Bệnh viện dùng LIME, công cụ tô sáng những phần của ảnh da ảnh hưởng nhiều nhất đến chẩn đoán của AI, giúp bác sĩ hiểu và tin vào lập luận của AI.
- Theo dõi thay đổi dữ liệu: Một công cụ data lineage ghi nhật ký mọi cập nhật vào tập huấn luyện, như ảnh mới thêm hoặc xóa. Điều này cho phép bệnh viện theo dõi tác động của thay đổi đến độ chính xác của AI theo thời gian.
- Xác minh độ chính xác: Mỗi tháng, bác sĩ da liễu rà soát ngẫu nhiên các chẩn đoán của AI, so với dữ liệu bệnh nhân gốc và ý kiến chuyên môn của họ. Mục tiêu là đảm bảo hệ thống duy trì tiêu chuẩn cao về độ chính xác và công bằng.
- Kiểm thử và giám sát thường xuyên: Đội CNTT kiểm thử hàng tuần với ảnh đa dạng, kiểm tra hiệu năng AI trên nhiều loại da và tình trạng. Họ cũng giám sát mẫu bất thường theo thời gian thực để khắc phục trước khi leo thang.
Công cụ AI này không chỉ thông minh mà còn có thể giải thích và đáng tin cậy. Bác sĩ hiểu quyết định của nó, bệnh nhân yên tâm với dịch vụ, và bệnh viện đảm bảo công nghệ hoạt động công bằng, chính xác.
Kết luận
Khi AI ngày càng hiện diện trong đời sống, giữ cho nó an toàn quan trọng hơn bao giờ hết. Vì sao? Vì cùng một sức mạnh tạo nên khả năng của AI cũng khiến nó trở thành mục tiêu tấn công. Những mối đe dọa như tấn công đối kháng, đầu độc dữ liệu và đánh cắp mô hình có thể làm gián đoạn nghiêm trọng cách AI vận hành.
Vậy ta phòng thủ cho AI thế nào? Chúng ta đã học được rằng không có một giải pháp “vừa cho tất cả”. Các kỹ thuật như huấn luyện đối kháng, kiểm toán thường xuyên và phòng vệ nhiều lớp có thể giảm rủi ro và làm hệ thống vững vàng hơn.
Rồi đến AI sinh sinh (generative AI). Các mô hình ngôn ngữ lớn mang đến cơ hội to lớn, nhưng cũng đưa vào lỗ hổng mới. Từ việc tạo nội dung gây hiểu nhầm đến bị thao túng để đưa ra đầu ra gây hại, các công cụ này đòi hỏi giám sát cẩn trọng. Trong bài Cách xây dựng “lan can an toàn” cho mô hình ngôn ngữ lớn, các biện pháp an toàn để đảm bảo LLM hành xử đúng được phân tích.
Đạo đức và minh bạch là không thể thương lượng. Hệ thống AI cần công bằng, có thể giải thích và đáng tin cậy. Thiên lệch và lạm dụng có thể bào mòn niềm tin—mà niềm tin là tất cả trong thế giới công nghệ ngày nay. Mọi người sẽ không dùng thứ họ không tin.
Cuối cùng, đi trước là chìa khóa. Mối đe dọa AI liên tục tiến hóa. Doanh nghiệp cần thường xuyên cập nhật chiến lược bảo mật, theo kịp rủi ro mới để được bảo vệ.Điểm mấu chốt là chủ động, cảnh giác và cam kết với đạo đức, minh bạch; bằng cách đó, doanh nghiệp có thể xây dựng niềm tin và tận dụng tối đa lợi ích của AI.


 Matt Crabtree · 10 min
AI đang phát triển nhanh đến mức theo kịp những thách thức về bảo mật của nó giống như đang cố sửa một chiếc máy bay khi nó đang bay. Khi hệ thống trở nên thông minh hơn và được tích hợp sâu vào các quy trình kinh doanh hằng ngày, chúng cũng dễ bị tổn thương hơn trước những kiểu đe doạ mới.
Tôi đã chứng kiến điều này rất rõ trong công việc của mình. Nhiều lần tôi phát hiện ra lỗ hổng bảo mật trong quy trình kinh doanh có thể cho phép ai đó truy cập thông tin nhạy cảm mà họ không được phép, đặc biệt khi các giải pháp AI được triển khai vội vàng mà không có biện pháp bảo vệ phù hợp.
Đó là lý do có bài viết này: hiểu rủi ro, thách thức và thực hành tốt nhất để giữ an toàn cho AI. AI đang tăng trưởng quá nhanh, và nếu không đi trước các lỗ hổng, chúng ta có nguy cơ đánh mất niềm tin và lợi ích mà nó mang lại.
Nếu bạn muốn tìm hiểu sâu hơn về chủ đề này, tôi khuyến nghị xem khóa học AI Security and Risk Management.
Những thách thức bảo mật AI mới
AI vận hành dựa trên dữ liệu. Và càng phụ thuộc vào dữ liệu, mục tiêu càng lớn. Hacker biết điều đó. Hãy hình dung một bệnh viện dùng AI dự đoán rủi ro sức khỏe bệnh nhân. Nghe thật tuyệt, cho đến khi ai đó xâm nhập hệ thống. Đột nhiên, hồ sơ bệnh nhân riêng tư bị rao bán trên dark web, hoặc tệ hơn, dữ liệu y tế bị chỉnh sửa, có thể dẫn đến quyết định gây hại. Mã hóa dữ liệu nhạy cảm và có bản sao lưu là chìa khóa, nhưng nhiều công ty mải mê đổi mới đến mức bỏ qua những điều cơ bản này.
Và hacker không chỉ đánh cắp dữ liệu. Họ còn có thể can thiệp trực tiếp vào mô hình AI. Ví dụ, một xe tự lái bị đánh lừa nghĩ biển báo dừng là biển giới hạn tốc độ. Kiểu tấn công này gọi là tấn công đầu độc dữ liệu (data poisoning), trong đó hacker bơm dữ liệu xấu vào hệ thống để làm sai lệch quyết định. Chúng ta sẽ xem chi tiết hơn ở phần tiếp theo.
Tấn công tiêm lệnh (prompt injection) cũng là một kiểu tấn công khác. Đây là các thao tác tinh vi nhằm đánh lừa AI nói—hoặc làm—điều nó không nên. Chúng tôi có một bài viết tuyệt vời về prompt injection, nên chúng tôi sẽ không đi quá sâu ở đây, nhưng chắc chắn rất đáng đọc.
Trớ trêu thay, hacker cũng dùng AI để hack. Đây là lúc an ninh mạng trở thành cuộc chạy đua với thời gian—hacker đổi mới, và đội ngũ bảo mật phải phản ứng nhanh không kém. Các công cụ như phát hiện bất thường có thể giúp, nhưng không hề hoàn hảo.
Bạn từng nghe câu “Mạnh vì gạo, bạo vì tiền” hay “Mắt xích yếu làm hỏng cả dây xích” chứ? Điều này hoàn toàn đúng với AI. Các công ty thường tích hợp công cụ AI dựng sẵn vào hệ thống của họ. Nhưng nếu một trong các công cụ đó bị xâm phạm thì sao? Hãy tưởng tượng một chatbot phổ biến được hàng trăm doanh nghiệp sử dụng bị hack. Nghĩa là hàng trăm công ty—cùng toàn bộ dữ liệu khách hàng của họ—đều gặp rủi ro. Hiệu ứng đô-mi-nô kỹ thuật số.
Cuối cùng là khoảng cách về chuyên môn. Việc ứng dụng AI đang tăng, nhưng bảo mật cho AI vẫn đang chạy theo sau.
Các mối đe dọa bảo mật AI
Hệ thống AI đối mặt với những mối đe dọa nghiêm trọng có thể ảnh hưởng đến hiệu quả và độ tin cậy. Hãy điểm qua các mối đe dọa chính.
Tấn công đối kháng (Adversarial attacks)
Tấn công đối kháng đánh lừa hệ thống AI bằng cách thực hiện những thay đổi nhỏ, kín đáo vào đầu vào mà AI xử lý. Những thay đổi này tinh vi đến mức con người thường không nhận ra, nhưng có thể khiến AI hoàn toàn nhầm lẫn và đưa ra quyết định sai.
Ví dụ:
Những tấn công này không đòi hỏi kẻ tấn công phải biết AI hoạt động nội bộ ra sao, đó là một lý do nữa khiến chúng rất khó phát hiện và ngăn chặn.
Giờ hãy xem vài ví dụ thực tế.
Sơ đồ này minh họa một cuộc tấn công đối kháng vào hệ thống AI chẩn đoán hình ảnh y khoa. Ảnh X-quang gốc được phân loại đúng là "Nguy cơ cao ung thư phổi" bị chỉnh nhẹ với nhiễu đối kháng, dẫn đến phân loại sai thành "Phổi khỏe mạnh".
Một bài đọc rất hay là Học máy đối kháng (Adversarial Machine Learning), một lĩnh vực nghiên cứu các cuộc tấn công khai thác lỗ hổng trong mô hình học máy và phát triển biện pháp phòng vệ để bảo vệ trước các mối đe dọa này.
Tấn công đầu độc (Poisoning attacks)
Tấn công đầu độc nhắm vào giai đoạn huấn luyện của hệ thống AI, nơi mô hình học cách ra quyết định. Kẻ tấn công lén đưa dữ liệu hỏng hoặc gây hiểu nhầm vào tập huấn luyện để thao túng AI hành xử sai hoặc thiên lệch. Những tấn công này hiệu quả vì chúng can thiệp vào nền tảng quá trình học của AI, thường không để lại dấu hiệu rõ ràng.
Điều này có thể bao gồm:
Những thay đổi tinh vi này có thể khiến AI thất bại trong một số điều kiện hoặc hành xử theo cách có lợi cho kẻ tấn công. Vì cuộc tấn công diễn ra trong quá trình huấn luyện, rất khó phát hiện khi mô hình đã triển khai.
Hãy xem vài ví dụ thực tế:
Sơ đồ này minh họa một cuộc tấn công đầu độc vào hệ thống AI dùng để phân loại hồ sơ bảo hiểm sai thật. Ở bảng đầu, hệ thống tách đúng hồ sơ sai (đỏ) và đúng (đen) bằng tập huấn luyện sạch. Ở bảng sau, dữ liệu bị gắn nhãn sai ác ý (“poison”) làm dịch chuyển ranh quyết định, dẫn đến phân loại sai hồ sơ gian lận thành đúng, làm suy giảm độ tin cậy và bảo mật của hệ thống.
Tấn công trích xuất mô hình
Trong tấn công trích xuất mô hình, kẻ tấn công tìm hiểu cách một mô hình AI hoạt động bằng cách đảo ngược nó. Họ dùng các đầu vào và đầu ra thu thập được để sao chép thiết kế và hành vi của hệ thống.
Khi đã dựng bản sao của mô hình, họ có thể:
Ví dụ, nếu mô hình bị đánh cắp được huấn luyện trên dữ liệu khách hàng riêng tư, kẻ tấn công có thể dự đoán thông tin cá nhân về những khách hàng đó hoặc tạo phiên bản mô hình tuỳ biến cho mục đích riêng.
Hãy xem một số ví dụ thực tế:
Sơ đồ này minh họa một cuộc tấn công trích xuất mô hình, trong đó kẻ tấn công tương tác với mô hình AI nạn nhân bằng cách gửi truy vấn và thu thập dự đoán. Dữ liệu thu được được dùng để huấn luyện mô hình bản sao, cuối cùng tái tạo một phiên bản bị đánh cắp của hệ thống gốc.
Phòng thủ bảo mật AI
Như đã đề cập ở các phần trước, khi AI trở nên phổ biến hơn, việc áp dụng các biện pháp bảo mật mạnh mẽ để chống lại tấn công là rất quan trọng. Hãy nói về một số cách hiệu quả để làm AI an toàn hơn.
Huấn luyện đối kháng
Phương pháp này liên quan đến việc dạy mô hình nhận biết và xử lý các đầu vào bị thao túng (gọi là ví dụ đối kháng). Khi bạn huấn luyện mô hình với các ví dụ này, nó sẽ chống chịu tốt hơn trước một số kiểu tấn công.
Chưng cất phòng thủ (Defensive distillation)
Chưng cất LLM liên quan đến việc huấn luyện một mô hình thứ cấp để bắt chước hành vi của mô hình gốc với mục tiêu khiến kẻ tấn công khó thao túng hơn.
Kiểm tra và làm sạch đầu vào
Đảm bảo dữ liệu đưa vào hệ thống AI sạch và an toàn là then chốt để bảo vệ khỏi các đầu vào độc hại.
Phương pháp tổ hợp (Ensemble)
Sử dụng nhiều mô hình AI khác nhau cùng lúc (tổ hợp) có thể làm hệ thống an toàn hơn. Dù một mô hình bị tấn công, các mô hình khác vẫn có thể “đỡ lưng”.
AI có thể giải thích (XAI)
Làm cho hệ thống AI có thể giải thích giúp con người hiểu cách chúng hoạt động và phát hiện lỗ hổng hoặc hành vi bất thường. Bạn có thể khám phá chi tiết hơn trong khóa học Explainable AI in Python.
Kiểm toán bảo mật định kỳ
Thường xuyên kiểm tra hệ thống AI để tìm điểm yếu giúp phát hiện sớm vấn đề và đảm bảo hệ thống an toàn theo thời gian.
Áp dụng các chiến lược này có thể giúp hệ thống AI an toàn hơn và được bảo vệ tốt hơn trước tấn công. Nhưng có một điều—bảo mật AI không phải kiểu “thiết lập rồi để đó”. Đó là một quá trình liên tục.
Khi các mối đe dọa mới xuất hiện—và tin tôi đi, chúng luôn xuất hiện—doanh nghiệp cần luôn cảnh giác. Điều đó có nghĩa là liên tục giám sát lỗ hổng, cập nhật hệ thống và cải thiện phòng thủ.
Phương pháp
Cách hoạt động
Lý do hữu ích
Hạn chế
Huấn luyện đối kháng
Tạo ví dụ dữ liệu bị thao túng và đưa vào quá trình huấn luyện AI.
Cải thiện khả năng chống chịu trước các tấn công đối kháng cố đánh lừa hệ thống.
Có thể hơi giảm độ chính xác của AI trên dữ liệu bình thường (sạch).
Chưng cất phòng thủ
Huấn luyện một mô hình thứ cấp bắt chước mô hình gốc, làm mượt quá trình ra quyết định.
Khiến kẻ tấn công khó khai thác điểm yếu trong mô hình hơn.
Yêu cầu nhiều năng lực tính toán, đặc biệt với mô hình lớn.
Xác thực & Làm sạch đầu vào
Xác thực đầu vào đúng định dạng, trong phạm vi mong đợi và không chứa thành phần gây hại.
Ngăn đầu độc dữ liệu và đảm bảo hệ thống AI vận hành trơn tru.
Cần triển khai cẩn thận ở nhiều giai đoạn.
Phương pháp tổ hợp
Kết hợp dự đoán từ nhiều mô hình để ra quyết định.
Khó để kẻ tấn công xâm phạm tất cả mô hình cùng lúc.
Cần nhiều tài nguyên tính toán để quản lý và duy trì nhiều mô hình.
AI có thể giải thích (XAI)
Dùng các công cụ như LIME, SHAP hoặc cơ chế attention để giải thích quyết định AI.
Tăng niềm tin và giúp dễ xác định, khắc phục các vấn đề như thiên lệch hoặc hành vi bất thường.
Mô hình đơn giản, dễ giải thích có thể không hiệu quả bằng mô hình phức tạp.
Kiểm toán bảo mật định kỳ
Thực hiện đánh giá lỗ hổng, kiểm thử xâm nhập và rà soát mã để xác định điểm yếu.
Xác định khoảng trống bảo mật tiềm ẩn và đảm bảo tuân thủ quy định.
Có thể tốn nhiều tài nguyên tùy độ phức tạp của hệ thống.
Xu hướng mới trong bảo mật AI
Trong phần này, chúng ta xem các xu hướng mới giúp hệ thống AI an toàn, chính xác và đáng tin cậy.
Bảo vệ mô hình AI và tính toàn vẹn dữ liệu
Trước hết, hãy nói về lý do việc bảo vệ mô hình AI và dữ liệu lại quan trọng đến vậy.
Vậy, làm thế nào để thực sự giữ an toàn cho AI? Dưới đây là vài chiến lược chính:
Hãy làm sống động điều này bằng một kịch bản thực tế. Hình dung một ngân hàng quốc tế lớn phát triển mô hình AI phát hiện giao dịch gian lận. Hệ thống xử lý hàng triệu giao dịch mỗi ngày, phát hiện mẫu đáng ngờ và gắn cờ gian lận.
Ngân hàng chi 50 triệu đô và ba năm để xây dựng hệ thống này. Nếu bị đánh cắp, đối thủ có thể dùng mà không đầu tư xu nào, khiến ngân hàng mất lợi thế.
Mô hình này xử lý dữ liệu tài chính nhạy cảm của hàng triệu khách hàng. Một vụ lộ có thể khiến thông tin bị phơi bày, dẫn đến khoản phạt lớn theo các luật như GDPR.
Nếu hacker bơm dữ liệu giả vào lúc huấn luyện, họ có thể dạy AI bỏ sót một số mẫu gian lận, khiến ngân hàng dễ bị tổn thương.
Những kẻ tinh vi thậm chí có thể rút ra chi tiết riêng tư của khách hàng từ đầu ra mô hình.
Ngân hàng bảo vệ thế nào?
Kết quả là một hệ thống AI an toàn, đáng tin cậy hơn, giữ dữ liệu khách hàng an toàn và thực hiện đúng cam kết phát hiện gian lận hiệu quả. Đó là lợi ích kép cho cả ngân hàng lẫn khách hàng.
Phòng vệ trước tấn công né tránh và đầu độc
Hãy tưởng tượng bạn vận hành một cơ sở an ninh cao dựa vào nhận diện khuôn mặt để giữ mọi thứ an toàn. Tuy nhiên, chúng ta đã biết hệ thống AI dễ bị tấn công, như đầu vào đối kháng hoặc dữ liệu huấn luyện bị đầu độc. Hacker có thể thao túng hệ thống để lọt qua.
Hãy chia nhỏ bốn phòng tuyến chủ chốt có thể chặn đứng kẻ tấn công:
Hệ thống không chỉ thông minh; nó còn thận trọng. Mỗi đầu vào phải “chứng minh” là hợp lệ trước khi đi tiếp.
Bảo mật chuỗi cung ứng AI
Bảo mật AI là quản trị tính toàn vẹn dữ liệu, bảo vệ mô hình sở hữu và đảm bảo mọi thứ ăn khớp với thiết lập an ninh mạng hiện có. Thêm vào đó là nhu cầu đối phó mối đe dọa tiến hóa, tuân thủ quy định, đạo đức và lỗ hổng trong chuỗi cung ứng. Dưới đây là một số chiến lược để bảo mật vòng đời AI:
Ví dụ thực tế: một công ty chăm sóc sức khỏe phát triển công cụ chẩn đoán dùng AI. Chuỗi cung ứng của họ gồm:
Họ bảo mật pipeline này thế nào?
Bằng cách này, họ có một chuỗi cung ứng AI an toàn, đảm bảo công cụ chẩn đoán chính xác, đáng tin cậy và tuân thủ tiêu chuẩn ngành.
Giải quyết rủi ro đạo đức
AI rất mạnh mẽ, nhưng sức mạnh đó có thể nguy hiểm nếu rơi vào tay kẻ xấu. Nếu hệ thống AI bị hack hoặc thiết kế kém, nó có thể dẫn đến quyết định thiên lệch, kết quả phi đạo đức, thậm chí bị lạm dụng. Điều này nghiêm trọng, đặc biệt khi AI đưa ra quyết định ảnh hưởng đến đời thực—như tuyển dụng, cho vay hay chăm sóc sức khỏe.
Vậy làm sao để hệ thống AI đạo đức hơn và bền vững hơn? Hãy chia thành bốn bước chính:
Ví dụ thực tế: một công ty công nghệ lớn dùng hệ thống tuyển dụng hỗ trợ AI. Họ giữ cho nó có đạo đức thế nào?
Đây là một hệ thống tuyển dụng có đạo đức, công bằng và minh bạch—kể cả khi đối mặt với khả năng bị xâm phạm.
Thách thức về khả năng giải thích và niềm tin
Hệ thống AI thường bị xem như “hộp đen”, nghĩa là quá trình ra quyết định không dễ hiểu. Điều này khiến khó phát hiện vấn đề hoặc xây dựng niềm tin. Nếu bạn là bác sĩ dựa vào công cụ AI hoặc bệnh nhân chịu tác động bởi quyết định của nó, bạn muốn câu trả lời, không phải dấu hỏi. Giải pháp là khả năng giải thích. Dưới đây là bốn chiến lược giúp hệ thống AI minh bạch và dễ tạo niềm tin hơn:
Hãy xem cách một bệnh viện xây dựng niềm tin với công cụ chẩn đoán da liễu dùng AI—một hệ thống dùng nhận dạng hình ảnh để phát hiện tình trạng da tiềm ẩn.
Công cụ AI này không chỉ thông minh mà còn có thể giải thích và đáng tin cậy. Bác sĩ hiểu quyết định của nó, bệnh nhân yên tâm với dịch vụ, và bệnh viện đảm bảo công nghệ hoạt động công bằng, chính xác.
Kết luận
Khi AI ngày càng hiện diện trong đời sống, giữ cho nó an toàn quan trọng hơn bao giờ hết. Vì sao? Vì cùng một sức mạnh tạo nên khả năng của AI cũng khiến nó trở thành mục tiêu tấn công. Những mối đe dọa như tấn công đối kháng, đầu độc dữ liệu và đánh cắp mô hình có thể làm gián đoạn nghiêm trọng cách AI vận hành.
Vậy ta phòng thủ cho AI thế nào? Chúng ta đã học được rằng không có một giải pháp “vừa cho tất cả”. Các kỹ thuật như huấn luyện đối kháng, kiểm toán thường xuyên và phòng vệ nhiều lớp có thể giảm rủi ro và làm hệ thống vững vàng hơn.
Rồi đến AI sinh sinh (generative AI). Các mô hình ngôn ngữ lớn mang đến cơ hội to lớn, nhưng cũng đưa vào lỗ hổng mới. Từ việc tạo nội dung gây hiểu nhầm đến bị thao túng để đưa ra đầu ra gây hại, các công cụ này đòi hỏi giám sát cẩn trọng. Trong bài Cách xây dựng “lan can an toàn” cho mô hình ngôn ngữ lớn, các biện pháp an toàn để đảm bảo LLM hành xử đúng được phân tích.
Đạo đức và minh bạch là không thể thương lượng. Hệ thống AI cần công bằng, có thể giải thích và đáng tin cậy. Thiên lệch và lạm dụng có thể bào mòn niềm tin—mà niềm tin là tất cả trong thế giới công nghệ ngày nay. Mọi người sẽ không dùng thứ họ không tin.
Cuối cùng, đi trước là chìa khóa. Mối đe dọa AI liên tục tiến hóa. Doanh nghiệp cần thường xuyên cập nhật chiến lược bảo mật, theo kịp rủi ro mới để được bảo vệ.Điểm mấu chốt là chủ động, cảnh giác và cam kết với đạo đức, minh bạch; bằng cách đó, doanh nghiệp có thể xây dựng niềm tin và tận dụng tối đa lợi ích của AI.